指标口径管理
 做数据开发这些年,技术问题从来不是最头疼的。最头疼的是开会的时候,运营说"昨天GMV是500万",财务说"不对,是480万",老板看大屏又是510万。
三个人,三张报表,同一个指标,三个数字。
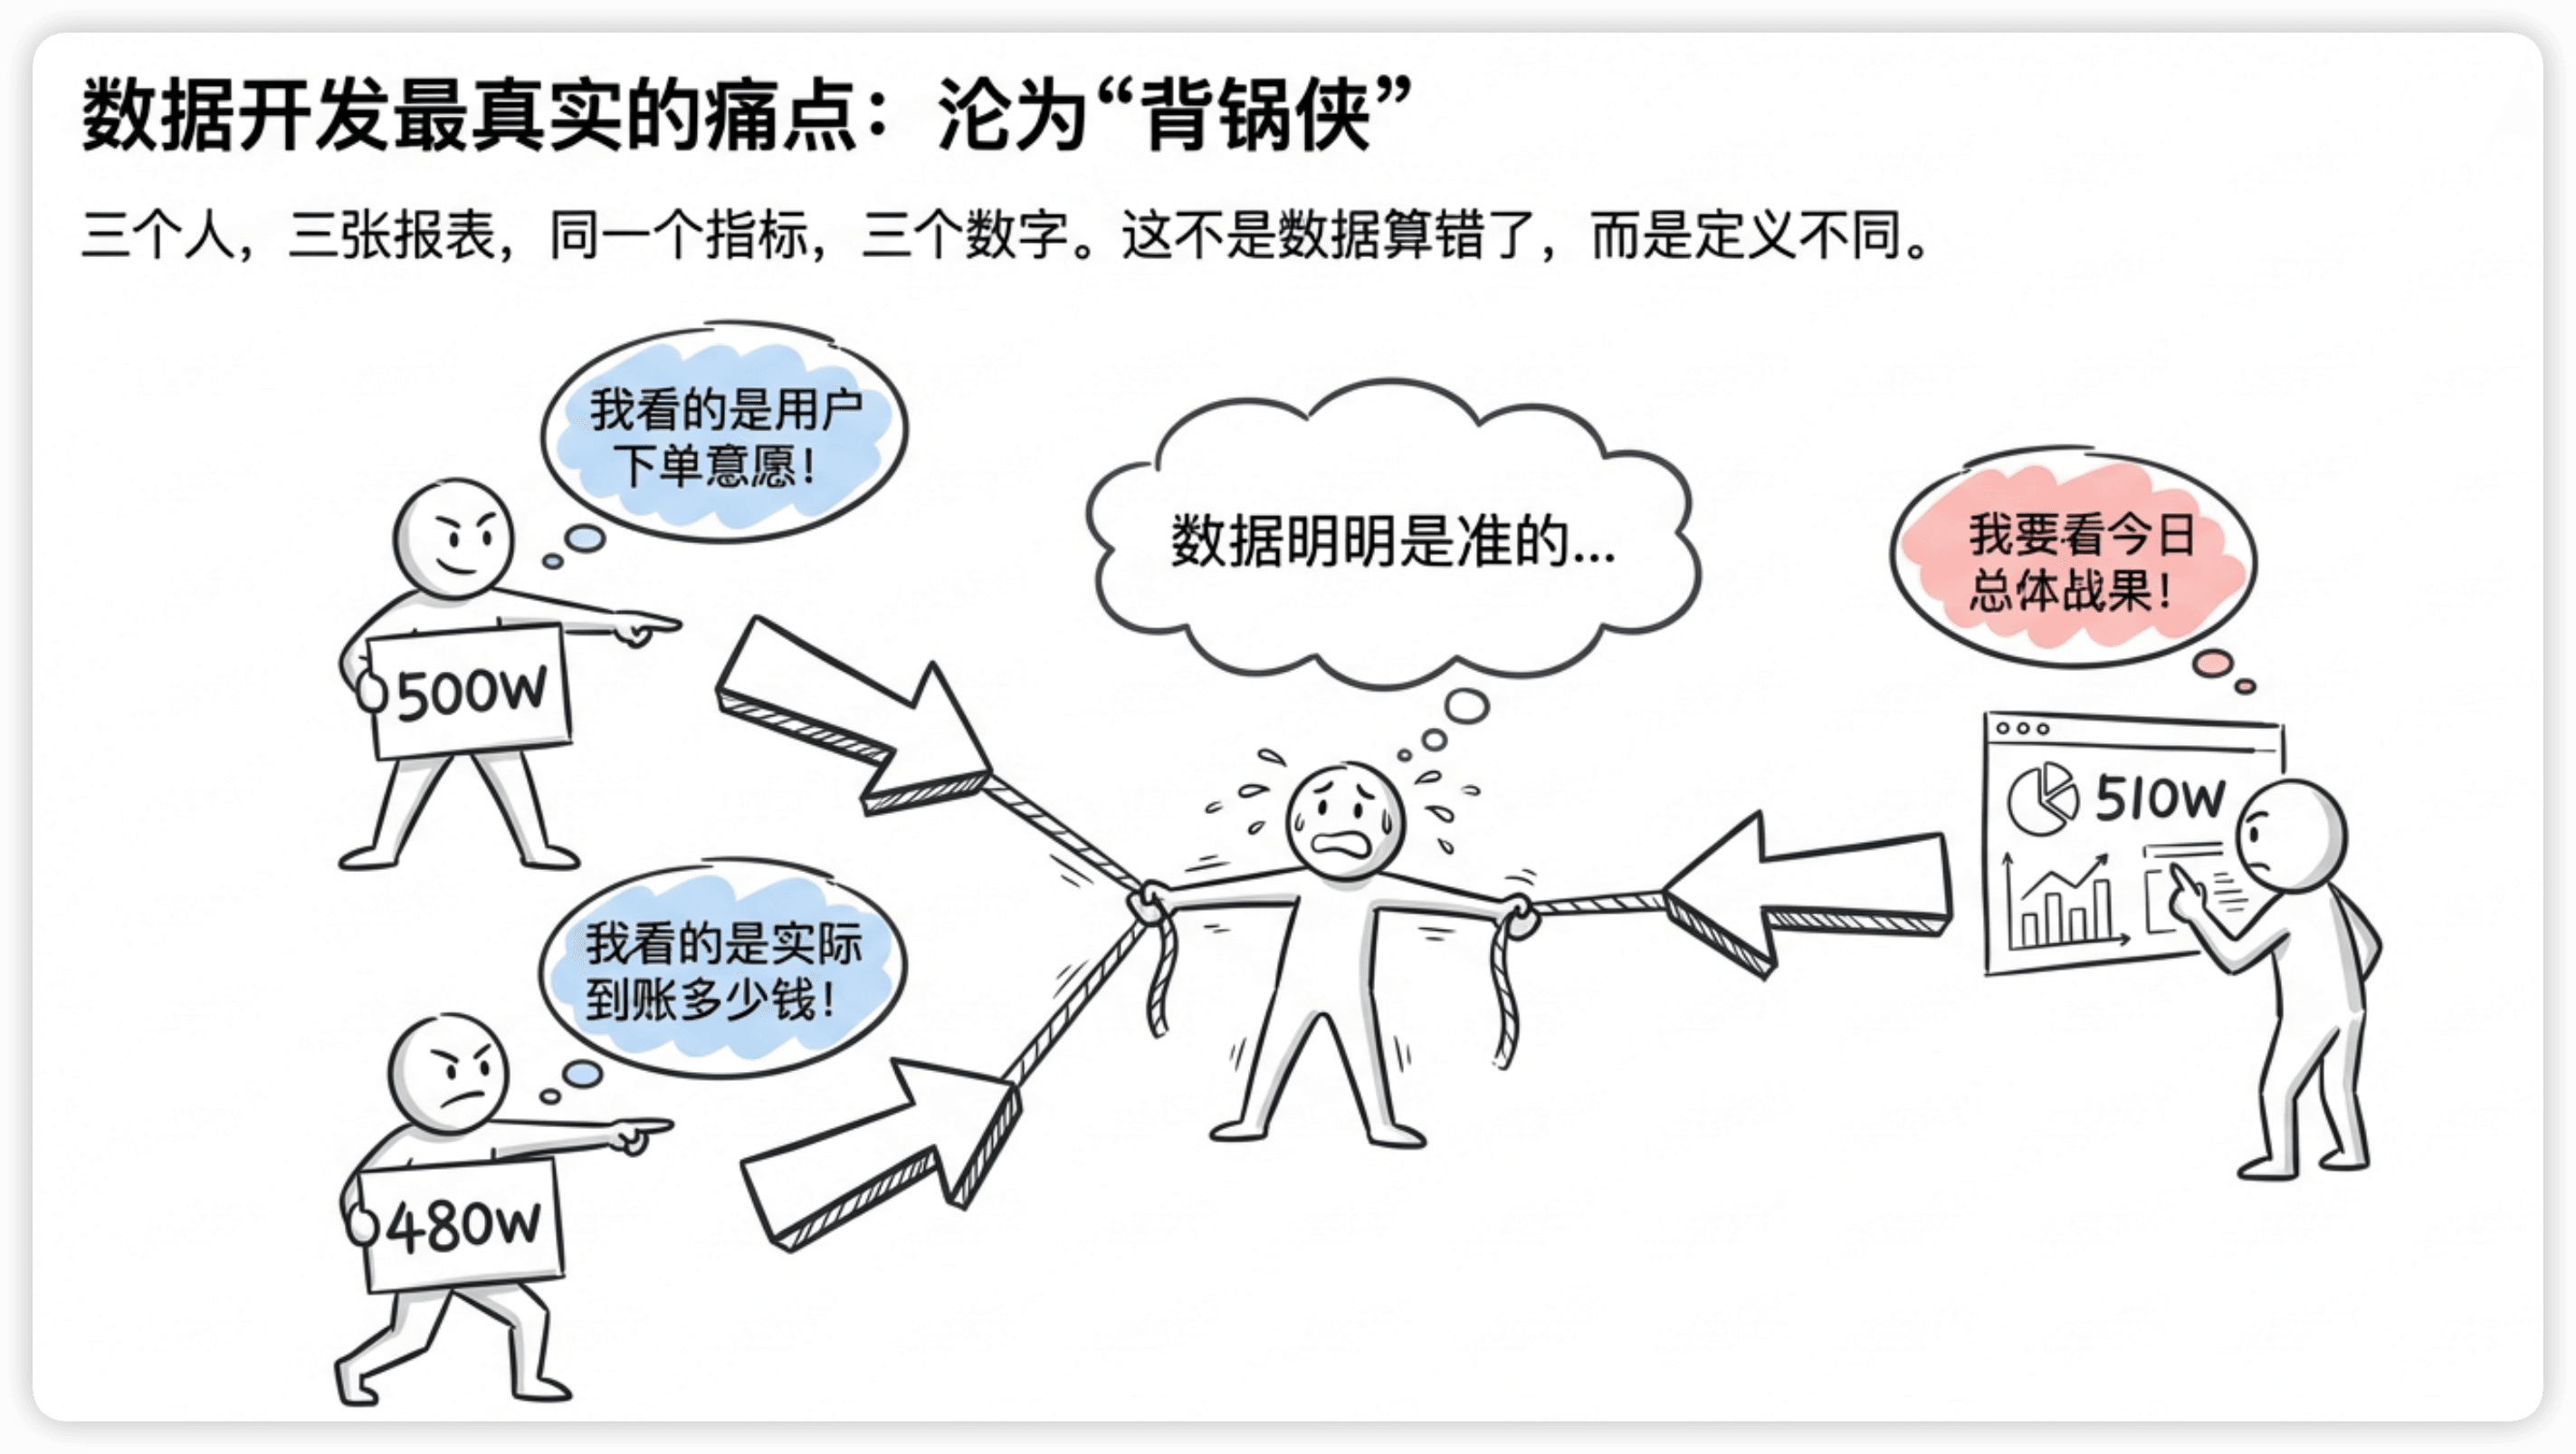
每次遇到这种场景,数据开发就成了背锅侠——"你们的数据到底准不准?"其实数据都是准的,只是每张报表对"GMV"的定义不一样。这就是指标口径不一致,数仓开发最真实、最常见、也最难根治的痛点。
这篇文章我从口径问题的根因讲起,到指标分类体系,到我在实际工作中用过的治理方案,最后给你一个面试高分回答模板。
口径不一致到底是怎么产生的?
先还原一个典型场景。
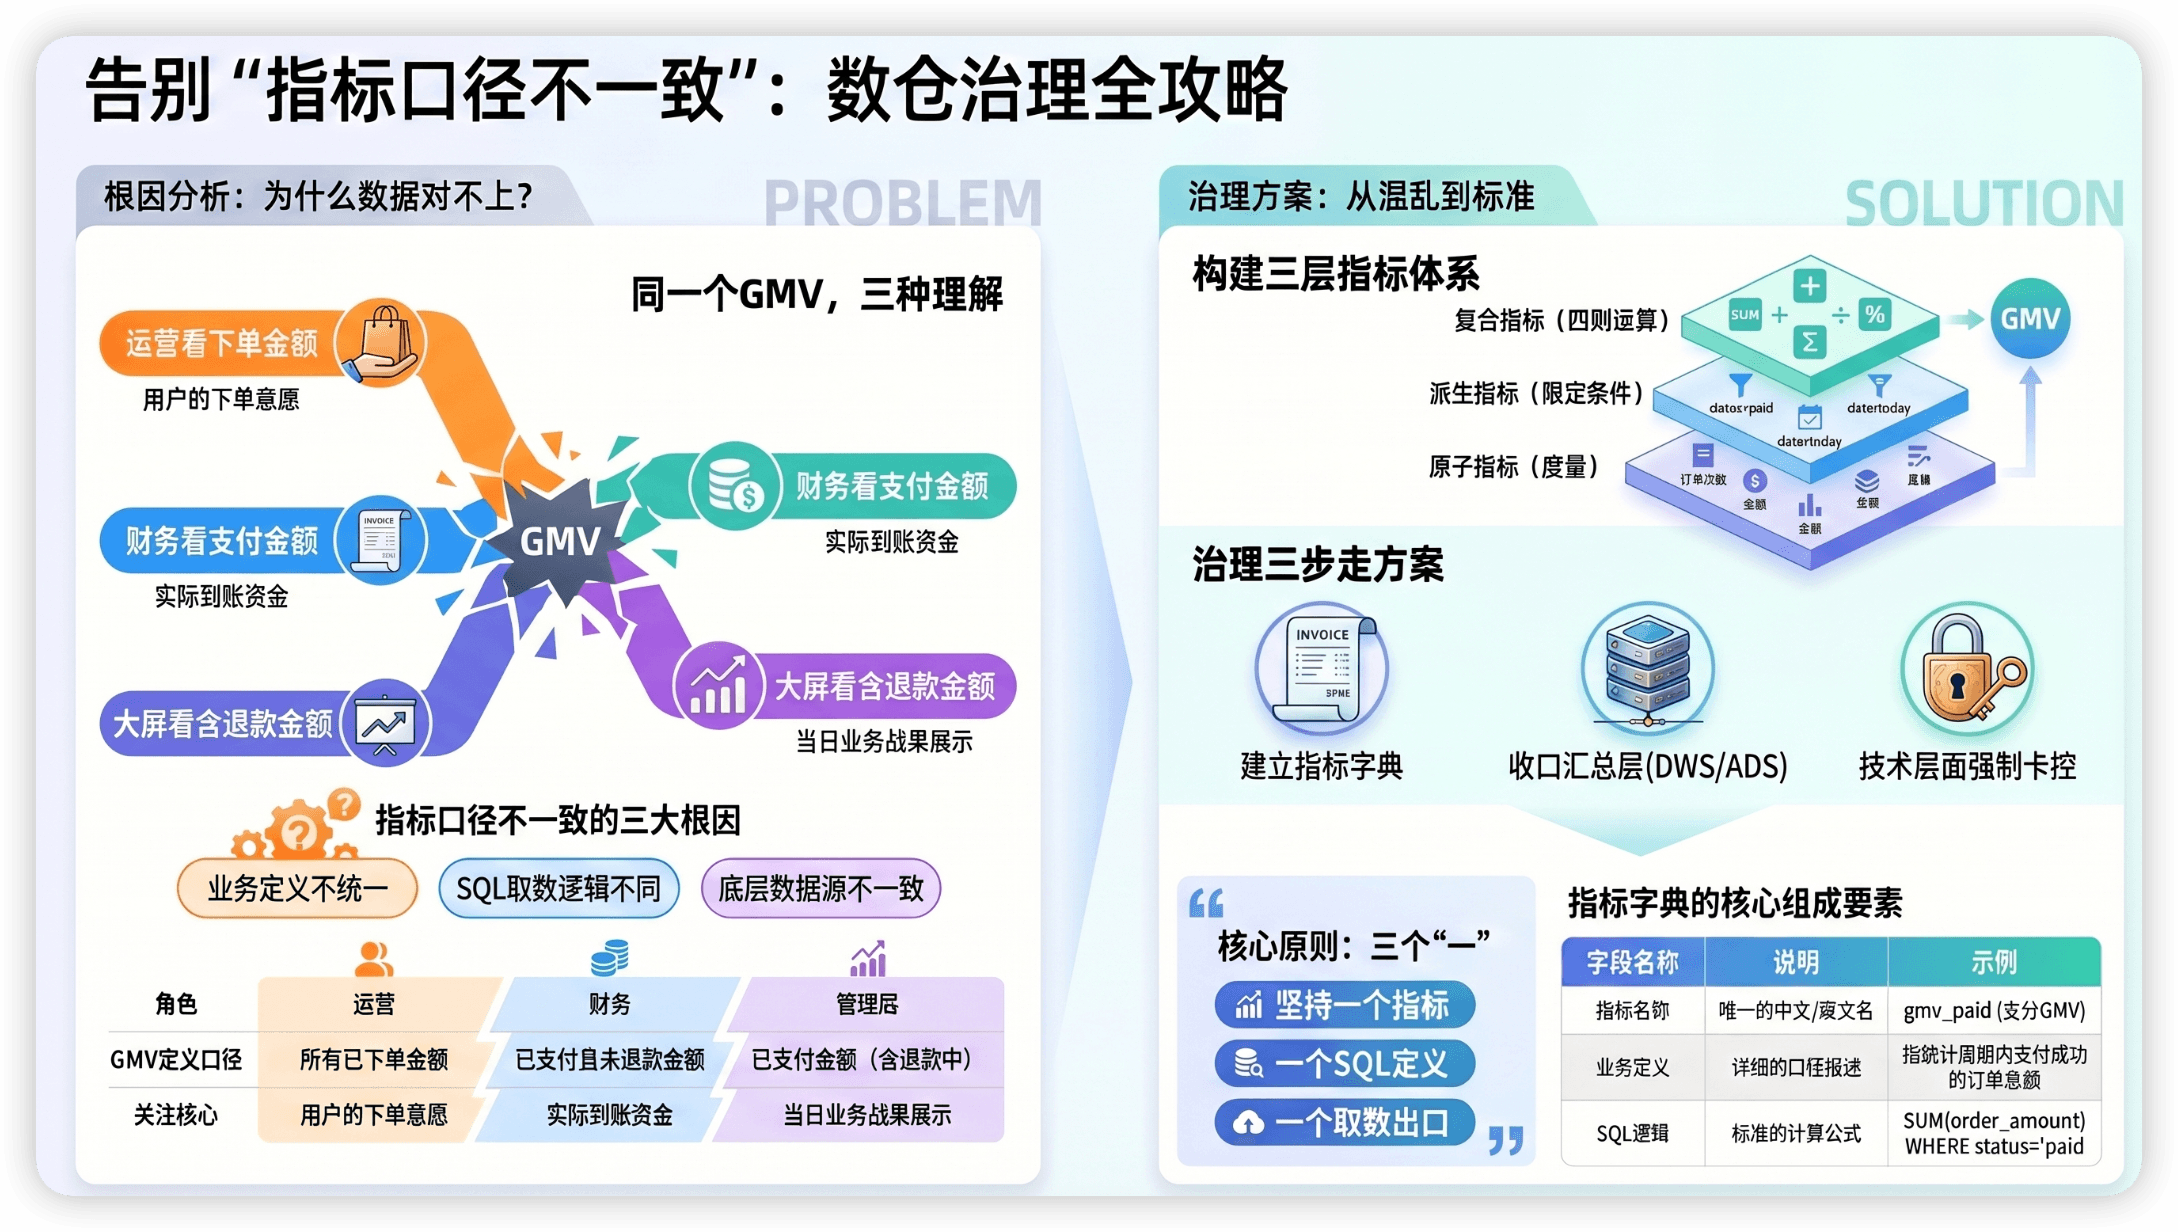
公司有一个"GMV"指标,听起来很明确对吧?但仔细一看,运营、财务、管理层对GMV的理解完全不同:
- 运营的GMV:所有已下单的金额,包含未支付的订单(因为运营关心"用户有下单意愿")
- 财务的GMV:已支付且未退款的金额(因为财务关心"实际到账多少钱")
- 大屏的GMV:已支付金额,包含退款中但尚未完成退款的(因为大屏要展示"当日战果")
三个人都觉得自己的理解是对的,三个开发分别写了三条SQL,三张报表自然三个数字。
口径不一致的根因就三个:
| 根因 | 具体表现 | 后果 |
|---|---|---|
| 定义不统一 | 同一个名字,不同的人有不同的理解 | 开会吵架,数据团队背锅 |
| 取数逻辑不同 | 不同报表各自写SQL,WHERE条件不一样 | 数字永远对不上 |
| 数据源不同 | A报表从DWD取数,B报表从ODS取数 | 清洗口径不同导致差异 |
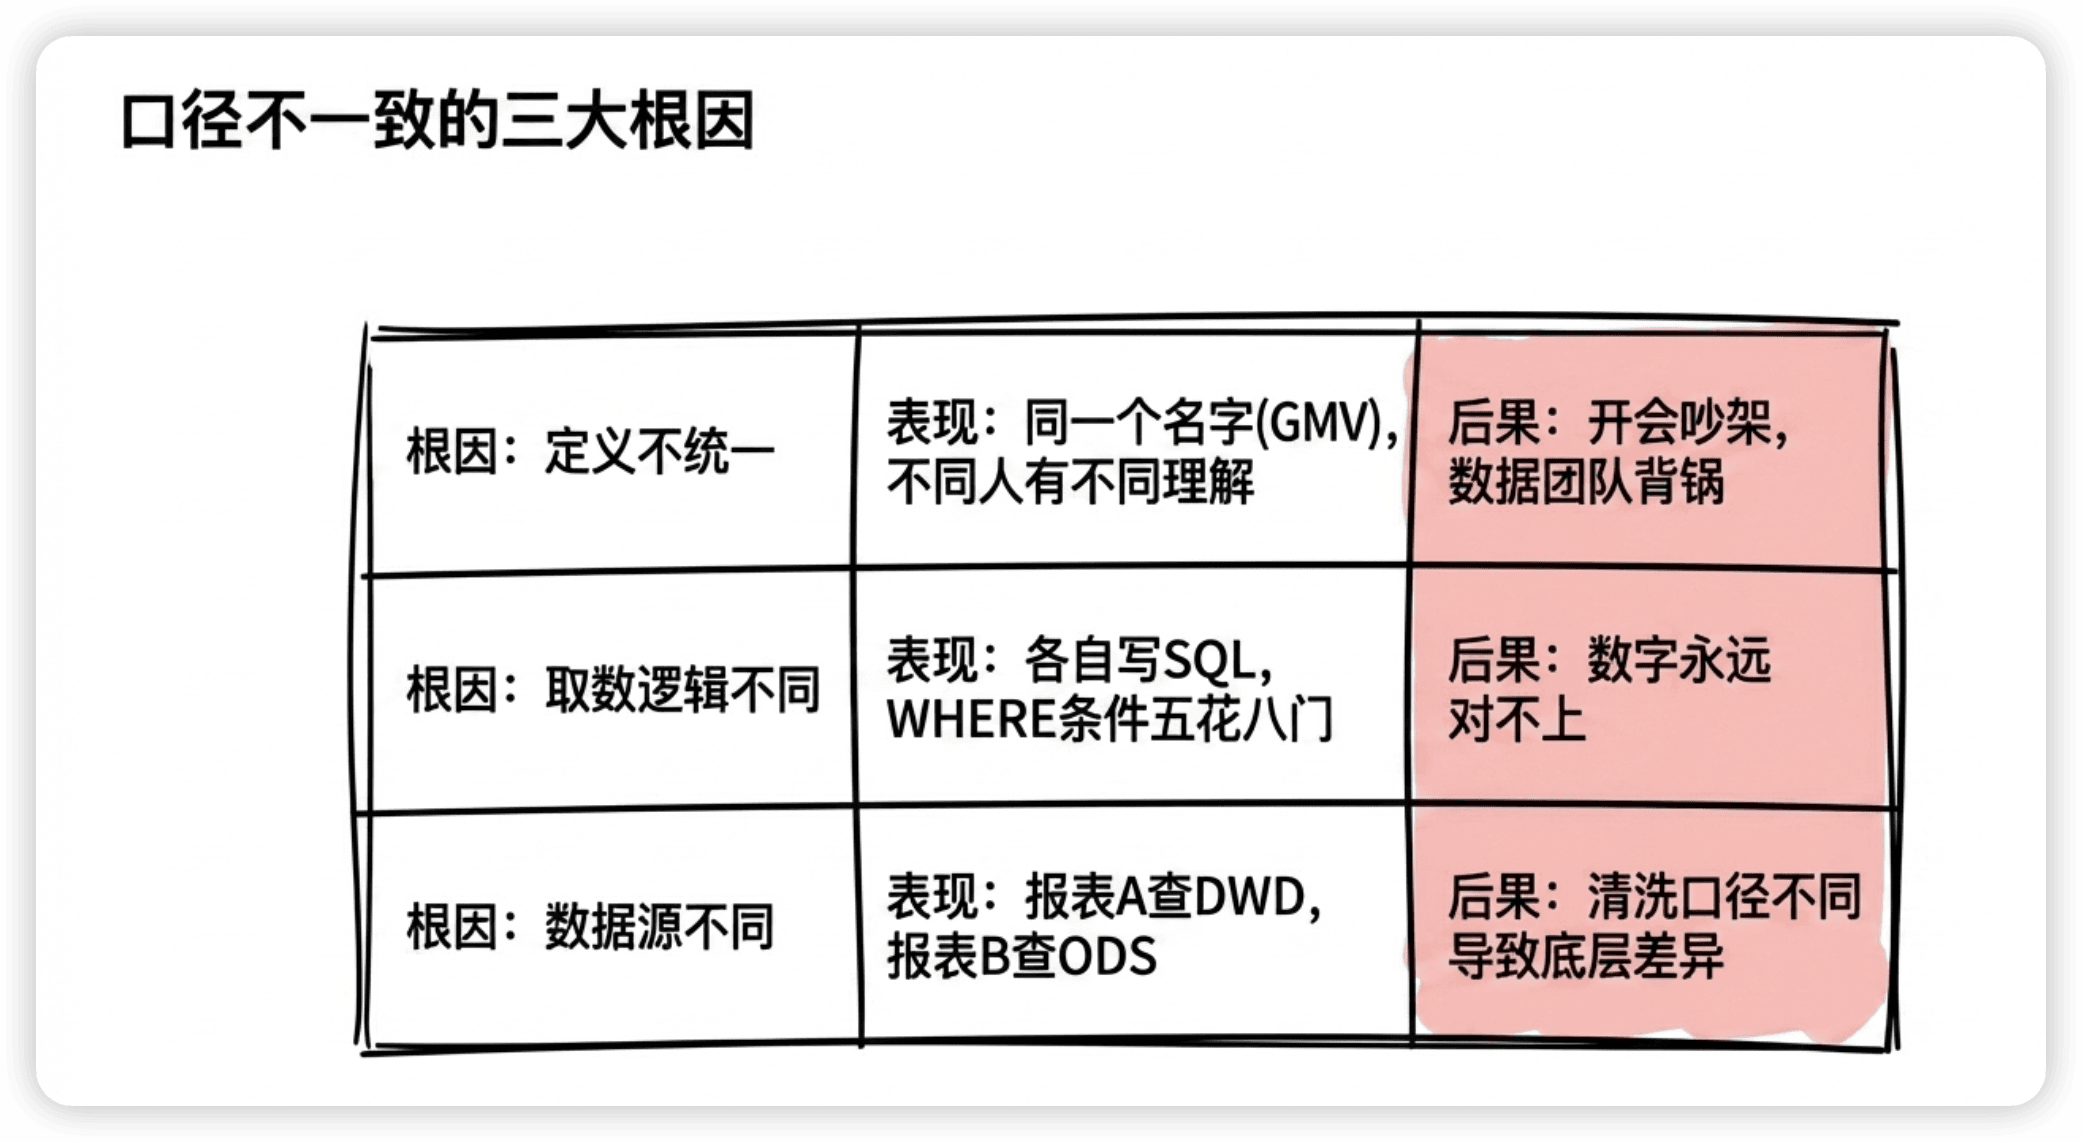 |
这三个问题往往同时存在,而且会随着业务增长越来越严重——报表越多,口径越乱。
指标的分类体系:原子、派生、复合
要治理指标口径,首先要有一套清晰的分类体系。Kimball体系里把指标分为三层:
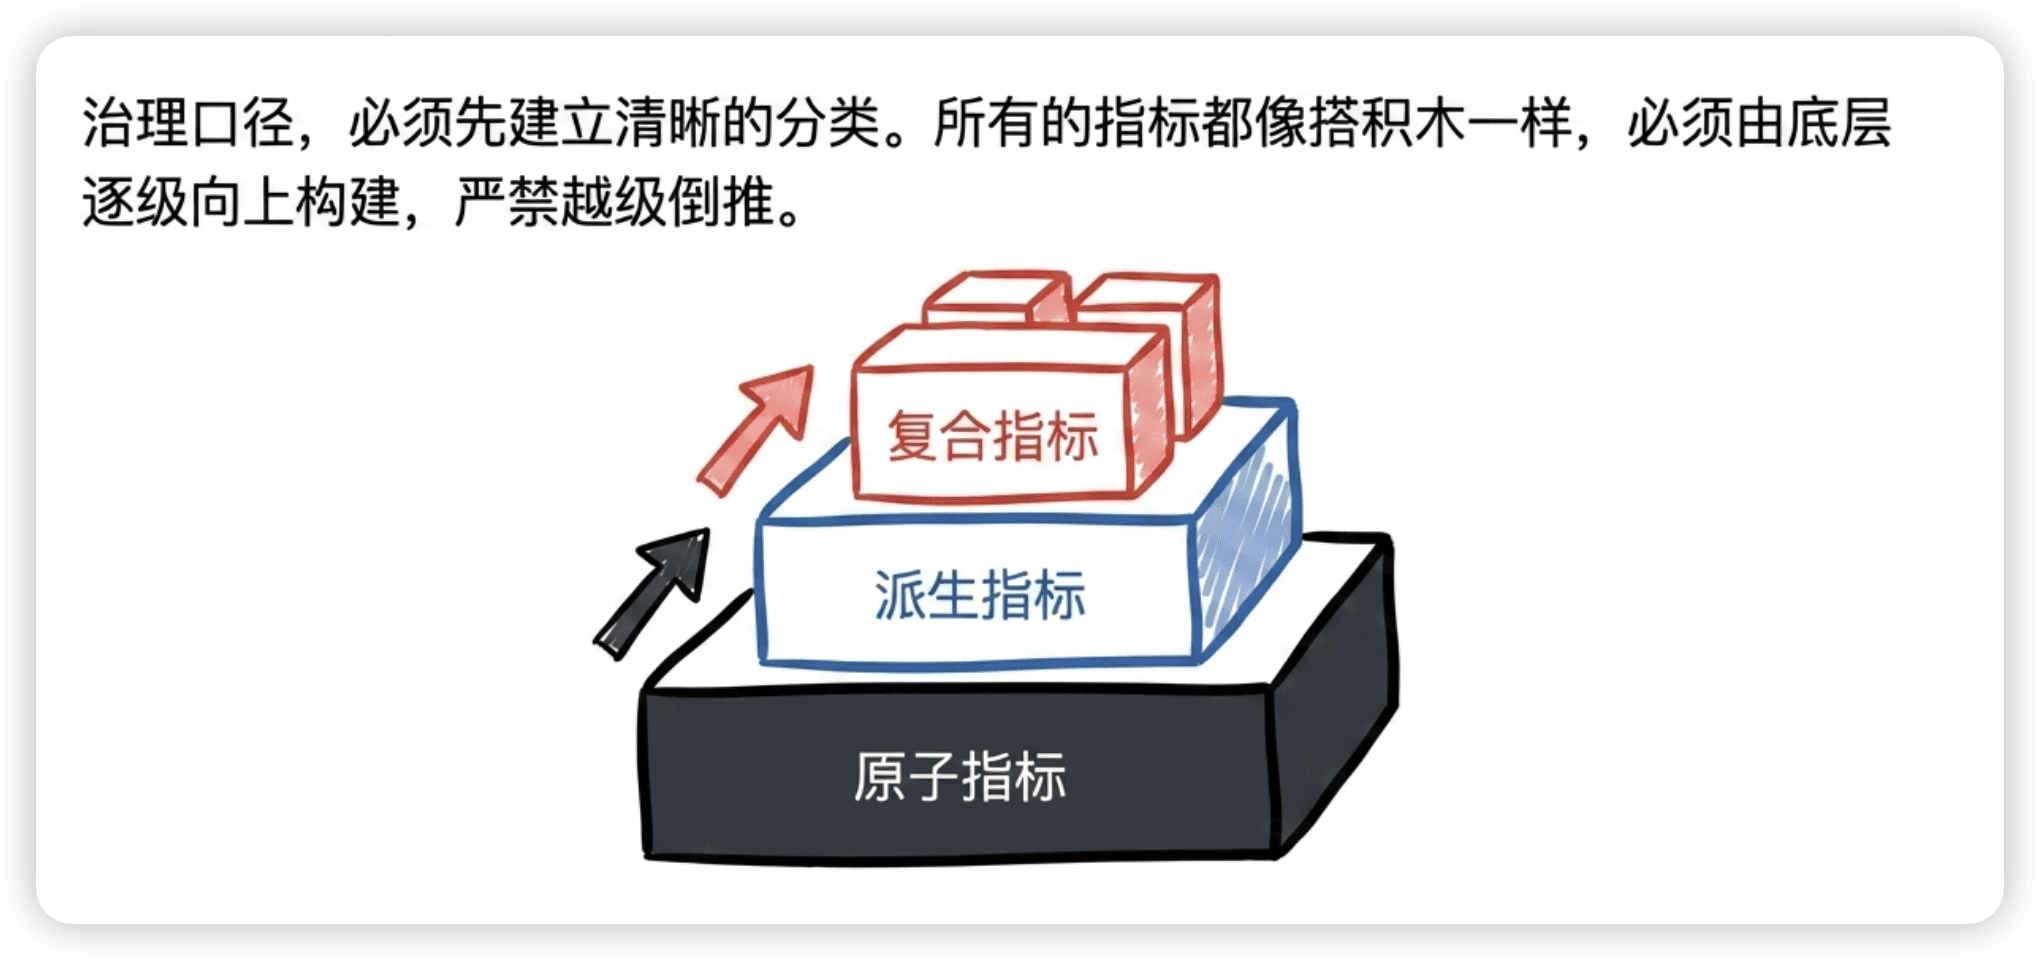
原子指标:最底层的度量
原子指标是不可再拆分的、最基础的度量。它由一个度量字段 + 聚合方式组成,没有任何业务限定条件。
-- 原子指标示例
订单金额   = SUM(order_amount)
下单用户数 = COUNT(DISTINCT user_id)
支付次数   = COUNT(pay_id)
播放时长 = SUM(play_duration)原子指标是口径一致性的基石。一旦原子指标的SQL定义确定了,所有基于它的派生指标就有了统一的起点。
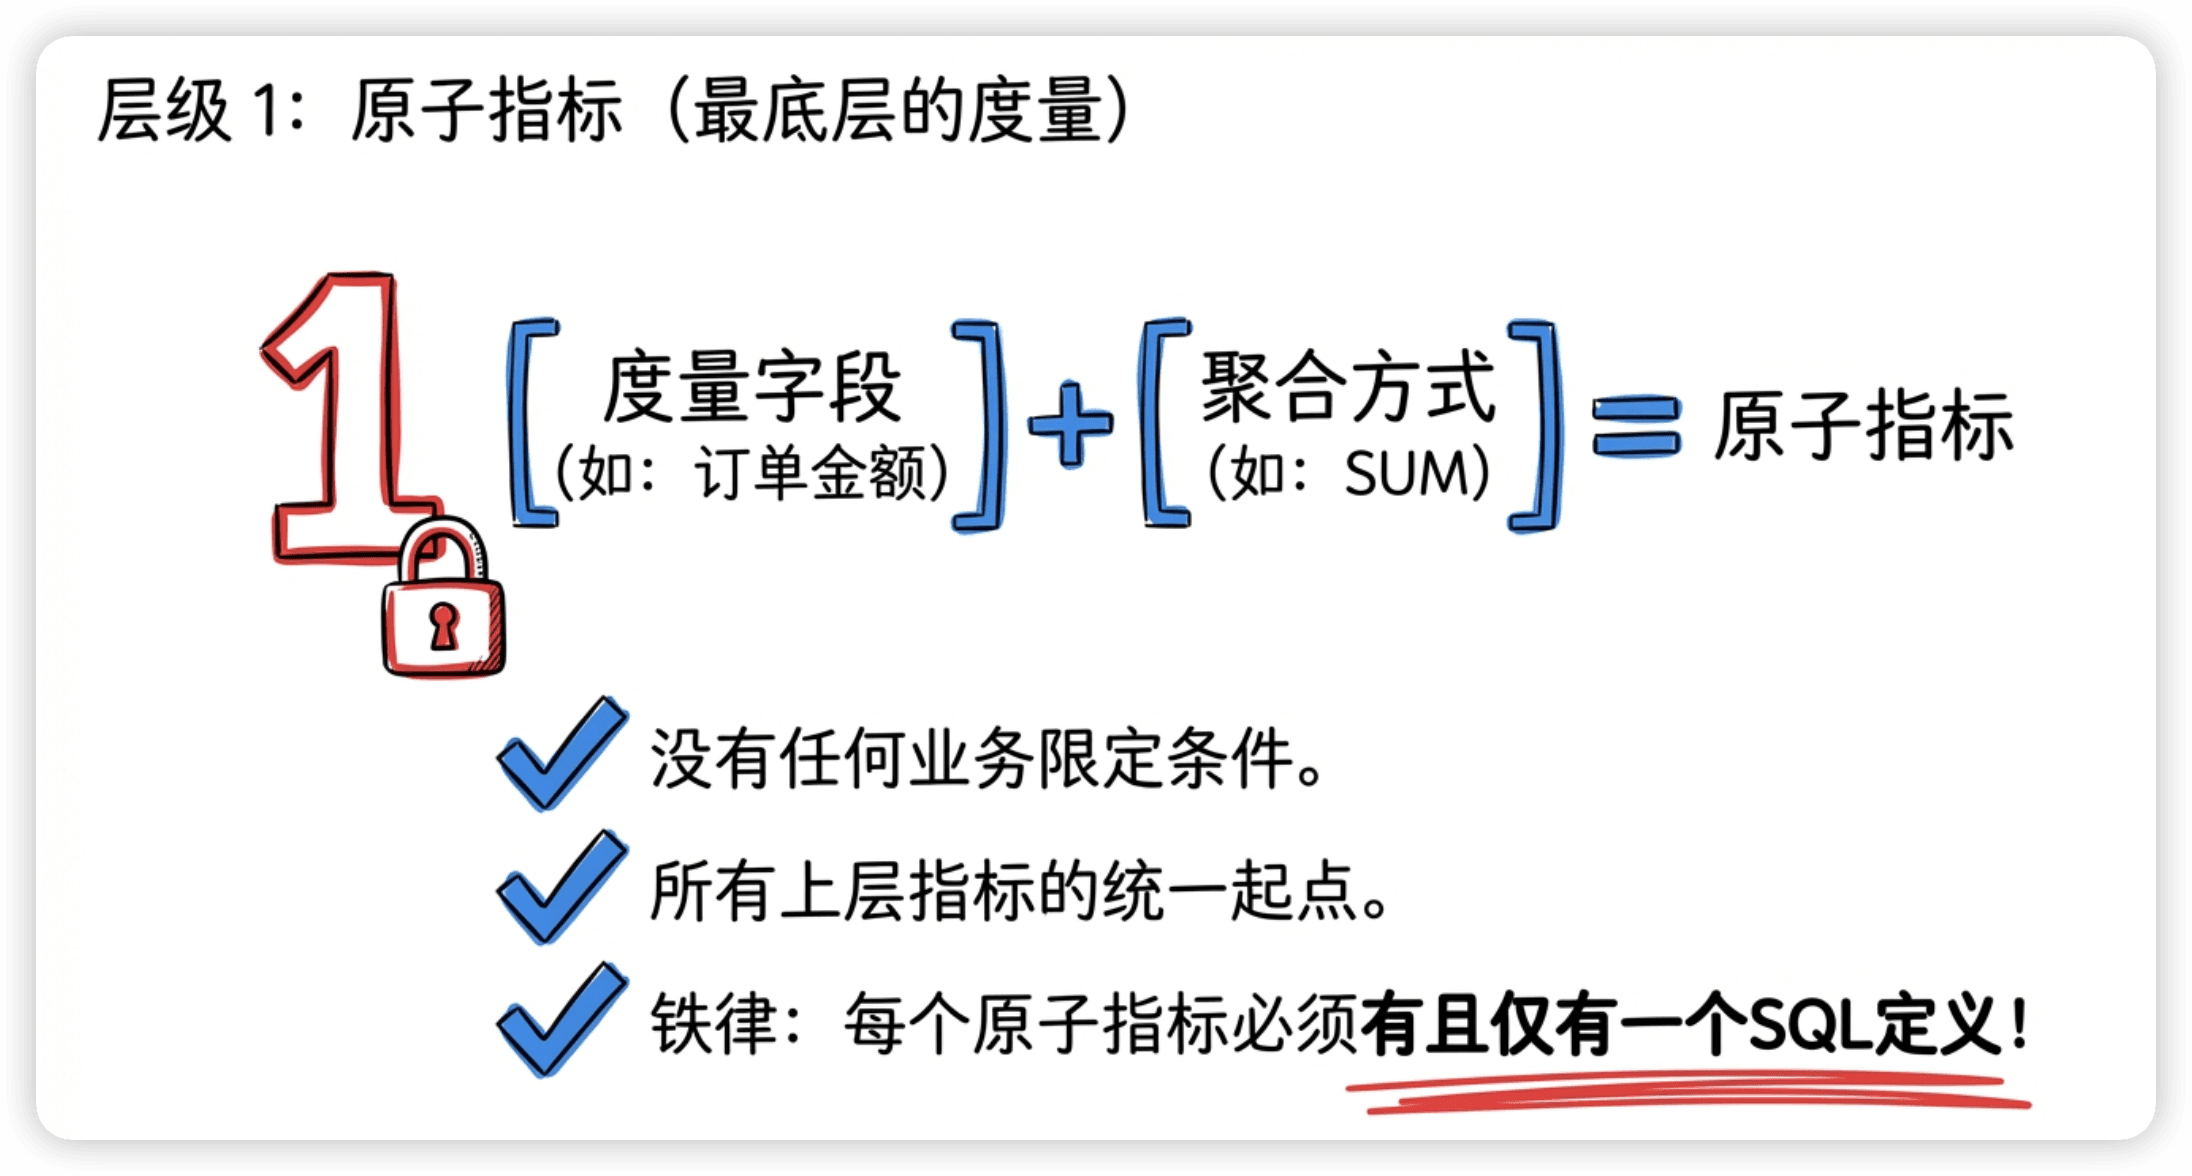
关键规则:每个原子指标必须有且仅有一个SQL定义。如果出现了两个不同的SQL都叫"订单金额",问题就从这里开始了。
派生指标:原子指标 + 限定条件
在原子指标上加上时间范围、业务过滤条件、维度限定,就变成了派生指标。
-- 派生指标示例
近7日支付GMV     = SUM(pay_amount) WHERE dt >= T-7 AND status = 'paid'
新客首单金额     = SUM(order_amount) WHERE is_new_user = 1 AND order_rank = 1
日本地区DAU     = COUNT(DISTINCT user_id) WHERE region = 'jp' AND is_active = 1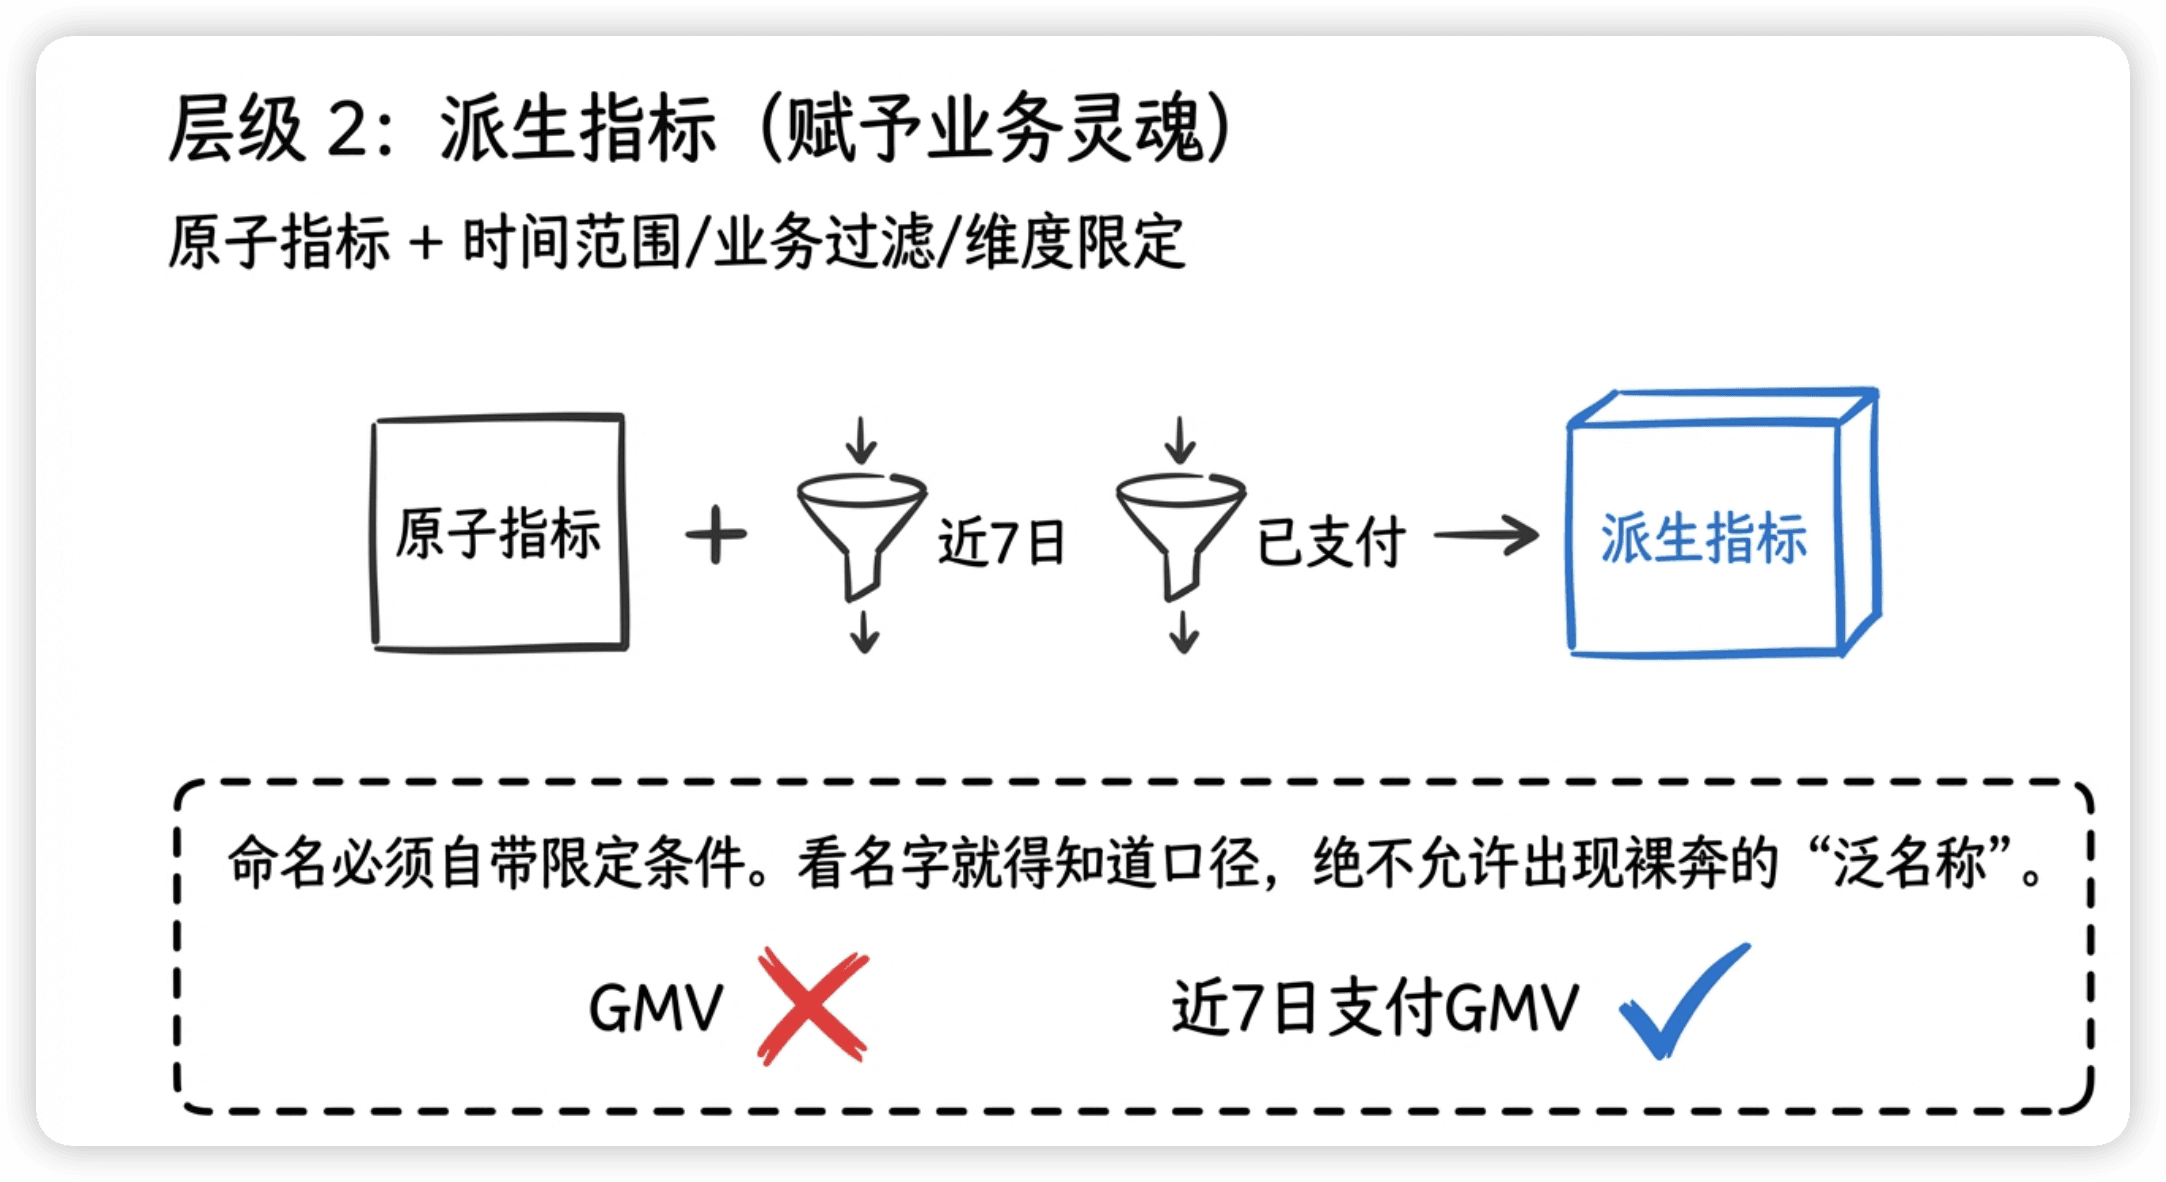
派生指标的命名必须自带限定条件,让人一看名字就知道口径。比如不能只叫"GMV",要叫"近7日支付GMV"或"当日下单GMV"——名字里就把口径说清楚了。
复合指标:多个指标的运算
两个及以上指标做四则运算,得到的就是复合指标。
-- 复合指标示例
客单价   = 支付GMV / 支付用户数
转化率   = 支付用户数 / 访问用户数
ROI     = 归因收入 / 广告花费
ARPU    = 总收入 / DAU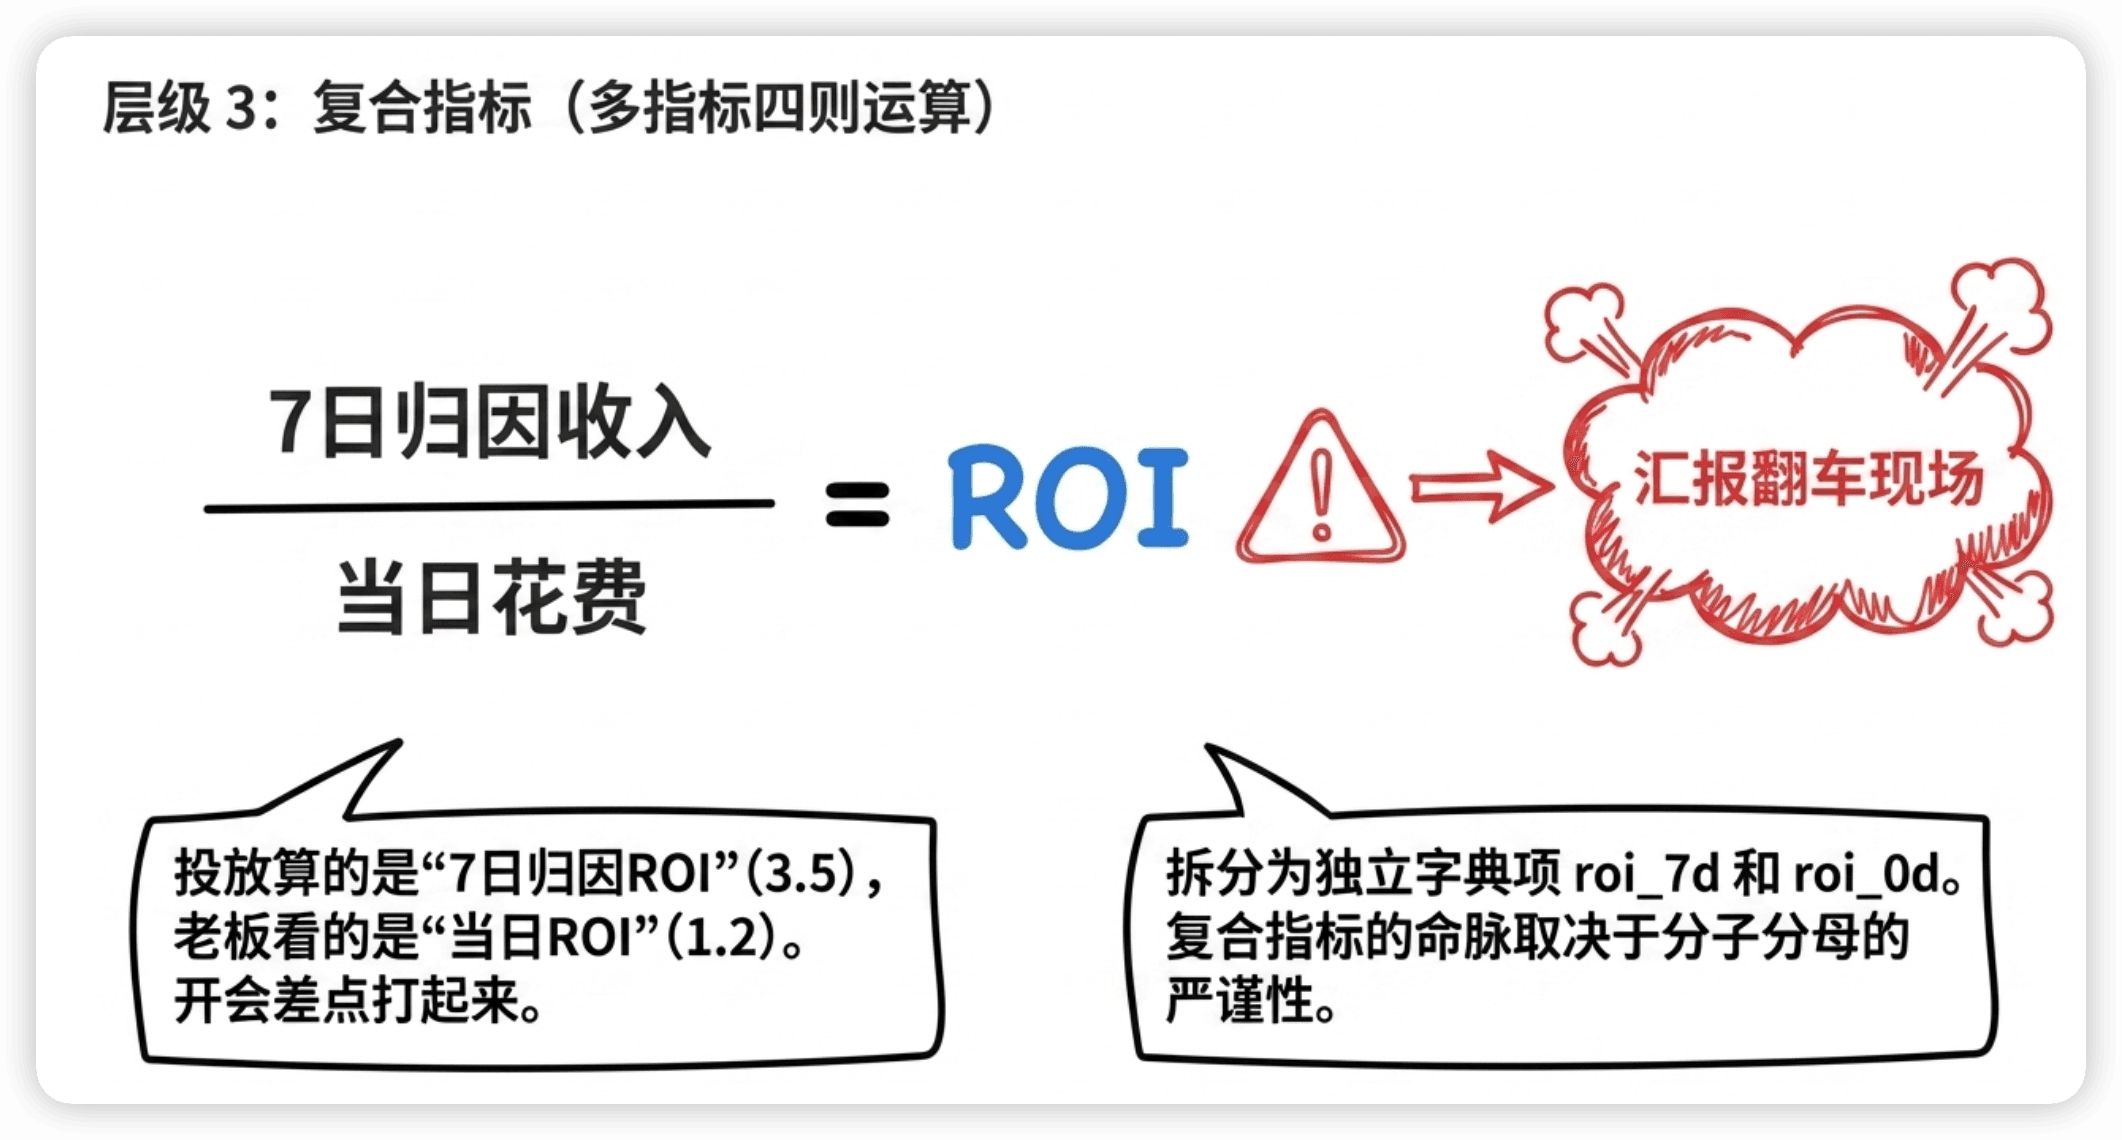
复合指标的口径取决于分子和分母各自的口径。如果分子用的是"7日归因收入",分母用的是"当日花费",那这个ROI就是"7日归因ROI",不能笼统地叫"ROI"。
我在做广告归因的时候,ROI这个指标就出过大问题。投放团队算的ROI用的是"7日归因收入÷当日花费",管理层看的是"当日收入÷当日花费"。归因窗口不同,两个ROI差了3倍。开会的时候投放说"ROI是3.5,投放效果很好",管理层说"我看ROI才1.2,什么情况?"差点吵起来。
后来我把ROI拆成了两个独立指标:
roi_7d(7日归因ROI)和roi_0d(当日ROI),各自在指标字典里有明确的定义和SQL,报表上也标清楚看的是哪个口径。问题就彻底解了。
口径治理的完整方案
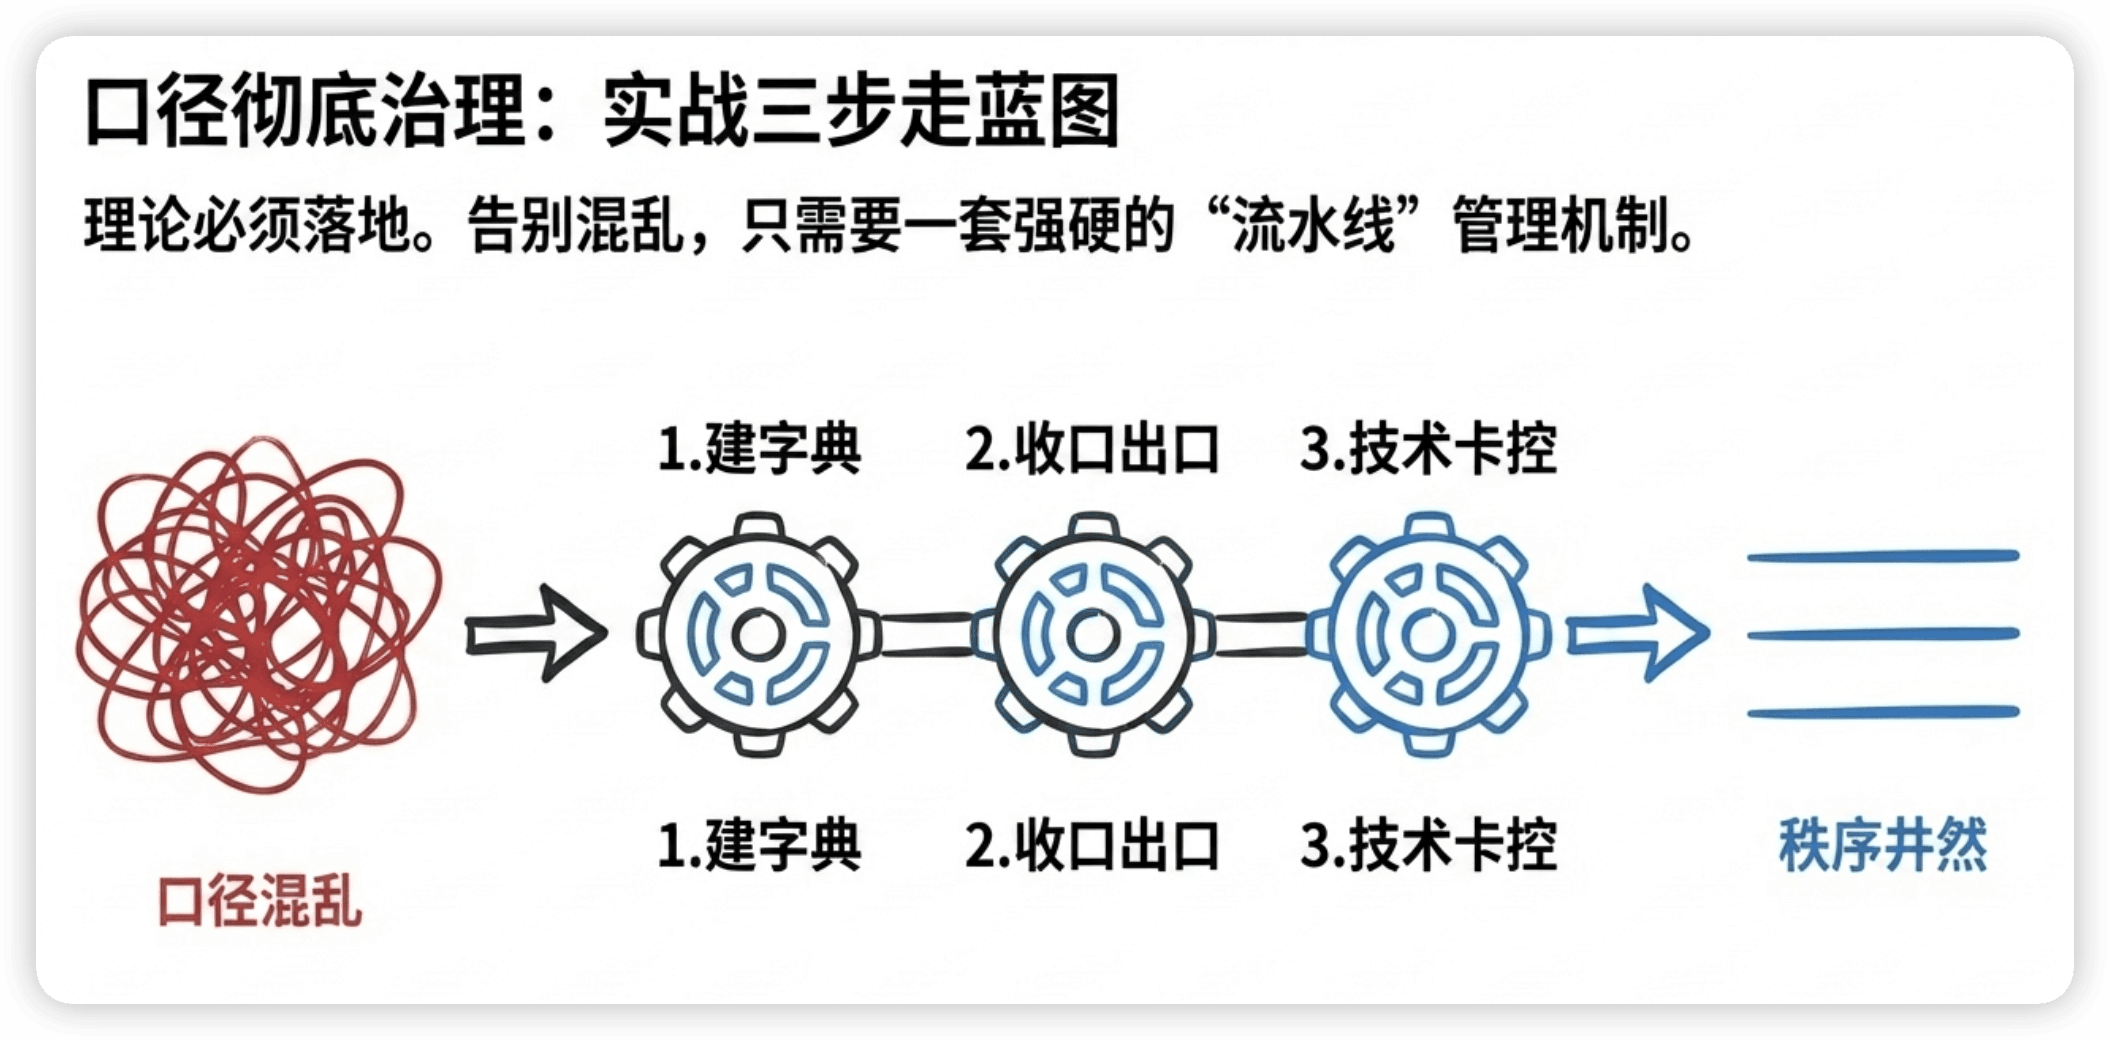
第一步:建指标字典
指标字典是治理的基础。每个指标必须有一张"身份证",包含以下信息:
指标名称(中文):7日支付GMV
指标名称(英文):gmv_paid_7d
业务定义:最近7个自然日内,状态为"已支付"的订单实付金额总和
计算逻辑:SUM(pay_amount) WHERE status = 'paid' AND dt BETWEEN T-7 AND T
所属主题域:交易域
数据来源表:dws_trade_order_summary_1d
指标类型:派生指标(原子指标"支付金额" + 时间限定"近7日")
负责人:Wood
创建时间:2025-01-01
最后修改时间:2025-01-01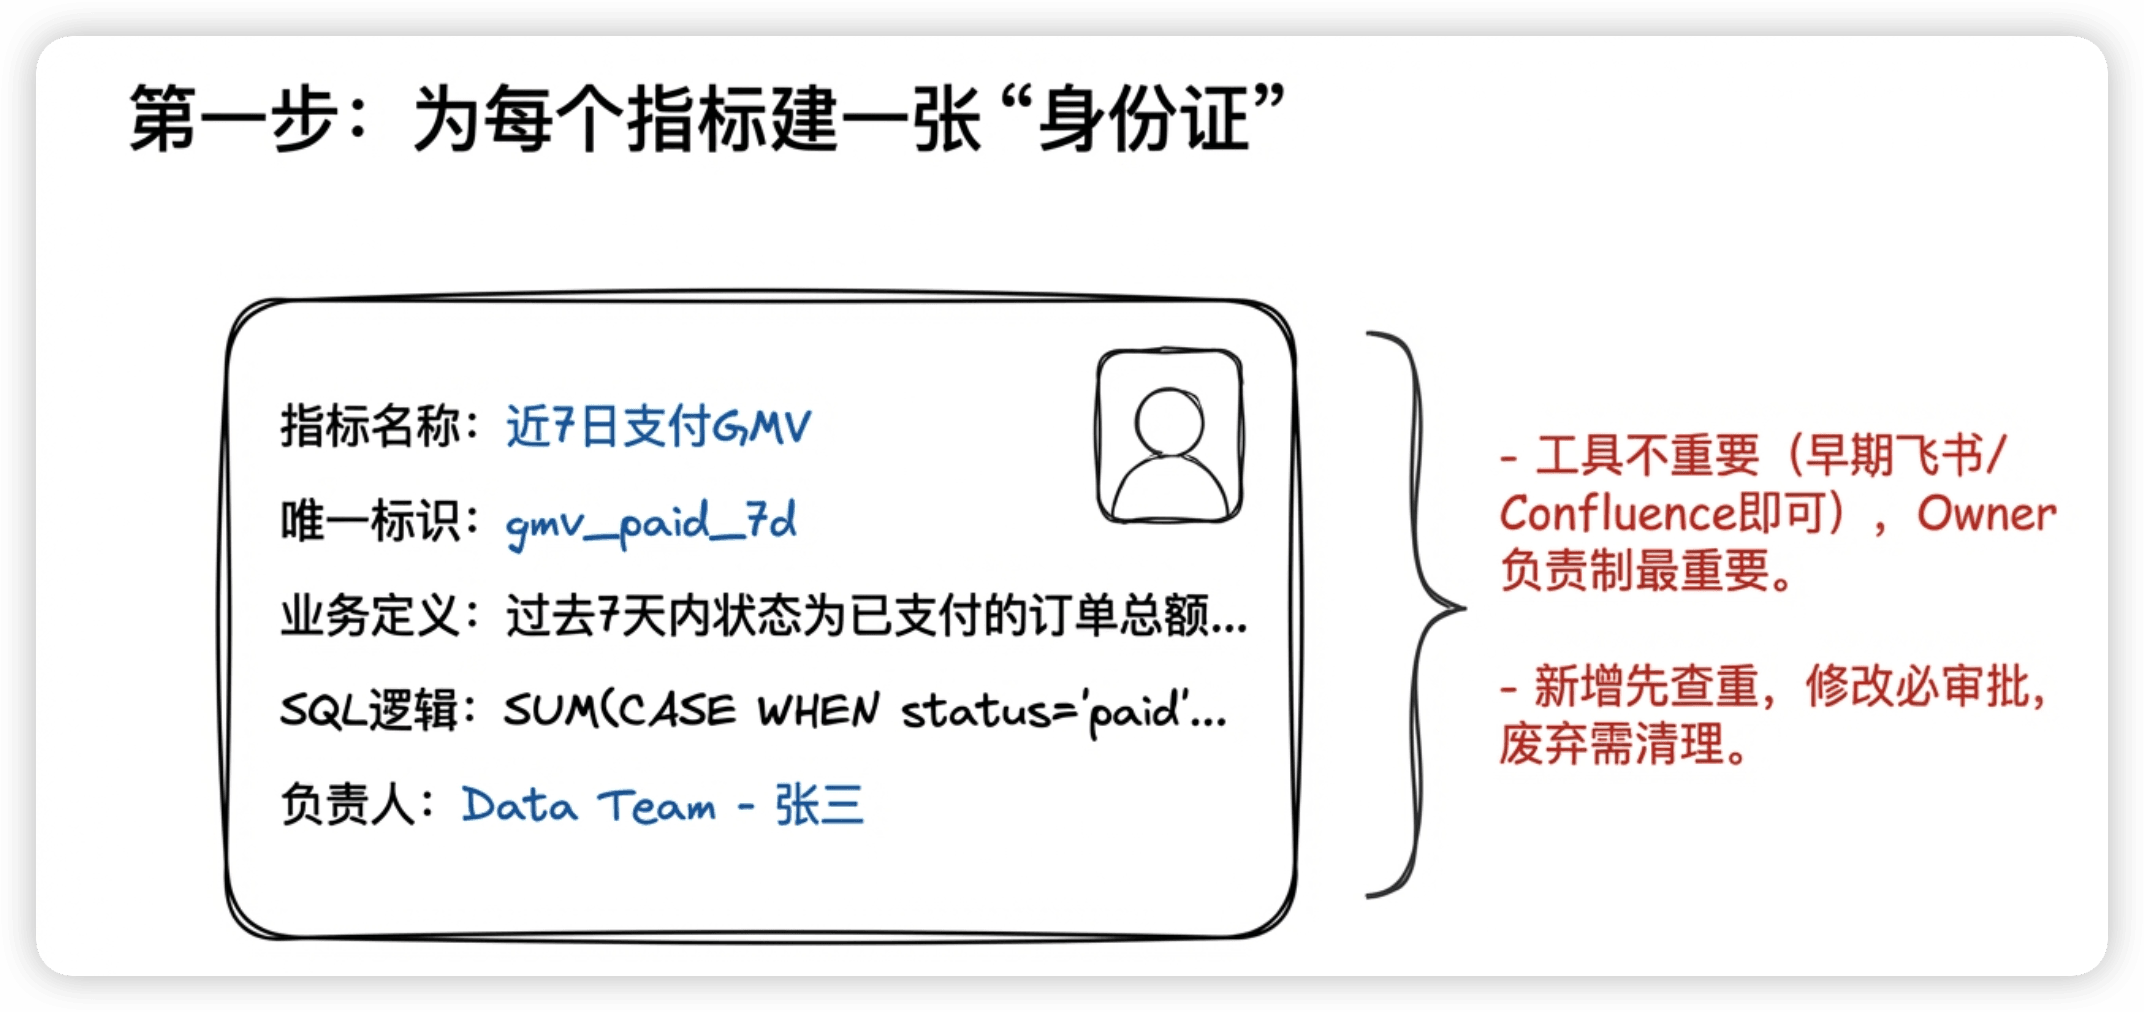
指标字典不需要很复杂的系统,初期用一个飞书/Confluence文档 + 表格就够了。关键是每个指标有唯一定义,而且有人负责维护。
指标字典的维护规则:
- 新增指标必须先查字典,确认没有已存在的同义指标
- 修改指标定义需要走审批,所有下游报表负责人需知晓
- 定期Review,清理不再使用的废弃指标
第二步:收口汇总层
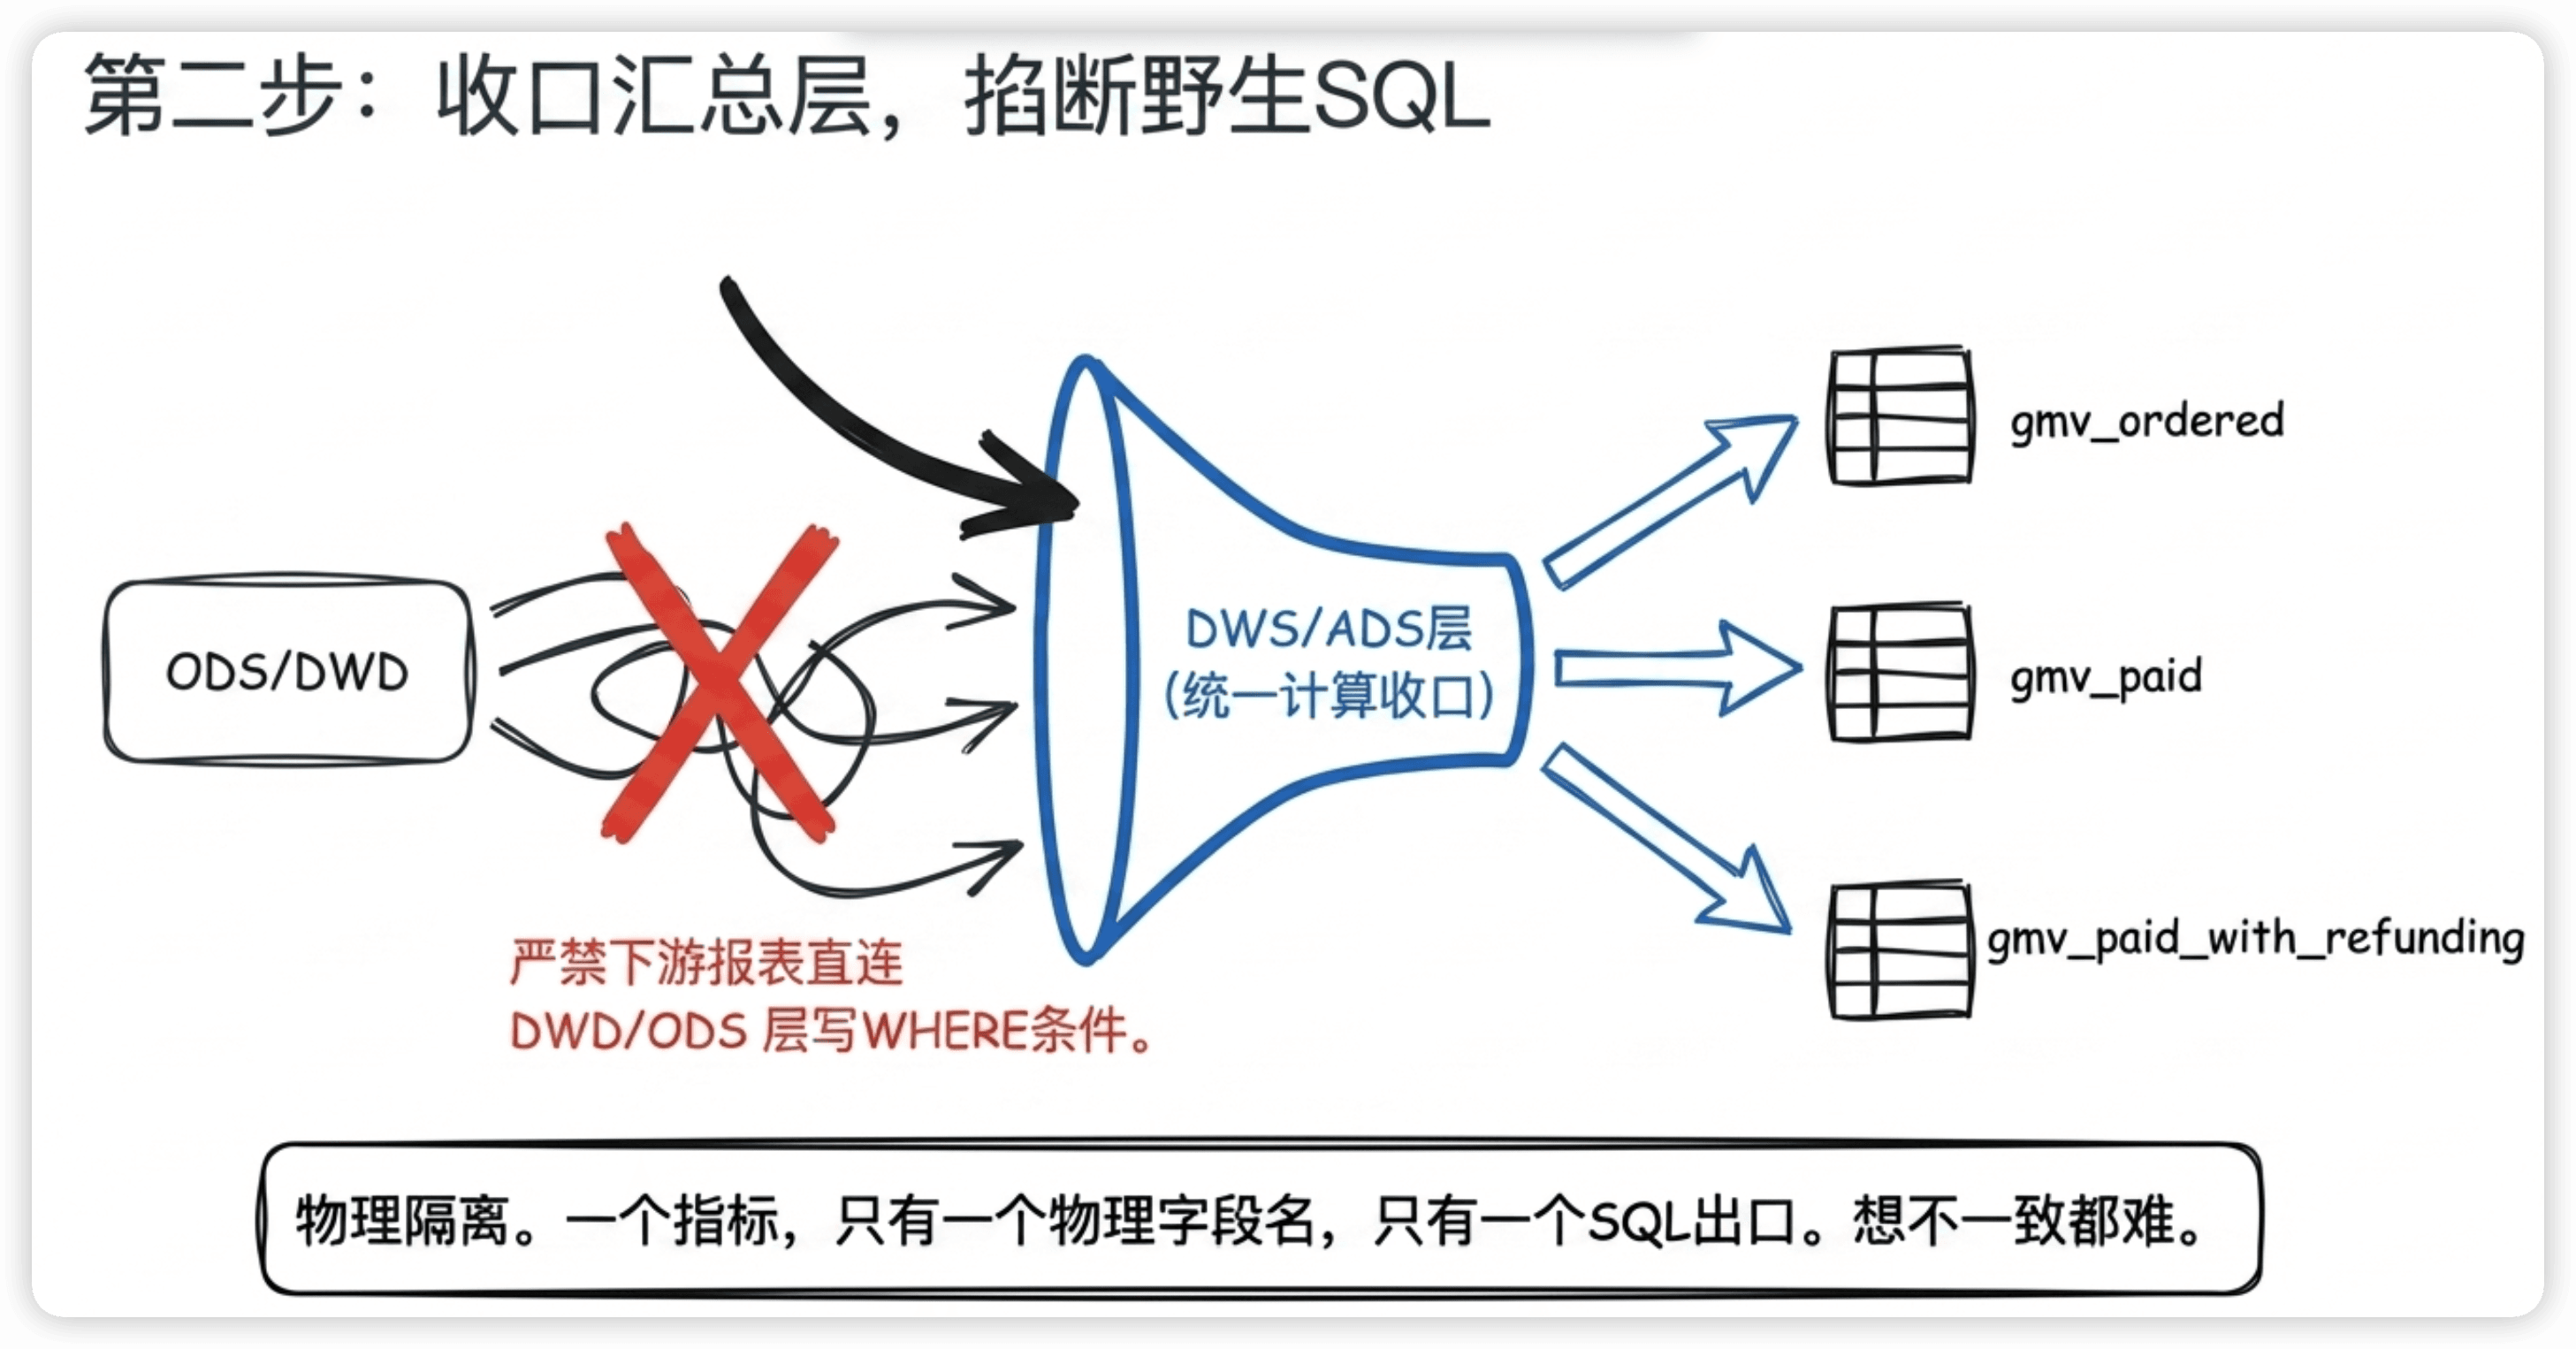
有了指标字典还不够——你定义了"支付GMV"的SQL是什么,但如果10个报表开发者各自写SQL去查DWD层,依然可能写出不同的WHERE条件。
解决方案是收口:所有指标的计算逻辑统一在DWS/ADS层完成,下游报表只能从DWS/ADS取数,不允许直接查DWD/ODS。
❌ 散乱模式(口径不一致的温床):
  报表A: SELECT SUM(amount) FROM dwd_order WHERE status IN ('paid','refunding') ...
  报表B: SELECT SUM(pay_amount) FROM ods_pay WHERE ...
  报表C: SELECT SUM(total) FROM dwd_order_detail WHERE is_paid = 1 ...
  → 三个报表三条SQL,三个数字

✅ 收口模式(口径统一):
  DWS层:把 gmv_paid、gmv_ordered 等指标提前算好存在汇总表
  报表A/B/C统一: SELECT gmv_paid FROM ads_trade_daily_report WHERE dt = ...
→ 所有报表同一个数字一个指标只有一个SQL出口,口径想不一致都难。
具体实现:
-- DWS层:指标汇总表(所有核心指标在这里统一计算)
CREATE TABLE dws_trade_metrics_1d AS
SELECT
    dt,
    region,
    -- 下单GMV(含未支付)
    SUM(order_amount) AS gmv_ordered,
    -- 支付GMV(已支付,不含退款)
    SUM(CASE WHEN status = 'paid' THEN pay_amount ELSE 0 END) AS gmv_paid,
    -- 支付GMV(含退款中)
    SUM(CASE WHEN status IN ('paid','refunding') THEN pay_amount ELSE 0 END) AS gmv_paid_with_refunding,
    -- 下单用户数
    COUNT(DISTINCT user_id) AS order_user_cnt,
    -- 支付用户数
    COUNT(DISTINCT CASE WHEN status = 'paid' THEN user_id END) AS pay_user_cnt
FROM dwd_trade_order_detail_di
WHERE dt = '${bizdate}'
GROUP BY dt, region;注意看:三种"GMV"在同一张表里各自有明确的字段名——gmv_ordered、gmv_paid、gmv_paid_with_refunding。运营看gmv_ordered,财务看gmv_paid,大屏看gmv_paid_with_refunding。名字不同,不会混淆。
第三步:技术层面卡控
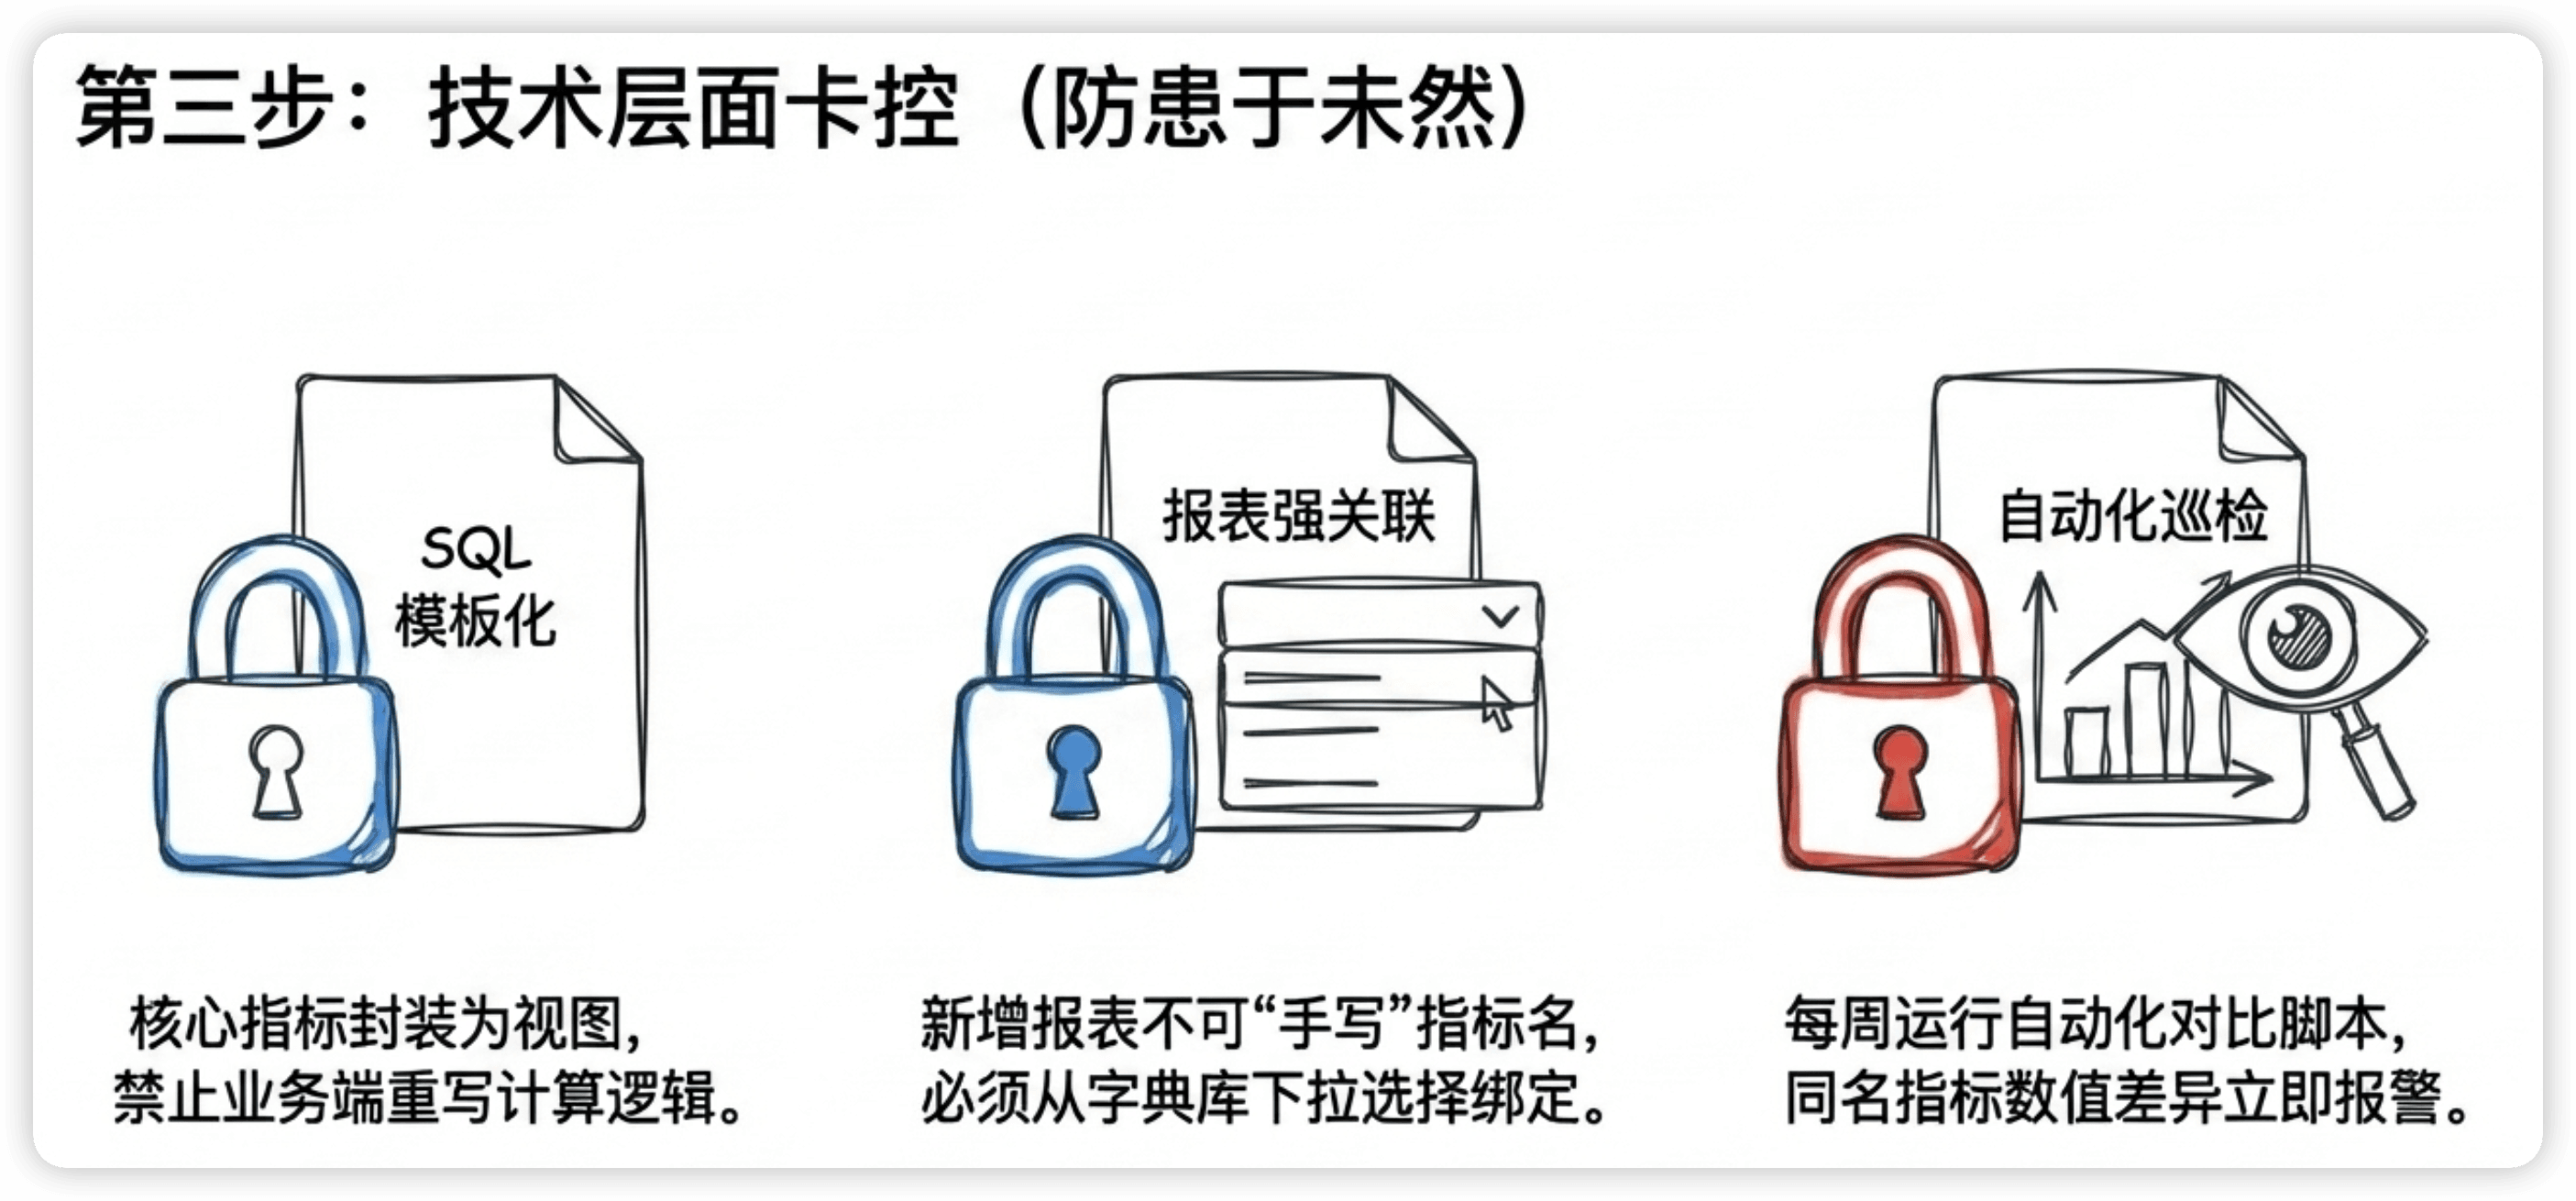
光靠制度和规范还不够,要用技术手段来"卡":
① 指标SQL模板化
核心指标的SQL写成模板/视图,变更需要走审批流程。不允许开发者在报表里自己重写指标计算逻辑。
-- 方式一:用视图封装指标口径
CREATE VIEW v_gmv_paid AS
SELECT dt, region, SUM(pay_amount) AS gmv_paid
FROM dwd_trade_order_detail_di
WHERE status = 'paid'
GROUP BY dt, region;

-- 下游直接查视图,不碰原表
SELECT * FROM v_gmv_paid WHERE dt = '2025-01-15';
② 新增报表必须关联已有指标
报表开发需求单里要填写"使用了哪些指标",必须从指标字典里选择,不能自己造。如果现有指标不满足需求,先走指标新增流程。
③ 定期巡检
每周跑一次自动化对比脚本,检查不同报表中同名指标的数值是否一致:
-- 自动化巡检:对比不同报表的GMV数值
SELECT
    a.dt,
    a.gmv_paid AS report_a_gmv,
    b.gmv_paid AS report_b_gmv,
    ABS(a.gmv_paid - b.gmv_paid) AS diff,
    ROUND(ABS(a.gmv_paid - b.gmv_paid) / a.gmv_paid * 100, 2) AS diff_rate
FROM ads_trade_daily_report a
JOIN ads_finance_daily_report b ON a.dt = b.dt
WHERE ABS(a.gmv_paid - b.gmv_paid) > 0;
-- 如果diff > 0,说明口径还是不一致,需要排查
面试怎么答?
低分回答
「口径不一致就是大家对指标定义不一样。解决方案是统一定义。」
面试官内心OS:说了等于没说。
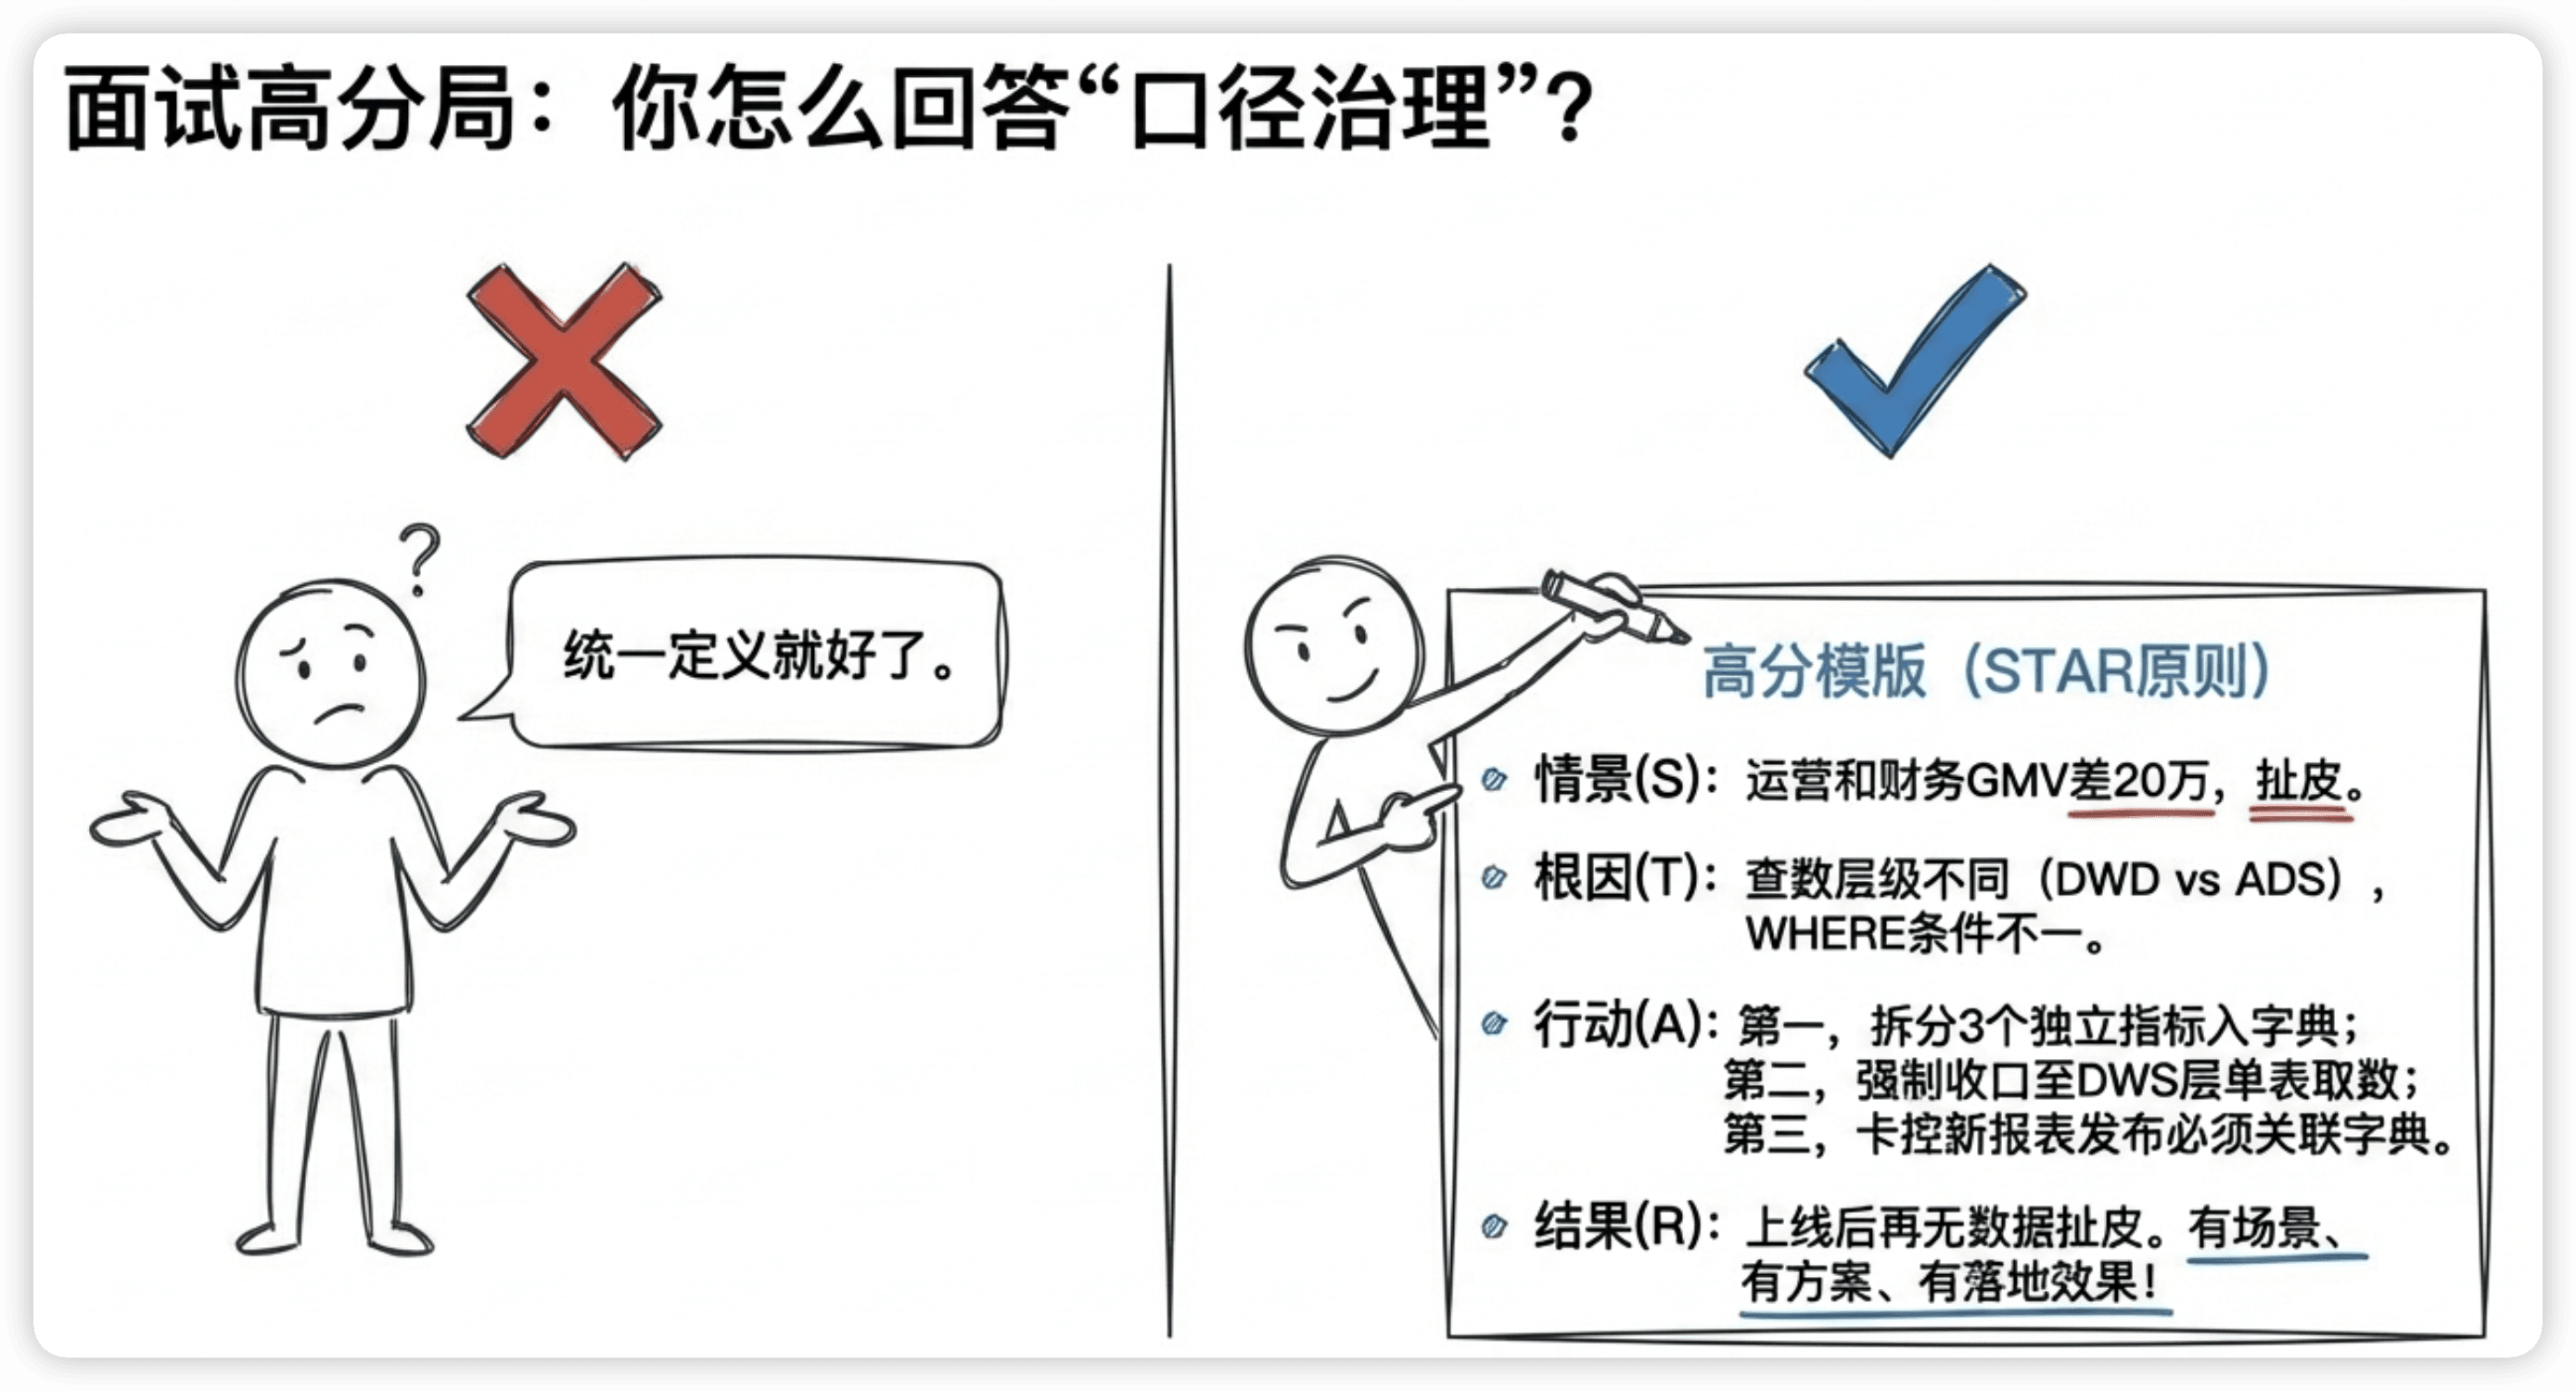
高分回答
「我们之前就遇到过典型的口径问题。运营和财务看的GMV差了20万,我排查后发现运营的报表直接查的DWD层,用的是
SUM(order_amount)包含了未支付订单;财务的报表查的ADS层,过滤了status='paid'。根因就是同一个'GMV'没有统一定义,取数出口也不一样。」
「我的解决方案分三步:第一,把GMV拆成了三个独立指标——下单GMV、支付GMV、含退款GMV,各自在指标字典里有明确的SQL定义;第二,所有指标的计算收口到DWS层一张汇总表,下游报表统一从这张表取数,不允许直接查DWD;第三,在报表需求流程里加了指标关联环节,新报表必须选择已有指标,不能自己造。上线后再没出现过口径扯皮的问题。」
这个回答有场景、有根因分析、有分步方案、有落地效果——面试官要的就是这种。
追问防线
追问1:指标字典用什么工具管理?
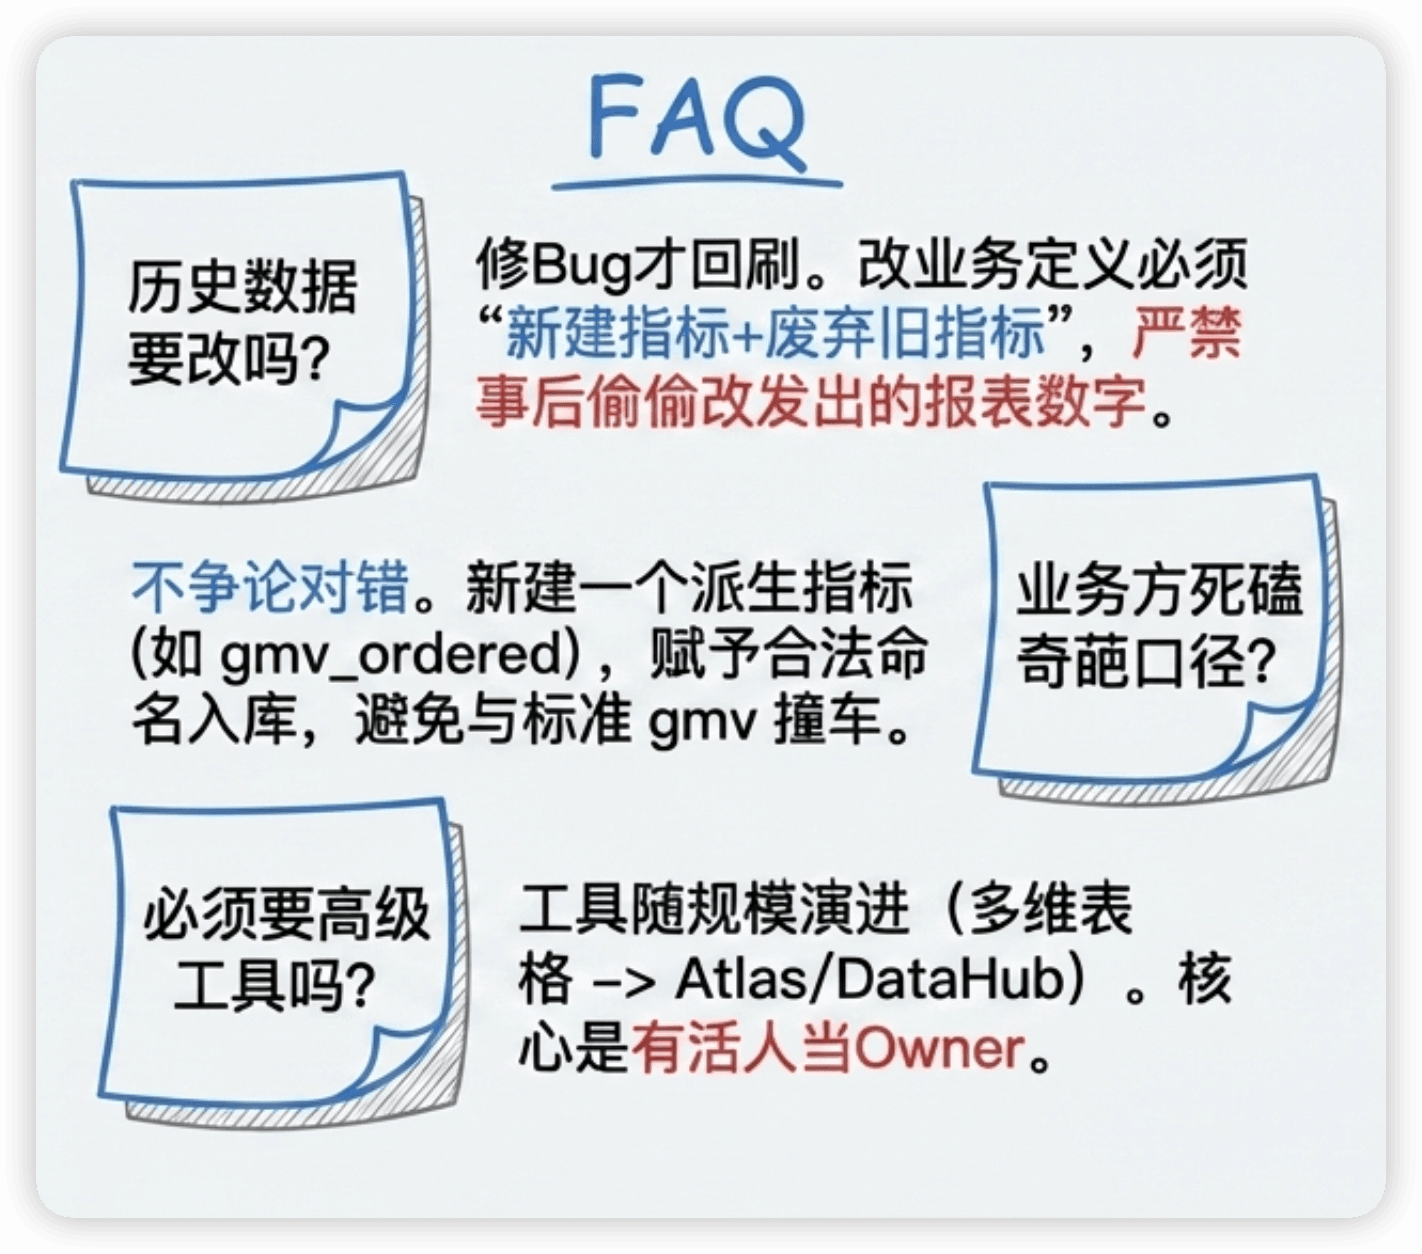
初期不需要太复杂的工具。我们一开始用的是飞书多维表格,每个指标一行,包含名称、定义、SQL、负责人等字段。团队只有3-5个人的时候这就够了。
等指标数量上了100+,才考虑用专业的指标管理平台。市面上常见的有Apache Atlas(元数据管理)、DataHub、或者各云厂商的数据治理产品(比如阿里云DataWorks的指标管理模块)。但工具不是关键,有人维护才是关键。最好指定一个人做指标Owner,负责审核新增和变更。
追问2:指标口径变更了怎么办?历史数据要不要改?
这取决于变更的性质。如果是修正错误(比如之前的SQL有Bug),历史数据需要回刷。如果是业务定义调整(比如管理层决定GMV以后不含退款中的),建议新建一个指标而不是改旧指标。旧指标标记为废弃,保留历史数据的一致性。
核心原则:已发出的报表数字不要事后偷偷改。如果必须改,要同步通知所有使用方,说明变更原因和影响范围。
追问3:如果业务方坚持要一个和标准定义不同的口径怎么办?
这种情况很常见。比如某个业务方就想看"含未支付的GMV",但标准口径里GMV定义为"已支付金额"。
我的做法是:不要去争论谁对谁错,而是新建一个派生指标,给它一个明确的名字(比如gmv_ordered而不是gmv),在指标字典里注册,让它成为一个"合法"的指标。关键是名字不能和标准口径的指标撞车——撞车才是口径混乱的根源。
总结
- 口径不一致的三大根因:定义不统一、SQL各写各的、数据源不同
- 指标三层体系:原子指标(基础度量)→ 派生指标(加限定条件)→ 复合指标(多指标运算)
- 治理三步走:建指标字典(统一定义)→ 收口汇总层(统一出口)→ 技术卡控(防止跑偏)
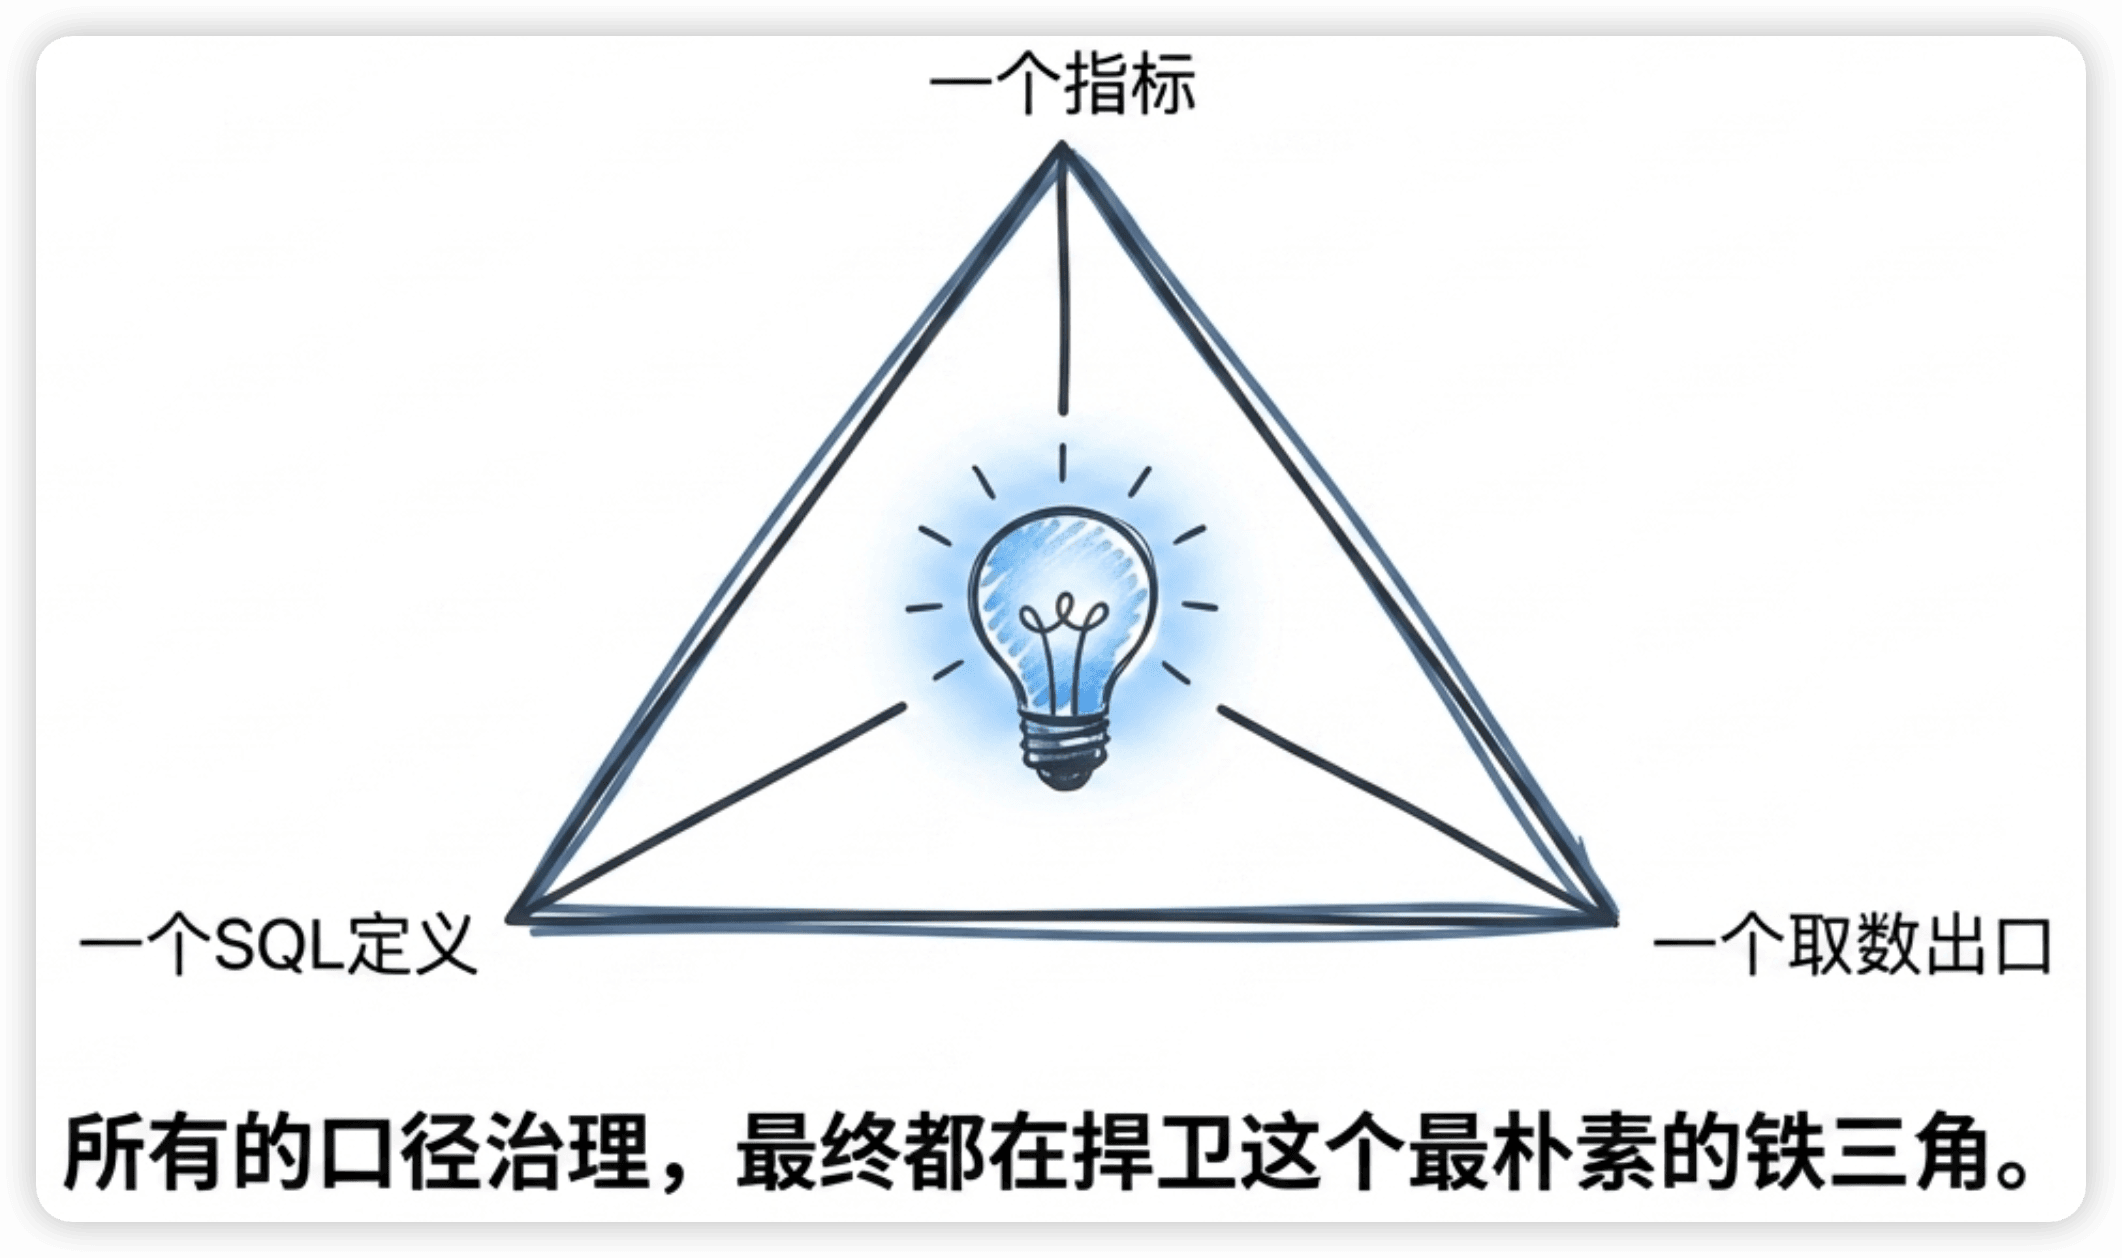
- 核心原则:一个指标,一个SQL定义,一个取数出口
- 面试关键:能讲出你亲手解决过的口径混乱案例,有场景、有根因、有方案、有效果