数据膨胀与JOIN陷阱
这个Bug我踩过,我带过的新人也踩过,我面试候选人的时候问这道题,80%的人都踩过。
场景是这样的:你写了一个很普通的JOIN,原表100万行,JOIN之后变成了150万行。金额SUM完比实际多了50%,报表数字全是错的,被业务方投诉了。
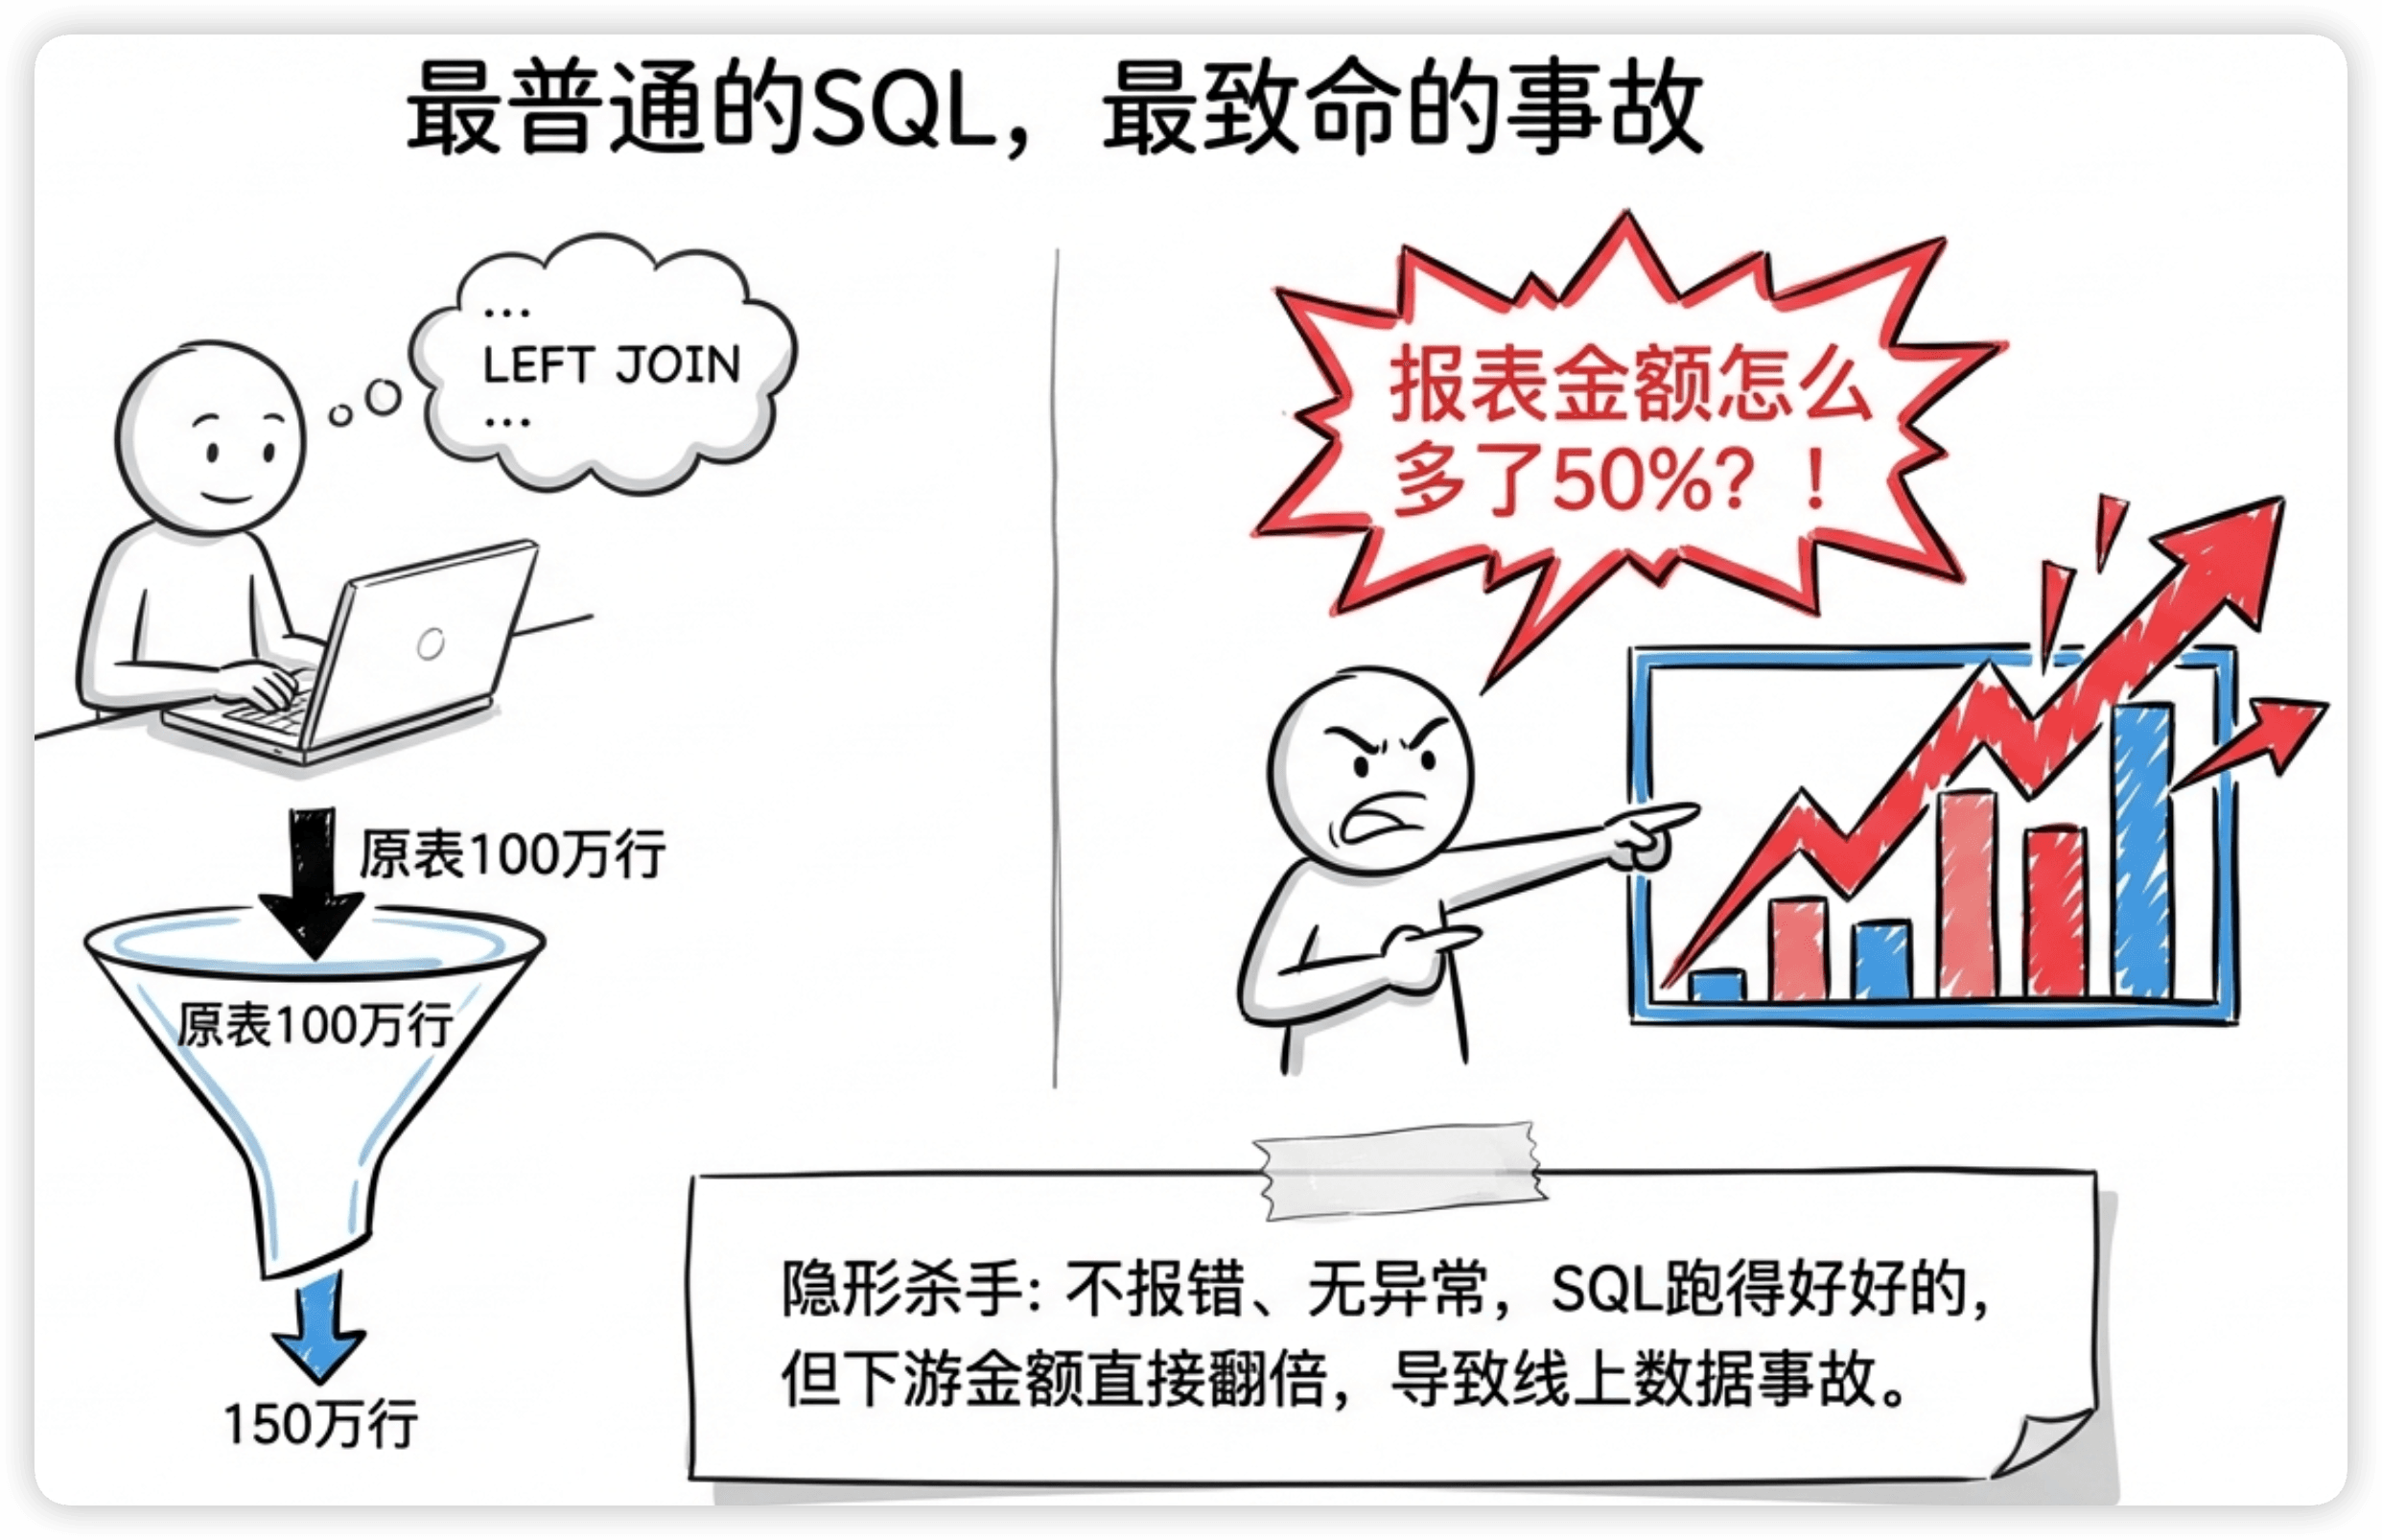
你一脸懵——"我就写了个LEFT JOIN啊,怎么行数就多了?"
这就是数据膨胀,数仓开发的隐形杀手。它不会报错,不会抛异常,SQL跑得好好的,结果却是错的。如果你没有主动检查行数的习惯,这种错误可能在线上跑了好几天才被发现。
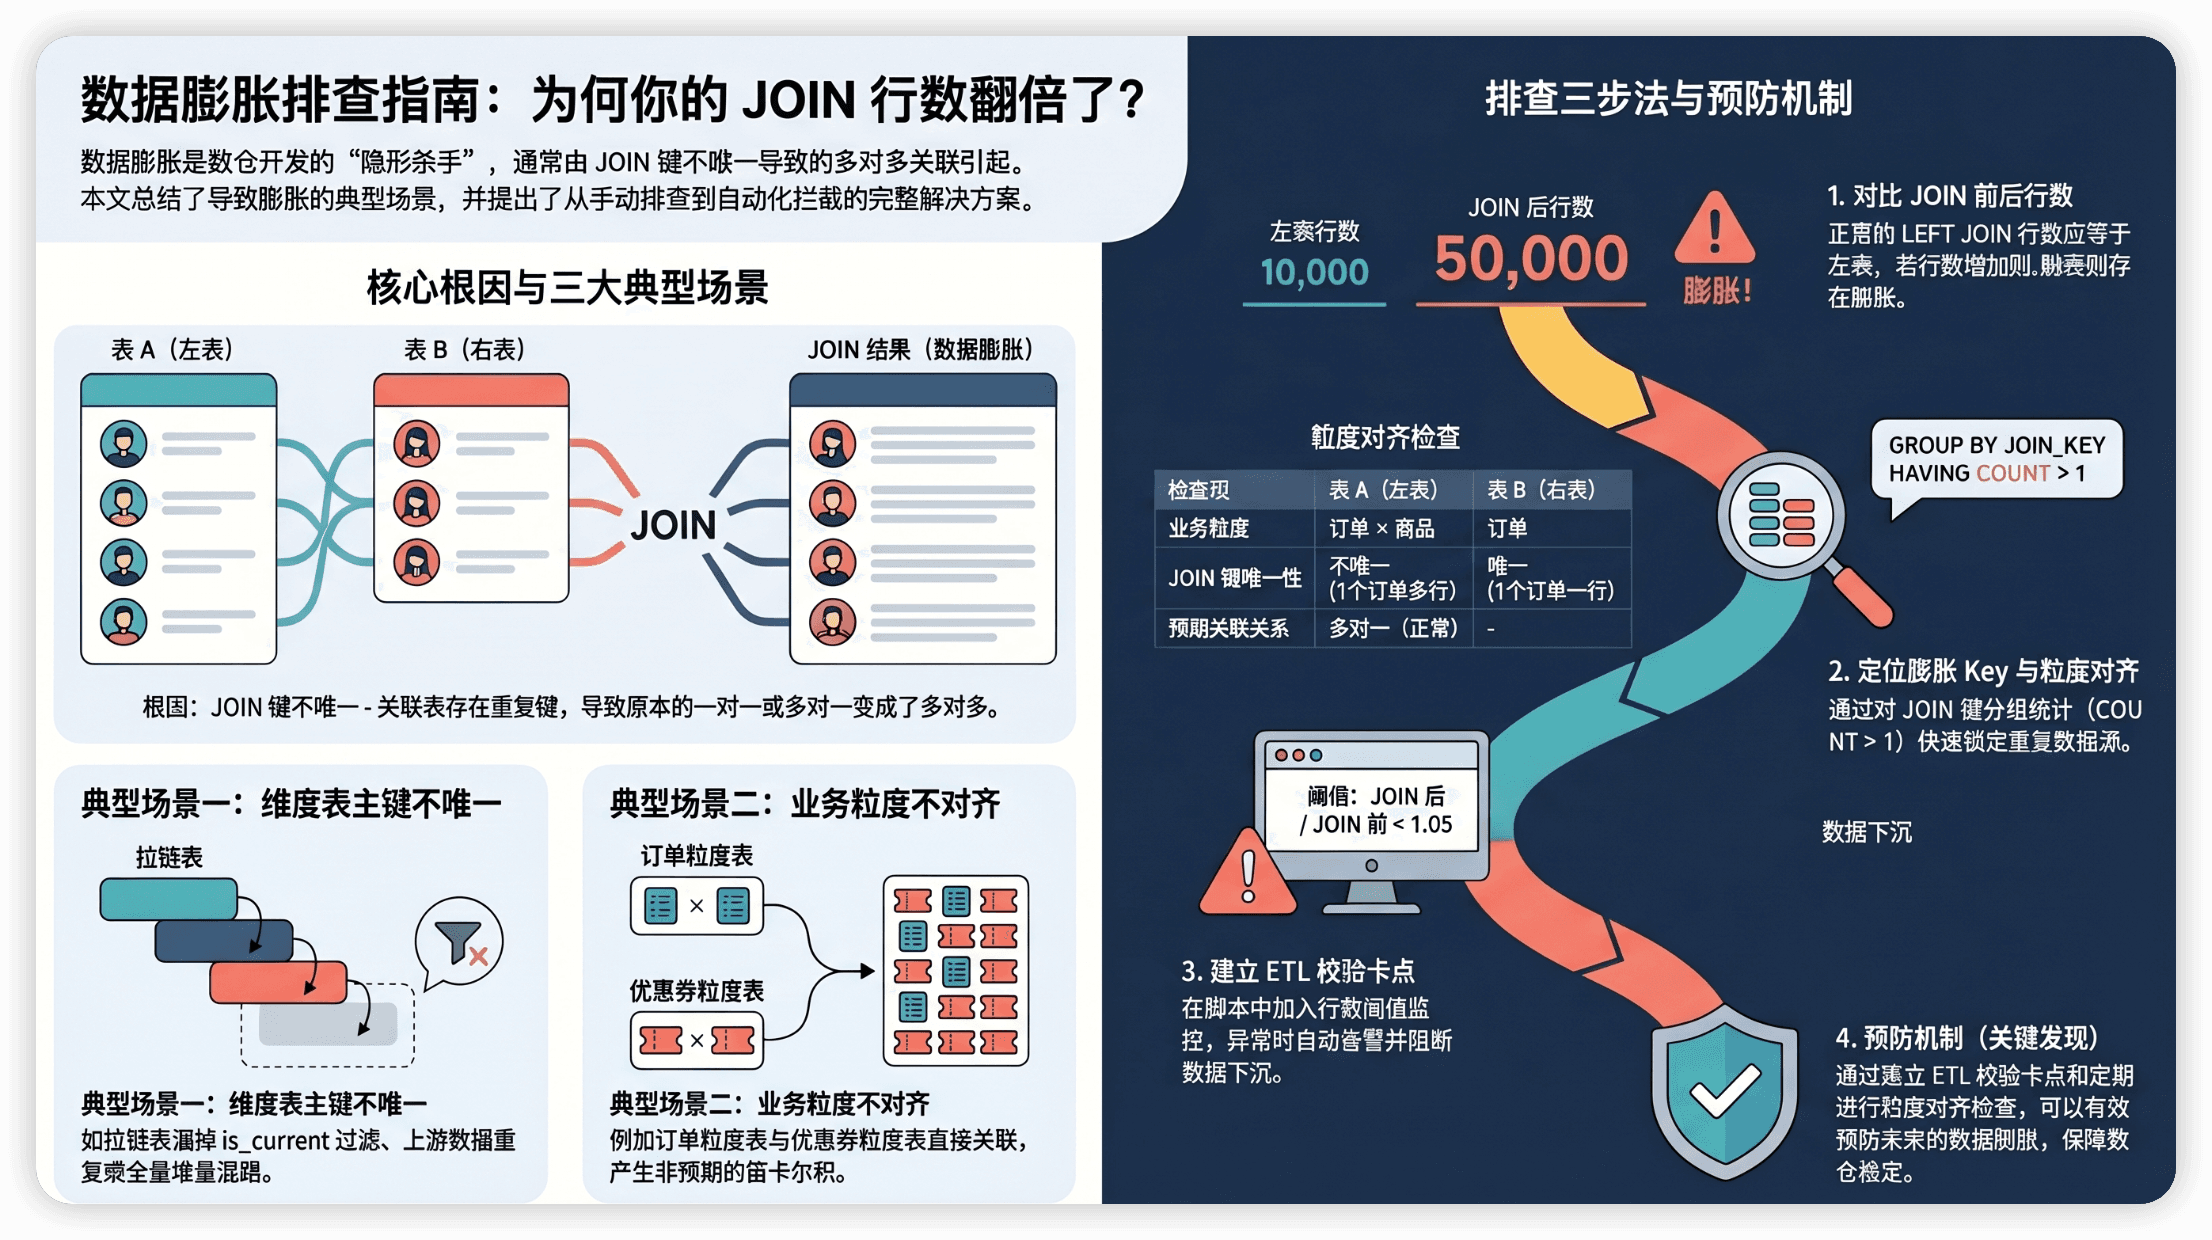
这篇文章我把数据膨胀的根因、三大典型场景、排查方法和预防机制全讲清楚。
数据膨胀的根因:一句话说清楚
JOIN键不唯一,产生了多对多关联。
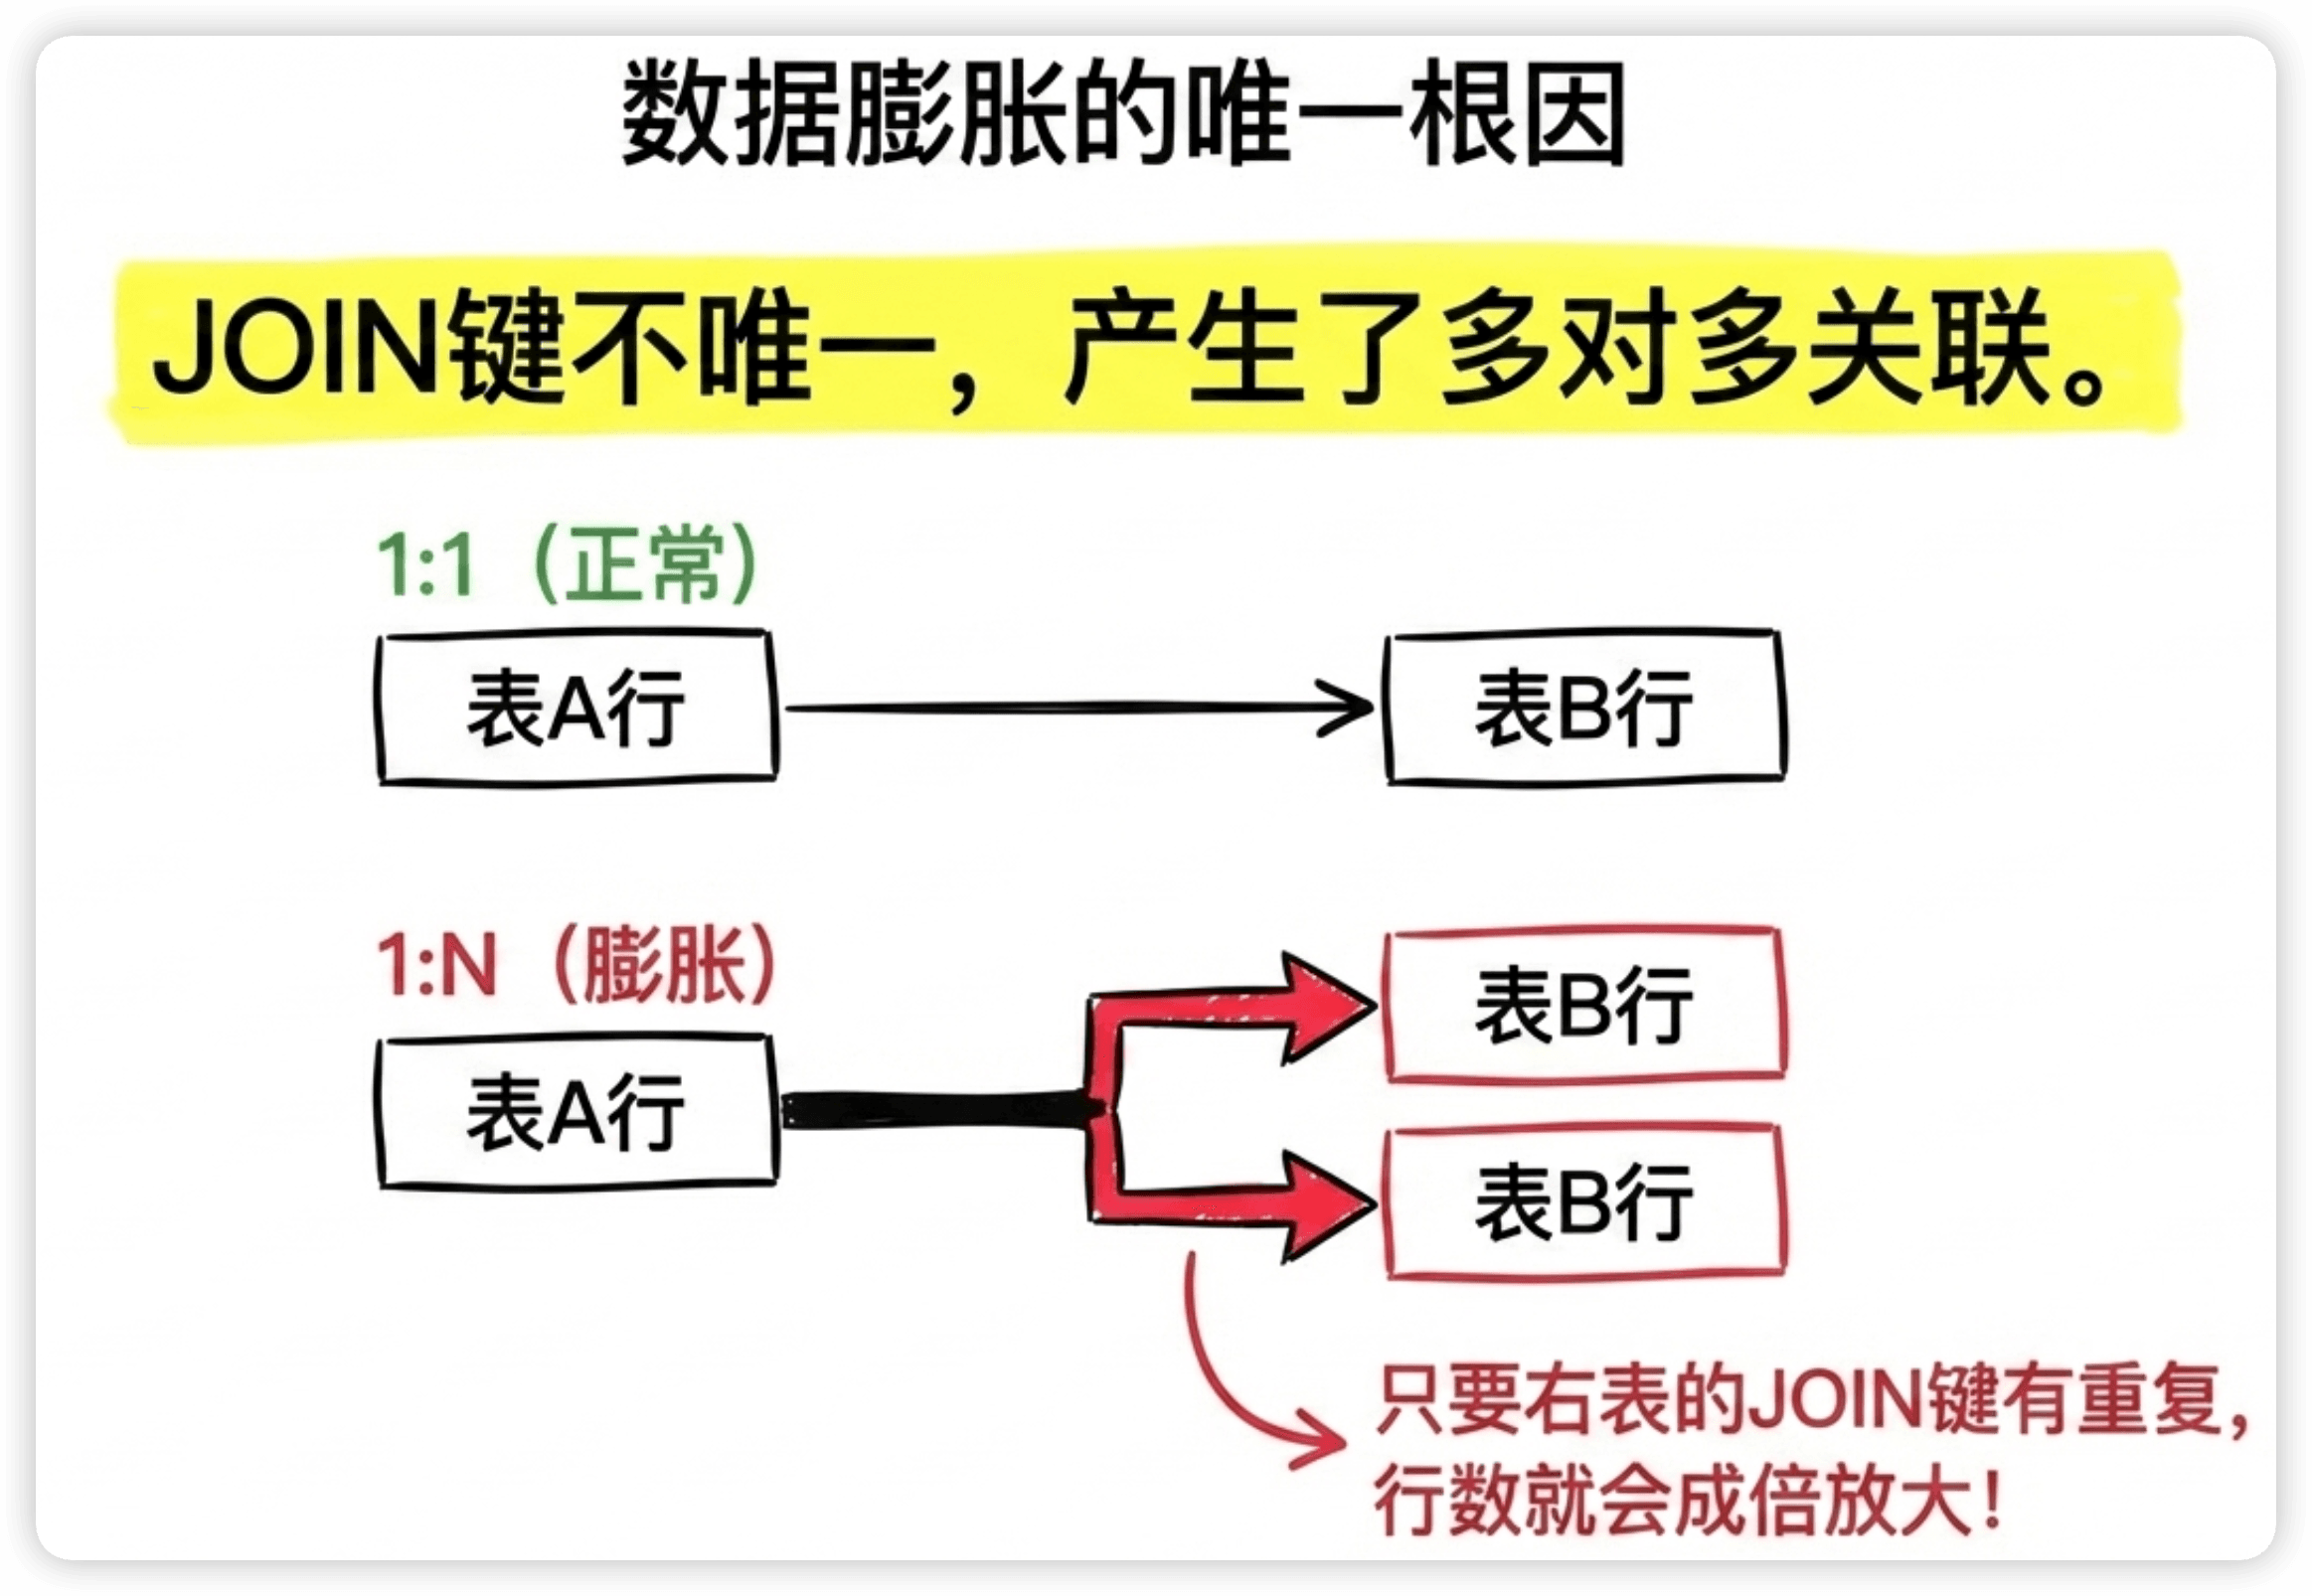
就这一个原因。
JOIN的本质是什么?是拿表A的每一行,去表B里找匹配的行。如果表B的JOIN键是唯一的(一个user_id只有一行),那就是一对一或多对一,行数不会变。但如果表B的JOIN键有重复(一个user_id有两行),那表A的每一行就会匹配到两行,行数就翻倍了。
表A(事实表):user_id = 1001 有 2 笔订单
  order_001, user_id=1001, amount=100
  order_002, user_id=1001, amount=200

表B(维度表):user_id = 1001 有 2 条记录(主键重复!)
  user_id=1001, name=张三, is_current=1
  user_id=1001, name=张三, is_current=0  ← 拉链表旧记录没过滤掉

JOIN 结果:2 × 2 = 4 行(膨胀了!)
  order_001, 100, 张三, is_current=1
  order_001, 100, 张三, is_current=0
  order_002, 200, 张三, is_current=1
  order_002, 200, 张三, is_current=0

SUM(amount) = 100+100+200+200 = 600(实际应该是300)
金额直接翻倍。如果你不检查行数,这个错误会一路带到下游所有报表。
三大典型膨胀场景
场景一:维度表主键不唯一(最常见)
这是踩坑概率最高的场景。你以为dim_user的user_id是唯一的,但实际上不是。
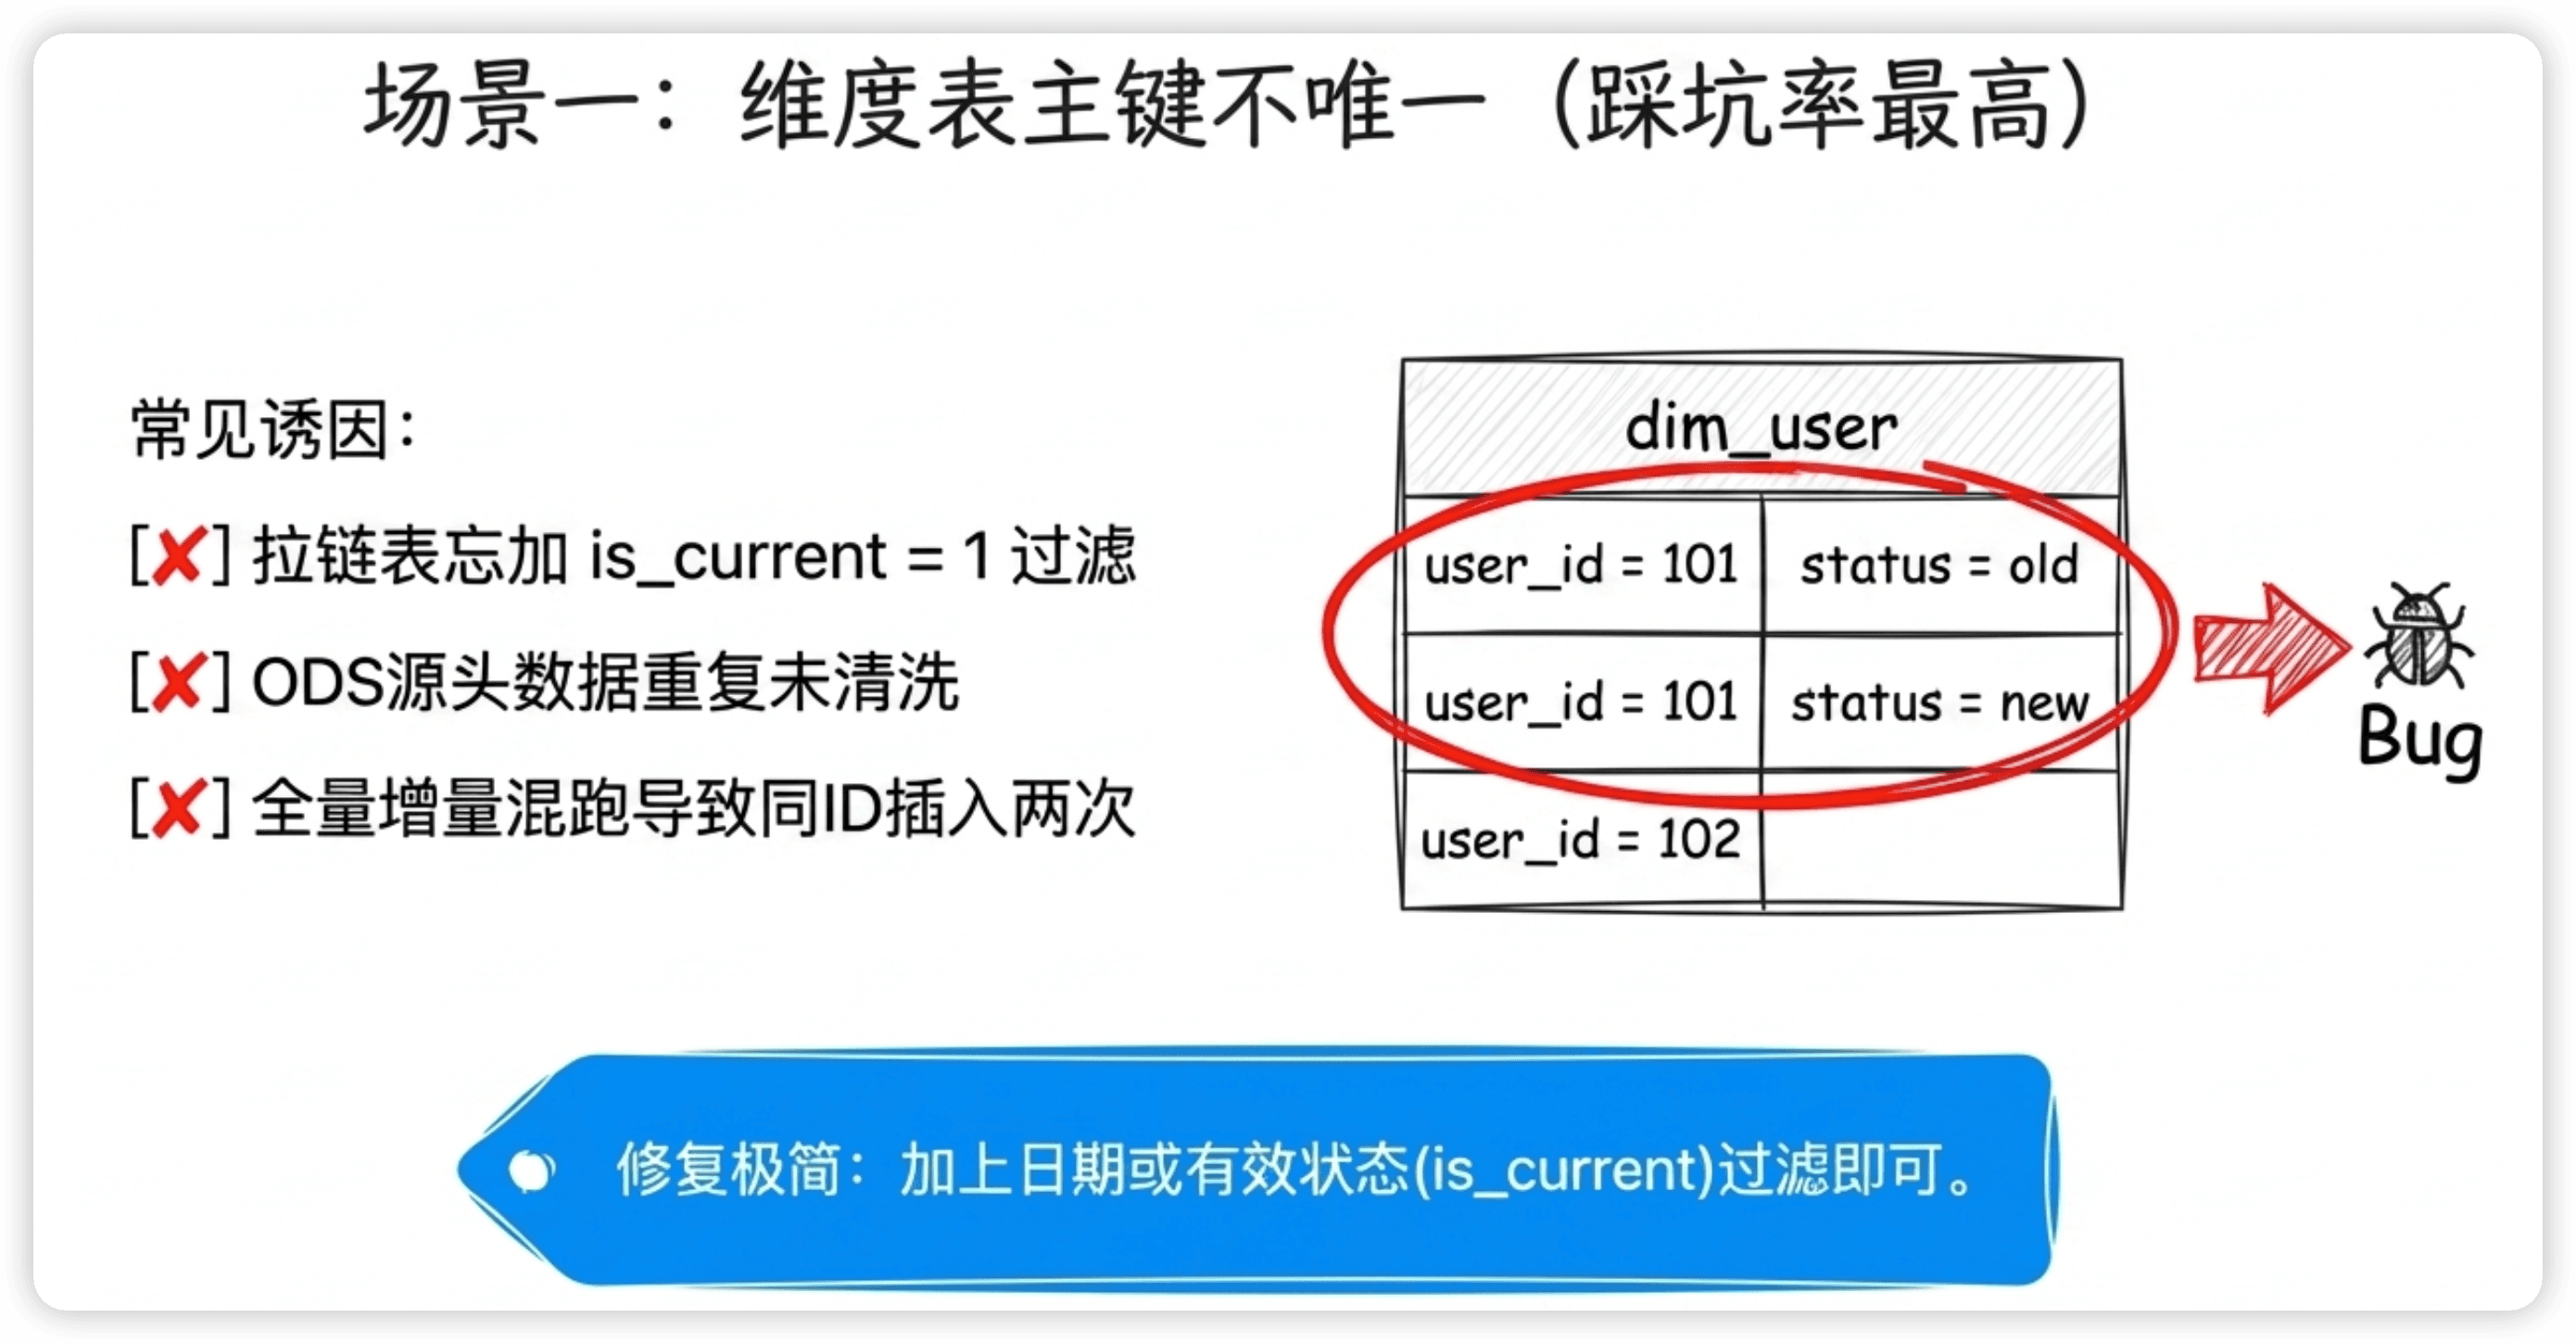
常见原因:
- 拉链表忘了过滤:DAY 3讲过的拉链表,一个user_id可能有多条历史记录,如果你JOIN的时候忘了加
WHERE is_current = 1或者日期范围过滤,就会匹配到所有历史记录 - 上游数据有重复:源系统的数据本身就有重复行,ODS层照单全收,DWD层没做去重
- 全量和增量混跑:某次调度任务跑了两遍(重跑的时候INSERT没有用OVERWRITE),同一个ID进了两次
检测方法:
-- 在JOIN之前,先检查维度表的主键唯一性
SELECT user_id, COUNT(*) AS cnt
FROM dim_user
WHERE is_current = 1   -- 别忘了这个条件
GROUP BY user_id
HAVING cnt > 1;

-- 如果返回结果不为空,说明主键不唯一
-- 先解决这个问题,再去JOIN
我遇到过一次真实事故:用户维度表的is_current标记有Bug,某批数据导入时没有正确关闭旧记录,导致同一个user_id有两条
is_current=1的记录。JOIN之后订单行数直接翻倍,GMV多算了一倍。当天运营看报表就发现数字异常了,排查了半天才定位到维度表。
修复方法:
-- 修复:只保留最新的一条记录
-- 如果拉链表有多条is_current=1的记录,用ROW_NUMBER取最新的
SELECT * FROM (
    SELECT *,
        ROW_NUMBER() OVER(PARTITION BY user_id ORDER BY start_date DESC) AS rn
    FROM dim_user
    WHERE is_current = 1
) t WHERE rn = 1;
场景二:粒度不对齐
两张表的粒度不一致,JOIN的时候产生了意料之外的笛卡尔积。
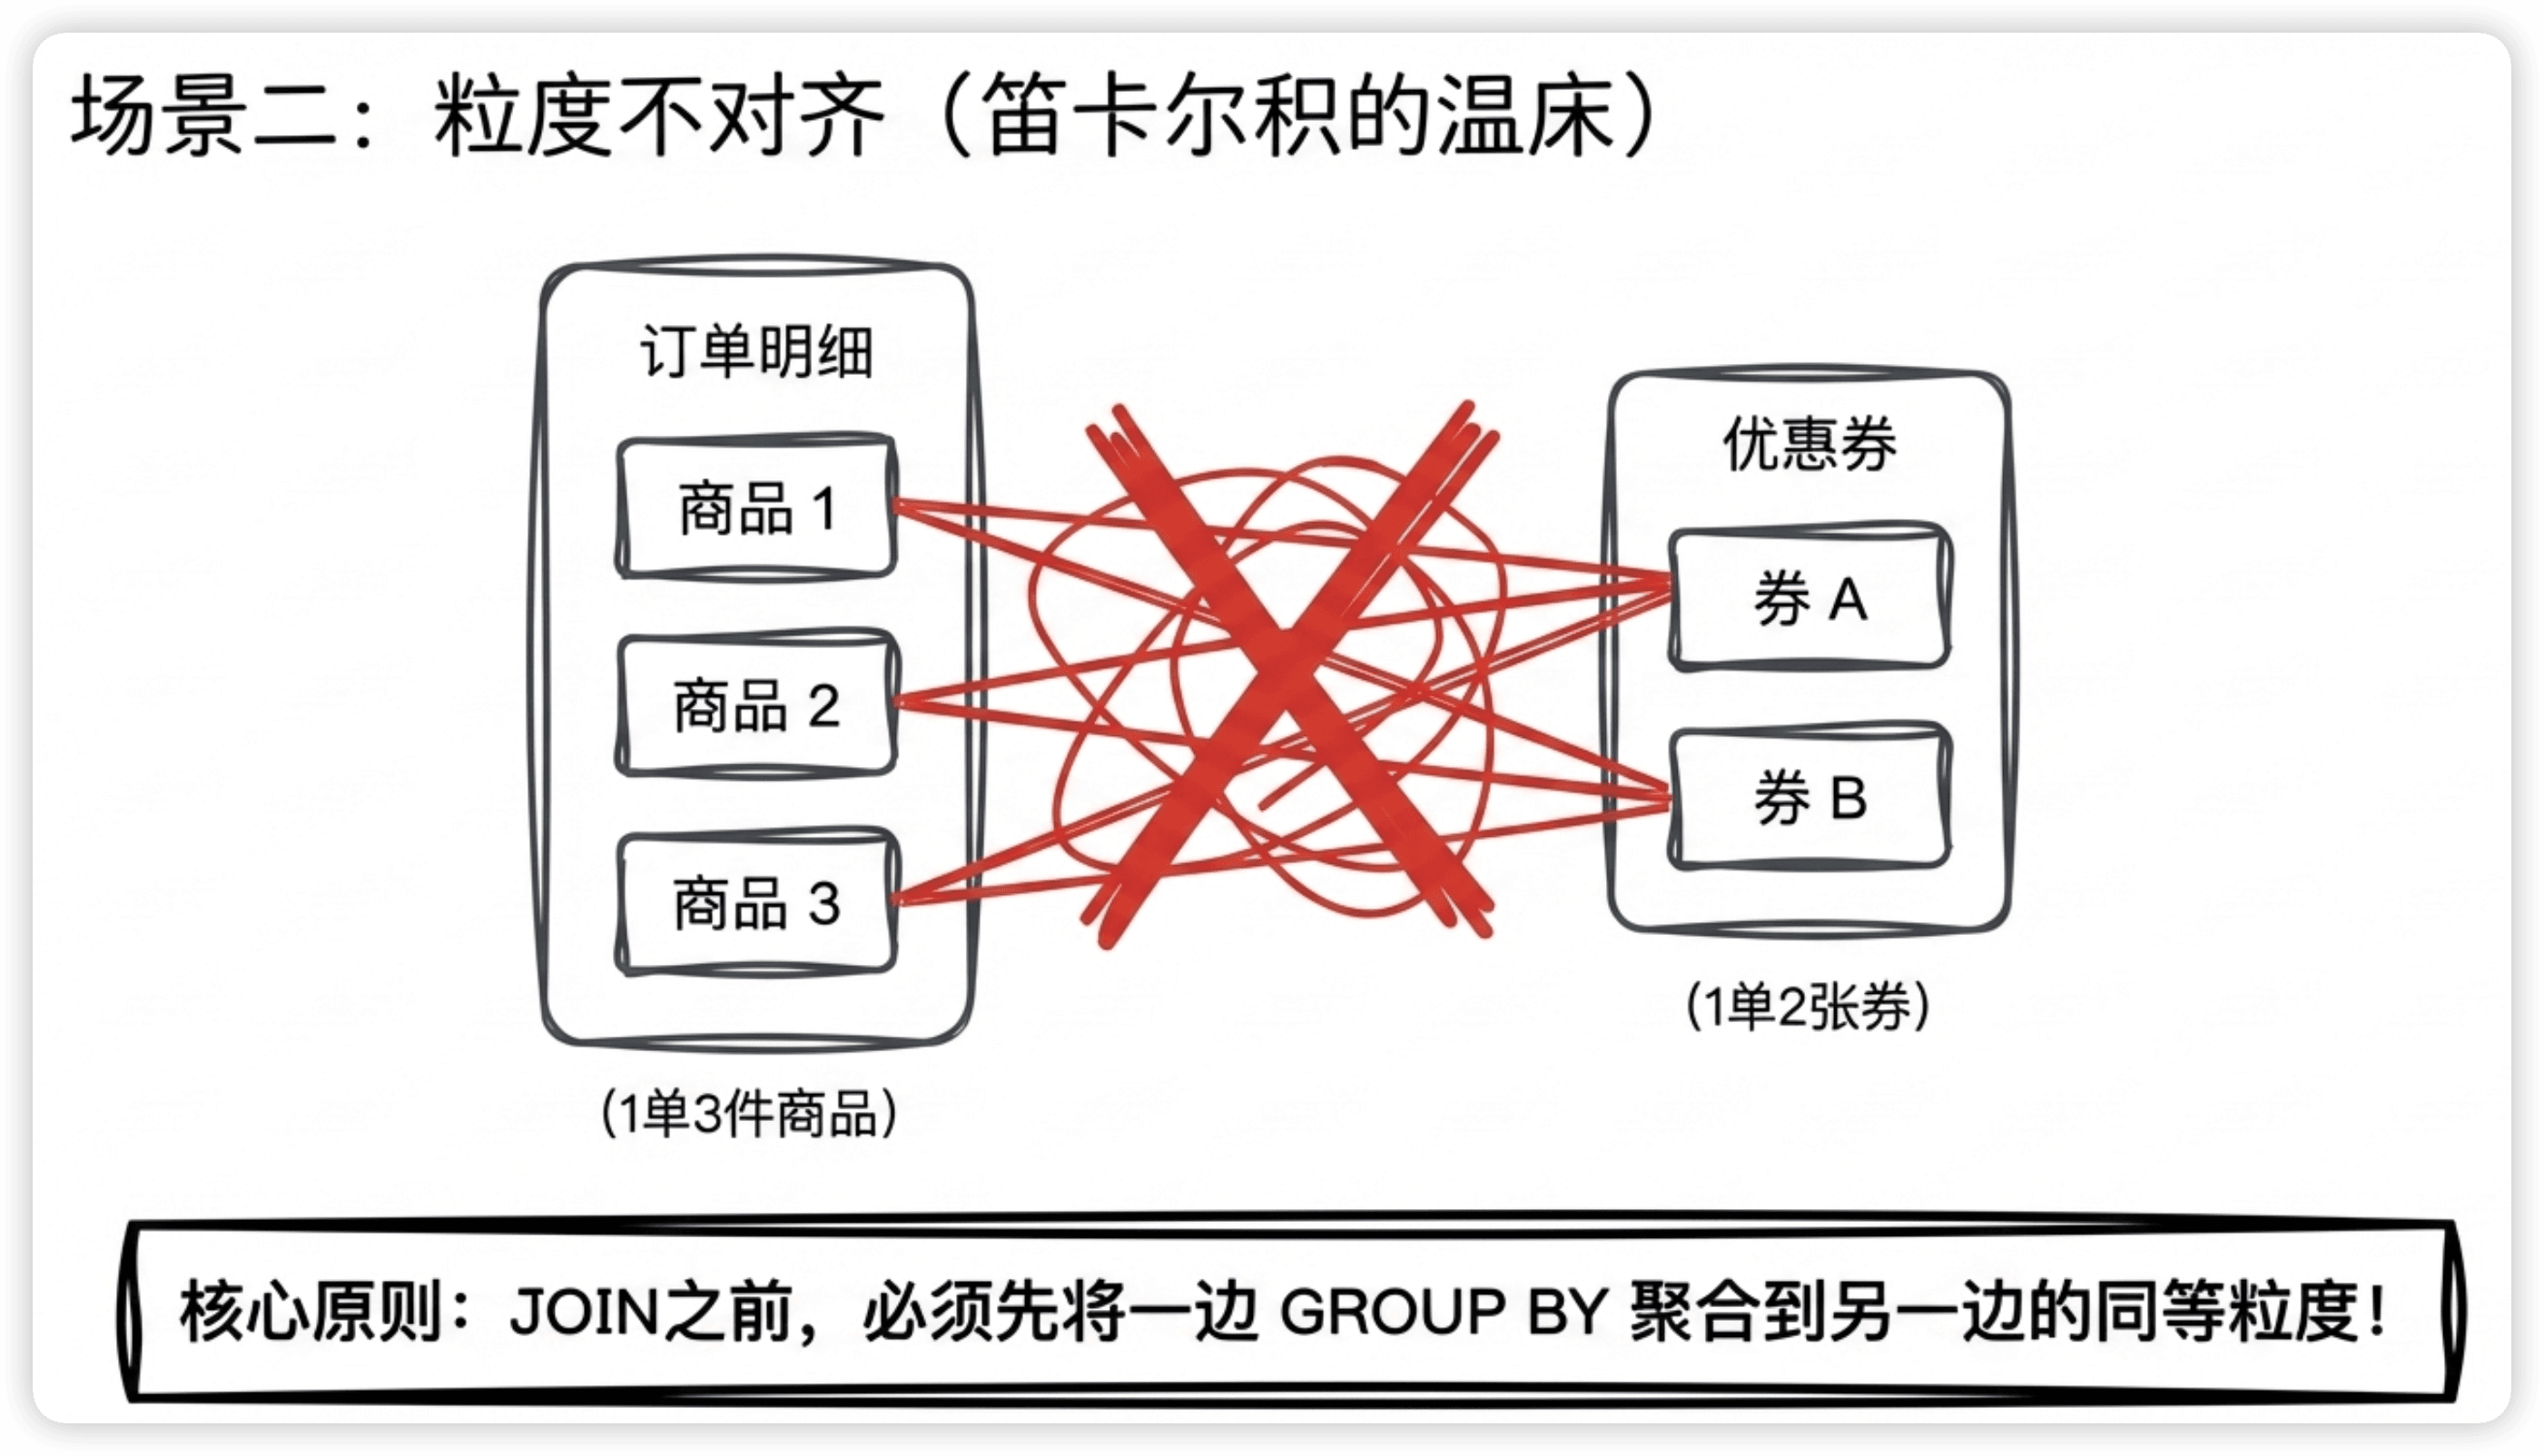
典型例子:
事实表的粒度是"订单 × 商品"(一个包含3件商品的订单 = 3行),你JOIN了一张"订单粒度"的优惠券表(一个订单用了2张优惠券 = 2行)。
事实表(订单×商品粒度):
  order_001, product_A, 100
  order_001, product_B, 200
  order_001, product_C, 150

优惠券表(订单×优惠券粒度):
  order_001, coupon_X, 折扣30
  order_001, coupon_Y, 折扣20

JOIN ON order_id 之后:3 × 2 = 6 行
  order_001, product_A, 100, coupon_X, 30
  order_001, product_A, 100, coupon_Y, 20
  order_001, product_B, 200, coupon_X, 30
  order_001, product_B, 200, coupon_Y, 20
  order_001, product_C, 150, coupon_X, 30
  order_001, product_C, 150, coupon_Y, 20

原来3行变成了6行,金额SUM翻倍了。
核心原则:JOIN之前先确认两边的粒度是否对齐。
如果粒度不同,需要先把一边聚合到和另一边相同的粒度:
-- 先把优惠券表聚合到订单粒度
WITH coupon_summary AS (
    SELECT order_id,
        COUNT(*) AS coupon_cnt,
        SUM(discount_amount) AS total_discount
    FROM coupon_table
    GROUP BY order_id
)
-- 再和事实表JOIN(现在两边都是order_id唯一的)
SELECT f.*, c.coupon_cnt, c.total_discount
FROM fact_order_detail f
LEFT JOIN coupon_summary c ON f.order_id = c.order_id;
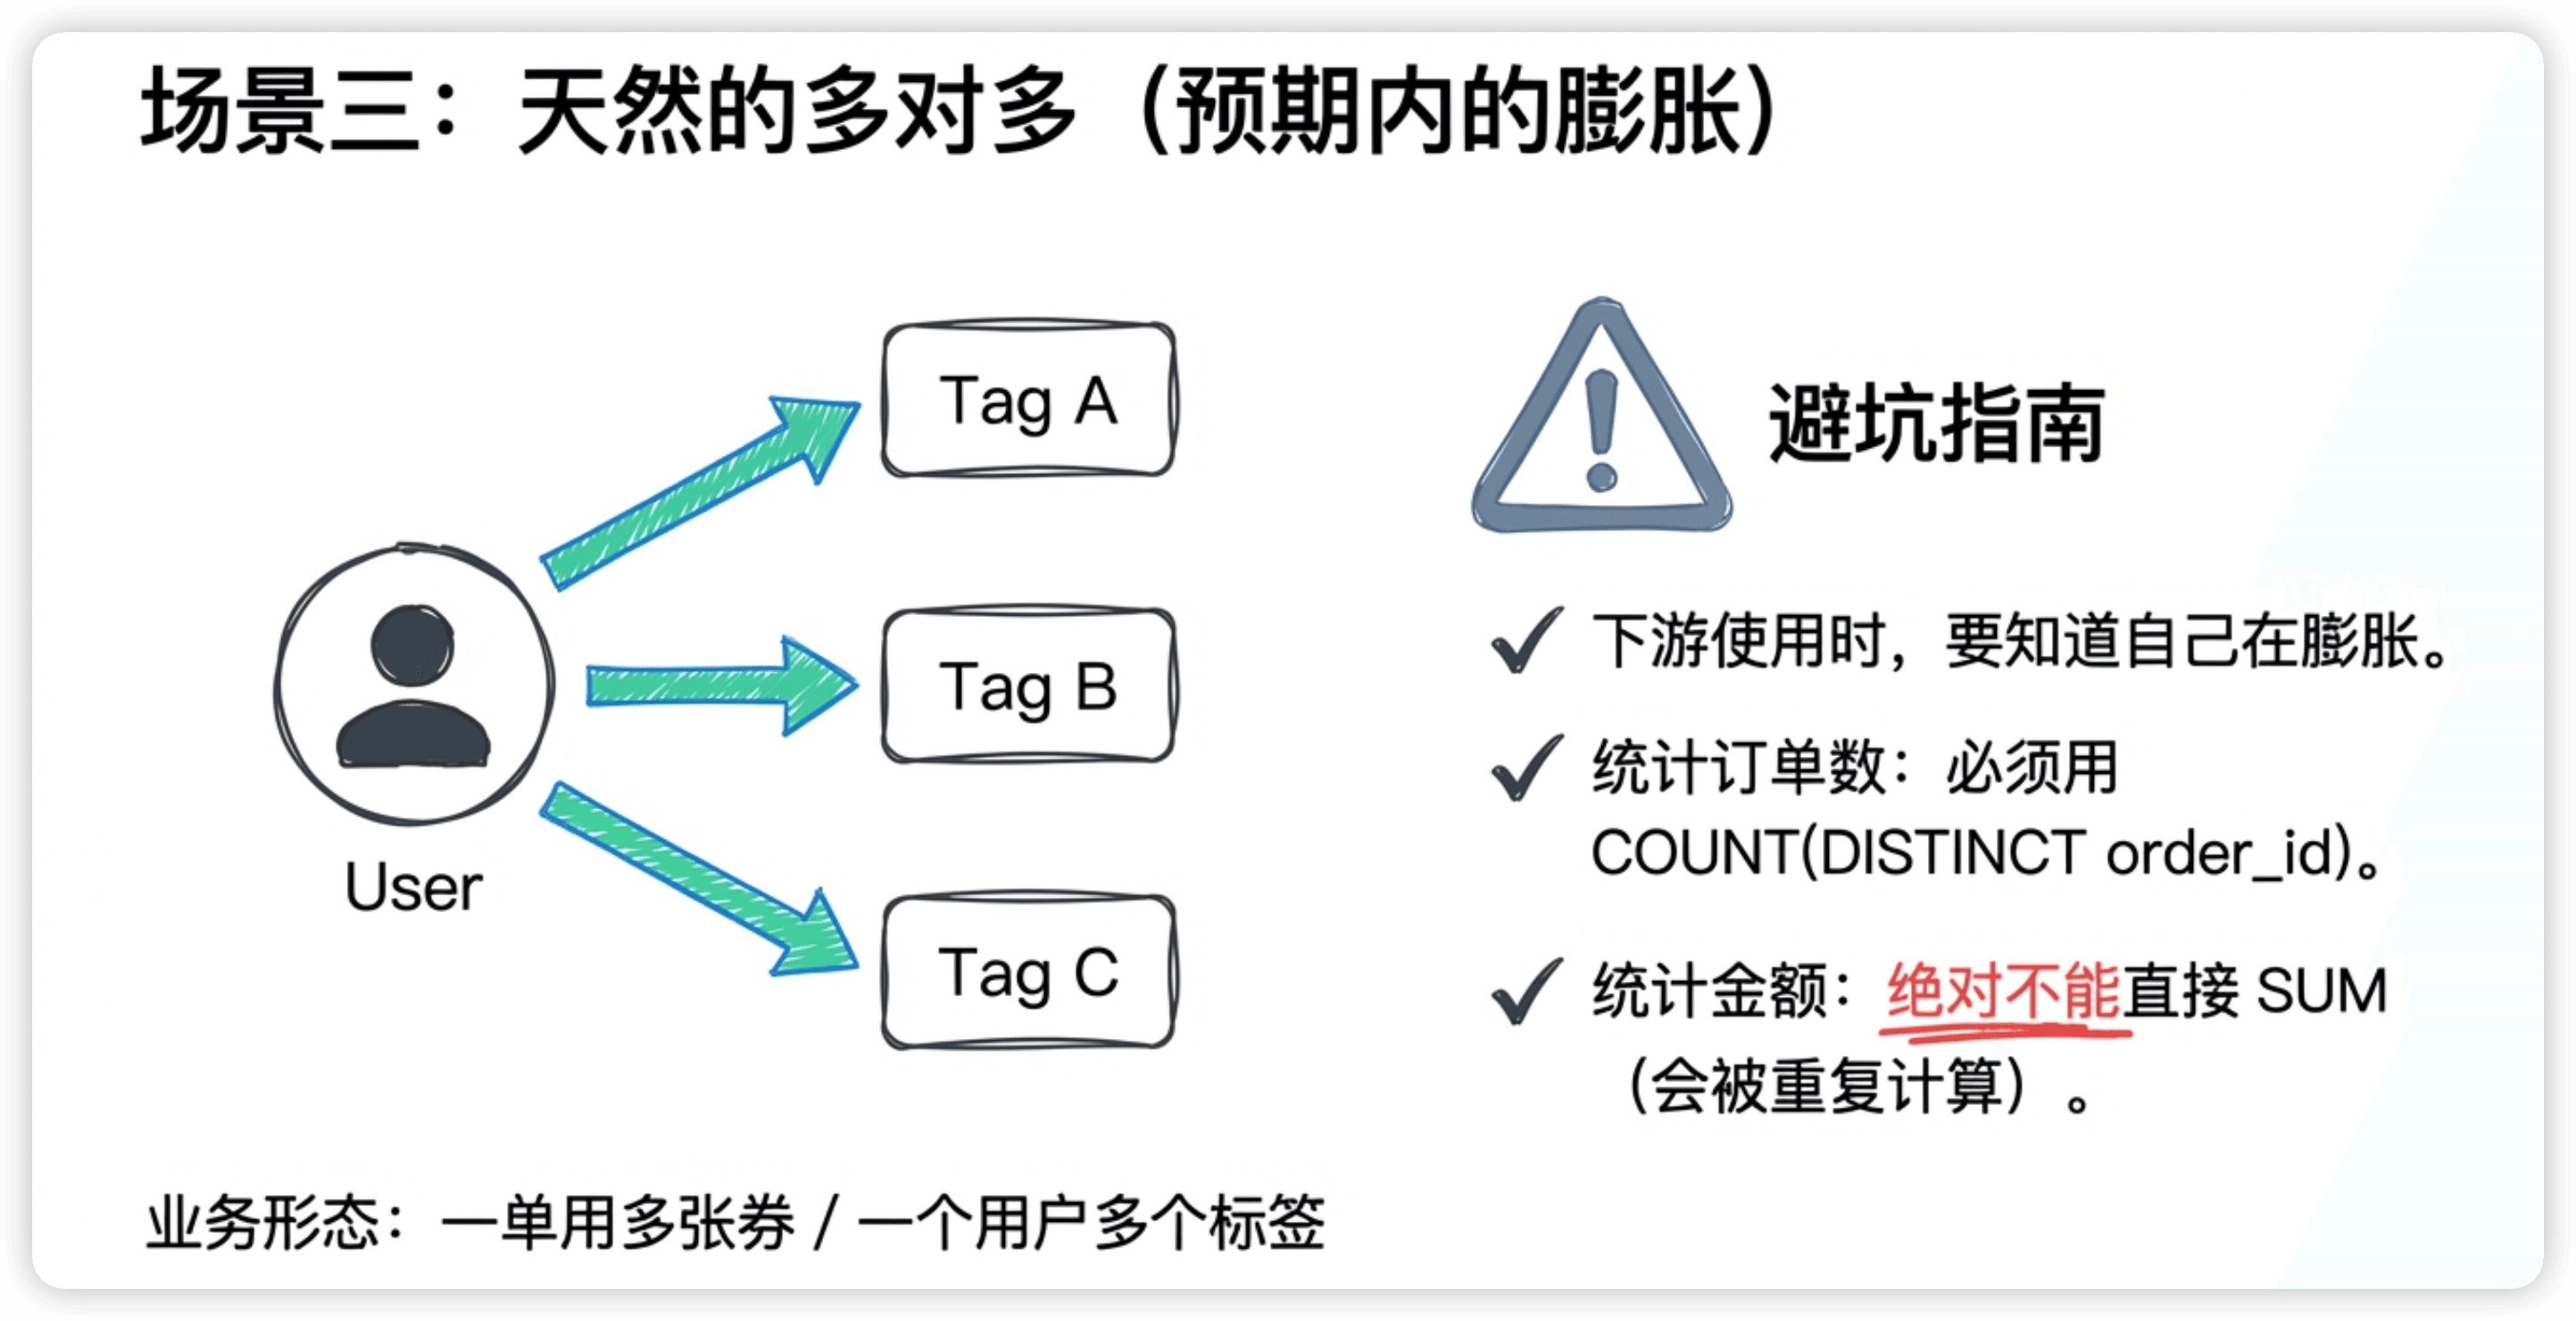
场景三:天然的多对多关系
有些业务关系天然就是多对多的:
- 一个用户可以属于多个用户组/标签
- 一个商品可以有多个分类标签
- 一个订单可以用多张优惠券
-- 用户标签表:一个用户3个标签
user_id | tag
1001    | 高价值
1001    | 活跃
1001    | 新注册

-- 订单表:user_id=1001 有2笔订单
user_id | order_id | amount
1001    | 001      | 100
1001    | 002      | 200

-- 如果直接JOIN:2 × 3 = 6行,金额从300变成900
解决方案取决于你要分析什么:
-- 方案A:只取主标签(如果有优先级的话)
SELECT o.*, t.tag
FROM fact_order o
LEFT JOIN (
    SELECT user_id, tag,
        ROW_NUMBER() OVER(PARTITION BY user_id ORDER BY priority) AS rn
    FROM user_tags
) t ON o.user_id = t.user_id AND t.rn = 1;

-- 方案B:先聚合标签,拼成一个字段
SELECT o.*, t.tags
FROM fact_order o
LEFT JOIN (
    SELECT user_id, COLLECT_SET(tag) AS tags
    FROM user_tags
    GROUP BY user_id
) t ON o.user_id = t.user_id;

-- 方案C:如果确实需要按标签维度分析,要意识到金额会重复计数
-- 报表上注明"同一订单可能出现在多个标签下,金额不可直接累加"
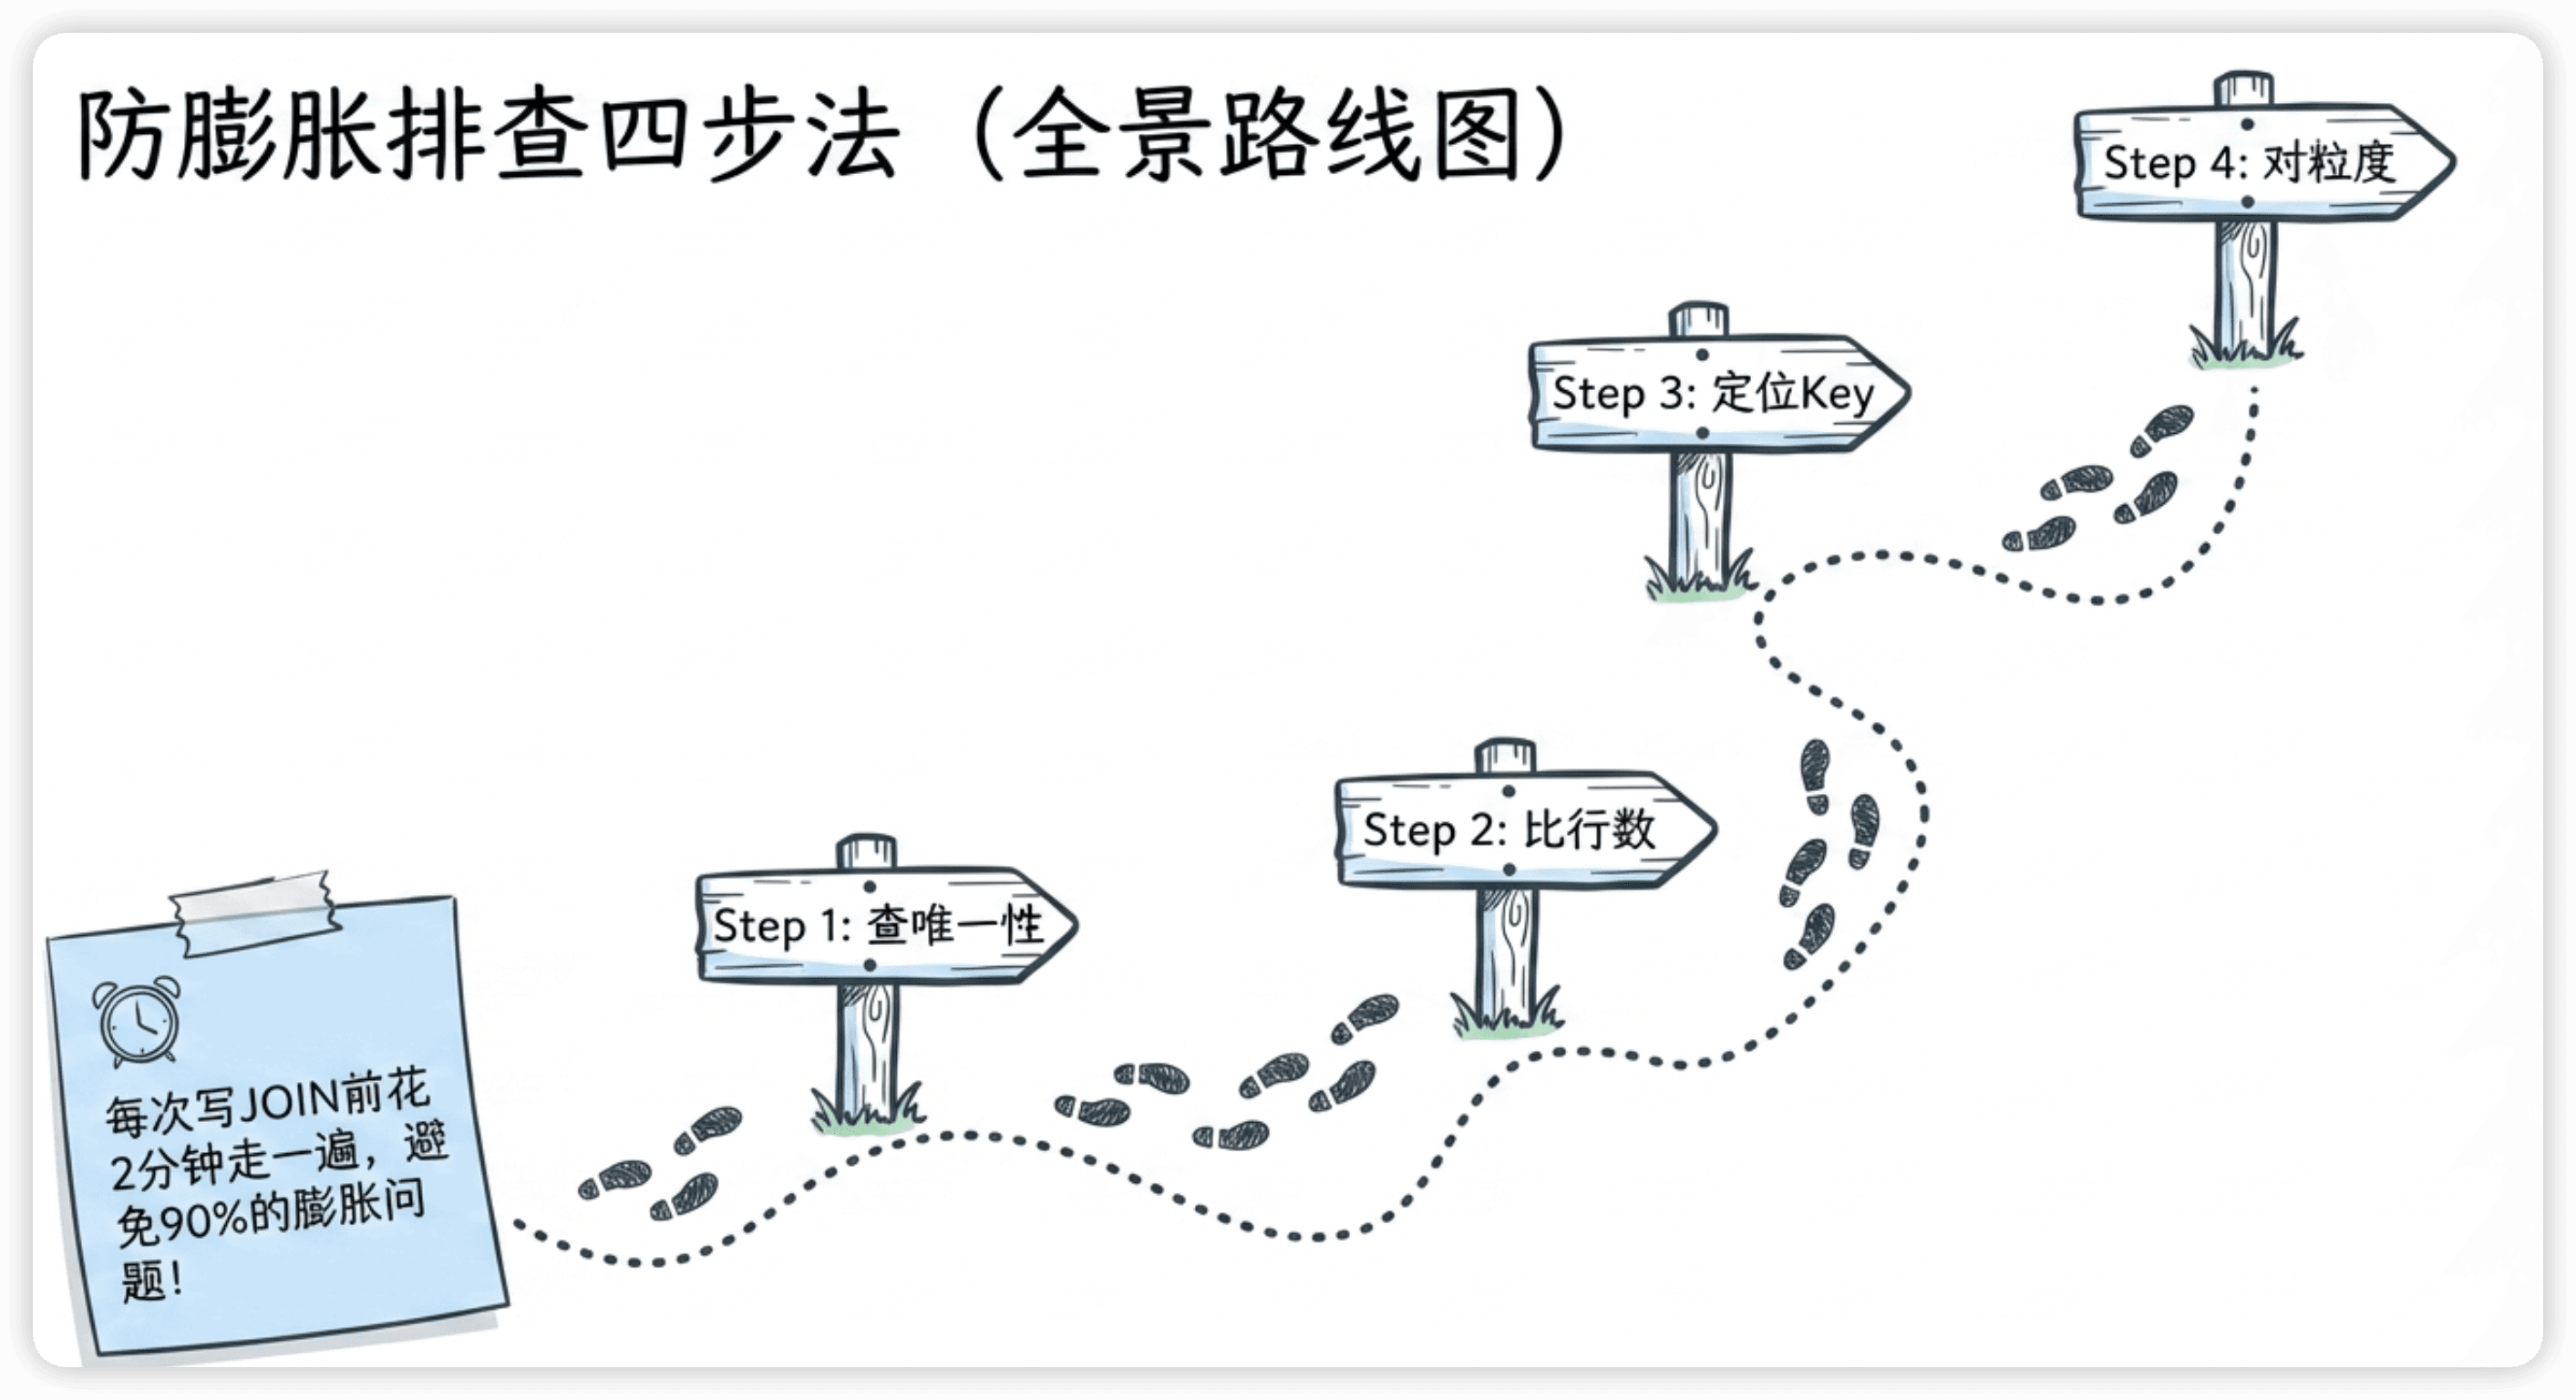
防膨胀排查四步法
每次写JOIN之前,花2分钟过一遍这个流程,能避免90%的膨胀问题:
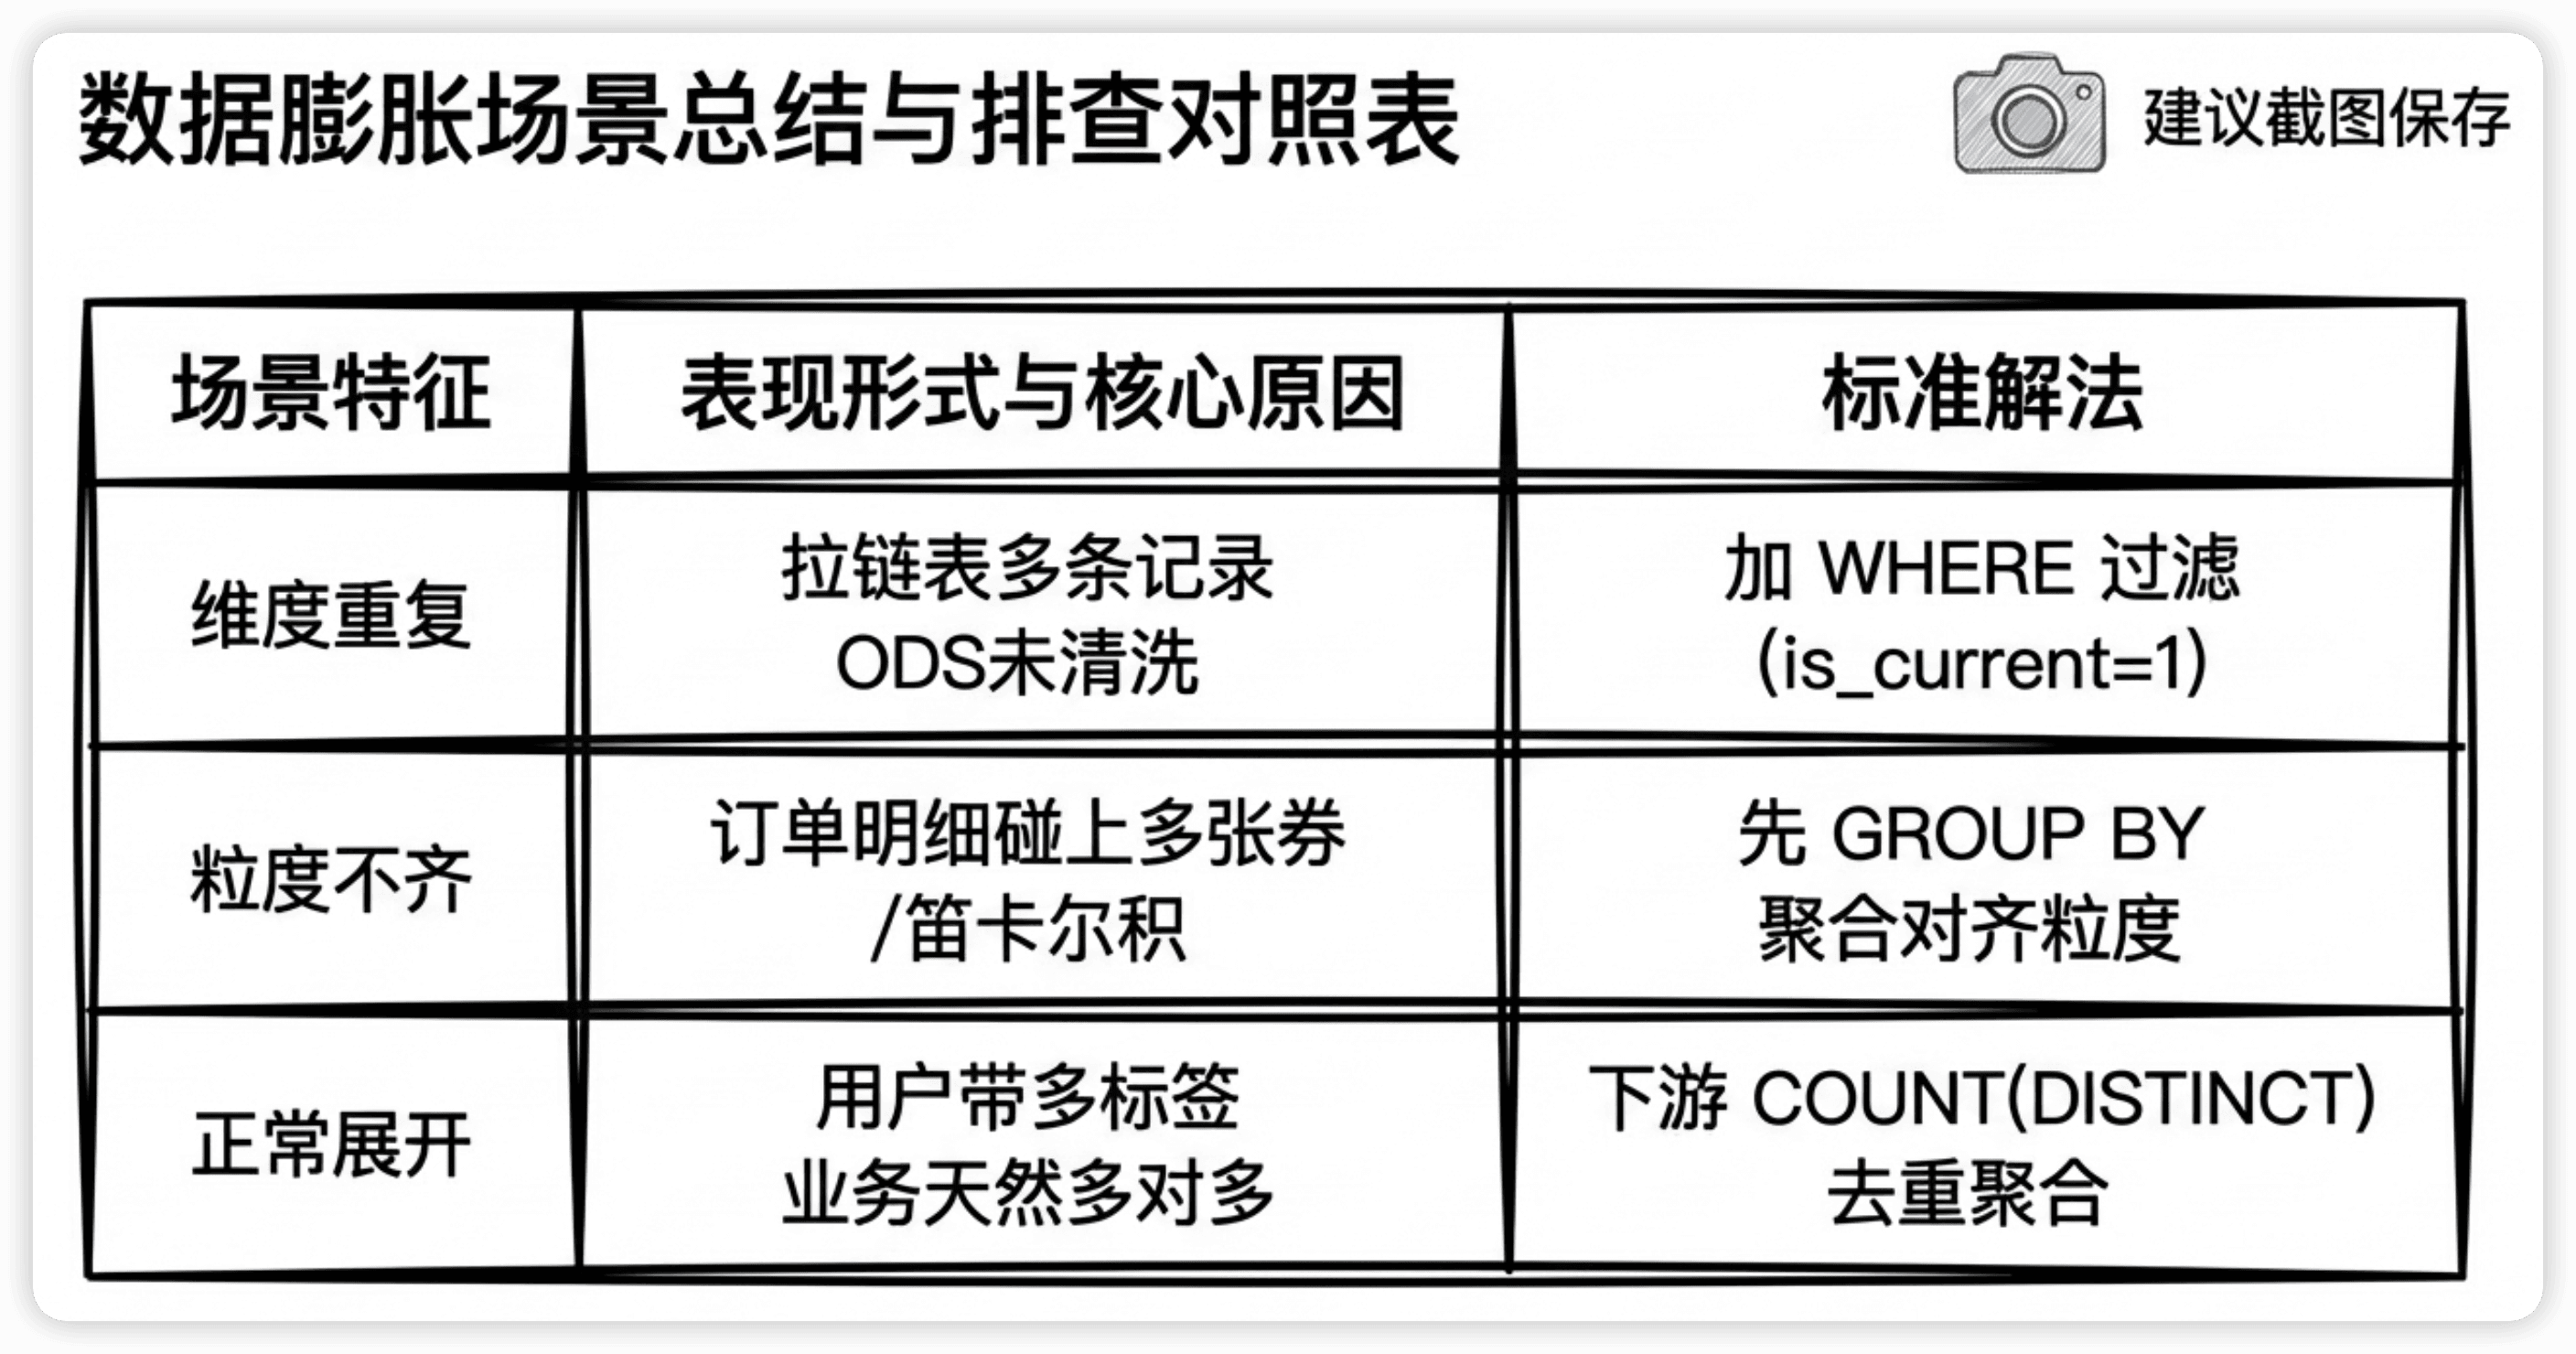
第一步:检查JOIN键唯一性
-- 分别检查JOIN两侧的关联键是否唯一
-- 左表
SELECT join_key, COUNT(*) AS cnt
FROM table_a
GROUP BY join_key
HAVING cnt > 1
LIMIT 10;

-- 右表
SELECT join_key, COUNT(*) AS cnt
FROM table_b
GROUP BY join_key
HAVING cnt > 1
LIMIT 10;

-- 如果两边都有重复 → 多对多,必膨胀
-- 如果只有一边有重复 → 多对一或一对多,不膨胀但要清楚哪边是"多"
第二步:对比JOIN前后行数
-- JOIN前的行数
SELECT COUNT(*) FROM fact_order;  -- 假设 1,000,000

-- JOIN后的行数
SELECT COUNT(*)
FROM fact_order a
JOIN dim_user b ON a.user_id = b.user_id;
-- 如果 > 1,000,000,必有膨胀

-- 用一条SQL完成对比
SELECT
    (SELECT COUNT(*) FROM fact_order) AS before_cnt,
    (SELECT COUNT(*) FROM fact_order a JOIN dim_user b ON a.user_id = b.user_id) AS after_cnt;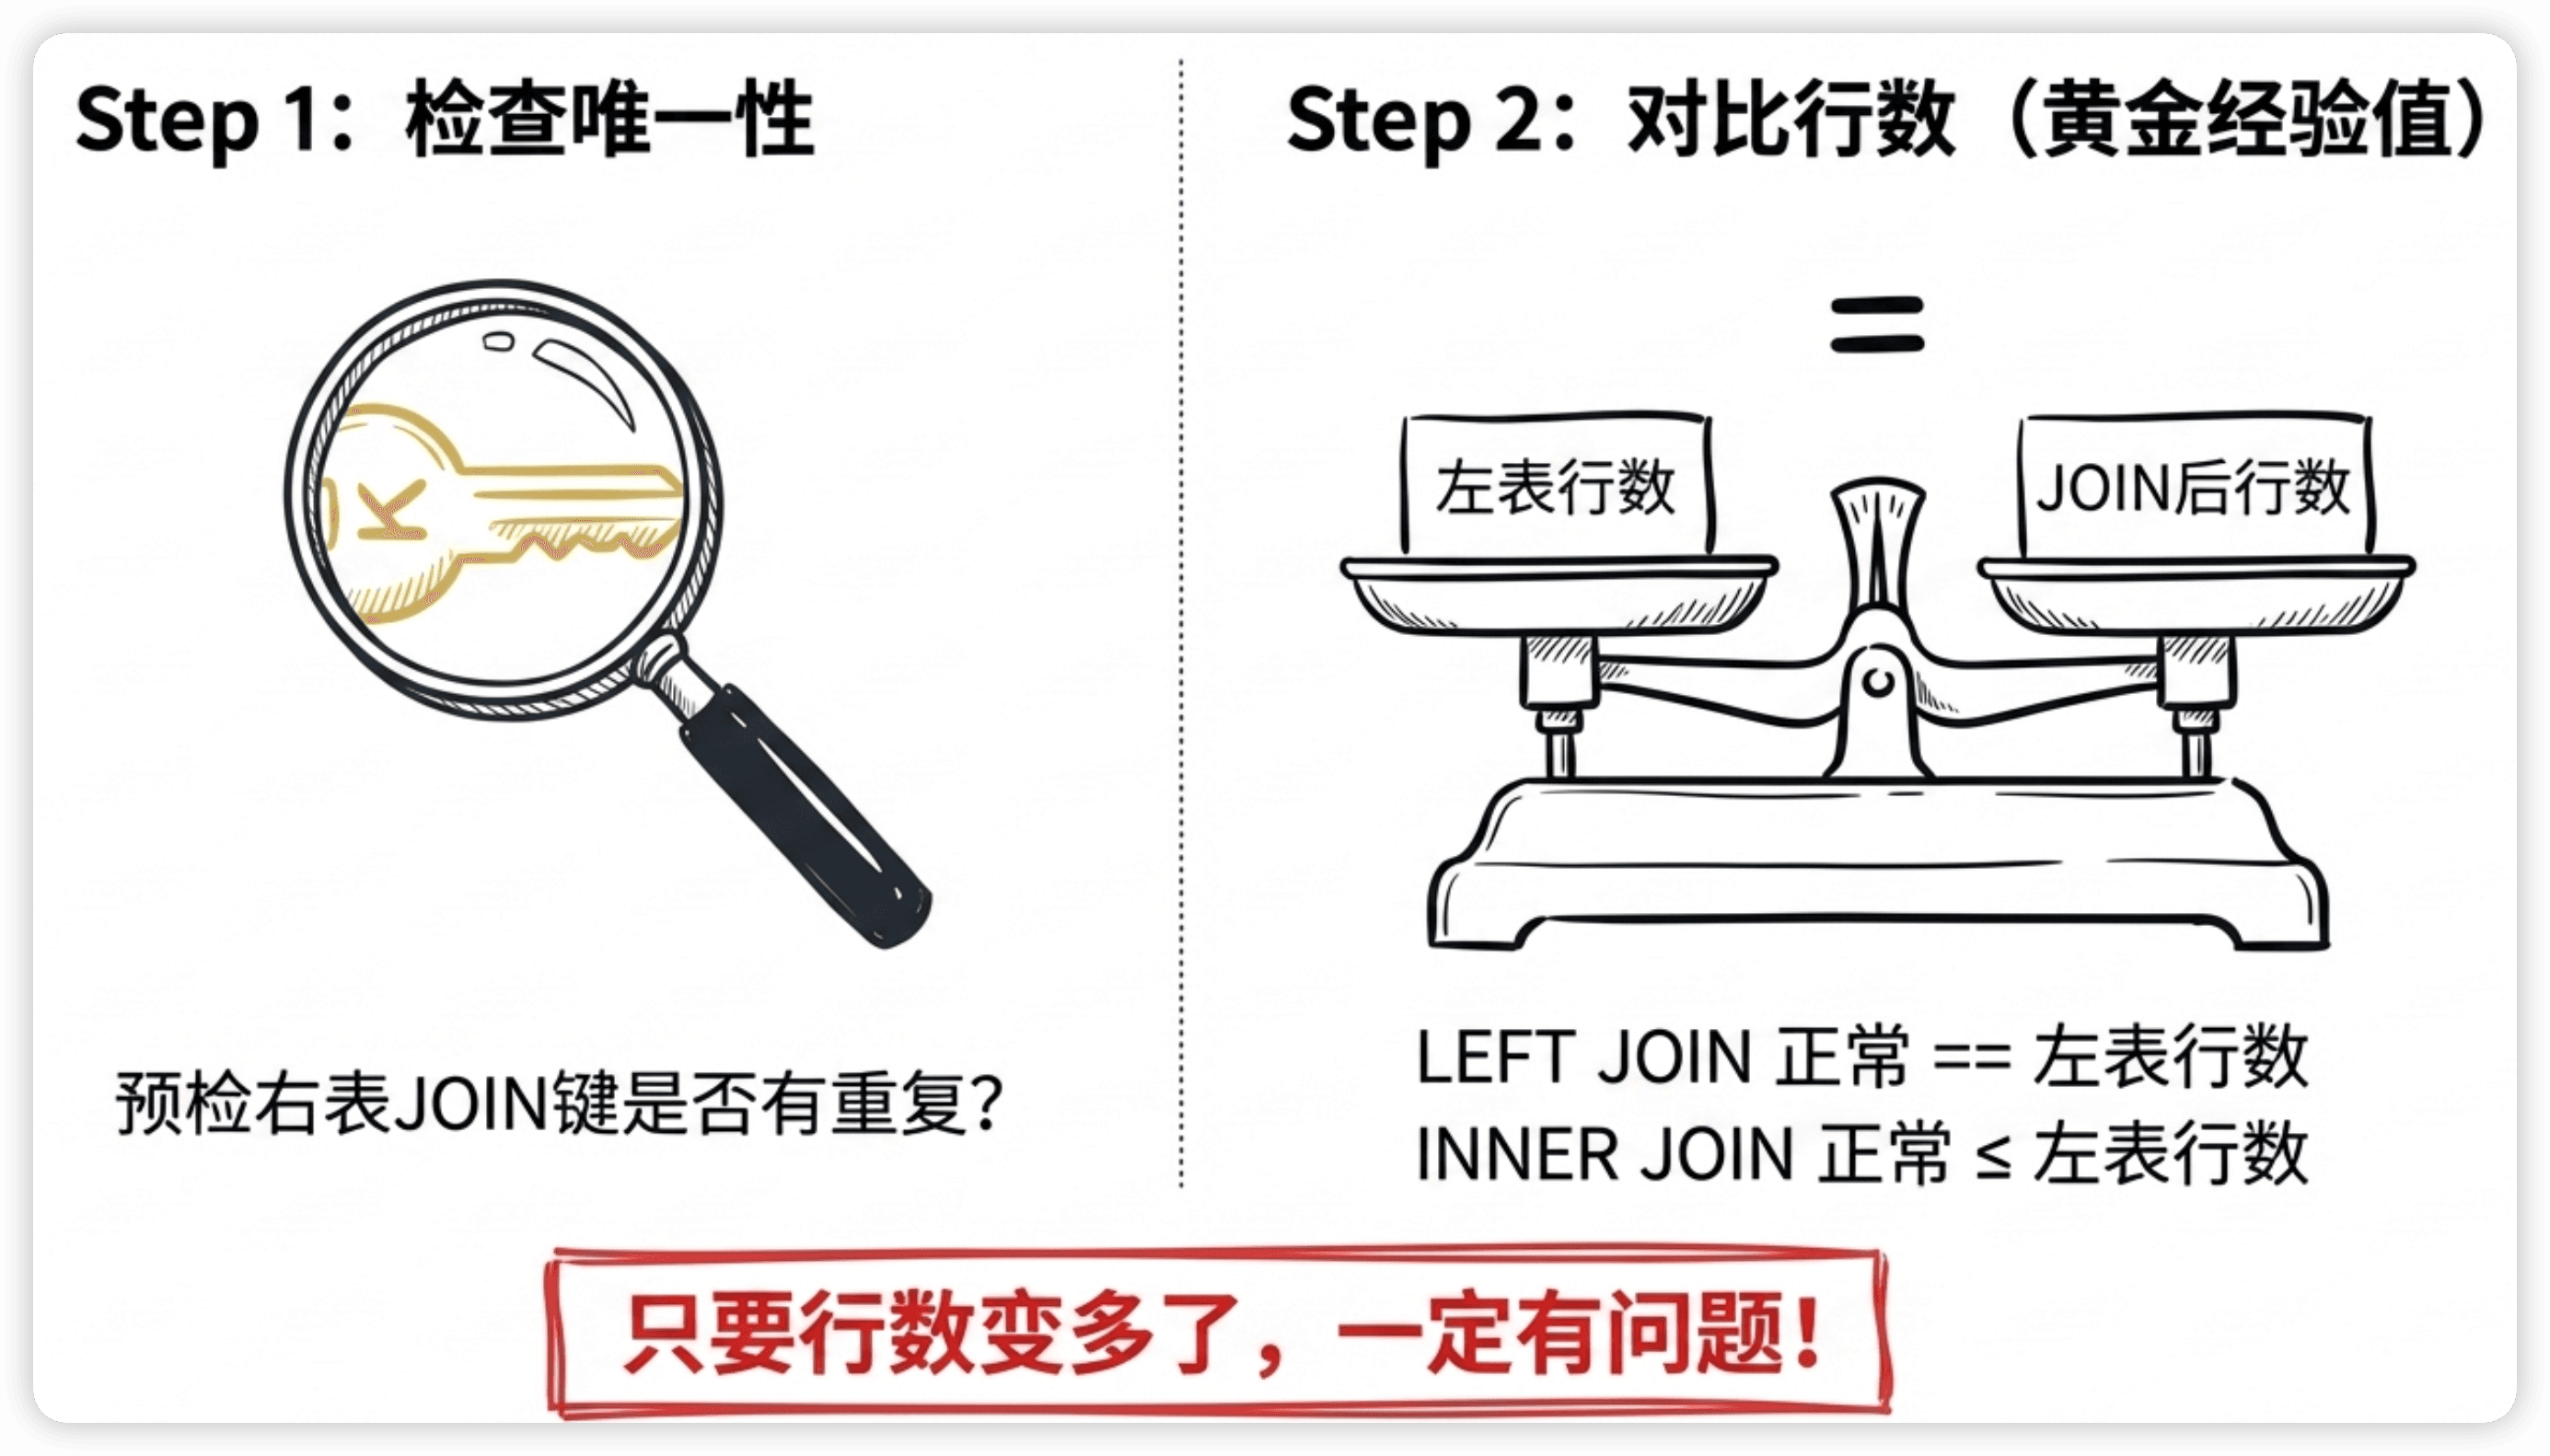
经验值: 正常的LEFT JOIN,行数应该等于左表行数。INNER JOIN可能行数变少(右表没匹配上的被丢弃了)。如果行数变多了,一定有问题。
第三步:定位膨胀的Key
如果确认了膨胀,接下来要找出是哪些Key导致的:
-- 找出JOIN后产生多行的Key
SELECT a.user_id,
    COUNT(*) AS joined_cnt
FROM fact_order a
JOIN dim_user b ON a.user_id = b.user_id
GROUP BY a.user_id
ORDER BY joined_cnt DESC
LIMIT 20;

-- 拿到这些user_id,去维度表里看看为什么有重复
SELECT * FROM dim_user WHERE user_id IN (问题user_id列表);
第四步:确认粒度对齐
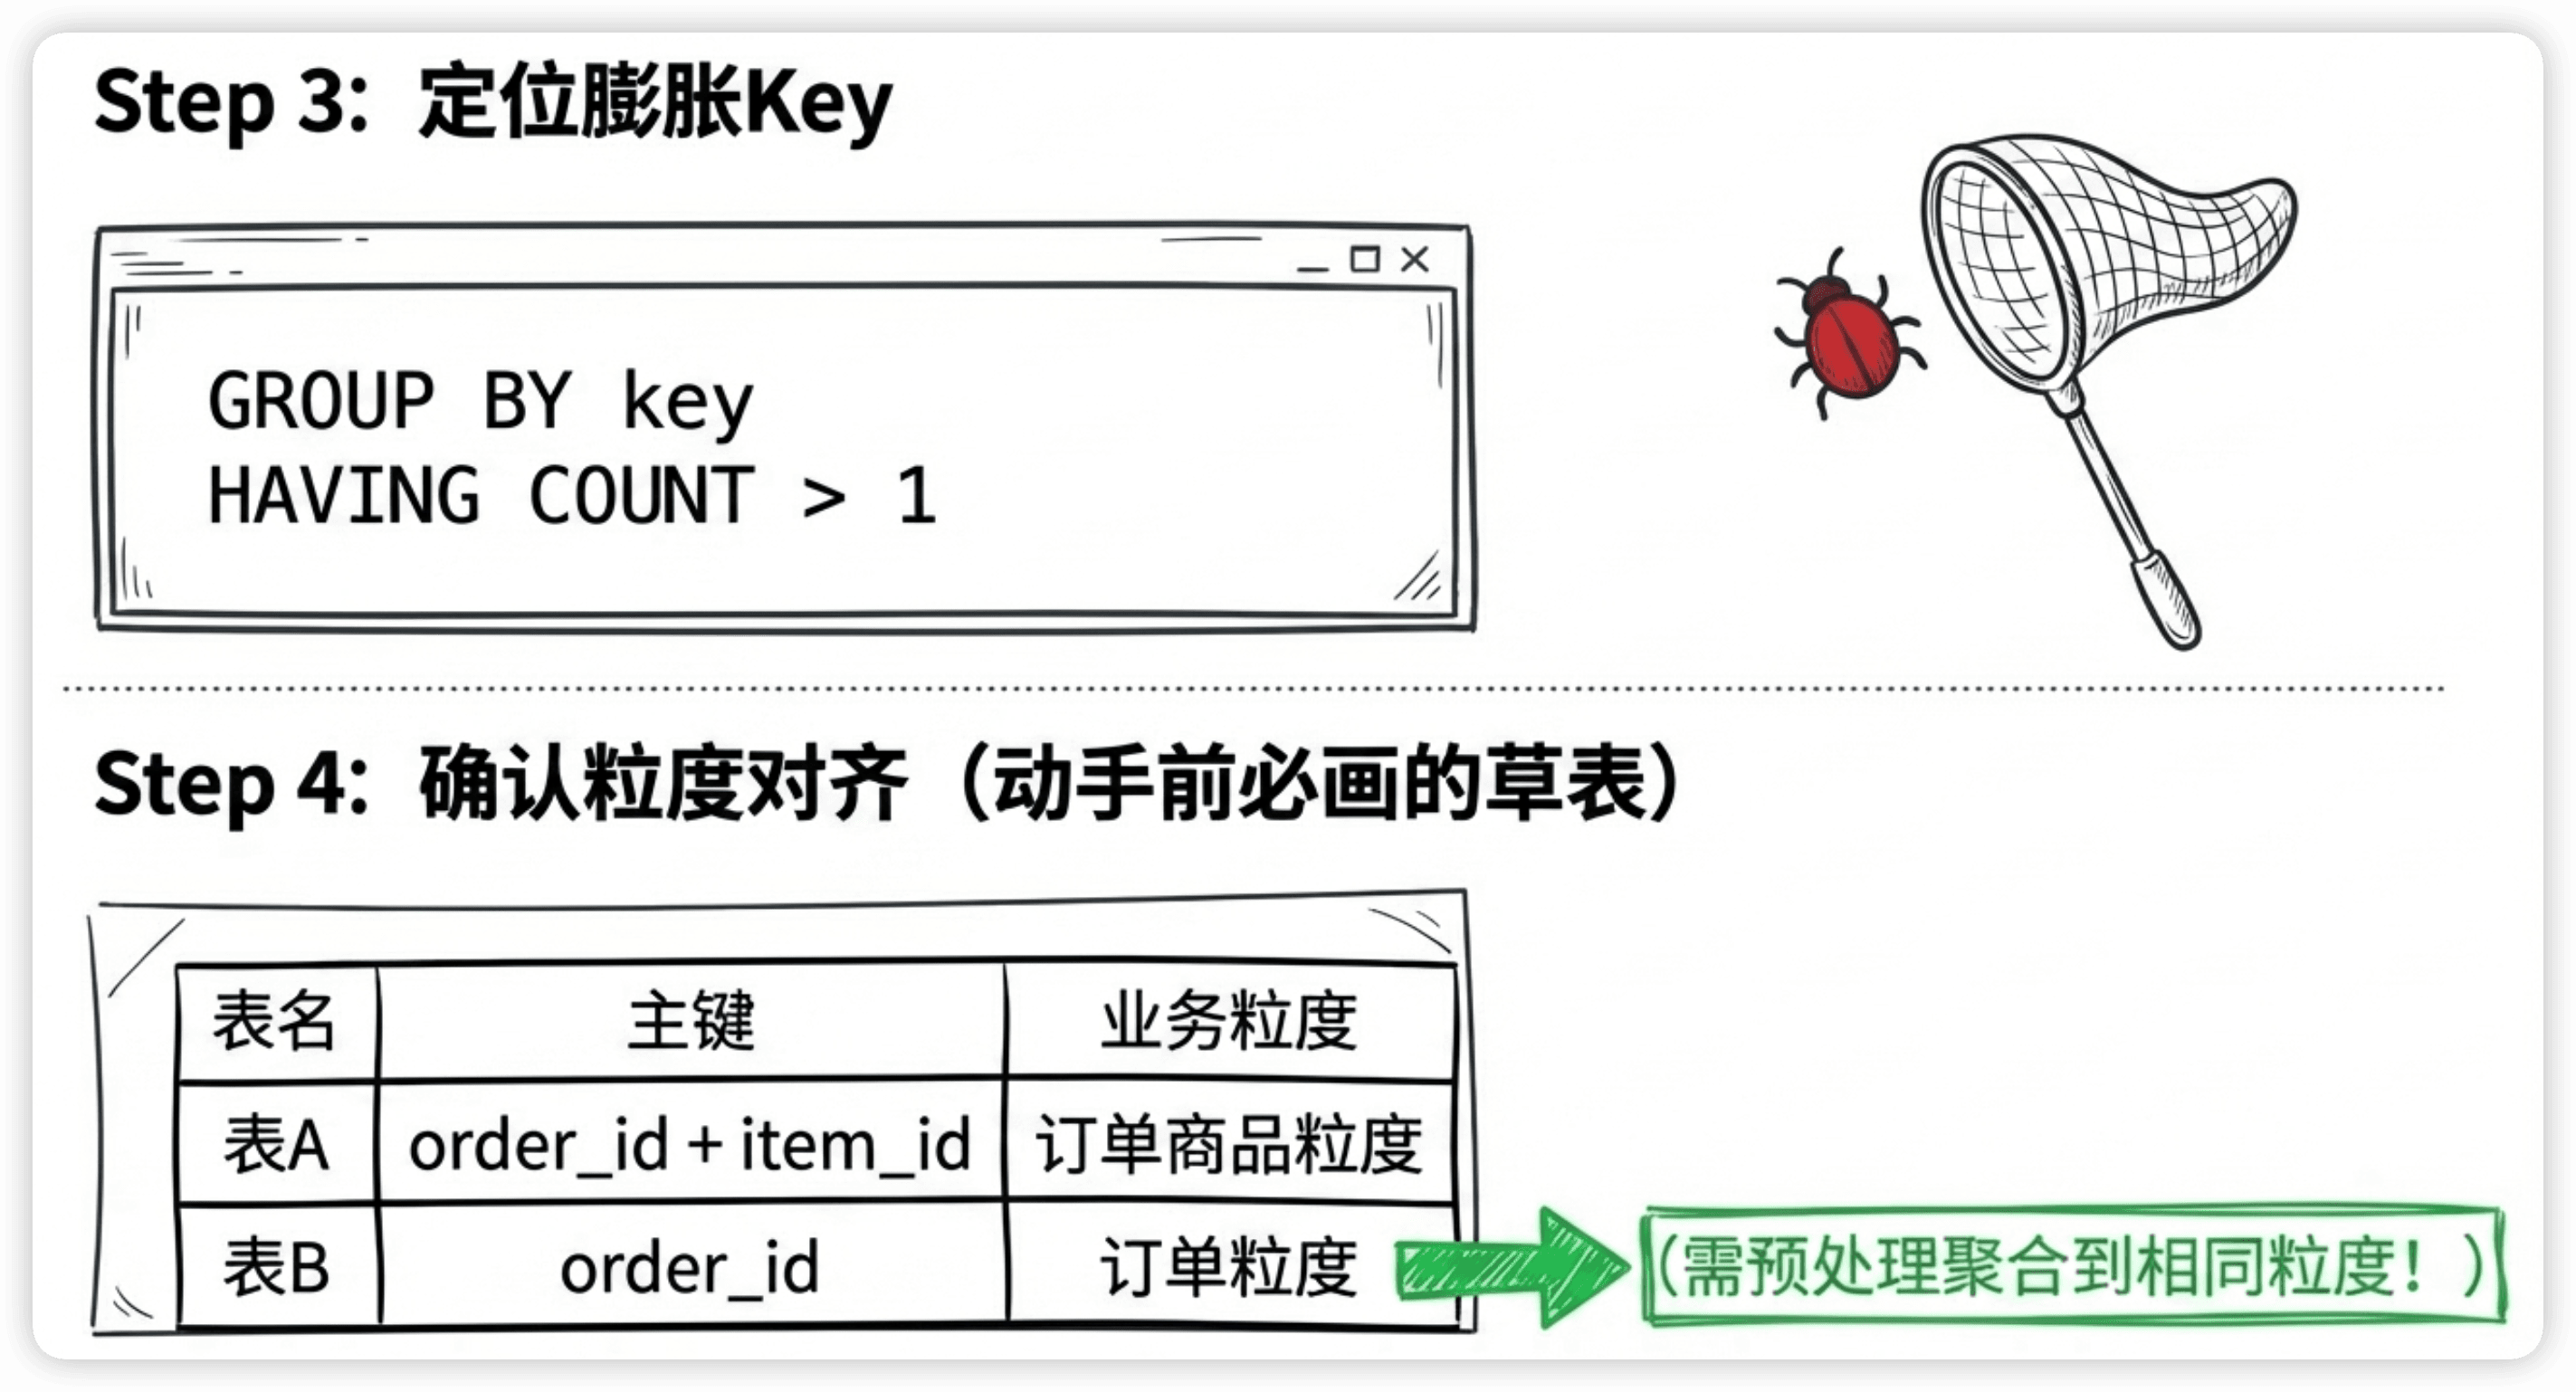
在动手写SQL之前,先画一张粒度对齐表:
┌──────────────────┬───────────────────┬──────────────┐
│ 表名              │ 粒度              │ JOIN键唯一?  │
├──────────────────┼───────────────────┼──────────────┤
│ fact_order_detail │ 一笔订单×一件商品  │ order_id 不唯一│
│ dim_user          │ 一个用户           │ user_id 唯一  │
│ JOIN关系           │ 多对一             │ ✅ 不膨胀     │
├──────────────────┼───────────────────┼──────────────┤
│ fact_order_detail │ 一笔订单×一件商品  │ order_id 不唯一│
│ coupon_usage      │ 一笔订单×一张优惠券│ order_id 不唯一│
│ JOIN关系           │ 多对多             │ ❌ 会膨胀!   │
└──────────────────┴───────────────────┴──────────────┘
2分钟画完这张表,能避免好几个小时的排查时间。
预防机制:ETL加行数校验卡点
排查是事后补救,更重要的是事前预防。
我在团队里推了一个机制:每次ETL的JOIN步骤之后,自动校验行数。行数增长超过阈值就告警,不让错误数据流入下游。
-- ETL中的行数校验卡点
-- 在INSERT之前先检查
WITH join_result AS (
    SELECT f.*, d.user_name, d.city
    FROM fact_order f
    LEFT JOIN dim_user d ON f.user_id = d.user_id AND d.is_current = 1
),
row_check AS (
    SELECT
        (SELECT COUNT(*) FROM fact_order WHERE dt = '${bizdate}') AS src_cnt,
        (SELECT COUNT(*) FROM join_result) AS joined_cnt
)
SELECT
    CASE
        WHEN joined_cnt > src_cnt * 1.01 THEN  -- 膨胀超过1%
            RAISE_ERROR('数据膨胀告警:JOIN后行数增长超过1%')
        WHEN joined_cnt < src_cnt * 0.95 THEN  -- 丢失超过5%
            RAISE_ERROR('数据丢失告警:JOIN后行数减少超过5%')
        ELSE 'PASS'
    END AS check_result
FROM row_check;
实际实现中,不同引擎的告警方式不同。在DataWorks里可以用节点间的数据质量检查组件;在纯SQL调度里可以把检查结果写入一张监控表,外部脚本定期扫描告警。
面试怎么答?
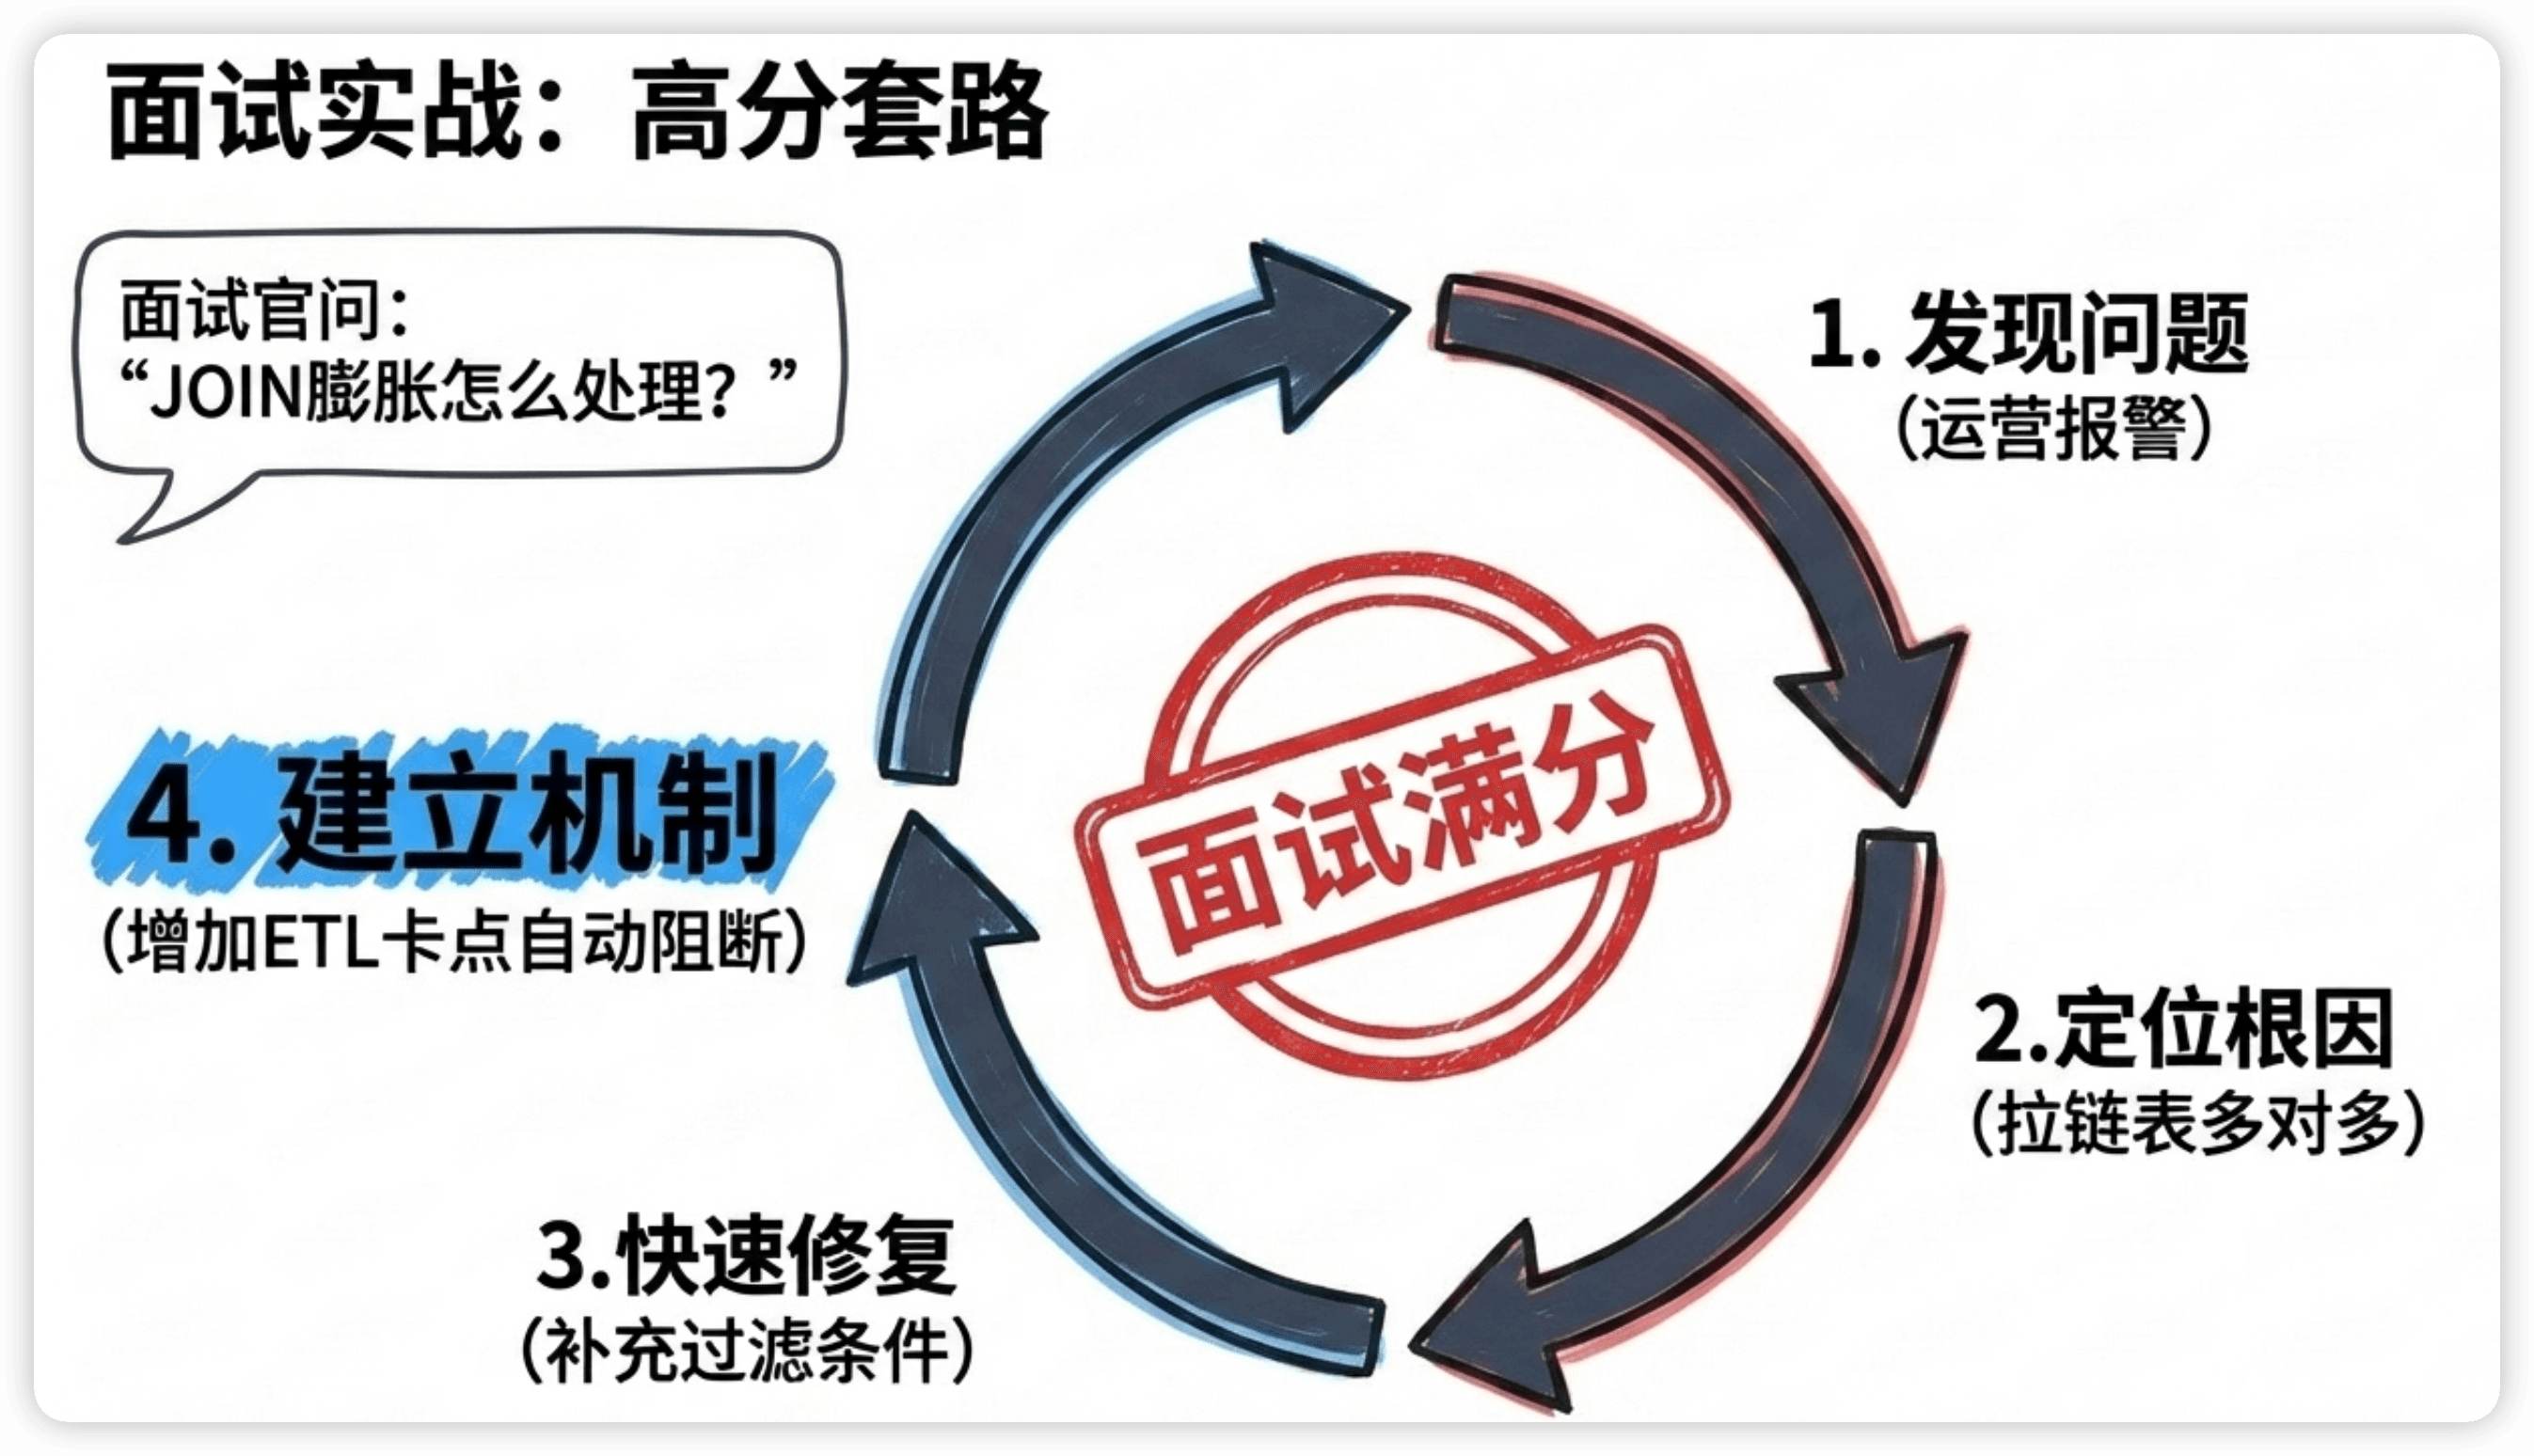
高分回答
「我遇到过一次数据膨胀事故。用户行为宽表的金额指标比源表多了将近一倍,被运营发现后报了上来。排查后发现是用户维度表的拉链表没加is_current过滤,同一个user_id有两条有效记录,JOIN导致行数翻倍。修复很简单——加上
WHERE is_current = 1。但更重要的是预防:我在ETL流程里加了一个行数校验卡点,每次JOIN之后自动对比源表行数,膨胀超过1%就告警阻断,避免问题再次漏到下游。上线后确实拦截过几次类似问题。」
这个回答的结构:发现问题 → 定位根因 → 修复 → 建立预防机制 → 验证效果。有完整闭环。
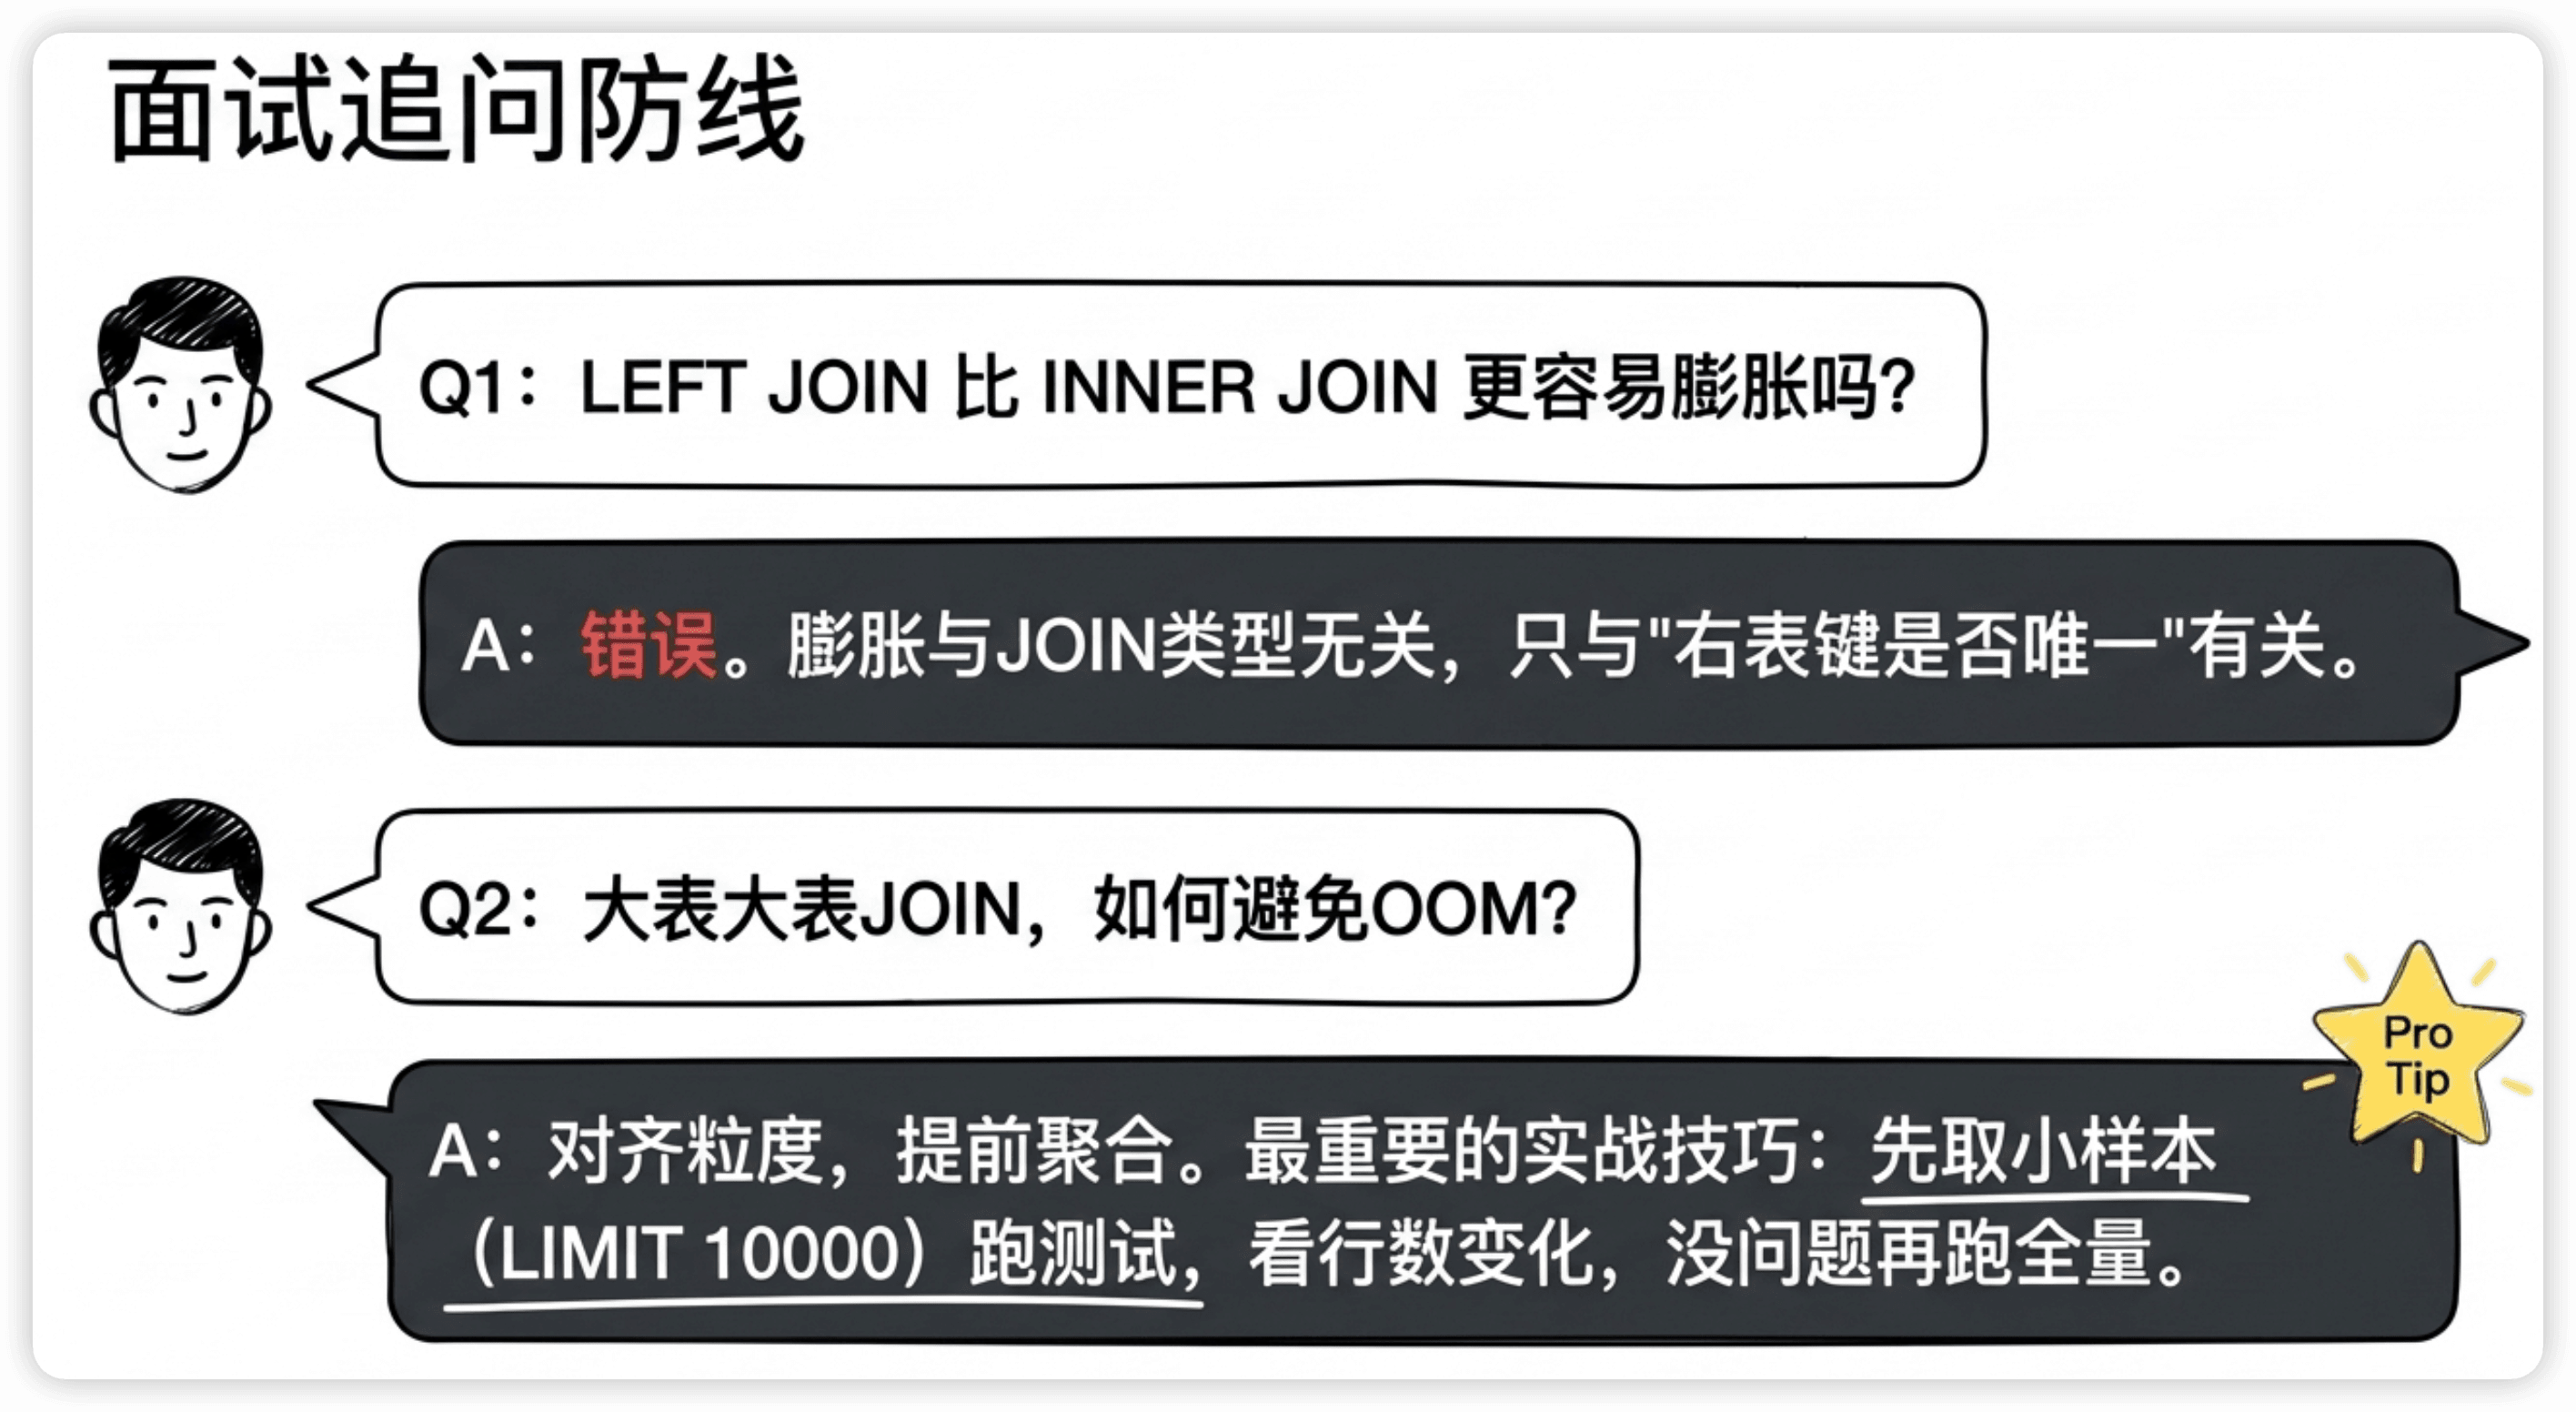
追问防线
追问1:LEFT JOIN和INNER JOIN哪个更容易膨胀?
都一样容易。膨胀的根因是JOIN键不唯一,和JOIN类型无关。不管是LEFT还是INNER,只要右表的JOIN键有重复,就会产生多对多匹配。
区别在于:LEFT JOIN可能还会带来NULL的问题(右表没匹配上的行保留为NULL),但不会导致膨胀。
追问2:大表JOIN大表怎么避免膨胀?
两张大表JOIN的时候,膨胀的后果更严重(原来1亿行变成10亿行,直接OOM)。核心方法还是那几个:JOIN前检查Key唯一性、粒度对齐、如果是多对多就先聚合一边。
另外一个技巧是:先LIMIT小样本测试。在正式跑之前,两张表各取1万行做JOIN,看看行数变化,确认没问题再跑全量。
追问3:有没有"合理的膨胀"场景?
有。如果你的业务需求就是要做"展开"——比如一个订单有3件商品,你就是要把一行展开成3行,分别统计每件商品的销售情况——这种膨胀是预期内的。
关键是你要知道自己在膨胀,并且在下游使用的时候正确处理。比如统计"订单数"的时候要用COUNT(DISTINCT order_id)而不是COUNT(*),统计"订单金额"的时候不能直接SUM(因为同一笔订单金额被重复了)。
总结
- 数据膨胀的根因:JOIN键不唯一,产生多对多关联
- 三大典型场景:维度表主键重复(最常见)、粒度不对齐、天然多对多关系
- 排查四步法:检查唯一性 → 对比行数 → 定位Key → 确认粒度
- 预防机制:ETL里加行数校验卡点,膨胀超阈值自动告警
- 最重要的习惯:每次写JOIN前花2分钟确认粒度和主键唯一性