数仓实战小结
数仓建模系列写到DAY 12,是时候做一篇阶段性的总结了。
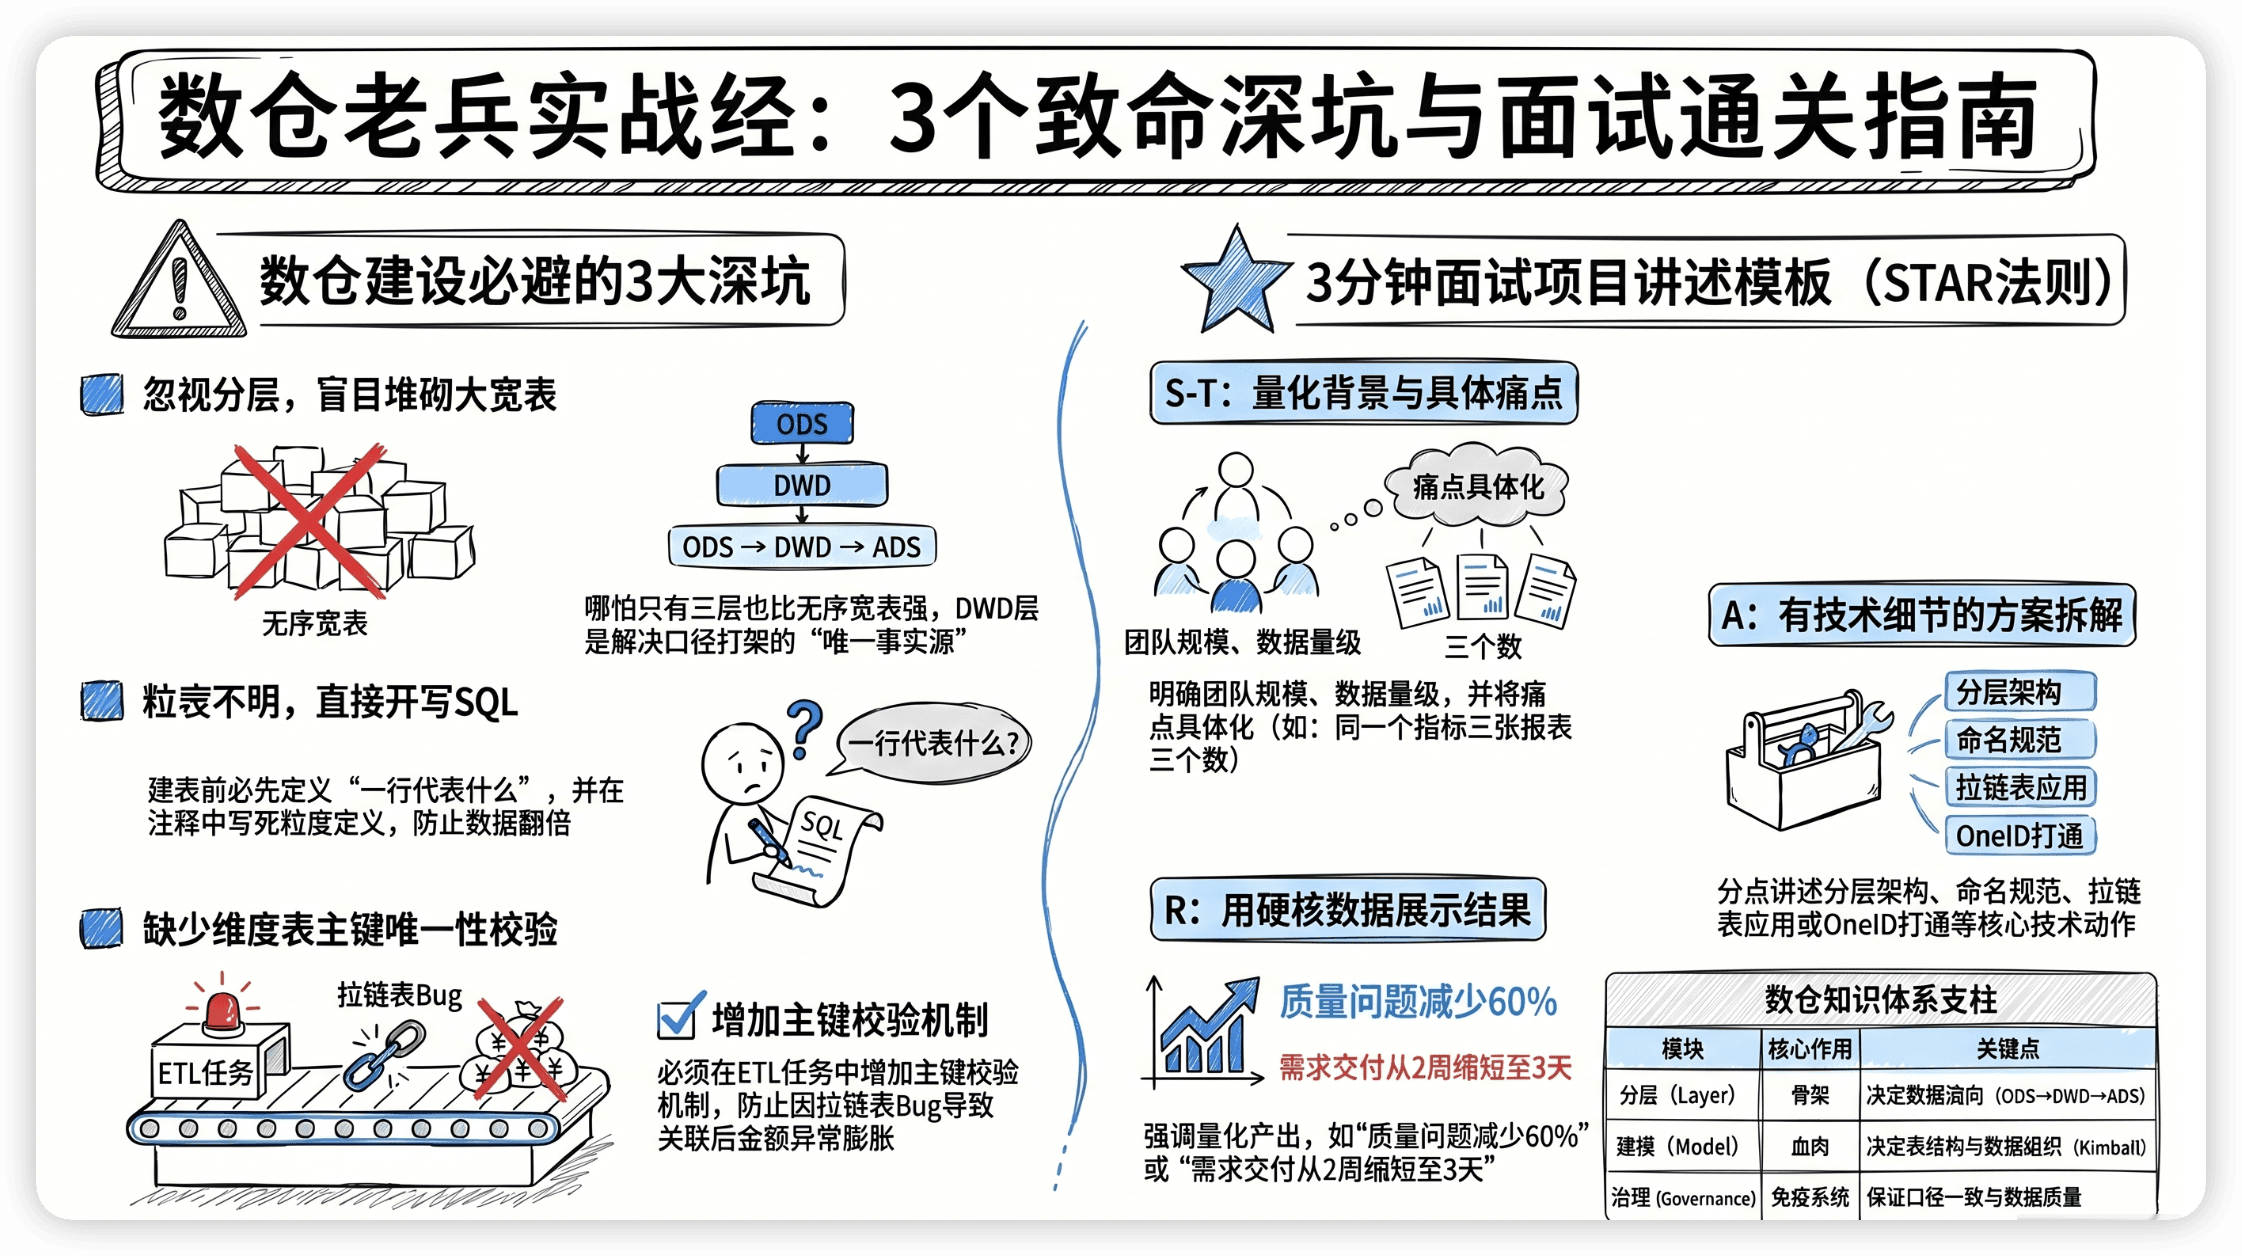
前11天讲的都是"怎么做"——分层怎么设计、星型模型怎么选、拉链表怎么实现、口径怎么治理。今天换一个角度,聊聊"做的时候会踩什么坑",以及面试时怎么把这些知识串成一个完整的项目故事。
9年,4家公司,从从0建数仓到平台迁移到重构优化,我踩过的坑可能比你想象的多。
我的4段数仓经历
| 阶段 | 公司 | 数仓状态 | 我的角色 |
|---|---|---|---|
| 起步期 | 某短视频平台(2016-2019) | 没有数仓,全是临时脚本 | 从0搭建,能用就行 |
| 建设期 | 某元宇宙社交App(2019-2021) | 有基础分层但混乱 | 梳理规范,建实时数仓 |
| 成熟期 | 某出海硬件品牌(2021-2023) | 完整数仓,要迁移平台 | EMR→Databricks迁移+治理 |
| 优化期 | 某短剧出海公司(2024-至今) | 有数仓但需要重构 | SQL治理+指标规范化 |
每个阶段的侧重点完全不同,但建模的基本功是相通的。今天把每个阶段踩过的典型坑分享出来。
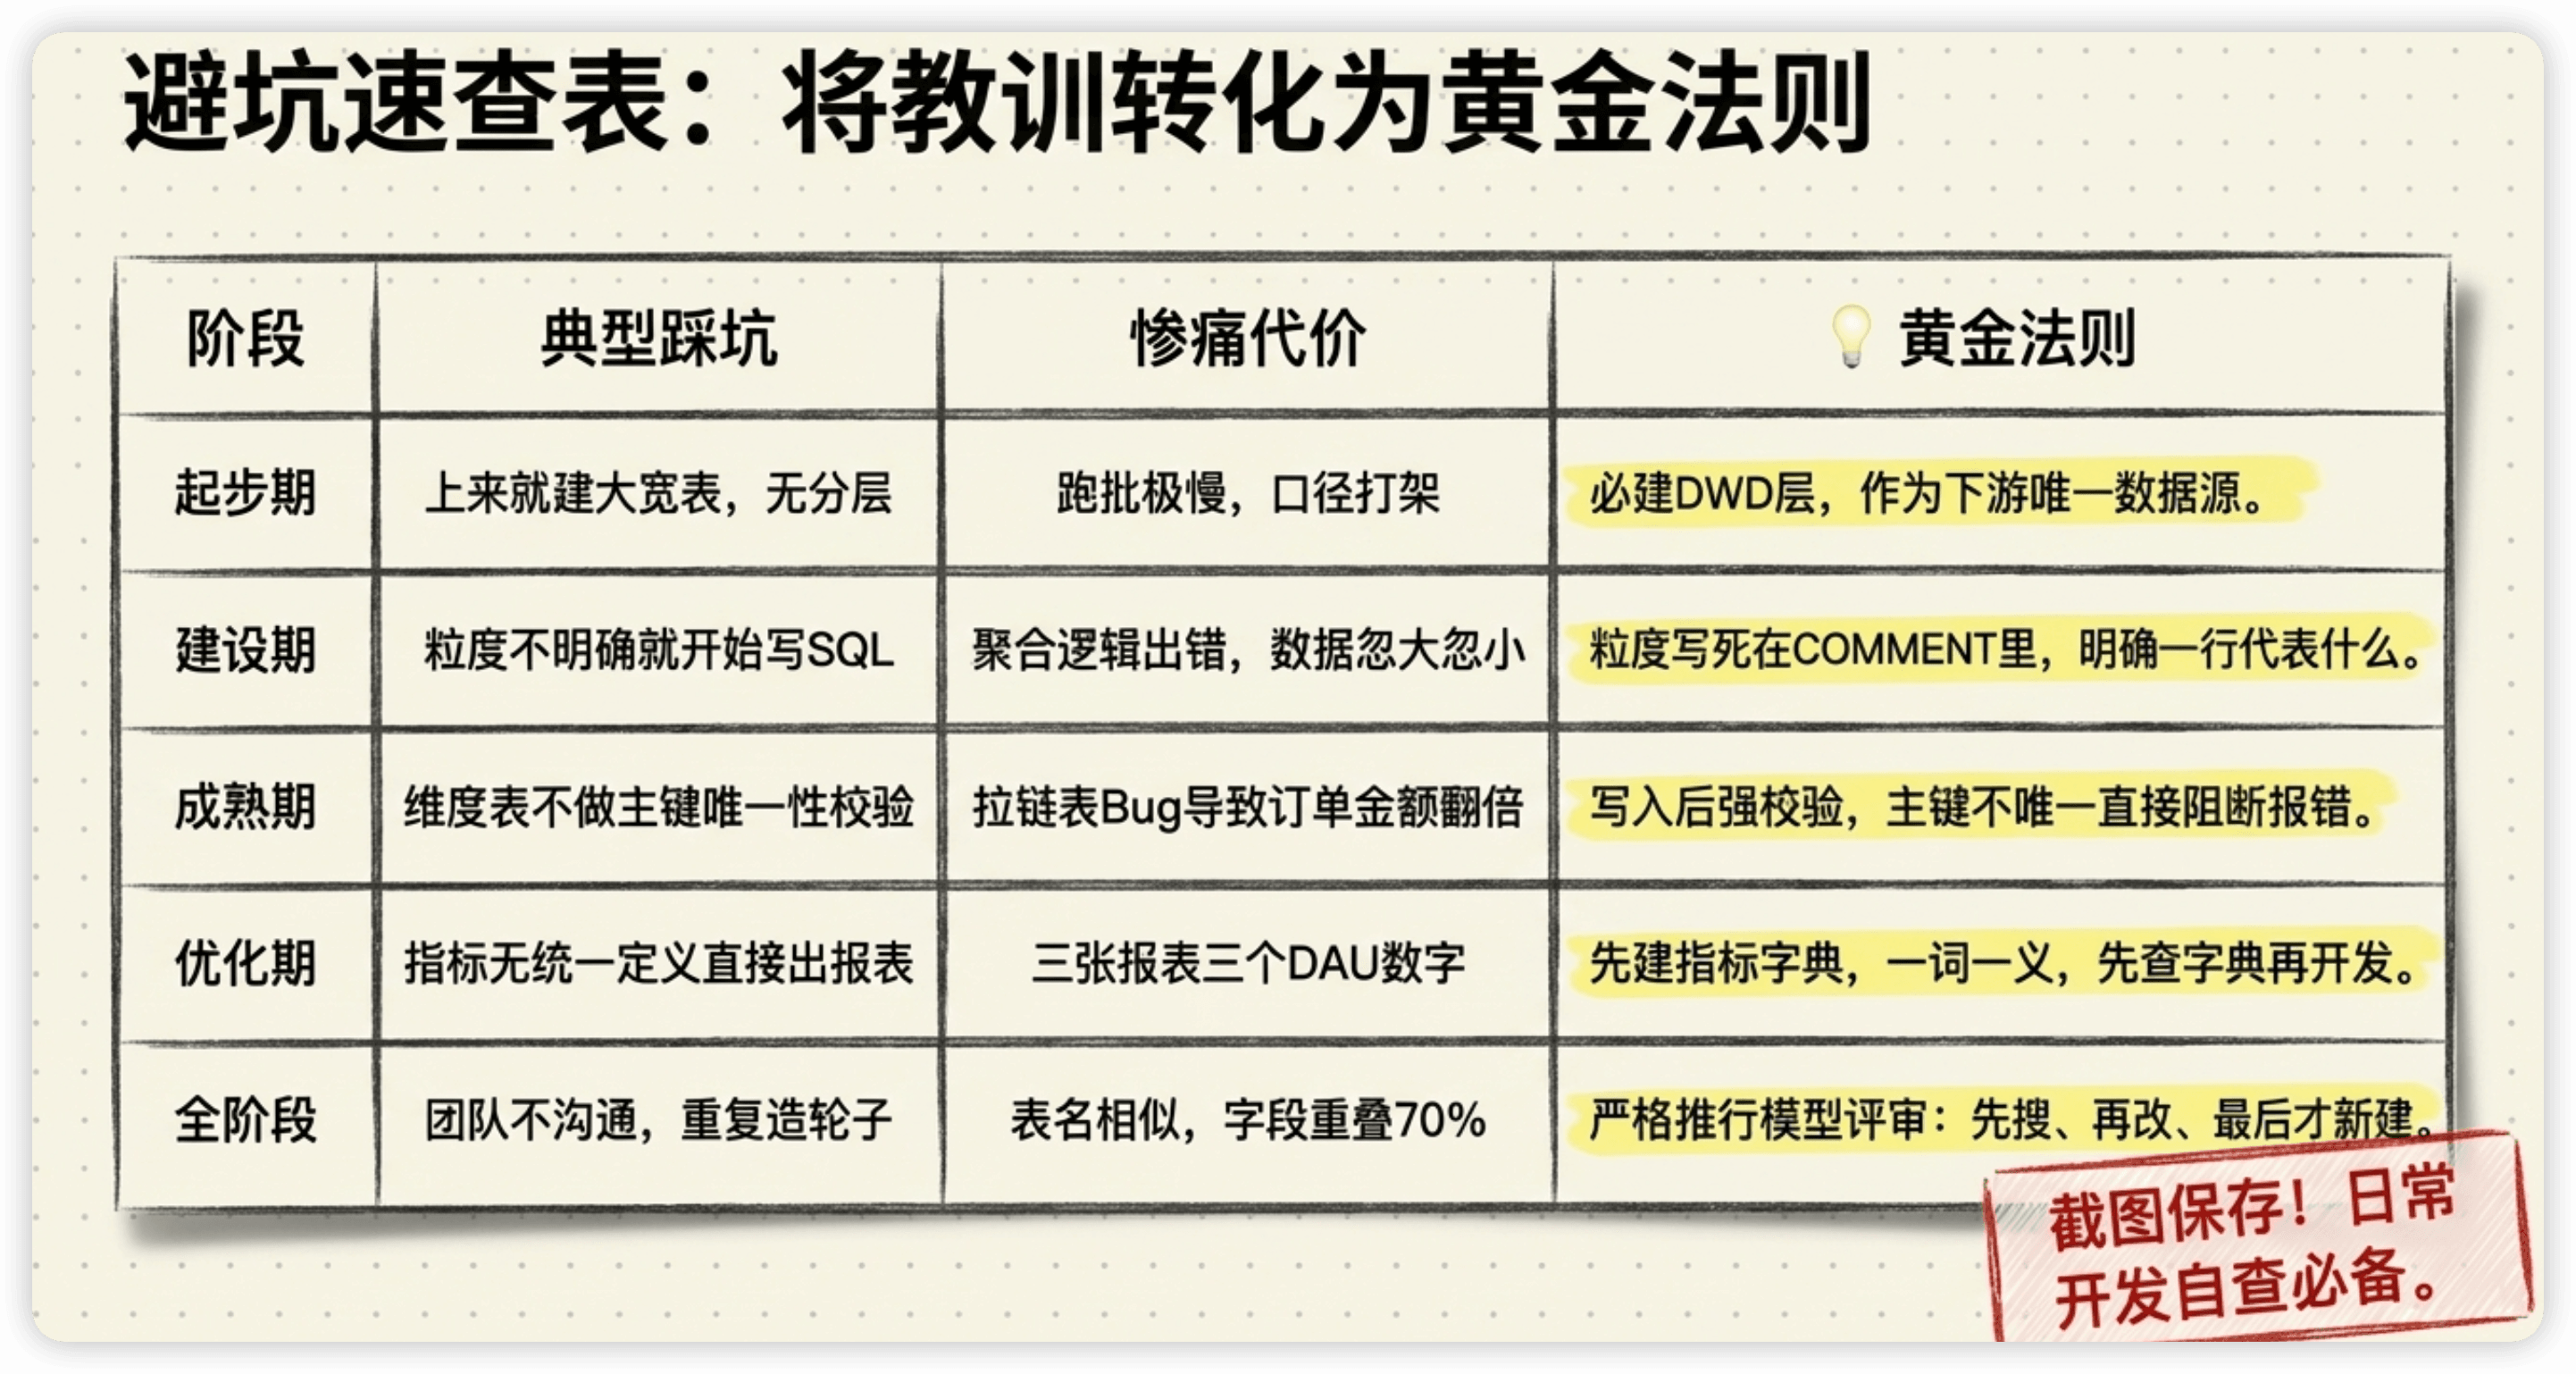
最常踩的5个坑
坑一:上来就建宽表,不做分层
踩坑阶段: 起步期。
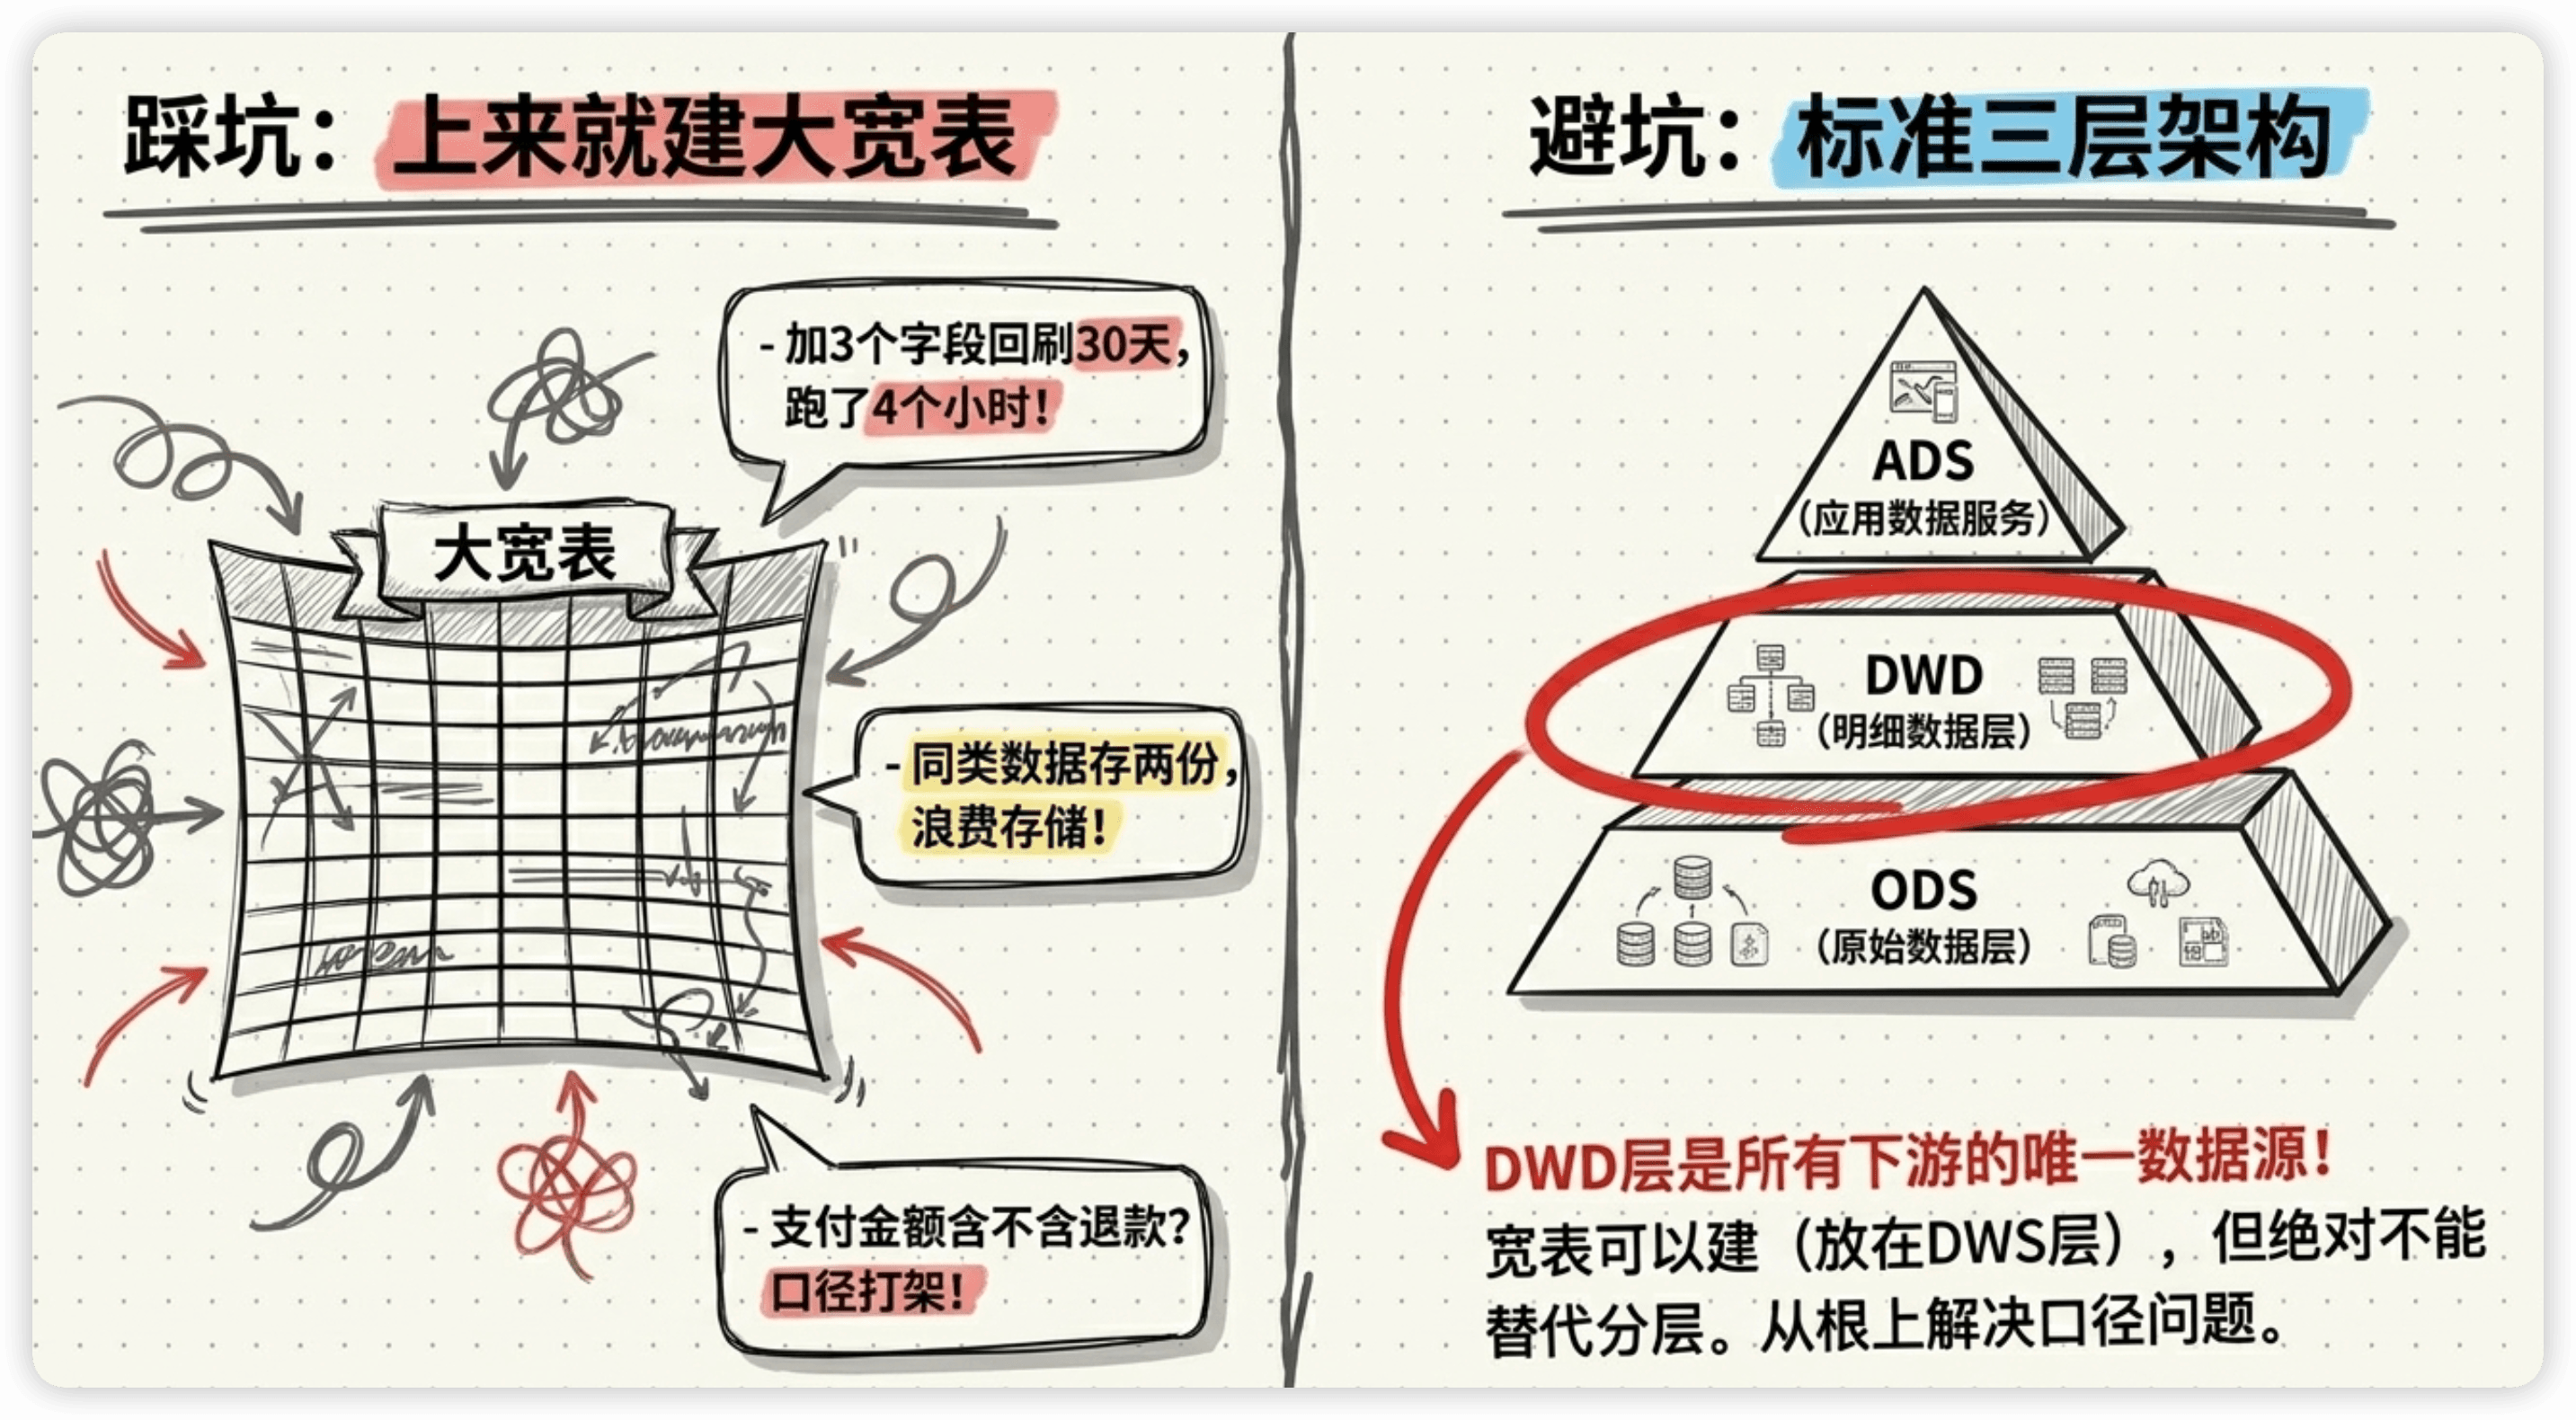
刚入行的时候,业务方说"我要一张表,包含订单信息、用户信息、商品信息",我的第一反应是——好,搞一张大宽表把所有东西JOIN到一起。
一开始确实管用。但很快问题就来了:
- 产品加了一个新功能,要在宽表里加3个字段,回刷30天历史,跑了4个小时
- 另一个业务方也要看订单数据,但维度不同,又建了一张宽表——同样的数据存了两份
- 两张宽表的"支付金额"定义不一样,一个含退款一个不含,口径开始打架
教训: 再简陋也要做分层。哪怕只有ODS→DWD→ADS三层,也比一堆宽表强100倍。DWD层是所有下游的"唯一数据源",口径问题从根上解决。宽表可以建,但应该放在DWS层,而不是替代分层。
坑二:粒度不明确就开始写SQL
踩坑阶段: 建设期。
在元宇宙社交App的时候,有一次建了一张DWS表,当时没仔细想粒度——到底是"一行一个用户"还是"一行一个用户×一天"。
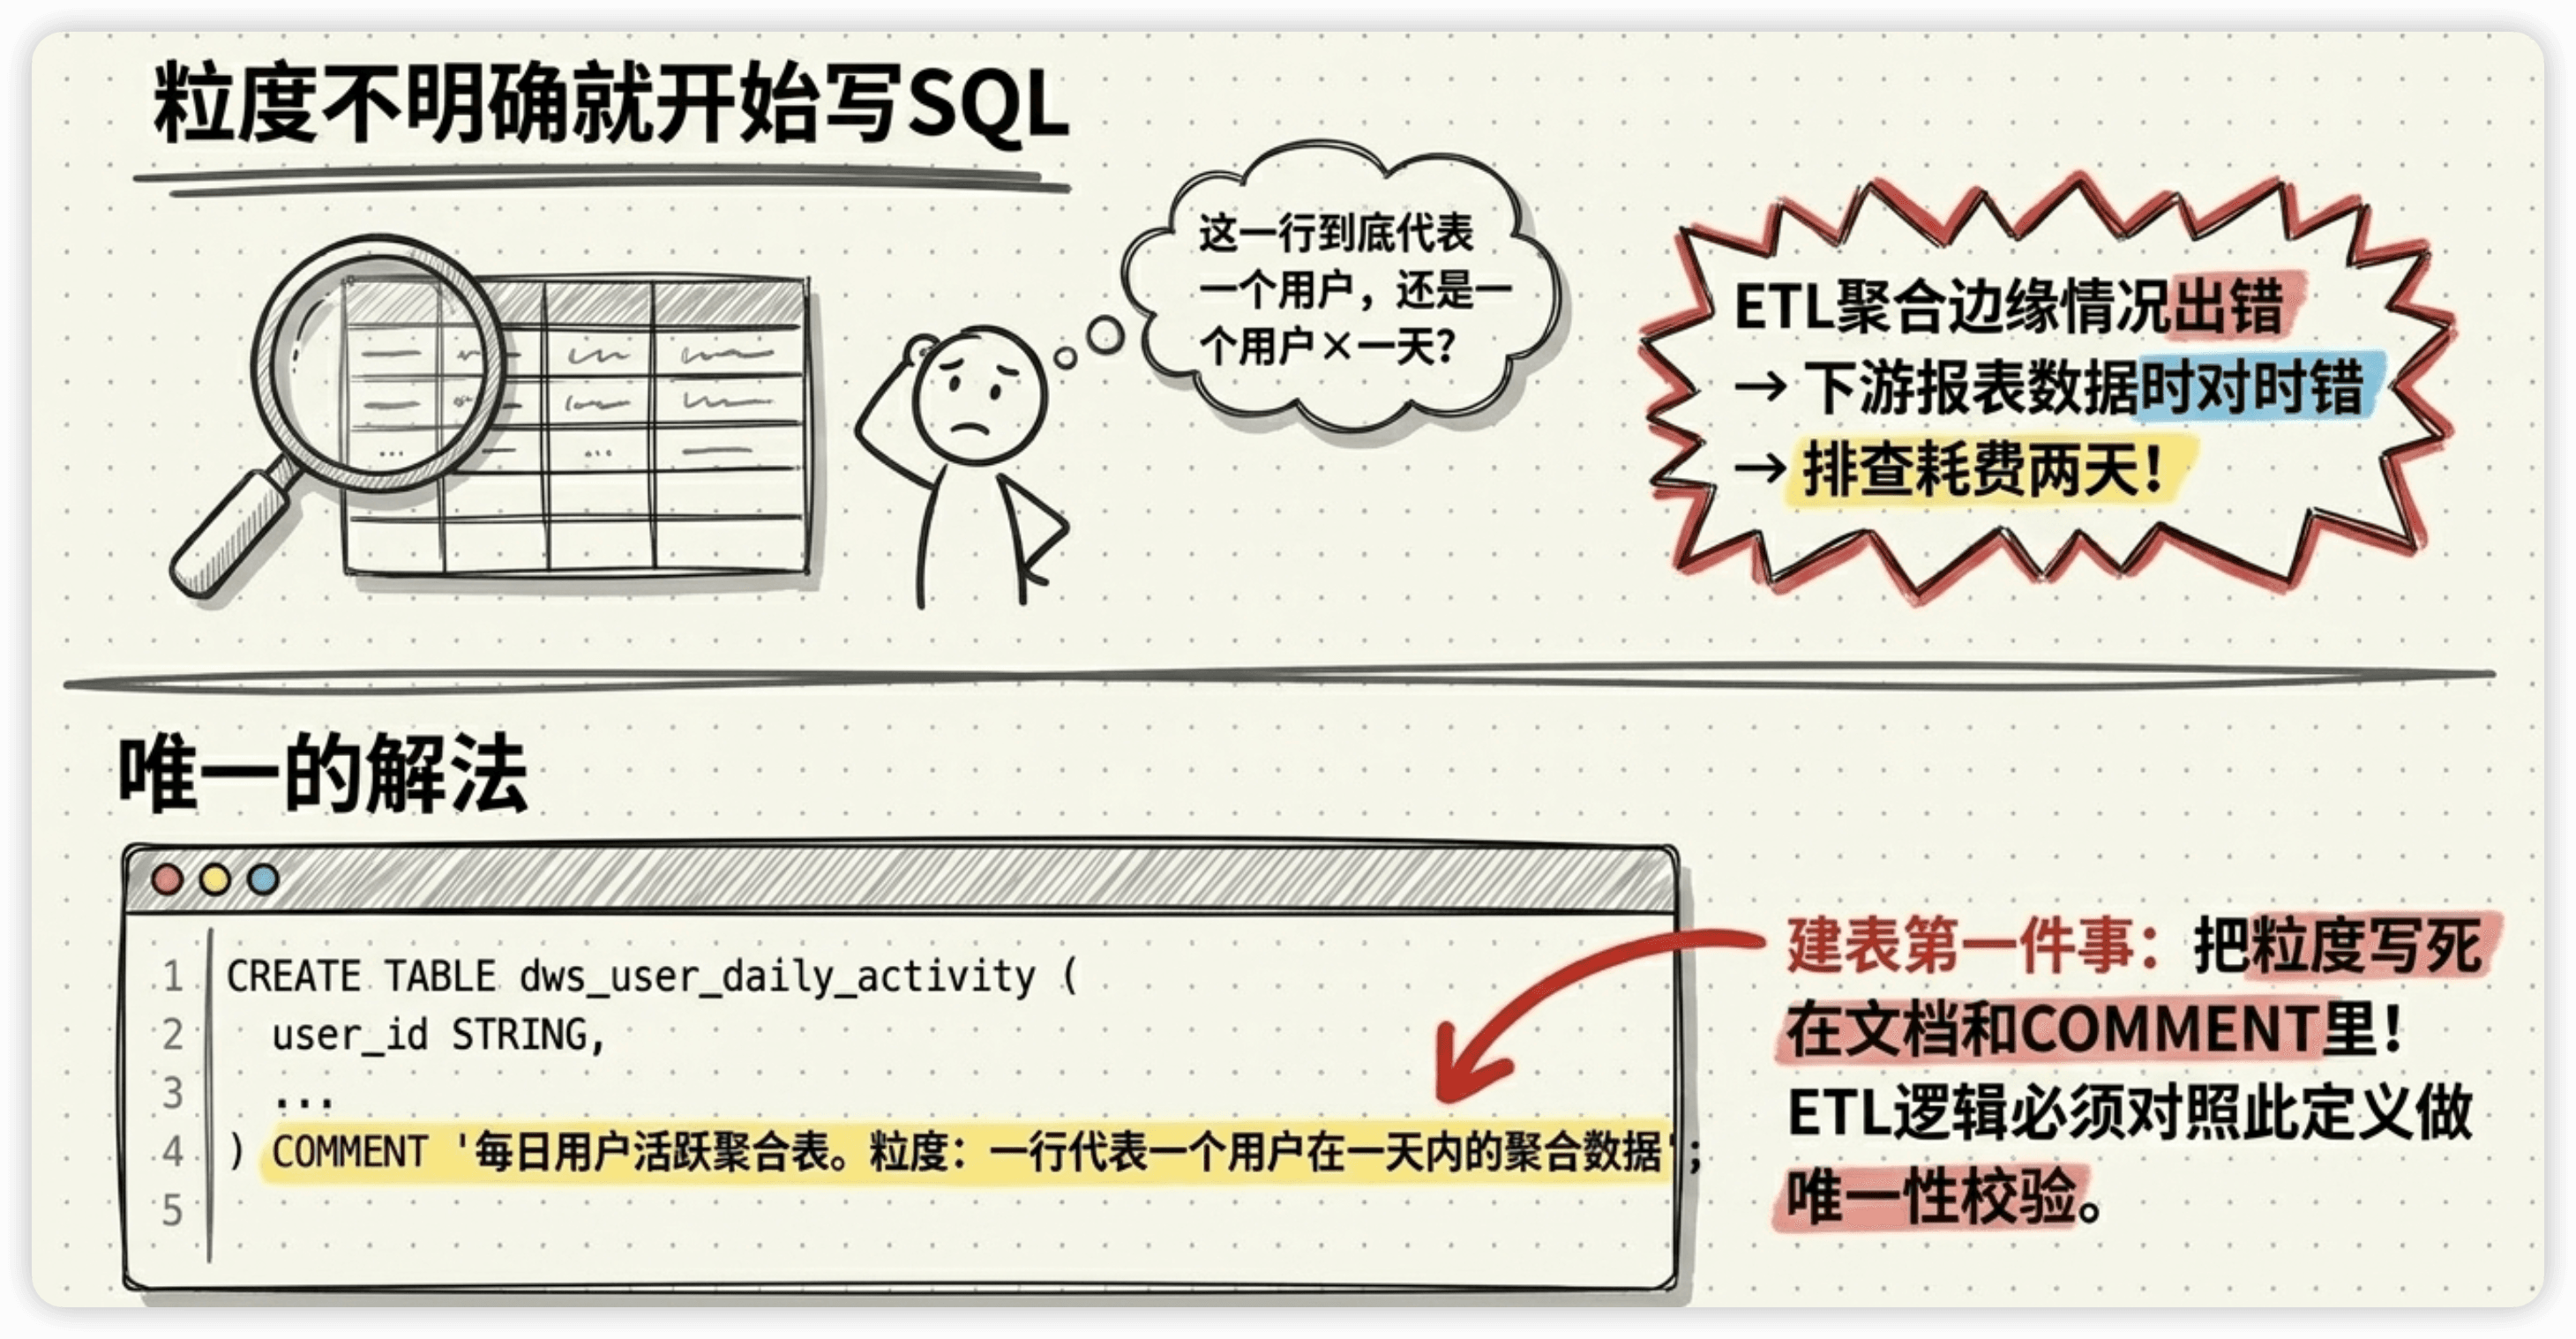
结果数据进来后,有的天一个用户一行,有的天一个用户多行(因为ETL逻辑在某些edge case下没有正确聚合)。下游报表的数字一会对一会不对,排查了两天才发现根因。
教训: 新建一张表,第一件事不是写SQL,而是在文档里写一句话——"一行数据代表什么"。我现在的习惯是在建表语句的COMMENT里把粒度写死:
CREATE TABLE dws_user_behavior_1d (
    ...
) COMMENT '用户行为汇总-天级 | 粒度:一个user_id × 一天 | 主键:user_id + dt';
这样任何人看到这张表,第一眼就知道粒度。ETL逻辑也能对照这个定义做唯一性校验。
坑三:维度表不做主键校验,金额翻倍
踩坑阶段: 成熟期。
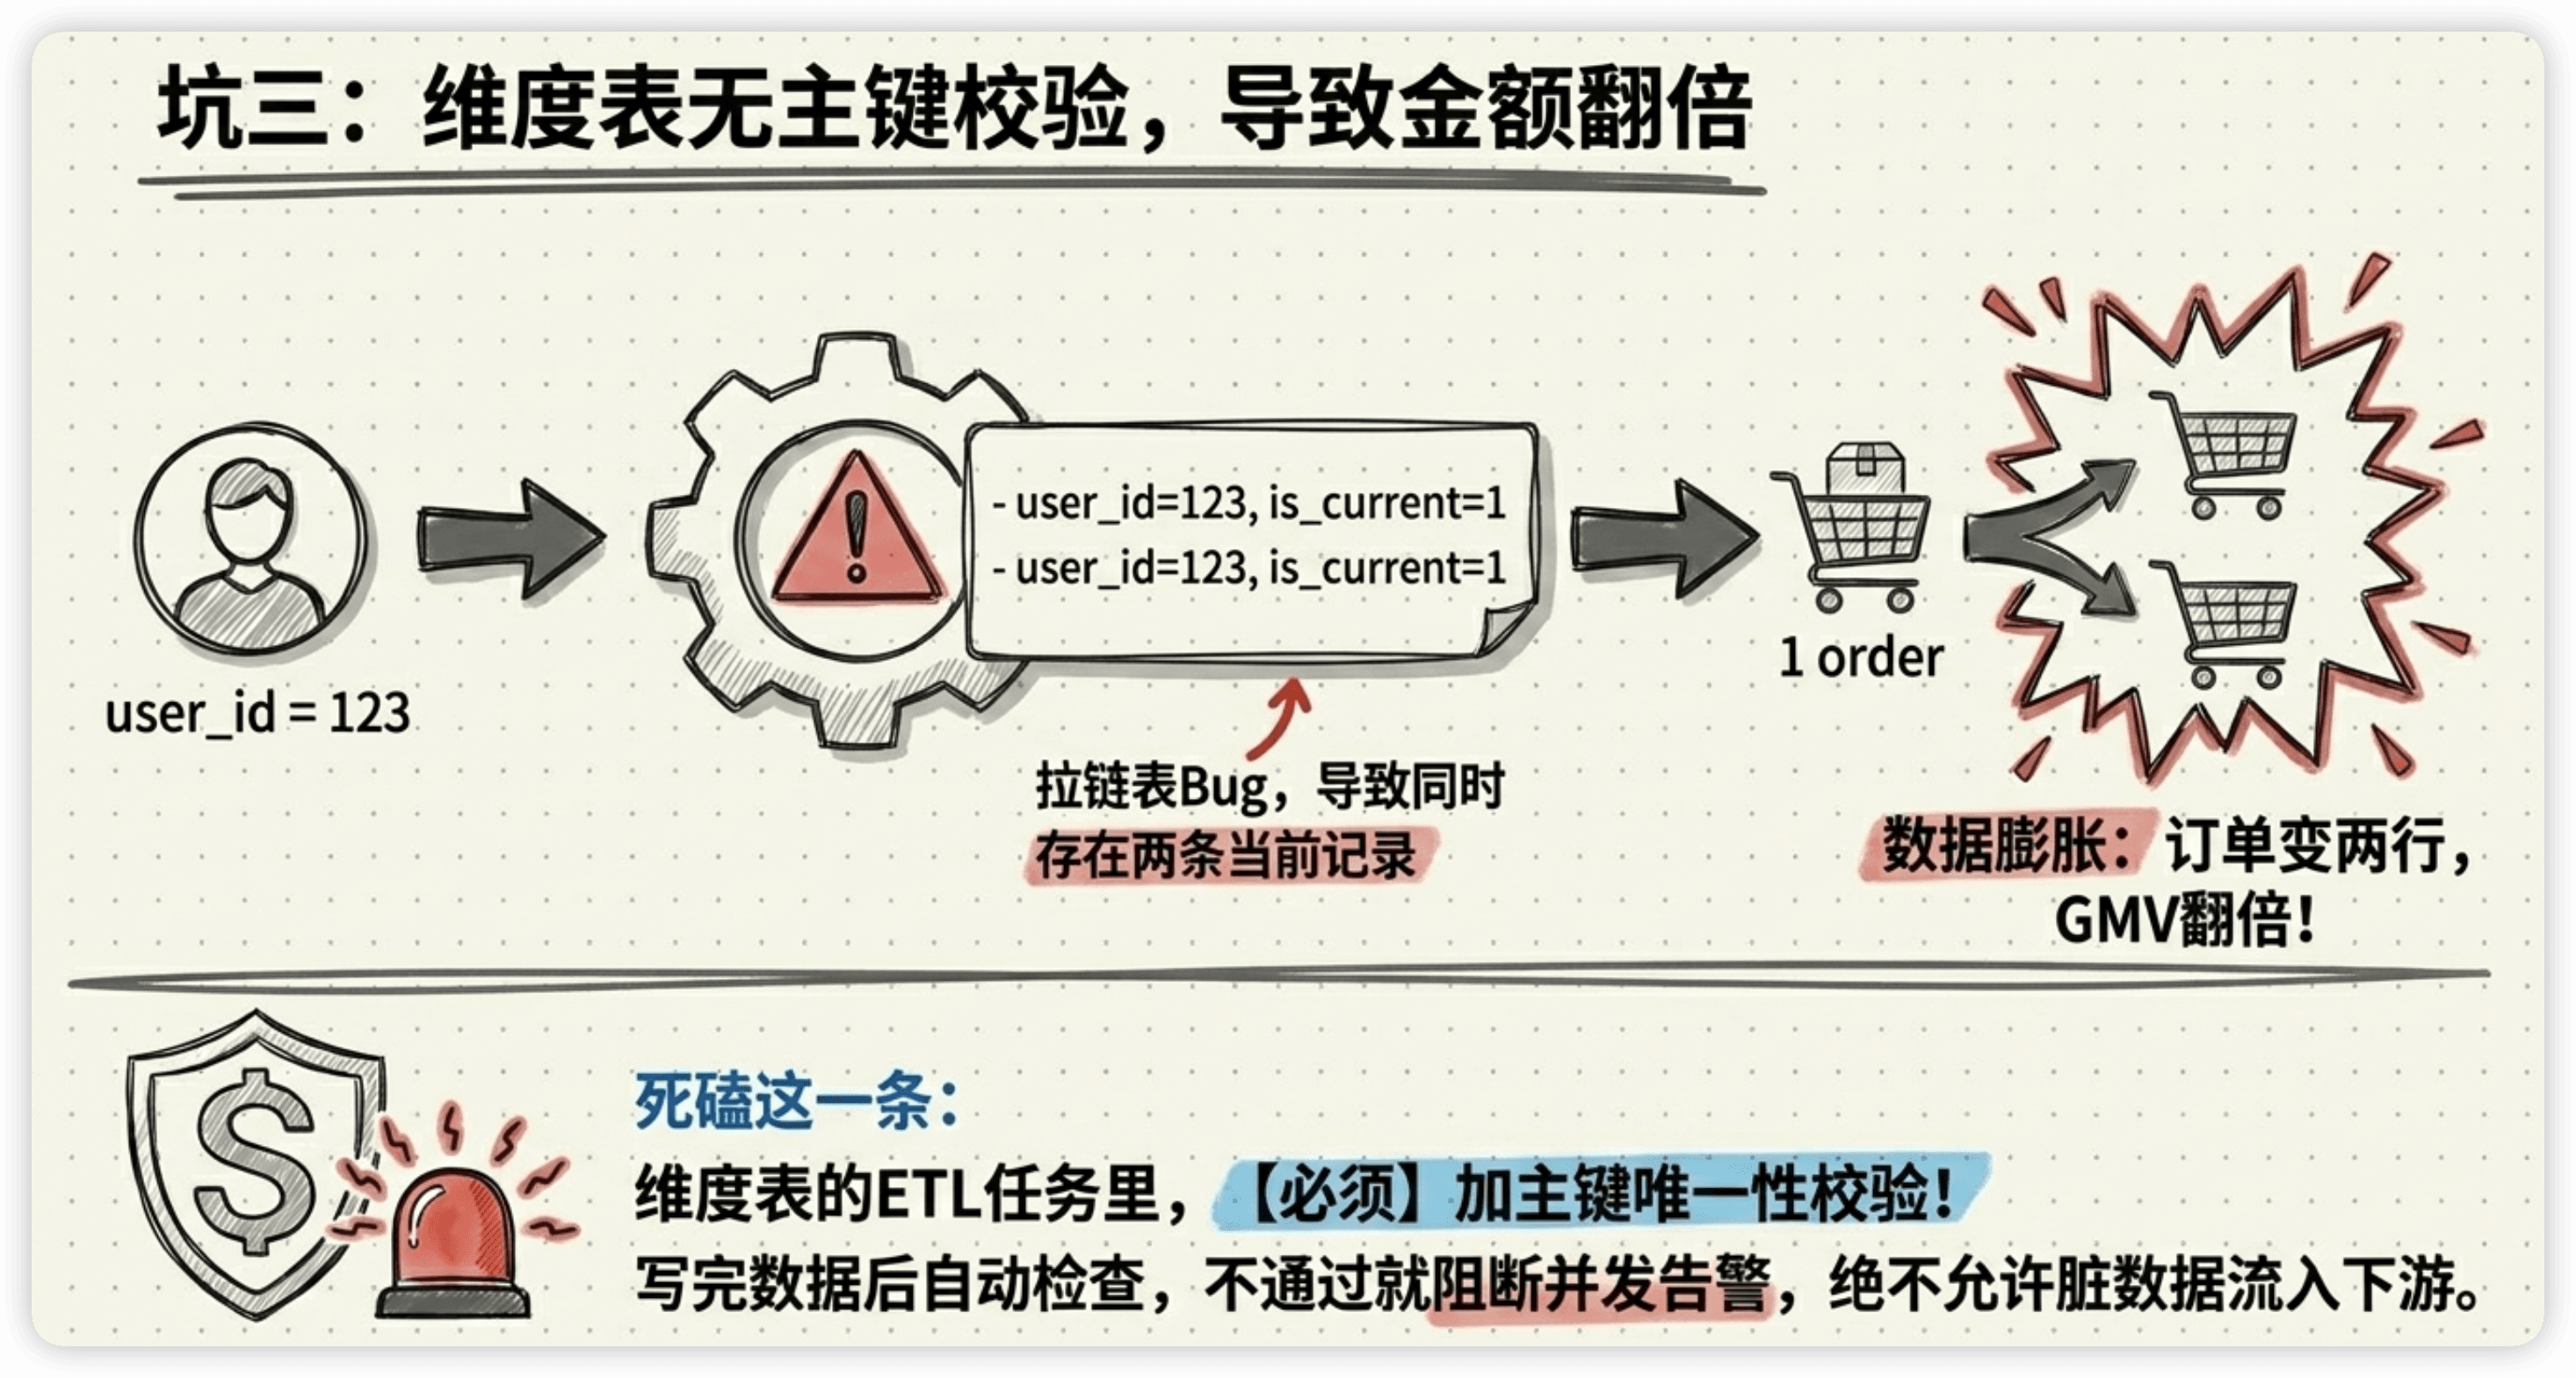
在出海硬件品牌做Databricks迁移的时候,迁移后的DWS表跑出来金额比迁移前多了将近一倍。排查后发现是用户维度表的拉链表有Bug——迁移脚本在处理is_current标记时出了问题,同一个user_id有两条is_current=1的记录。JOIN之后每笔订单变成两行,金额翻倍。
DAY 7讲的数据膨胀问题,我自己就是受害者。
教训: 维度表的ETL任务里必须加主键唯一性校验。每次写完数据后自动检查,不通过就不允许写入下游,并发告警。
-- 维度表写入后的自动校验
SELECT user_id, COUNT(*) AS cnt
FROM dim_user WHERE is_current = 1
GROUP BY user_id HAVING cnt > 1;
-- 如果有结果,阻断下游任务并告警
坑四:指标没有统一定义就开始出报表
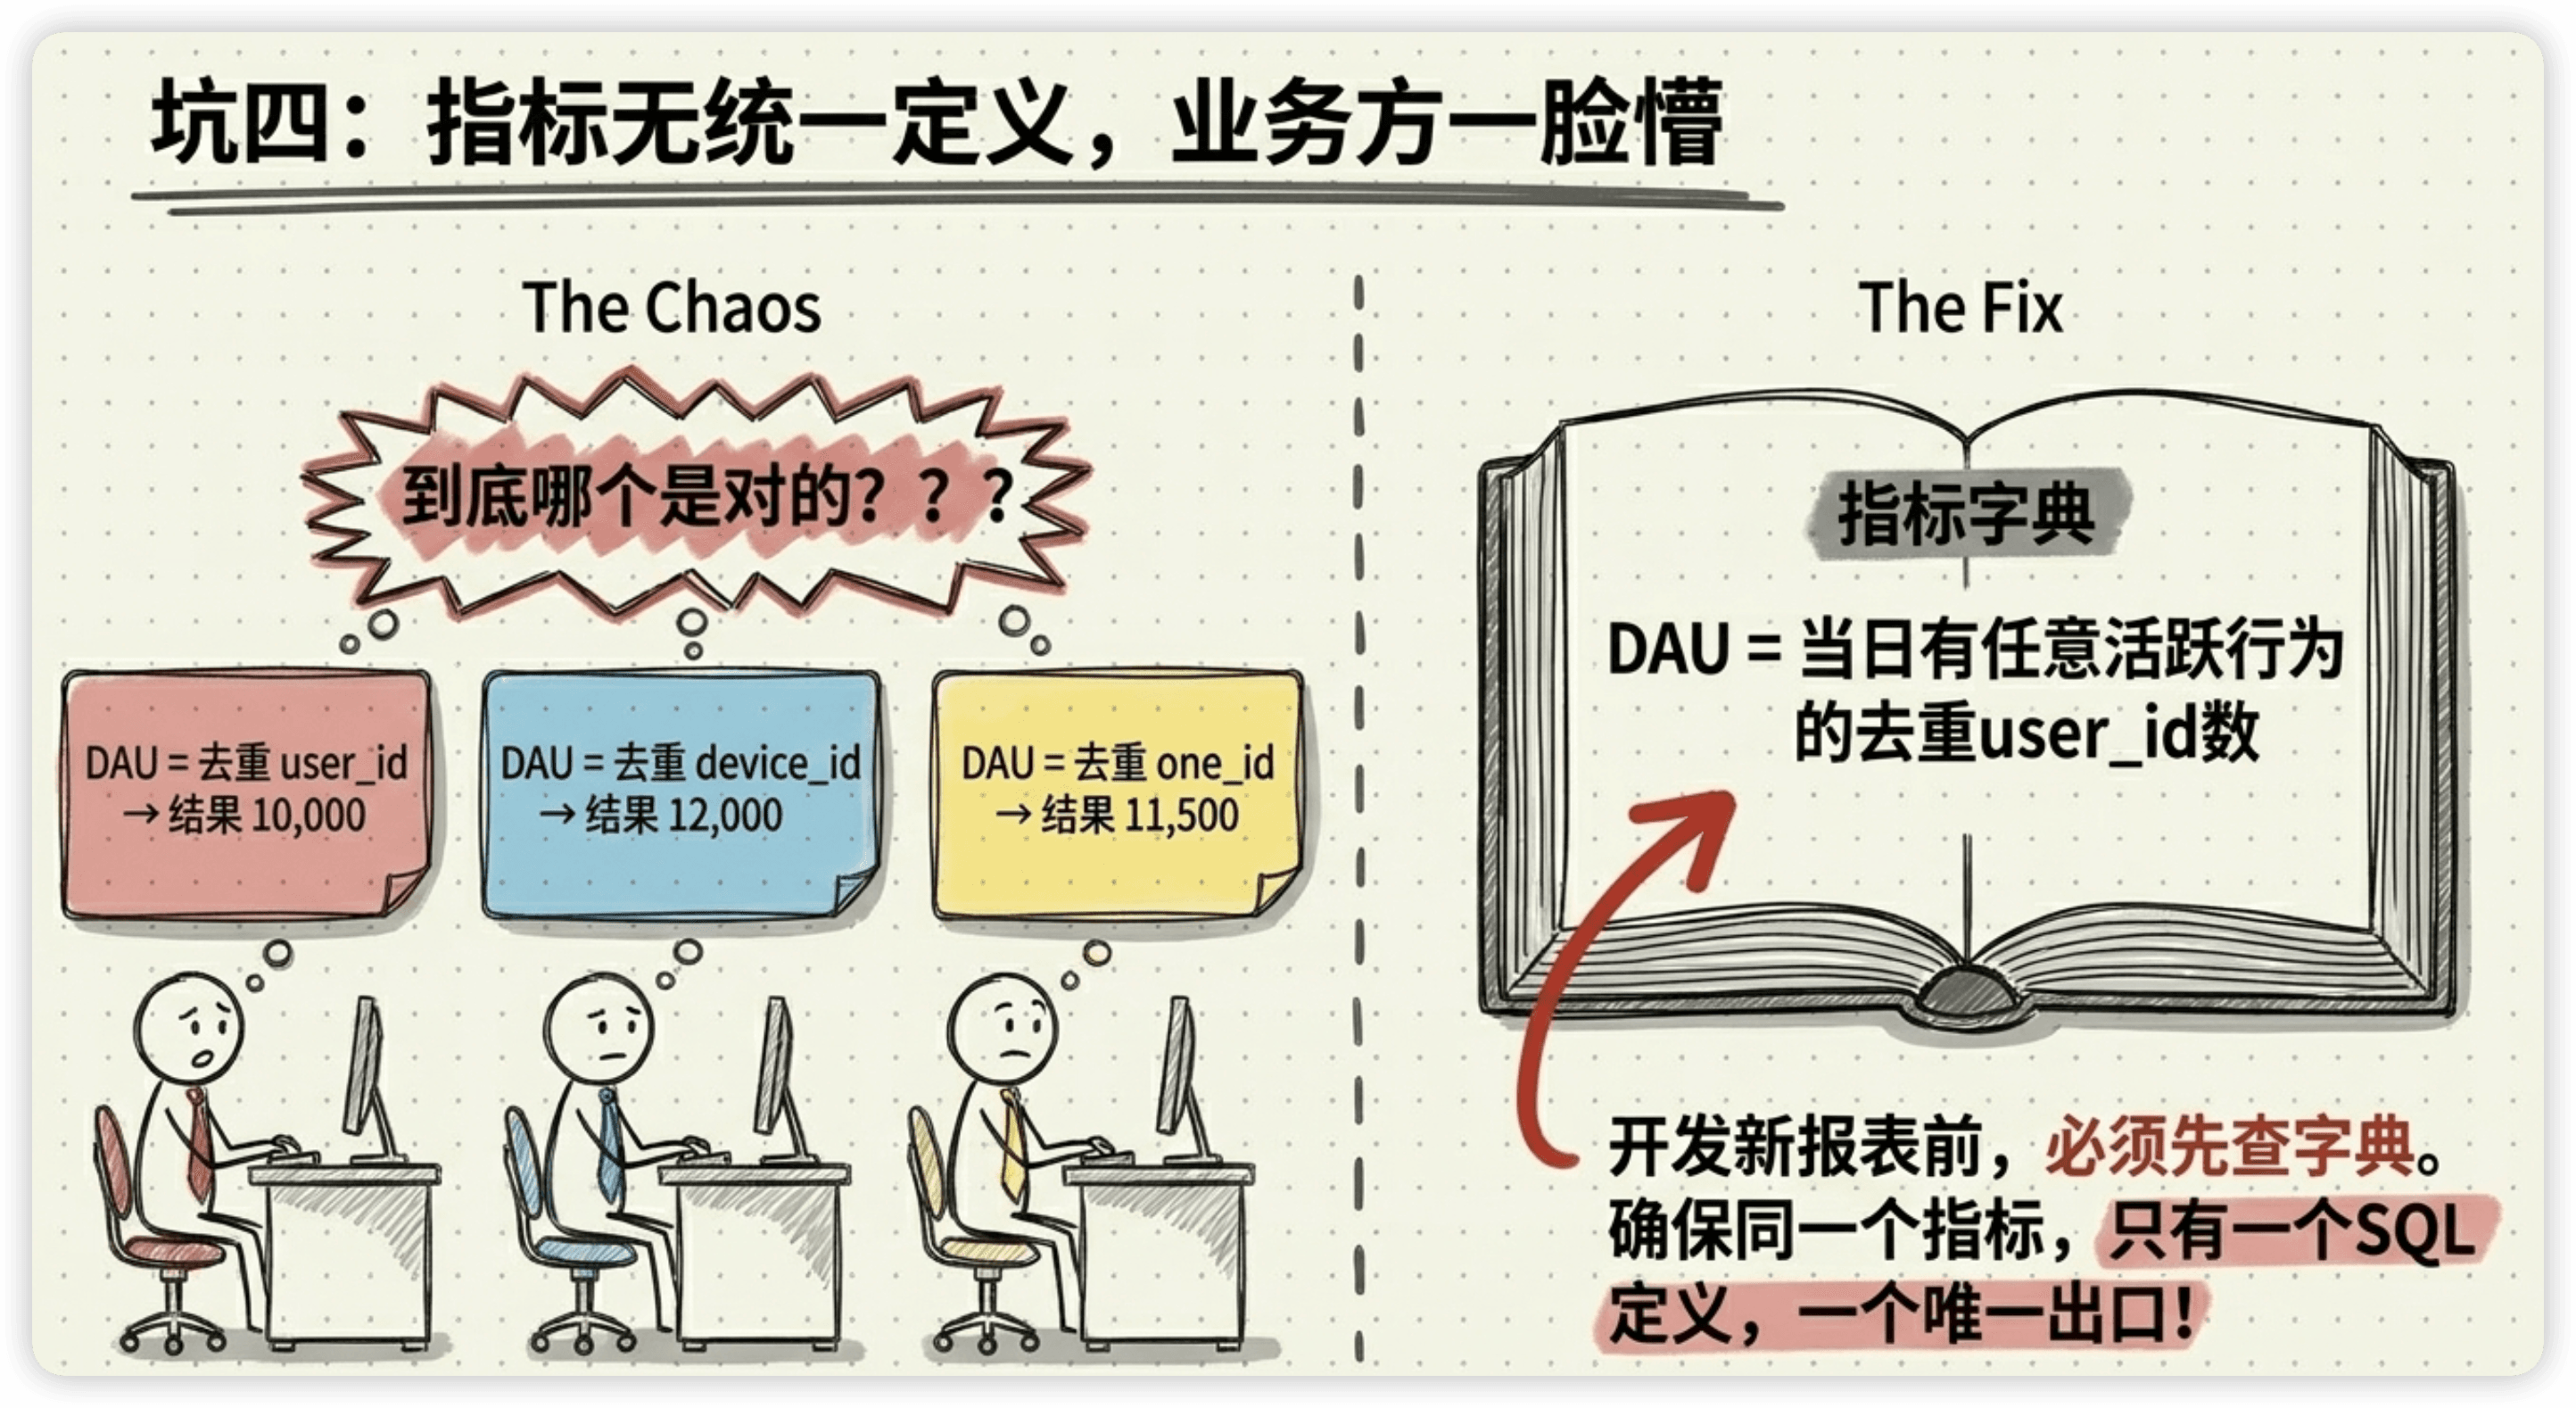
踩坑阶段: 优化期。
到了短剧出海公司,接手时发现同一个"DAU"指标,不同报表的数字不一样——一个用user_id去重,一个用device_id去重,还有一个用one_id去重。三种算法,三个数字,业务方一脸困惑。
DAY 6讲的口径问题,不是理论,是每天都在发生的事。
教训: 先定义再开发。哪怕只是在飞书文档里写一句"DAU = 当日有任意活跃行为的去重user_id数",也比直接写SQL强。建了指标字典之后,新报表的开发必须先查字典,确认用的是哪个指标的哪个口径。
坑五:团队重复造轮子
踩坑阶段: 多个阶段都遇到过。
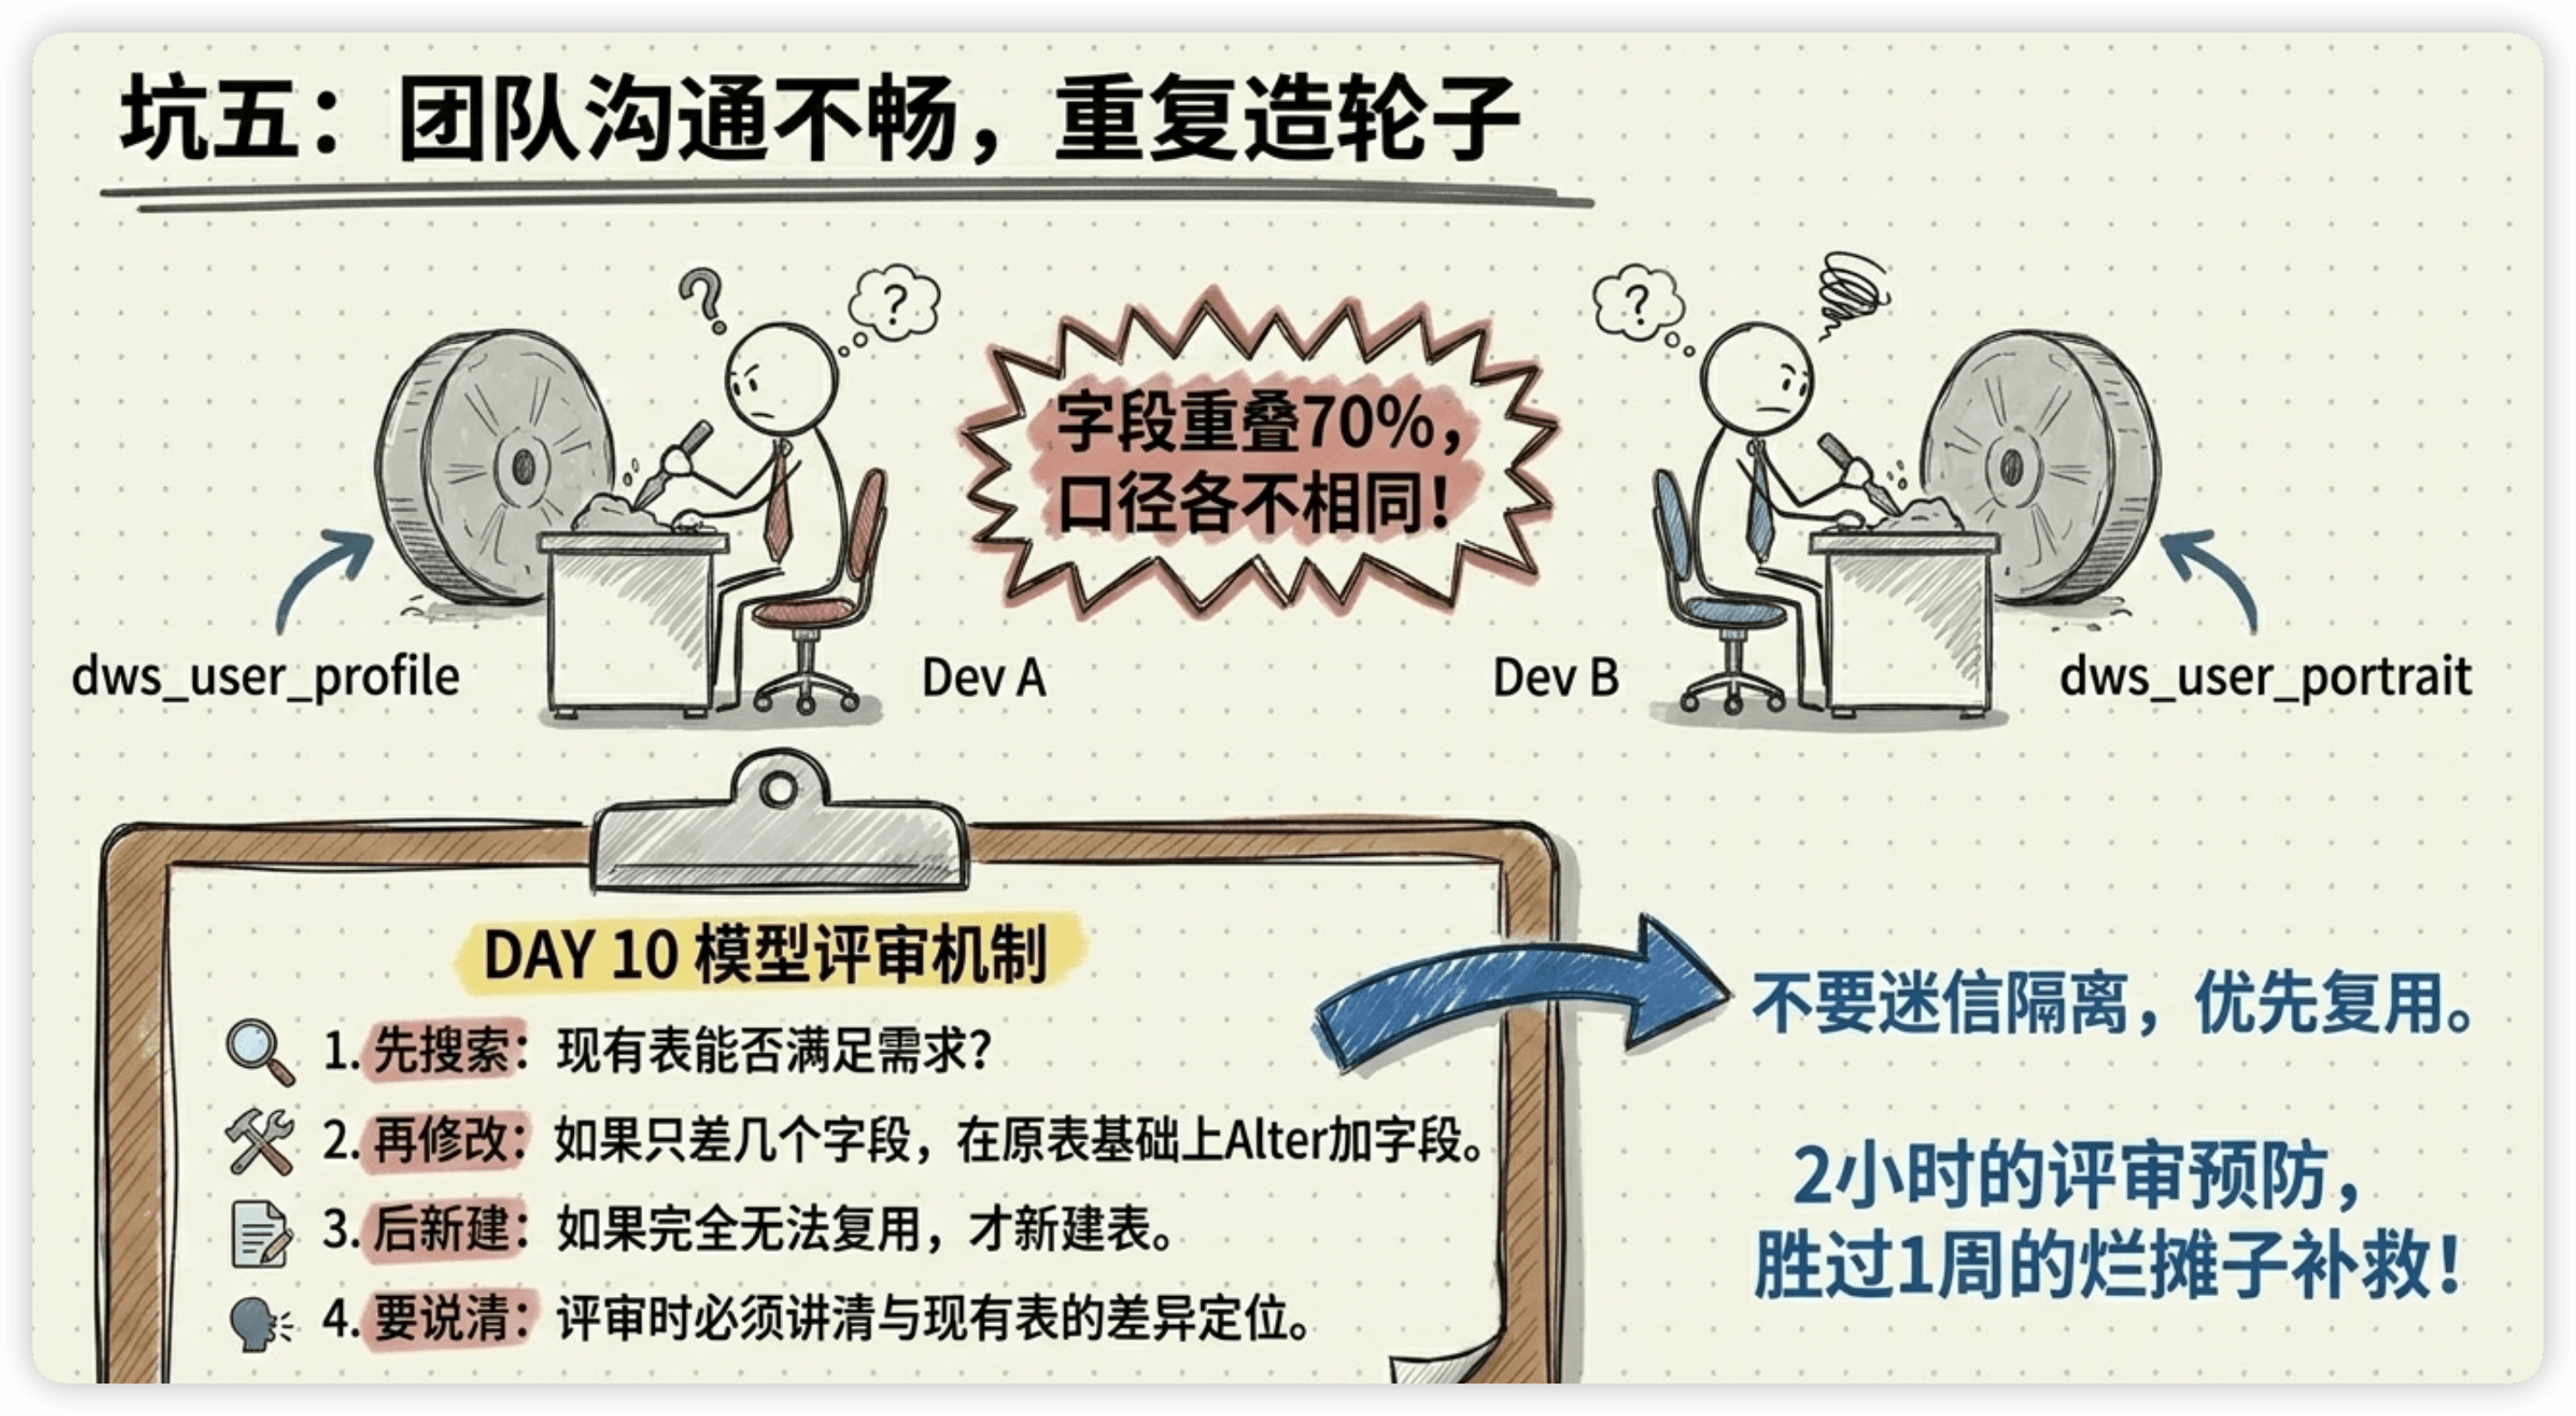
3个人的数据团队,各自建了一张用户画像表,字段重叠70%。每个人维护自己那张表,口径各不相同。更离谱的是其中两张表名字几乎一样——dws_user_profile和dws_user_portrait。
教训: DAY 10的模型评审机制。新建表之前先搜索现有表有没有能满足需求的。如果已有表差几个字段,在已有表上加字段,而不是新建一张。如果确实需要新建,在评审时说清楚和已有表的差异定位。
建模决策树:新建一张表时的思考顺序
9年踩坑下来,我总结了一个决策框架。每次要新建数仓表的时候,按这个顺序想:
第一步:确定层级
├── 保留原始数据?→ ODS
├── 清洗后的明细?→ DWD
├── 按主题聚合?  → DWS
└── 直接给报表?  → ADS

第二步:确定粒度
└── 一行代表什么?写一句话
    例:"一个用户 × 一天的支付汇总"

第三步:确定表类型
├── 记录事件发生?       → 事务型事实表(DAY 4)
├── 记录某时间点状态?   → 周期快照型(DAY 4)
├── 记录全生命周期?     → 累积快照型(DAY 4)
└── 存储描述信息?       → 维度表

第四步:确定建模方式
├── 需要多维分析?       → 星型模型(DAY 2)
├── 直接给报表/宽查询?  → 宽表(DAY 5)
└── 维度有历史变化?     → 拉链表Type2(DAY 3)

第五步:检查规范
├── 命名符合公式?       → DAY 8
├── 有没有已存在的类似表?→ DAY 10
├── 指标定义在字典里了? → DAY 6
└── 上下游关系清晰?     → DAY 10

第六步:评审上线
└── 过一遍10项Checklist → DAY 10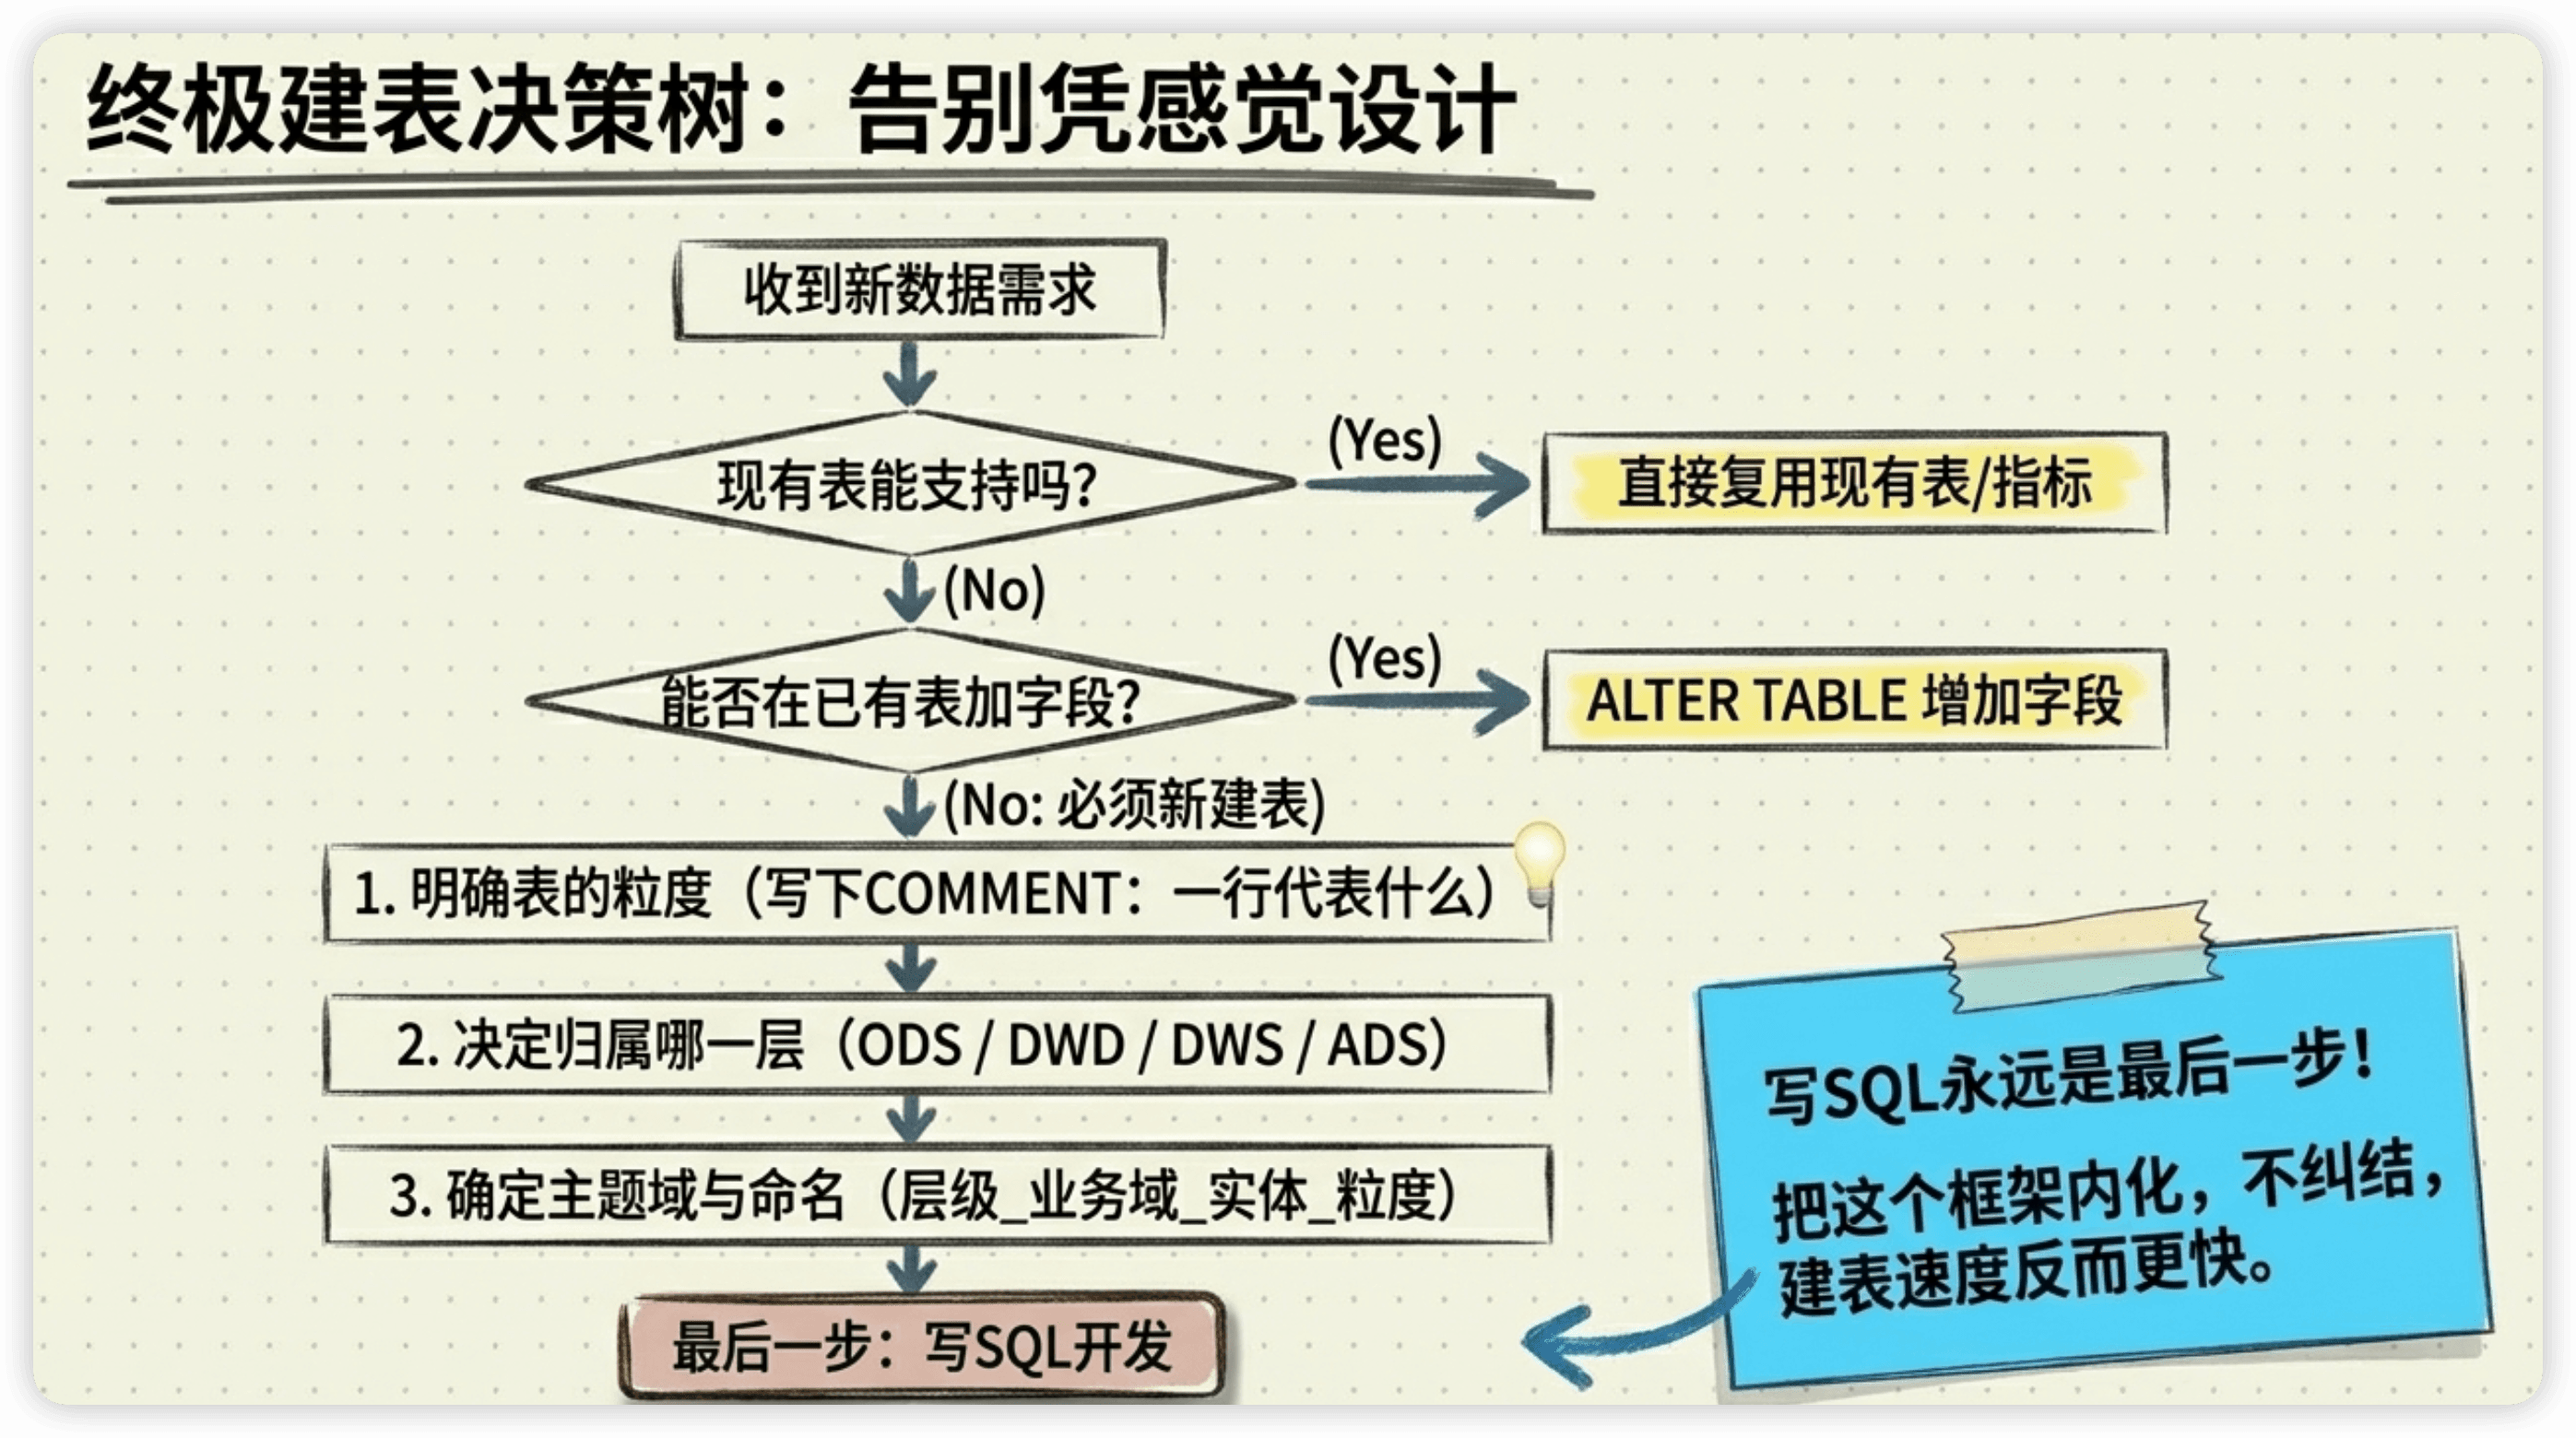
每一步都有明确的判断标准,不用凭感觉设计。把这个框架内化之后,建表的速度反而更快了——因为不用在过程中反复纠结。
面试讲数仓项目:3分钟模板
面试中高阶岗位时,"聊聊你做过的数仓项目"是必问题。很多人要么讲得太细(15分钟还没讲完),要么太空泛(全是概念没有细节)。
我总结了一个3分钟模板,用STAR法则把数仓项目讲清楚:
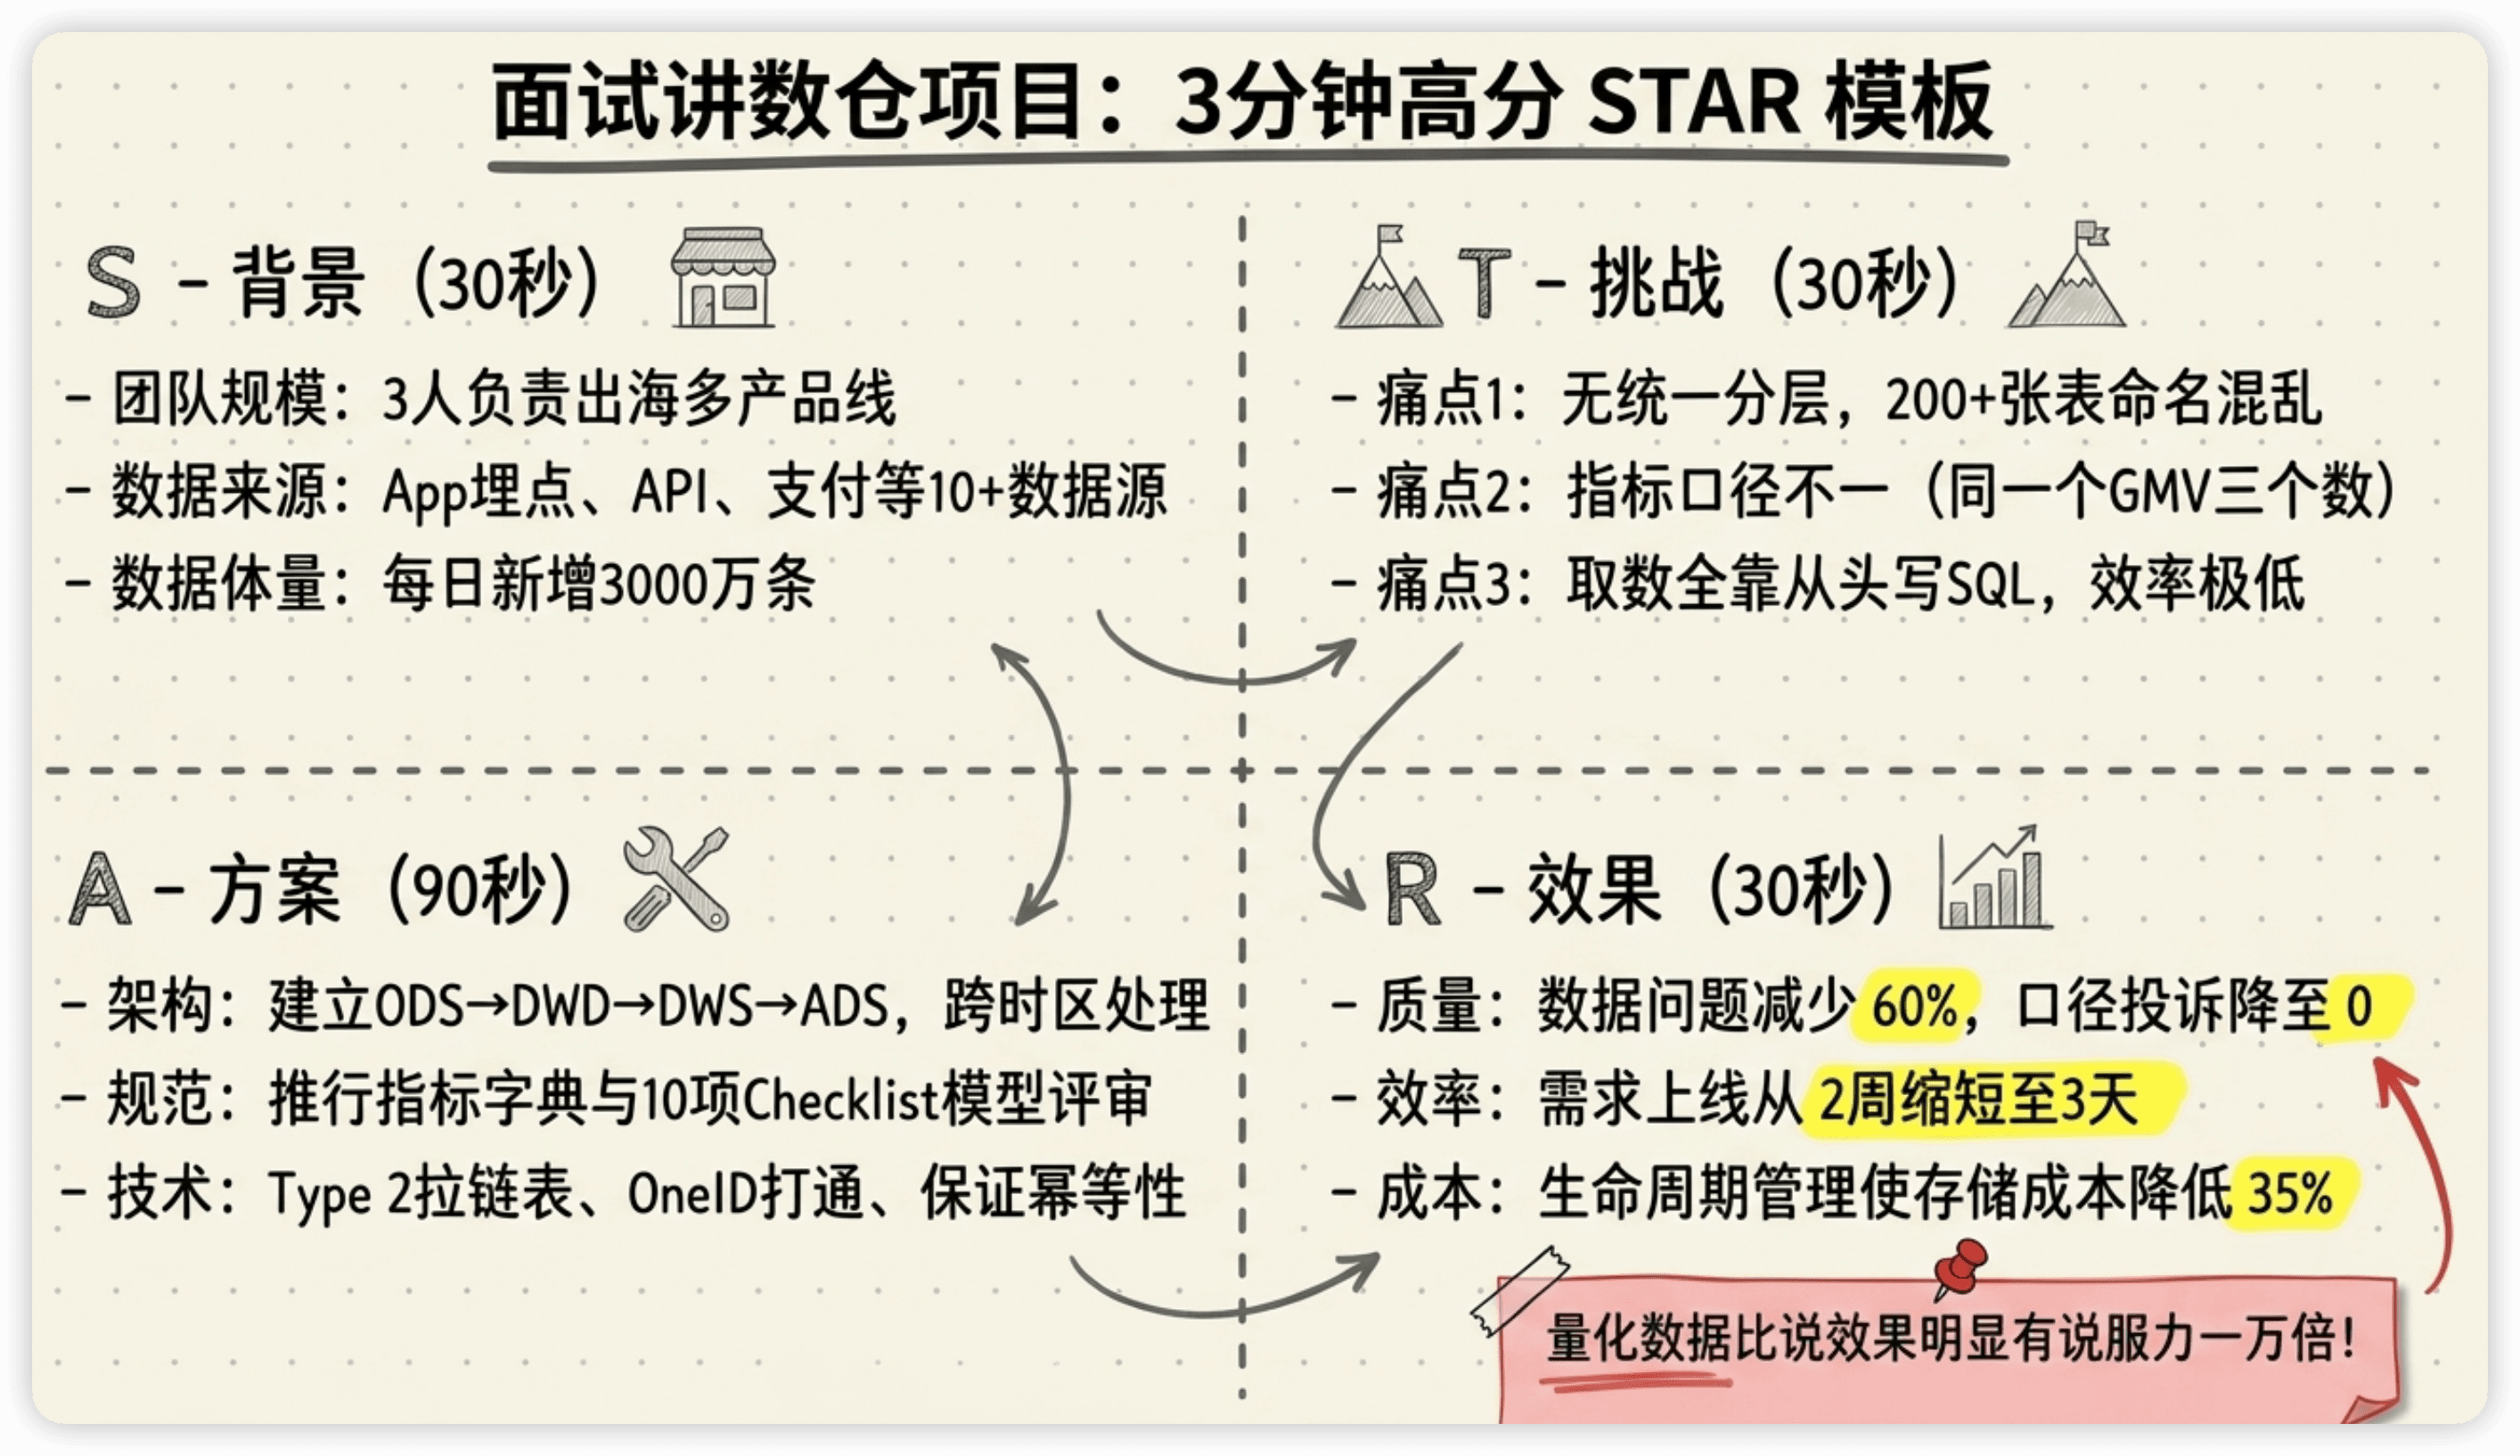
Situation(背景)—— 30秒
「我在某出海公司负责数据仓库建设。团队3个人,业务包括短剧、小说等多个产品线,数据来源有App埋点、广告平台API、第三方支付等十几个数据源,每天新增数据量约3000万条。」
关键:说出团队规模、业务特点、数据规模。这些信息帮面试官判断你面对的是什么级别的问题。
Task(挑战)—— 30秒
「接手时数仓有几个严重问题:没有统一的分层架构,200多张表命名混乱,指标口径不统一——同一个GMV三张报表三个数字。每次出新报表都要从头写SQL,效率很低。」
关键:说出具体的痛点,而不是笼统的"不够好"。
Action(方案)—— 90秒
「我主导做了三件事。」
「第一,建立标准分层架构——ODS→DWD→DWS→ADS,用Kimball维度建模,按交易、用户、广告三个主题域建设。DWD层做了严格的数据清洗和跨时区处理,解决了出海业务UTC时间转换的问题。」
「第二,制定数据规范——统一命名规范(层级_业务域_实体_粒度),建立指标字典(每个指标有唯一的SQL定义),推行模型评审机制(新表上线必须过10项Checklist)。」
「第三,技术层面——用户维度表用Type 2拉链表保留历史。DWS层建了用户行为和交易两张核心宽表。广告归因用OneID打通了广告平台ID、设备ID和App内user_id。所有ETL任务用INSERT OVERWRITE保证幂等性。」
关键:分点讲,每点有技术细节。面试官可以在任何一点上深挖。
Result(效果)—— 30秒
「数据质量问题减少60%,报表口径投诉从每周2-3次降到基本为零,新需求从提出到上线从2周缩短到3天。存储成本通过生命周期管理降低了35%。」
关键:有量化数据。"减少60%""每周2-3次降到零""2周→3天"——这些数字比"效果明显"有说服力一万倍。
面试官追问的串联能力
讲完项目之后,面试官一定会追问细节。最厉害的候选人是能把不同知识点串联起来回答的。
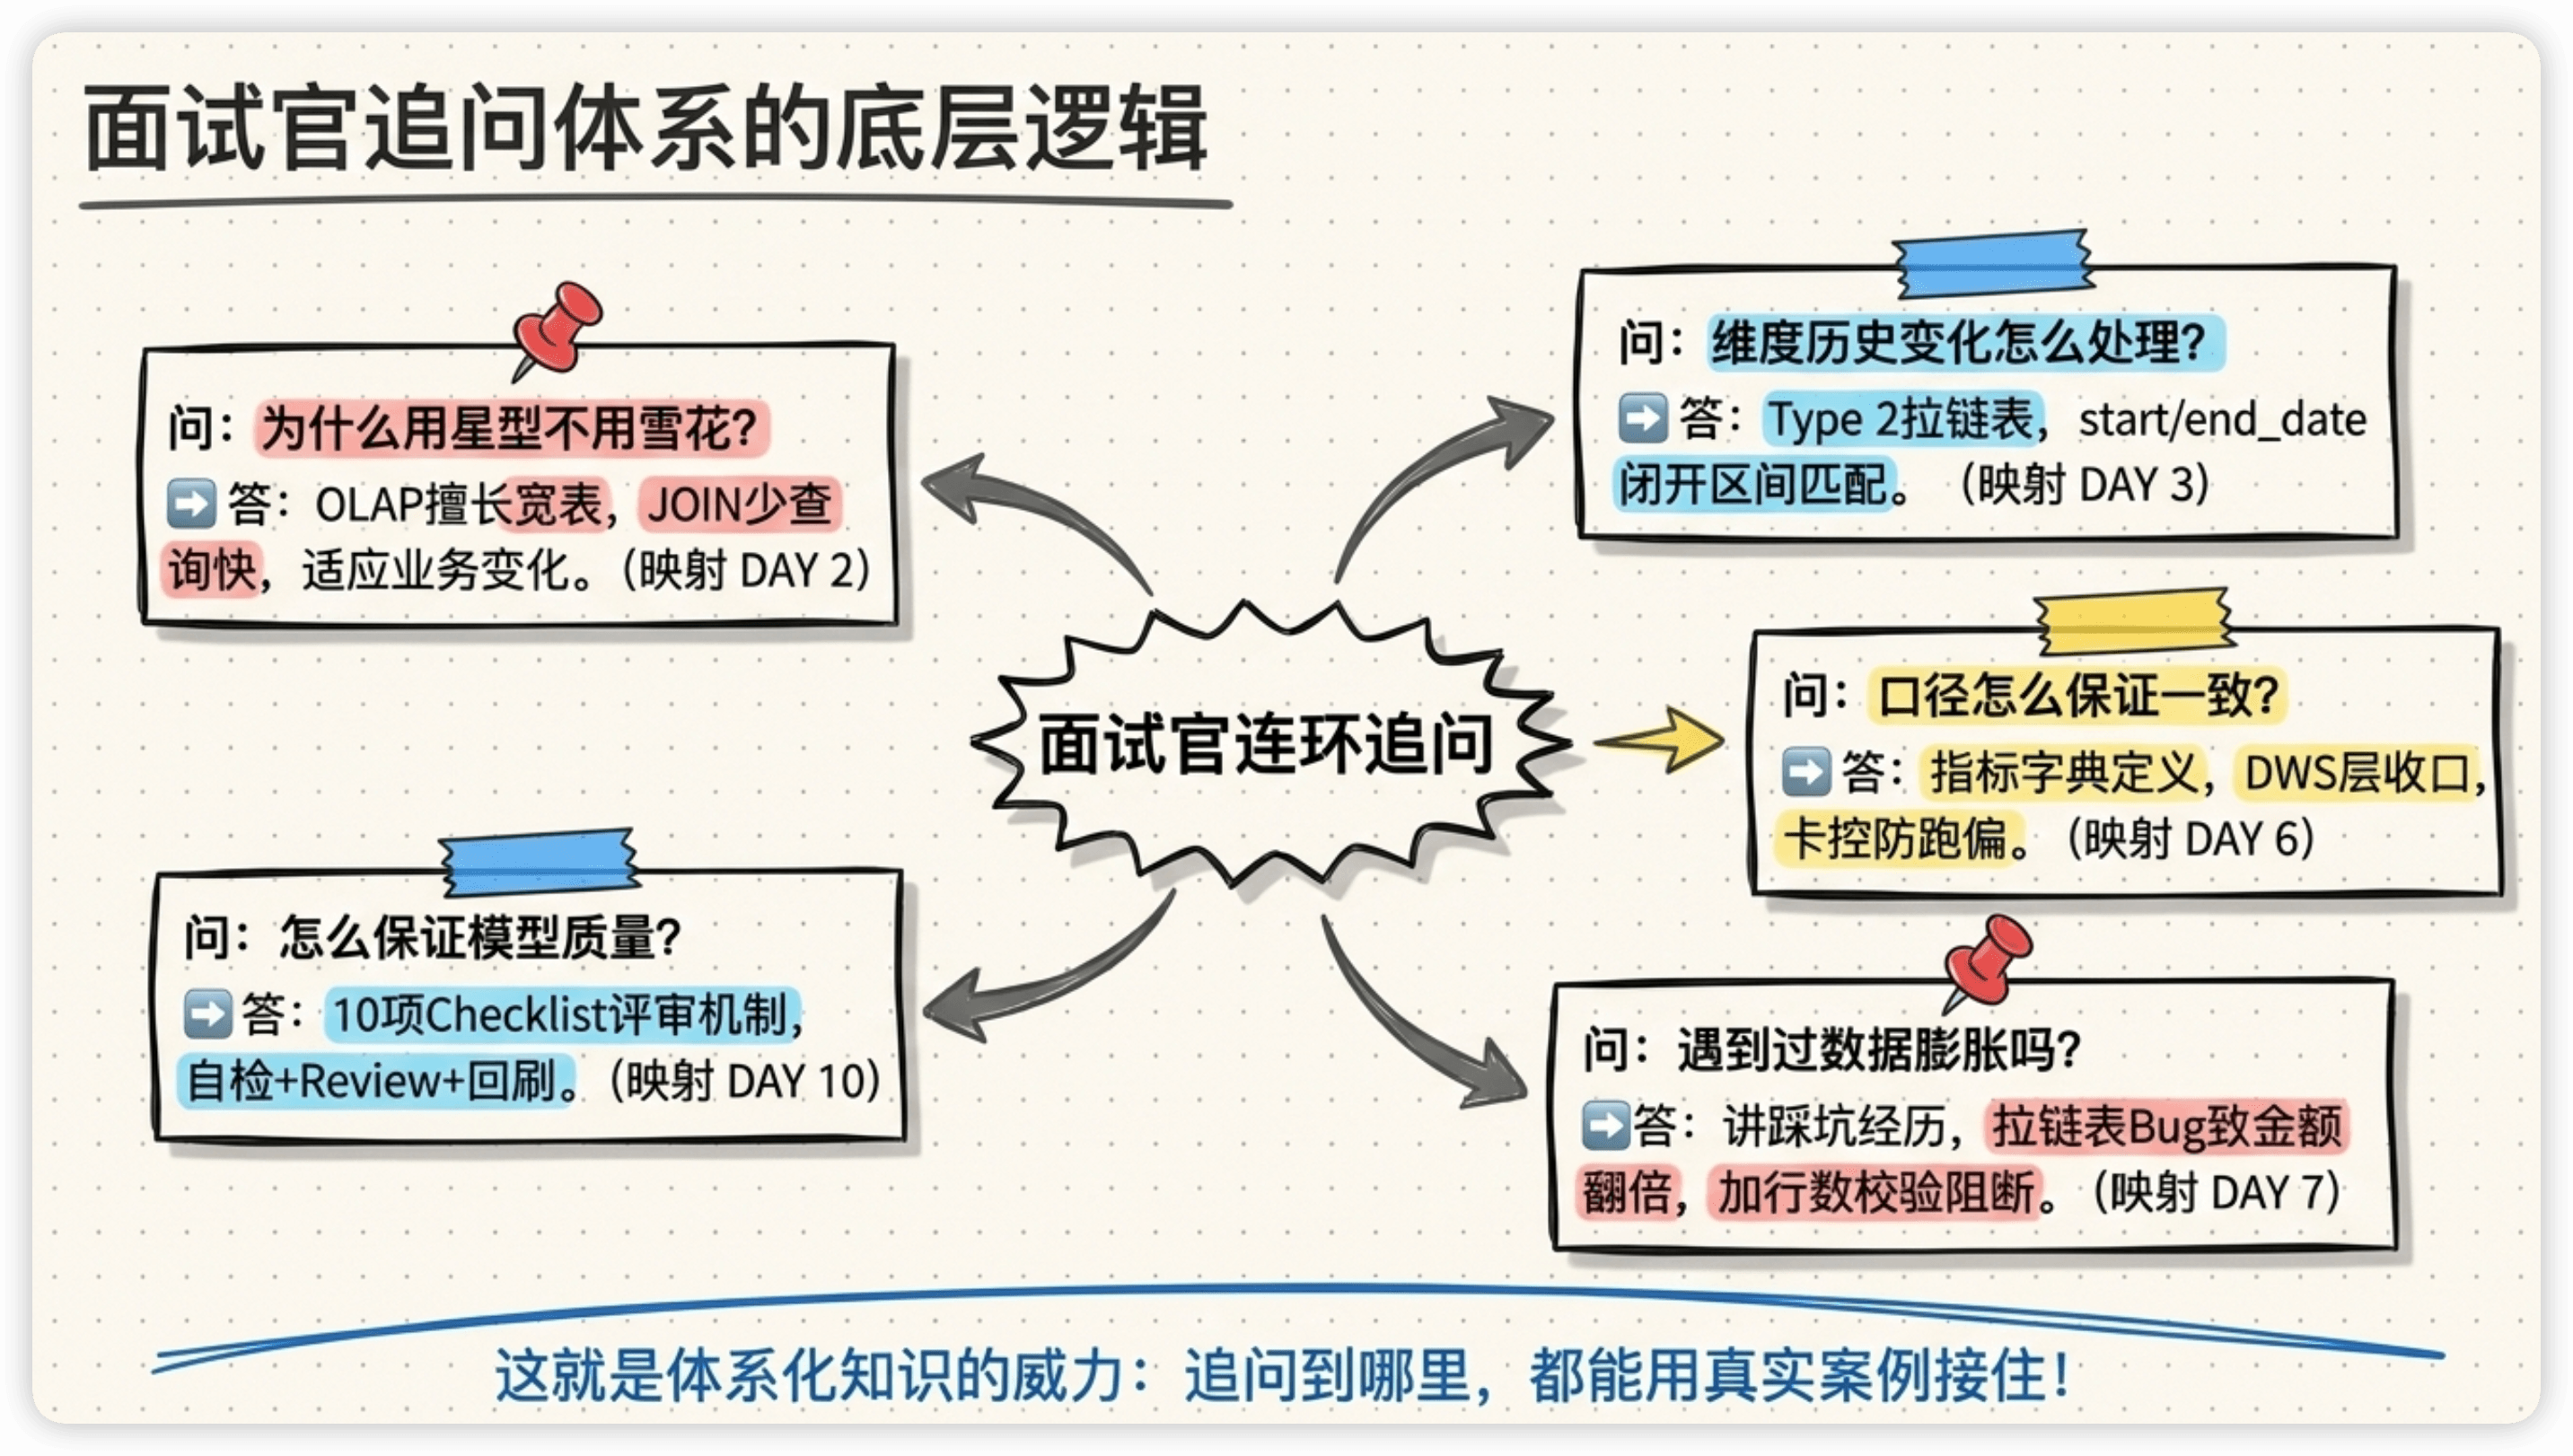
追问"为什么用星型模型不用雪花" → 讲DAY 2的选型逻辑:OLAP引擎擅长宽表、团队小维护简单、业务变化快不适合拆太细。
追问"维度变化怎么处理" → 讲DAY 3的拉链表:start_date/end_date标记有效期、事实表通过日期范围JOIN匹配历史维度、团队统一用左闭右开区间。
追问"口径怎么保证一致" → 讲DAY 6的治理方案:指标字典统一定义、DWS层收口取数、技术卡控防跑偏。
追问"数据膨胀遇到过吗" → 讲DAY 7的排查经历:拉链表is_current有Bug导致金额翻倍、加了行数校验卡点预防。
追问"怎么保证质量" → 讲DAY 10的评审机制:10项Checklist、自检+Review+回刷验证。
面试官追到哪你都能接住,而且每个回答都有真实案例支撑——这就是体系化知识的威力。
给正在准备面试的你
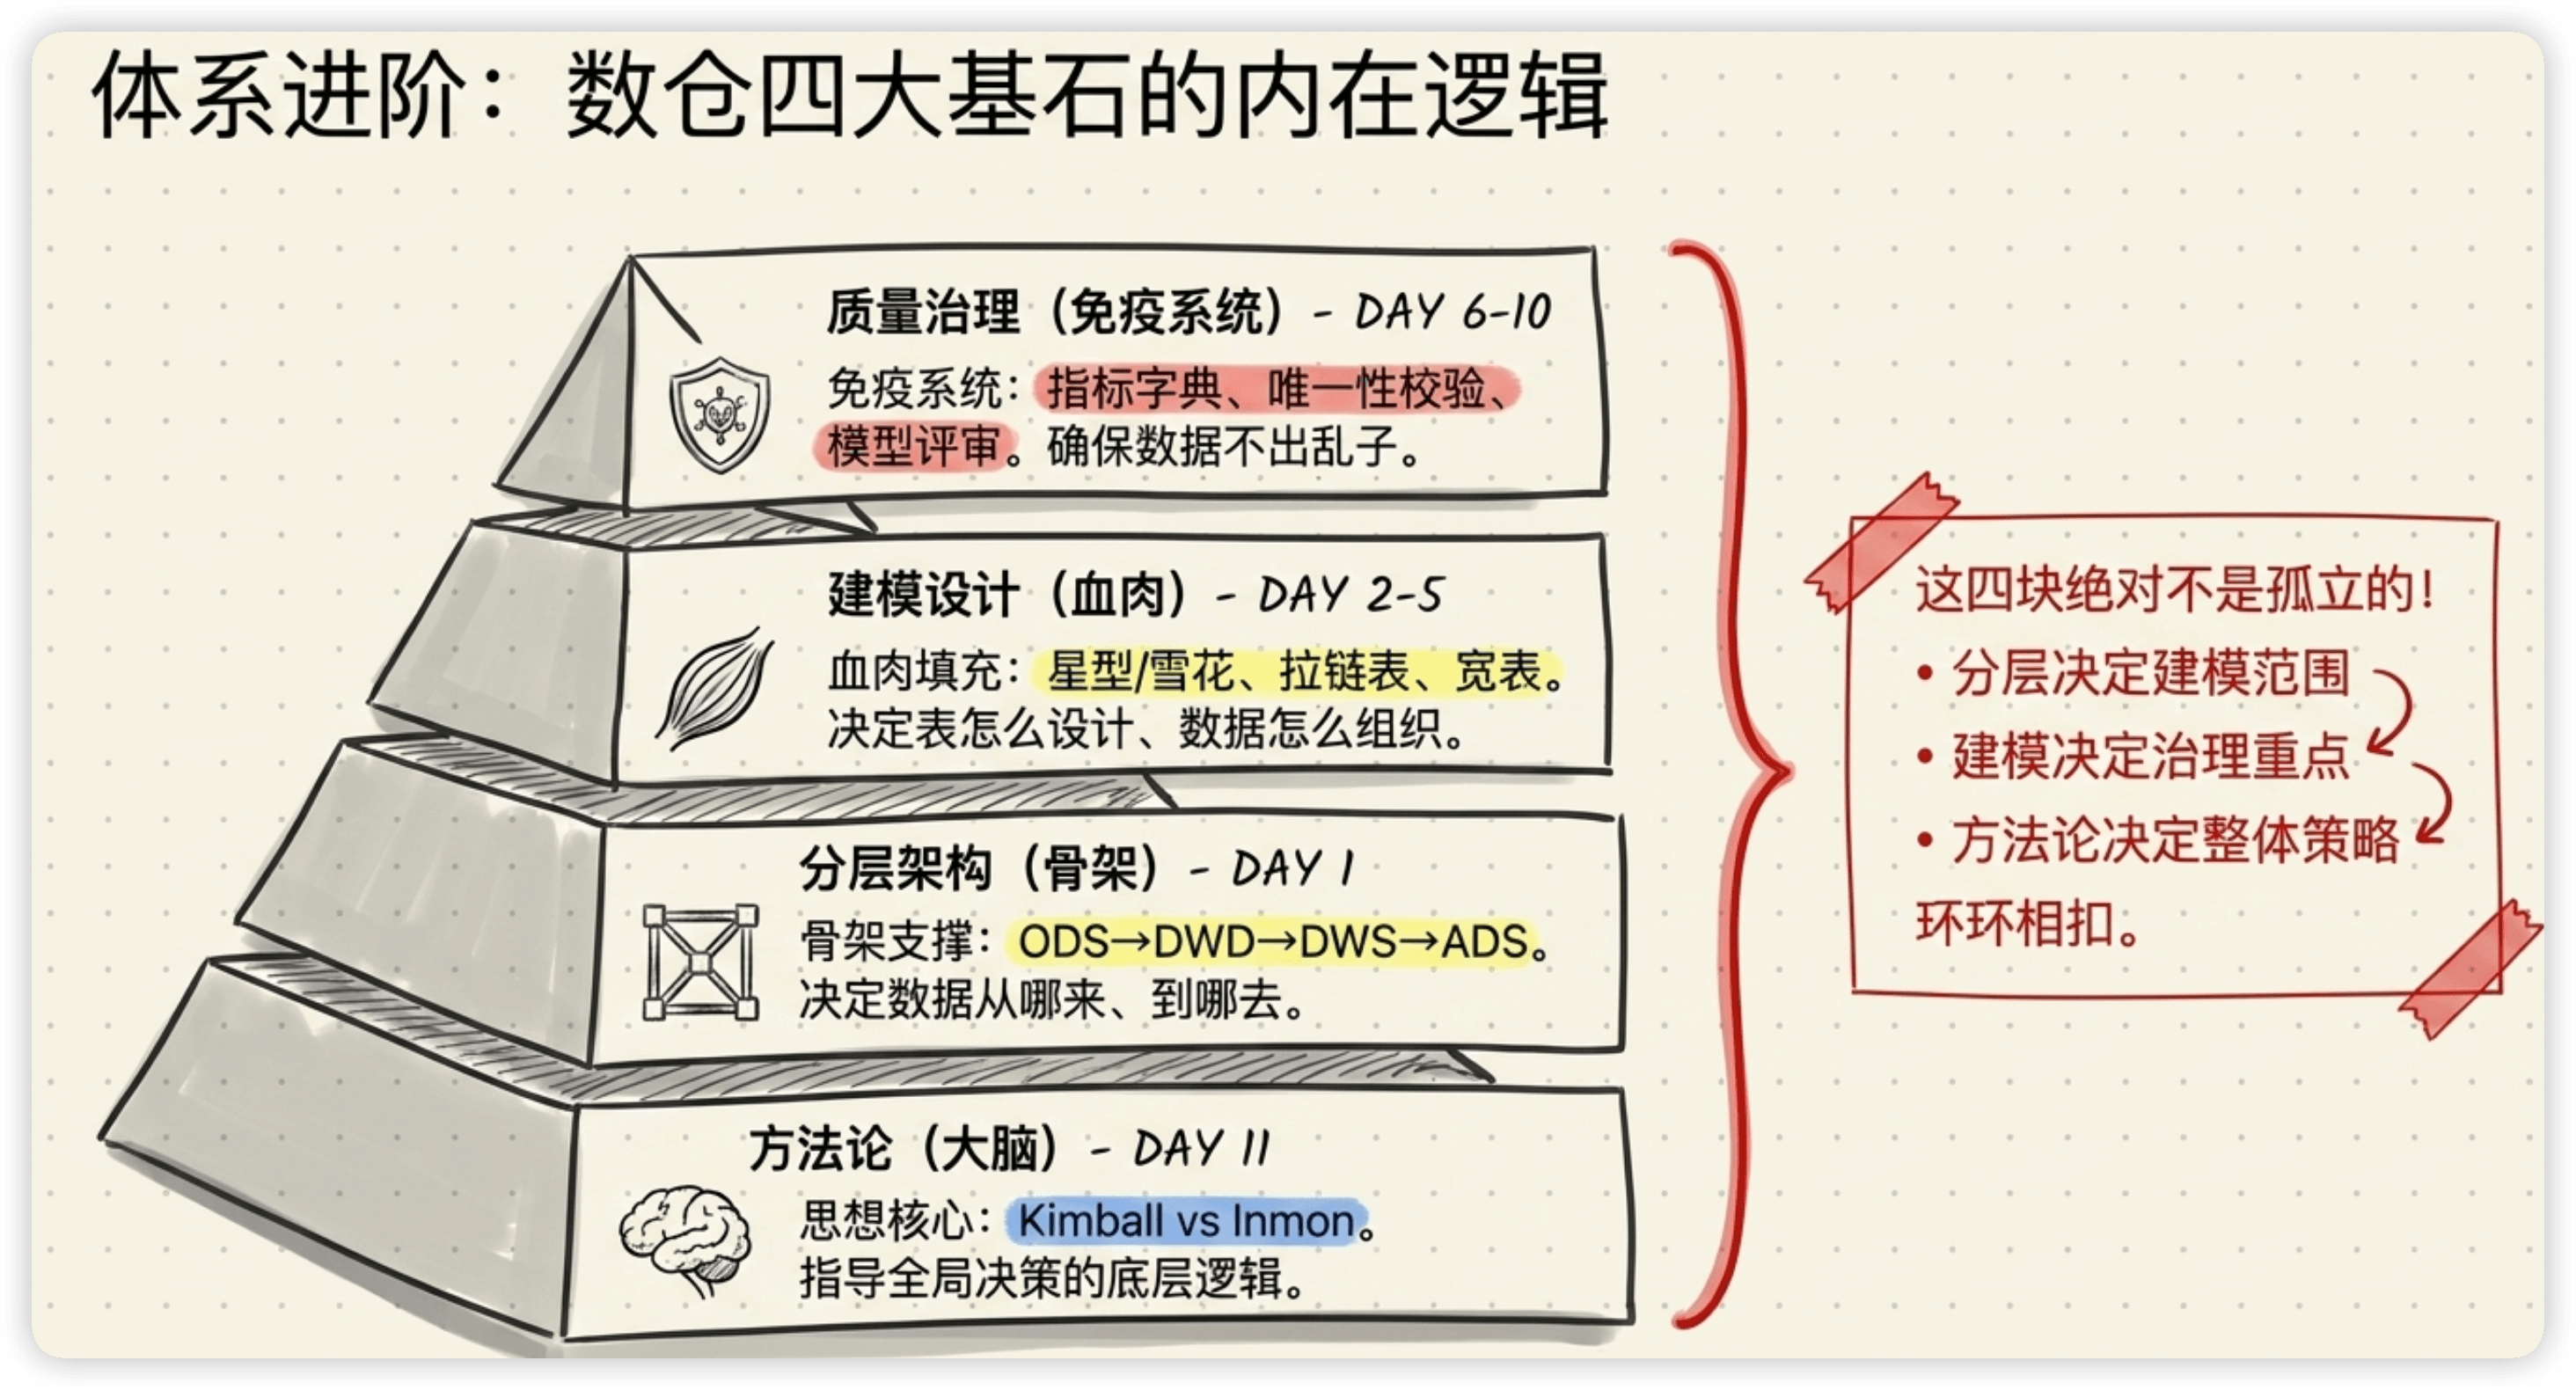
数仓建模的知识体系其实不复杂,核心就这几块:
- 分层(DAY 1)是骨架——决定了数据从哪来、到哪去
- 建模(DAY 2-5)是血肉——决定了表怎么设计、数据怎么组织
- 治理(DAY 6-10)是免疫系统——保证数据不出乱子
- 方法论(DAY 11)是思想——指导你做决策的底层逻辑
这四块不是孤立的,而是环环相扣。分层决定了你的建模范围,建模决定了你的治理重点,方法论决定了你的整体策略。面试时能把这个链条讲清楚,就是真正的高手。
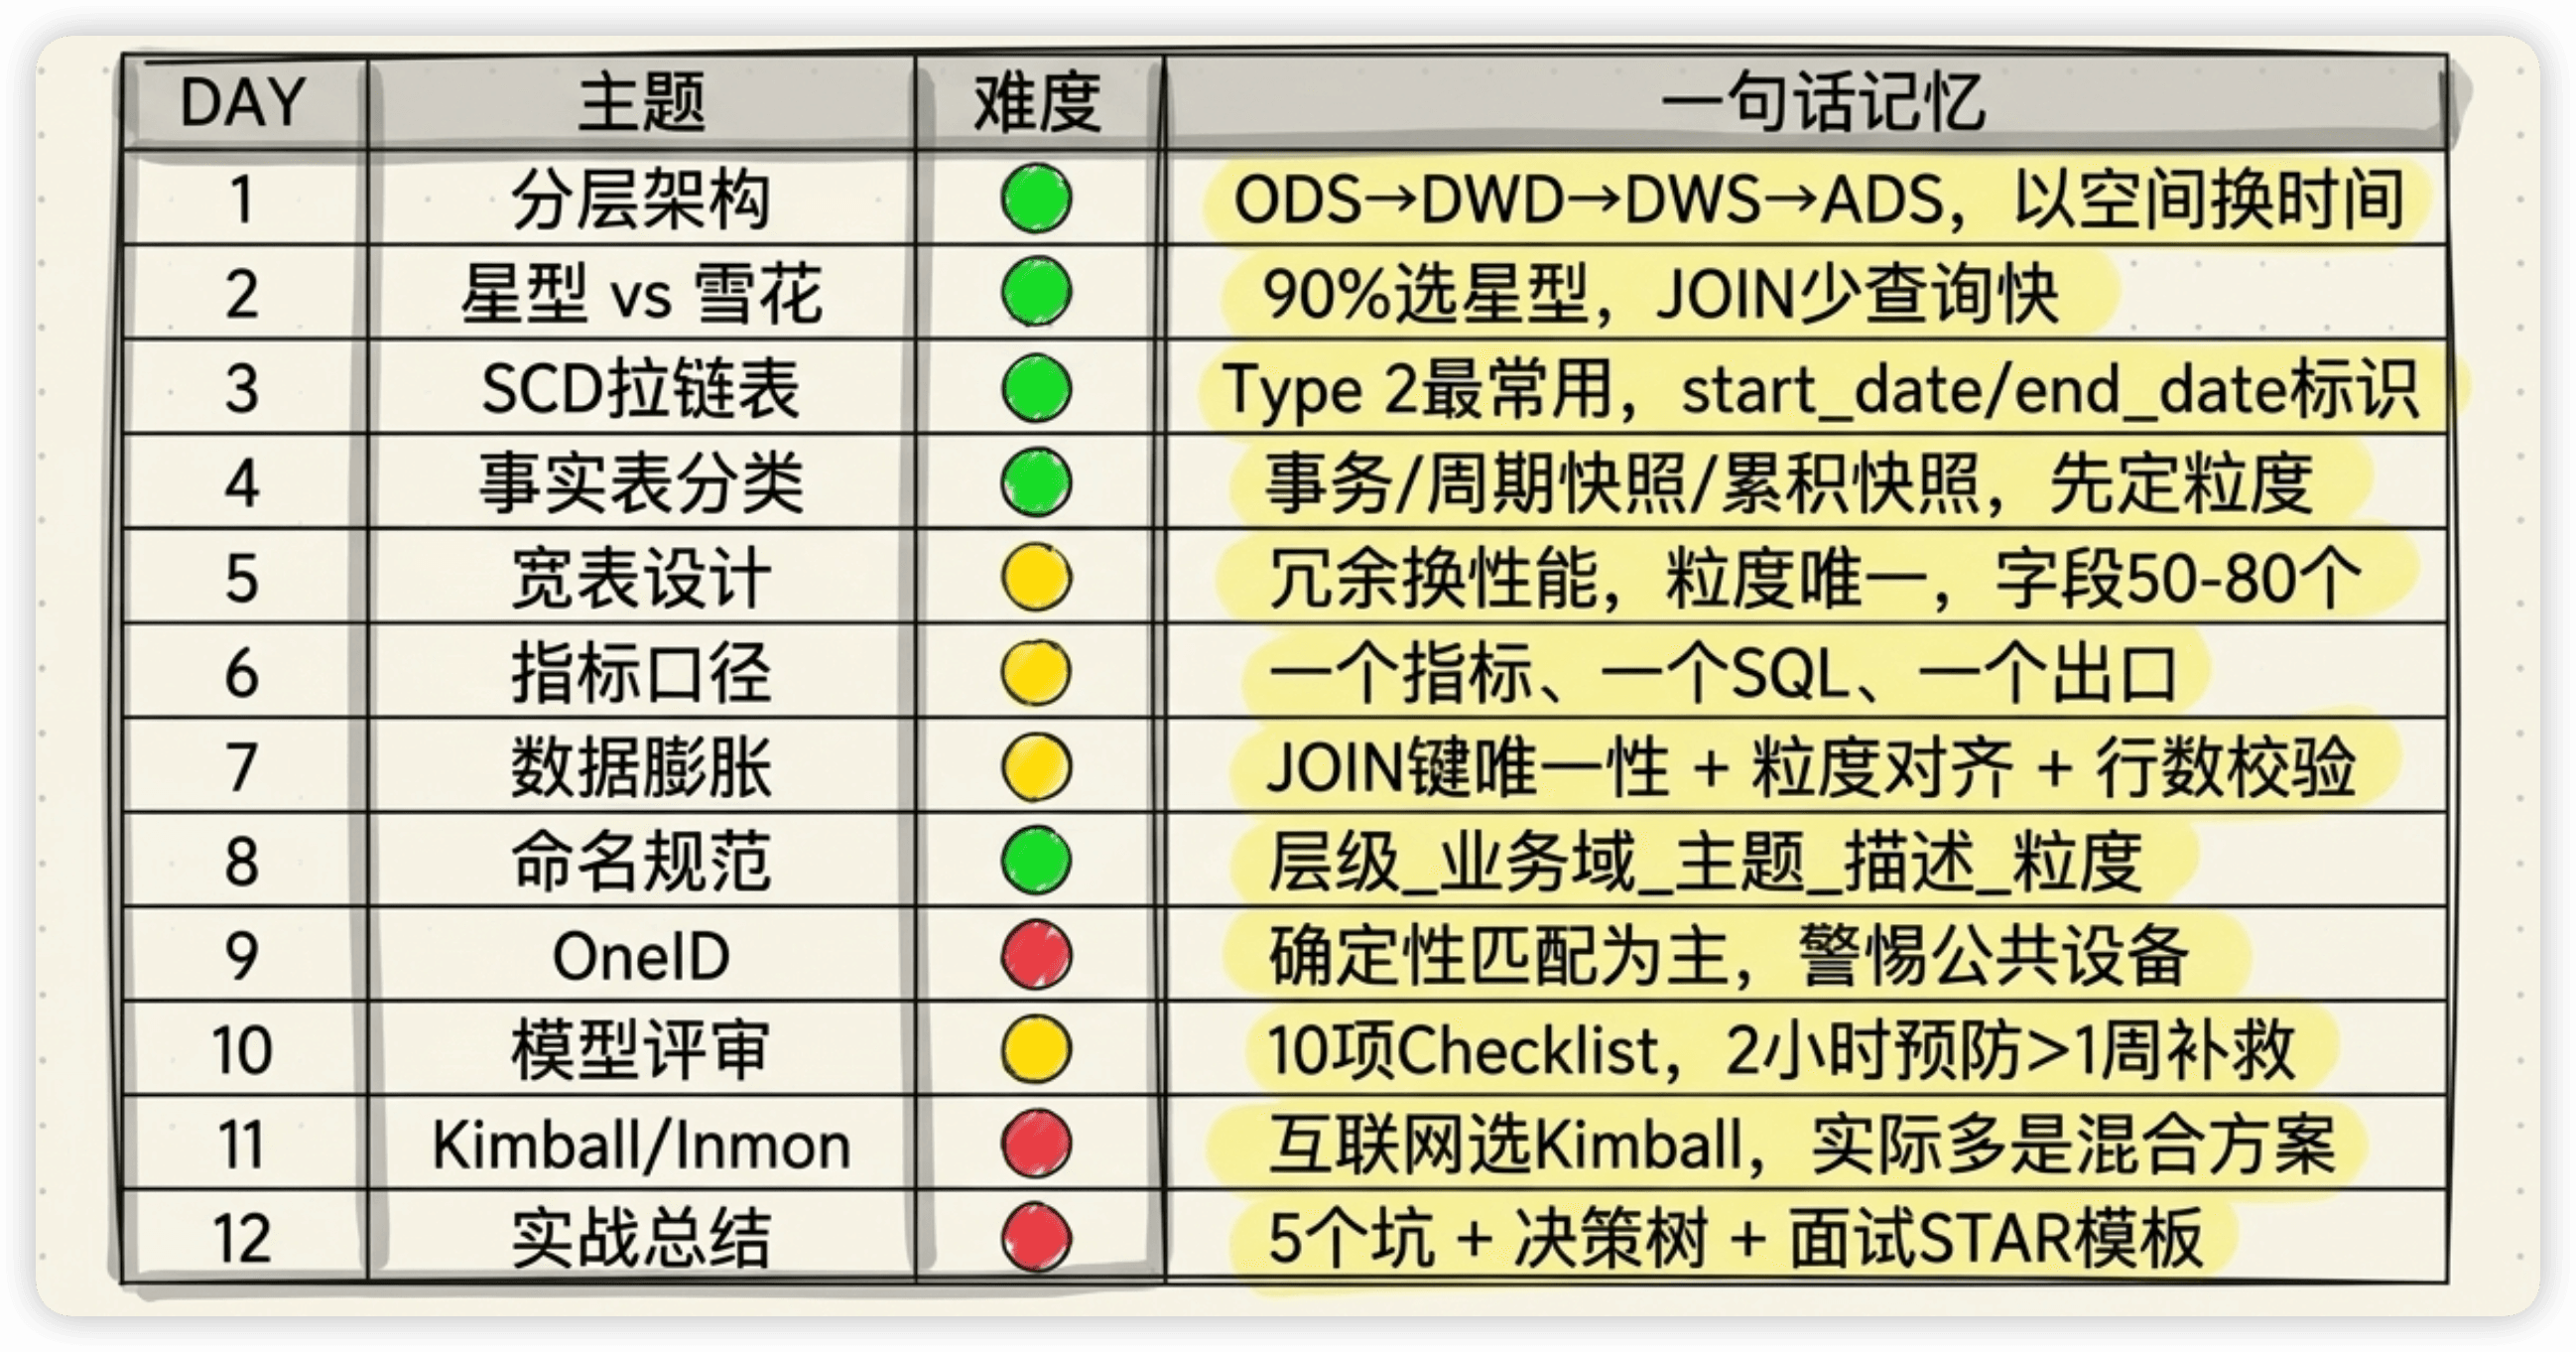
数仓建模系列 · 全12篇知识地图
| DAY | 主题 | 难度 | 一句话记忆 |
|---|---|---|---|
| 1 | 分层架构 | 🟢 | ODS→DWD→DWS→ADS,以空间换时间 |
| 2 | 星型 vs 雪花 | 🟢 | 90%选星型,JOIN少查询快 |
| 3 | SCD拉链表 | 🟢 | Type 2最常用,start_date/end_date/is_current |
| 4 | 事实表三种类型 | 🟢 | 事务型/周期快照/累积快照,先定粒度 |
| 5 | 宽表设计 | 🟡 | 冗余换性能,粒度唯一,字段50-80个 |
| 6 | 指标口径 | 🟡 | 一个指标一个SQL一个出口 |
| 7 | 数据膨胀 | 🟡 | JOIN键唯一性 + 粒度对齐 + 行数校验 |
| 8 | 命名规范 | 🟢 | 层级_业务域_主题_描述_粒度 |
| 9 | OneID | 🔴 | 确定性匹配为主,注意公共设备 |
| 10 | 模型评审 | 🟡 | 10项Checklist,2小时预防>1周补救 |
| 11 | Kimball vs Inmon | 🔴 | 互联网选Kimball,实际多是混合方案 |
| 12 | 实战总结 | 🔴 | 5个坑+决策树+3分钟面试模板 |
数仓建模系列初级就到这里完结。但这只是多个系列中的一个——SQL面试、Flink实时、Spark批处理、OLAP引擎、数据治理……每个系列都在持续更新中。