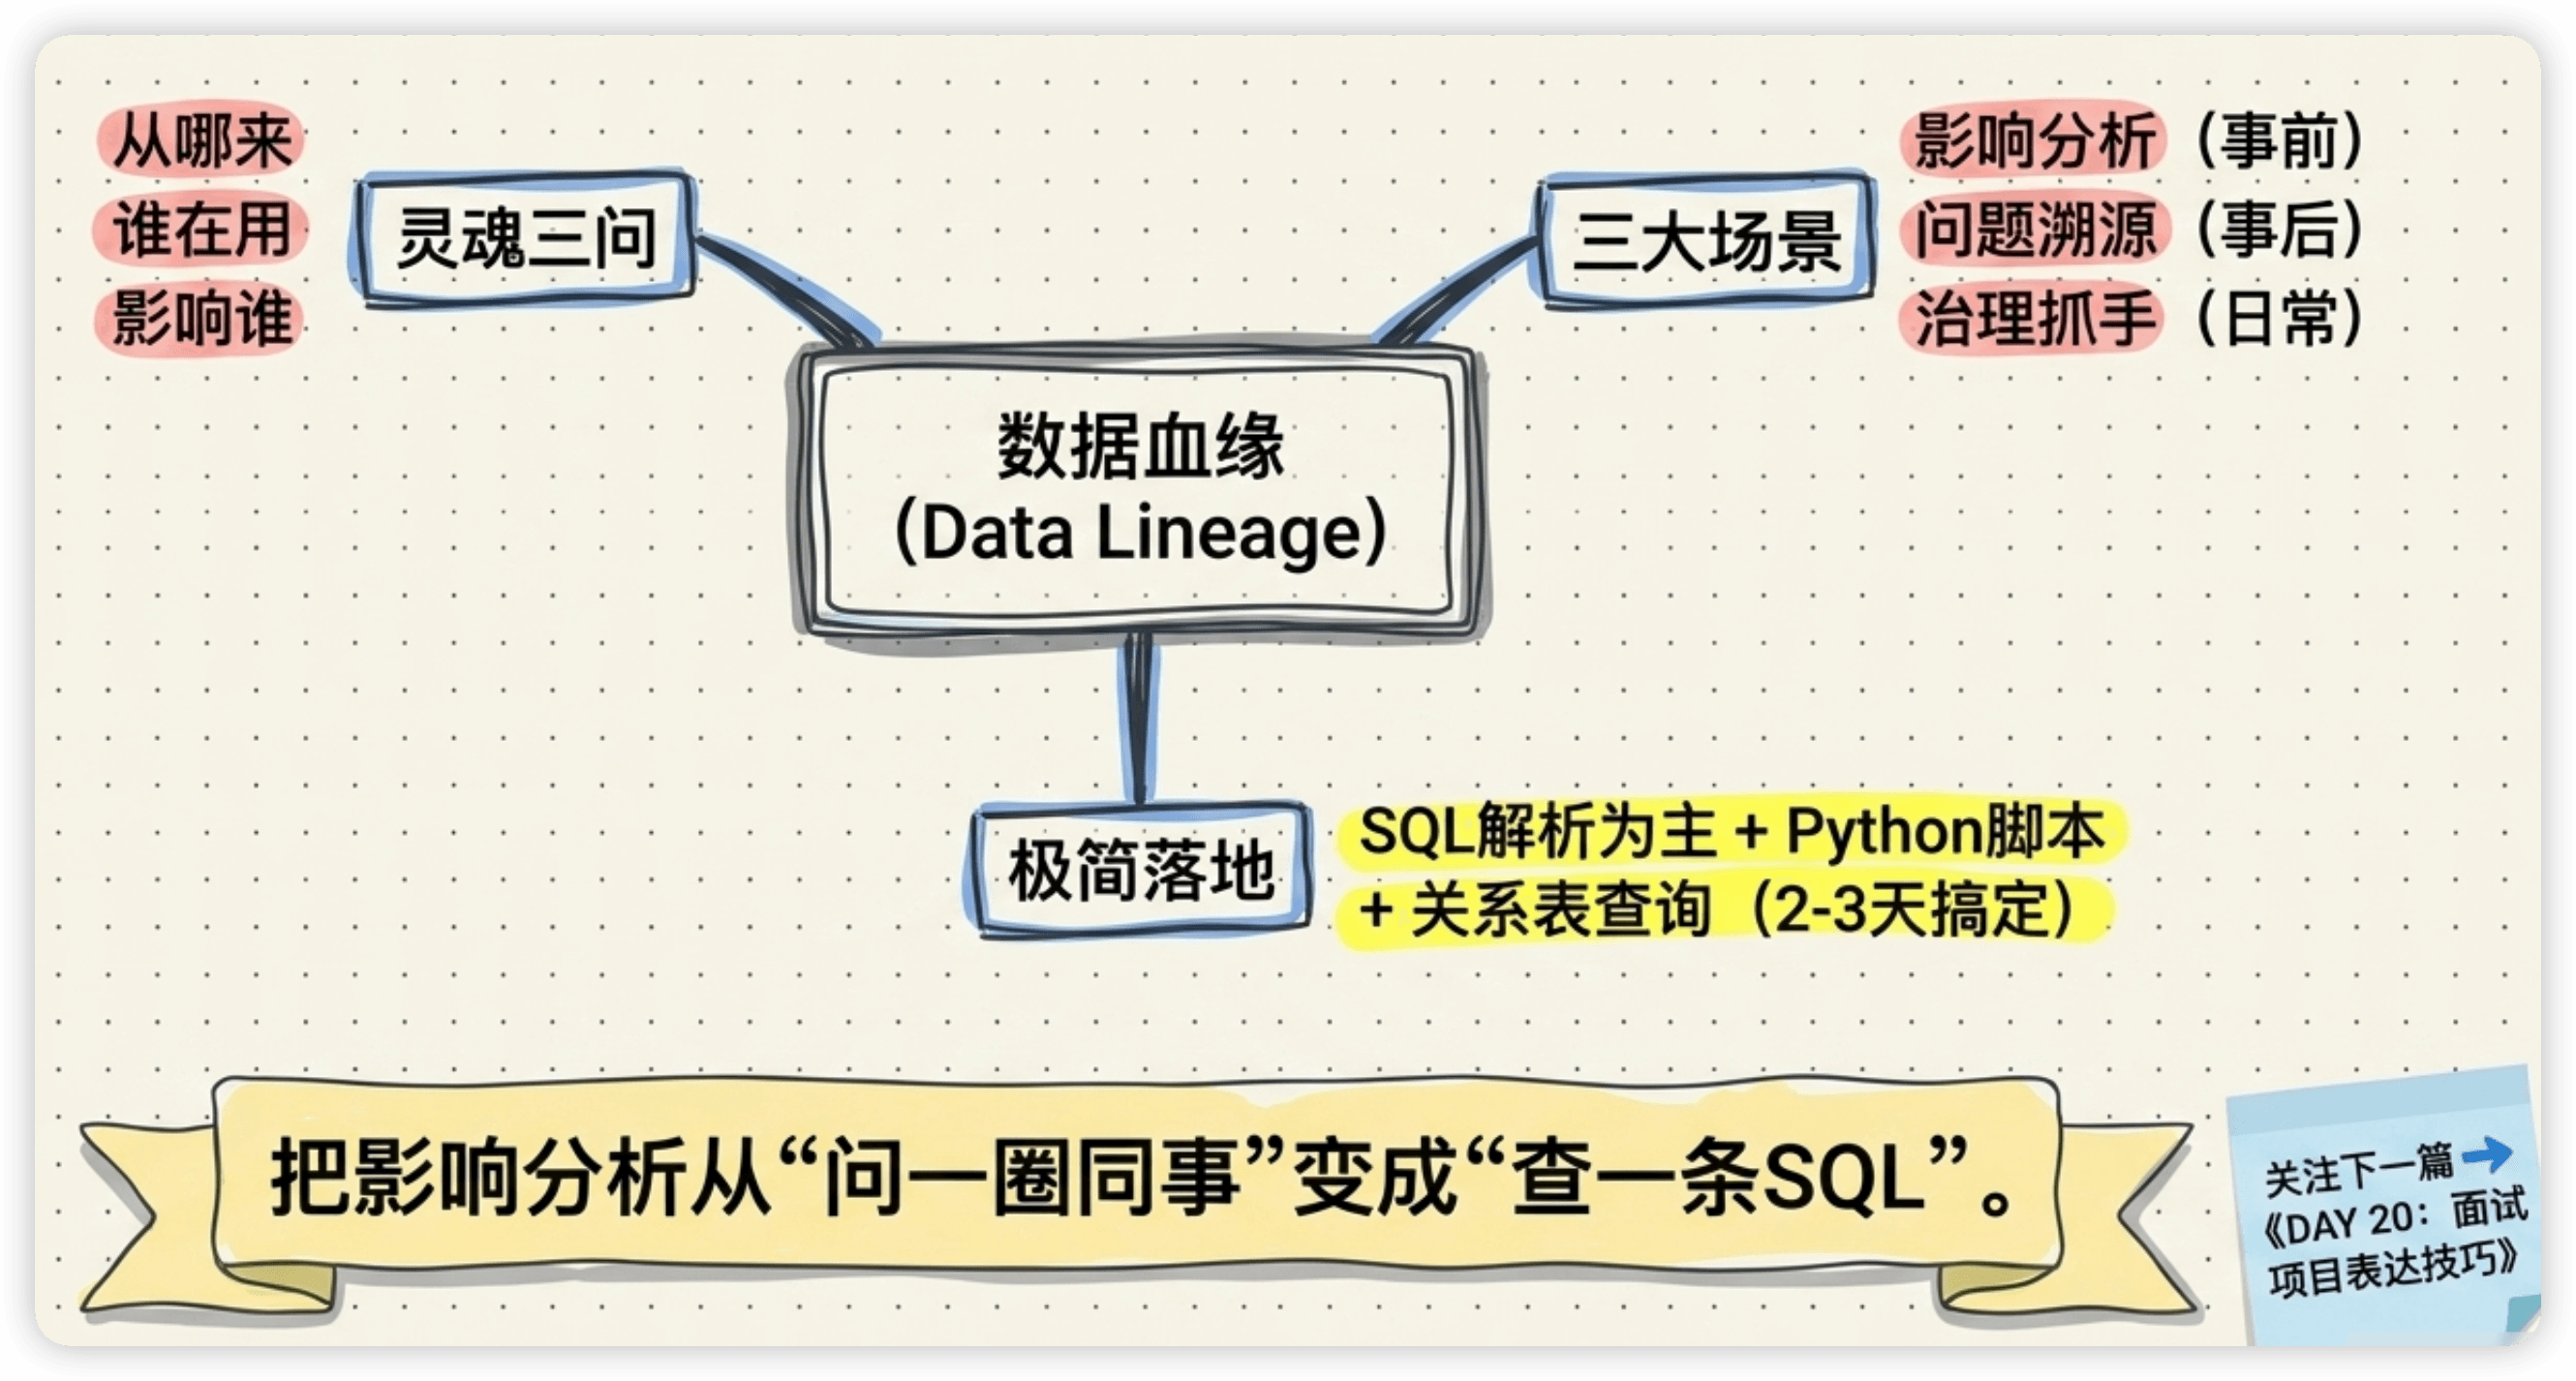
数据血缘
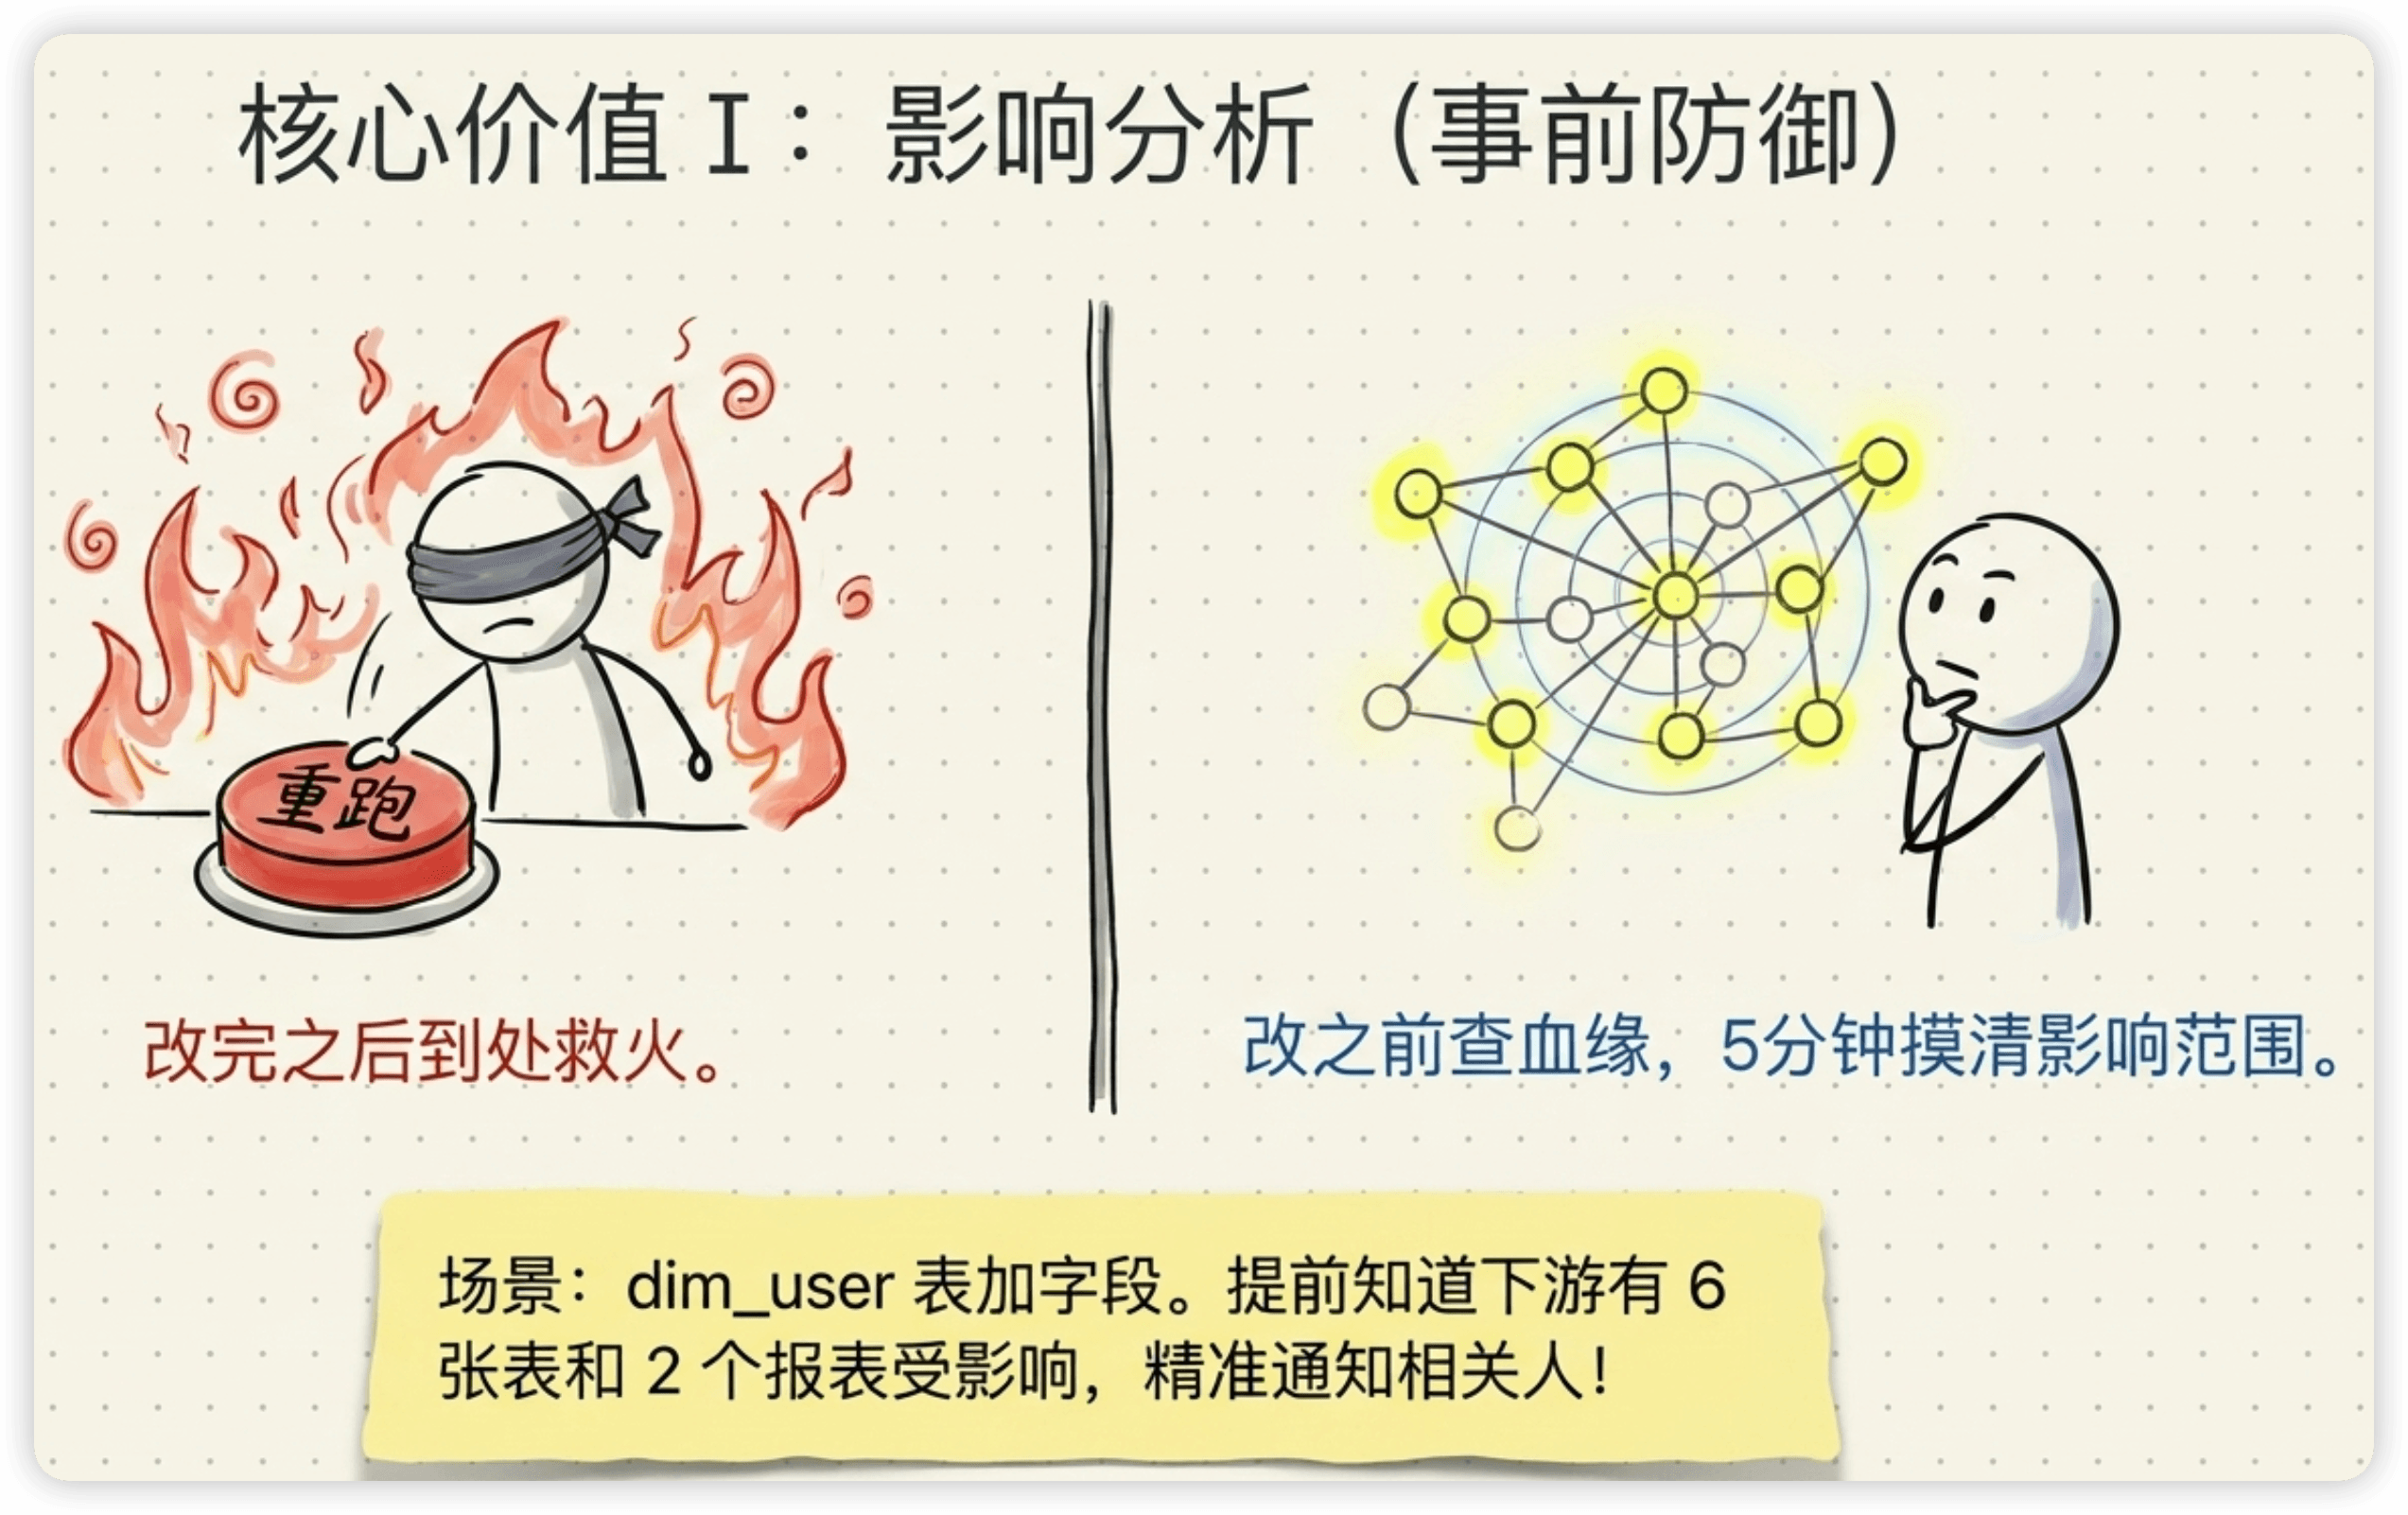
dim_user表要加一个字段,需要重跑ETL。你敢直接跑吗?
如果你不知道这张表有多少下游依赖,这次重跑可能引发一连串的"雪崩"——DWD表要重跑、DWS表要重跑、ADS报表数据变了、API接口返回值变了……你可能要花一天时间去问每个同事"你那边受影响没有"。
这就是没有数据血缘的代价。
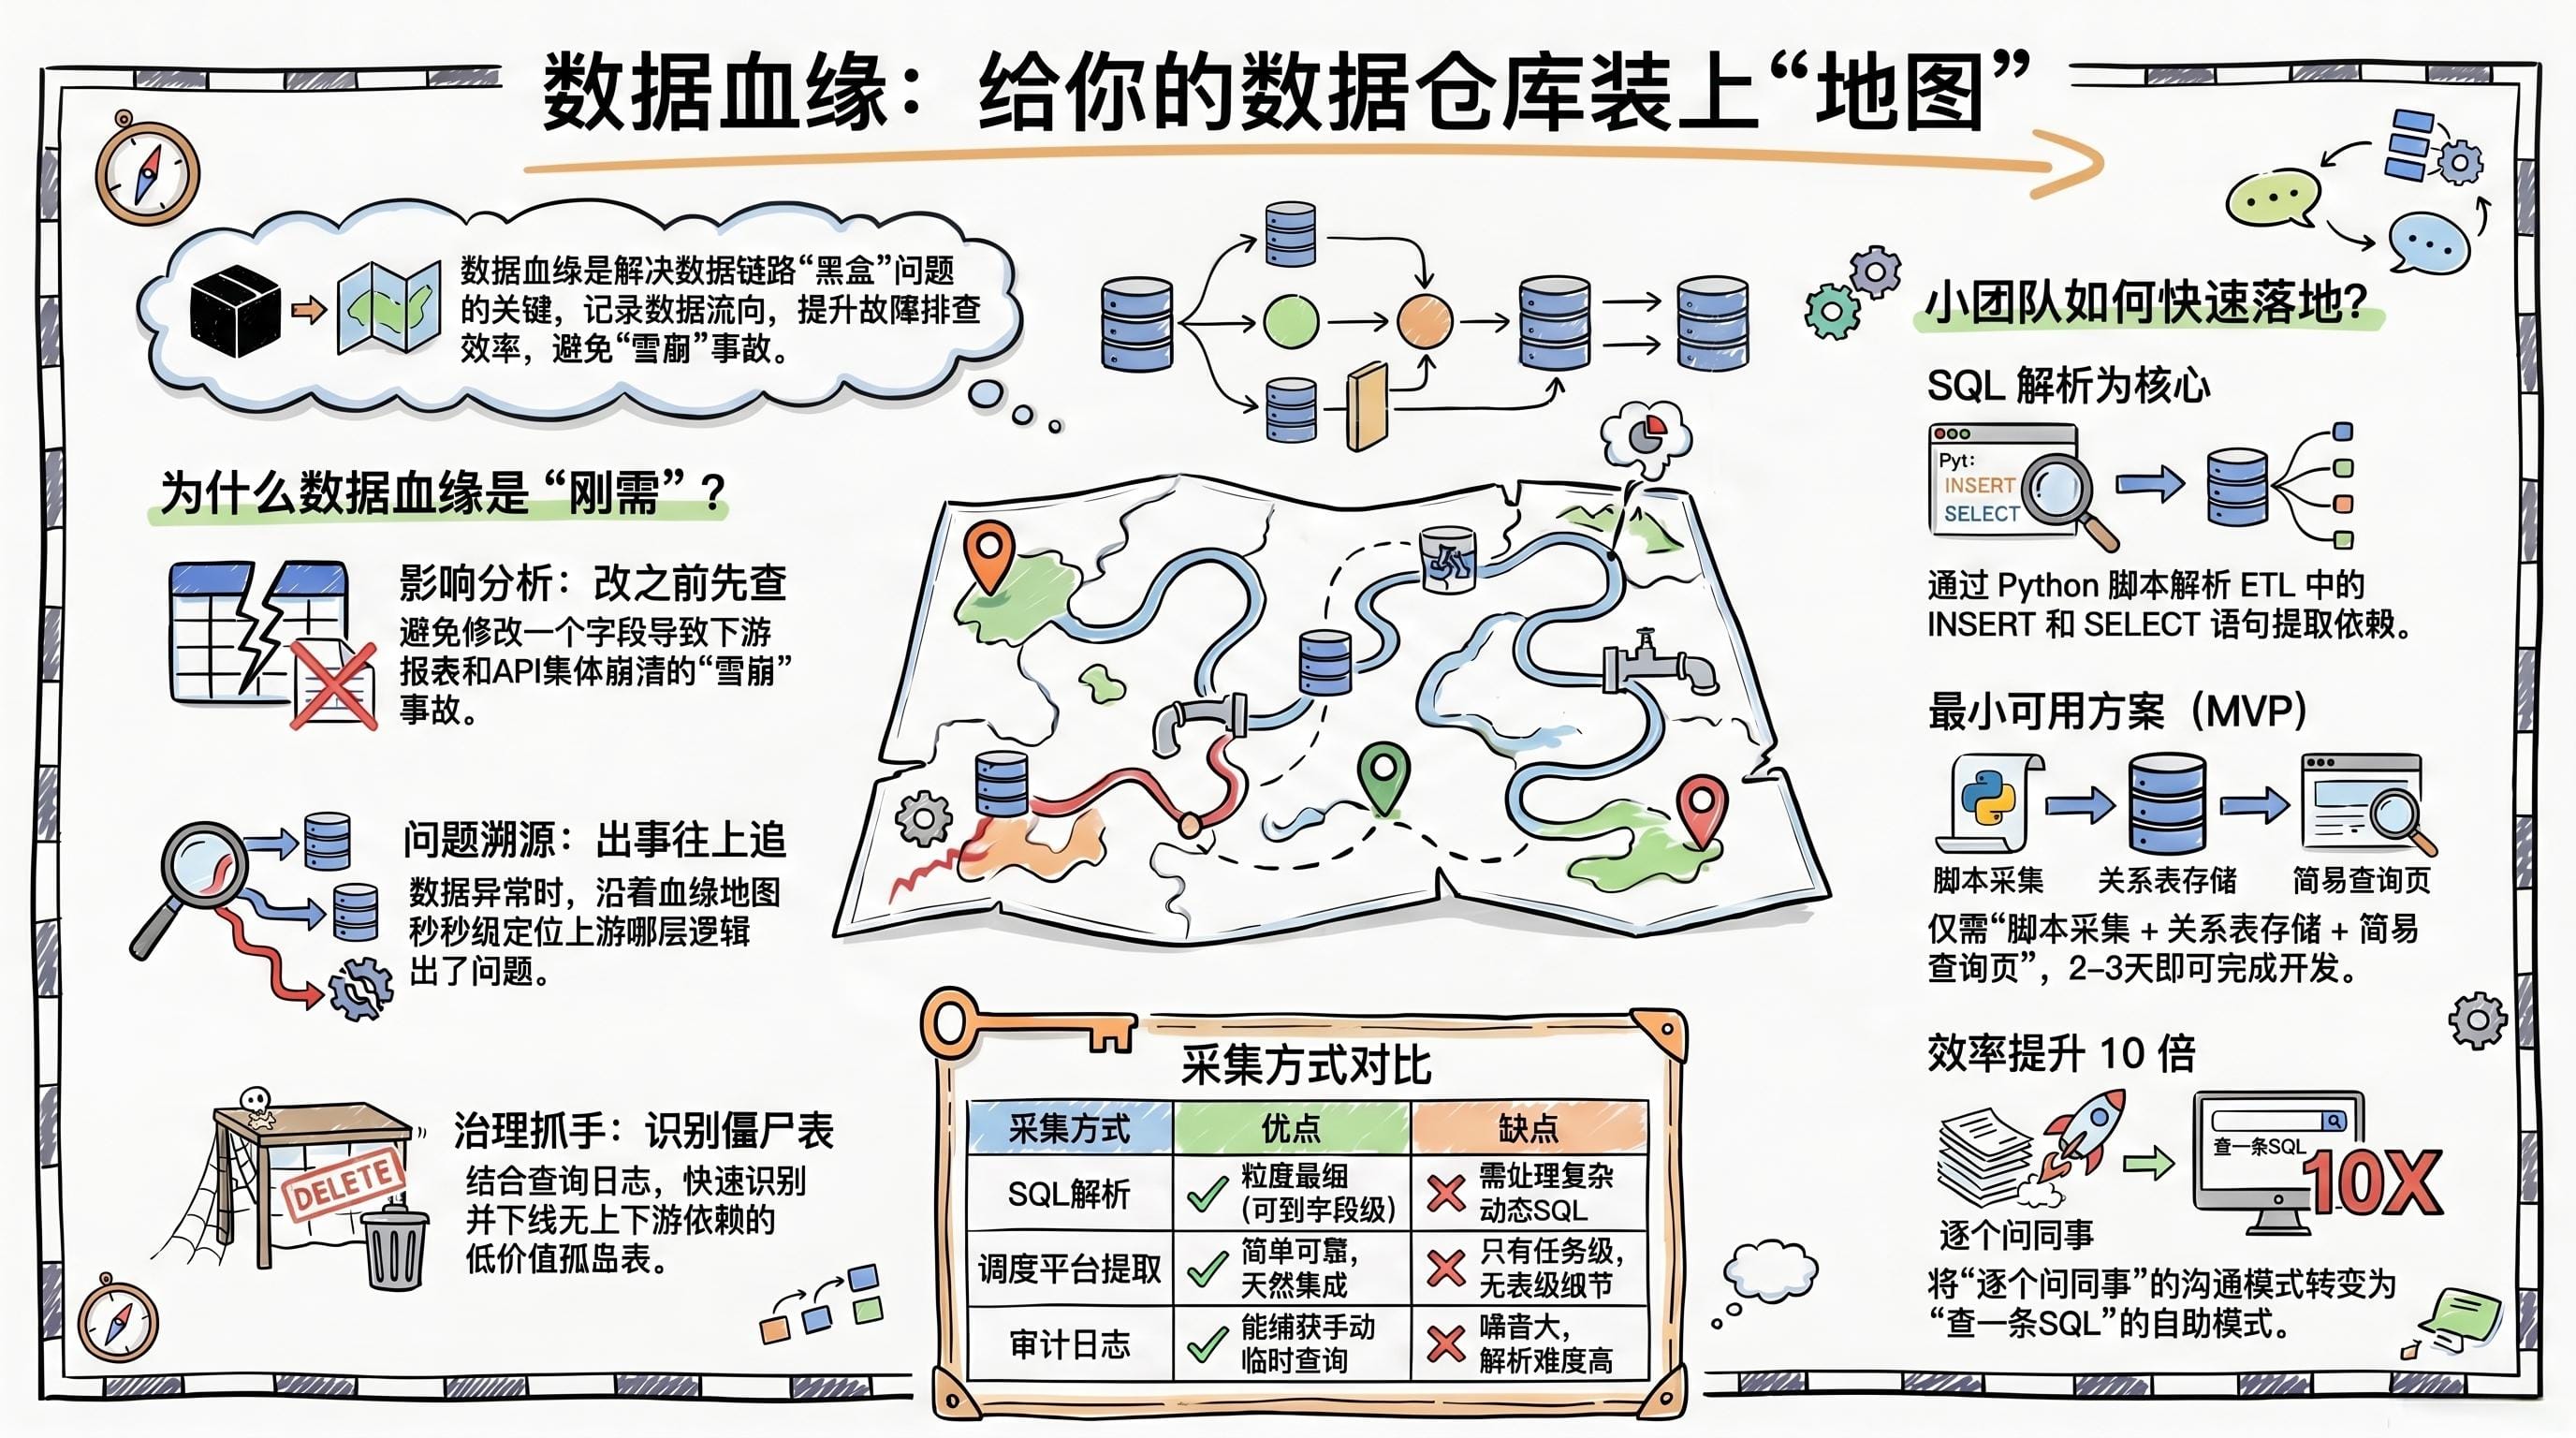
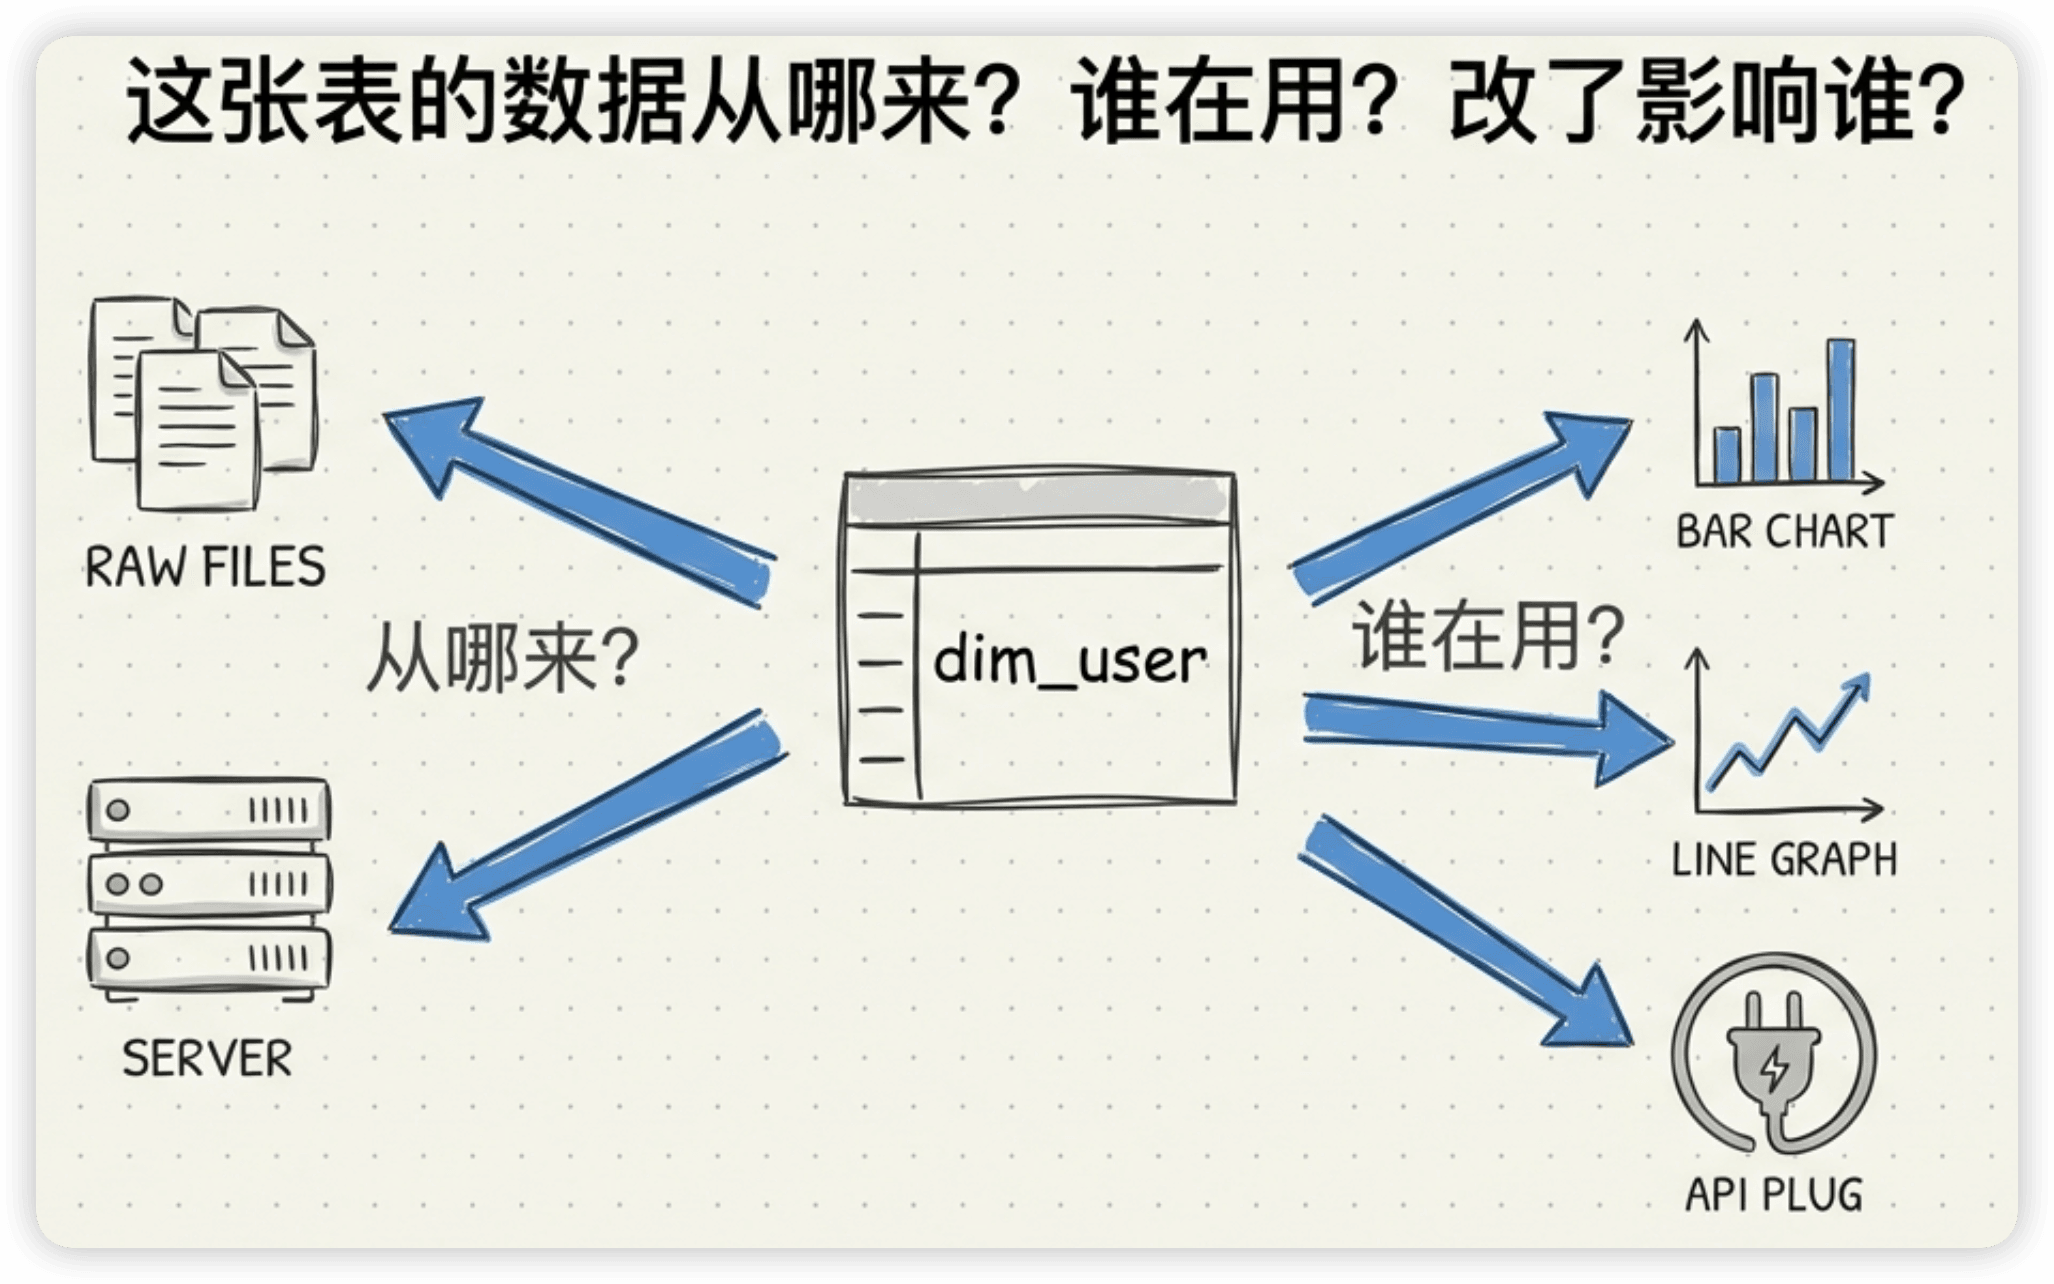
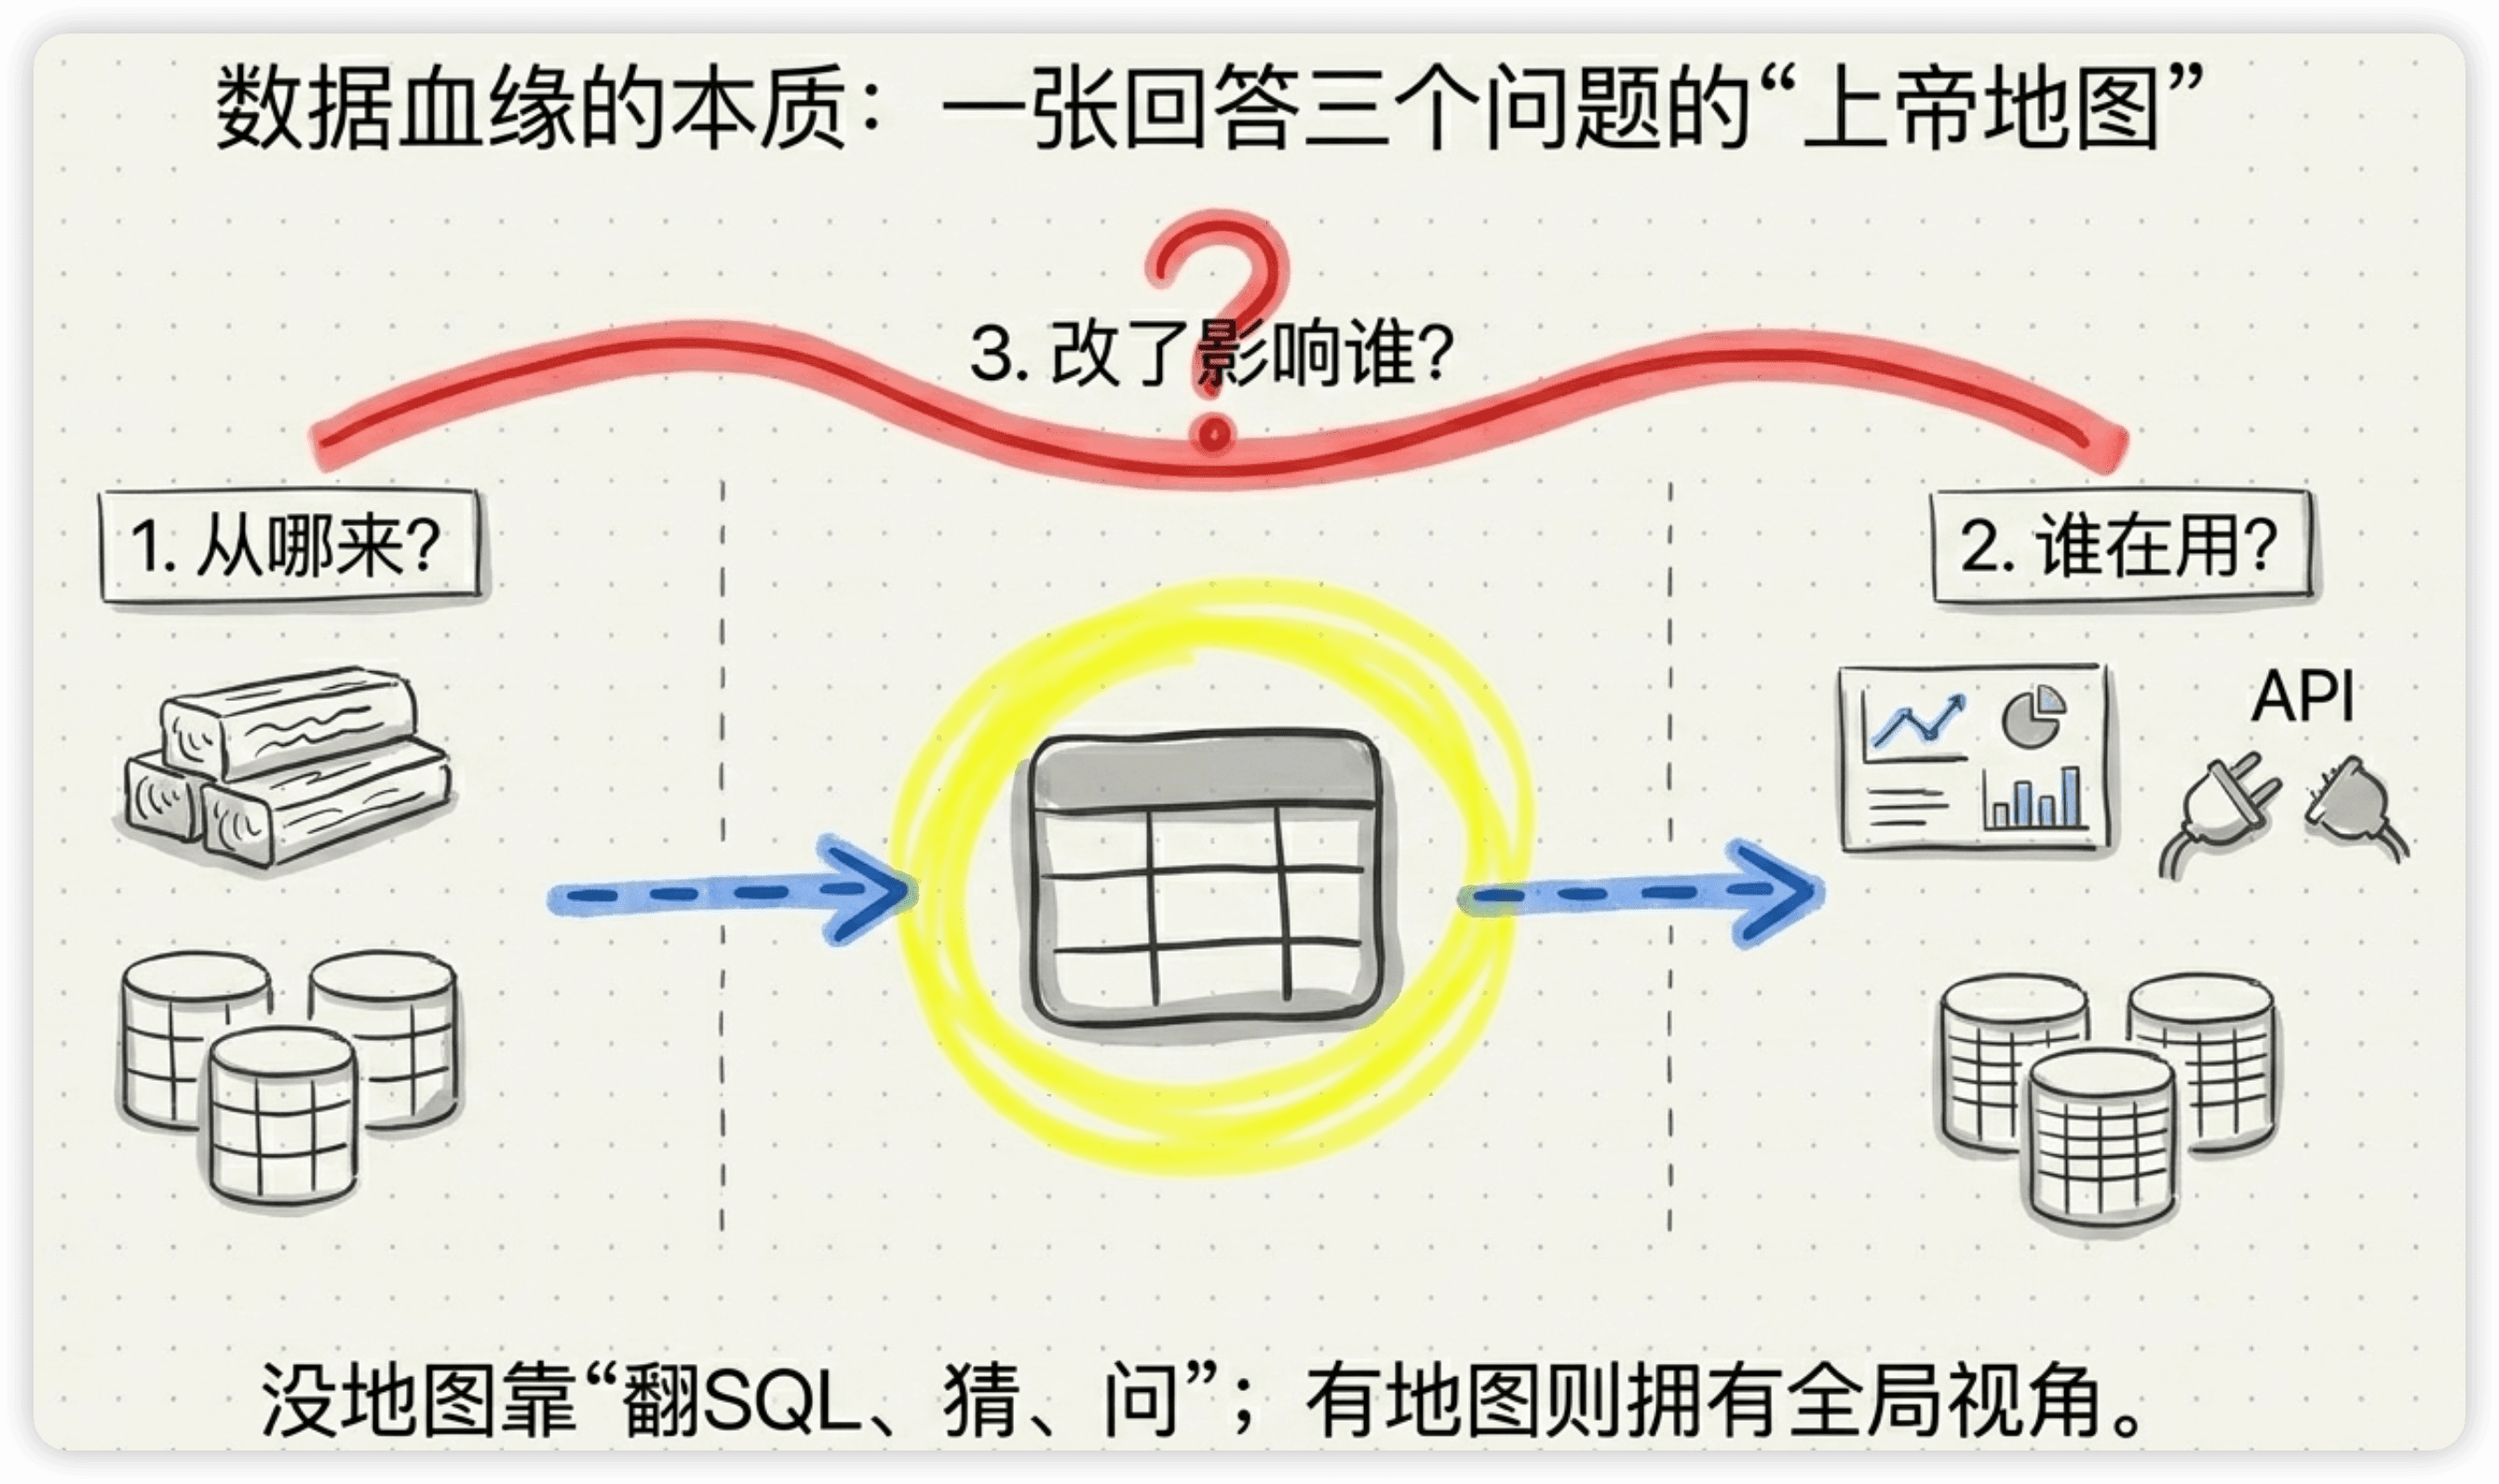
数据血缘说白了就是回答三个问题:这张表的数据从哪来?谁在用?改了会影响谁?有血缘的团队秒级定位,没血缘的团队靠翻SQL、问同事、猜。效率差10倍不夸张。
血缘解决的三大问题
问题一:影响分析(改之前先查)
场景:dim_user表要加字段重跑,需要知道下游有多少张表受影响。
血缘查询结果:

dim_user  → dwd_trade_order_detail_di  → dws_trade_user_pay_1d  → ads_daily_report
dim_user  → dwd_user_login_detail_di   → dws_user_behavior_1d   → ads_retention_report
dim_user  → dws_user_wide                                       → BI大屏接口

影响范围:3条链路,6张表,2个报表,1个API接口。
预估重跑时间:约2小时。
需要通知:报表负责人A、API负责人B。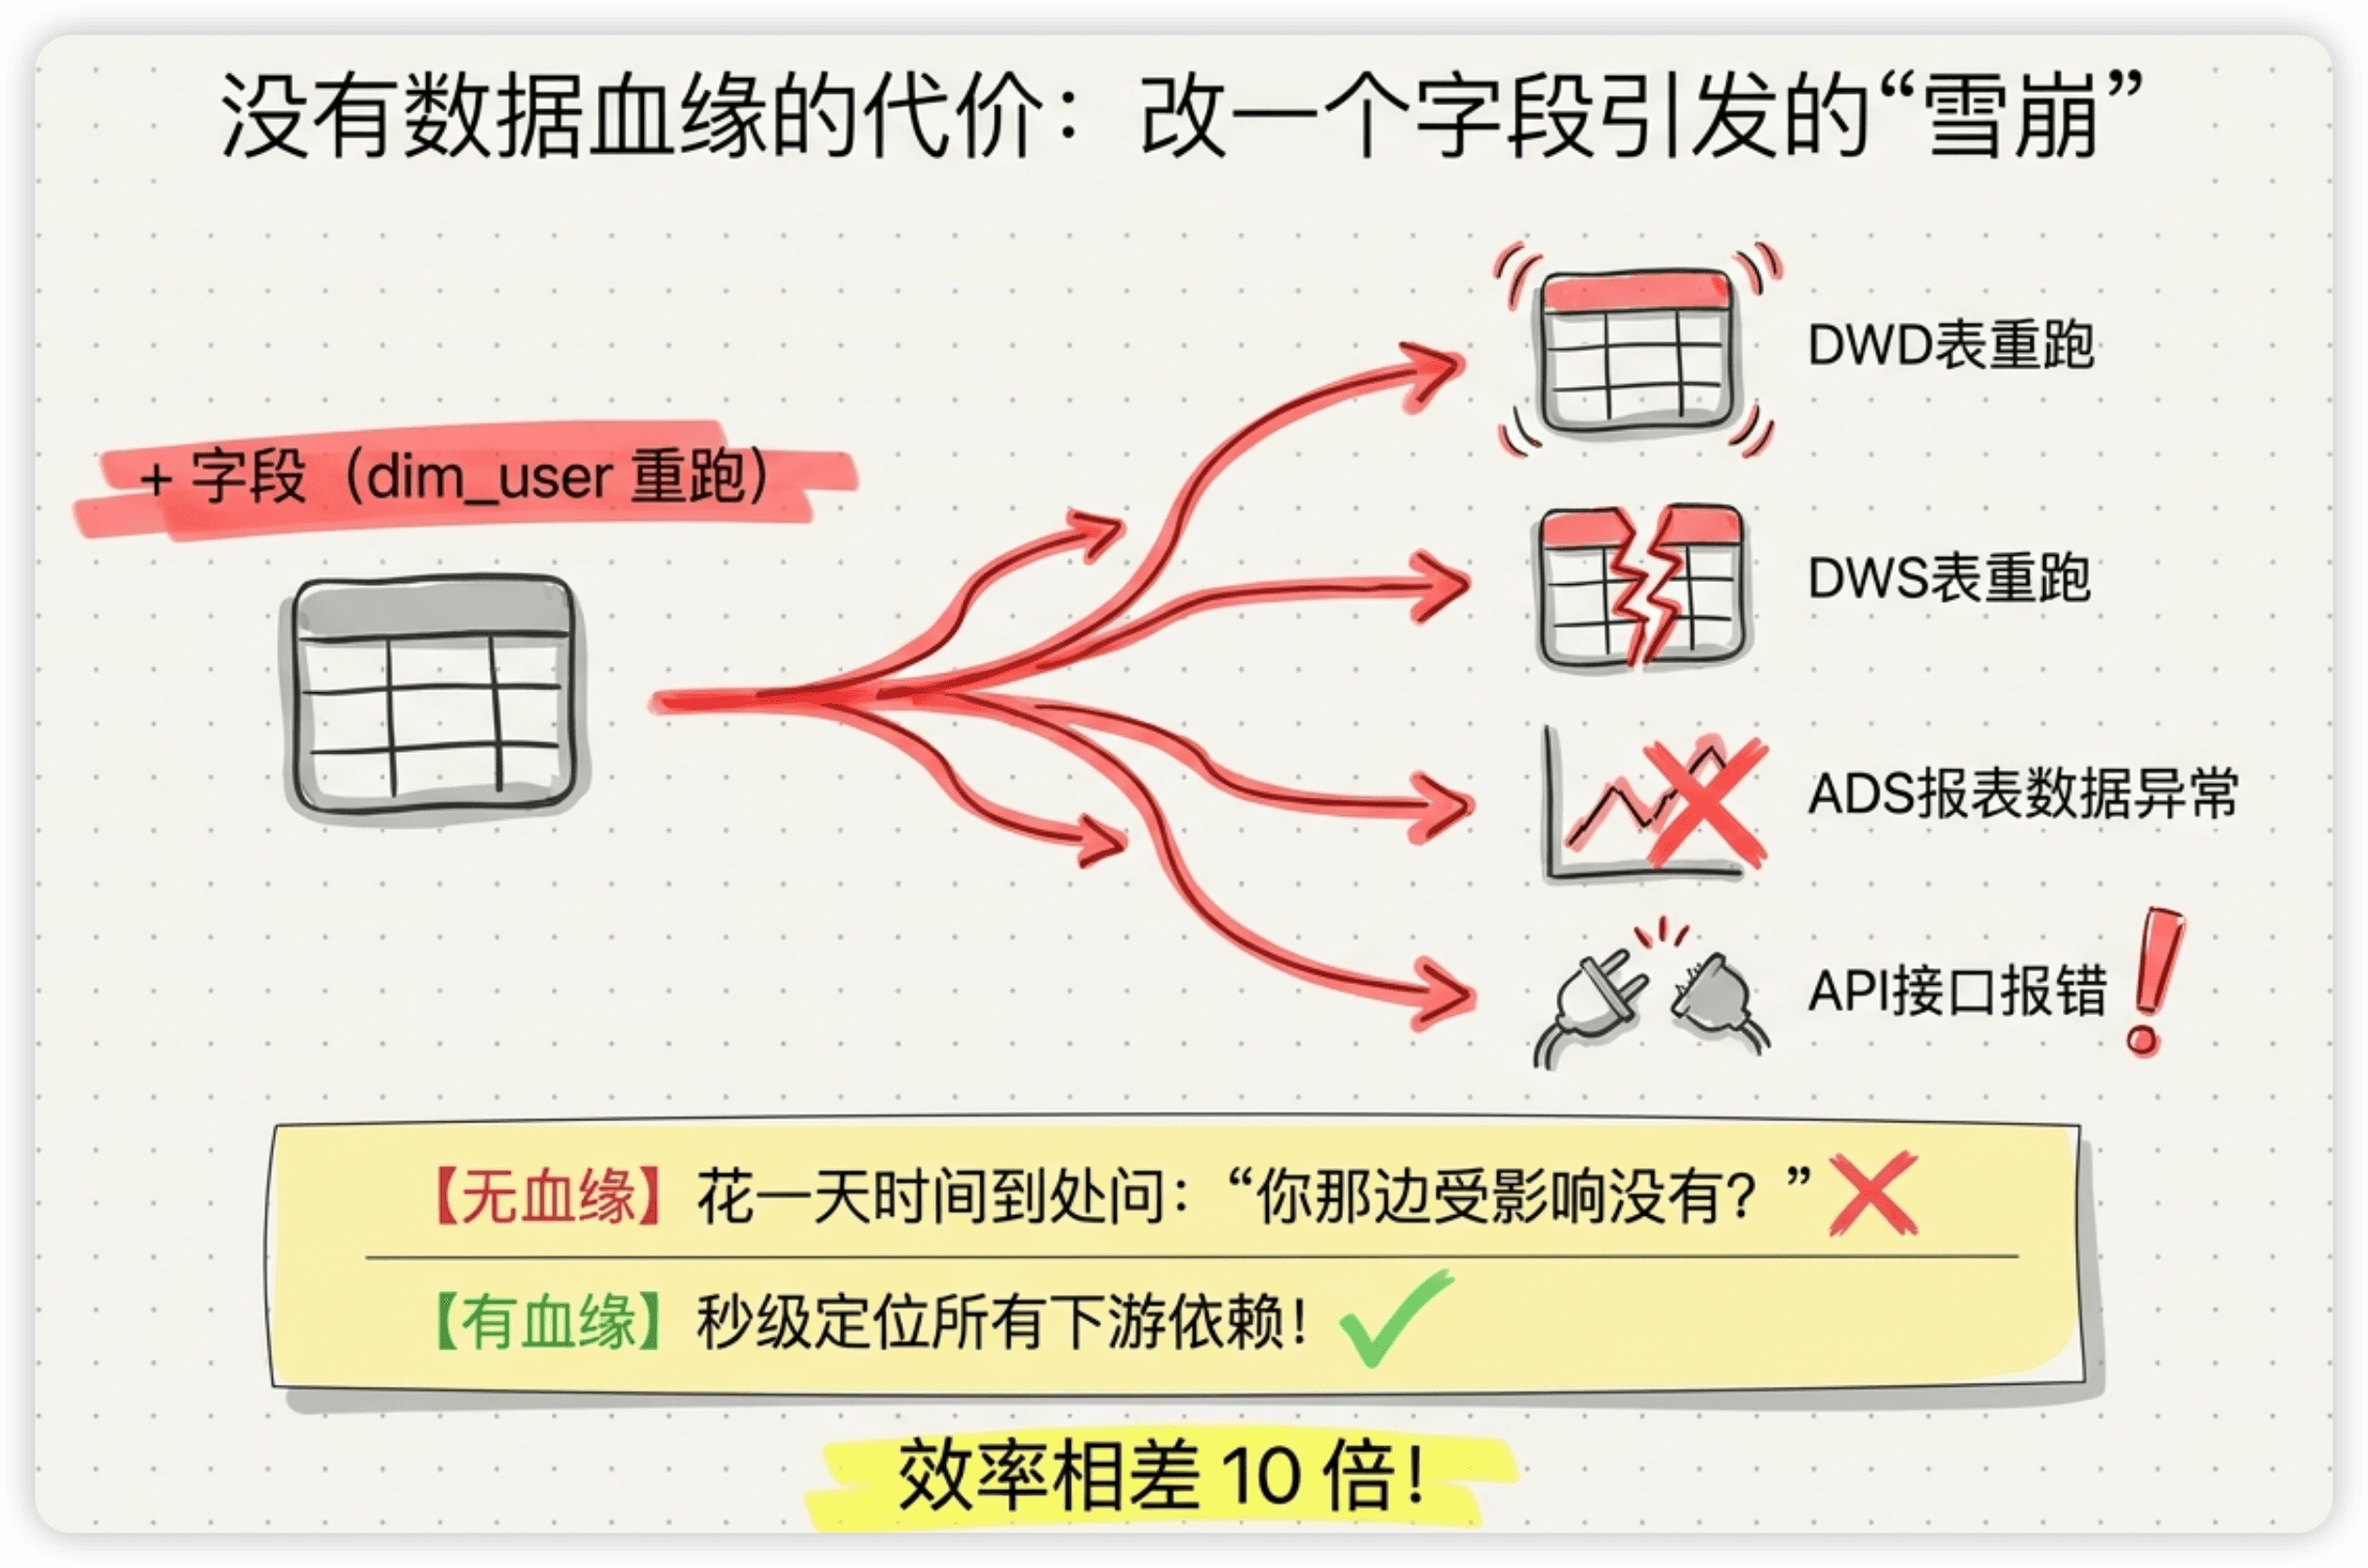
5分钟查清楚影响范围,远比改完之后到处救火强。
问题二:问题溯源(出了问题往上追)
DAY 18讲了质量监控告警之后的溯源方法。血缘就是溯源的"地图"。
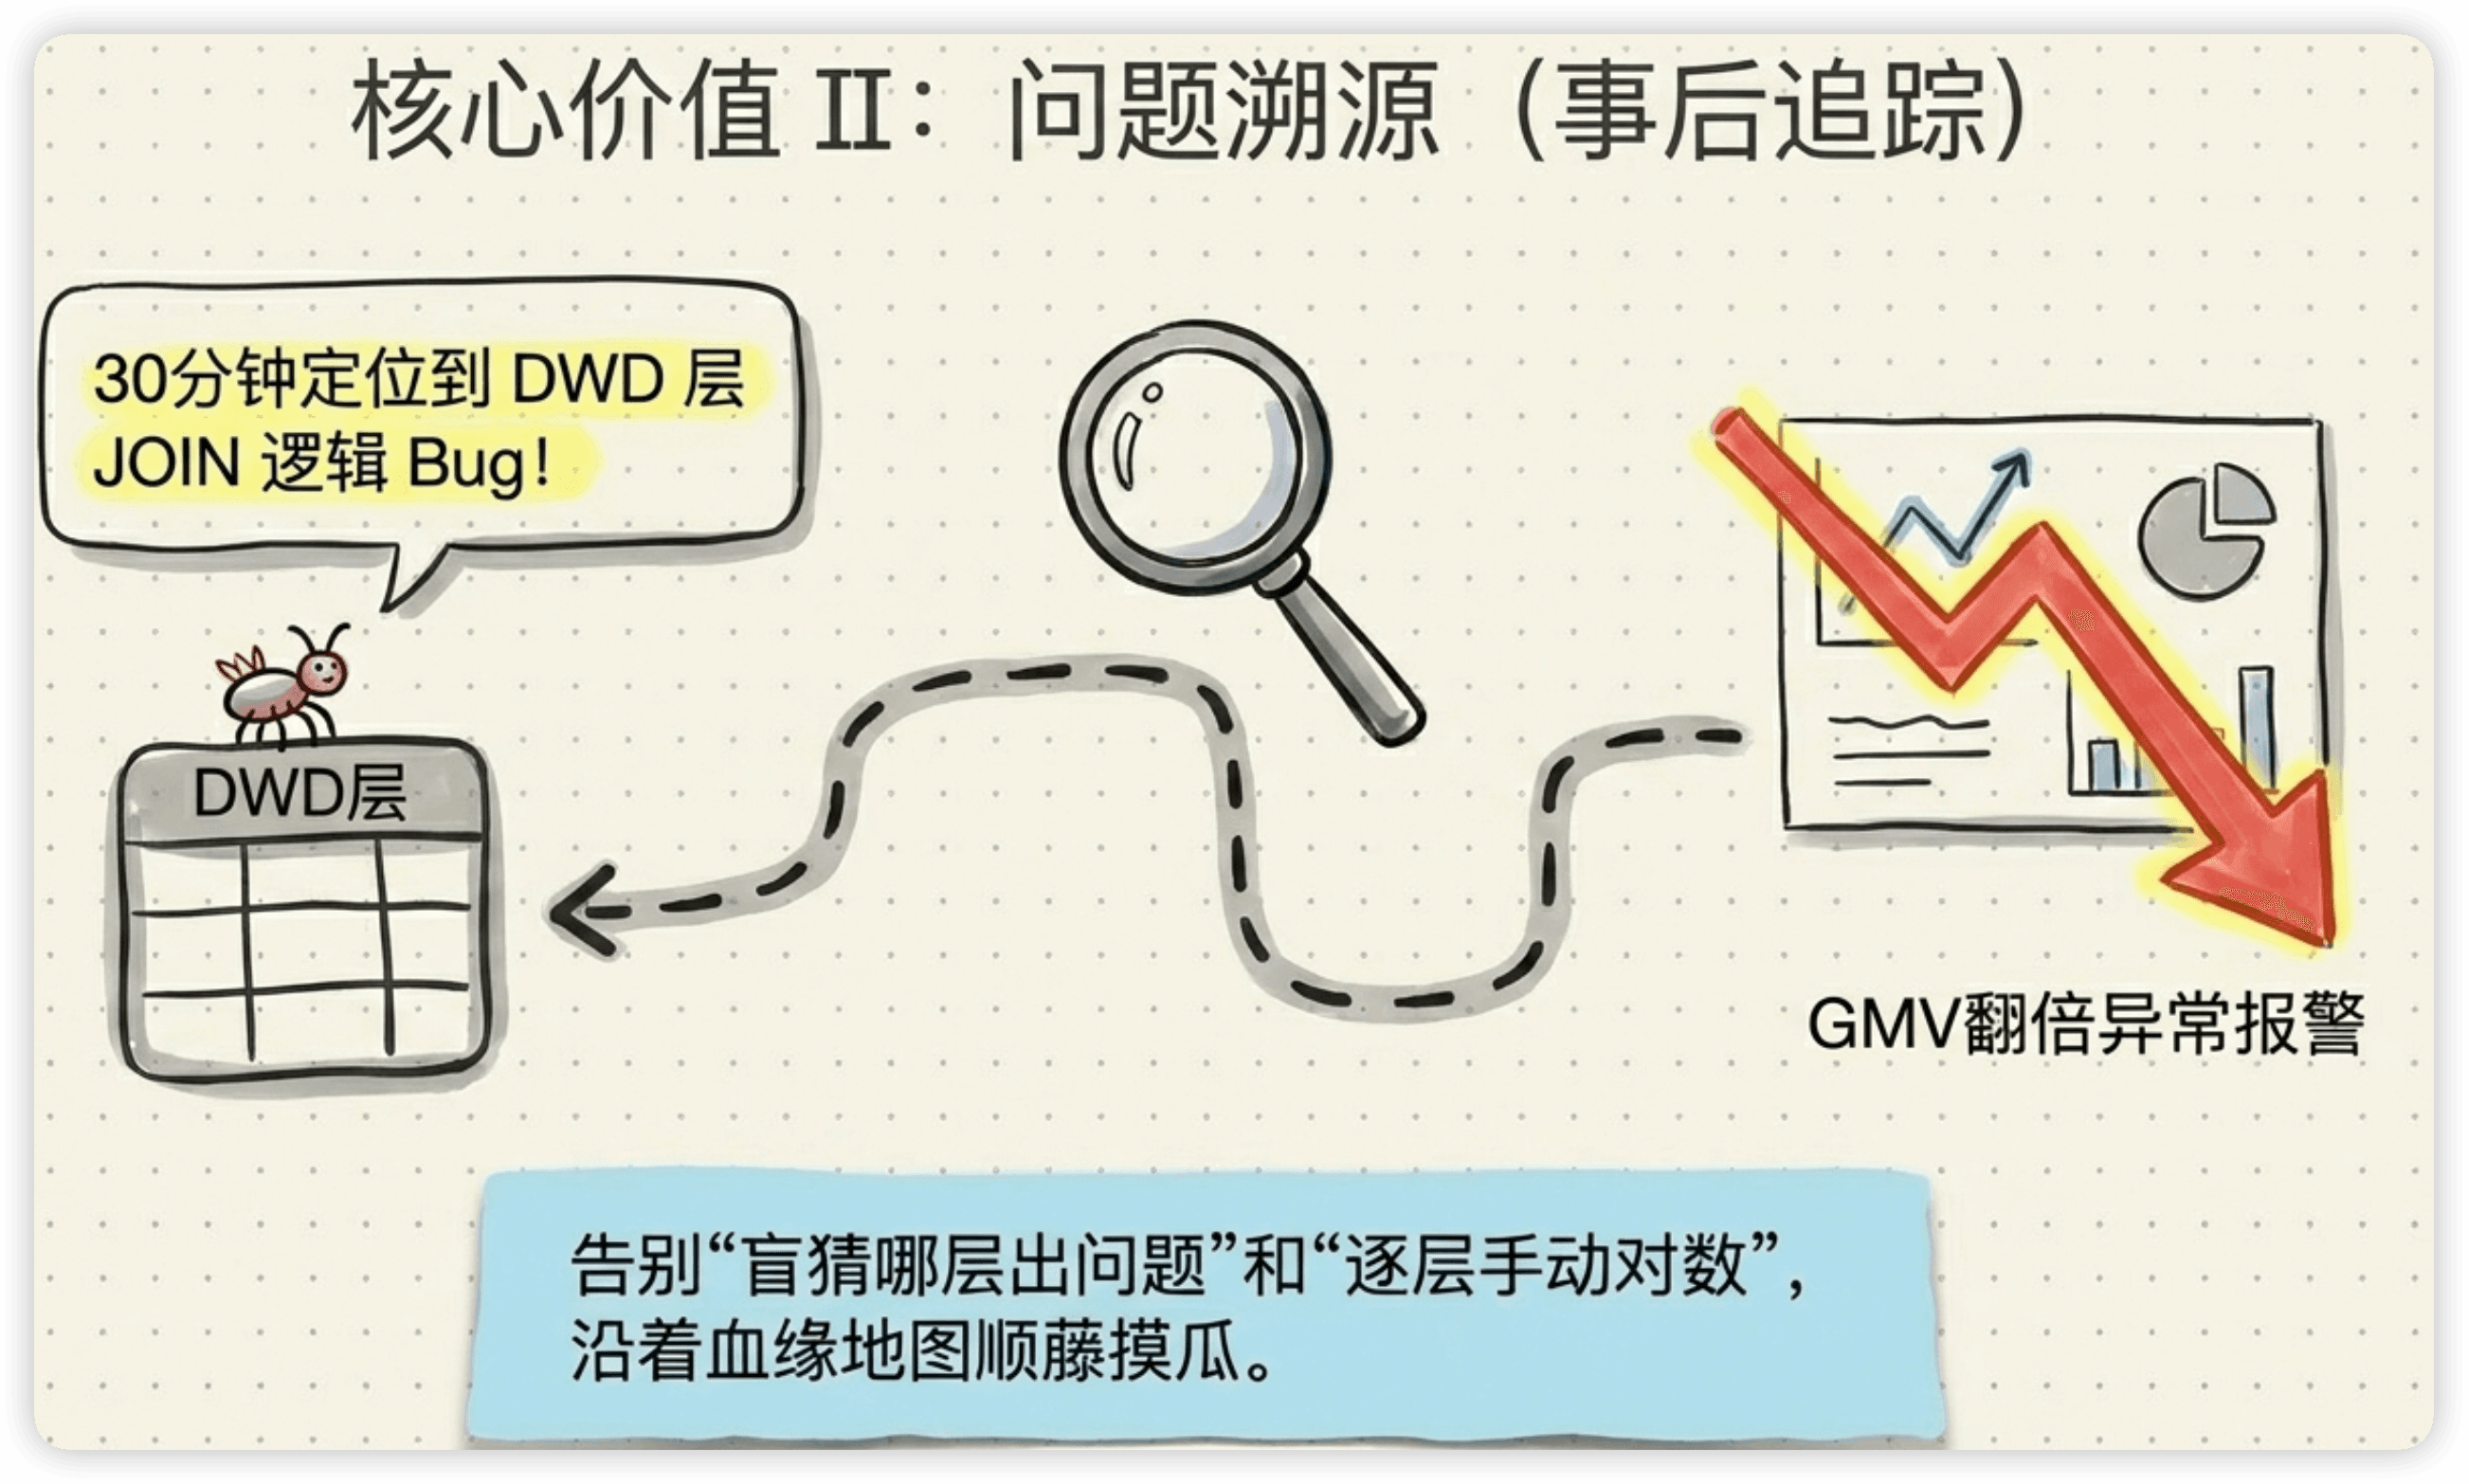
场景:ads_daily_report的GMV突然翻倍。

沿血缘往上追:
ads_daily_report ← dws_trade_summary_1d  → 数据翻倍 ❌
                 ← dwd_trade_order_detail ← 数据翻倍 ❌ ← 问题在这里!
                 ← ods_order               → 数据正常 ✅

定位:dwd层的ETL逻辑有问题。
排查:JOIN dim_user时拉链表没加is_current过滤,用户维度重复导致膨胀。
修复时间:从发现到定位到修复,全程30分钟。
没有血缘的话,你得先猜"可能是哪层的问题",然后逐层手动对数。一个下午可能都查不完。
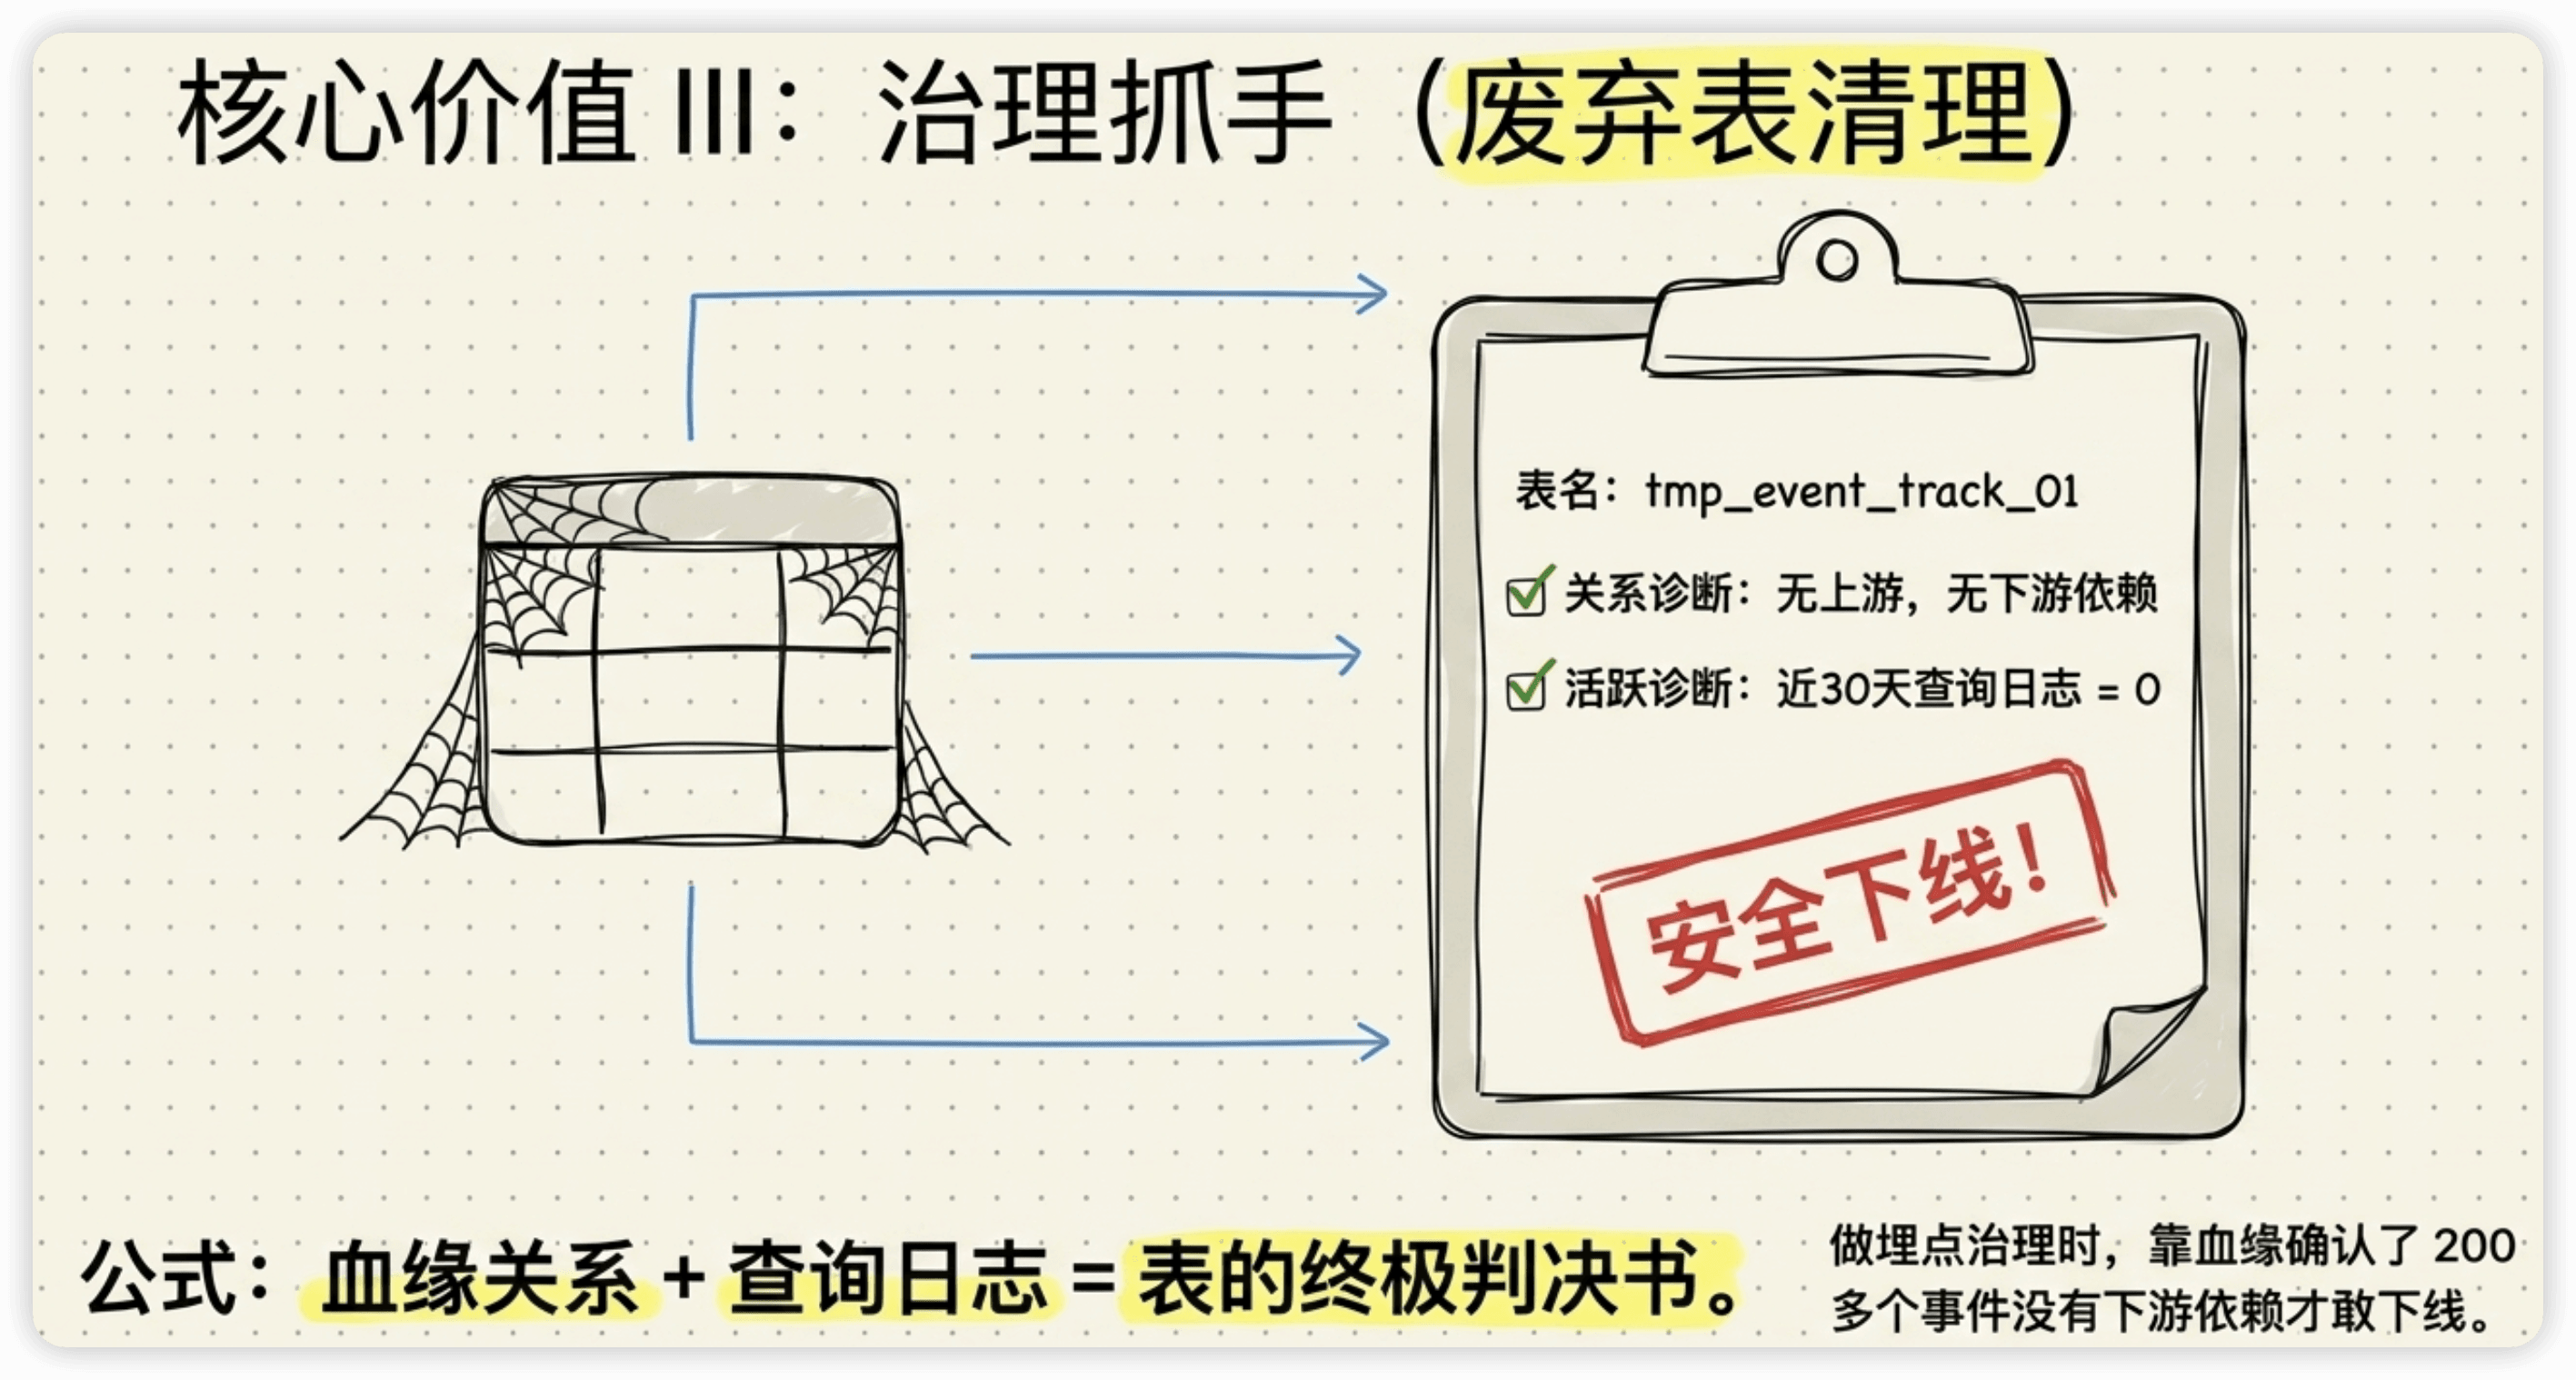
问题三:治理抓手(谁建的?还有用吗?)
DAY 16讲中间表治理时,判断一张表有没有用的核心依据就是血缘:
有上游、有下游 → 活跃表,正常维护
有上游、无下游 → 末端表,可能是废弃报表或测试表
无上游、有下游 → 源头表(ODS/外部输入),检查是否仍在产出
无上游、无下游 → 孤岛表,大概率可以下线
血缘 + 查询日志 = 表的完整"体检报告"。
血缘怎么建?
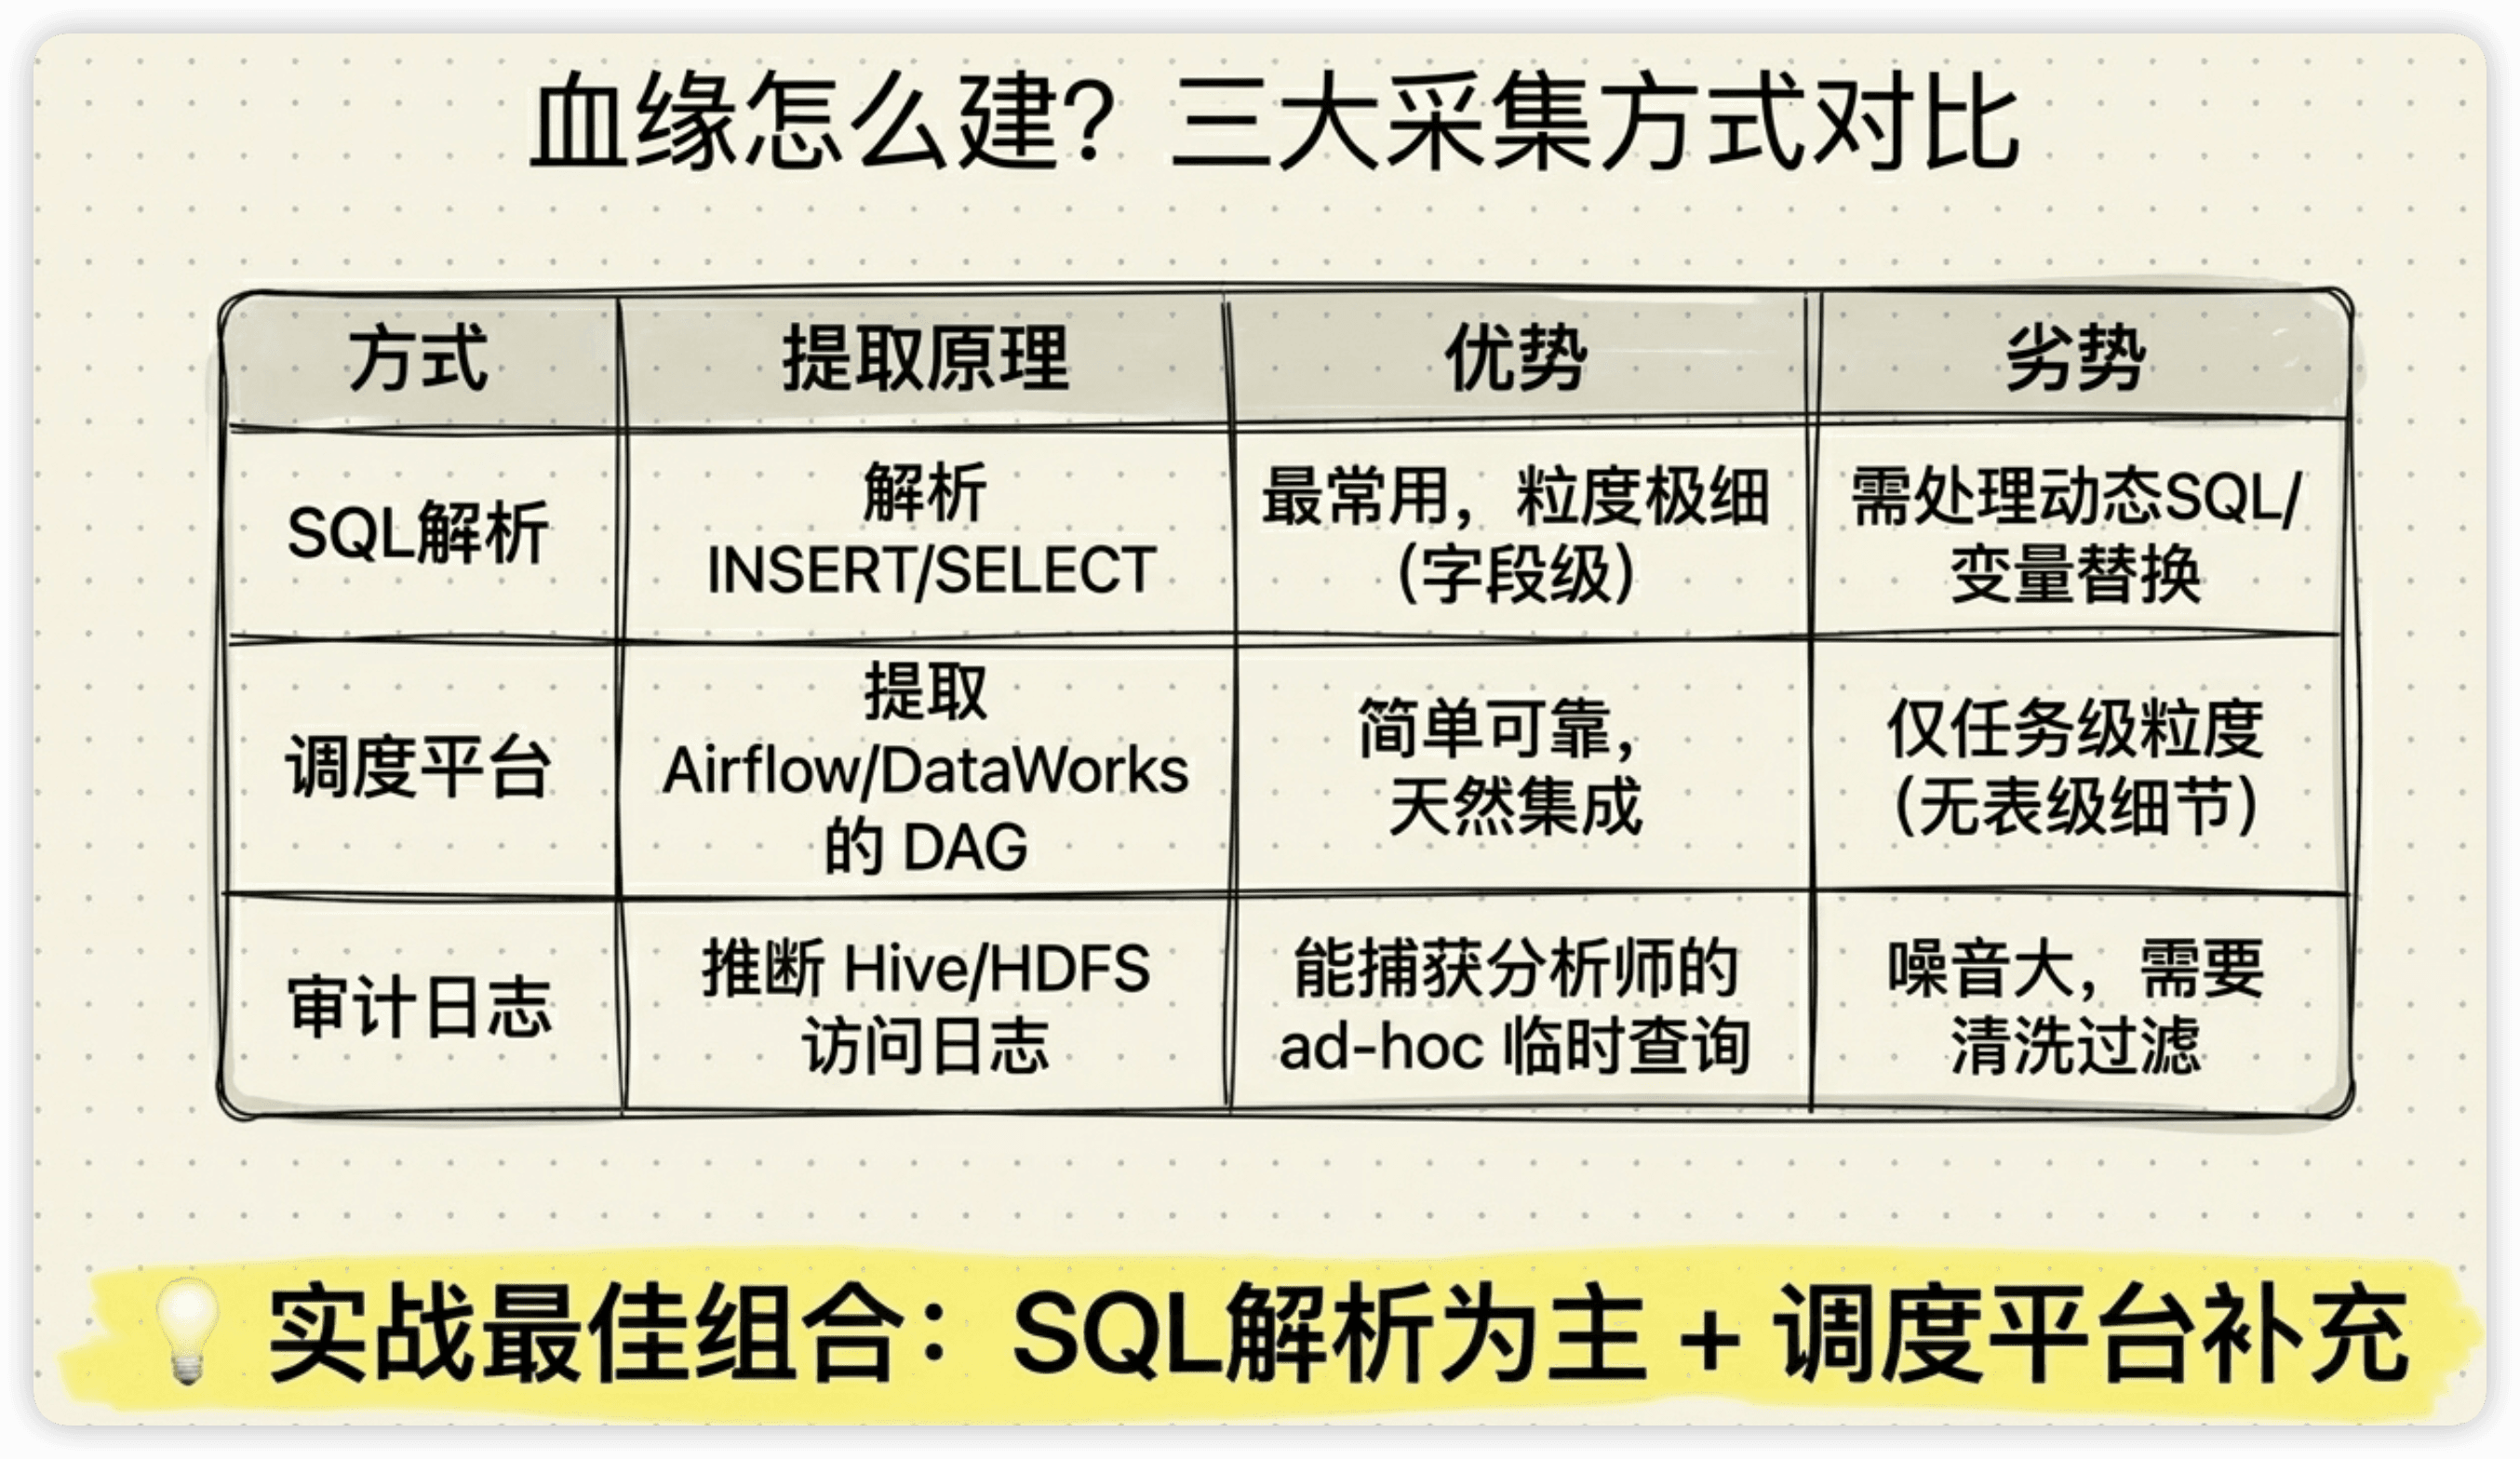
采集方式
| 方式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| SQL解析 | 解析ETL脚本中的INSERT/SELECT语句,提取源表和目标表 | 最常用,粒度细(可到字段级) | 需要处理动态SQL、变量替换 |
| 调度平台提取 | 从Airflow/DataWorks的任务DAG中提取任务间依赖 | 简单可靠,和调度天然集成 | 只有任务级粒度,看不到表级细节 |
| 审计日志 | 从Hive Metastore/HDFS的访问日志中推断 | 能捕获ad-hoc查询 | 噪音大,需要过滤 |
实际项目中通常SQL解析为主 + 调度平台补充。
SQL解析的核心逻辑:
# 简化示例:从SQL中提取源表和目标表
import sqlparse

def extract_lineage(sql):
    """从INSERT ... SELECT语句中提取血缘关系"""
    parsed = sqlparse.parse(sql)[0]

    # 目标表:INSERT OVERWRITE TABLE 后面的表名
    target = extract_after_keyword(parsed, 'INTO TABLE') or \
             extract_after_keyword(parsed, 'OVERWRITE TABLE')

    # 源表:FROM 和 JOIN 后面的表名
    sources = extract_after_keywords(parsed, ['FROM', 'JOIN'])

    return {
        'target': target,
        'sources': sources
    }

# 示例
sql = """
INSERT OVERWRITE TABLE dws_trade_user_pay_1d PARTITION(dt='2025-01-15')
SELECT f.user_id, SUM(f.pay_amount), d.city
FROM dwd_trade_order_detail_di f
JOIN dim_user d ON f.user_id = d.user_id
WHERE f.dt = '2025-01-15'
"""

lineage = extract_lineage(sql)
# {'target': 'dws_trade_user_pay_1d',
#  'sources': ['dwd_trade_order_detail_di', 'dim_user']}
实际的SQL解析比这复杂得多——要处理子查询、CTE、UNION、动态分区、变量替换等。但核心思路就是从INSERT语句中提取目标表,从SELECT语句中提取源表。
存储模型
血缘数据存在一张关系表里,结构很简单:
CREATE TABLE meta_lineage (
    source_table  STRING    COMMENT '上游表名',
    target_table  STRING    COMMENT '下游表名',
    source_fields STRING    COMMENT '上游字段列表(字段级血缘,可选)',
    target_fields STRING    COMMENT '下游字段列表(可选)',
    job_name      STRING    COMMENT 'ETL任务名',
    lineage_type  STRING    COMMENT '采集来源:sql_parse/scheduler/audit',
    update_time   TIMESTAMP COMMENT '最后更新时间'
);
使用方式
查上游(数据从哪来):
-- 查 dws_trade_user_pay_1d 的上游
SELECT source_table, job_name
FROM meta_lineage
WHERE target_table = 'dws_trade_user_pay_1d';

-- 结果:
-- dwd_trade_order_detail_di  |  job_dws_trade_pay
-- dim_user                    |  job_dws_trade_pay
查下游(谁在用):
-- 查 dim_user 的下游(改dim_user会影响谁)
SELECT target_table, job_name
FROM meta_lineage
WHERE source_table = 'dim_user';

-- 结果:
-- dwd_trade_order_detail_di  |  job_dwd_order
-- dws_user_behavior_1d       |  job_dws_user_behavior
-- dws_user_wide              |  job_dws_user_wide
查完整链路(递归查询):
-- 从ods_order到最终报表的完整链路
WITH RECURSIVE lineage_chain AS (
    -- 起点
    SELECT source_table, target_table, 1 AS depth
    FROM meta_lineage
    WHERE source_table = 'ods_order'

    UNION ALL

    -- 递归查下游的下游
    SELECT l.source_table, l.target_table, c.depth + 1
    FROM meta_lineage l
    JOIN lineage_chain c ON l.source_table = c.target_table
    WHERE c.depth < 10  -- 防止无限递归
)
SELECT * FROM lineage_chain ORDER BY depth;
小团队的血缘落地方案
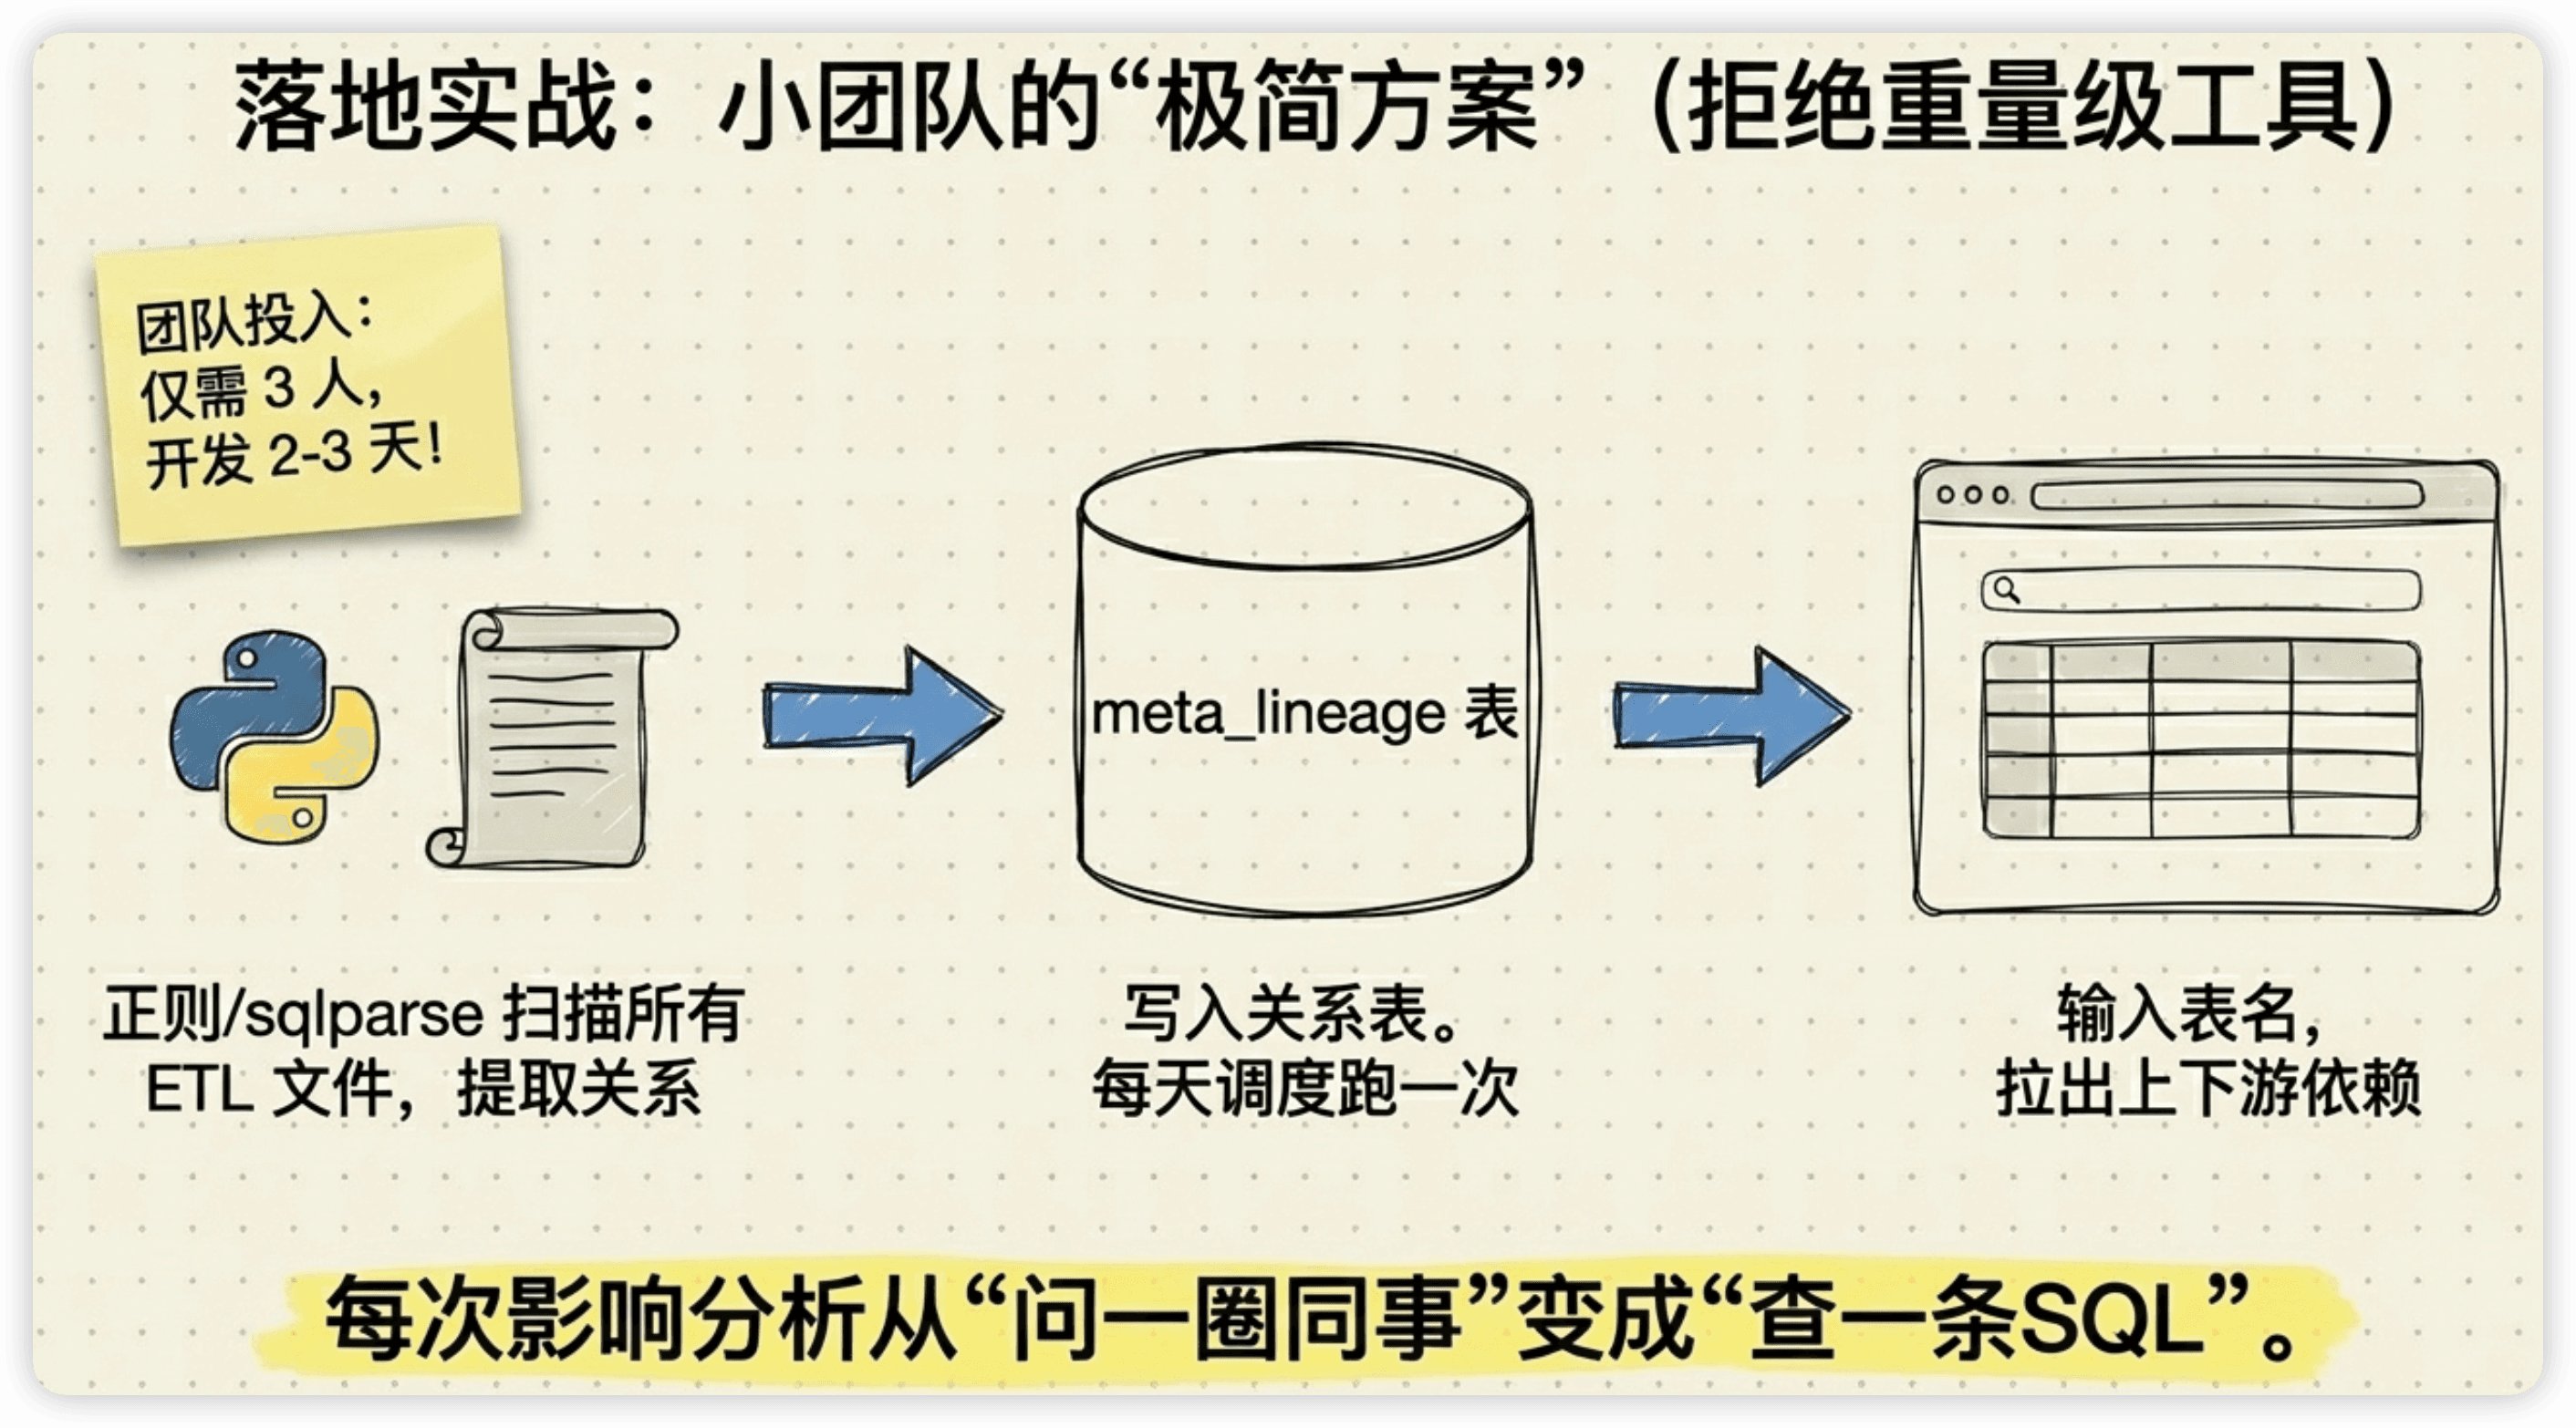
小团队不需要上Atlas/DataHub这种重量级方案。我们3个人的团队,用SQL解析+一张血缘关系表+一个简单的可视化页面就够了。
最小可用方案
第一步: 写一个Python脚本,扫描所有ETL的SQL文件,用正则或sqlparse提取血缘关系,写入meta_lineage表。每天调度跑一次。
第二步: 写一个简单的查询页面(甚至Excel也行),输入表名,查出上游和下游。
第三步: 在做影响分析和问题溯源时使用。
总投入:2-3天开发。价值:每次影响分析从"问一圈同事"变成"查一条SQL",效率提升巨大。
进阶方案
如果团队有余力,可以考虑:
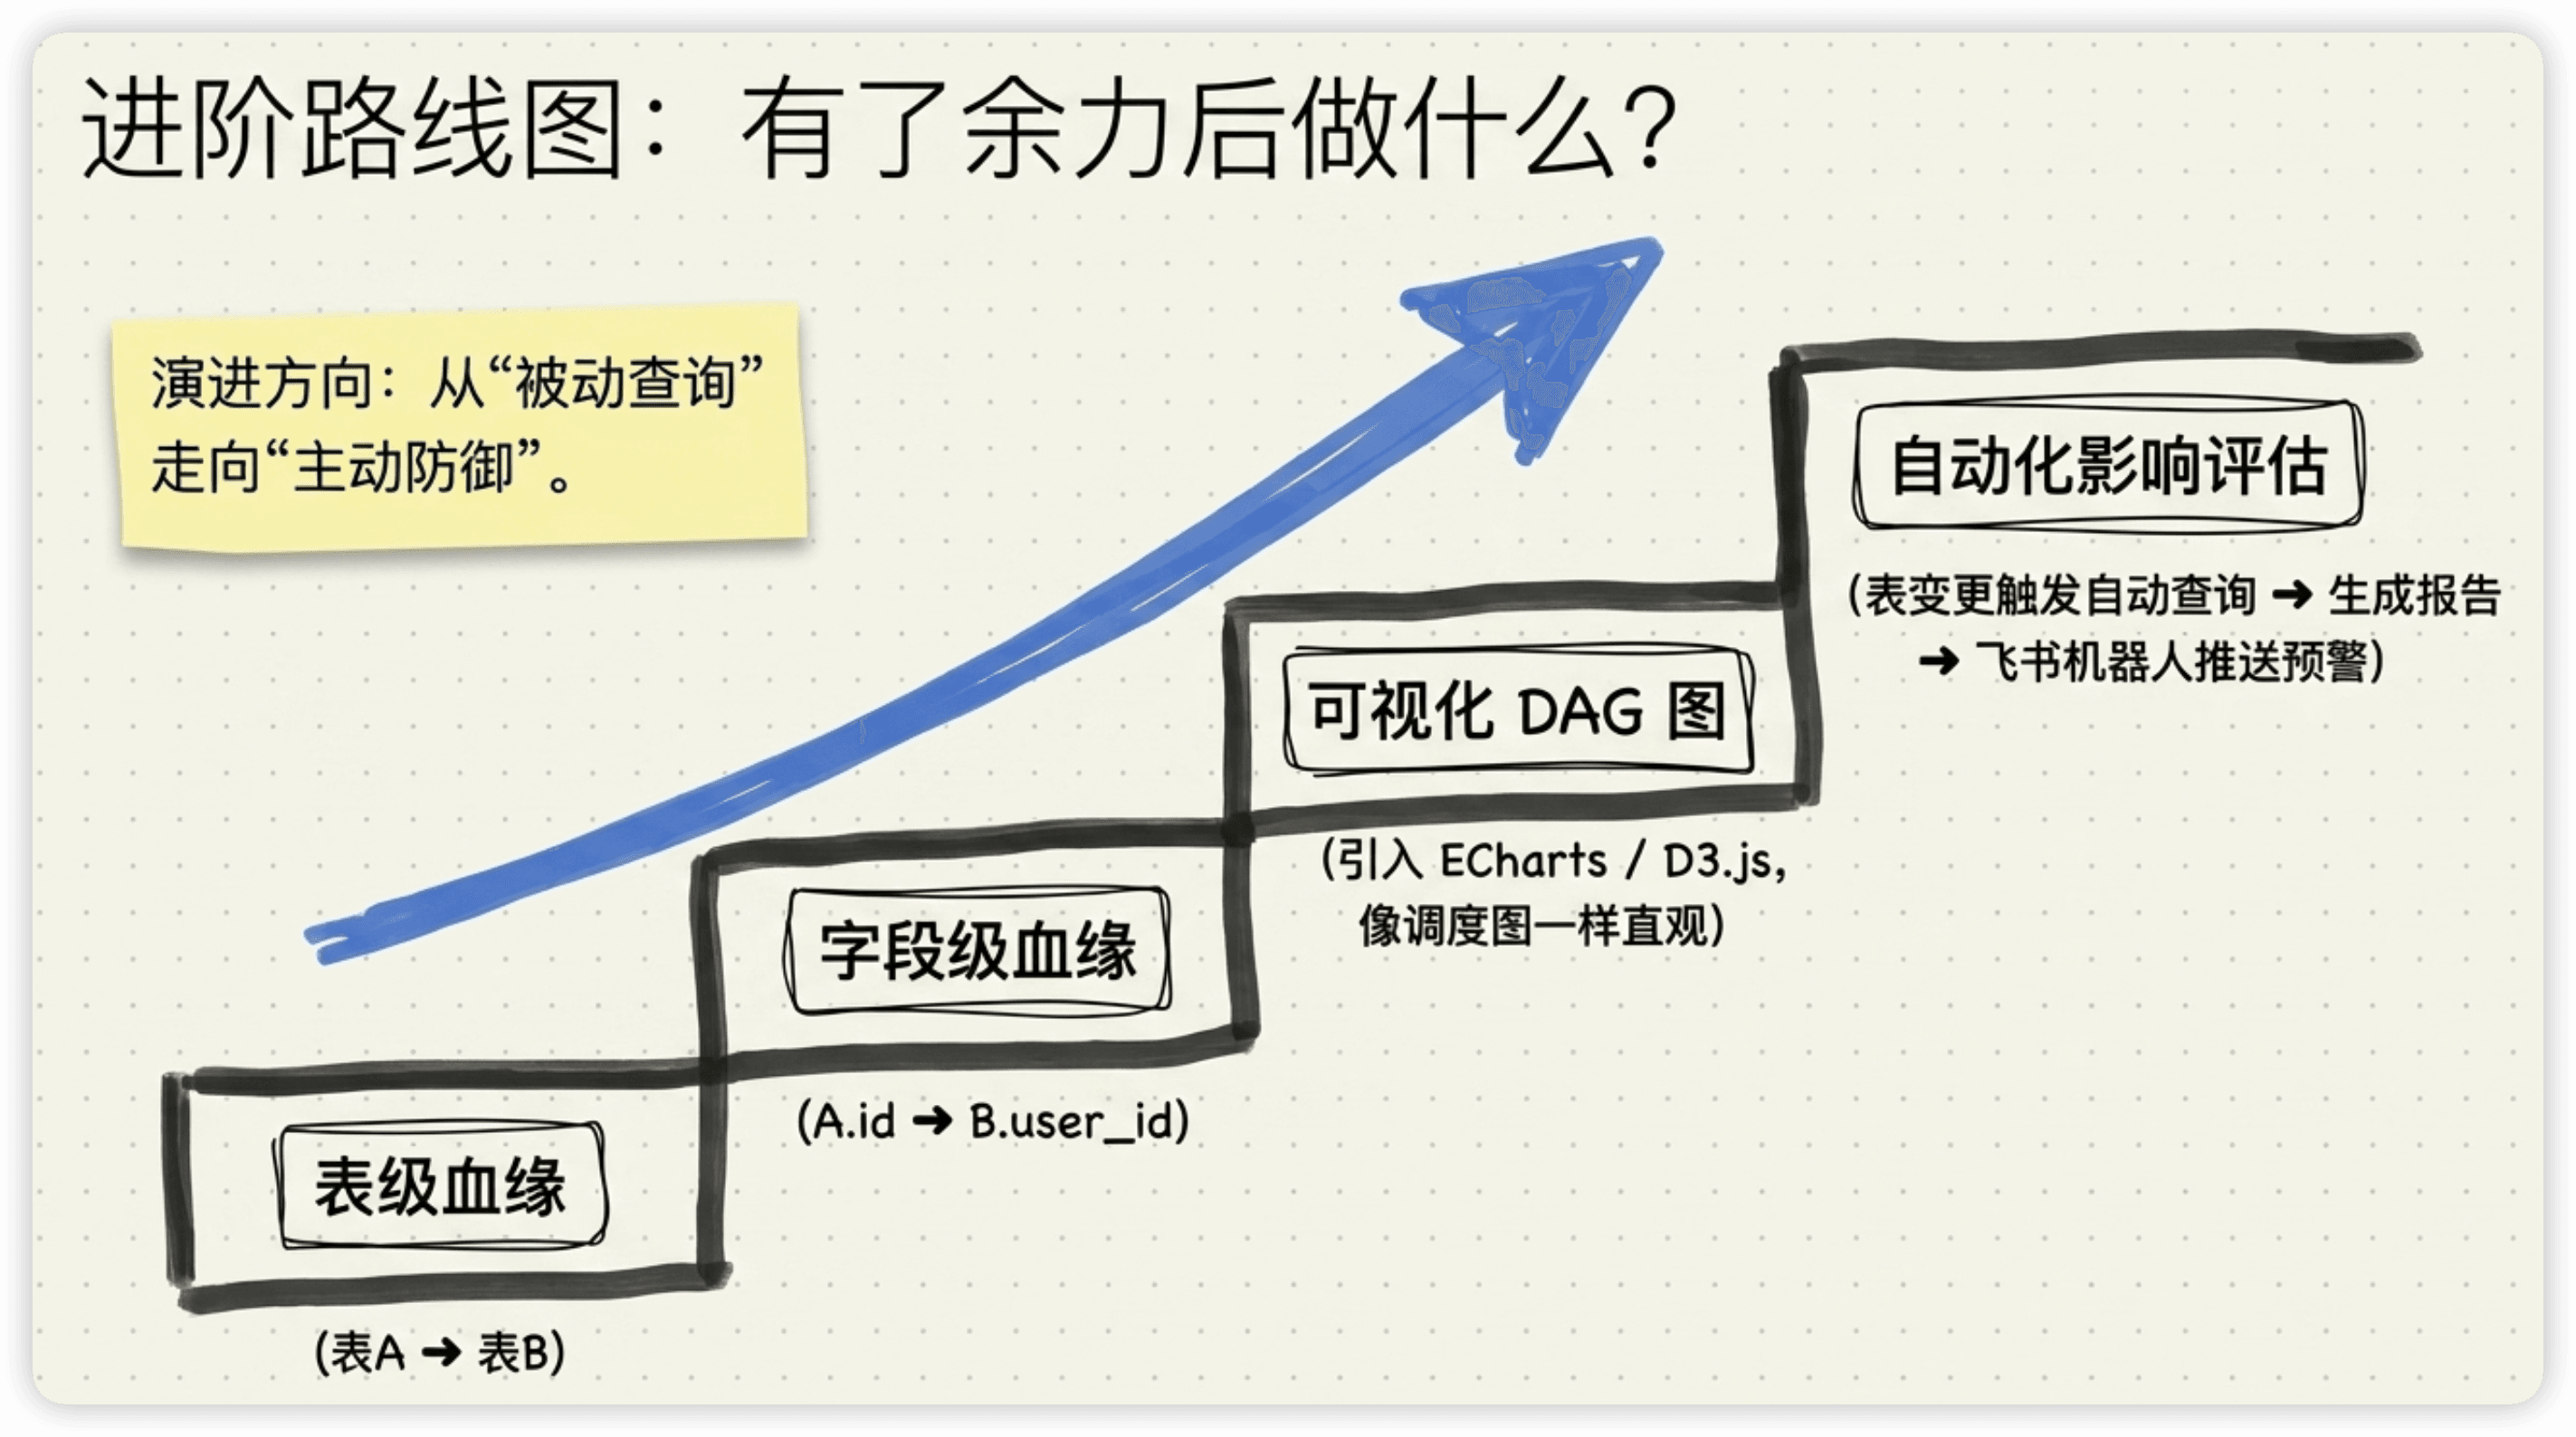
- 字段级血缘:不仅知道表A→表B,还知道A的哪个字段映射到了B的哪个字段
- 可视化DAG图:用D3.js或ECharts画出血缘关系图,像调度DAG那样直观展示
- 自动化影响评估:表变更时自动查血缘,生成影响报告推送到飞书
面试怎么答?
高分回答
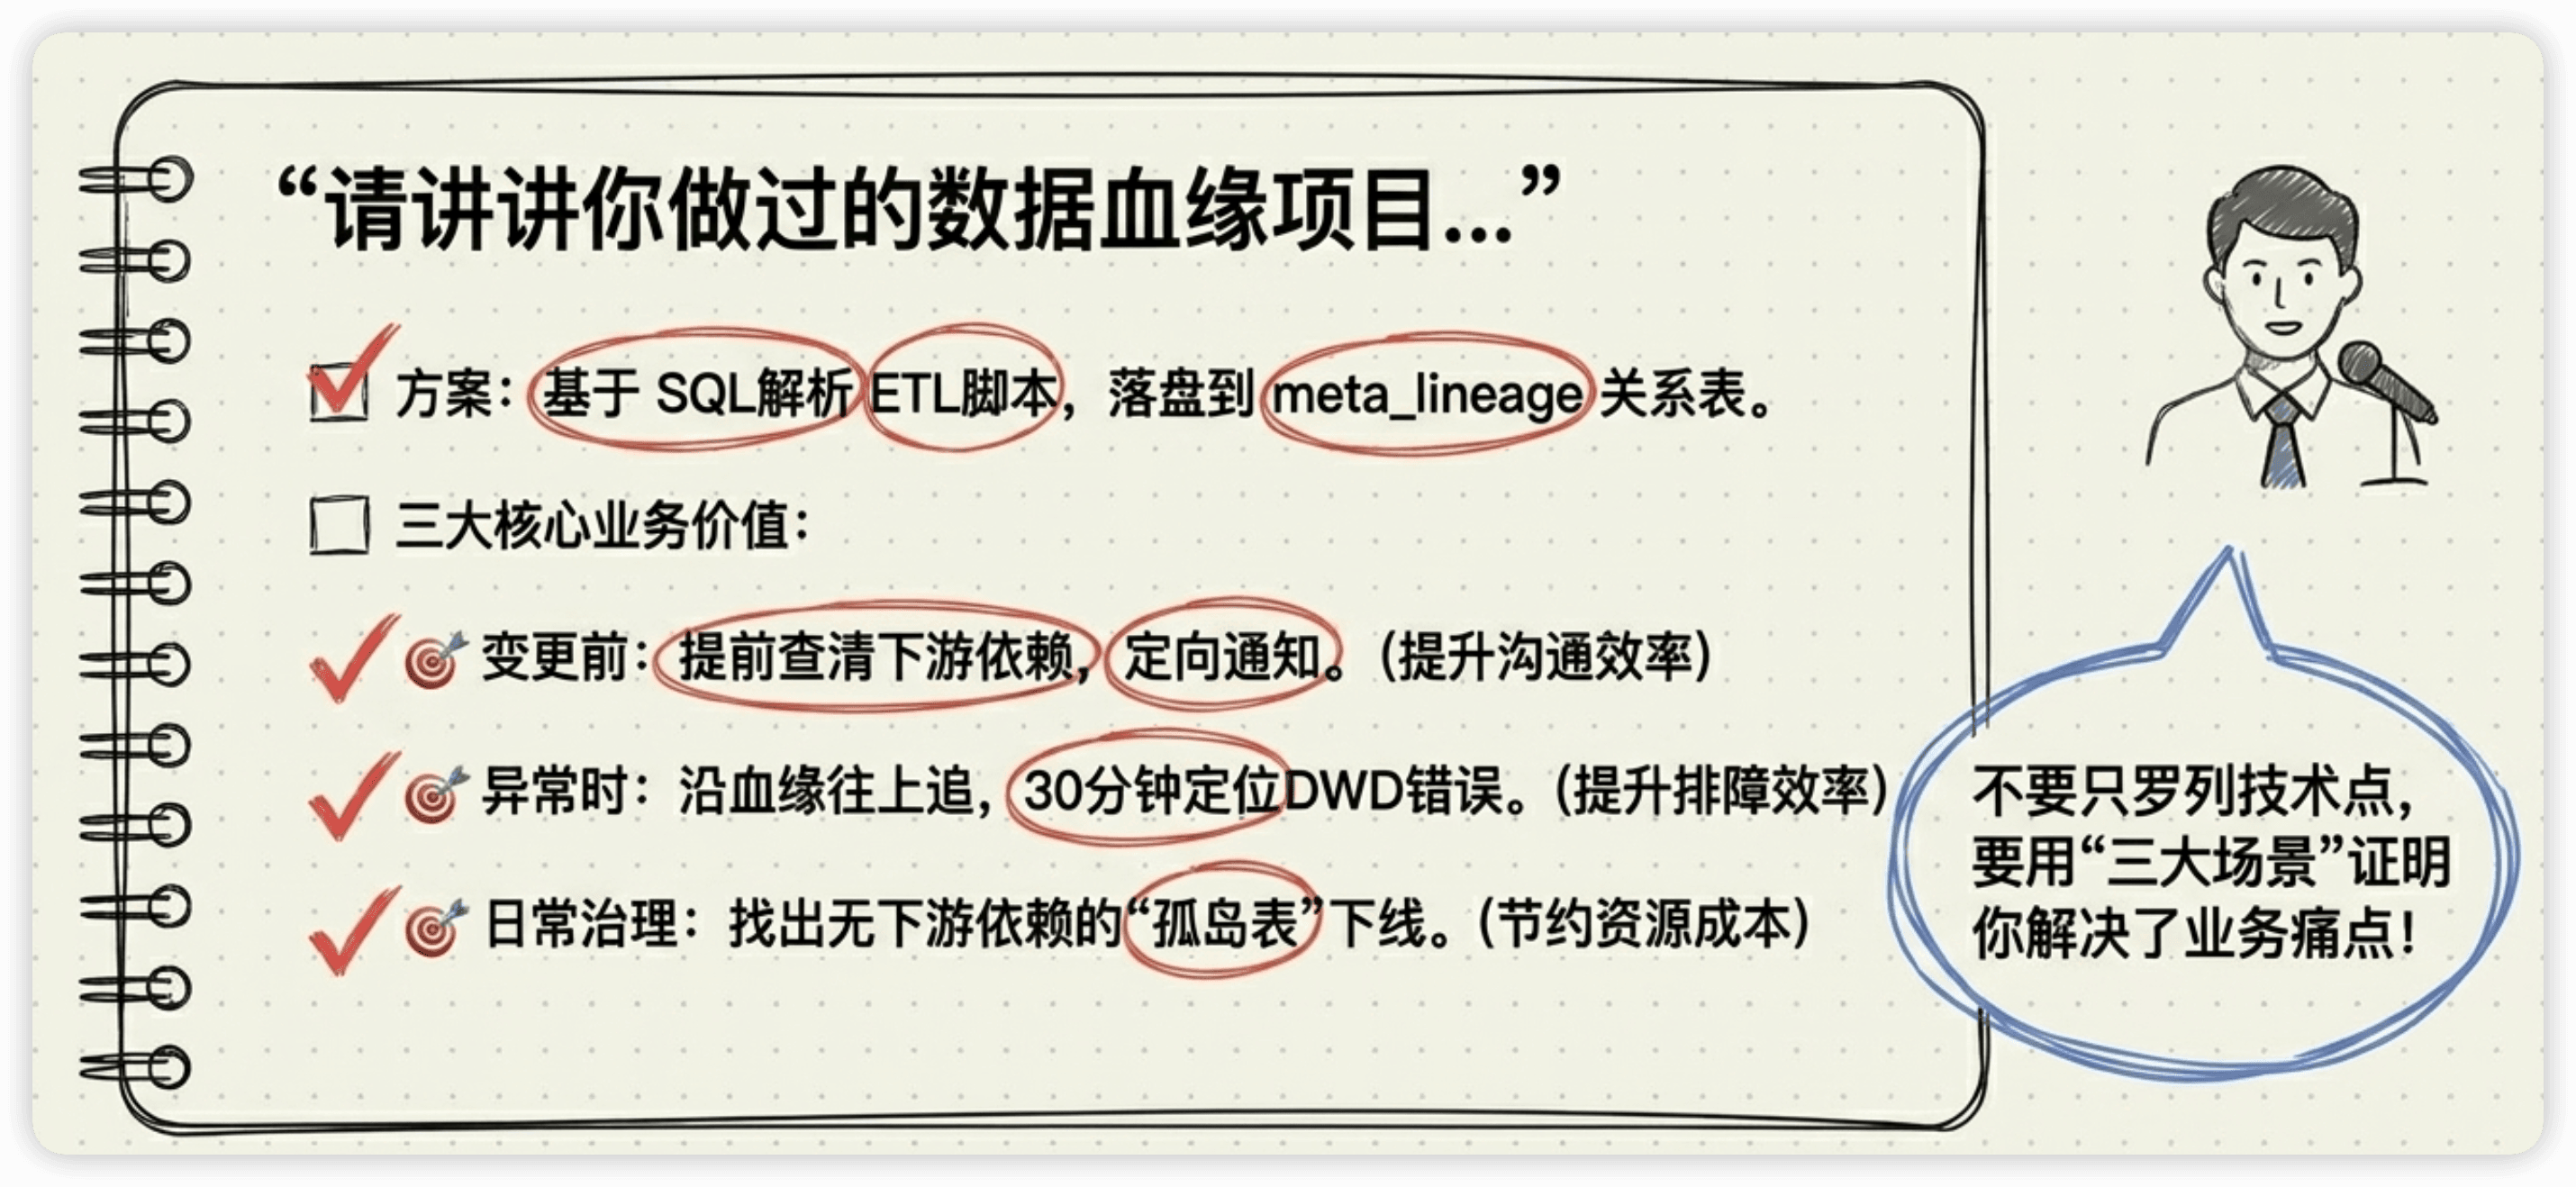
「我们建了表级血缘,主要通过SQL解析ETL脚本来采集上下游关系,存在一张meta_lineage表里。三个核心应用场景:第一,表变更前查影响分析——改dim_user之前先查下游有6张表和2个报表受影响,提前通知相关人;第二,数据异常时沿着血缘快速溯源——GMV翻倍了从报表层沿血缘往上追,30分钟定位到DWD层JOIN有Bug;第三,结合查询日志做表活跃度分析——无上游无下游的孤岛表基本可以下线。」
「做埋点治理时就靠血缘确认了200多个事件没有下游依赖才敢下线。没有血缘的话只能挨个问同事,效率差10倍。」
追问防线
追问1:血缘数据怎么保证准确?
两个机制。第一,SQL解析覆盖了所有调度任务的ETL脚本,自动采集。第二,每天增量更新——ETL脚本修改后下次运行时自动更新血缘。对于手动ad-hoc查询(比如分析师直接在SQL工具里查表),可以从Hive审计日志里补充采集。
不过完全准确很难,血缘的准确率做到90%以上就已经够用了。偶尔有漏采的,人工发现时手动补一下。
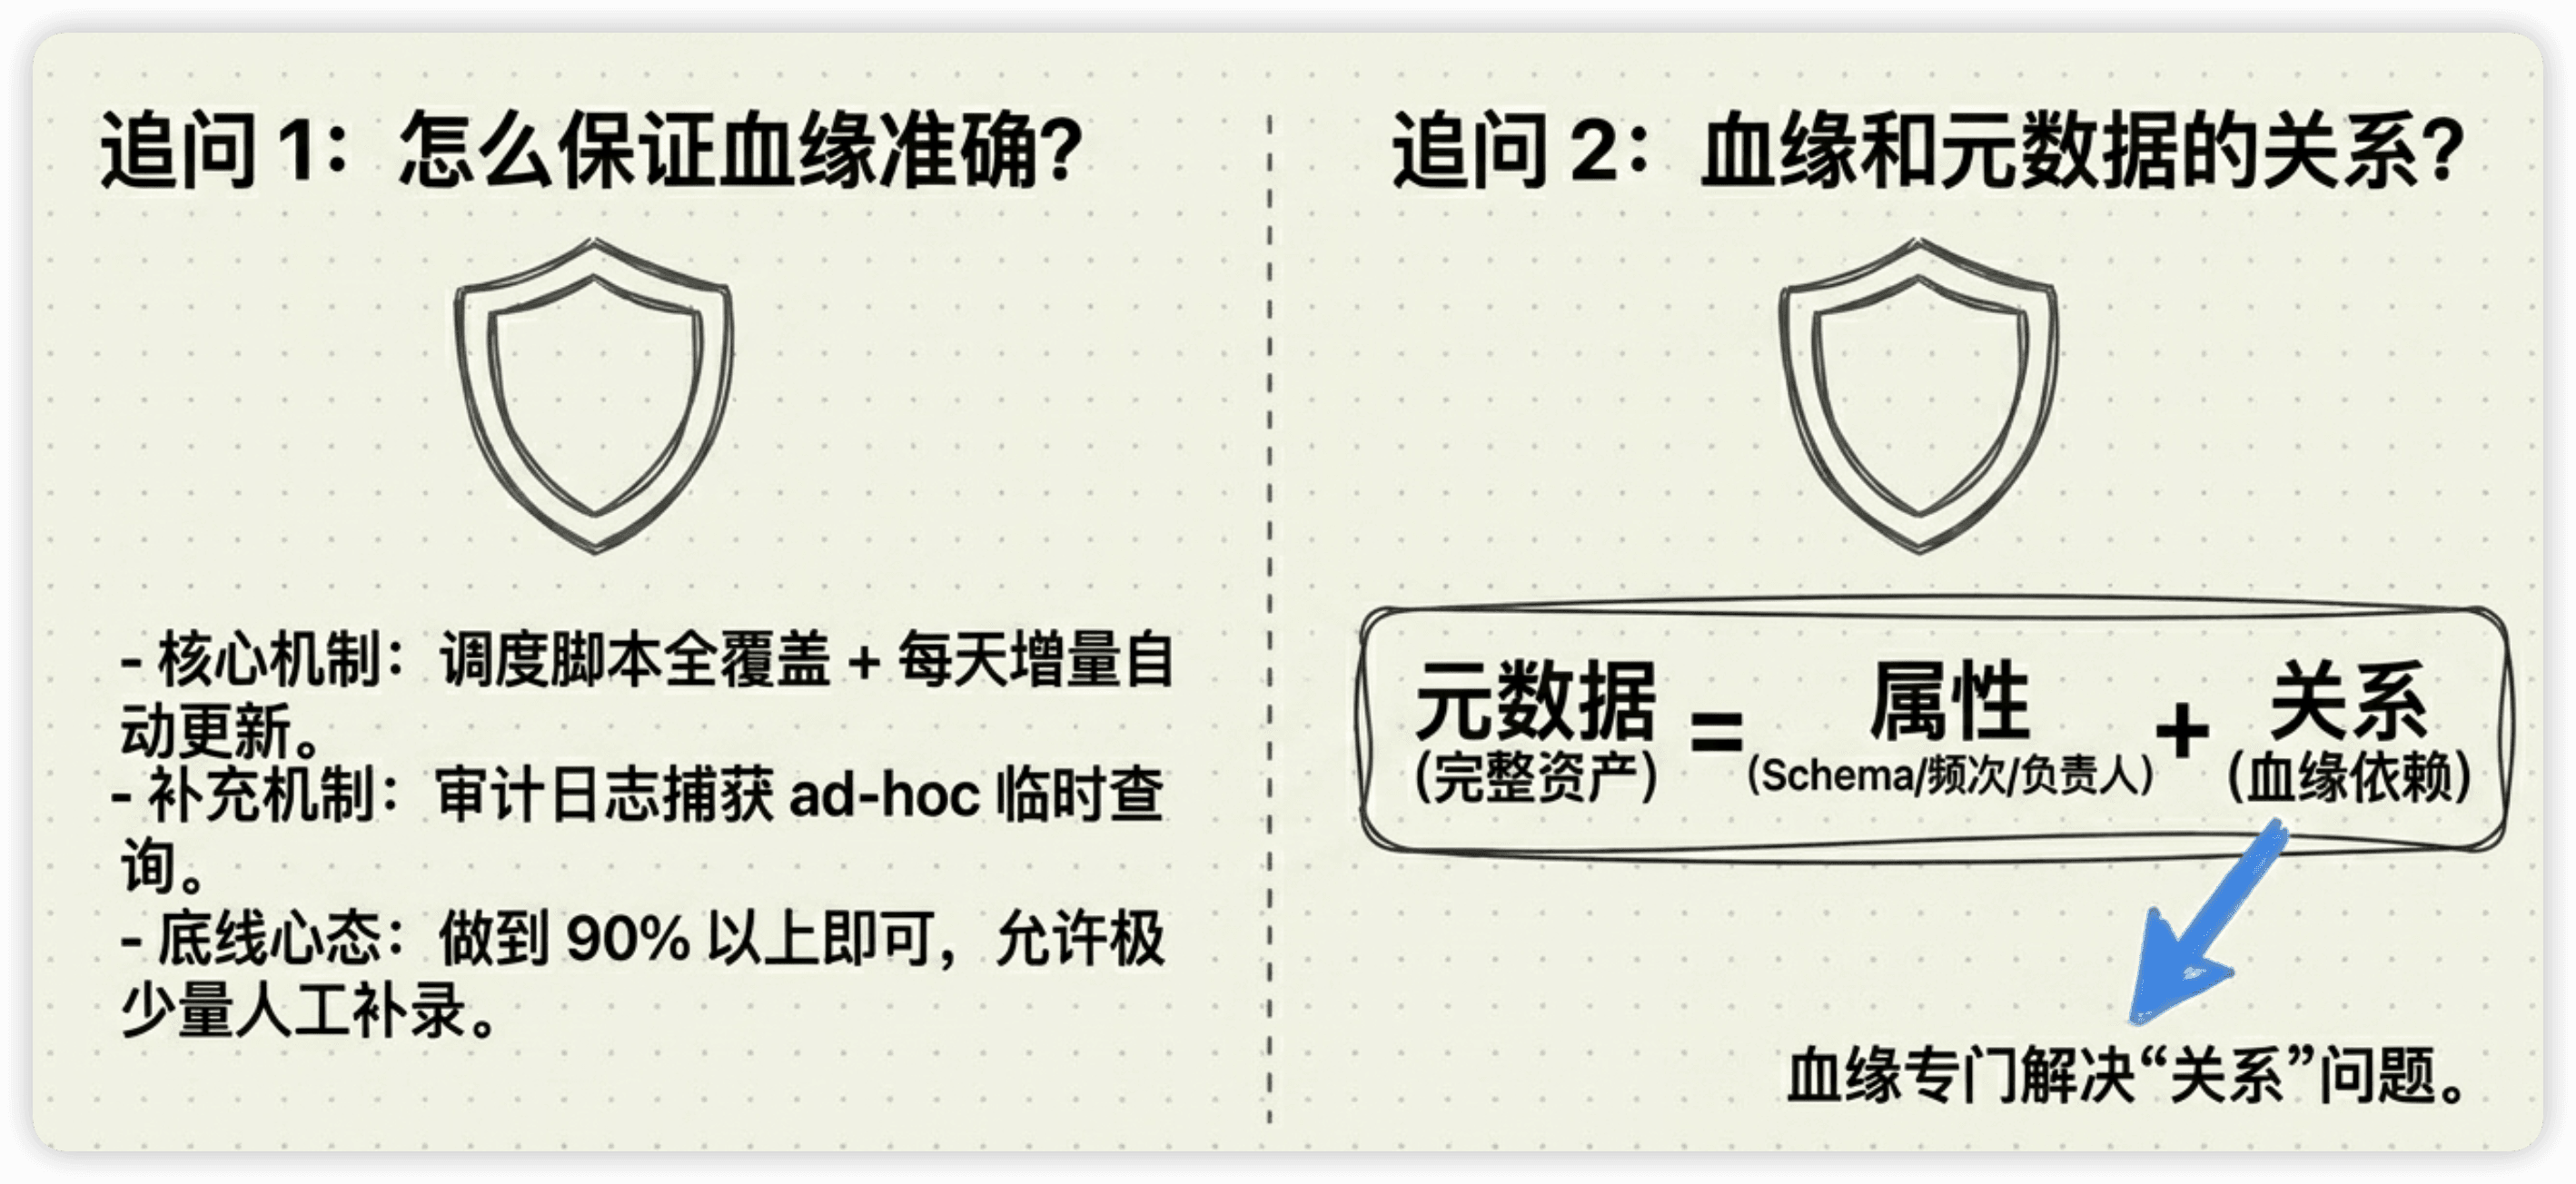
追问2:血缘和元数据管理是什么关系?
血缘是元数据管理的一部分。完整的元数据包括:表的Schema信息(字段名、类型、注释)、表的血缘关系(上下游依赖)、表的统计信息(行数、存储大小、查询频率)、表的负责人和SLA。
血缘解决的是"关系"问题,其他元数据解决的是"属性"问题。两者结合才是完整的数据资产管理。
总结
- 血缘解决三个问题:数据从哪来、谁在用、改了影响谁
- 三大应用场景:影响分析(改之前查)、问题溯源(出了问题追)、治理抓手(废弃表识别)
- 采集方式:SQL解析为主 + 调度平台补充
- 小团队方案:一个Python脚本 + 一张关系表 + 一个查询页面,2-3天搞定
- 核心价值:把影响分析从"问一圈同事"变成"查一条SQL"