数据模型评审
上线容易,下线难。这句话我在数仓开发里体会了无数遍。
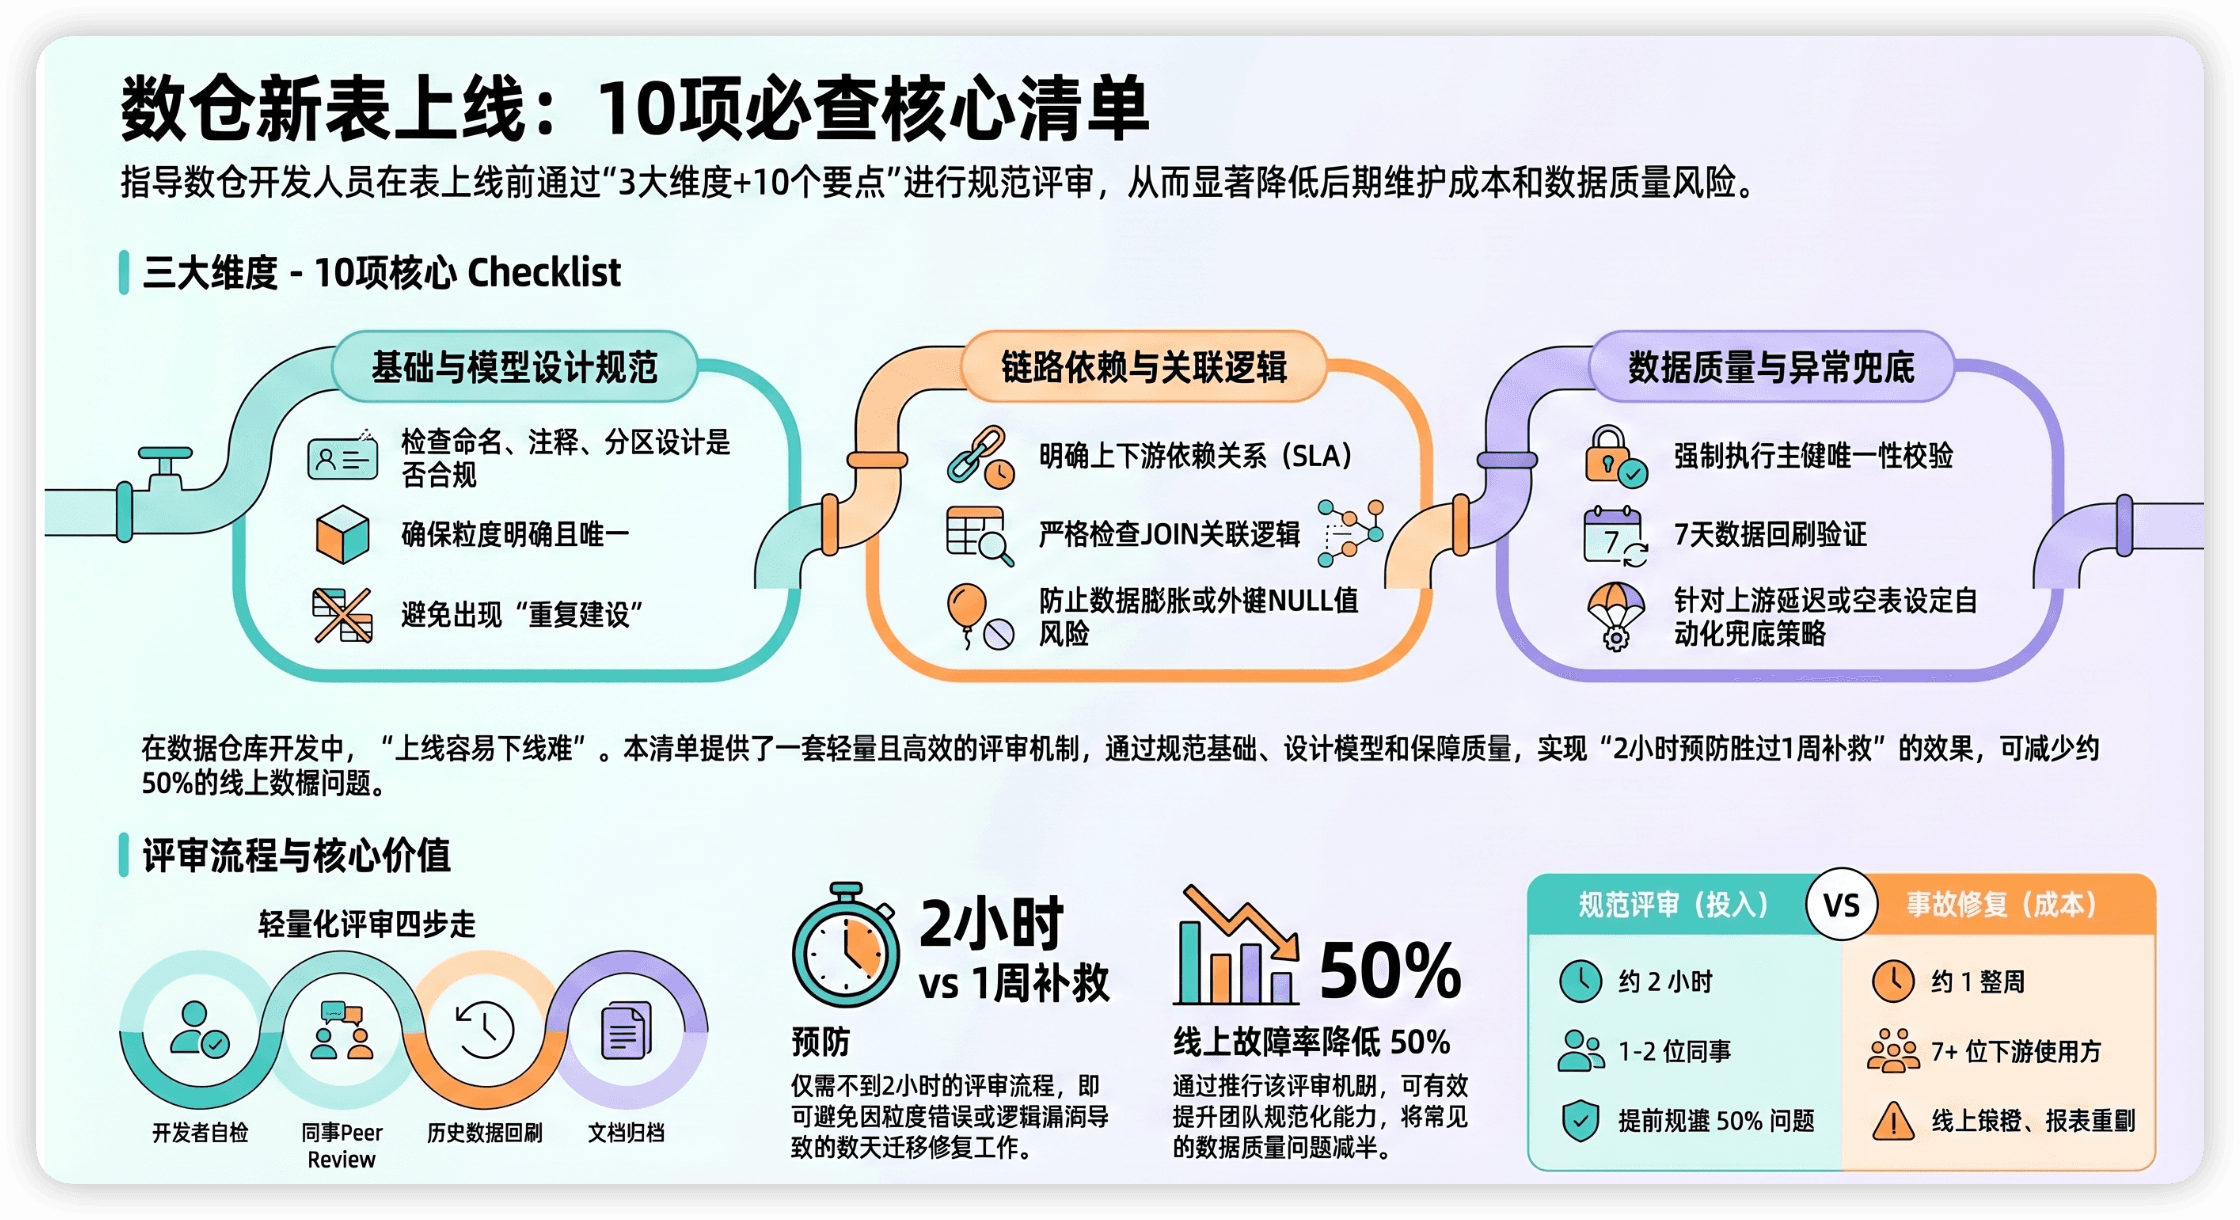
一张表上线之后,下游报表、数据接口、调度任务会在几天之内迅速挂上来。等你发现粒度定错了、命名不规范、字段冗余太多想改的时候,下游已经有5张报表和2个接口依赖它了。改一张表要协调7个人的排期,不如一开始就审好。
我之前接手一个项目时遇到过一张"祖传DWS表":粒度混了"订单"和"订单明细",金额字段聚合出来一直是错的。等发现的时候下游已经有十几张报表在用,花了整整一周才完成数据迁移。从那以后,我在团队里推了模型评审机制。
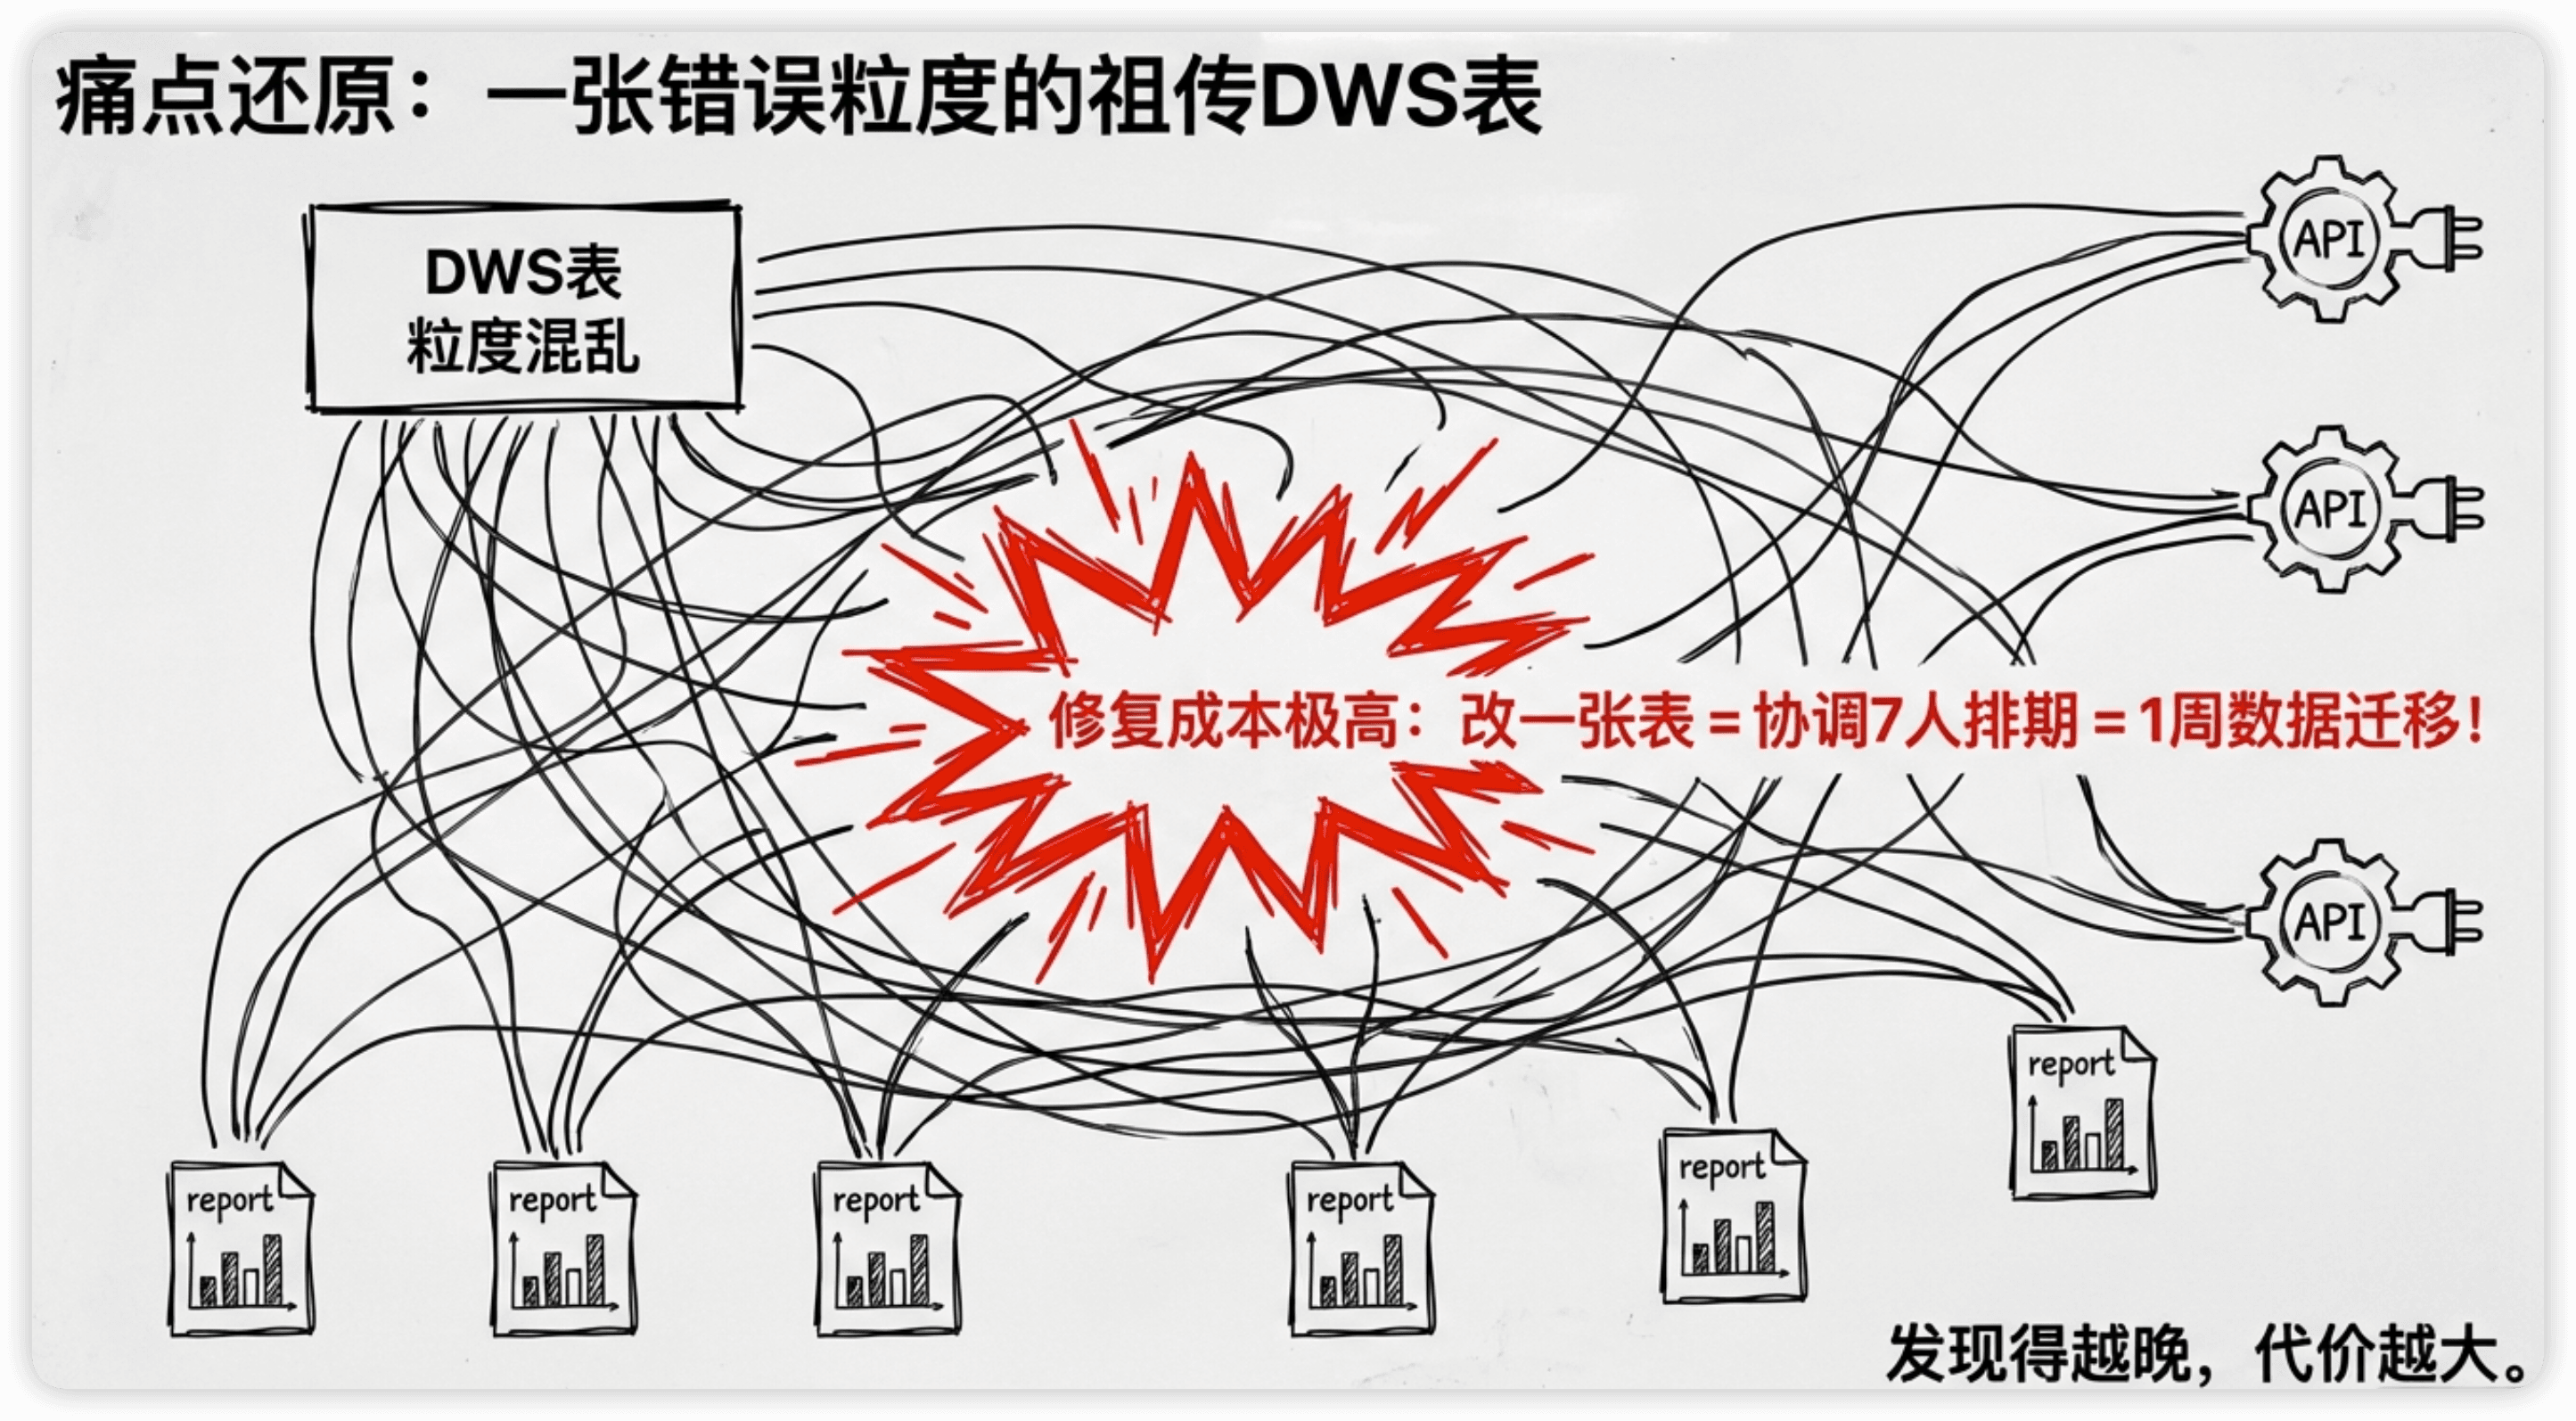
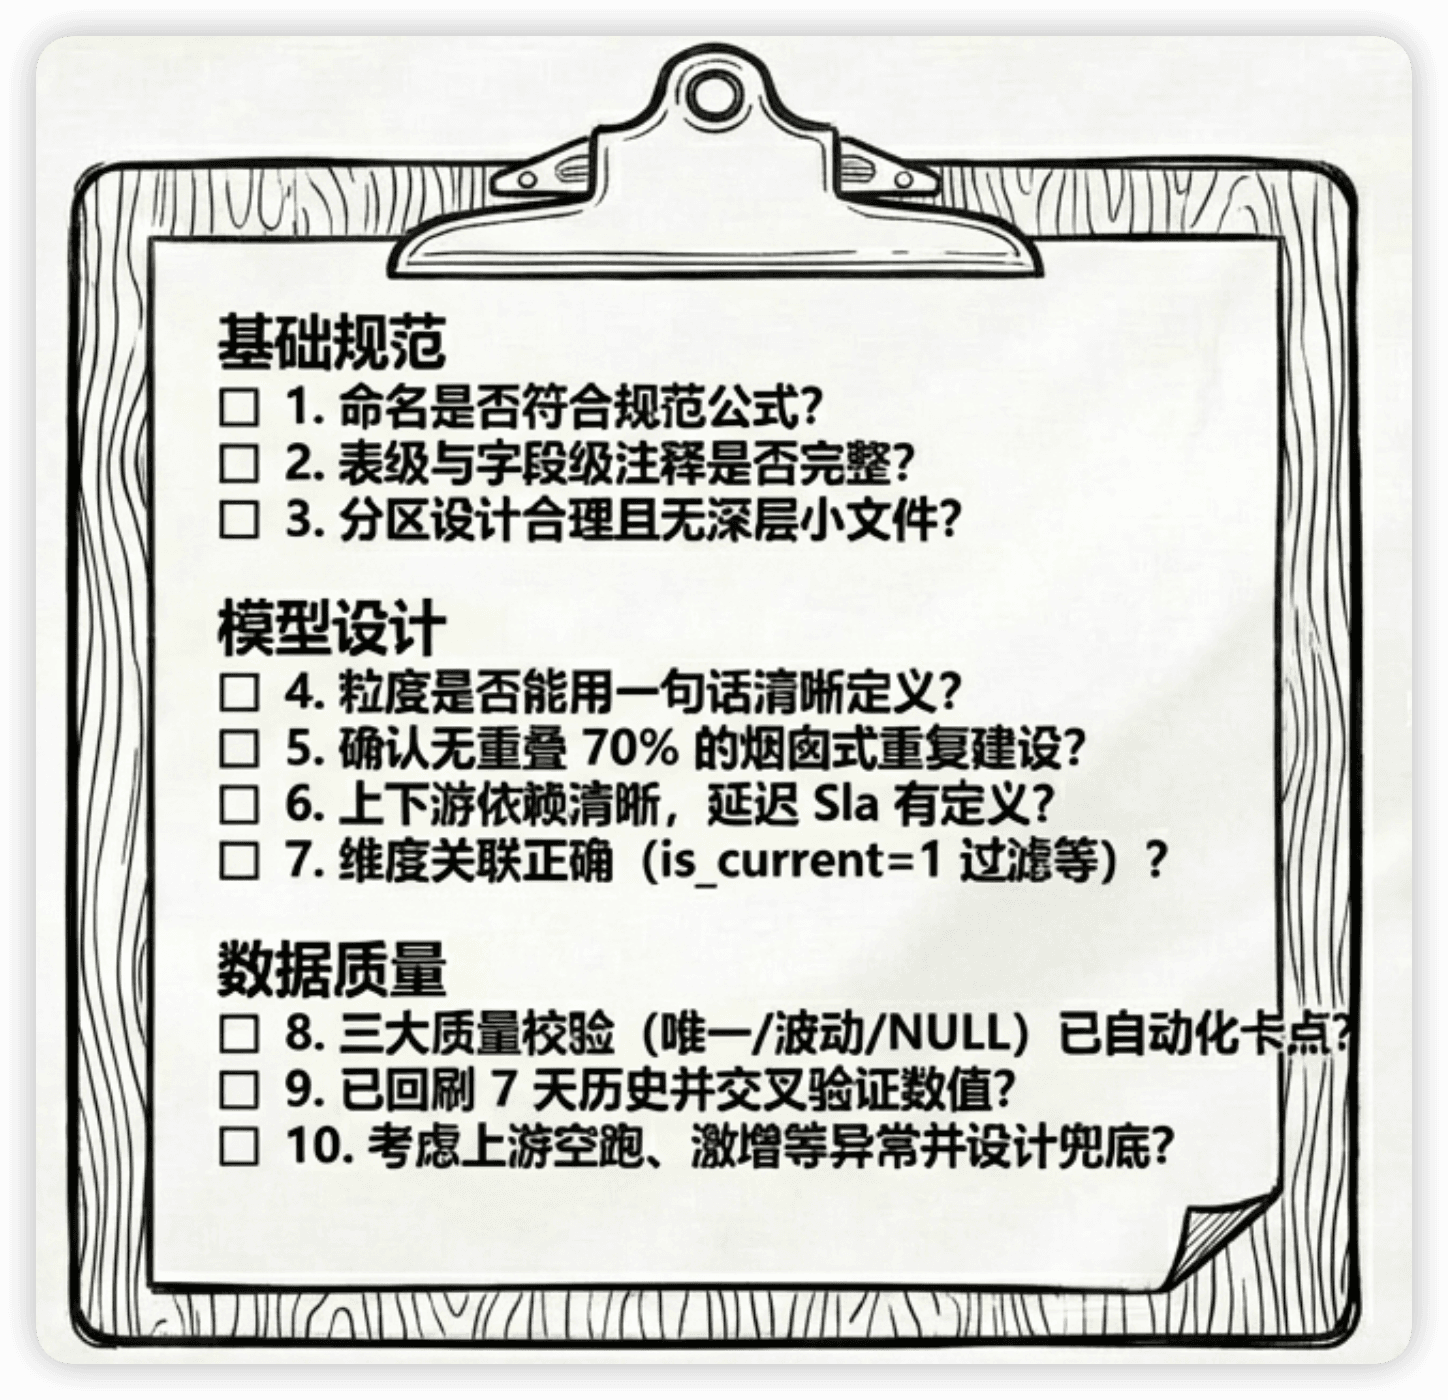
这篇文章把我实际在用的评审Checklist完整分享出来,10个必查项,按"基础规范、模型设计、数据质量"三个维度组织,每个都有具体的检查方法。
一、基础规范(3项)
① 命名是否符合规范?
这是最基本的检查,也是最容易不达标的。对照DAY 8的命名公式:
{层级}_{业务域}_{主题}_{描述}_{时间粒度}

✅ dws_trade_user_pay_1d        → 一看就知道是什么
❌ user_pay_summary_new_v2      → 哪一层的?什么粒度?
❌ tmp_wood_test_20250115       → 临时表上了生产?
不符合规范的打回去改。如果团队有建表校验机制(DAY 8讲过),这一步其实是自动化的。
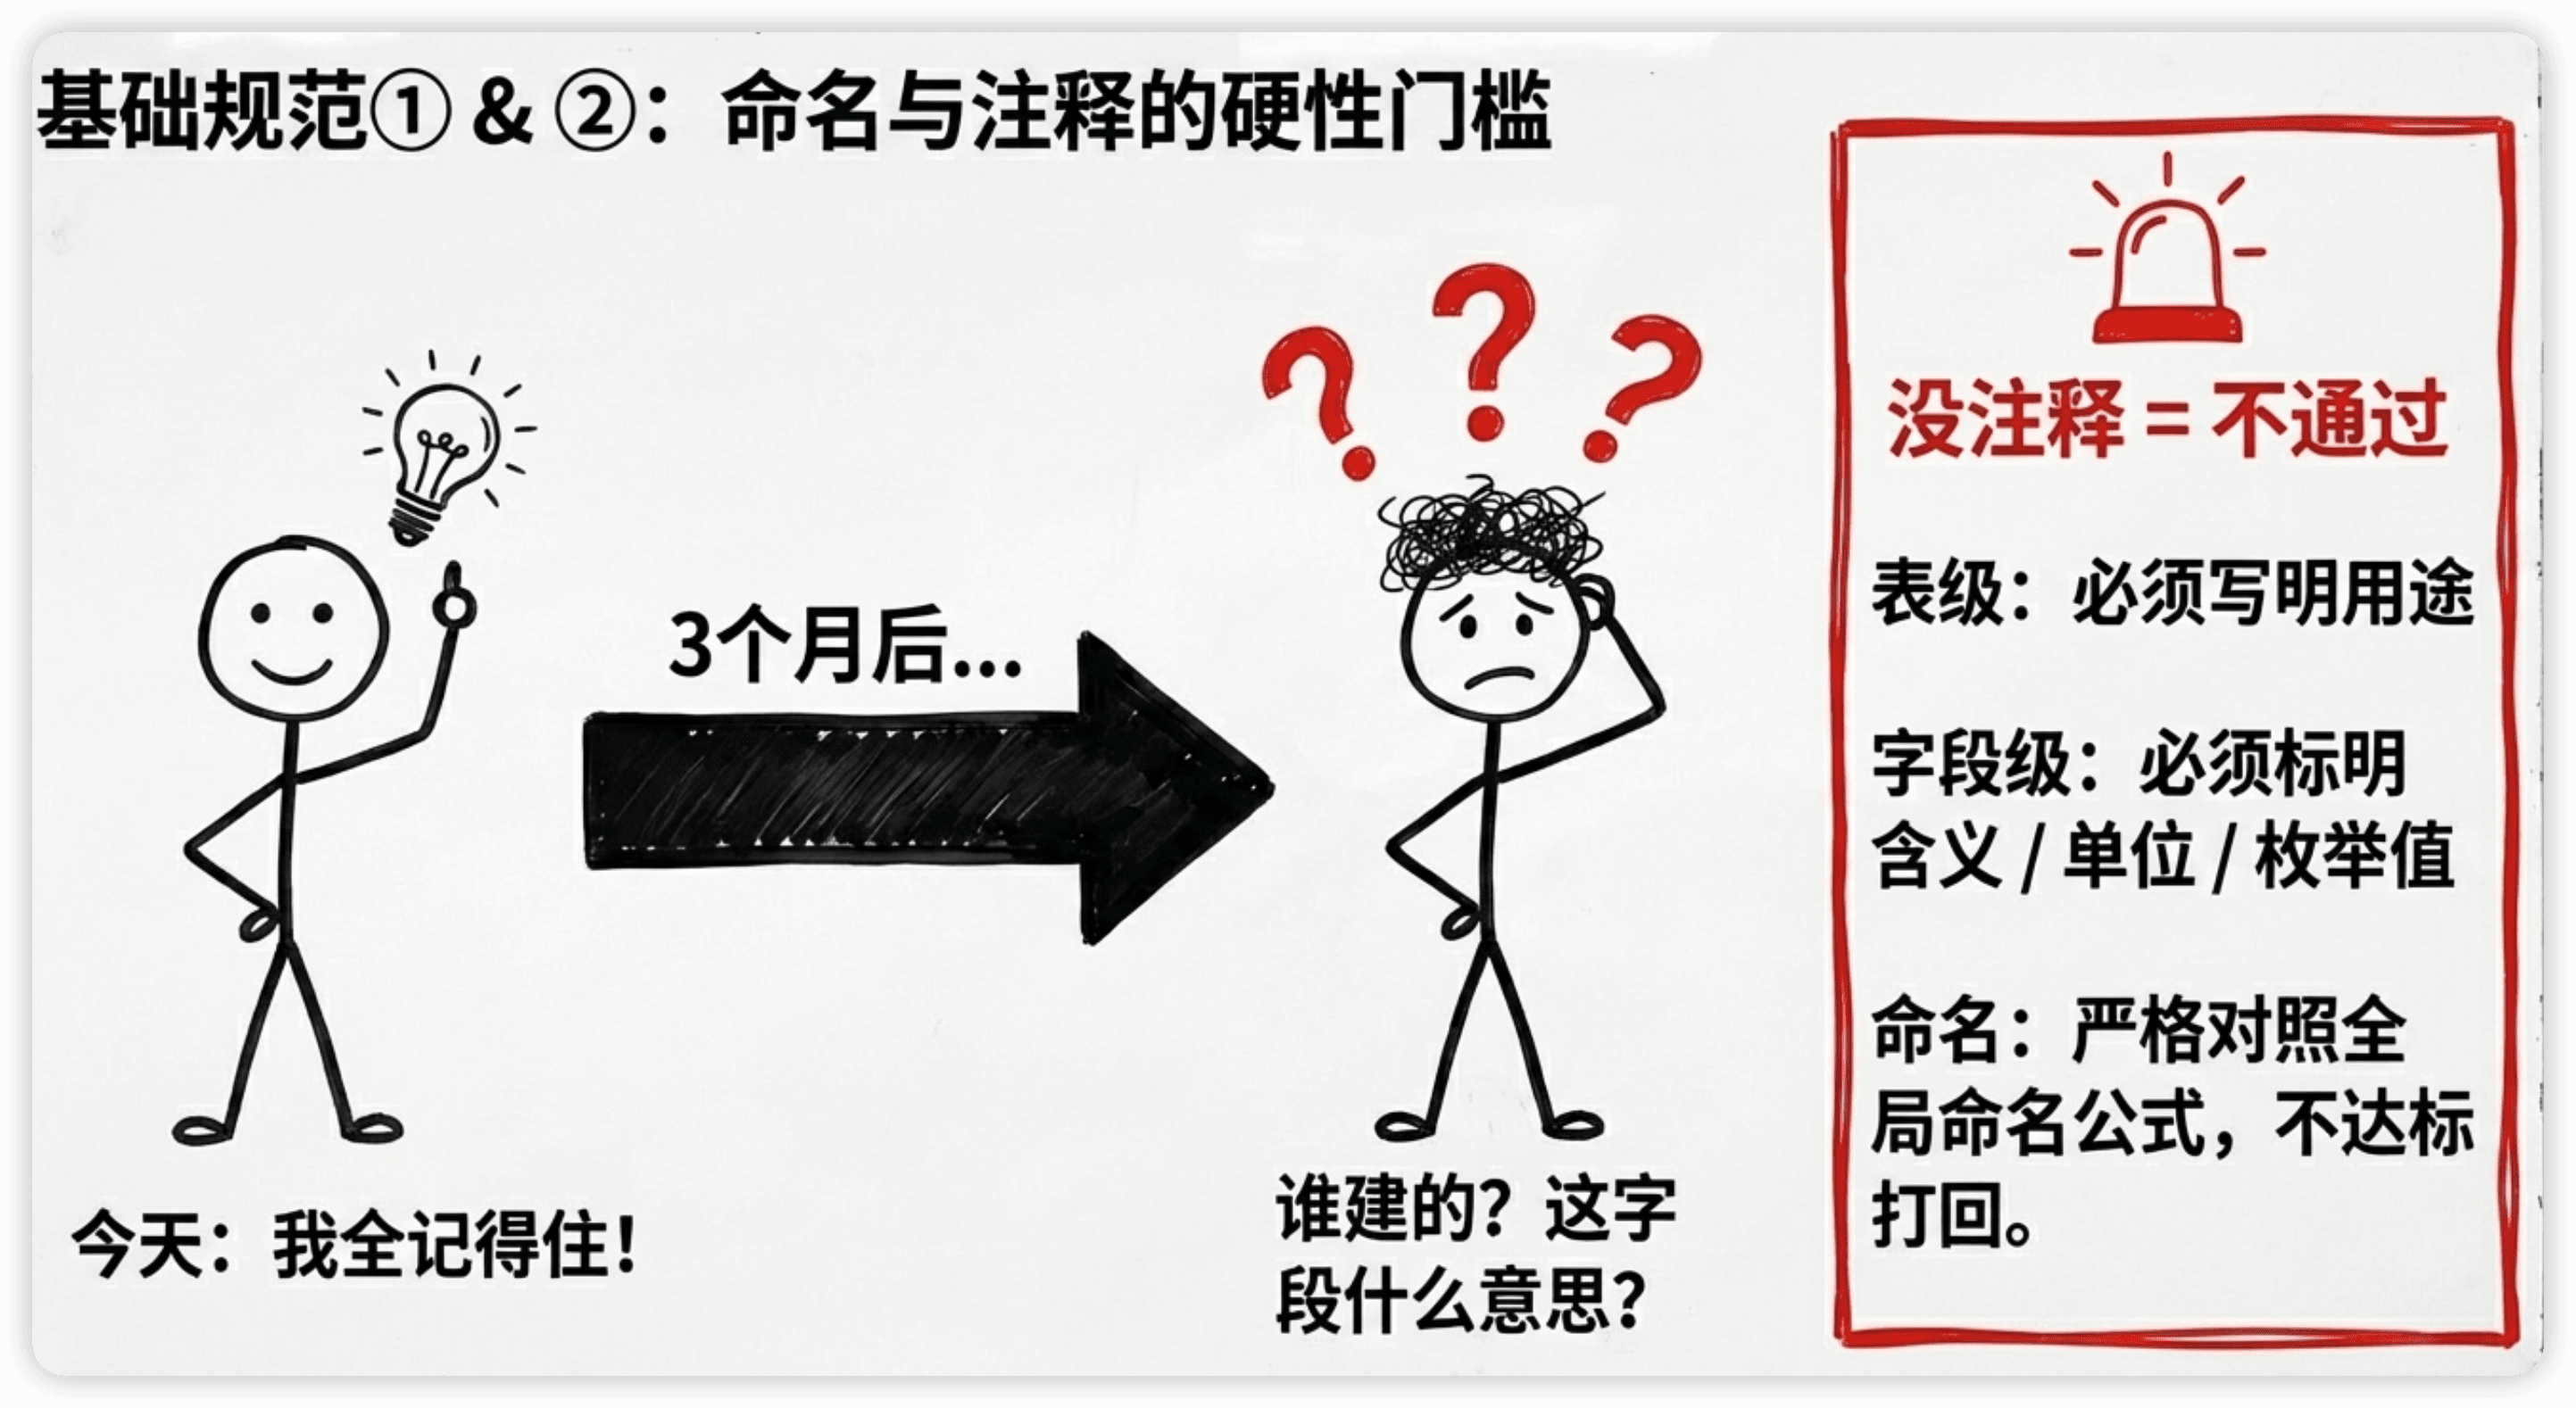
② 表注释和字段注释是否完整?
这一项的执行标准很简单:没注释 = 不通过。
每张表必须有表级COMMENT说明用途,每个字段必须有COMMENT说明含义、单位、枚举值。
-- ✅ 好的注释
CREATE TABLE dws_trade_user_pay_1d (
    user_id     BIGINT   COMMENT '用户ID',
    pay_amount  DECIMAL  COMMENT '当日支付总金额,单位:元,不含退款',
    pay_cnt     INT      COMMENT '当日支付次数',
    first_pay_time TIMESTAMP COMMENT '当日首次支付时间',
    order_status INT     COMMENT '订单状态:0=待支付,1=已支付,2=已取消,3=已退款',
    dt          STRING   COMMENT '数据日期,格式yyyy-MM-dd'
) COMMENT 'DWS层-交易域-用户维度-支付汇总-天级,粒度:一个用户×一天';

-- ❌ 差的注释
CREATE TABLE dws_trade_user_pay_1d (
    user_id     BIGINT,
    pay_amount  DECIMAL,        -- 什么金额?含退款吗?单位是什么?
    pay_cnt     INT,            -- 支付次数还是下单次数?
    status      INT,            -- 什么的状态?0/1/2分别是什么?
    dt          STRING
);
注释写得好不好直接影响三个月后的可维护性。别觉得"我记得住"——三个月后你自己都不记得了,更别说接手的新人。
③ 分区设计是否合理?
分区决定了查询性能和数据管理的便利性。检查要点:
- 日增量/日全量表必须有dt分区,没有例外
- 数据量大且有明确业务过滤维度的,考虑加二级分区(region、biz_type)
- 分区不要过深——超过3级分区要有充分理由(小文件问题会加剧)
- 分区字段的格式要和全局规范一致(dt统一用
yyyy-MM-dd格式)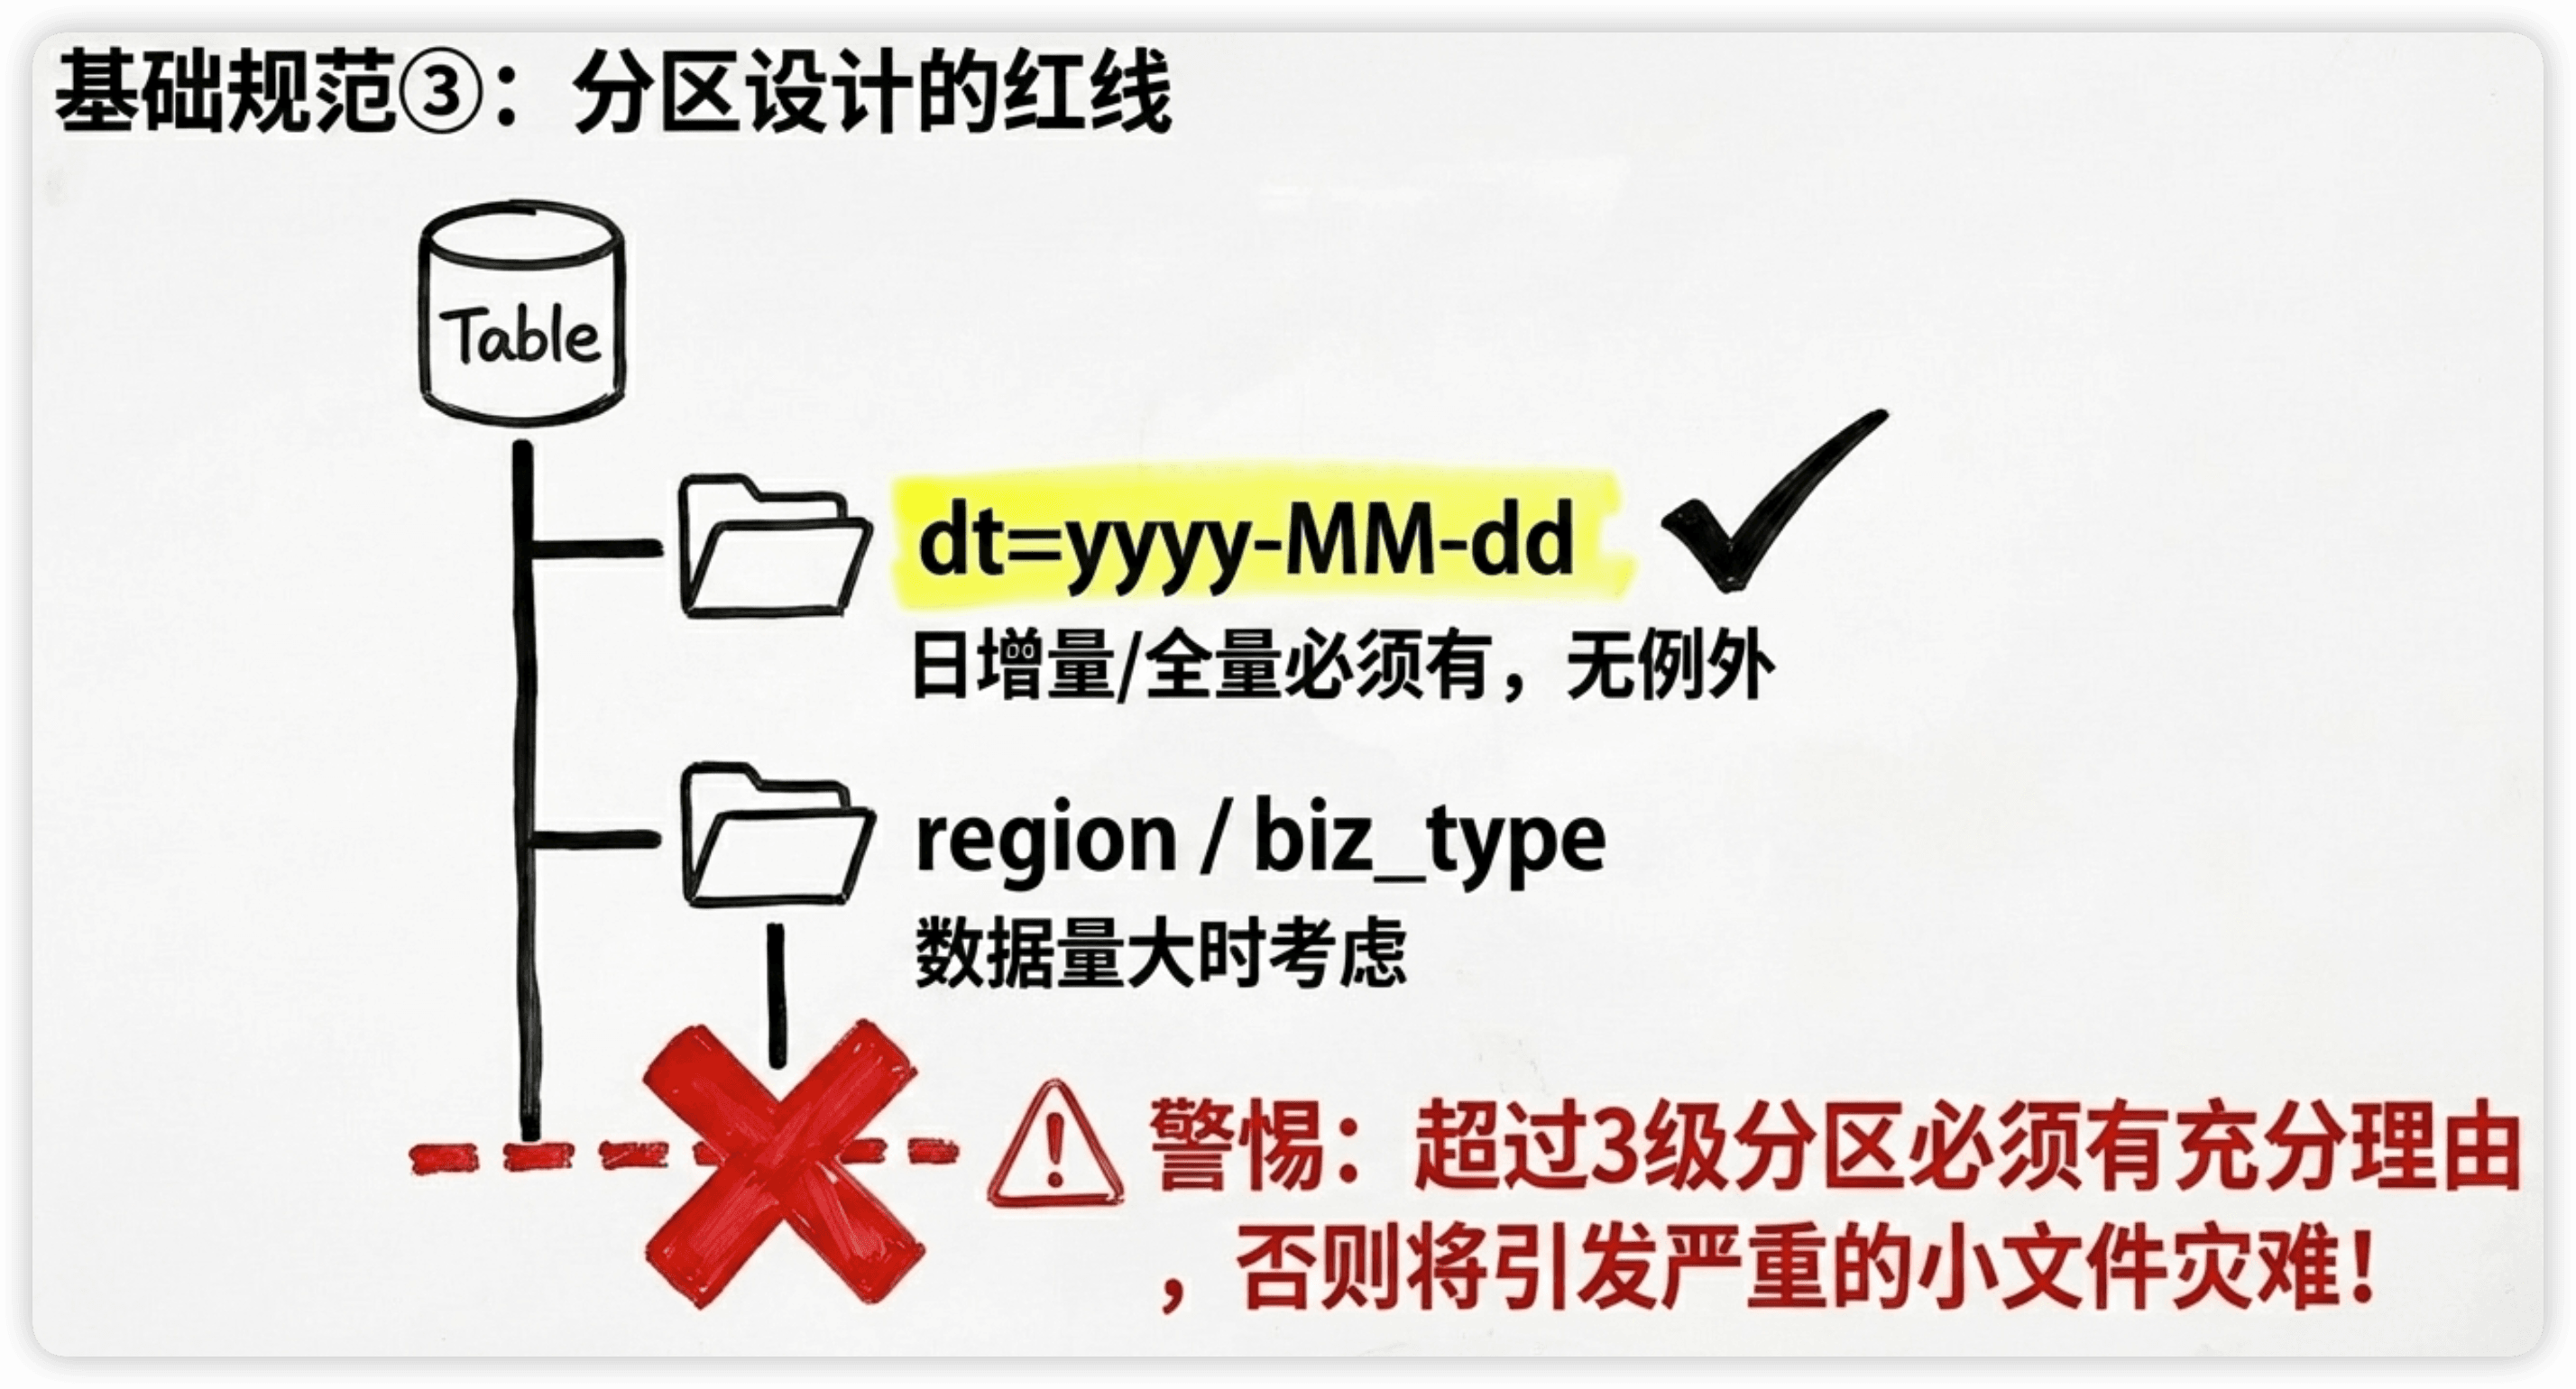
-- 检查分区是否合理的常见问题
-- ❌ 没分区的大表(每次全表扫描)
CREATE TABLE fact_event_log (...);  -- 每天5000万行,没分区

-- ❌ 过度分区(三级分区,大量小文件)
PARTITIONED BY (dt STRING, hour STRING, minute STRING);

-- ✅ 合理分区
PARTITIONED BY (dt STRING);                    -- 大多数场景足够
PARTITIONED BY (dt STRING, region STRING);     -- 出海业务按地区分区
二、模型设计(4项)
④ 粒度是否明确且唯一?
这是评审中最重要的一项。一张表的粒度必须能一句话说清楚。
✅ "一行 = 一个用户 × 一天的支付汇总"
✅ "一行 = 一笔订单 × 一件商品的明细"
❌ "嗯...大概是订单相关的汇总数据"
❌ "一行有时候代表订单,有时候代表用户..."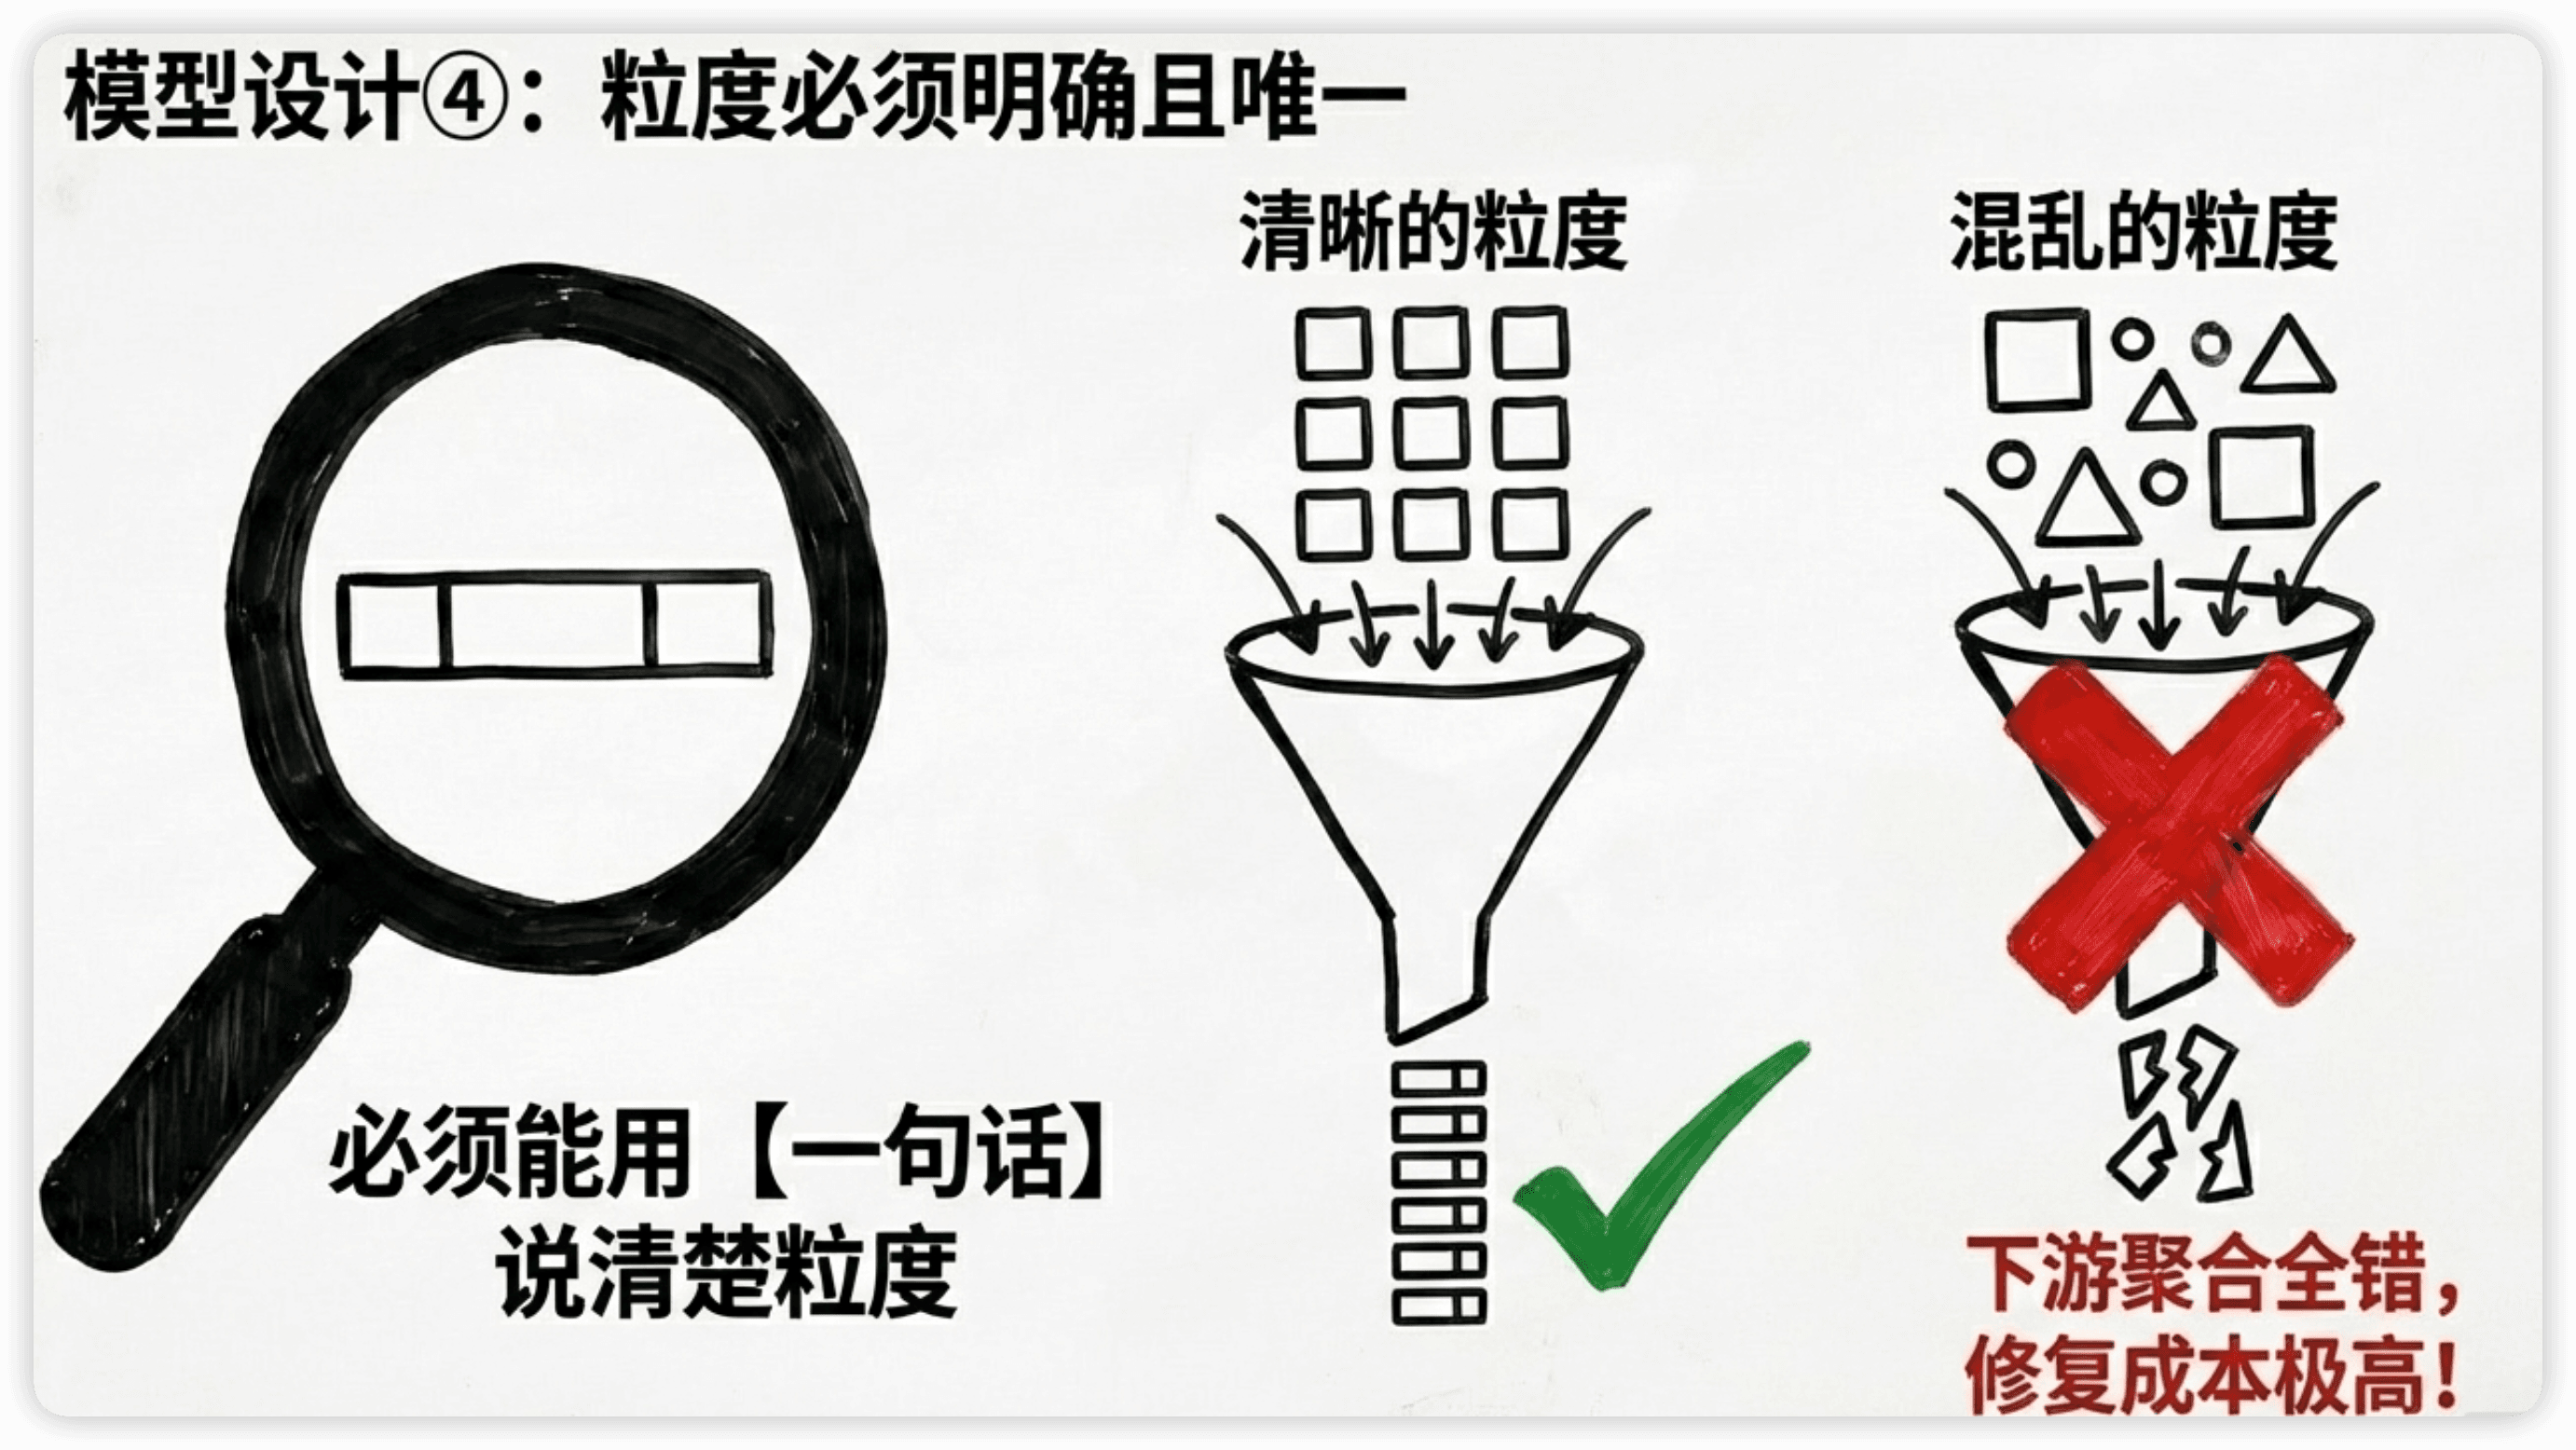
检查方法:
-- 验证粒度唯一性:表的业务主键不应该有重复
-- 如果粒度是"一个用户×一天",那 (user_id, dt) 应该唯一
SELECT user_id, dt, COUNT(*) AS cnt
FROM dws_trade_user_pay_1d
GROUP BY user_id, dt
HAVING cnt > 1;

-- 如果有结果返回,说明粒度定义和实际数据不一致
粒度混乱是数仓最严重的设计问题。一旦上线后被发现,修复成本极高,因为所有下游的聚合逻辑都可能是错的。
⑤ 是否有重复建设?
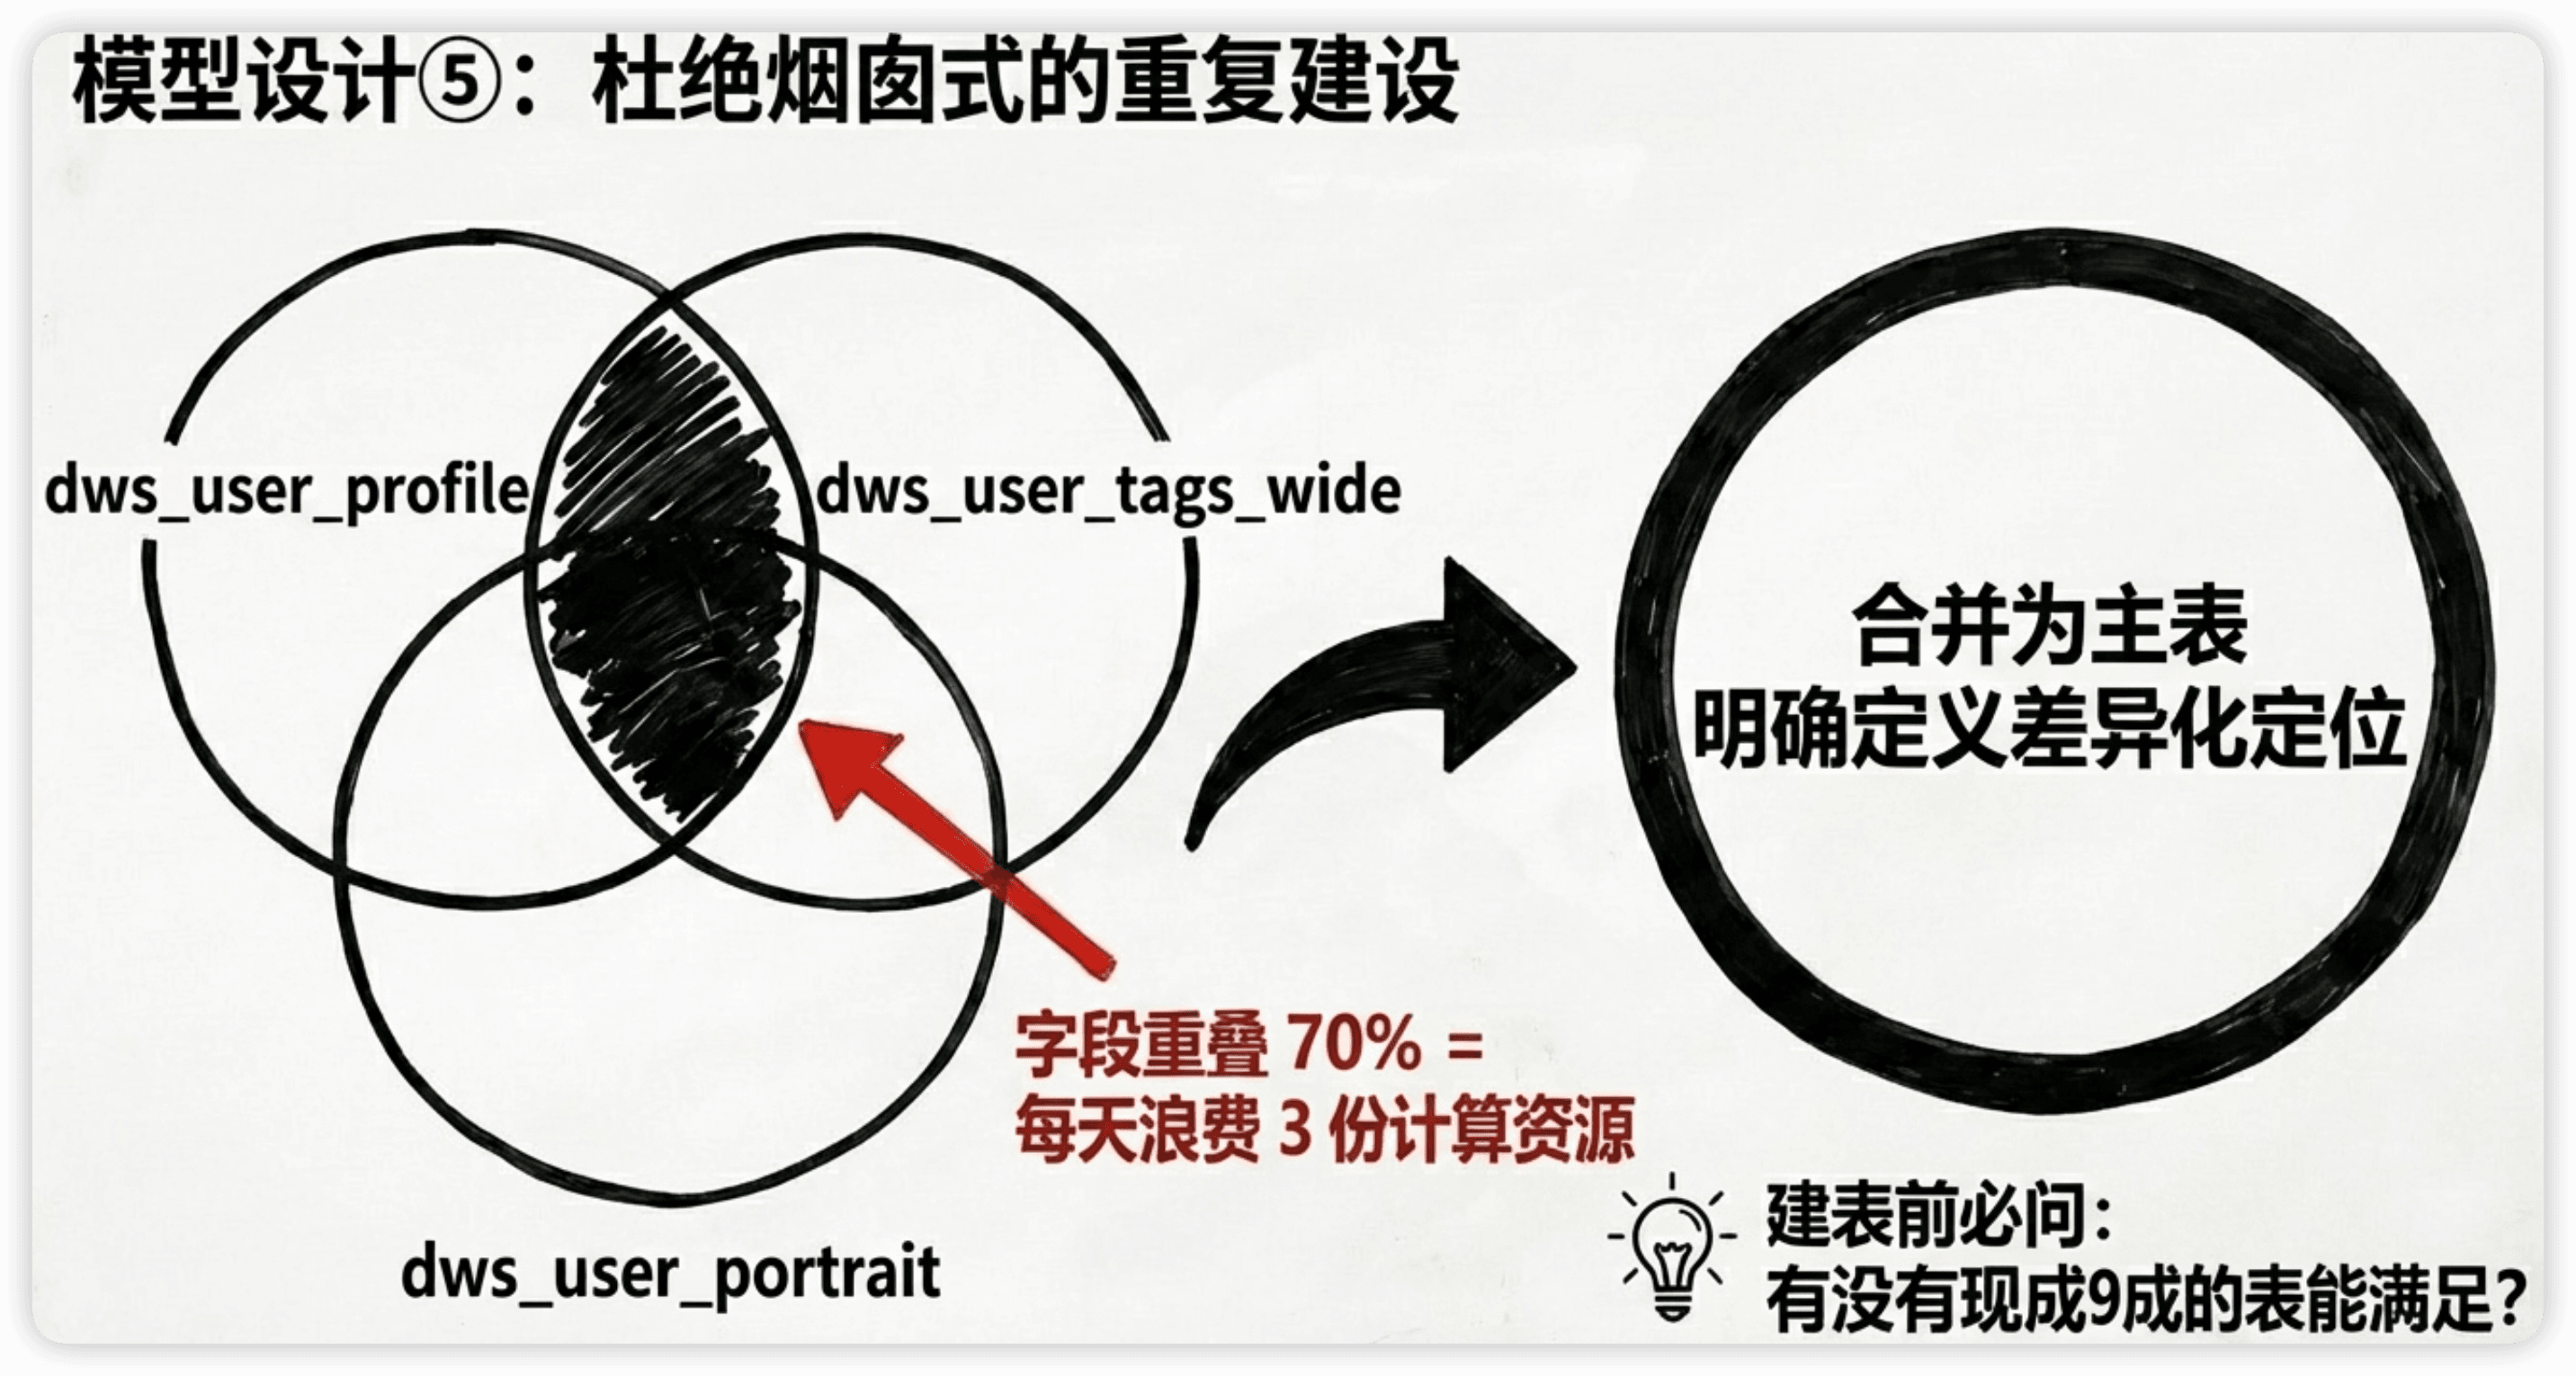
新建表之前必须先问一个问题:有没有已存在的表能满足这个需求?
很多时候答案是"有的,只是不知道"。命名不规范、缺乏元数据管理的团队尤其容易出现重复建设。
我曾经在团队里发现3个人各自建了一张用户画像宽表——dws_user_profile、dws_user_portrait、dws_user_tags_wide——字段重叠了70%,每天各跑一遍,浪费了3份计算资源。
检查方法:
-- 在Hive Metastore里搜索相似表名
SHOW TABLES LIKE '*user*profile*';
SHOW TABLES LIKE '*user*portrait*';
SHOW TABLES LIKE '*user*wide*';

-- 或者用元数据系统搜索关键字段
-- 找到包含 user_id + total_pay_amount + user_level 的所有表不是说不能有多张类似的表,但每张表应该有明确的差异化定位。如果定位重叠,就应该合并或者指定一张为"主表"。
⑥ 上下游关系是否清晰?
一张表不是孤立存在的。评审时必须回答清楚三个问题:
这张表的数据从哪来?(上游依赖)
dws_trade_user_pay_1d 的上游:
├── dwd_trade_order_detail_di    -- 订单明细表
├── dim_user_df                  -- 用户维度表
└── dim_product_df               -- 商品维度表(可选JOIN)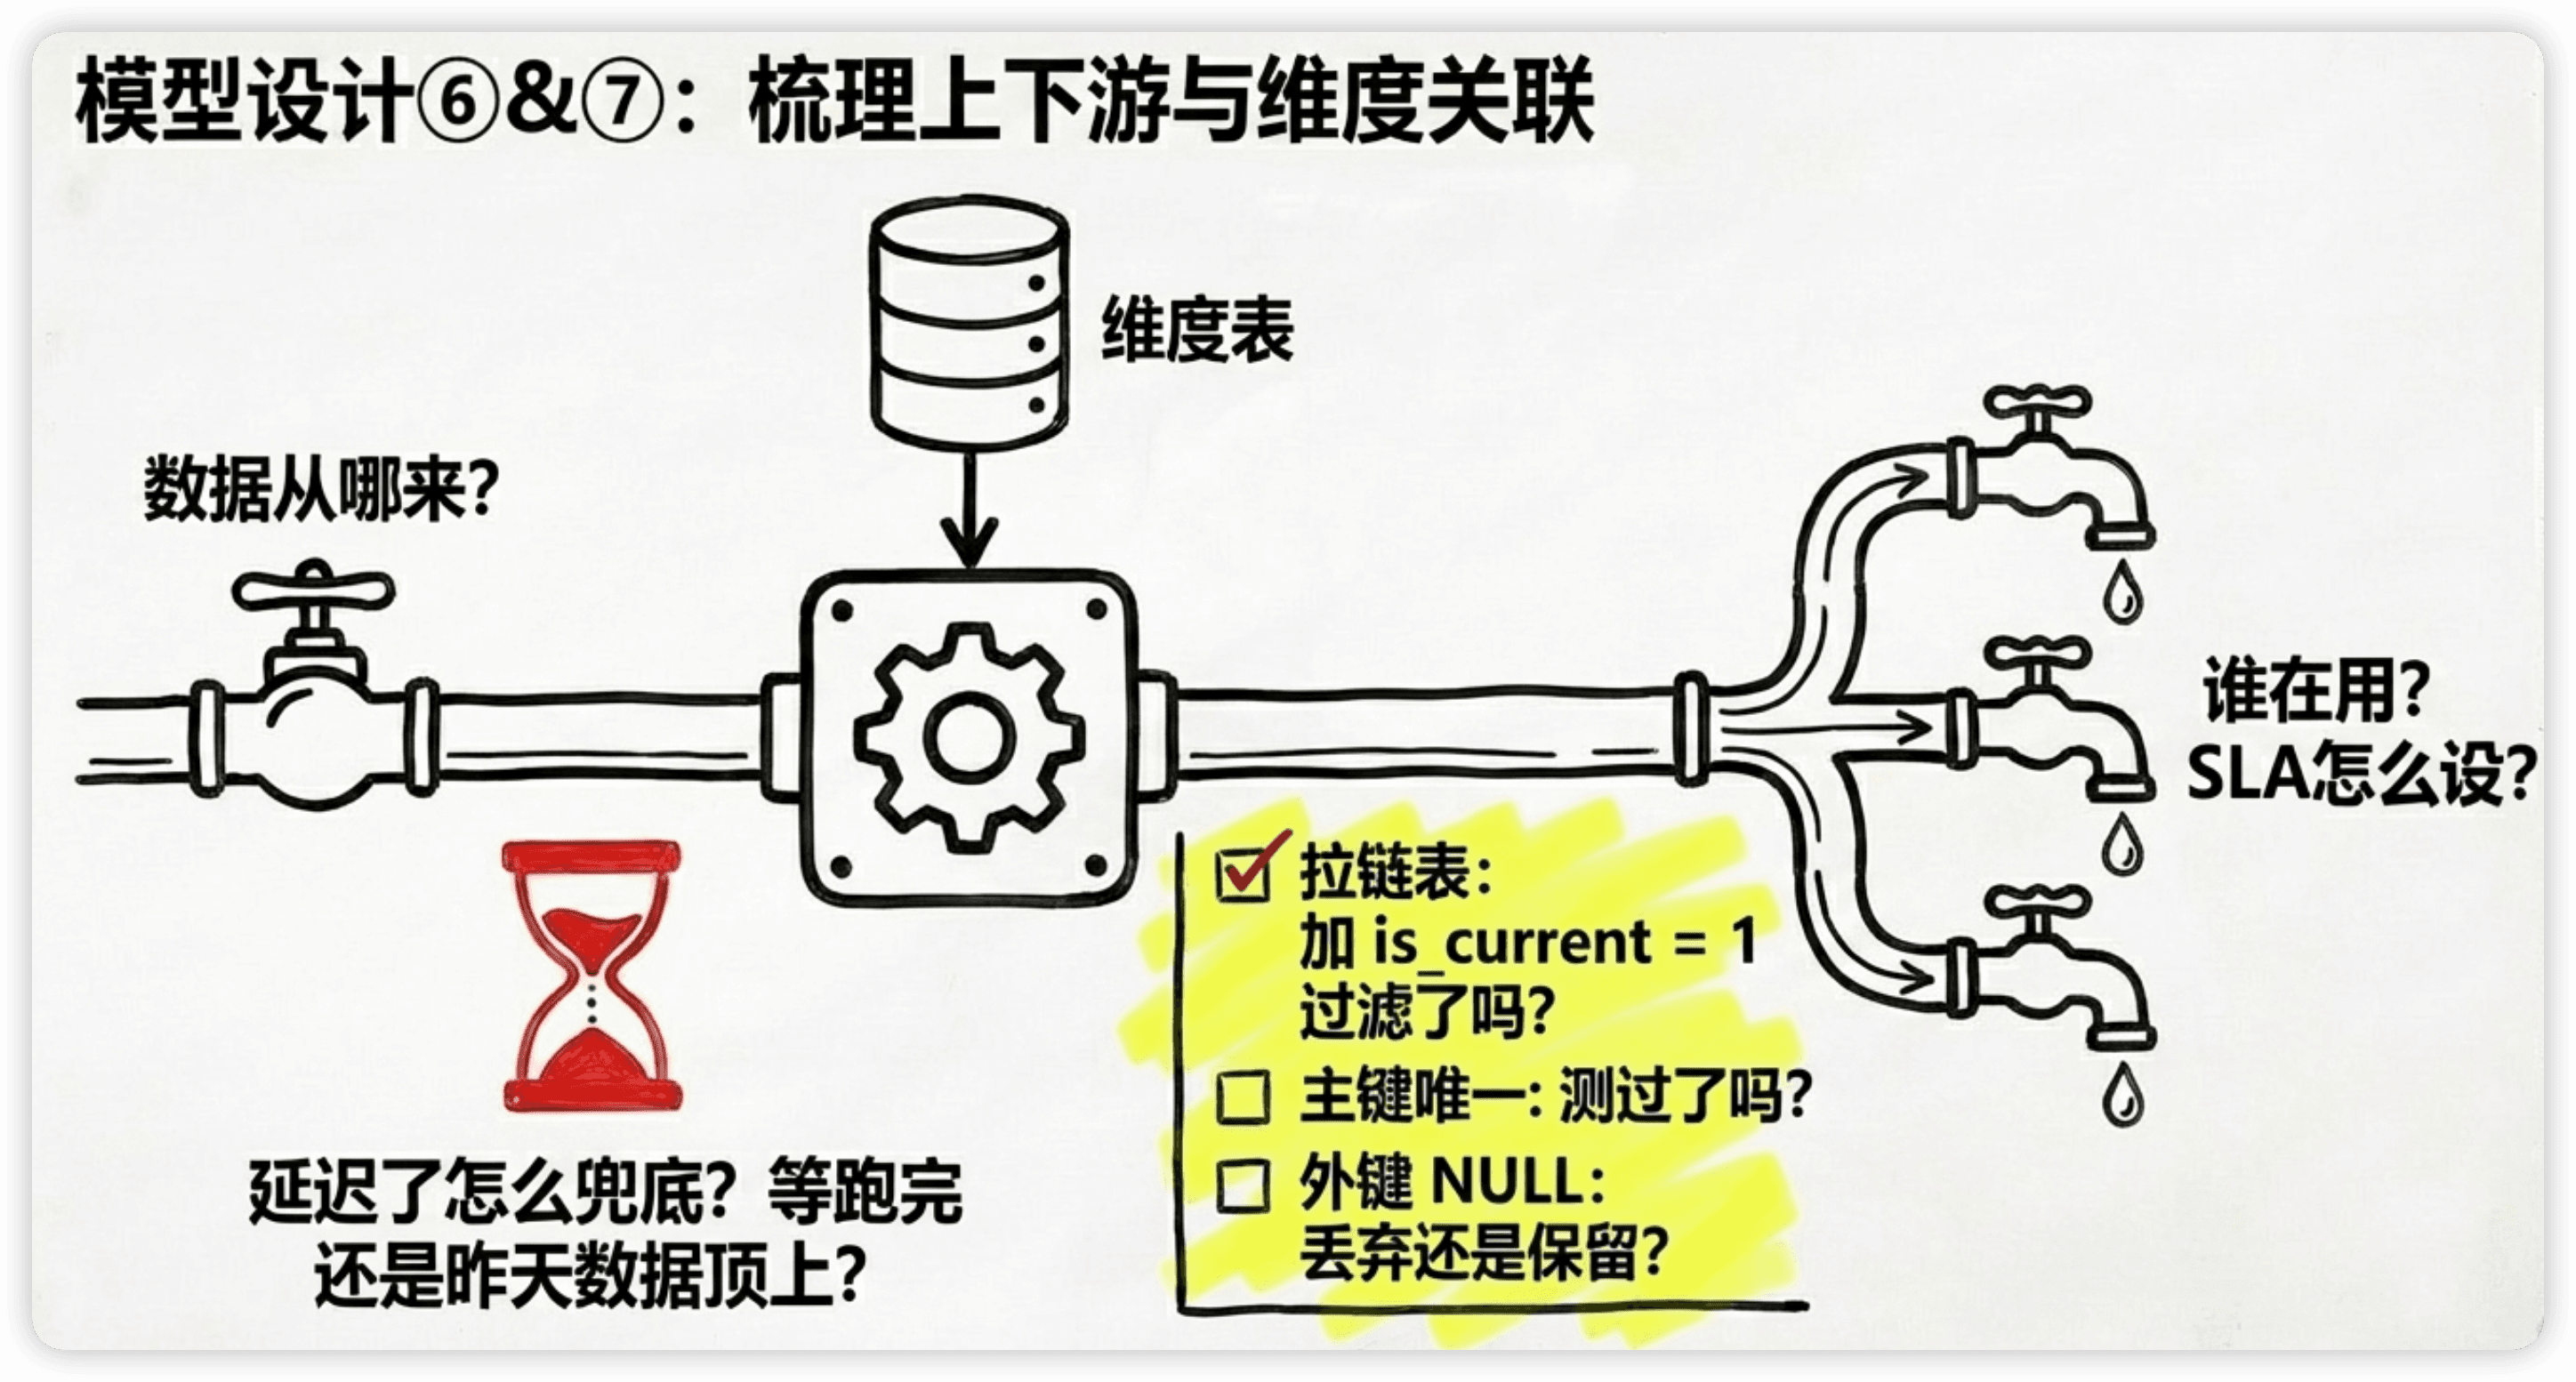
这张表谁在用?(下游使用方)
dws_trade_user_pay_1d 的下游:
├── ads_daily_revenue_report     -- 每日营收报表
├── ads_user_retention_report    -- 用户留存报表
└── 投放团队BI大屏(直查)        -- Hologres对接
上游延迟了怎么办?
如果dwd_trade_order_detail_di的ETL延迟了2小时,这张DWS表的产出时间也会推迟。SLA怎么设?是等上游跑完再触发,还是有兜底逻辑用昨天的数据先顶上?
这些问题在评审时不想清楚,上线后第一次出故障就是一团乱麻。
⑦ 维度关联是否正确?
如果ETL逻辑里JOIN了维度表,必须检查:
- 拉链表是否加了时间范围过滤? 不加
WHERE is_current = 1或日期范围过滤,行数必膨胀(DAY 7的内容) - 维度表主键是否唯一? 先跑一遍DAY 7的唯一性检查SQL
- 外键有NULL的情况怎么处理? 用LEFT JOIN还是INNER JOIN?NULL的行保留还是丢弃?
-- 评审时运行:检查JOIN后行数是否正常
SELECT
    (SELECT COUNT(*) FROM dwd_trade_order_detail_di WHERE dt = '2025-01-15') AS src_cnt,
    (SELECT COUNT(*) FROM dws_trade_user_pay_1d WHERE dt = '2025-01-15') AS result_cnt;

-- 如果result_cnt > src_cnt,可能存在数据膨胀
-- 如果result_cnt << src_cnt,可能外键NULL导致INNER JOIN丢失了大量数据
三、数据质量(3项)
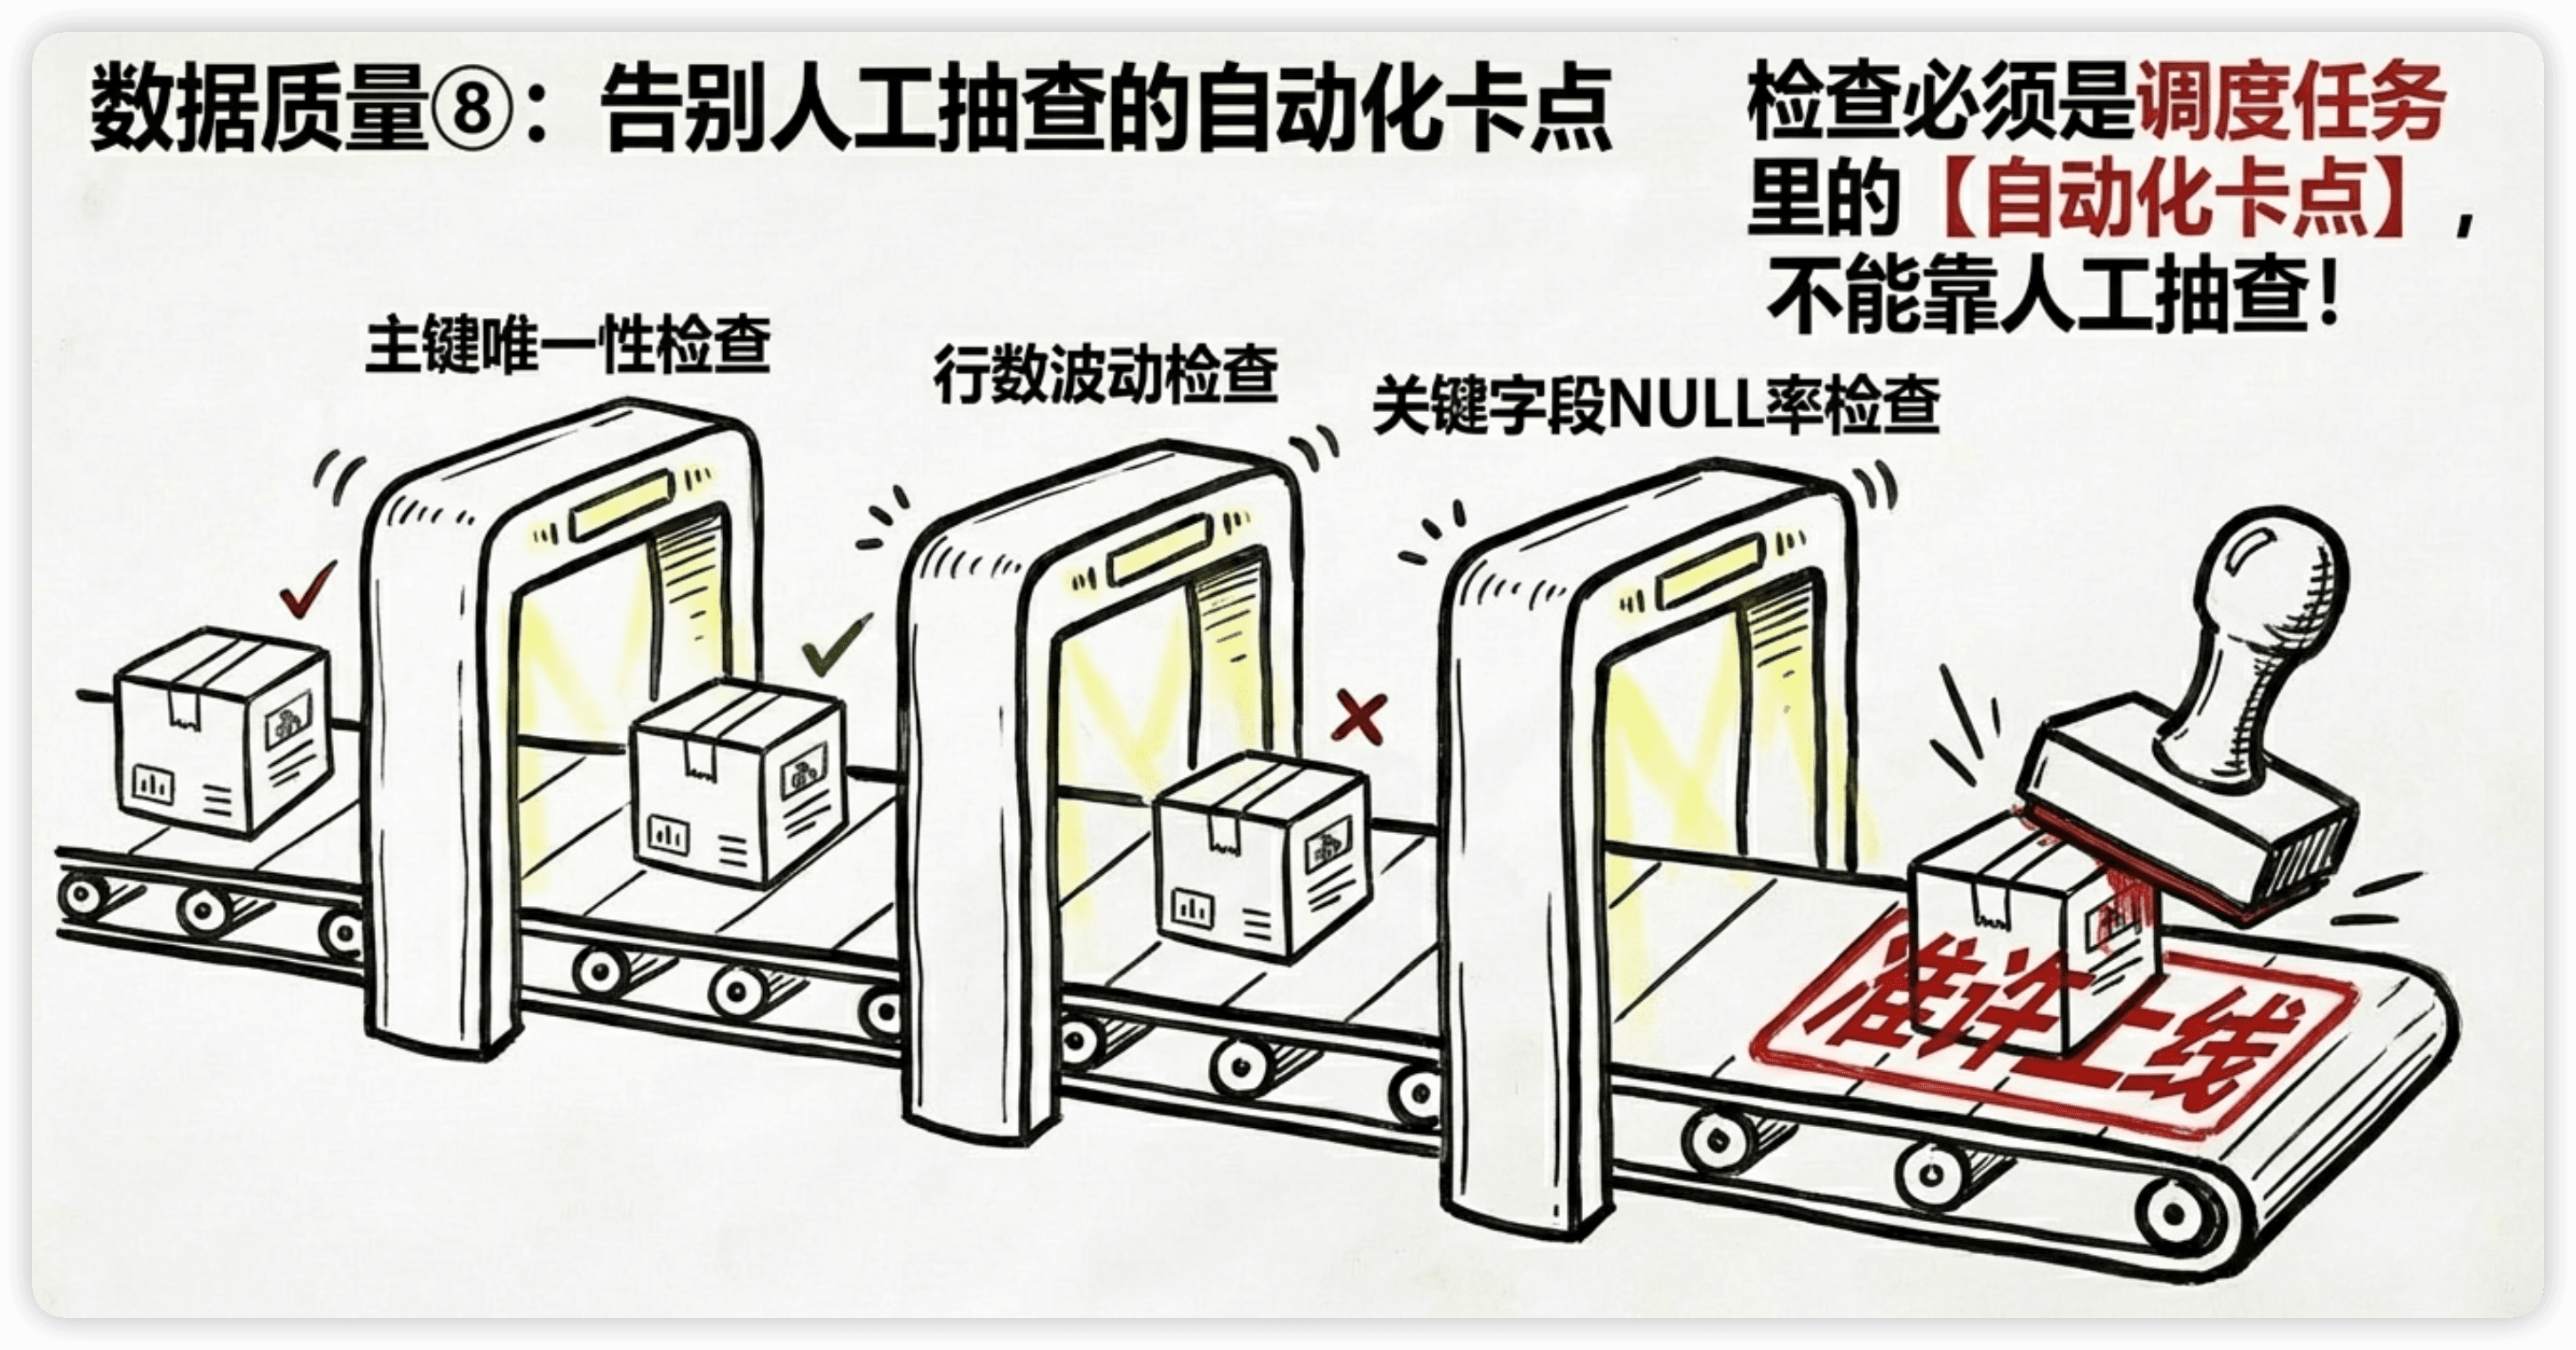
⑧ 有没有数据质量校验?
上线的表必须配套数据质量检查,至少包括三类:
主键唯一性检查:
-- 粒度是 user_id × dt,主键不能重复
SELECT user_id, dt, COUNT(*) AS cnt
FROM dws_trade_user_pay_1d
WHERE dt = '${bizdate}'
GROUP BY user_id, dt
HAVING cnt > 1;
-- 如果有结果,说明ETL有Bug
行数波动检查:
-- 和前一天对比,波动超过20%需要告警
WITH today AS (
    SELECT COUNT(*) AS cnt FROM dws_xxx WHERE dt = '${bizdate}'
),
yesterday AS (
    SELECT COUNT(*) AS cnt FROM dws_xxx WHERE dt = DATE_SUB('${bizdate}', 1)
)
SELECT
    today.cnt AS today_cnt,
    yesterday.cnt AS yesterday_cnt,
    ROUND((today.cnt - yesterday.cnt) * 100.0 / yesterday.cnt, 2) AS change_rate
FROM today, yesterday;
-- change_rate 超过 ±20% 就告警
关键字段NULL率检查:
-- 核心指标字段不应该有大量NULL
SELECT
    COUNT(*) AS total,
    SUM(CASE WHEN pay_amount IS NULL THEN 1 ELSE 0 END) AS null_cnt,
    ROUND(SUM(CASE WHEN pay_amount IS NULL THEN 1 ELSE 0 END) * 100.0 / COUNT(*), 2) AS null_rate
FROM dws_trade_user_pay_1d
WHERE dt = '${bizdate}';
-- null_rate 超过 5% 需要排查
这些检查要做成调度任务里的自动化卡点,不能靠人工抽查。
⑨ 历史数据是否回刷验证?
新表不能只跑当天数据就上线。至少要做:
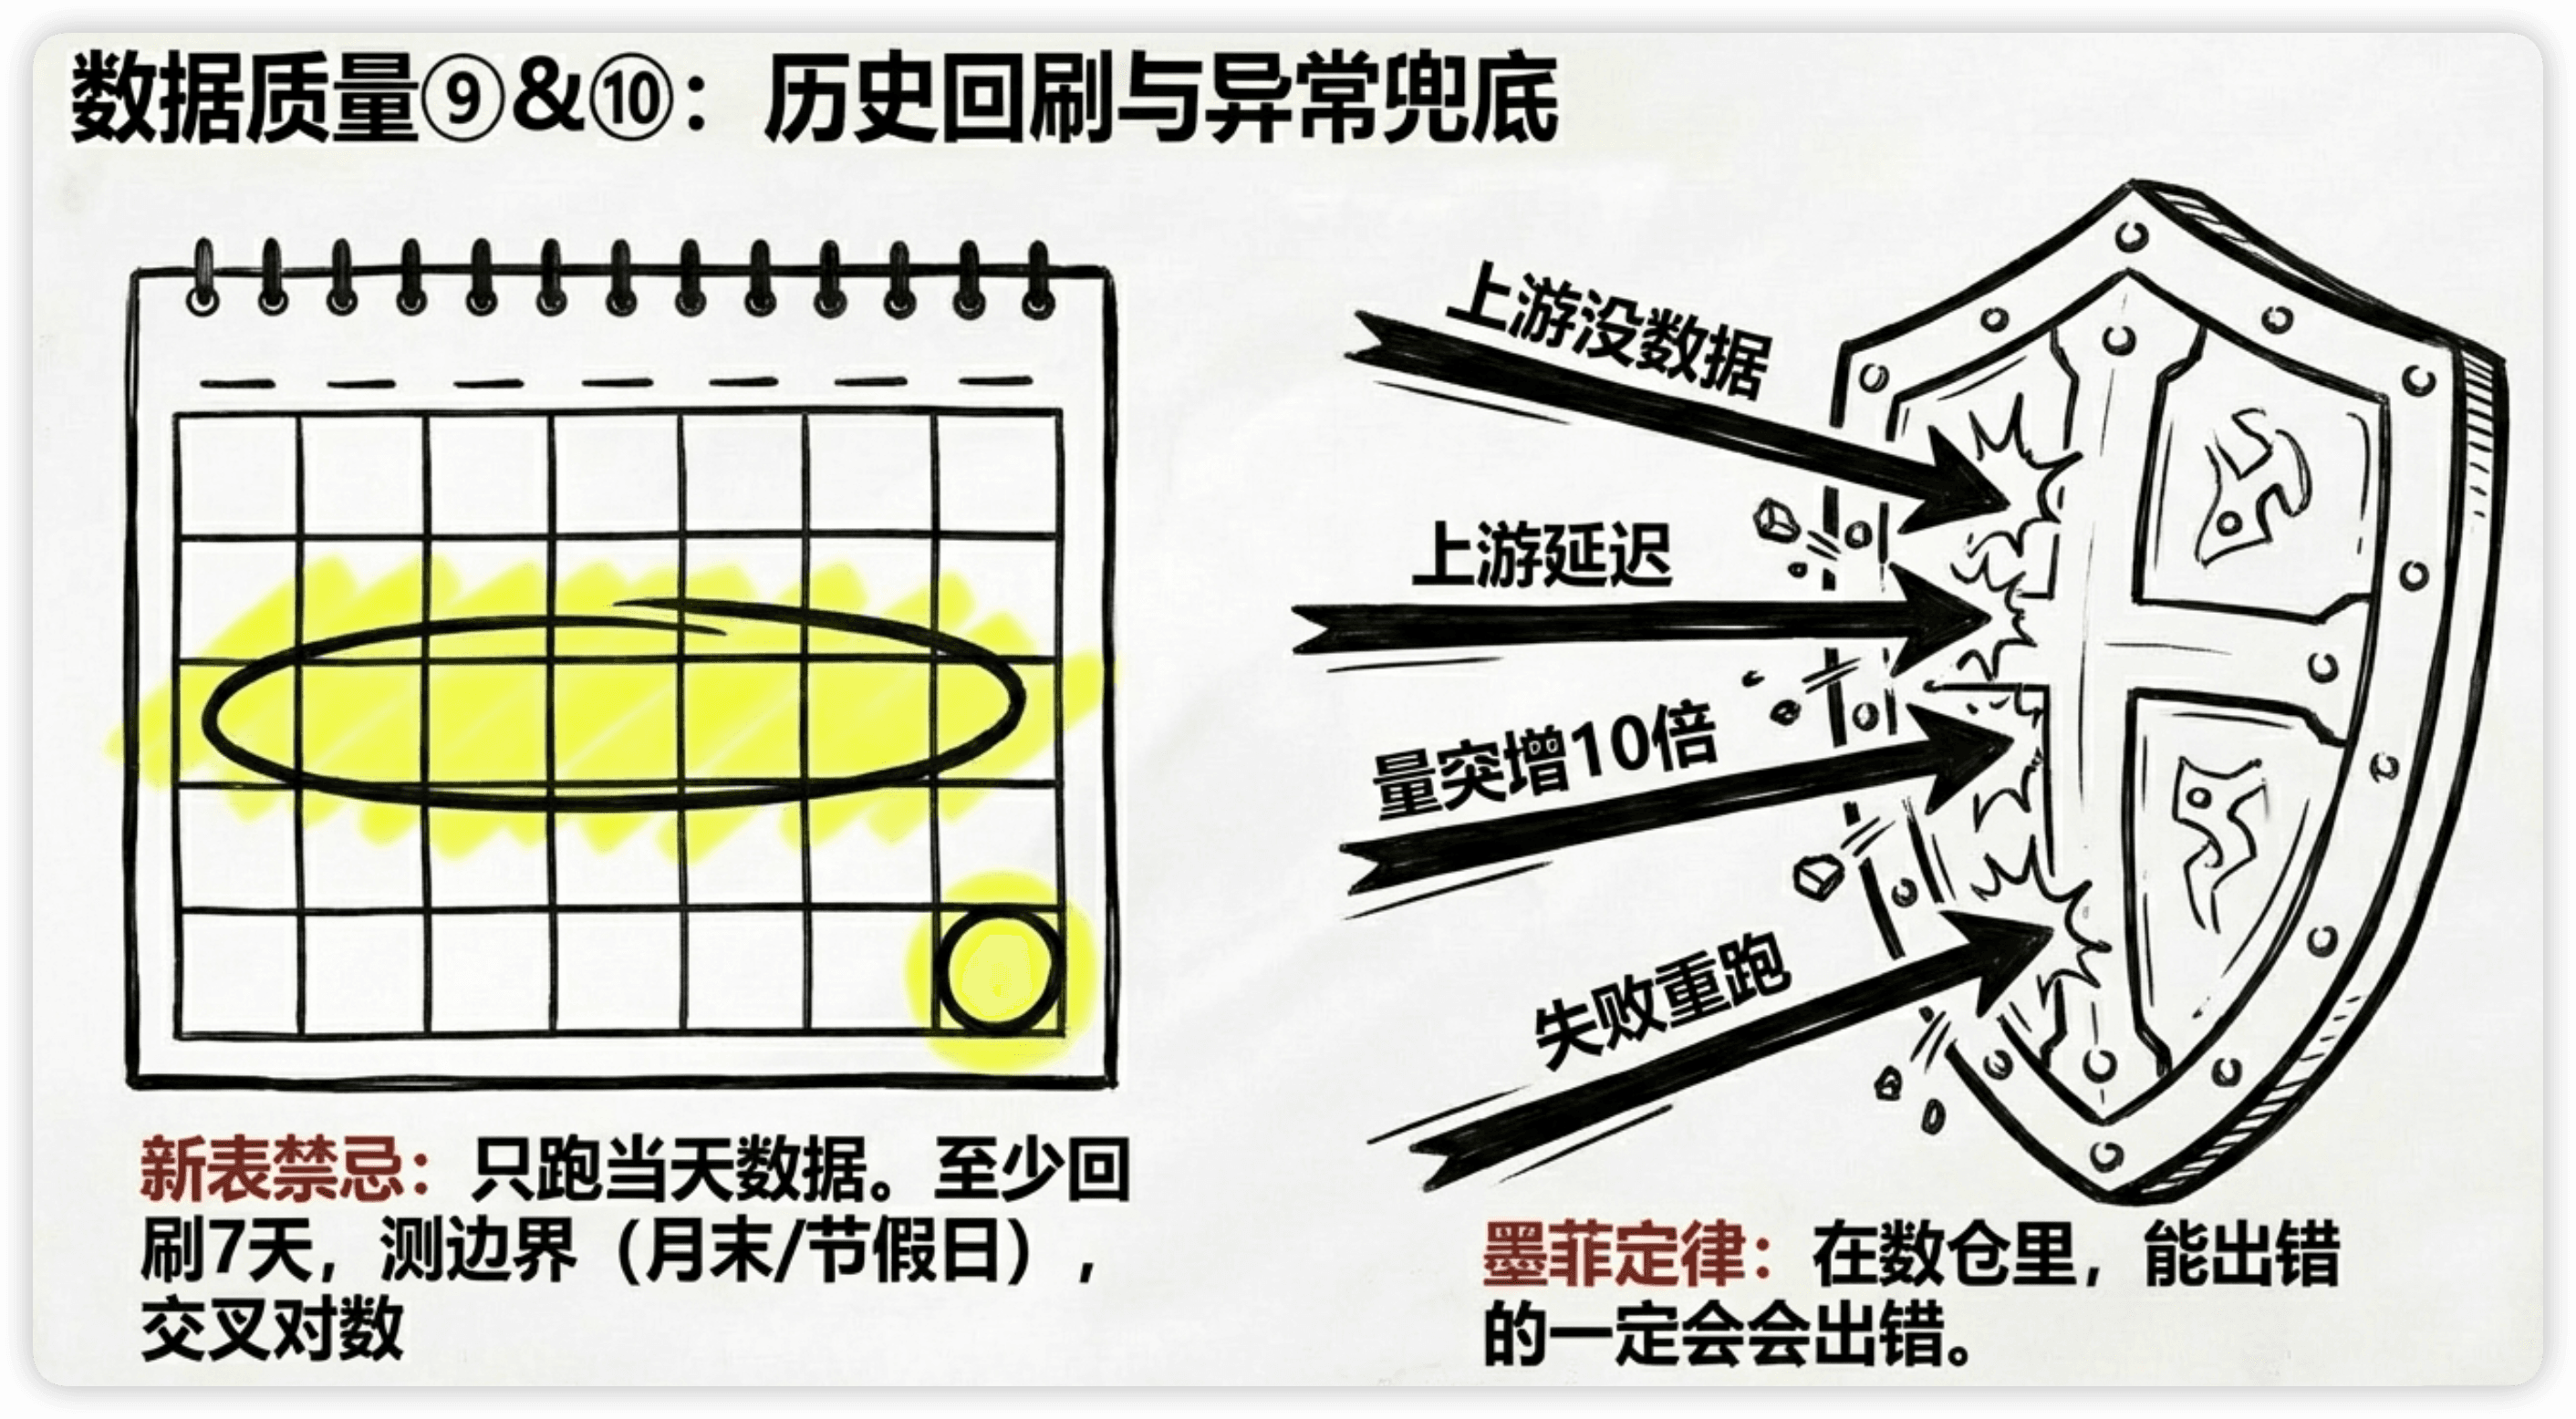
- 回刷7天数据,验证ETL逻辑在不同日期下都能正确运行
- 和已有报表/源表交叉验证,核心指标数值是否一致
- 检查边界情况:月初/月末、节假日、数据量异常大/小的日期
-- 交叉验证:新表的GMV和已有报表的GMV是否一致
SELECT
    a.dt,
    a.total_pay_amount AS new_table_gmv,
    b.gmv_paid AS old_report_gmv,
    ABS(a.total_pay_amount - b.gmv_paid) AS diff
FROM (
    SELECT dt, SUM(pay_amount) AS total_pay_amount
    FROM dws_trade_user_pay_1d
    GROUP BY dt
) a
JOIN ads_trade_daily_report b ON a.dt = b.dt
WHERE a.dt >= DATE_SUB(CURRENT_DATE, 7)
ORDER BY a.dt;
-- diff 应该为0或极小的精度差异
回刷验证虽然花时间(可能要跑1-2小时),但能避免上线后发现数据错误再紧急修复。
⑩ 异常情况有没有兜底?
Murphy定律在数仓里表现得淋漓尽致——能出错的一定会出错。评审时需要考虑:
- 上游表没数据时:下游是产出空表,还是用前一天的数据补充?
- 上游数据延迟时:调度依赖怎么设?强依赖等到跑完,还是弱依赖超时后跳过?
- 数据量突增时:如果某天活动导致数据量翻10倍,存储和计算资源能不能扛住?Executor内存够不够?
- 重跑是否幂等:如果任务失败重跑了两次,结果是否一致?是否会产生重复数据?
-- 幂等设计:使用 INSERT OVERWRITE 而不是 INSERT INTO
-- 这样重跑不会产生重复数据
INSERT OVERWRITE TABLE dws_trade_user_pay_1d PARTITION (dt = '${bizdate}')
SELECT ...
评审流程:轻量但有效
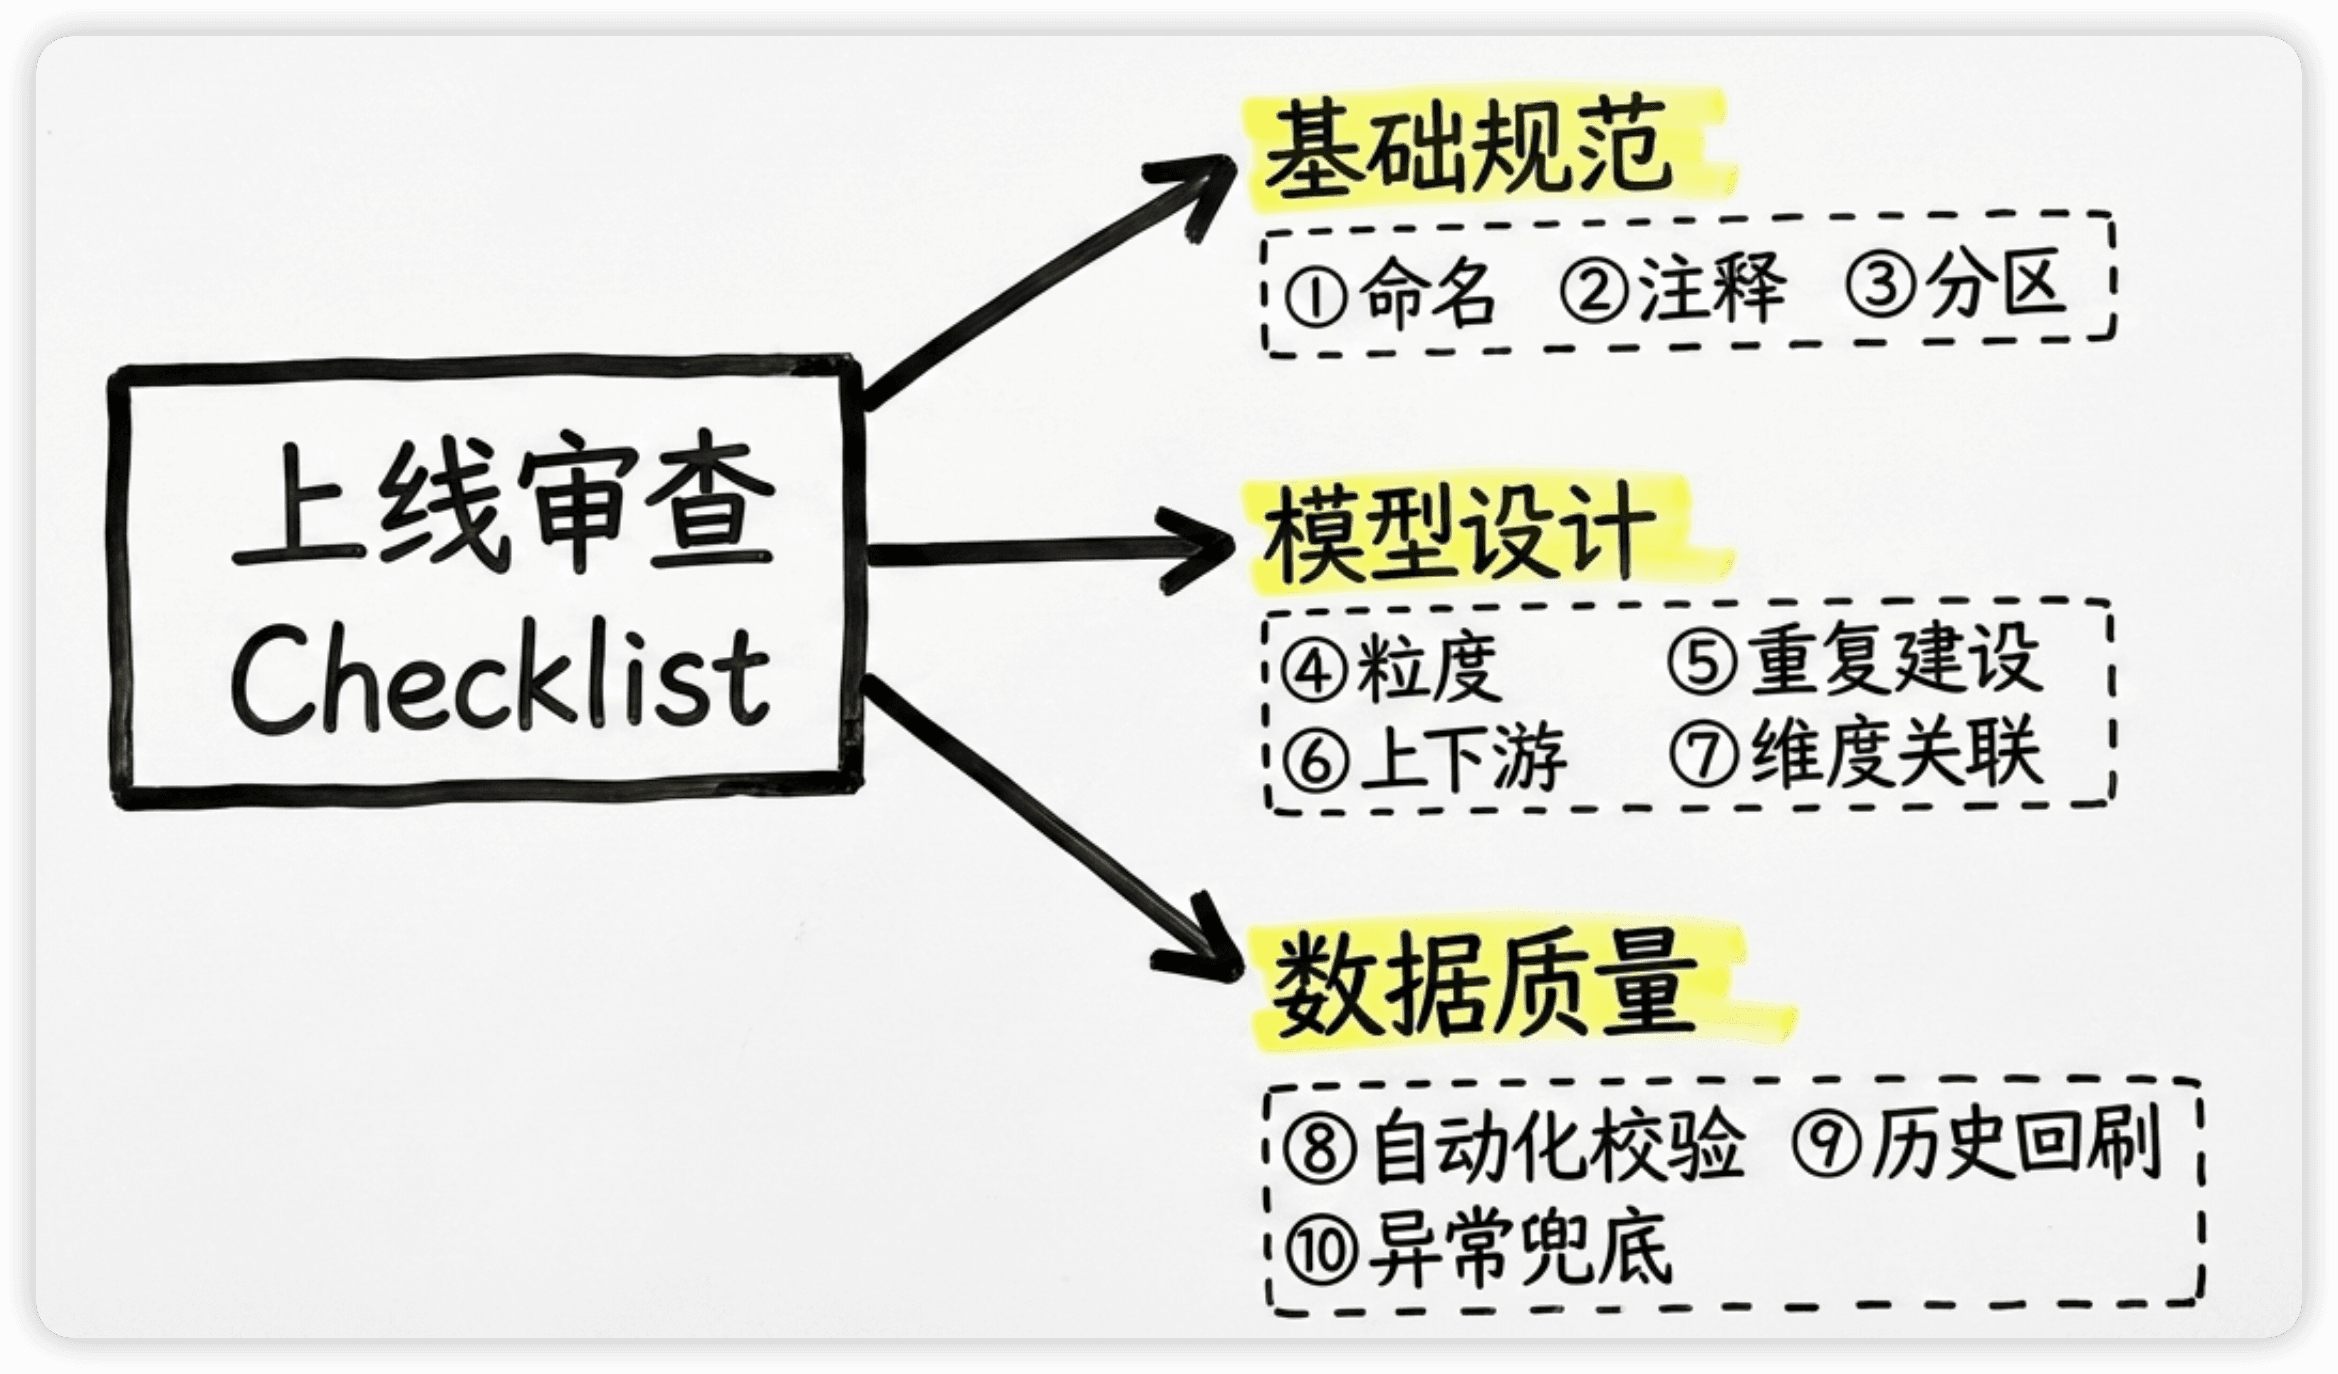
评审不需要搞得很重——开两小时的评审会、写二十页的设计文档、请五个人签字——那是大公司的做法。3-5人的数据团队,流程越轻越好。
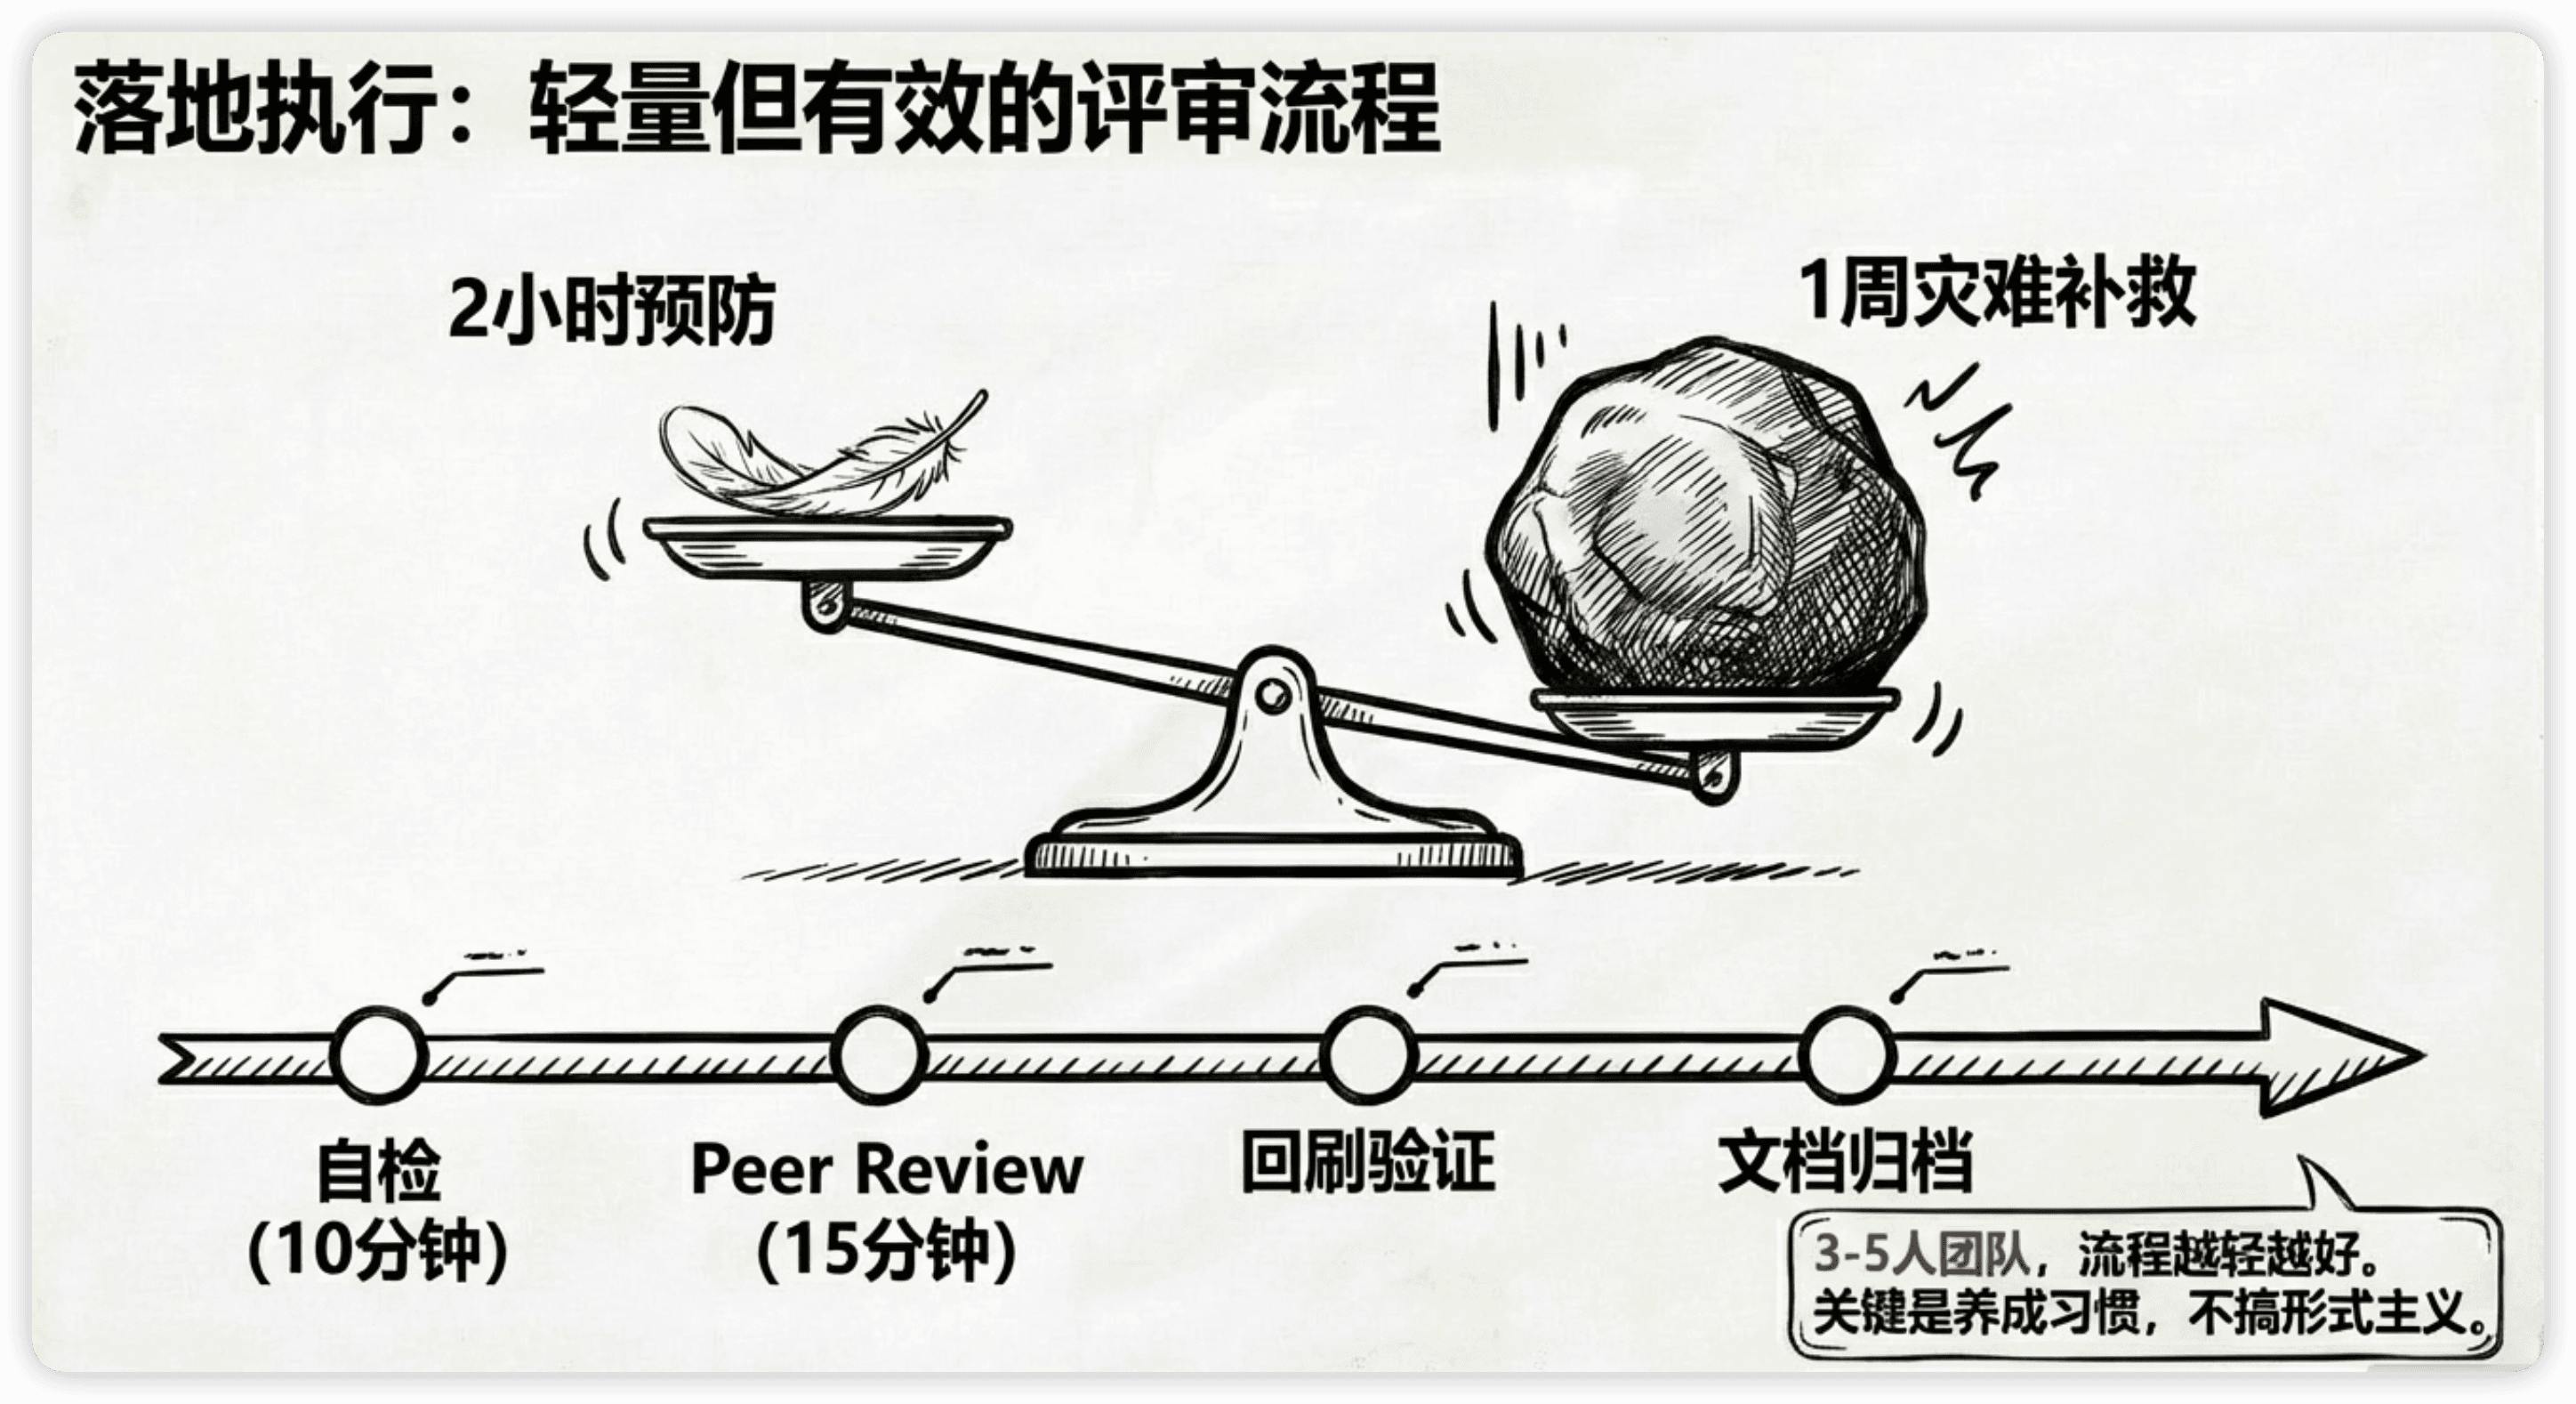
我的做法是四步走:
1. 开发者自检(10分钟)
   → 对照上面10项Checklist逐一检查,用✅/❌标记

2. Peer Review(15分钟)
   → 找一个同事过一遍设计文档和ETL代码
   → 重点看粒度定义、JOIN逻辑、命名规范

3. 上线验证(1-2小时)
   → 回刷7天数据 + 和已有报表对数 + 质量校验通过

4. 文档归档(5分钟)
   → 表信息录入元数据系统(或更新飞书文档)
→ 包括:表用途、粒度说明、上下游依赖、负责人整个流程加起来不到2小时,但能避免上线后花一周修问题。花2小时预防 vs 花一周补救,怎么算都划算。
我在团队推行评审机制之后,线上数据质量问题减少了大概一半。更重要的是团队养成了"上线前多想一步"的习惯。现在大家自己建表都会主动对照Checklist检查,不用我催。
面试怎么答?
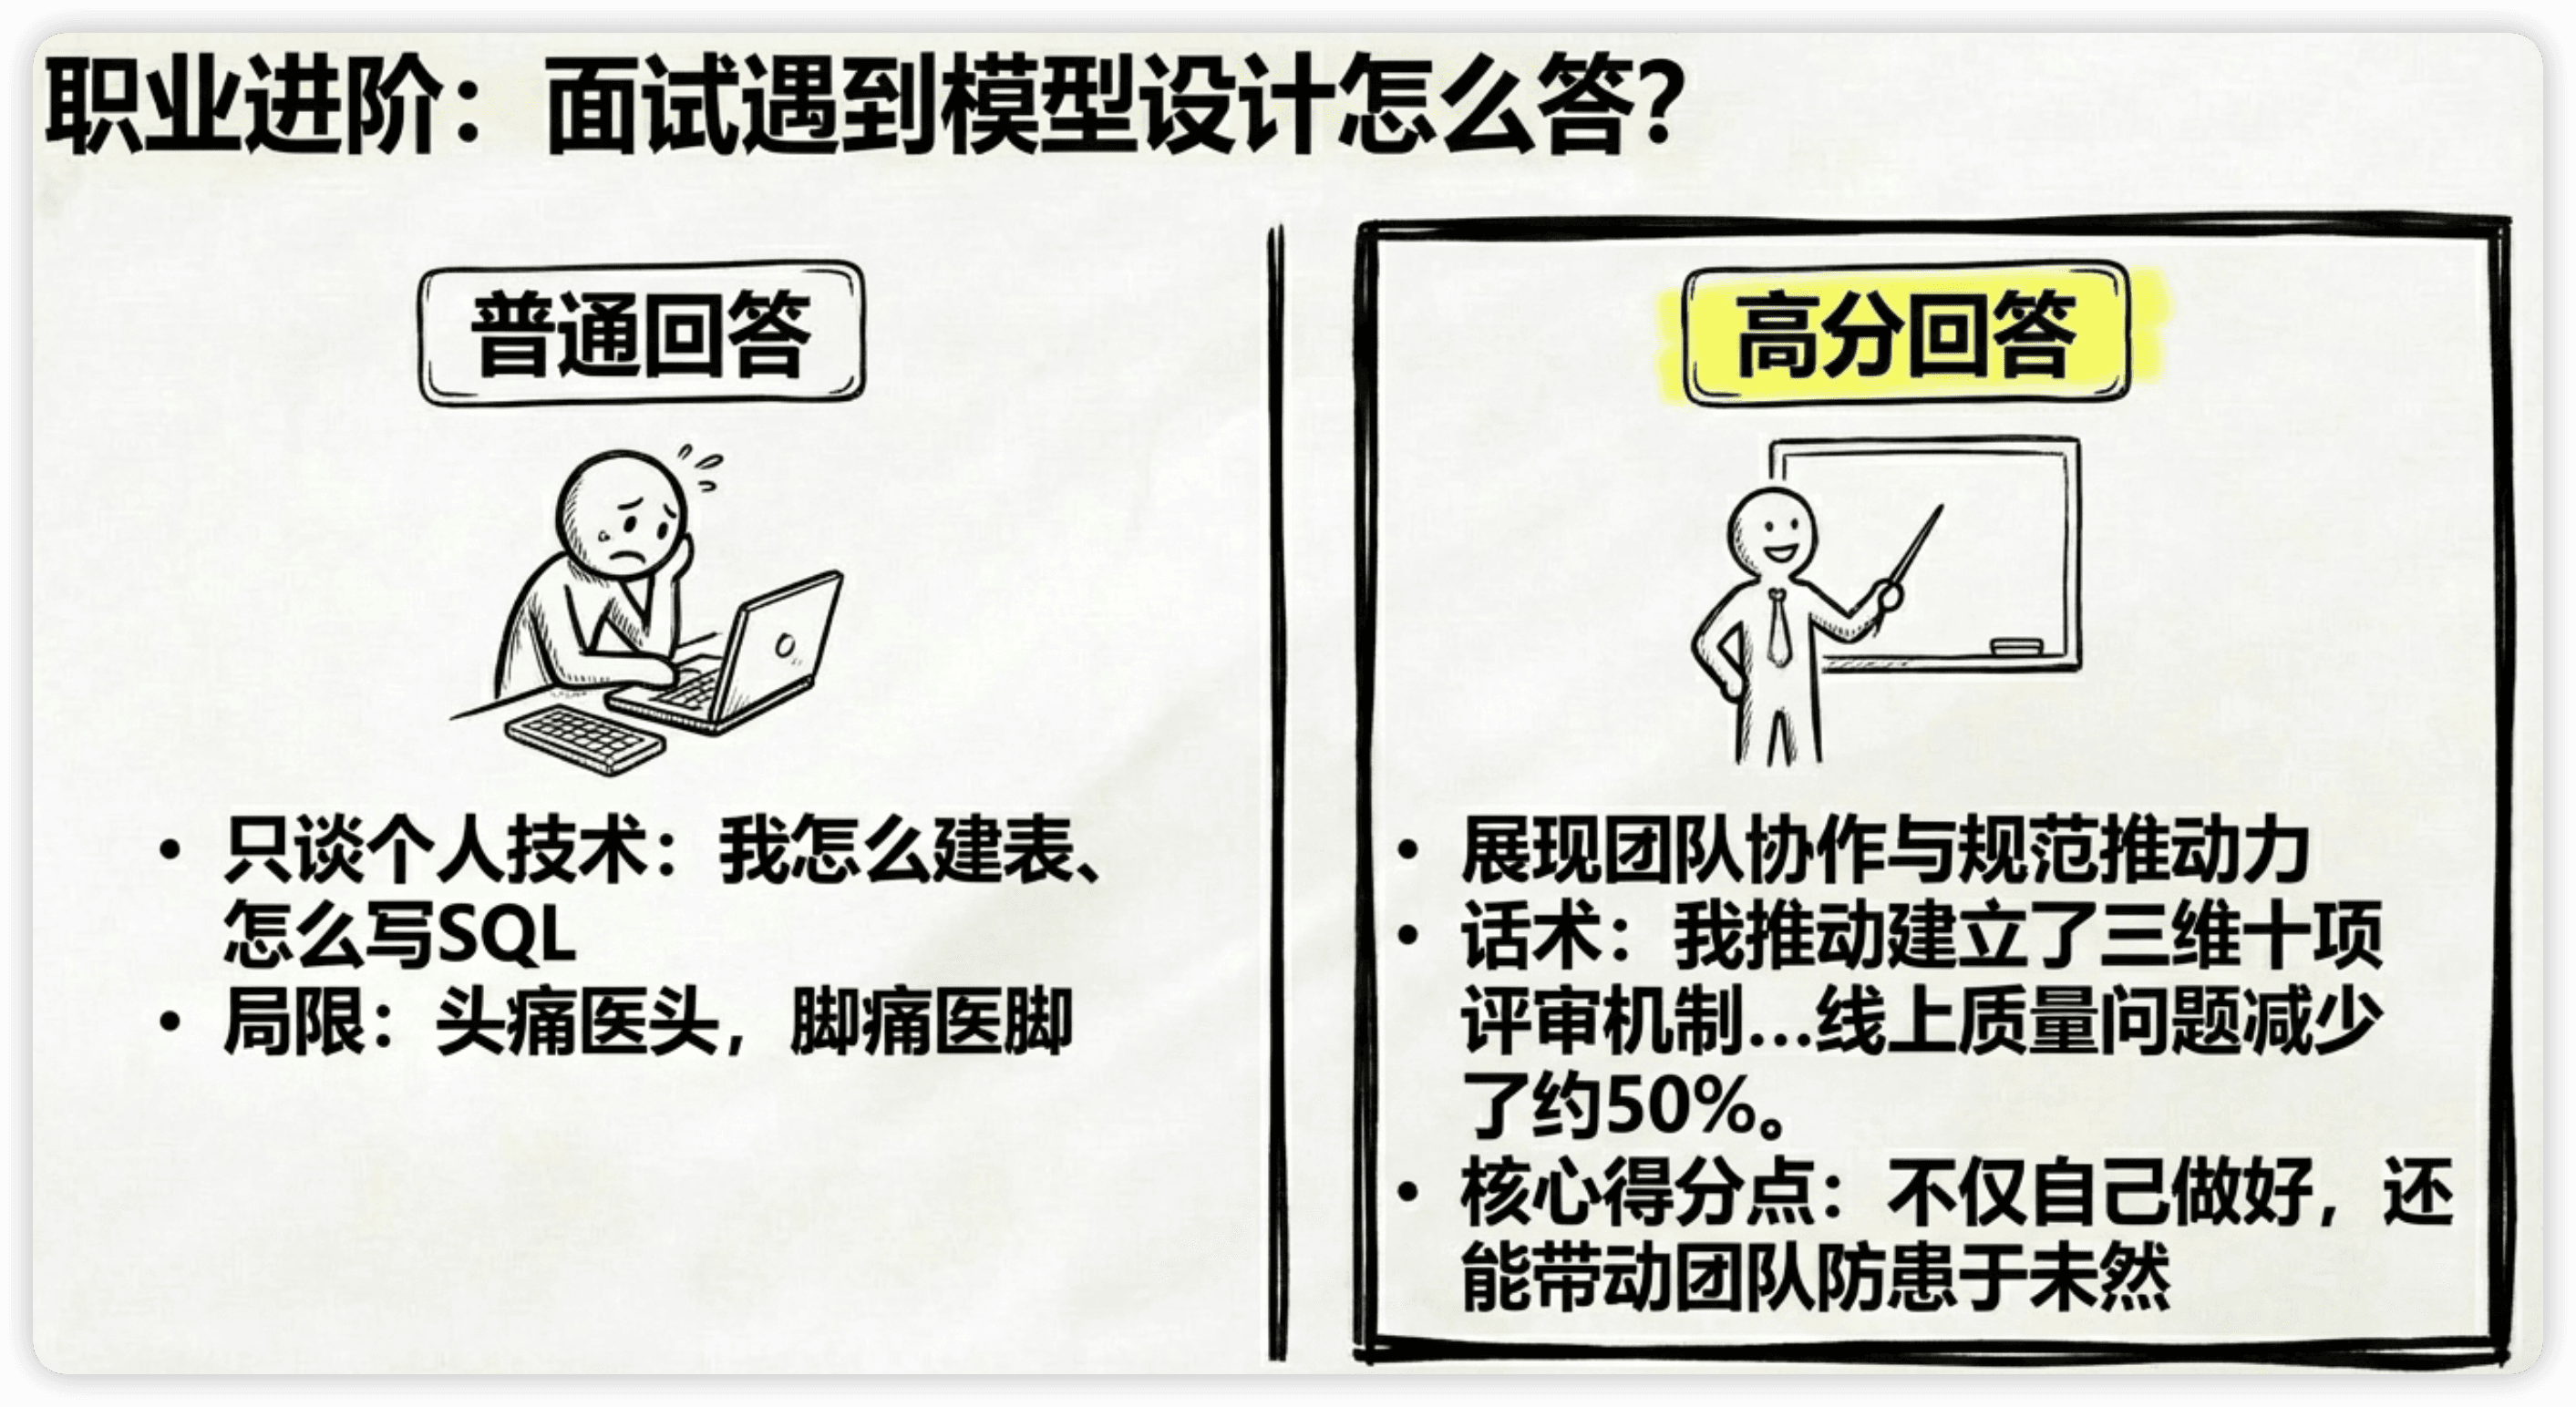
高分回答
「我们团队有一套模型评审机制,是我推动建立的。核心是一个10项Checklist,覆盖三个维度:基础规范(命名、注释、分区)、模型设计(粒度定义、避免重复建设、上下游关系、维度关联)、数据质量(主键唯一、回刷验证、异常兜底)。每张新表上线前需要开发者自检 + 一个同事Peer Review,回刷至少7天数据、和已有报表对数通过才能上线。推行之后线上数据质量问题减少了约50%。」
这个回答好在哪里?它展现的不只是技术能力,更是团队协作和规范化推动能力。这是中高级岗位面试官特别看重的维度——你不仅自己能做好,还能带动团队一起做好。
追问防线
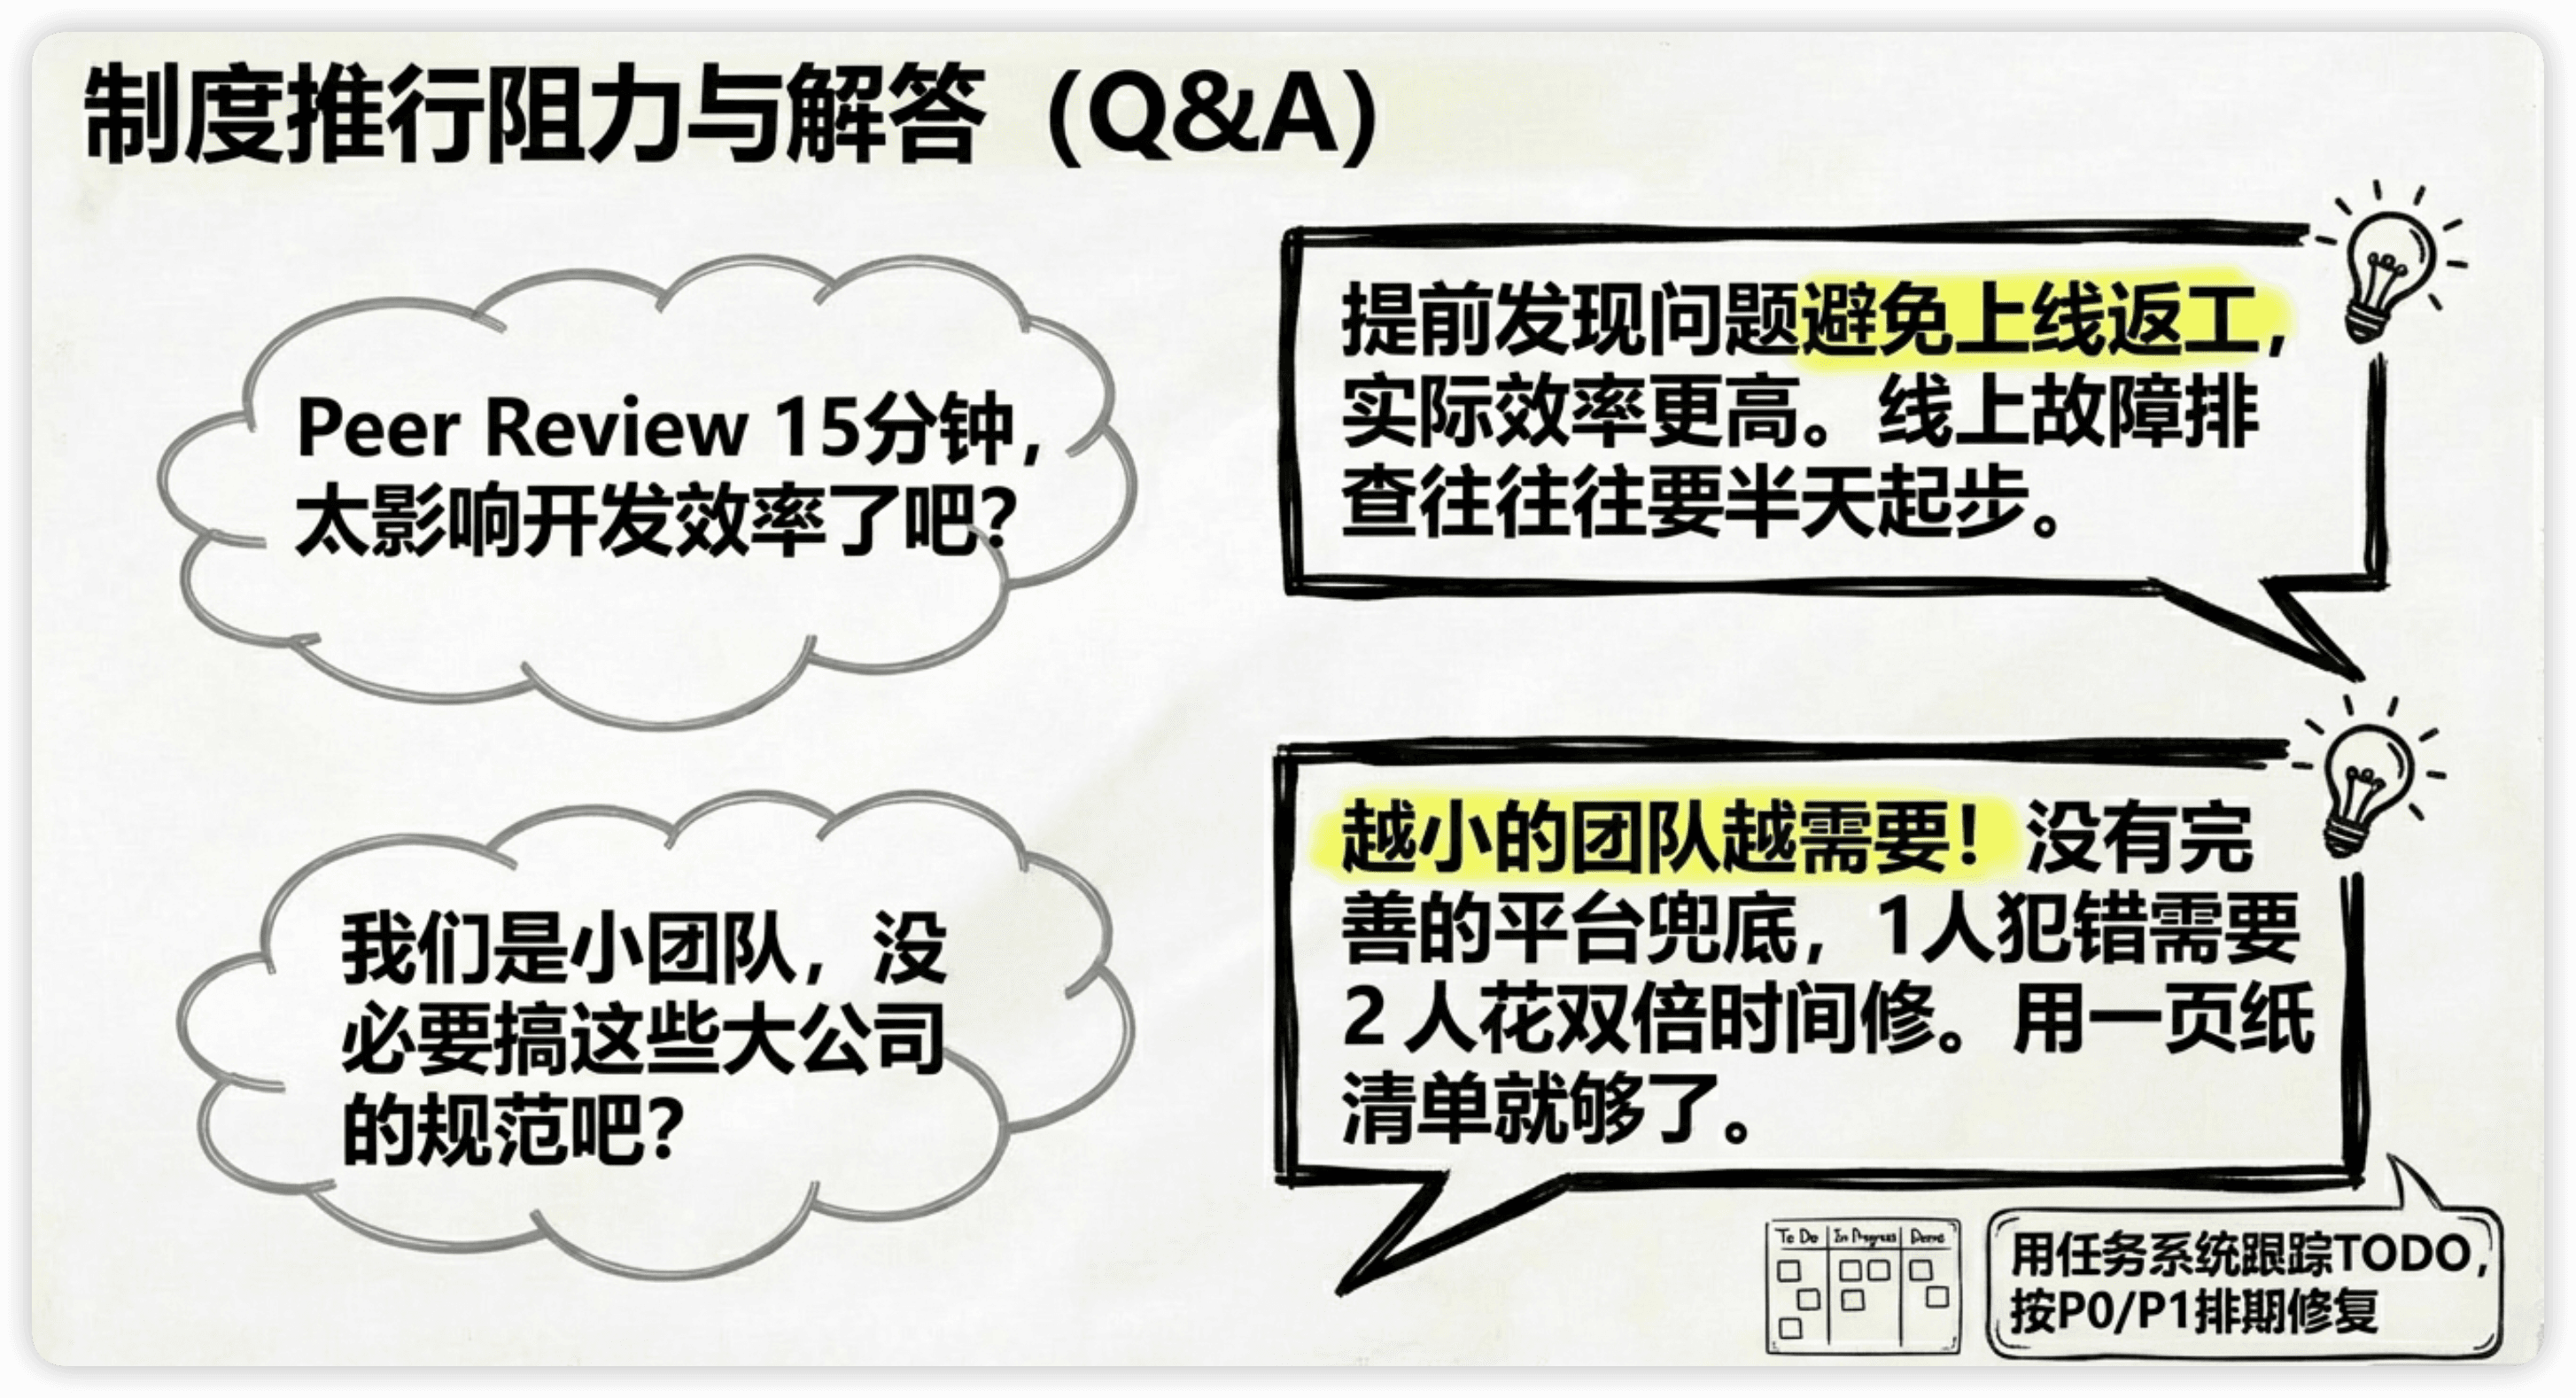
追问1:Peer Review会不会影响开发效率?
15分钟的Review看起来是"额外成本",但和线上出了问题后花半天排查、花一周修数据的成本比起来,简直太划算了。而且Review本身也是团队知识共享的机会——Reviewer能了解其他人在做什么,开发者也能得到不同视角的反馈。
实际上推行之后,大家反馈是开发效率反而提高了——因为Review过程中经常能提前发现问题,避免了上线后返工。
追问2:评审发现的问题怎么跟踪?
我们用飞书的任务列表来跟踪。Review时发现的问题记成TODO,标注严重程度(P0必须修才能上线,P1上线后一周内修,P2排期修)。每周站会过一遍待修复的P1/P2问题。
追问3:小团队有必要搞这些规范吗?
越小的团队越需要。大公司有完善的数据平台、元数据系统、自动化测试来兜底;小团队没有这些基础设施,全靠人来保证质量。一个3人团队如果不做Review,一个人犯的错误可能要另外两个人花双倍时间来修。
当然,小团队的规范要轻量——一页纸Checklist就够了,不要搞繁重的流程。关键是养成习惯,不是搞形式。
总结
- 上线容易下线难,一开始就要审好,避免下游依赖后改不动
- 10项Checklist分三个维度:
- 基础规范:命名、注释、分区
- 模型设计:粒度唯一、避免重复建设、上下游清晰、维度关联正确
- 数据质量:主键唯一校验、回刷验证、异常兜底
- 流程要轻量但有效:自检10分钟 → Peer Review 15分钟 → 回刷验证 → 文档归档
- 面试加分关键:不只是"我会做",更是"我推动了团队规范化"
数仓建模系列 DAY 1-10 到这里全部更新完了。从分层架构、维度建模、SCD拉链表、事实表类型、宽表设计、指标口径、数据膨胀、命名规范、OneID到模型评审,覆盖了数仓建模面试的核心考点。
这10篇的知识是串联在一起的——面试官经常从一个点追问到另一个点。建议把这10篇串起来复习,形成自己的知识体系。面试时能把不同话题之间的关系讲清楚(比如"宽表设计需要注意数据膨胀问题,而膨胀通常是因为维度表的缓慢变化维没处理好"),这才是真正的高手。