宽表设计,什么时候建、建多宽
"你们数仓有没有用宽表?"——面试里这道题看起来简单,但答好了非常能体现你的实战功底。
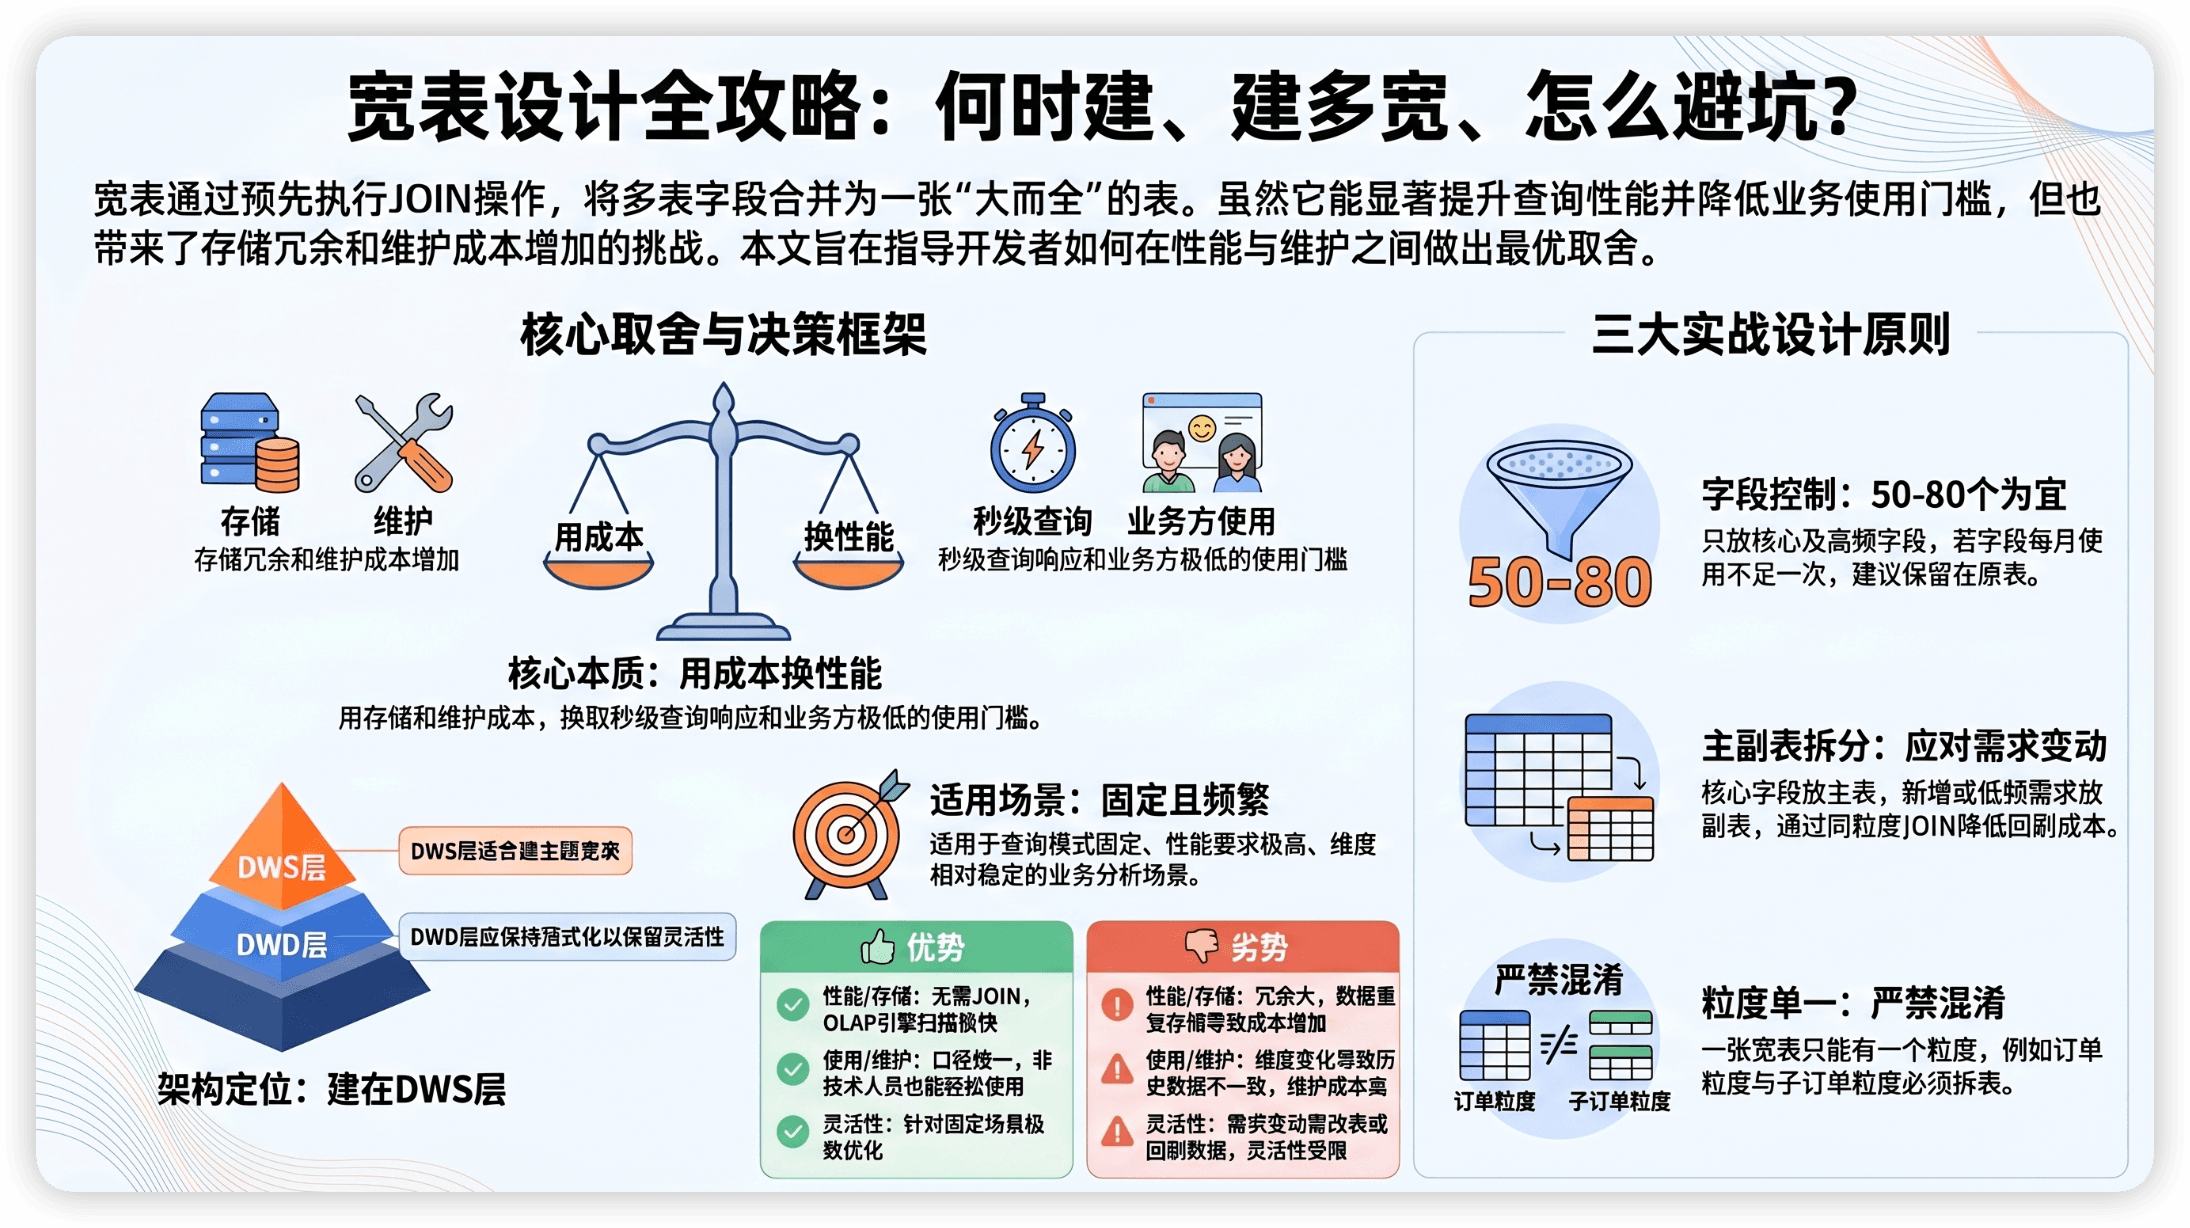
因为宽表设计不是一个纯技术问题,它涉及到性能与维护的取舍、粒度的把控、需求变化的应对,以及一个数仓老手都会遇到的灵魂拷问:这张宽表到底该有多少个字段?
这篇文章我结合自己的实战经验,把宽表的本质、适用场景、设计原则、常见踩坑一次讲透。
宽表到底是什么?
用一句话说:把多张表的字段提前JOIN好,合并成一张"大而全"的表。
举个例子,分析一笔订单的完整信息,正常需要JOIN四张表:
-- 没有宽表时:每次查询都要写这么多JOIN
SELECT
    o.order_id,
    o.order_amount,
    u.user_name,
    u.city,
    u.user_level,
    p.product_name,
    p.category,
    p.brand,
    c.channel_name,
    c.channel_type
FROM fact_order o
LEFT JOIN dim_user u ON o.user_id = u.user_id
LEFT JOIN dim_product p ON o.product_id = p.product_id
LEFT JOIN dim_channel c ON o.channel_id = c.channel_id
WHERE o.dt = '2025-01-15';
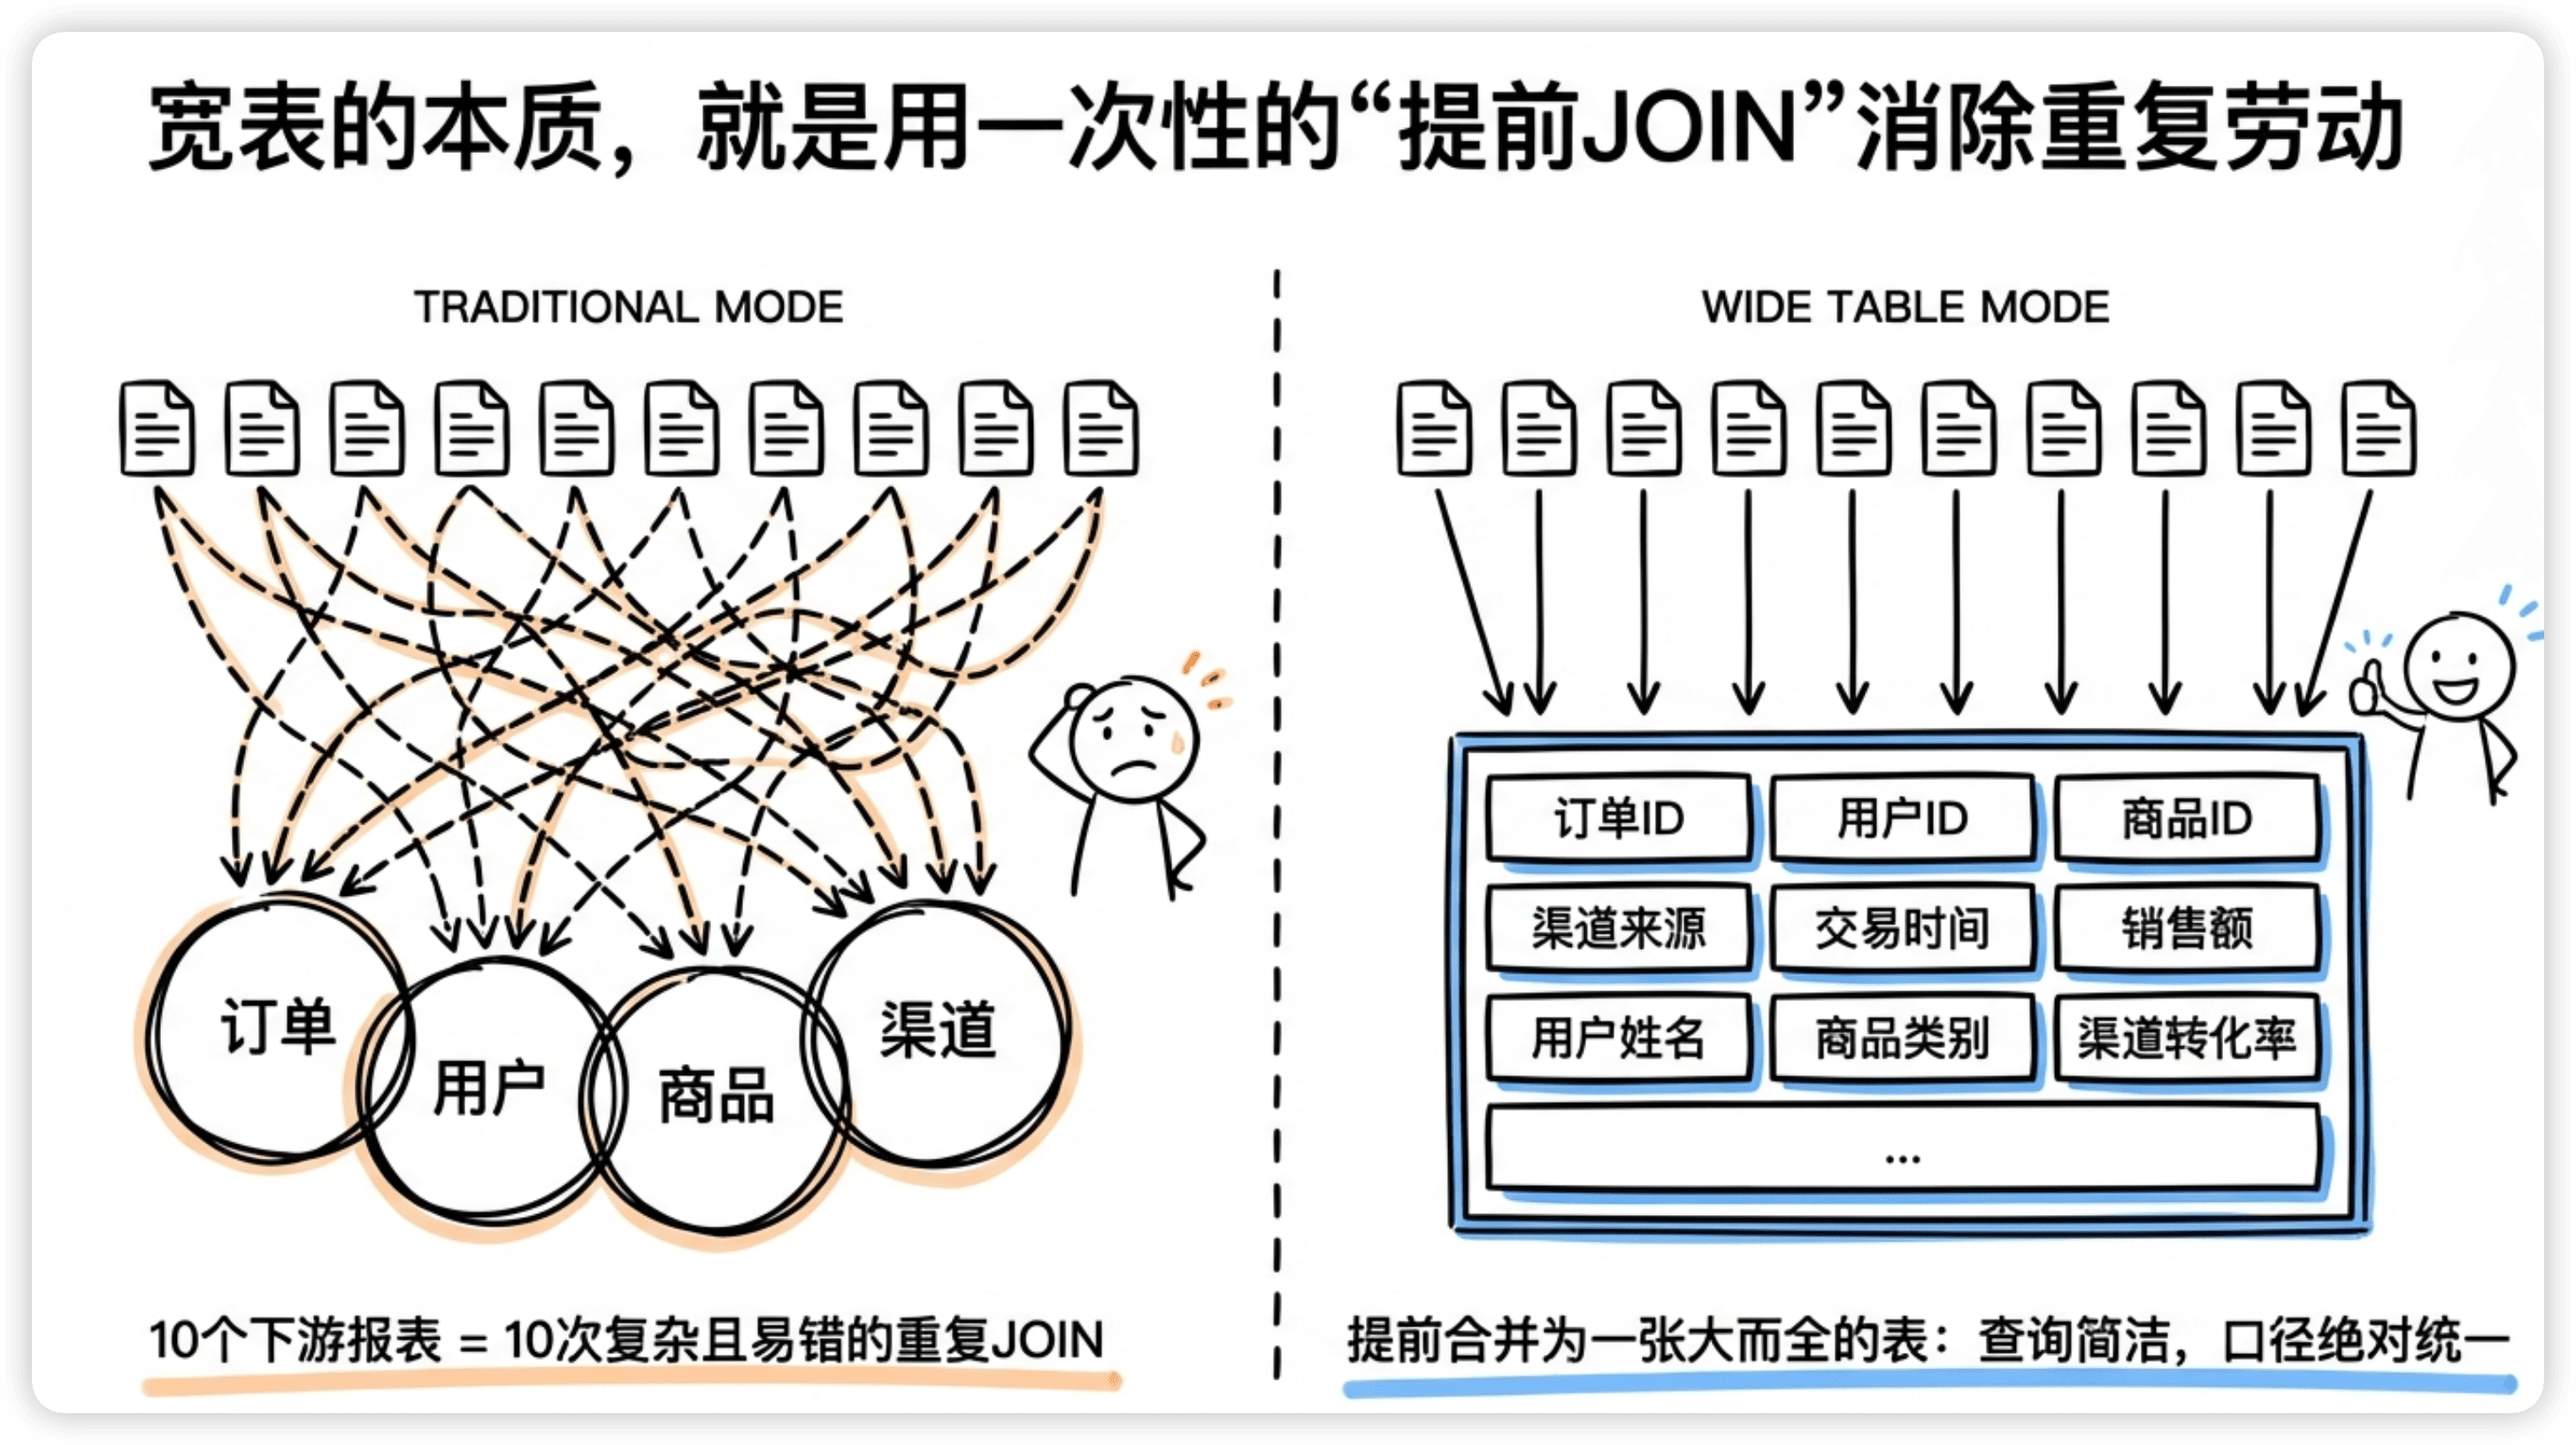
如果下游有10个报表都要查订单+用户+商品+渠道信息,每个报表都得写一遍上面这段JOIN——重复、低效、还容易写错。
建宽表就是把这些JOIN提前做好,结果存成一张大表:
-- 宽表:所有字段在一张表里,下游直接查
CREATE TABLE dws_order_wide AS
SELECT
    o.order_id,
    o.order_amount,
    o.pay_amount,
    o.order_time,
    -- 用户维度
    u.user_name,
    u.city,
    u.province,
    u.user_level,
    u.register_channel,
    -- 商品维度
    p.product_name,
    p.category,
    p.sub_category,
    p.brand,
    p.unit_price,
    -- 渠道维度
    c.channel_name,
    c.channel_type,
    -- 分区
    o.dt
FROM fact_order o
LEFT JOIN dim_user u ON o.user_id = u.user_id
LEFT JOIN dim_product p ON o.product_id = p.product_id
LEFT JOIN dim_channel c ON o.channel_id = c.channel_id;
之后下游查询变成了:
-- 有宽表后:一张表搞定,不用JOIN
SELECT city, SUM(pay_amount) AS total_pay
FROM dws_order_wide
WHERE dt = '2025-01-15'
GROUP BY city;
简洁、高效、业务方也能看懂。
宽表的利与弊
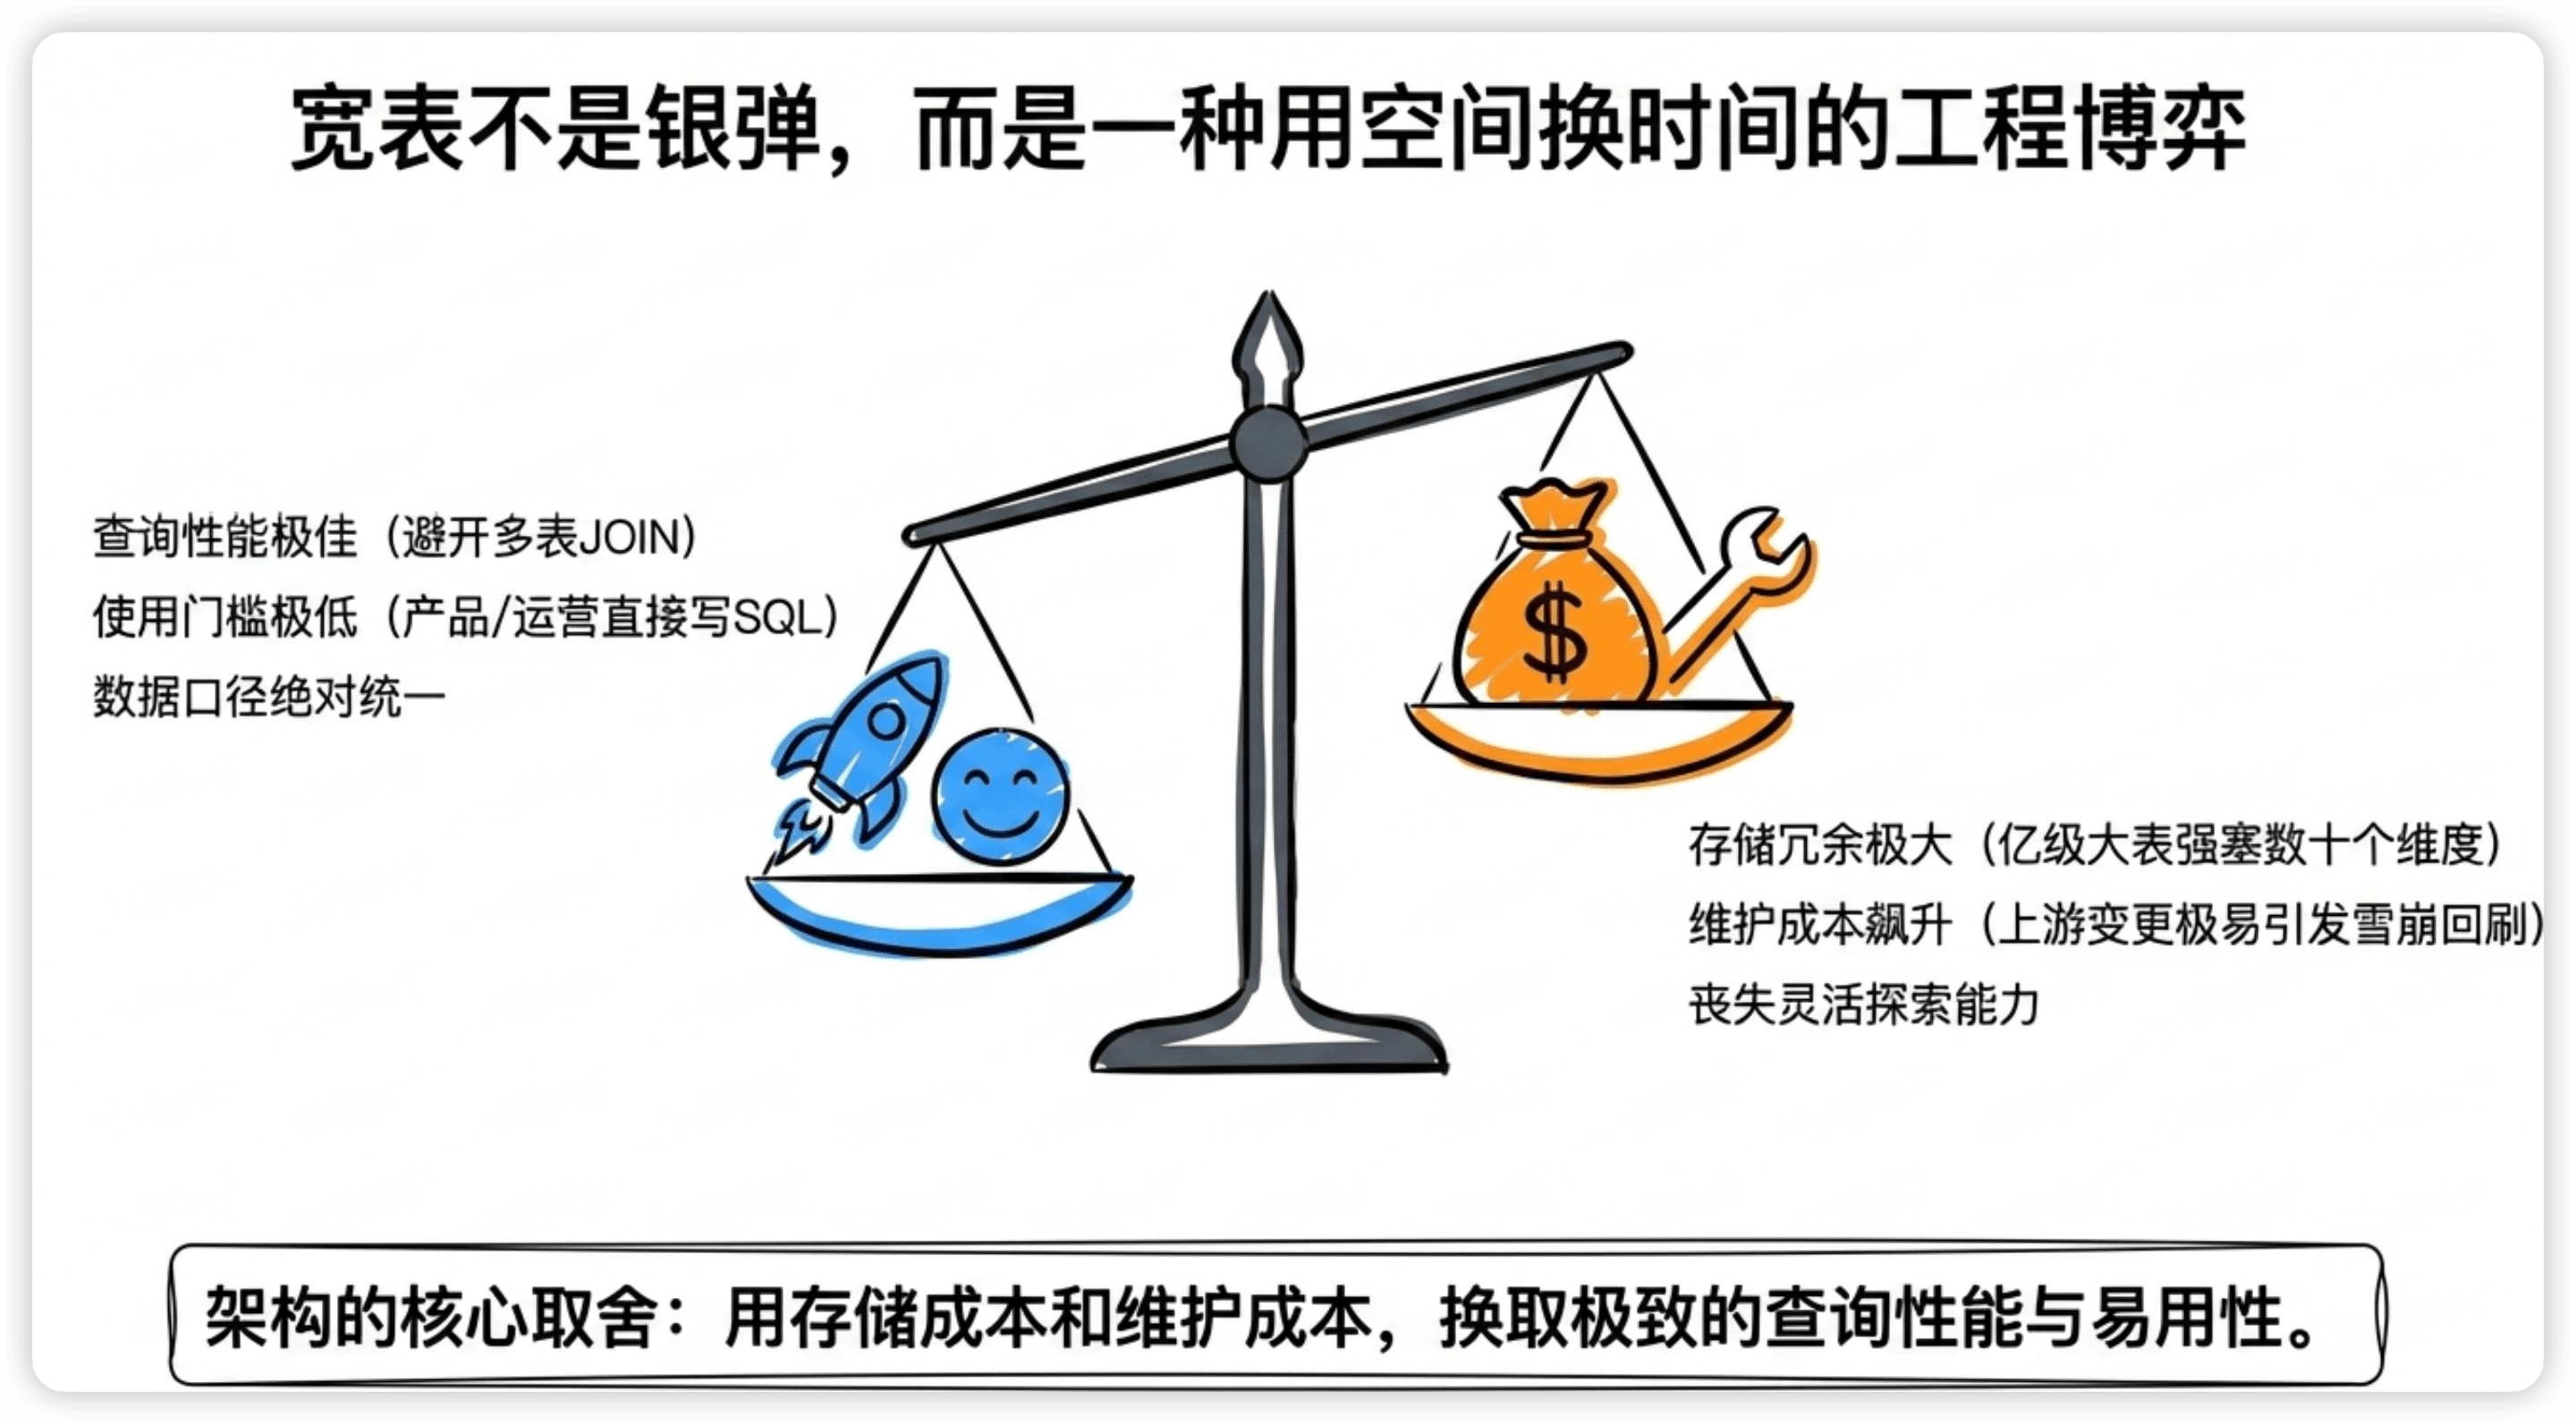
宽表不是万能的,它本质上是一种工程上的取舍。
好处
第一,查询性能好。 不需要JOIN,OLAP引擎扫描一张宽表比JOIN多张表快很多。特别是在Doris、ClickHouse这类列式存储引擎上,宽表查询的优势更明显。
第二,使用门槛低。 业务方、BI分析师不需要理解表关系就能用。产品经理写一条SELECT ... FROM dws_order_wide WHERE category = 'xxx'就能出报表,不用去研究dim_product的JOIN逻辑。
第三,口径统一。 所有下游用同一张宽表,不会出现A报表JOIN了用户表、B报表忘了JOIN的口径不一致问题。
坏处
第一,存储冗余大。 每一行订单都带着完整的用户信息和商品信息,大量数据被重复存储。如果事实表有1亿行,每行多存了50个维度字段,存储成本不可忽视。
第二,维护成本高。 上游任何一张表的结构变了,宽表就要跟着改。比如dim_user加了一个vip_expire_date字段,你要在宽表的ETL逻辑里加上这个字段,可能还要回刷历史数据。
第三,维度变化导致数据不一致。 宽表里的维度字段反映的是建表那天的值。如果用户后来从北京搬到了深圳,历史宽表里的城市还是北京。到底该不该更新历史数据?这是一个需要和业务方对齐的问题。
第四,灵活性受限。 宽表是为固定的分析场景设计的。如果业务方突然需要一个宽表里没有的字段,要么改宽表加字段(可能要回刷几十天数据),要么额外JOIN——这就违背了建宽表的初衷。
核心取舍就一句话:用存储成本和维护成本,换查询性能和使用便利性。
什么时候该建宽表?
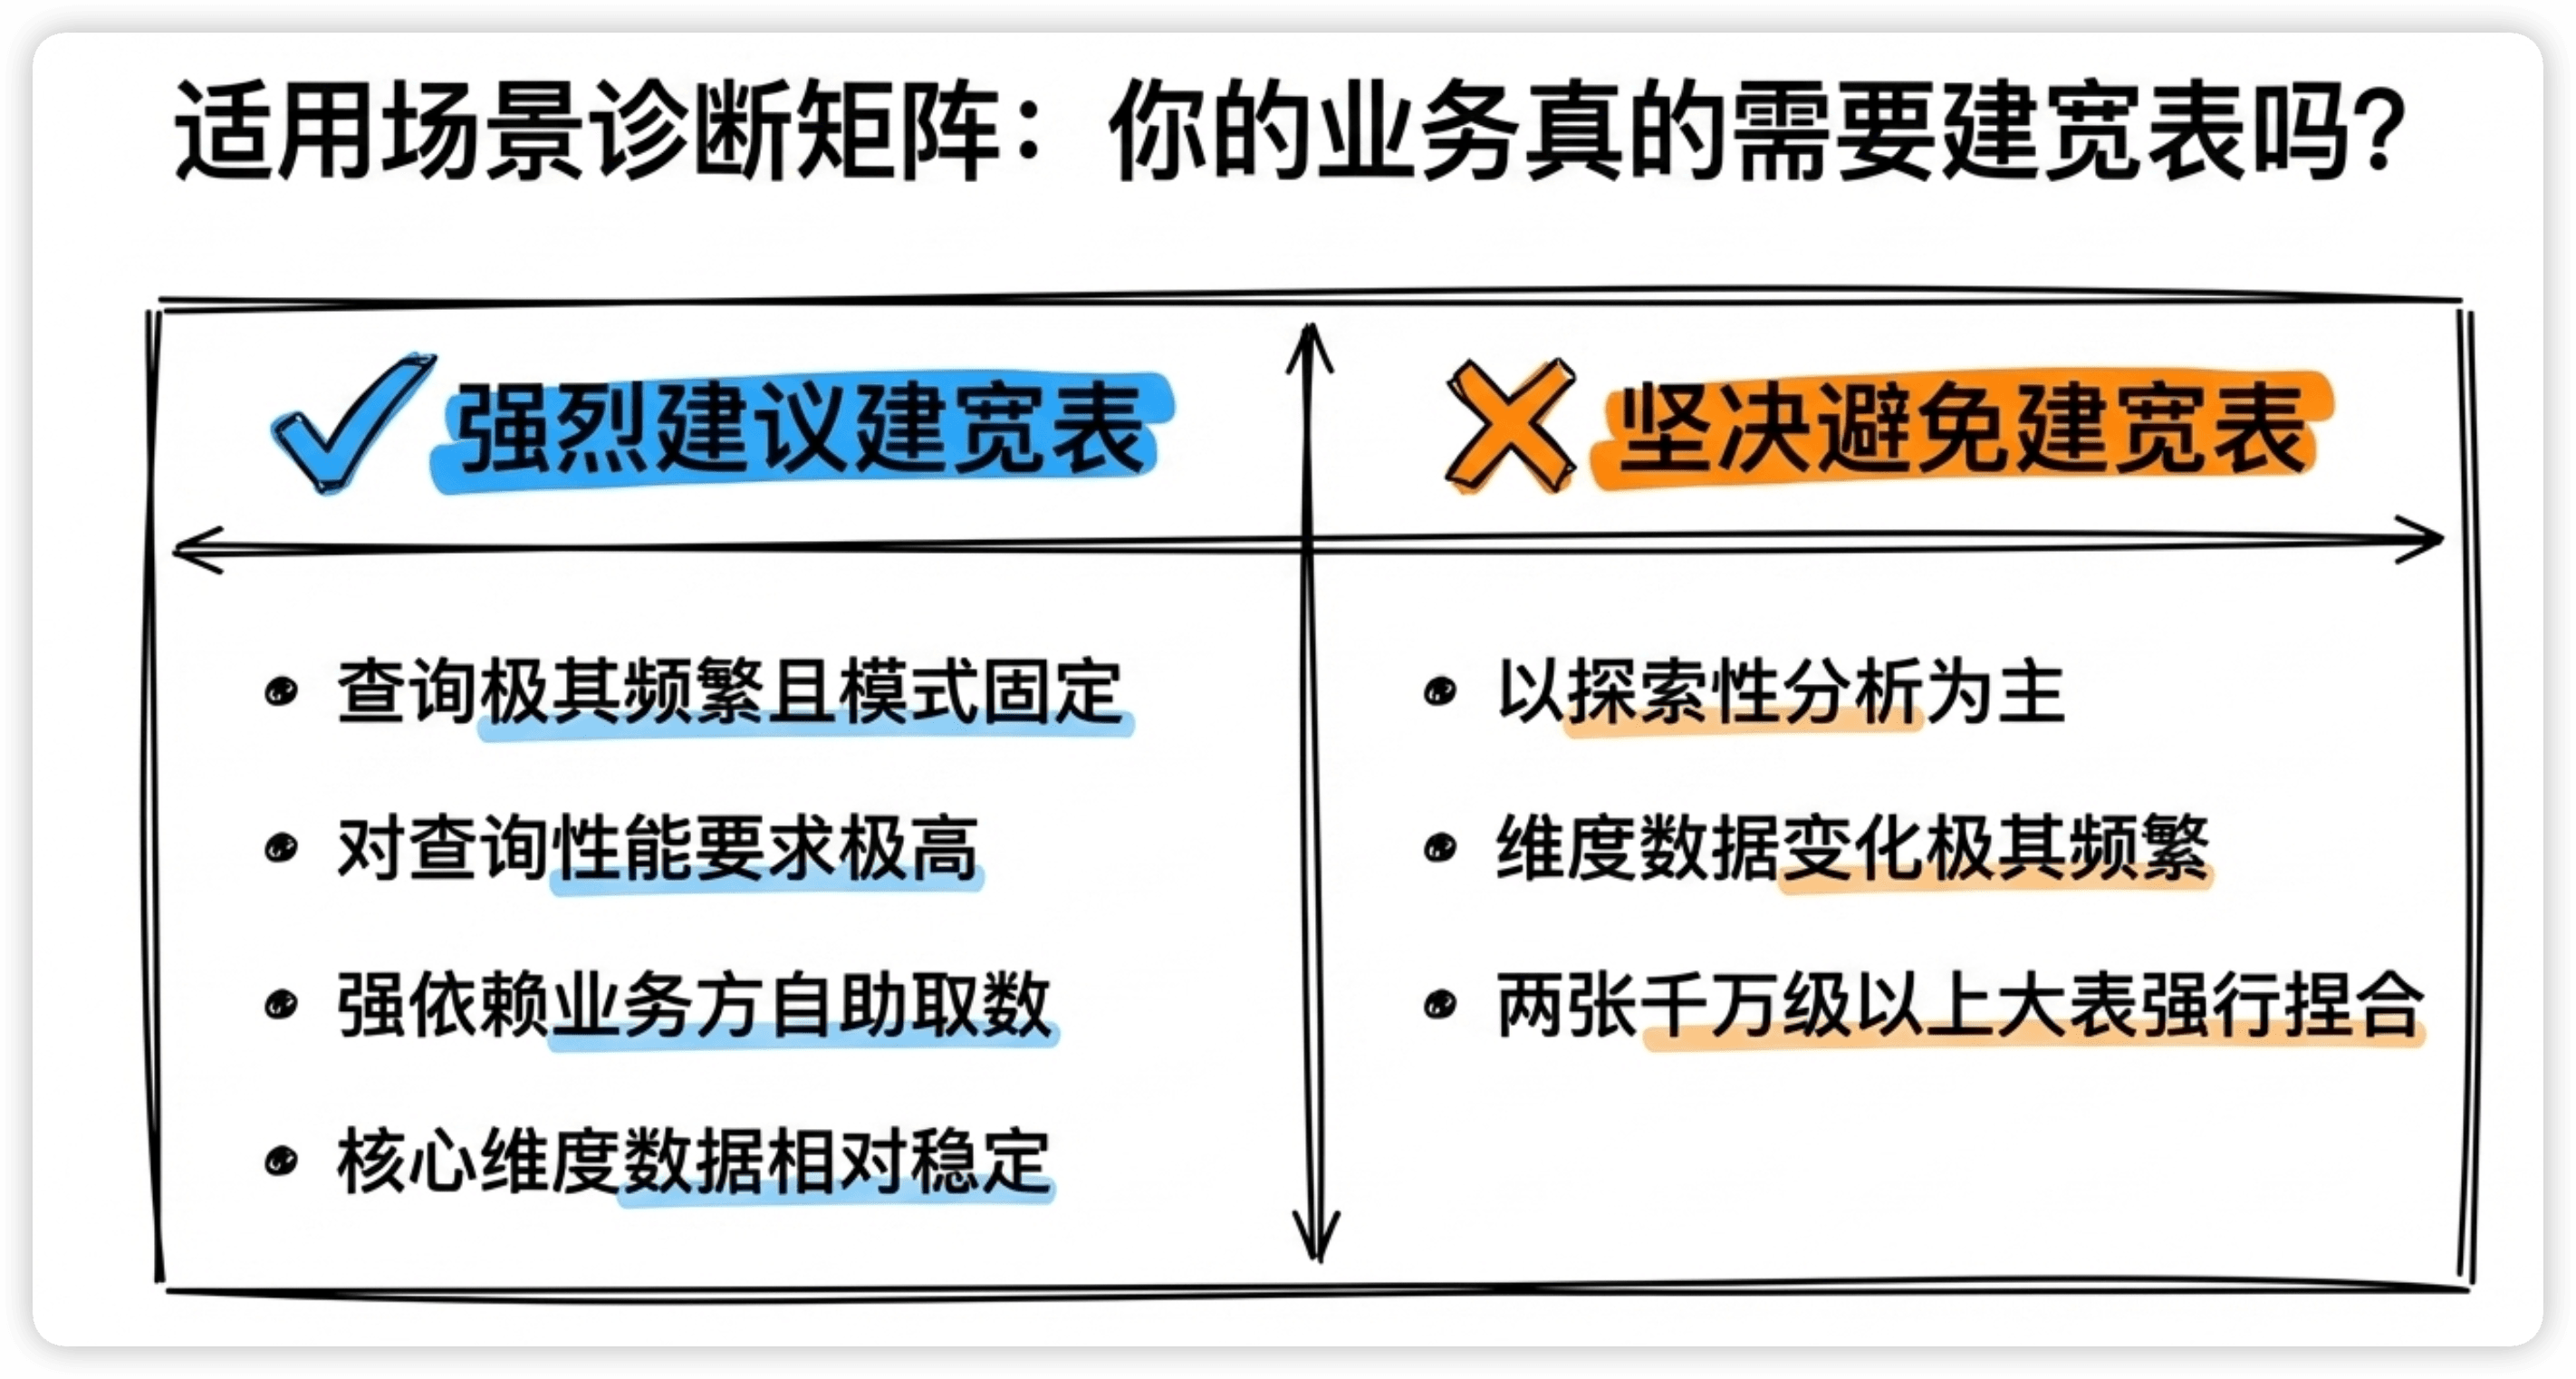
不是所有场景都适合宽表。我总结了一个判断框架:
适合建宽表的场景
- 下游查询频繁且模式固定:每天有10个报表都在查"订单+用户+商品",而且查的字段基本一样
- 查询性能要求高:秒级响应的实时大屏、在线报表,JOIN多张表来不及
- 业务方直接使用:产品经理、运营自己写SQL查数,降低使用门槛比节省存储更重要
- 维度相对稳定:用户维度表的结构不会三天两头改
不适合建宽表的场景
- 维度变化频繁:比如商品价格一天改好几次,宽表里的价格字段很快就过时了
- 分析需求不稳定:今天要加3个字段,明天要去掉2个字段,宽表反复修改成本很高
- 两张大表做宽表:如果事实表1亿行,维度表也500万行,做宽表后存储成本爆炸
- 探索性分析为主:数据分析师自己在做探索性分析,需求变化很大,用星型模型按需JOIN更灵活
我的经验
DWS层适合建主题宽表,DWD层尽量保持范式化。
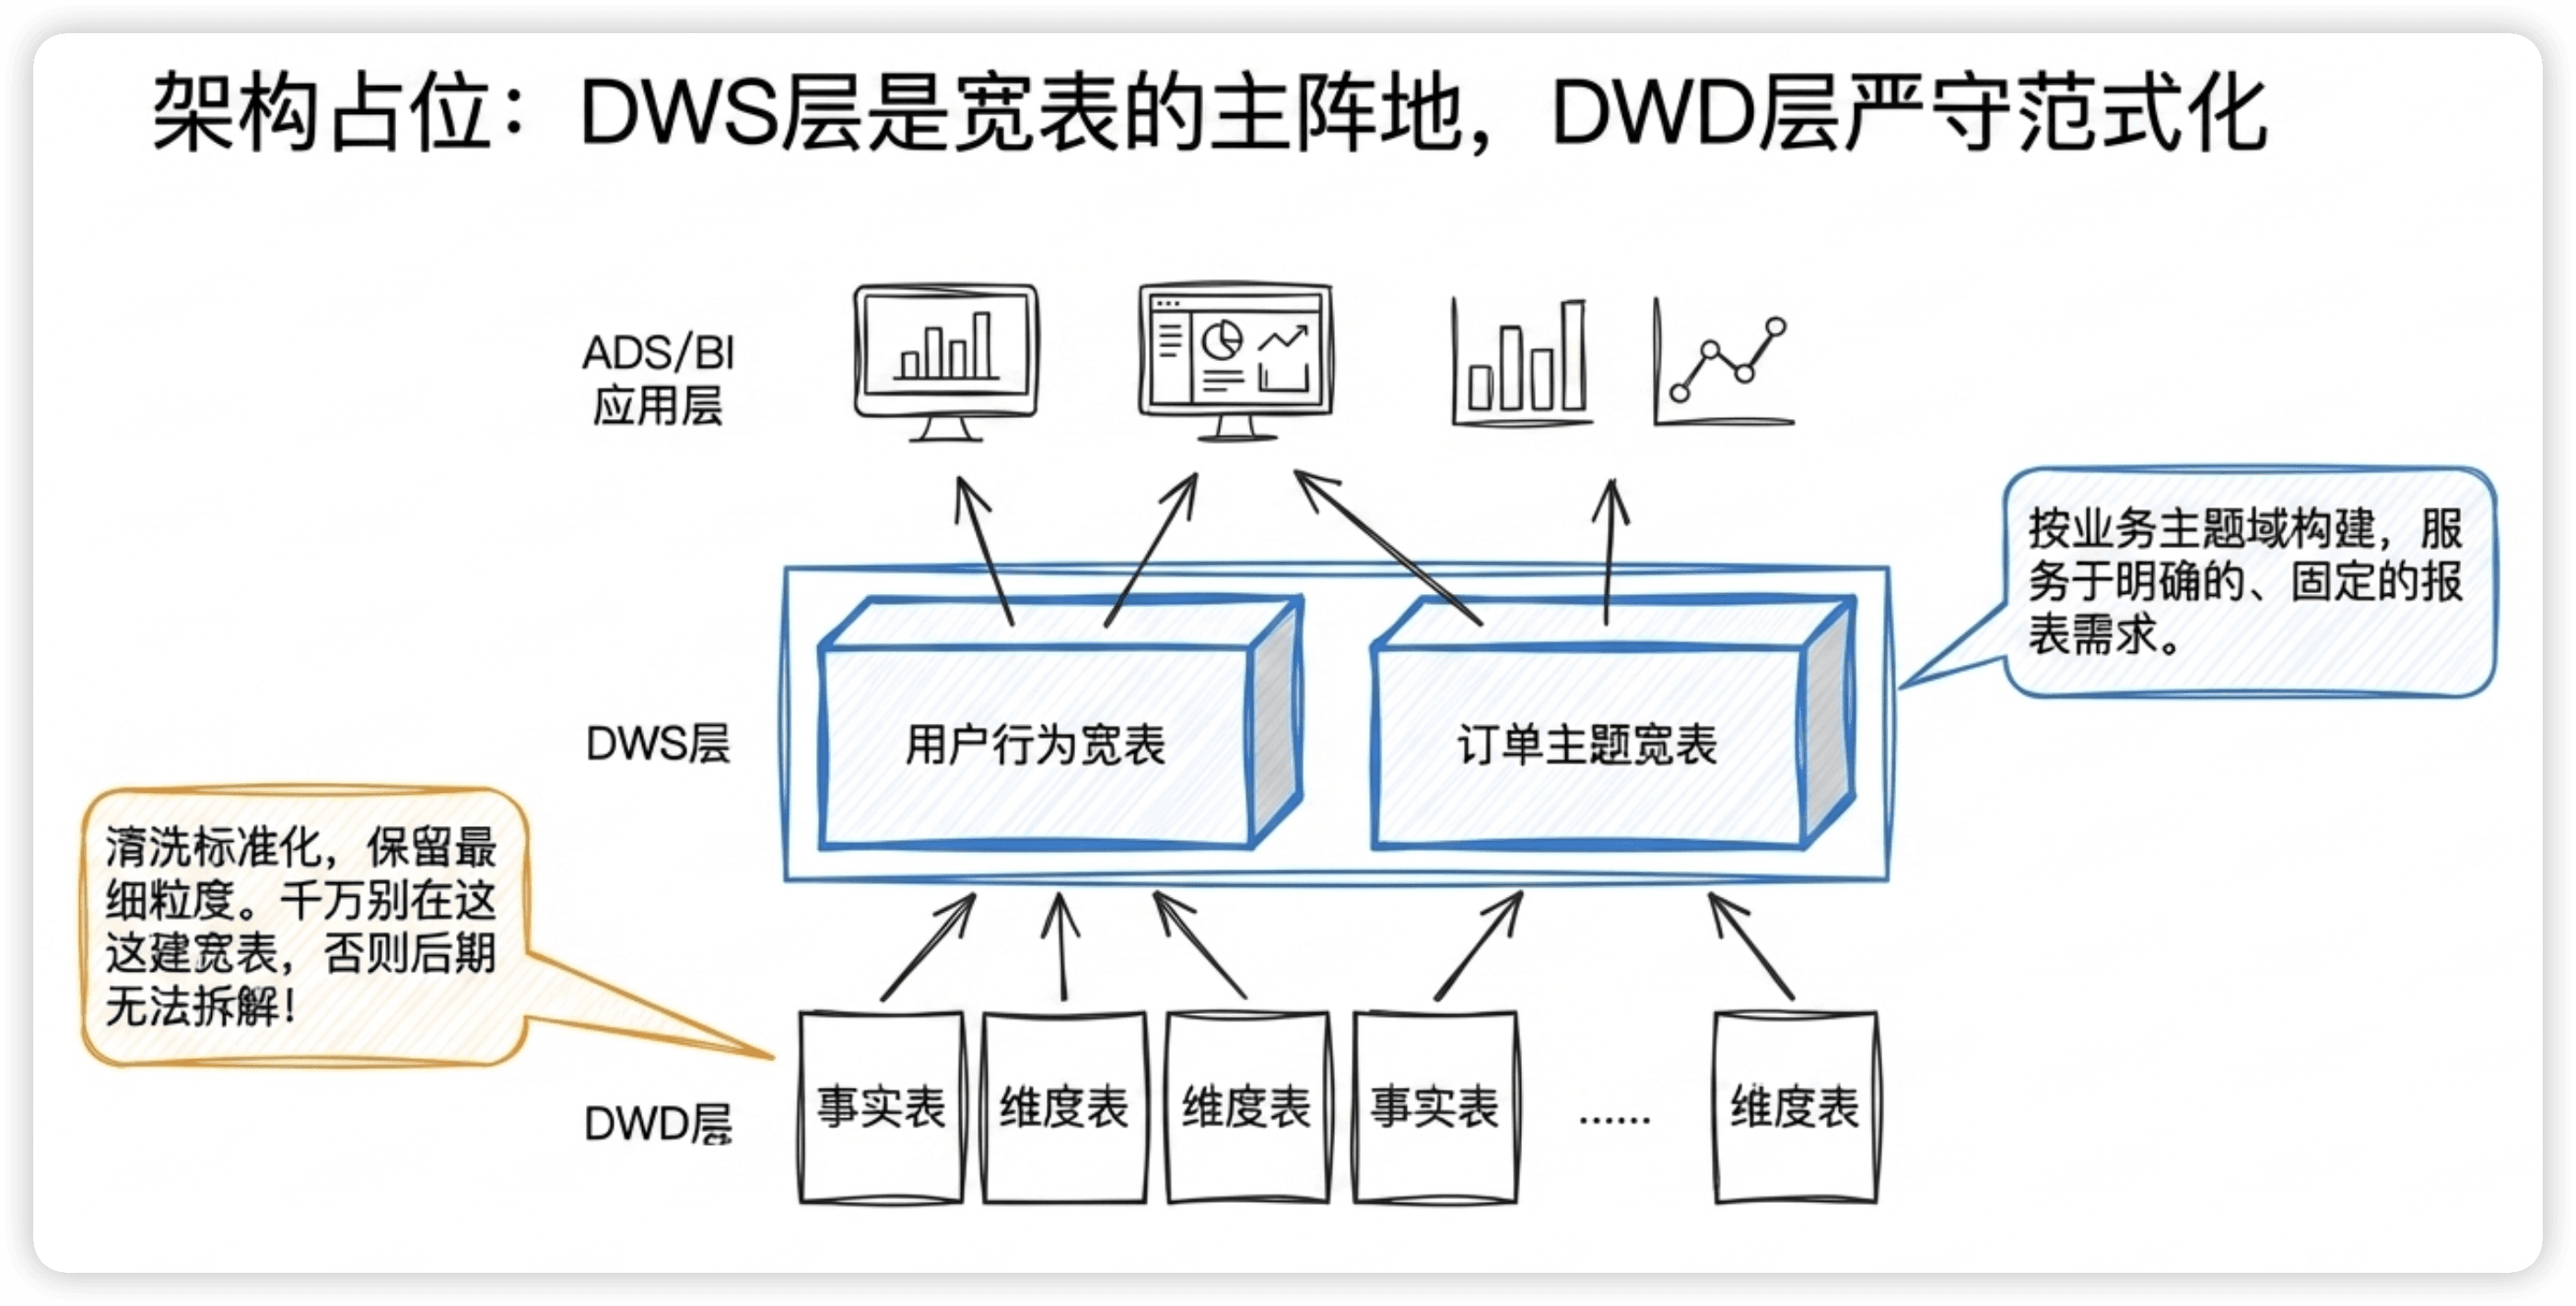
DWD层的职责是清洗和标准化,保留明细粒度和灵活性。如果DWD层就做成了宽表,后面再想拆解就很难了。
宽表放在DWS层,按业务主题来建——用户行为宽表、订单宽表、广告投放宽表——每张宽表服务一类固定报表需求。探索性分析不适合用宽表,还是应该用DWD层的规范事实表+维度表按需JOIN。
宽表设计的实战原则
原则一:粒度单一,不要混
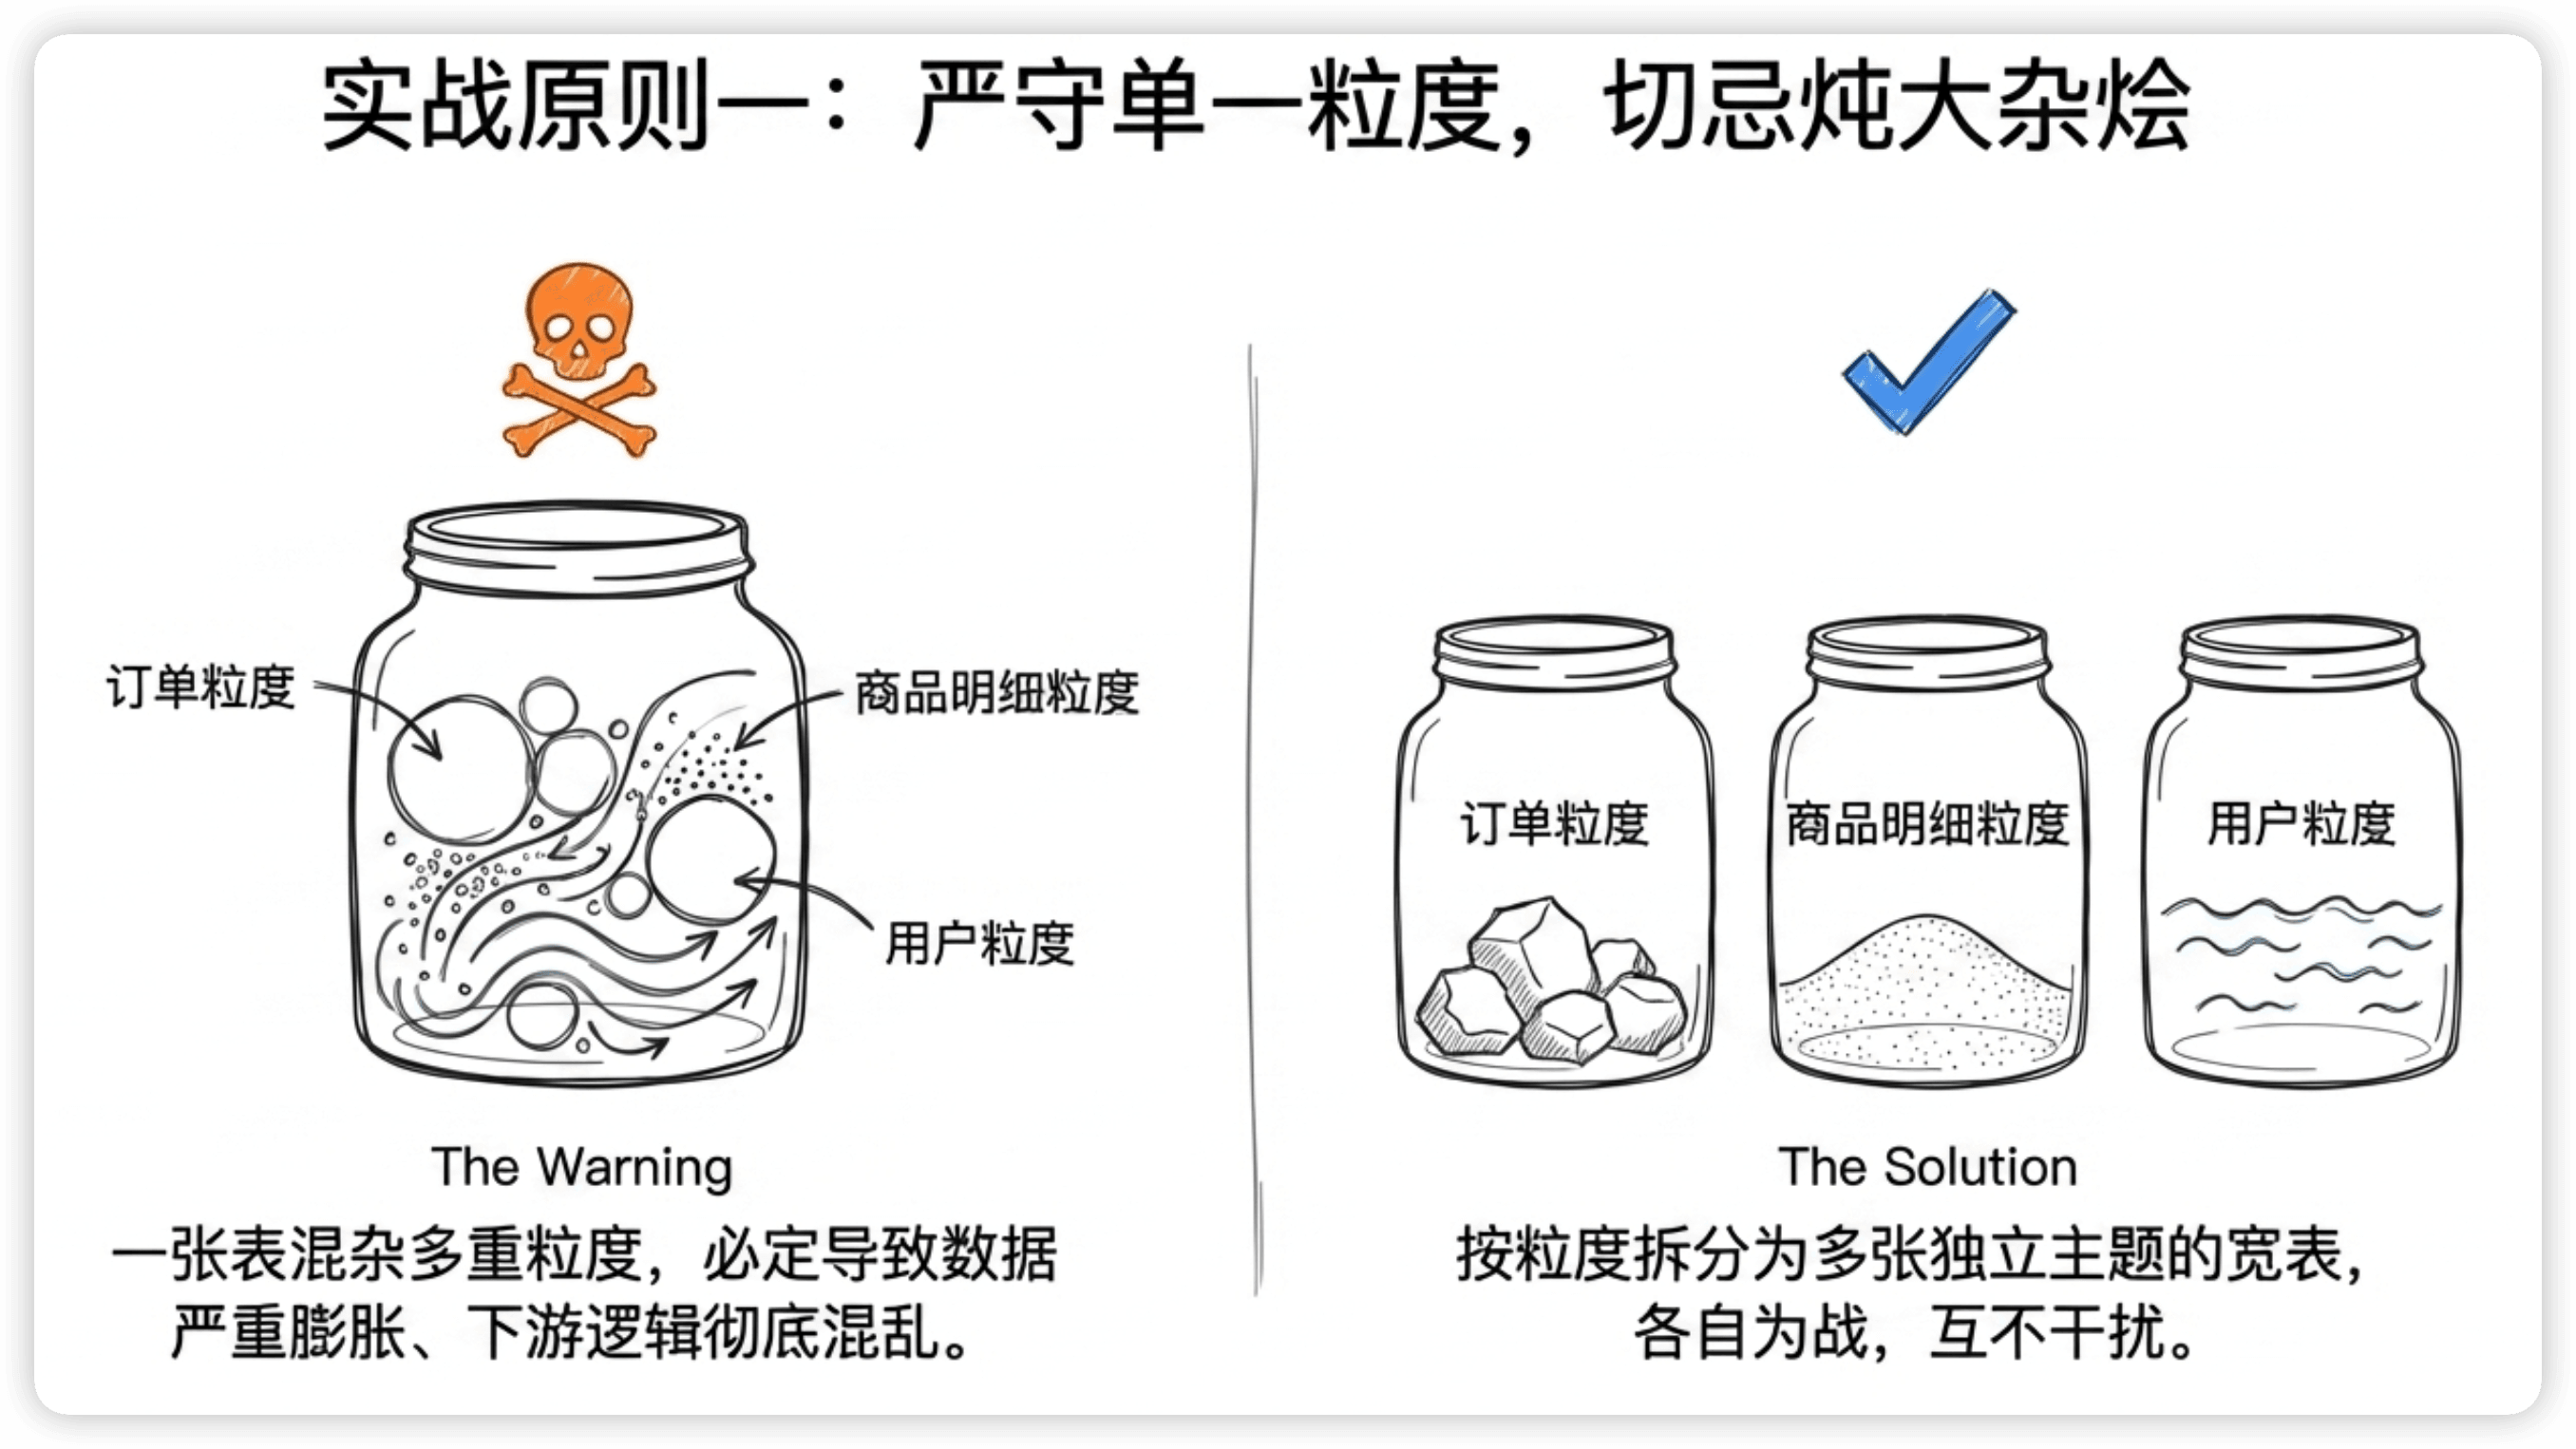
一张宽表只能有一个粒度。这是最容易犯的错误。
❌ 错误示范:订单粒度和用户粒度混在一起

dws_order_user_wide
├── order_id           -- 订单粒度
├── order_amount       -- 订单粒度
├── user_total_orders  -- 用户粒度(这个用户的累计订单数)
├── user_avg_amount    -- 用户粒度(这个用户的平均客单价)
└── ...

问题:user_total_orders在每一行订单里都一样,存储浪费
更大的问题:如果按这张表SUM(order_amount),拿到的是订单维度的总和
但如果AVG(user_avg_amount),拿到的是什么?是"所有订单中出现的用户平均客单价的平均值"
——大概率不是你想要的数字
正确做法:拆成两张宽表,各管各的粒度。
✅ 正确示范:

dws_order_wide      -- 粒度:一笔订单
├── order_id, order_amount, user_name, city, product_name, ...

dws_user_wide       -- 粒度:一个用户
├── user_id, total_orders, avg_amount, last_order_date, ...
原则二:控制字段数量
宽表不是越宽越好。
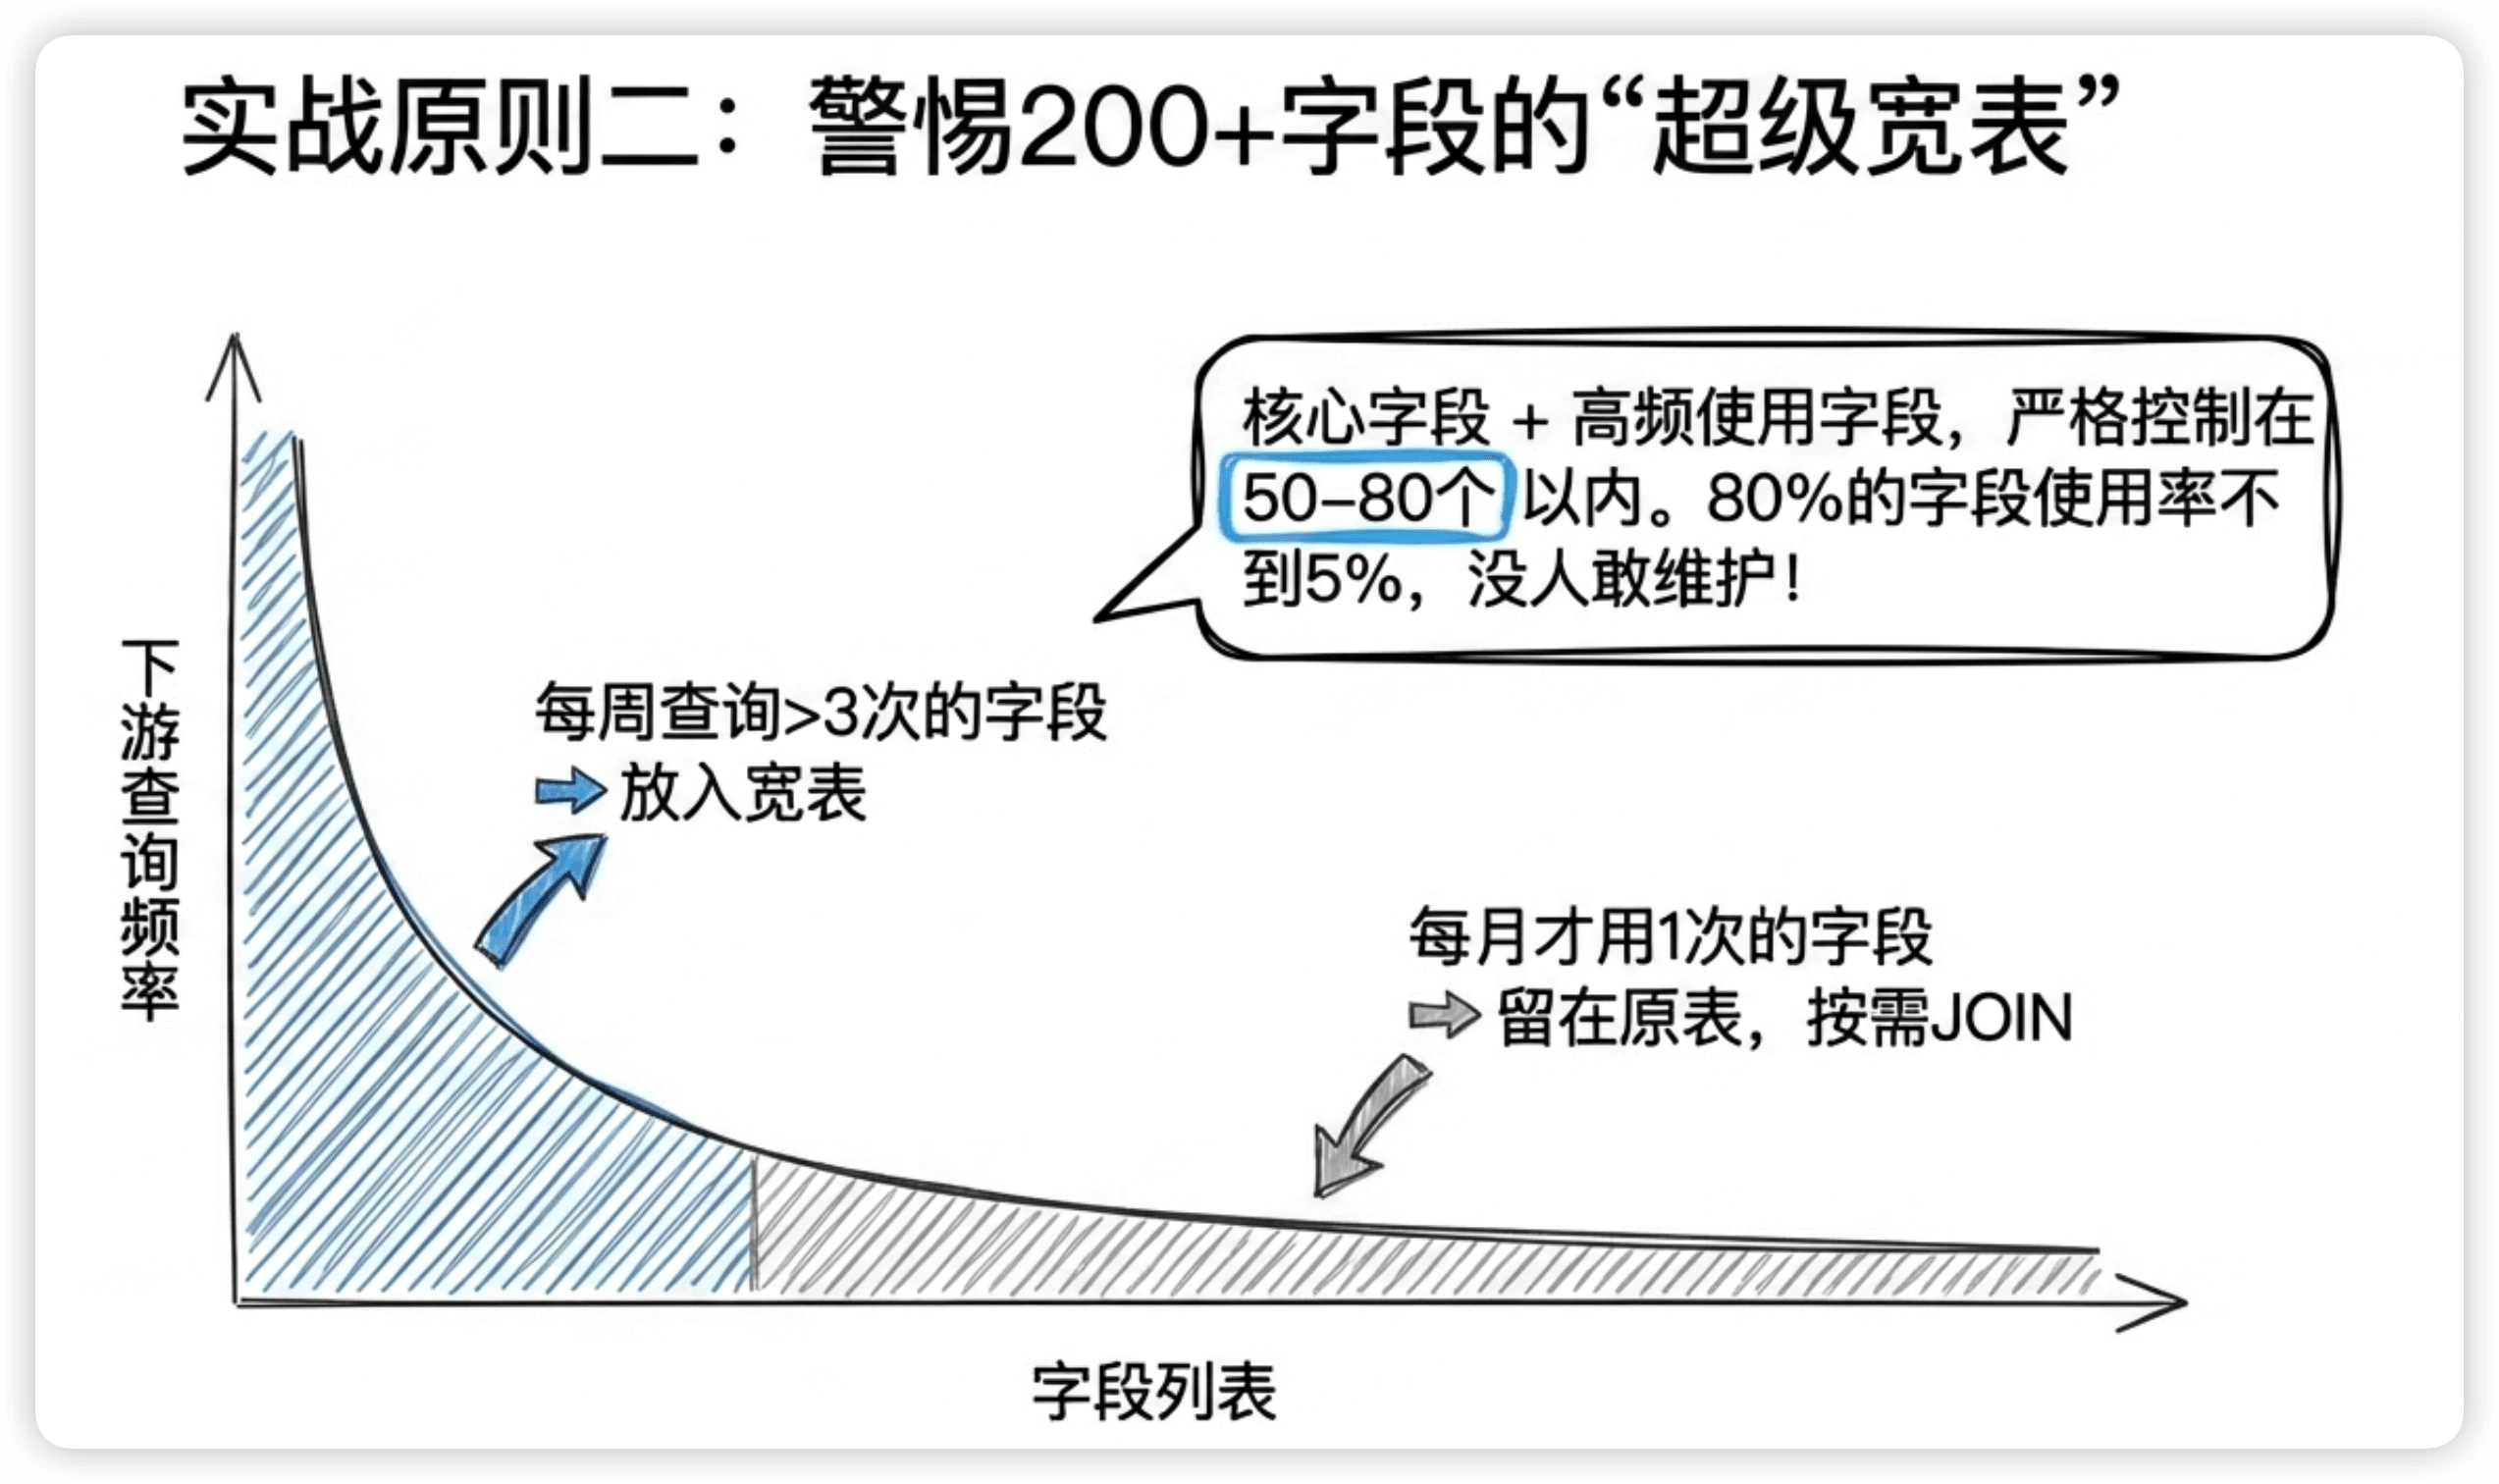
我见过一张200多个字段的"超级宽表"——各种维度信息、衍生指标、标签全往里塞。结果呢?80%的字段使用率不到5%,ETL逻辑复杂到没人敢动,每次加减字段都提心吊胆。
我的建议:核心字段 + 高频使用字段,控制在50-80个字段以内。
怎么判断一个字段该不该进宽表?看它的查询频率。如果一个字段每周被下游查询超过3次,就放进宽表;如果一个月才用一次,保留在原表里,用的时候再JOIN。
可以定期跑一下下游查询的字段使用统计,数据说话:
-- 分析宽表各字段的使用频率(从查询日志中统计)
-- 使用率低于5%的字段考虑移除
SELECT
    column_name,
    COUNT(*) AS query_count,
    COUNT(*) * 100.0 / total_queries AS usage_rate
FROM query_column_usage_log
WHERE table_name = 'dws_order_wide'
  AND dt >= DATE_SUB(CURRENT_DATE, 30)
GROUP BY column_name
ORDER BY query_count DESC;
原则三:处理好维度变化
宽表里的维度字段,用的是JOIN那天的维度值。如果用户后来改了城市,历史宽表里的城市不会自动更新。
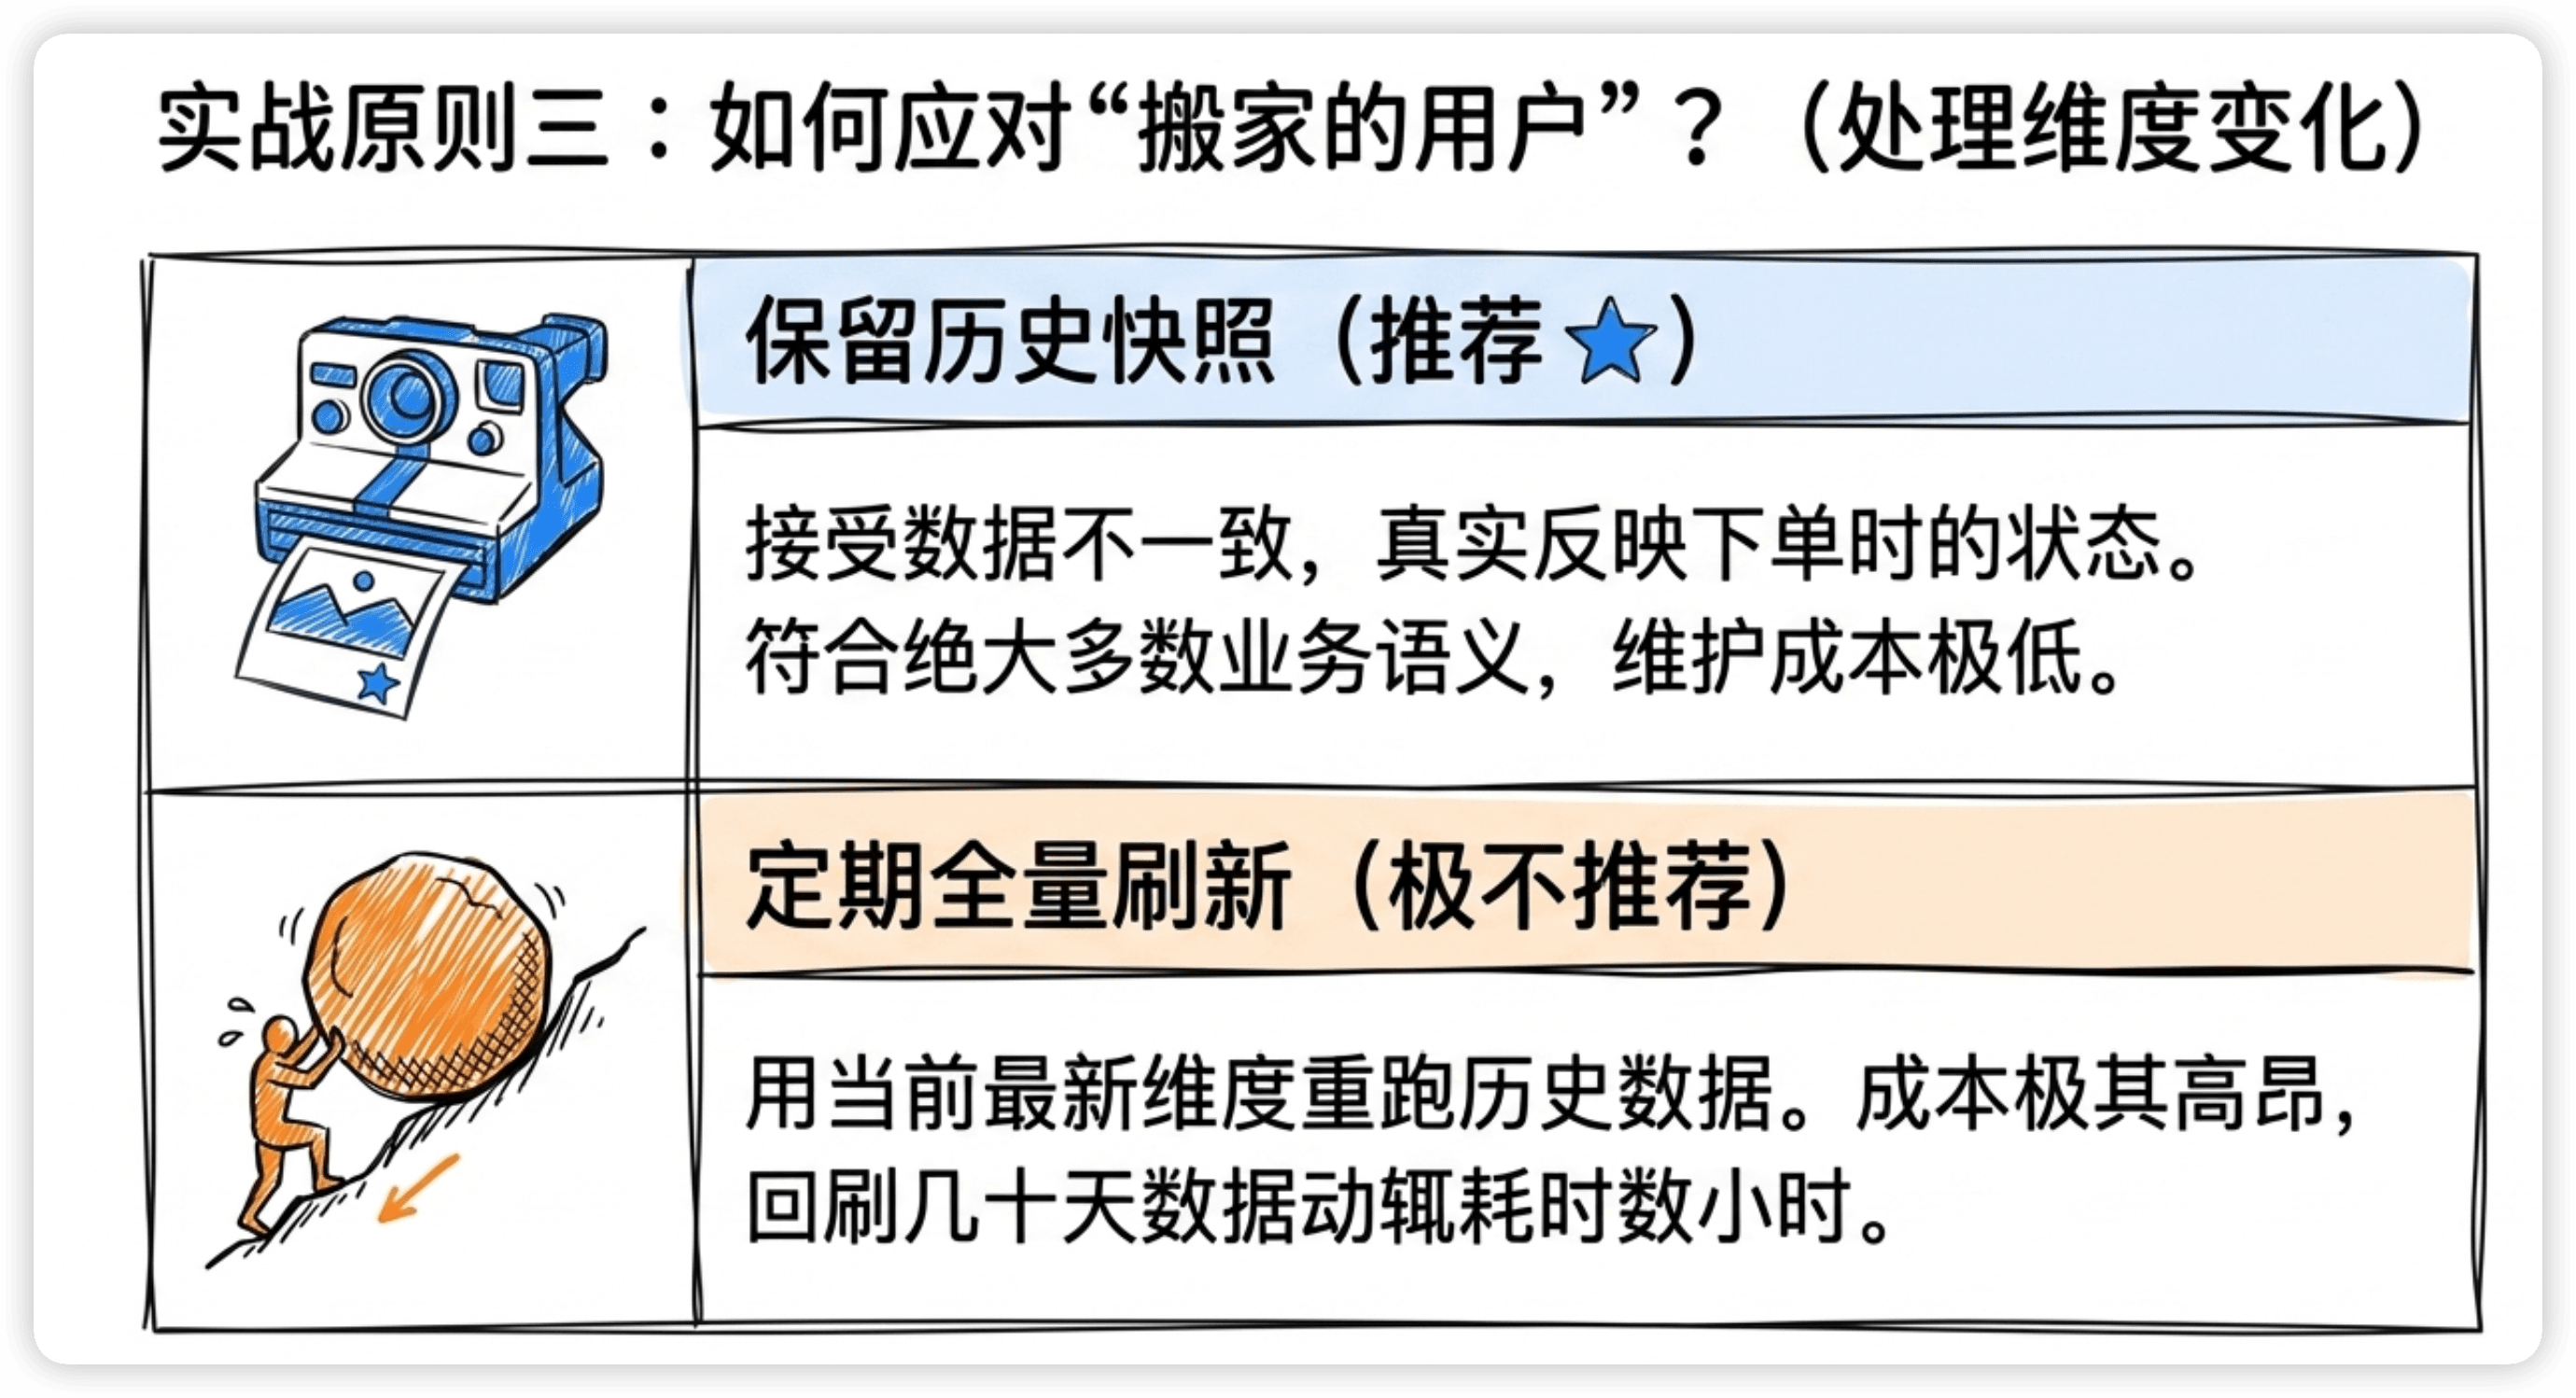
两种策略:
策略一:接受不一致,历史数据反映当时的状态。
这是最常用的做法,也是我推荐的方案。大多数分析场景关心的是"下单时用户在哪个城市",而不是"用户现在在哪个城市"。保留历史状态反而是正确的业务语义。
策略二:定期刷新,用当前维度值重跑历史宽表。
适用于业务方确实需要"按当前状态看历史数据"的场景。但成本高——每次维度变化都要回刷历史分区。我们曾经因为产品调整了商品分类,需要用新分类重跑过去30天的宽表,跑了4个多小时。
这件事后来促使我们做了一个优化,也就是下面要说的原则四。
原则四:主表 + 副表拆分
这个优化方案来自我们的一次真实踩坑。
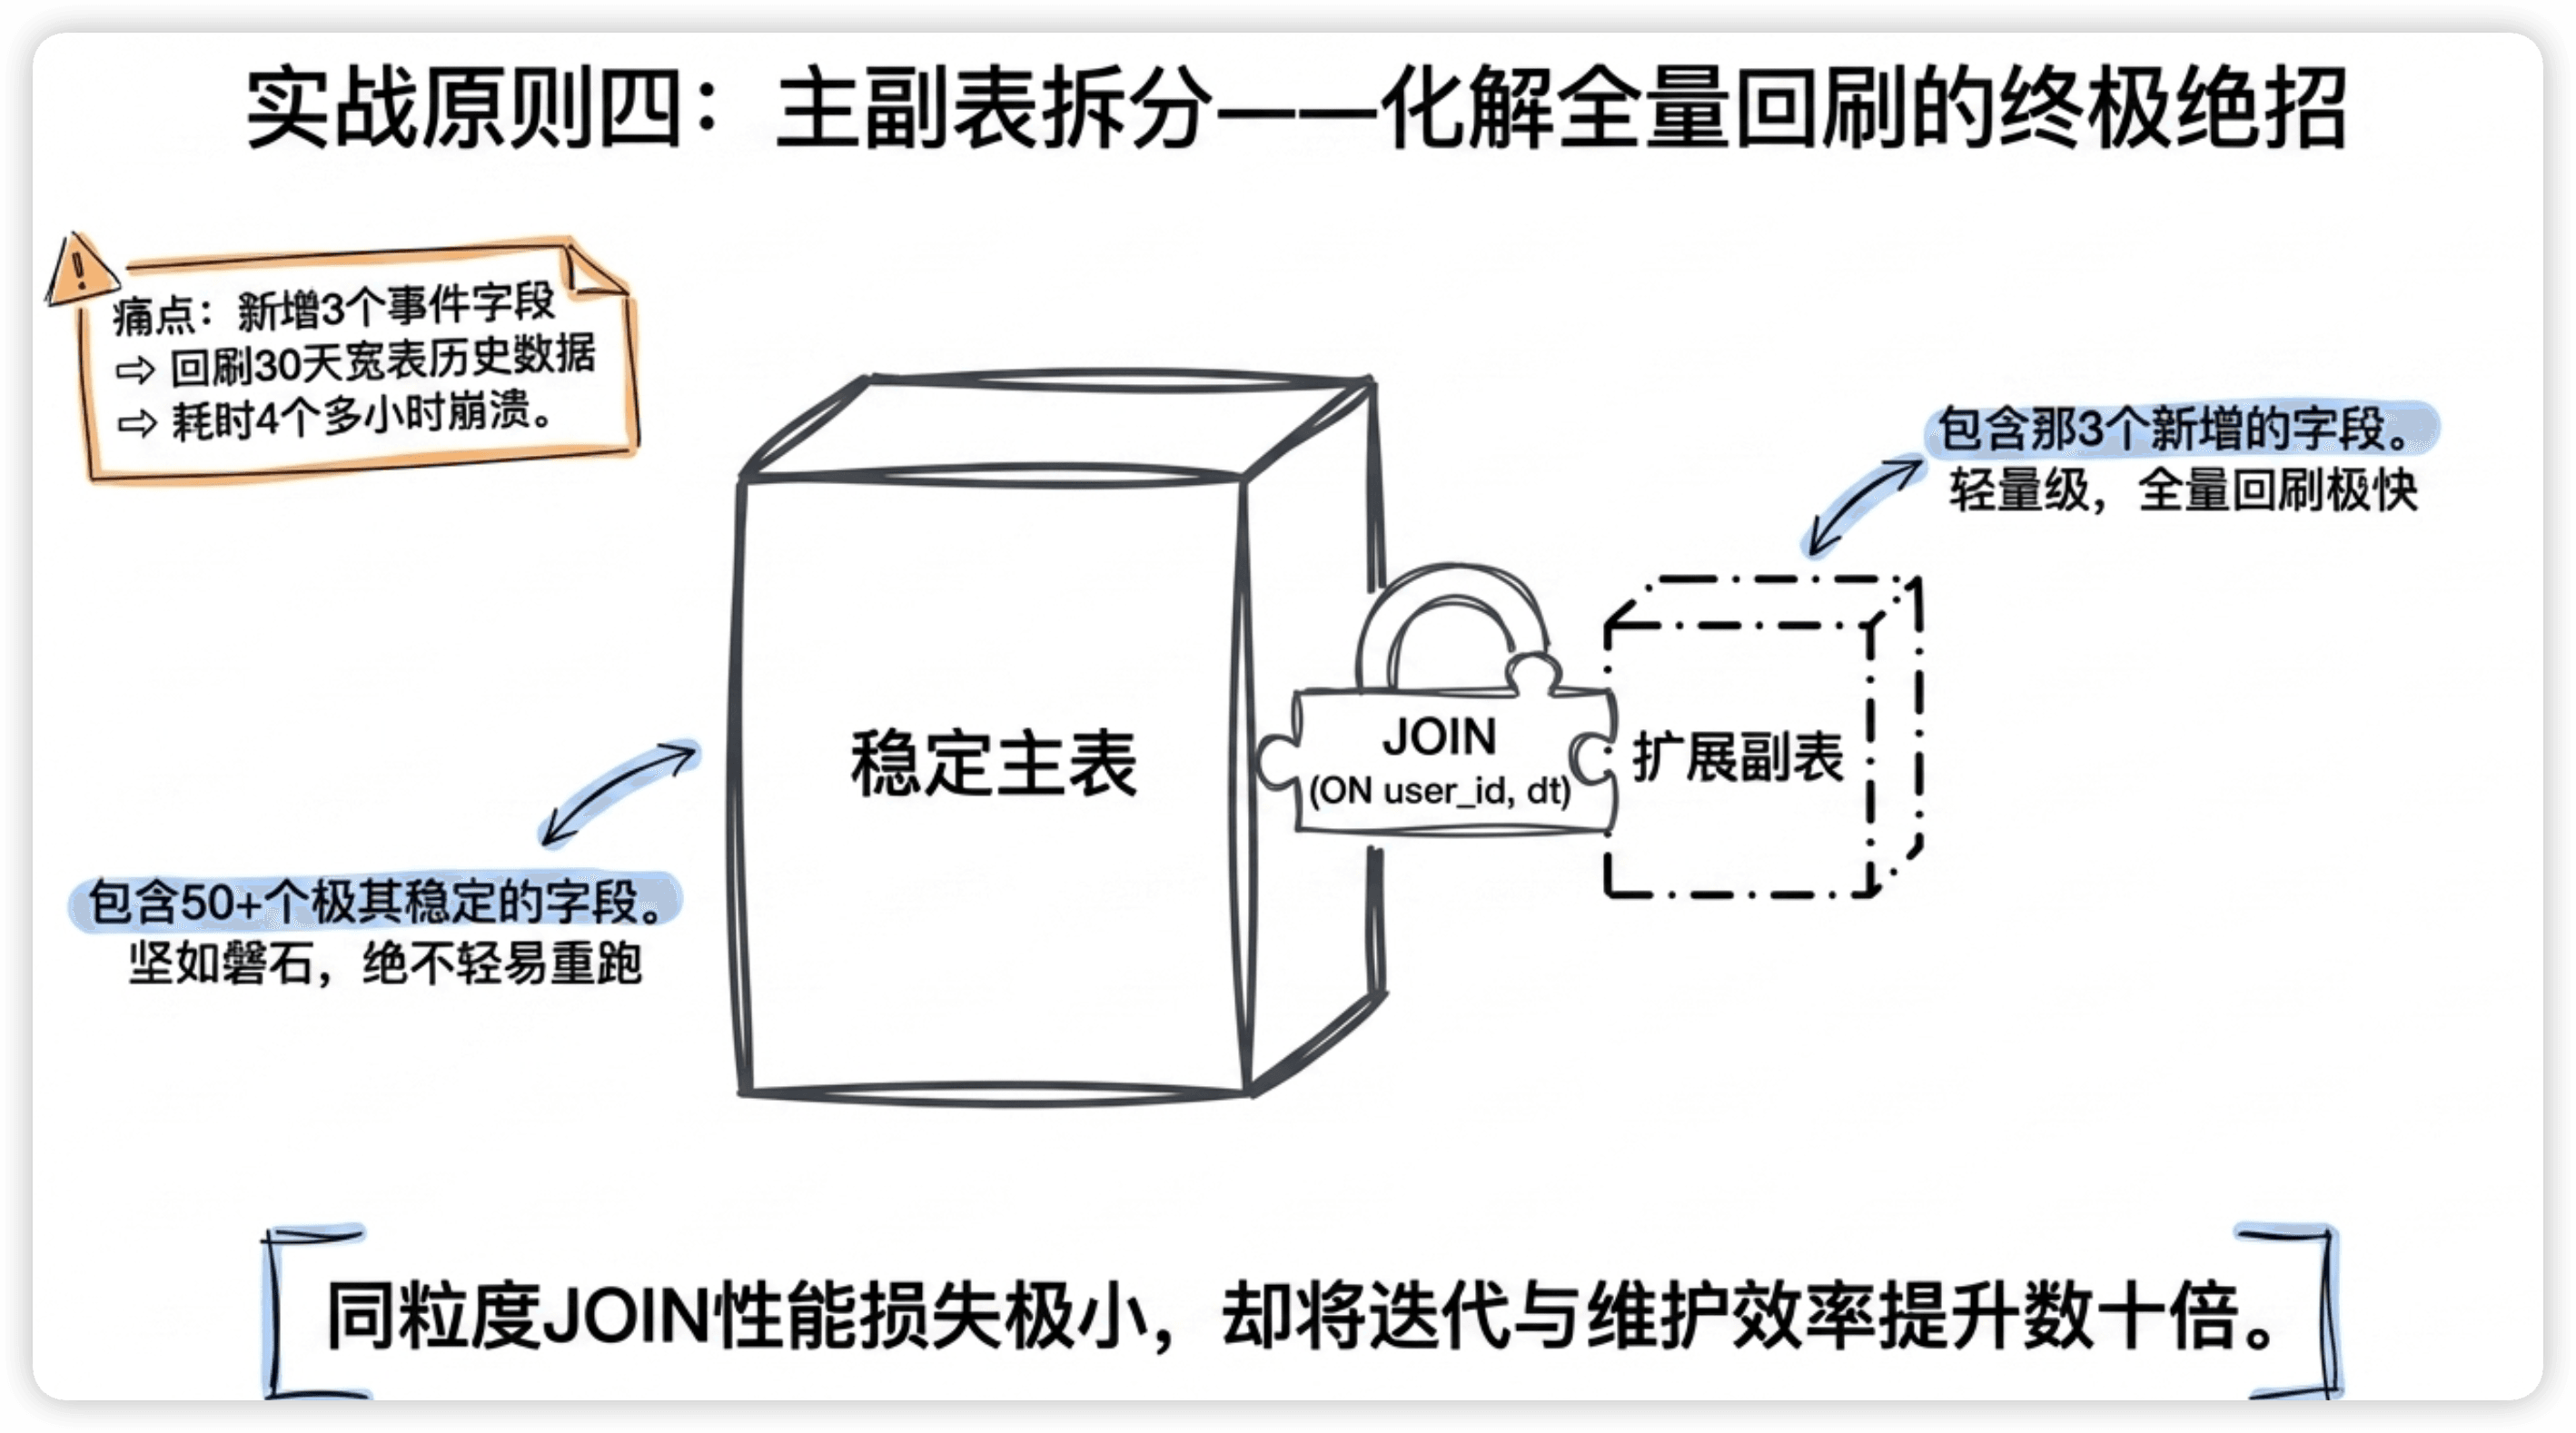
问题:产品新增了一个行为事件,需要在用户行为宽表里加3个字段。但宽表已经有60多个字段,加字段意味着回刷30天历史数据(因为新字段要从DWD层重新聚合),跑了4个多小时。
解决方案:把宽表拆成"主表"和"副表"。
dws_user_behavior_wide_stable   -- 主表:稳定字段(不常变的字段)
├── user_id
├── dt
├── session_cnt
├── click_cnt
├── play_cnt
├── total_play_sec
├── ... (30多个稳定指标)

dws_user_behavior_wide_extend   -- 副表:扩展字段(新增需求放这里)
├── user_id
├── dt
├── new_event_cnt                -- 新增的事件指标
├── feature_x_usage              -- 新功能使用指标
├── ... (随需求增长)
下游查询时JOIN一下就行:
SELECT s.*, e.new_event_cnt, e.feature_x_usage
FROM dws_user_behavior_wide_stable s
LEFT JOIN dws_user_behavior_wide_extend e
  ON s.user_id = e.user_id AND s.dt = e.dt
WHERE s.dt = '2025-01-15';
好处是:新增需求放副表,主表不用重跑。副表数据量小、字段少,回刷速度也快。虽然查询多了一次JOIN,但因为是同粒度JOIN(user_id + dt),性能损失很小。
面试怎么答?
低分回答
「宽表就是把多张表JOIN到一起。优点是查询快,缺点是存储大。」
面试官内心OS:这谁都知道。
高分回答
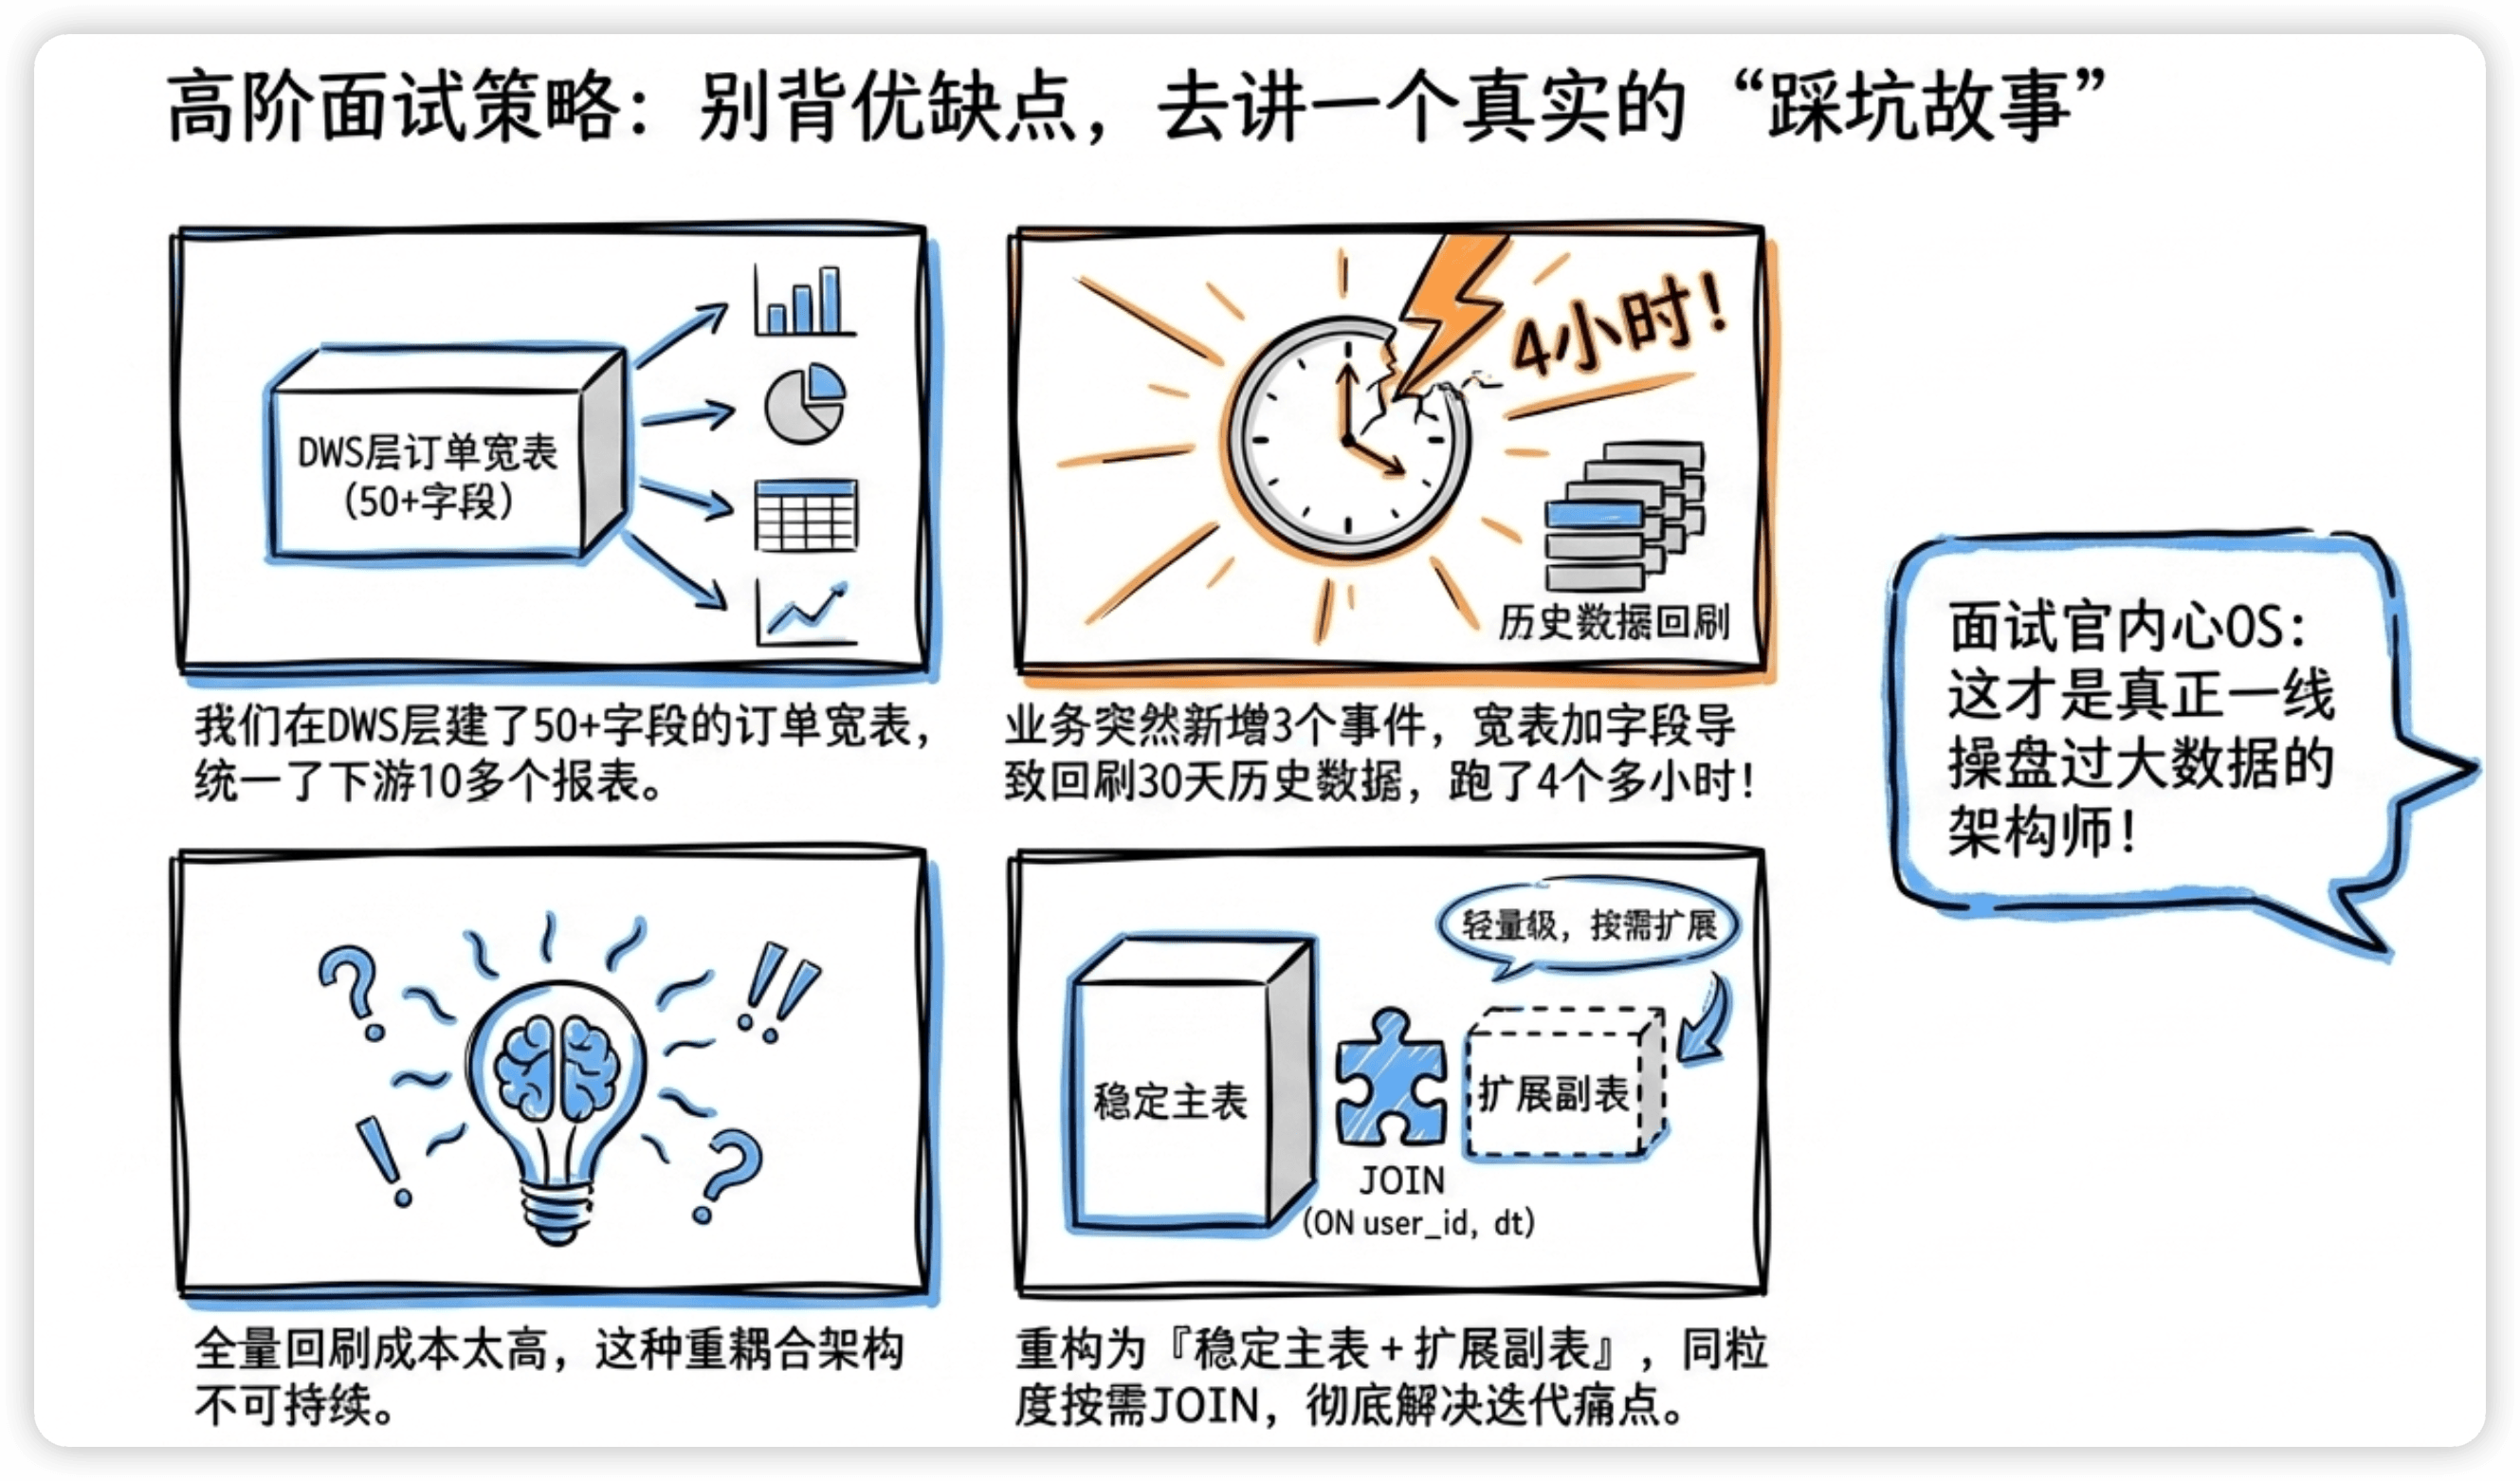
「我们DWS层有主题宽表,比如订单宽表大概50多个字段,把用户维度、商品维度、渠道维度都JOIN进去了。好处是下游10多个报表直接查宽表,不用每次写JOIN,口径也统一。坏处是维护成本高——之前产品加了一个新的行为事件,需要在宽表里新增3个字段,但历史数据要回刷30天,跑了4个多小时。后来我们做了优化,把宽表拆成了稳定主表和扩展副表,新增字段放副表,主表不用动,回刷成本降了很多。」
「我们的原则是DWS层建宽表服务固定报表,DWD层保持范式化保留灵活性。宽表的字段控制在50-80个,低频使用的字段不往里塞,需要时再JOIN。」
这个回答好在哪里?它不是在列优缺点,而是在讲一个完整的故事——遇到了什么问题、怎么分析的、怎么解决的。面试官一听就知道你是真做过的。
追问防线
追问1:宽表和物化视图有什么区别?
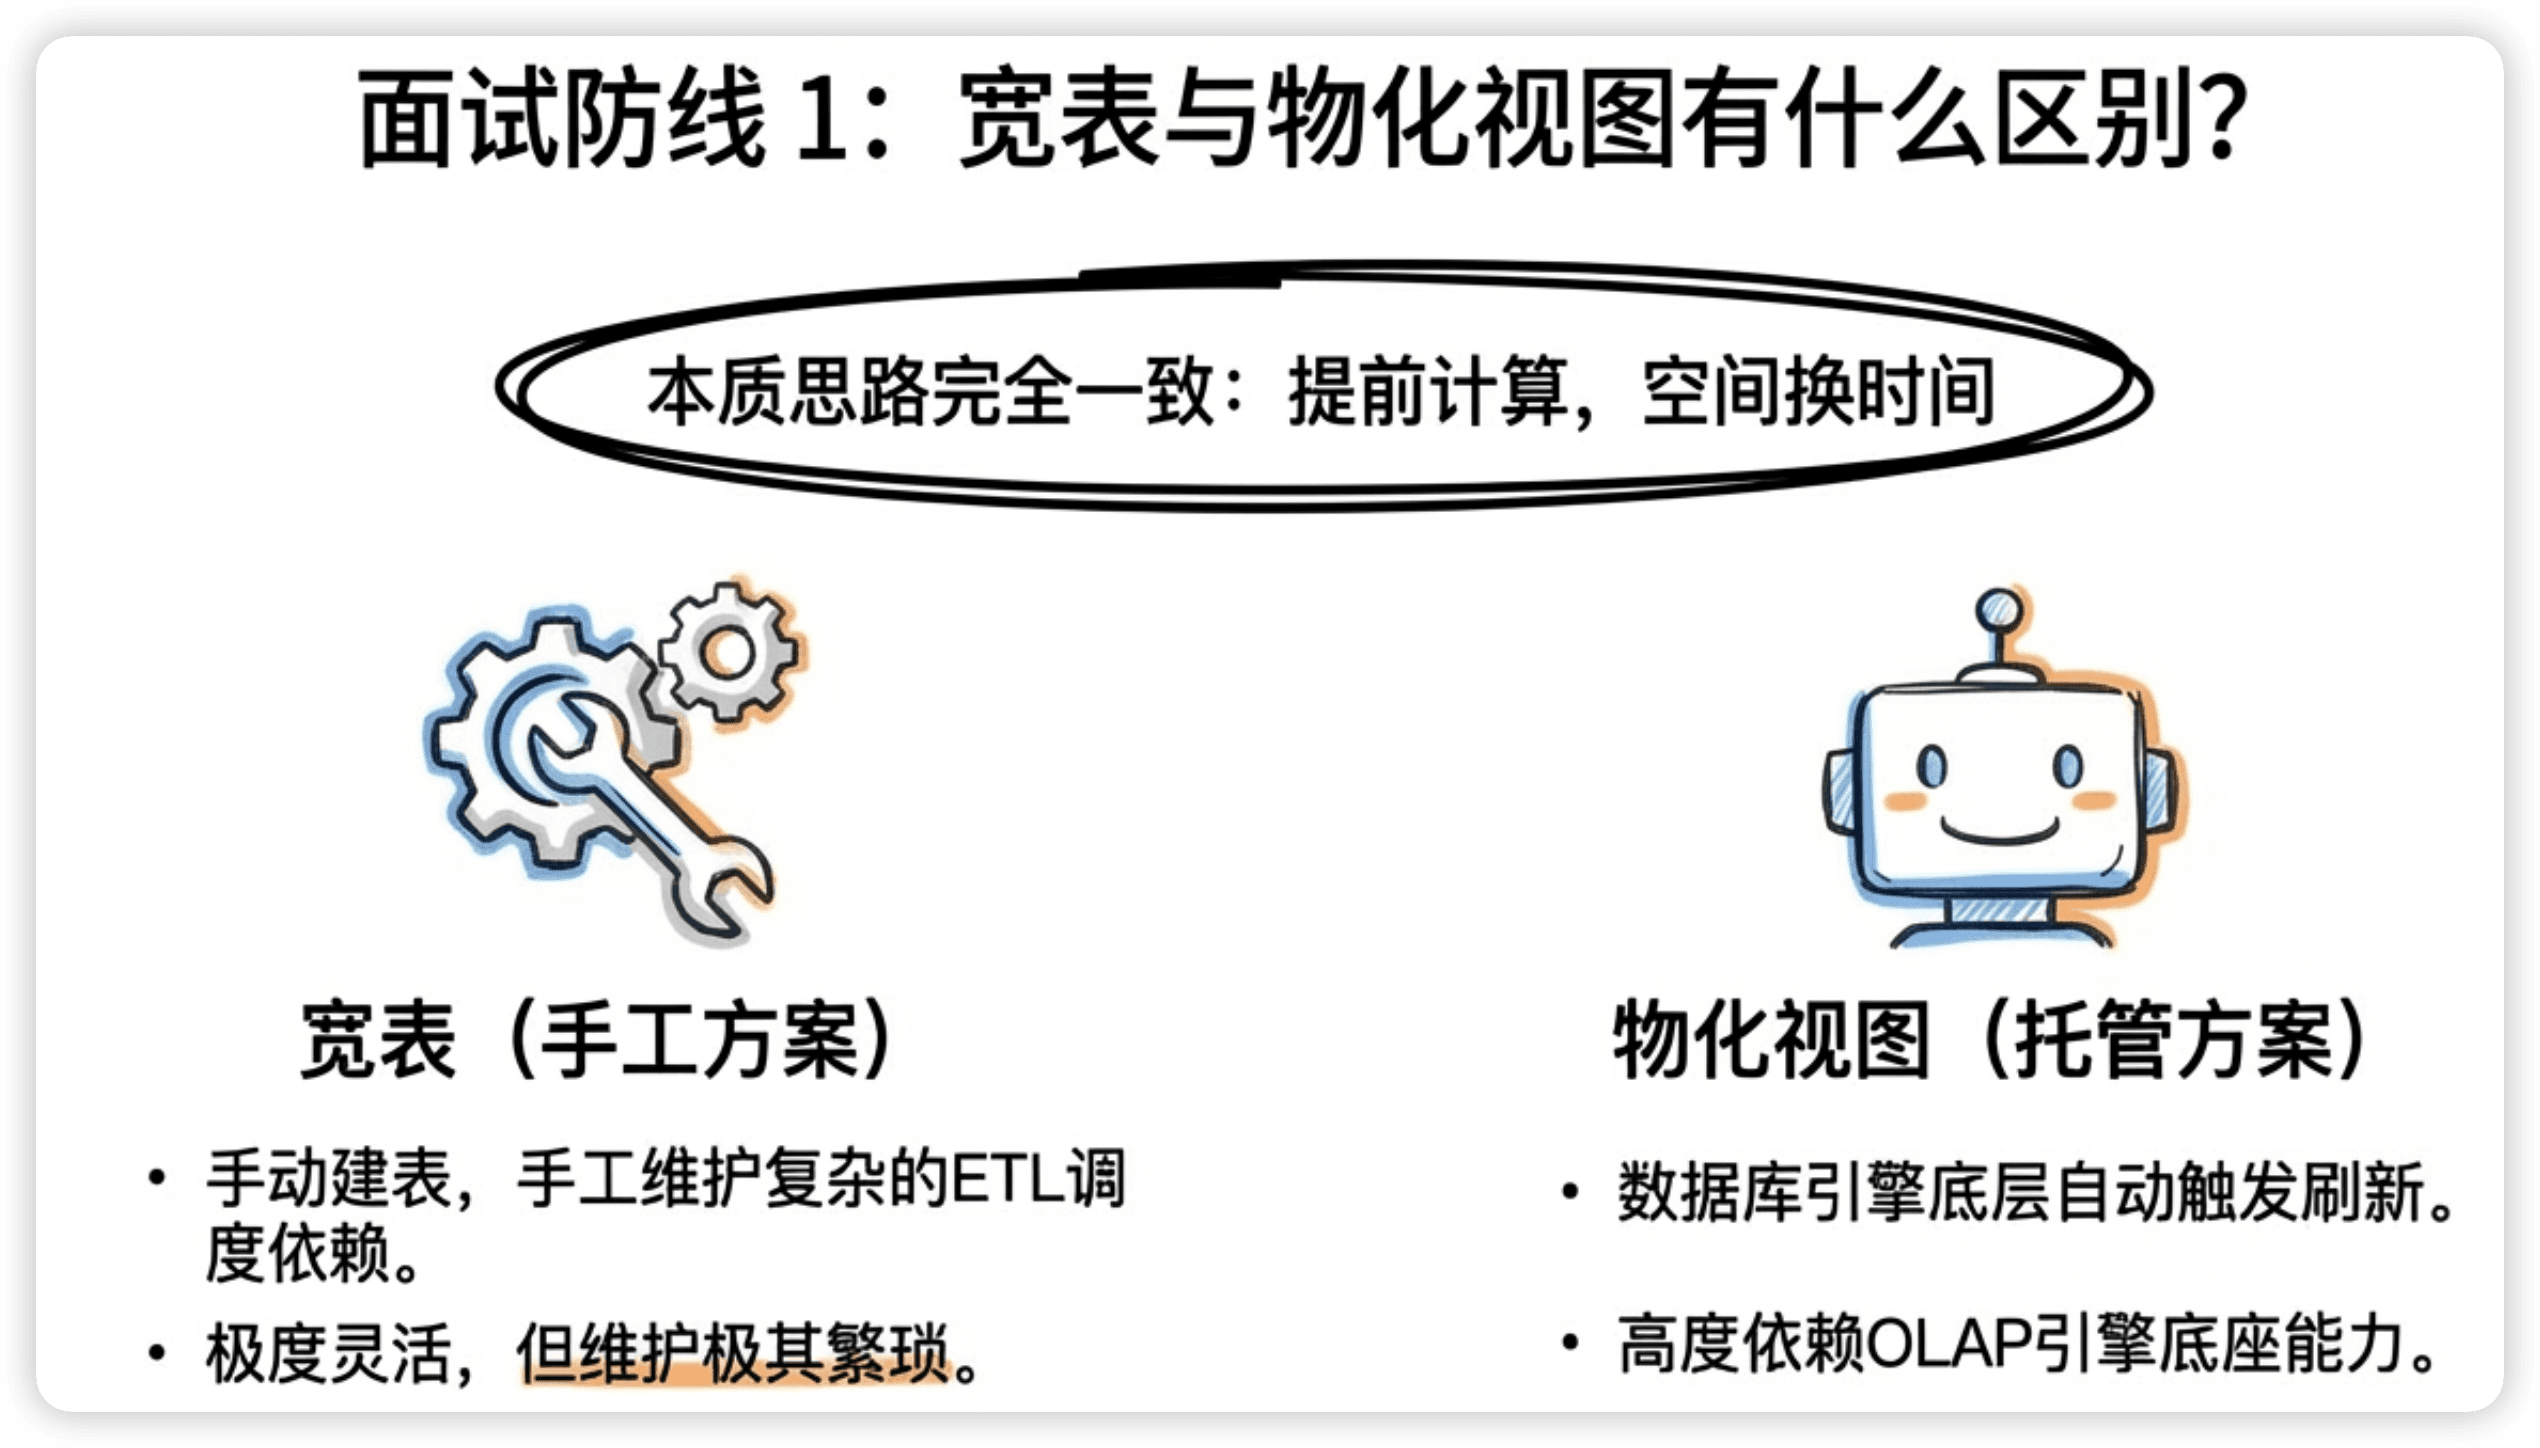
本质上思路一样——都是提前计算好结果存下来,加速查询。区别在于:宽表是你手动建表、手动维护ETL的"手工方案";物化视图是数据库/引擎自动维护的"托管方案"。
物化视图的好处是引擎会自动刷新(基于触发策略),缺点是依赖引擎的能力,不是所有引擎都支持复杂的物化视图。Doris和StarRocks的物化视图功能比较成熟,部分场景可以替代宽表。
追问2:宽表的数据一致性怎么保证?
核心是调度依赖和幂等设计。宽表的ETL任务必须在所有上游表(事实表+维度表)都产出之后才能跑。调度系统里配好强依赖关系,上游任何一张表没跑完,宽表就不触发。
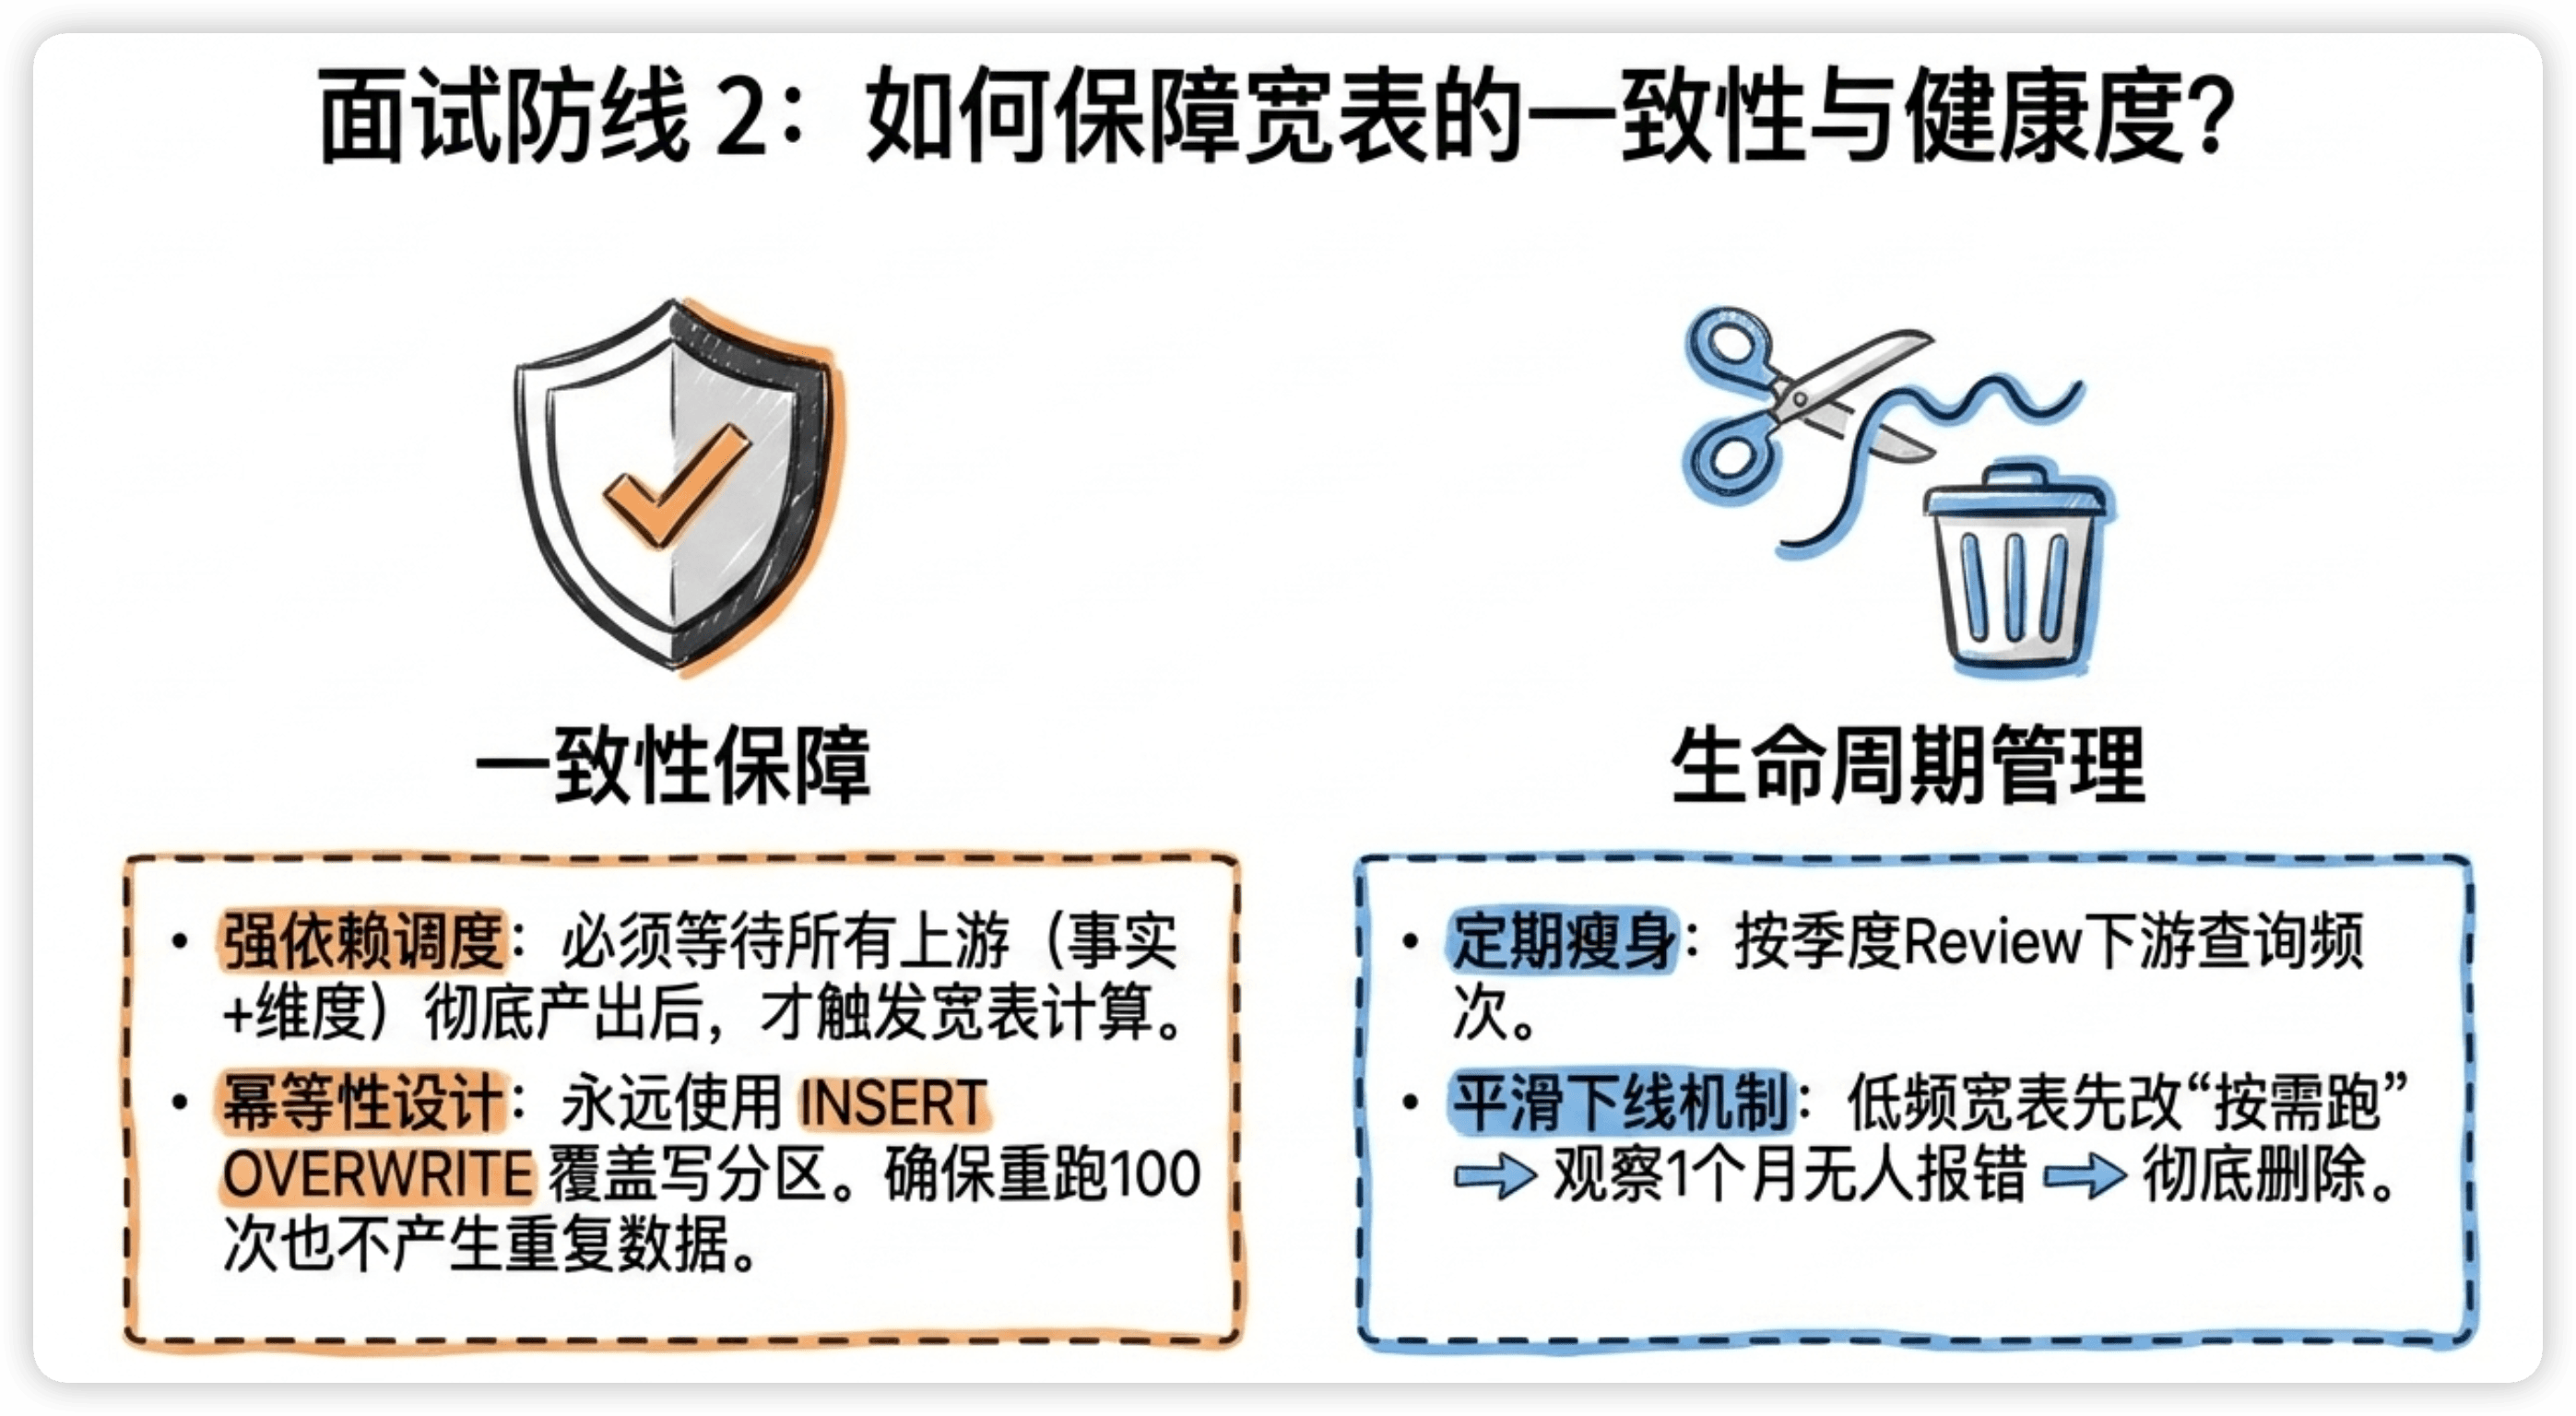
幂等设计则是确保宽表任务重跑不会产生重复数据。我们的做法是按天分区,每次用INSERT OVERWRITE PARTITION覆盖写,不管跑几次结果都一样。
追问3:宽表太多了怎么管理?
这是很现实的问题。宽表越建越多,维护成本指数增长。我们的做法是定期"瘦身"——每个季度review一次宽表的使用情况,查询频率低于阈值的宽表考虑下线。下线前先改成"按需跑"(去掉调度,需要的时候手动触发),观察一个月没人用了再真正删除。
总结
- 宽表的本质是提前JOIN,用存储和维护成本换查询性能和易用性
- 适合场景:查询频繁且固定、性能要求高、业务方直接用
- 不适合场景:维度频繁变化、需求不稳定、探索性分析
- 推荐位置:DWS层建主题宽表,DWD层保持范式化
- 设计原则:粒度单一、字段50-80个、处理好维度变化、考虑主副表拆分
- 面试的加分项不是列优缺点,而是讲一个宽表相关的踩坑故事
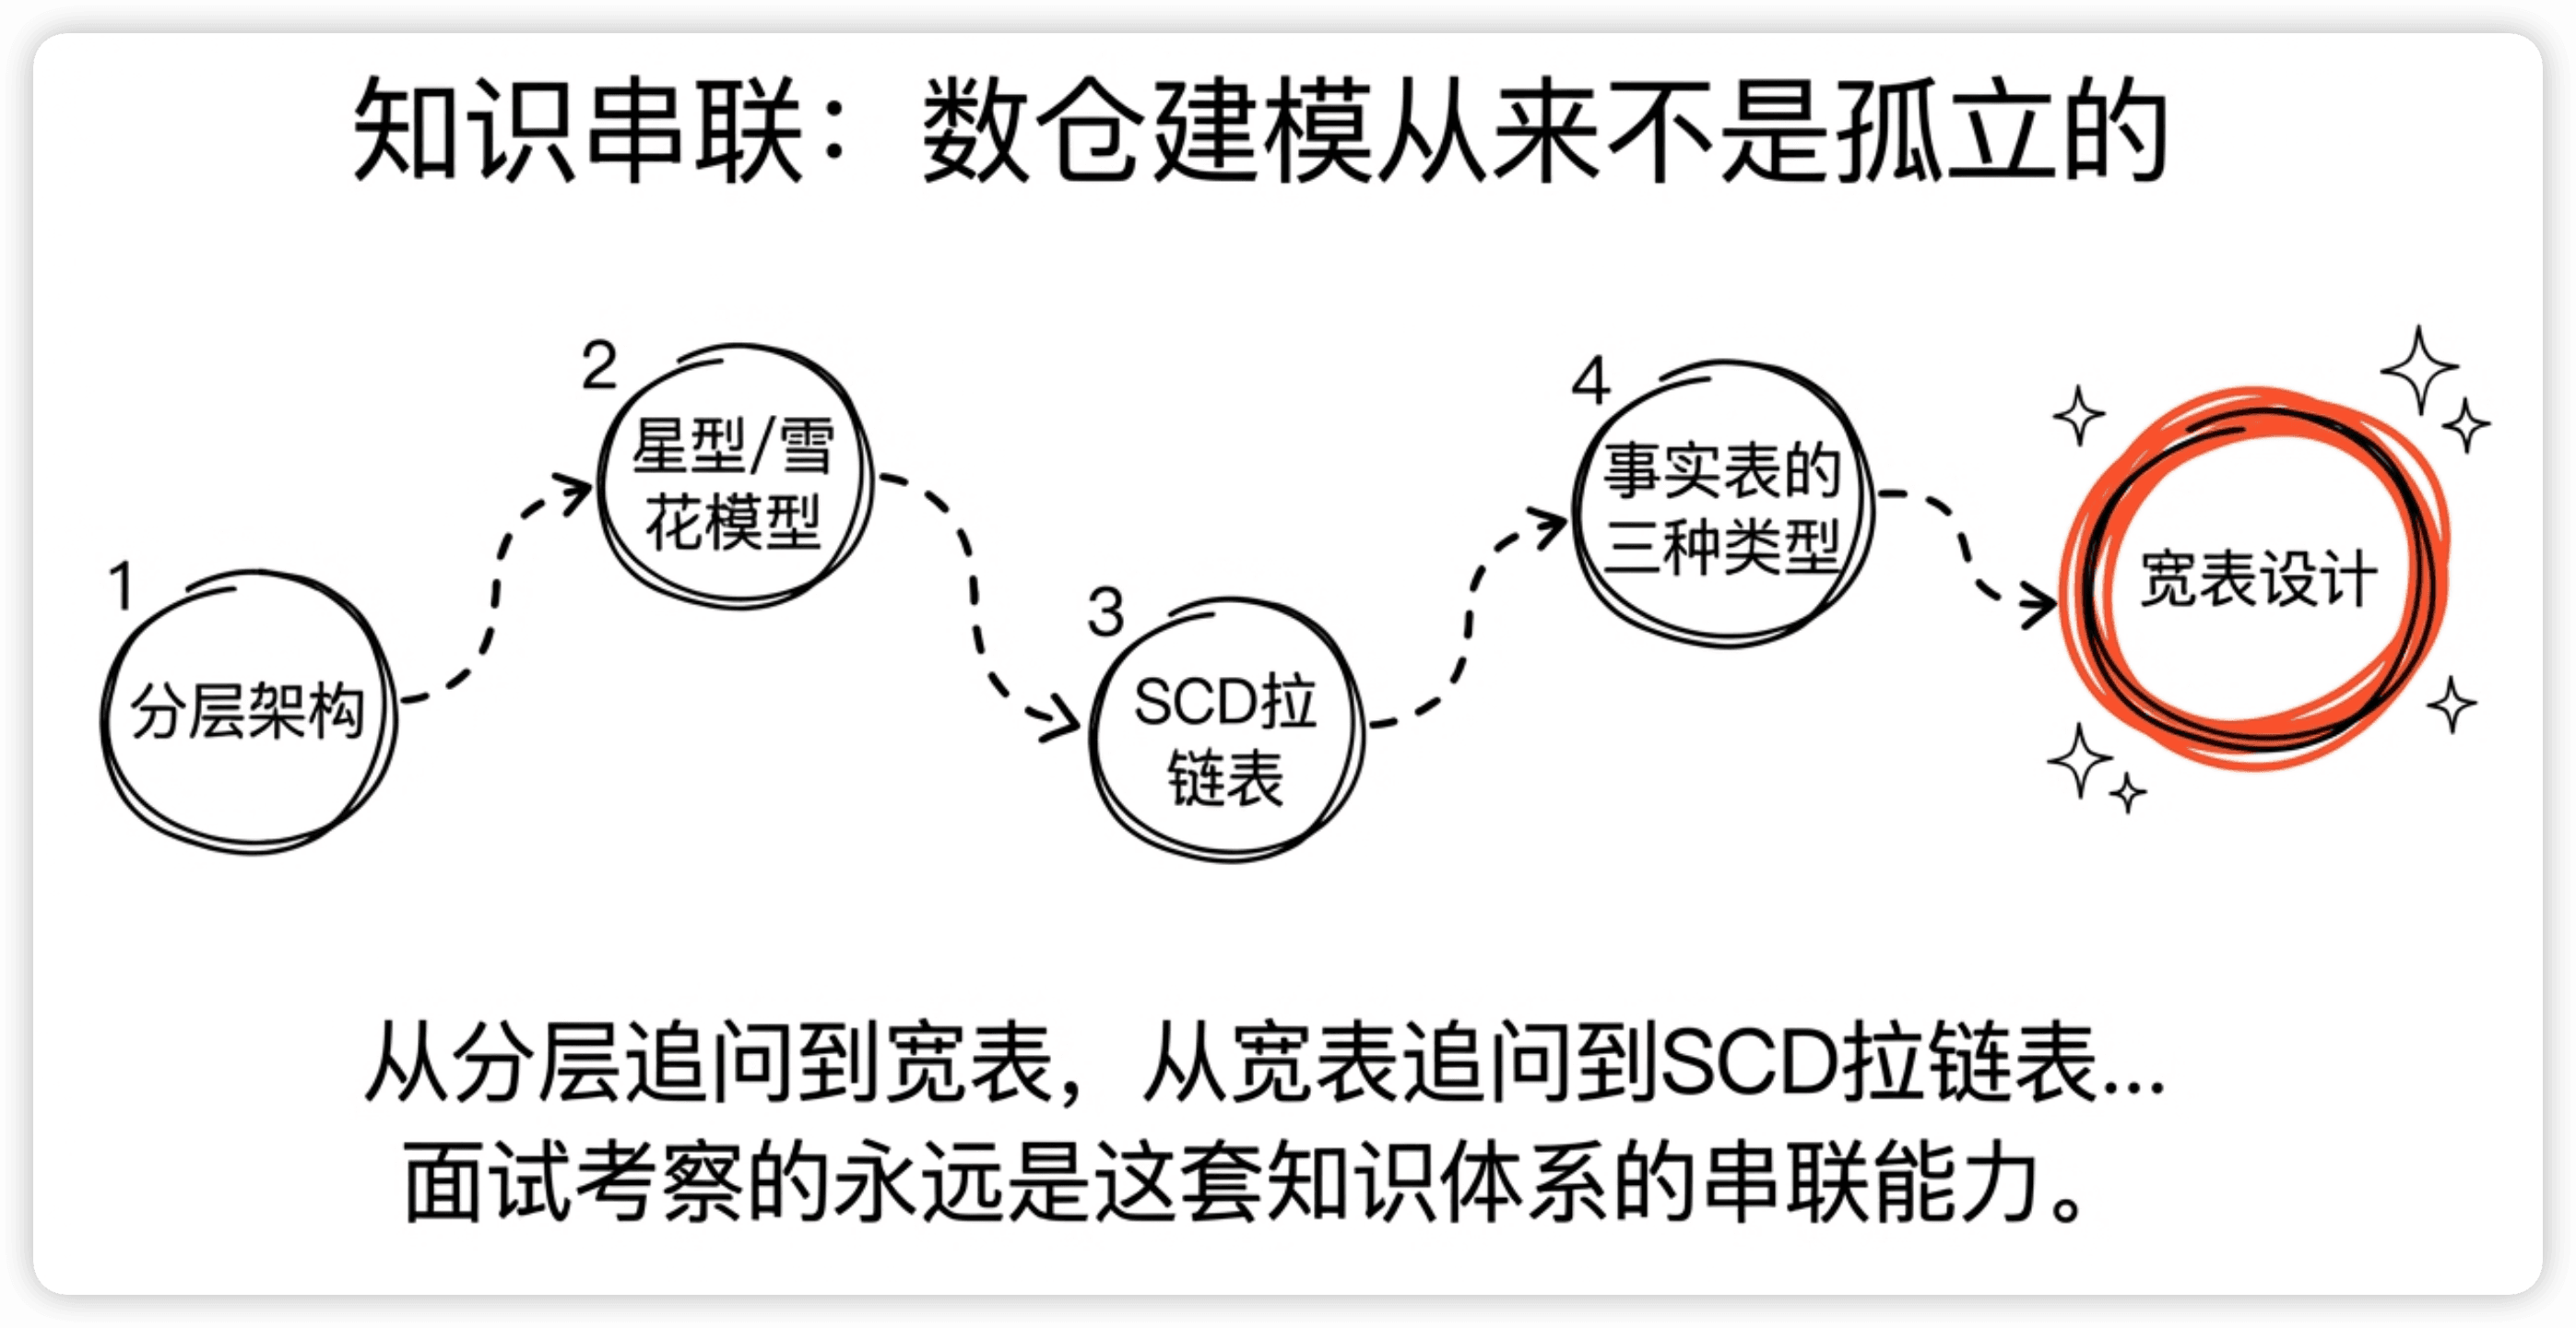
数仓建模系列 DAY 1-5 到这里就全部更新完了。从分层架构→星型/雪花模型→SCD拉链表→事实表三种类型→宽表设计,这5道题覆盖了数仓建模面试80%的考点。
如果你正在准备面试,建议把这5篇串起来复习——面试官经常从一个点追问到另一个点,比如从"分层架构"追问到"DWS层有没有宽表",再追问到"宽表的维度变化怎么处理",最后追问到"你们用的Type几的SCD"。这些知识是串联在一起的。