中间表治理
打开你们的数仓,搜一下tmp_、test_、bak_、xxx_copy——是不是有一大堆?
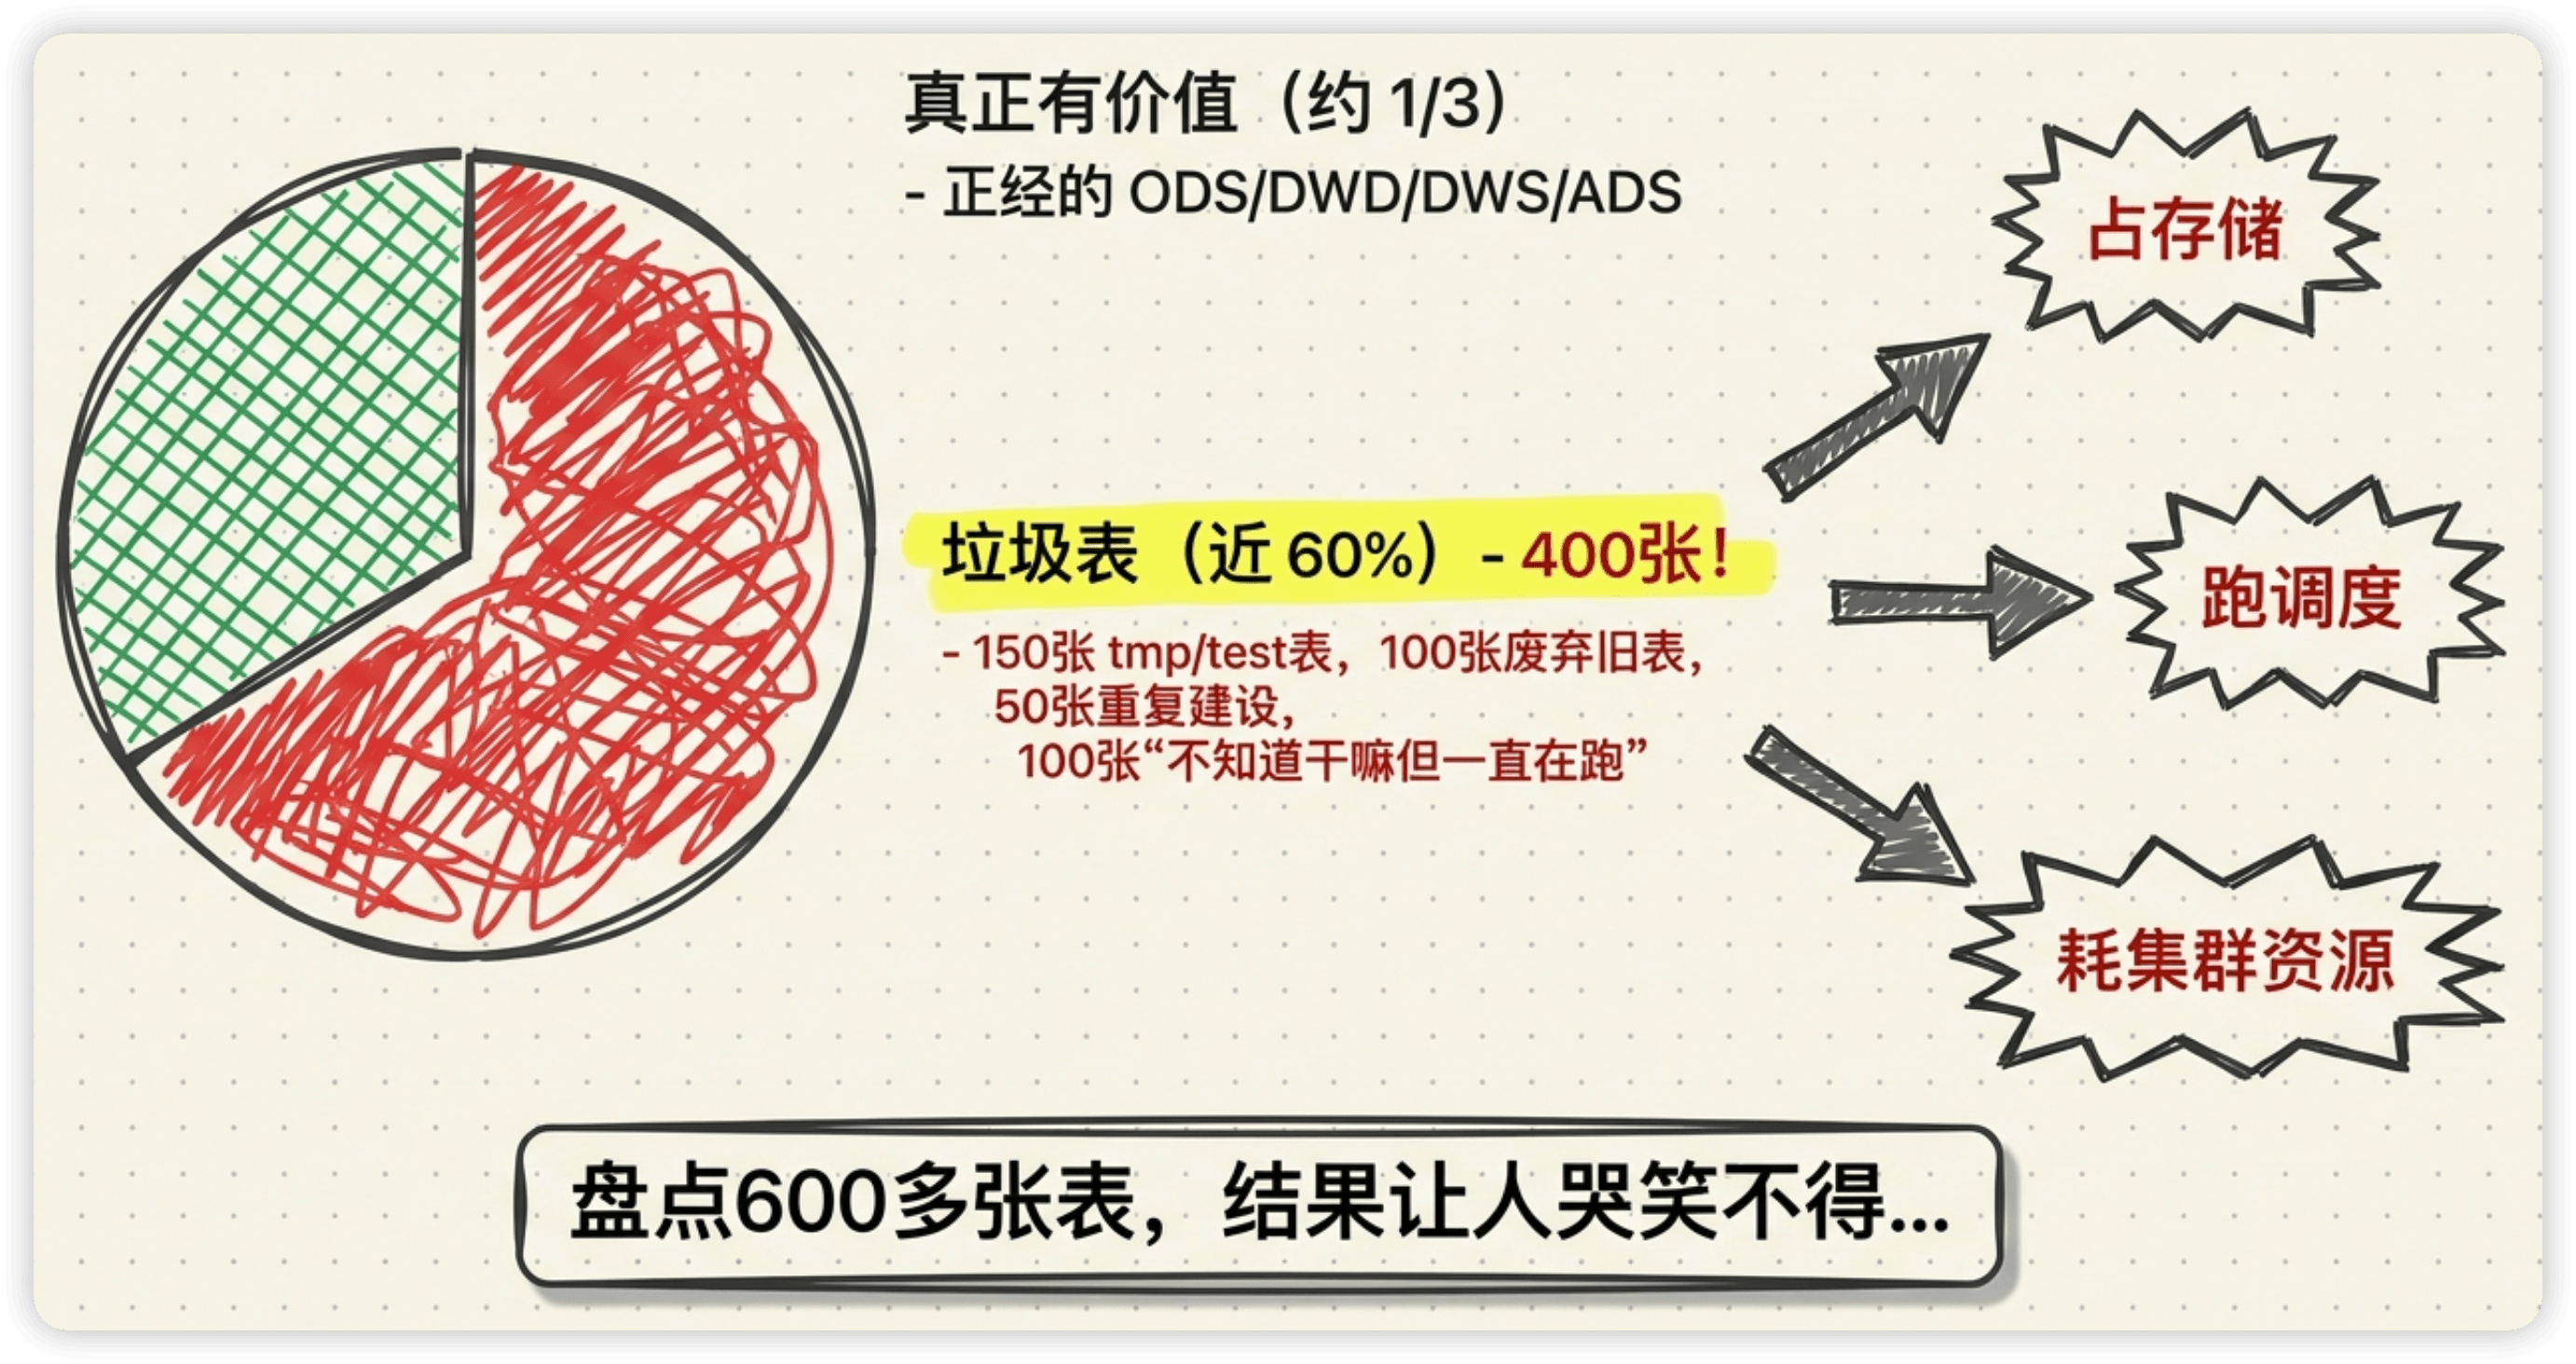
我接手短剧出海公司数据组的时候,数仓里有600多张表。我花了两天做了一次全量盘点,结果让我哭笑不得:200多张是正经的ODS/DWD/DWS/ADS,剩下400张里有150张tmp/test表、100张是已废弃但没人敢删的旧表、50张是重复建设(3个人各建了一张功能差不多的用户表)、还有100张是"不知道干嘛的但一直在跑"的表。
真正有价值的表只占了总数的三分之一。但这400张"垃圾表"每天都在占存储、跑调度、消耗集群资源。
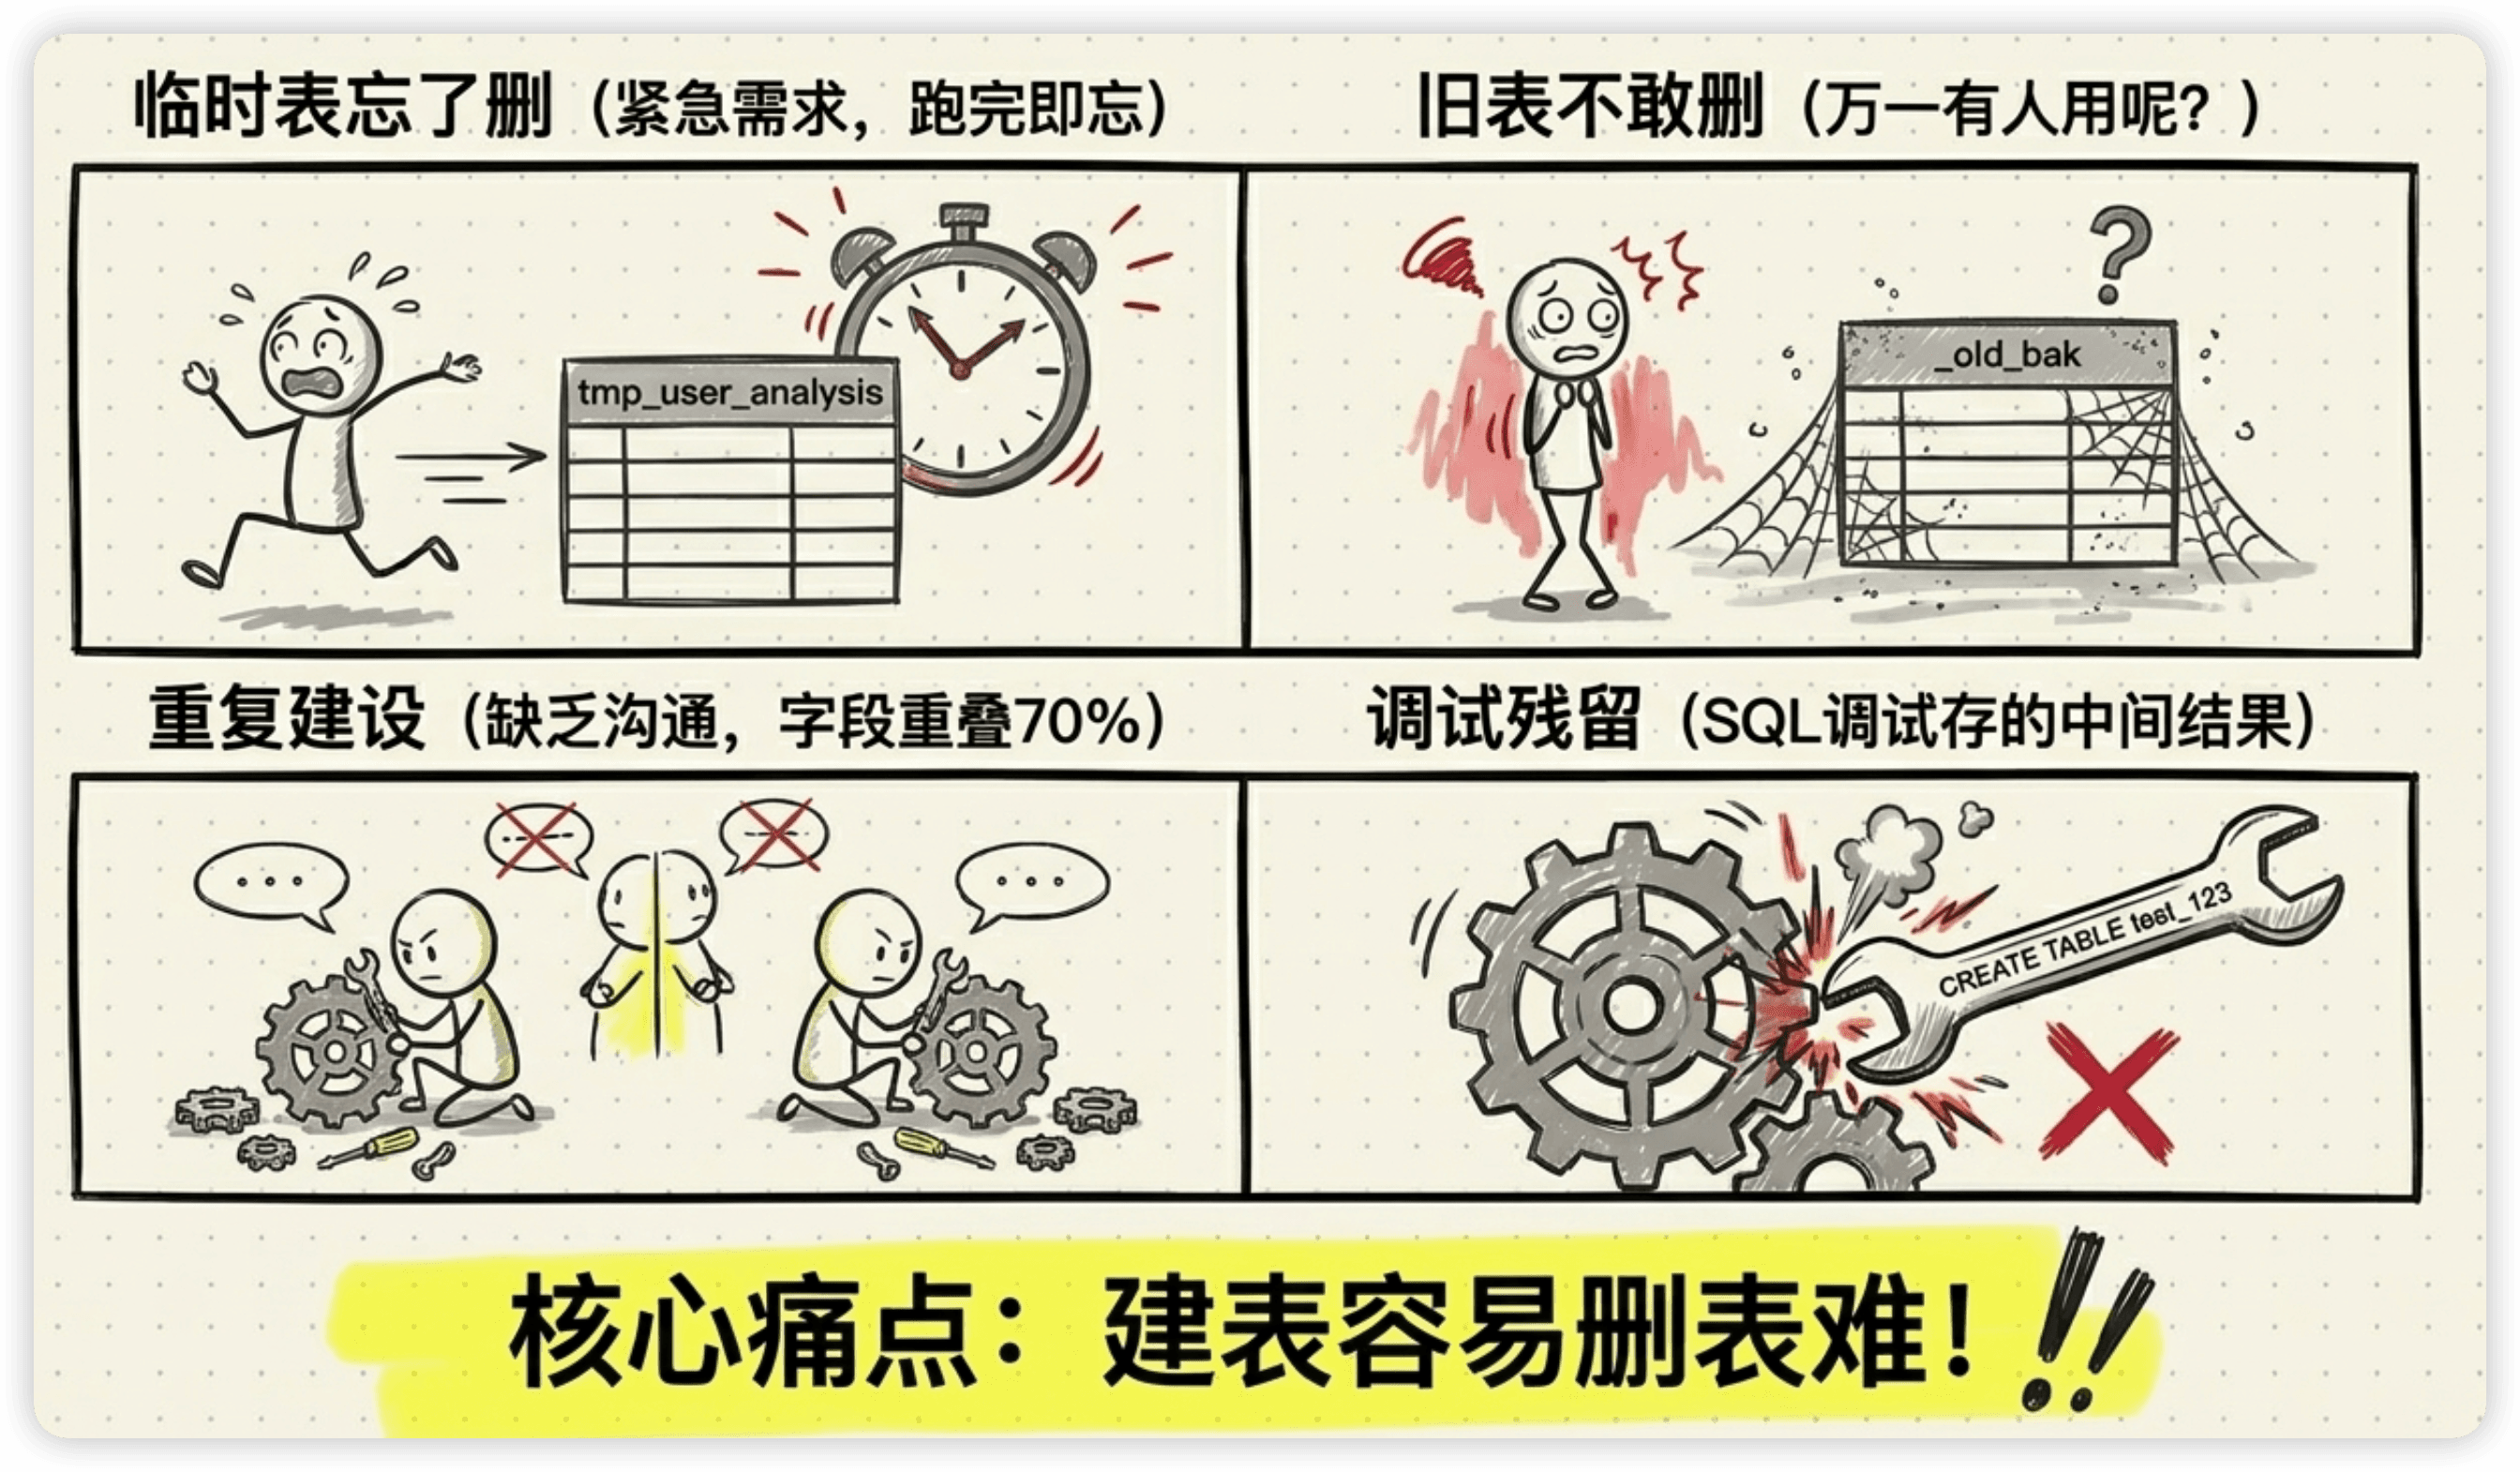
中间表泛滥是每个数仓的通病。不是因为大家故意制造垃圾,而是因为建表容易删表难——每个人都敢建,但没人敢删(万一有人在用呢?)。时间一长,数仓就变成了一个堆满杂物的仓库。
这篇文章我分享一下怎么系统性地做表治理——怎么判断一张表还有没有用、怎么安全地下线废弃表、以及怎么从源头预防泛滥。
中间表泛滥是怎么来的?
这些"垃圾表"的诞生通常是这样的:
场景一:临时表忘了删。 某天有个紧急需求,临时建了一张tmp_user_analysis跑通了交付了,然后就忘了删。下周又建了一张tmp_user_analysis_v2,上周那张还在。
场景二:旧表不敢删。 重构了一张DWS表,旧表rename成了dws_user_wide_old_bak,说好一周后删。但一周后你也不确定有没有人在用,就一直留着。半年了还在。
场景三:重复建设。 DAY 10讲过的问题——3个人各自建了一张用户画像表,字段重叠70%,每个人维护自己那张。
场景四:调试残留。 写SQL调试的时候CREATE TABLE test_123 AS SELECT ...存了中间结果,调完了表还在。
怎么判断一张表还有没有用?
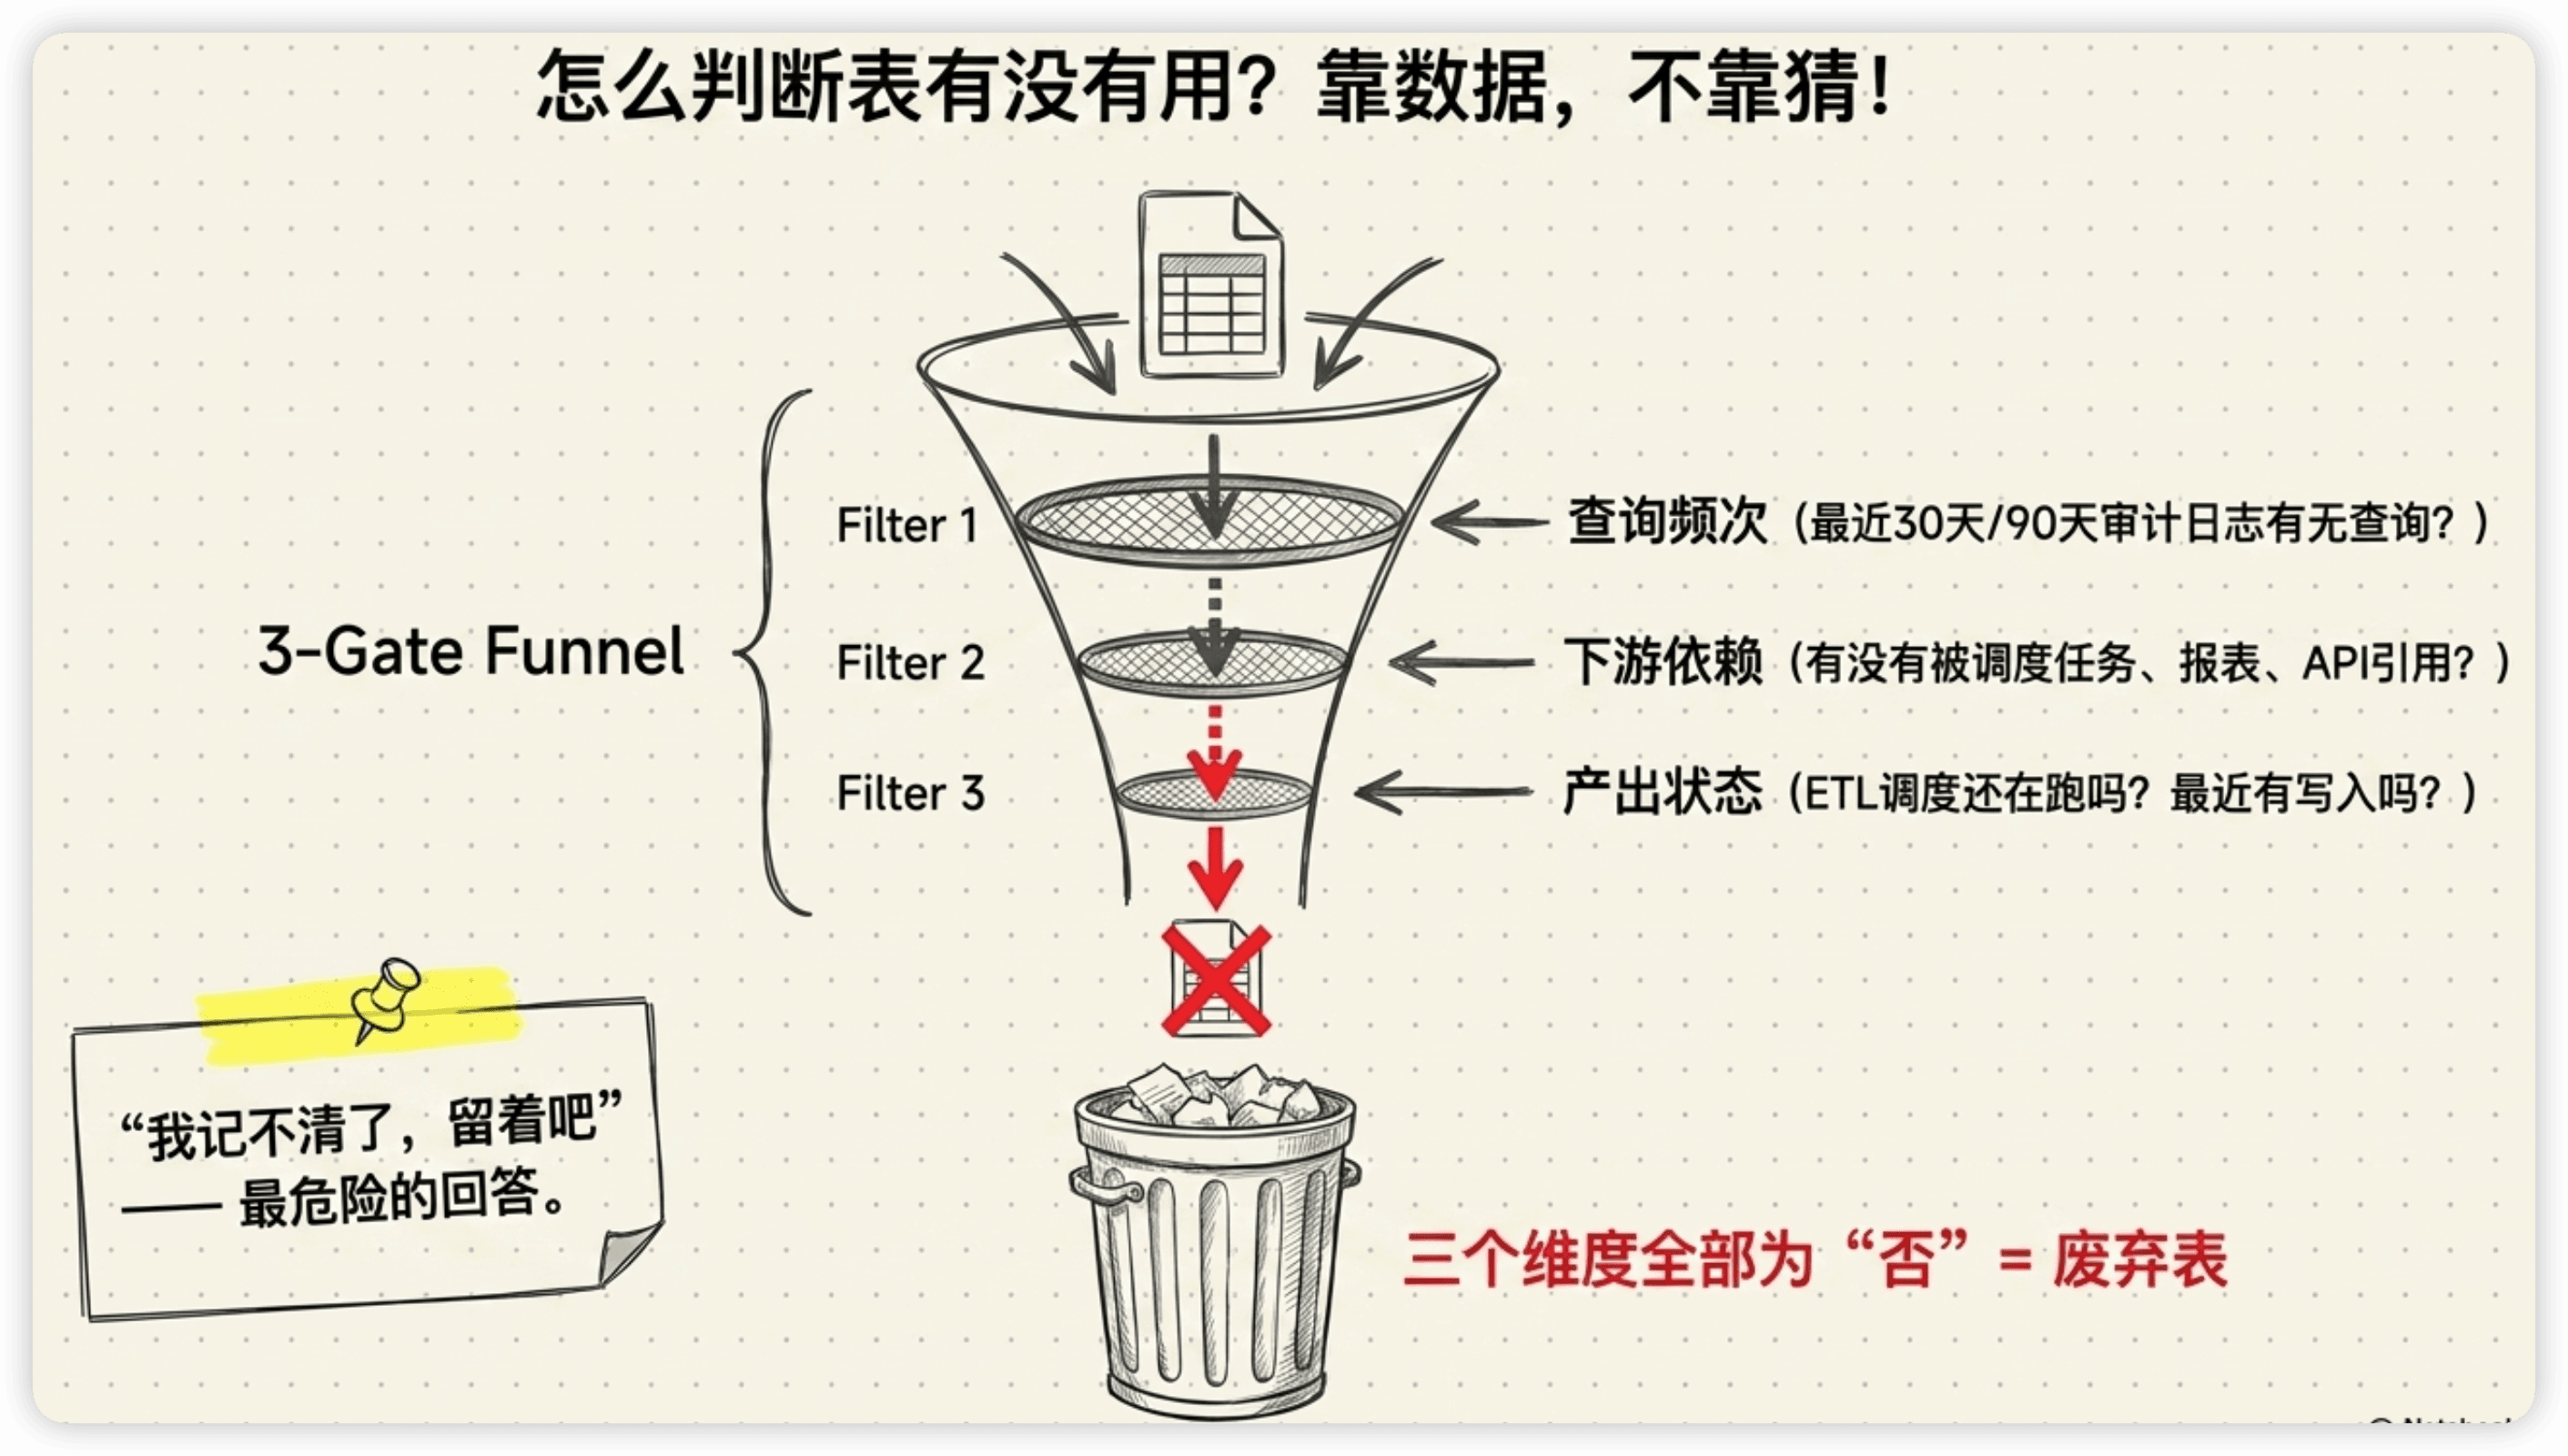
靠猜不行,靠问同事也不靠谱("我记不清了,留着吧万一要用"是最常见的回答)。要靠数据说话。
三维度判定法
维度一:查询频次
从审计日志/查询日志中统计每张表最近的查询情况:
-- 统计各表最近90天的查询频次
SELECT
    table_name,
    COUNT(*) AS query_cnt_90d,
    MAX(query_time) AS last_query_time,
    COUNT(DISTINCT query_user) AS user_cnt
FROM audit_query_log
WHERE query_time >= DATE_SUB(CURRENT_DATE, 90)
GROUP BY table_name
ORDER BY query_cnt_90d ASC;
判定标准:
- 最近30天查询次数 > 0 → 活跃表,保留
- 最近30天无查询但90天内有 → 低频表,需确认用途
- 最近90天无查询 → 高度疑似废弃表
维度二:下游依赖
这张表有没有被其他调度任务读取?有没有被报表引用?有没有被API接口调用?
用DAY 19的数据血缘来追踪。如果一张表既没人手动查、也没有调度任务在读,大概率可以下线。
-- 从血缘表中查下游依赖
SELECT target_table, job_name
FROM meta_lineage
WHERE source_table = 'tmp_user_analysis_old';
-- 如果结果为空,说明没有下游依赖
维度三:产出状态
这张表的ETL调度任务还在跑吗?最后一次写入数据是什么时候?
-- 查看表的最后更新时间
SELECT table_name, MAX(dt) AS last_partition
FROM information_schema.partitions
WHERE table_name = 'tmp_user_analysis_old'
GROUP BY table_name;
-- 如果最后分区是3个月前的,任务大概率已经停了
三个维度全部为"否"——无人查、无下游、无产出——基本可以确认是废弃表。
表资产分级治理
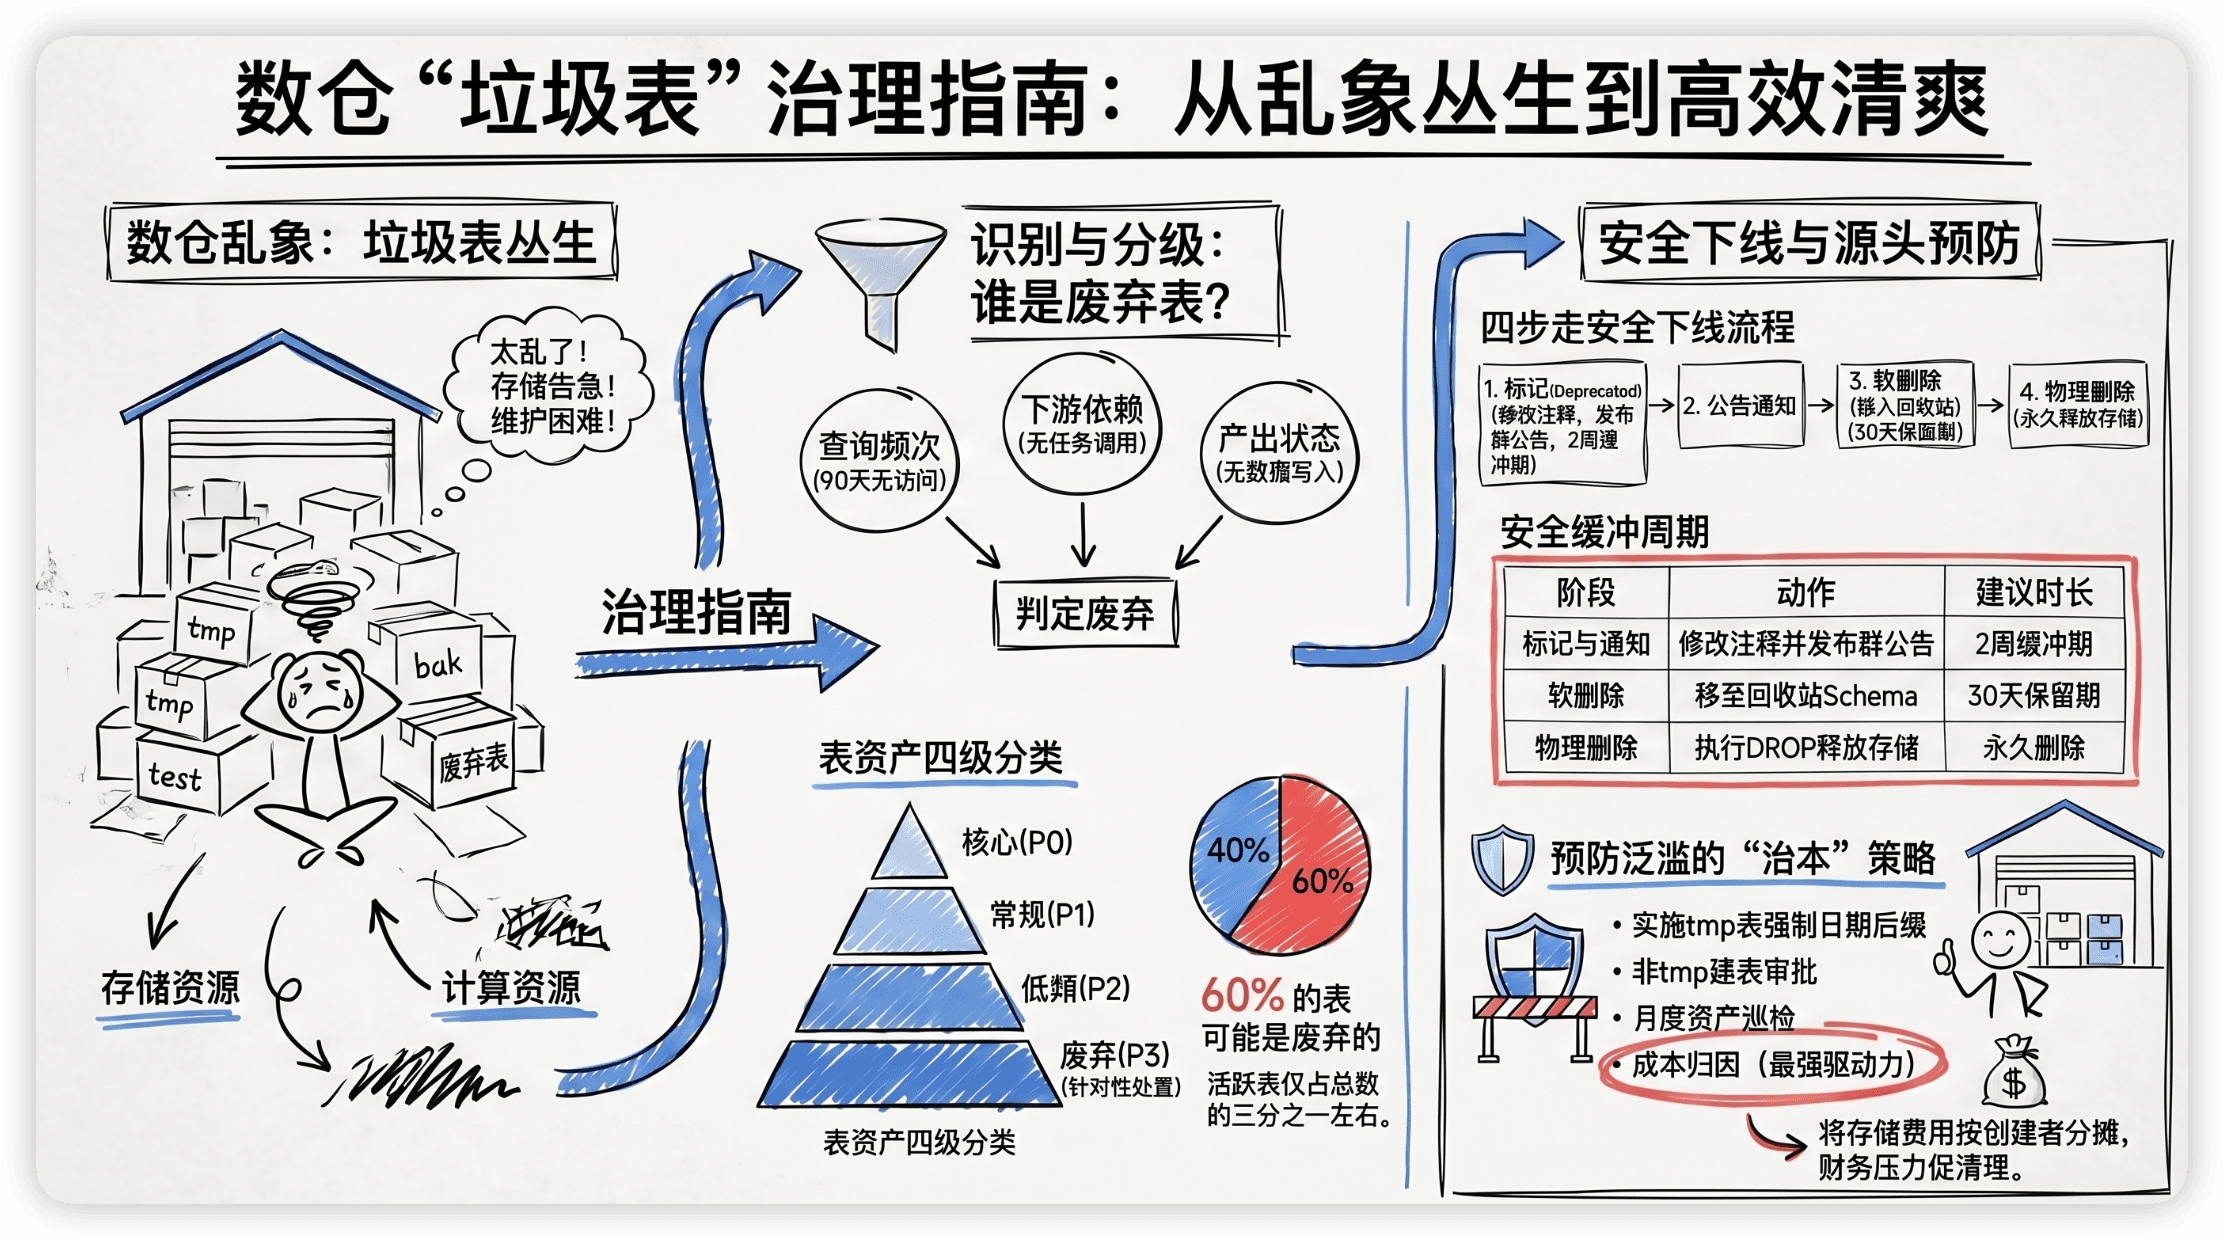
盘点完之后,把所有表分成四个等级,对应不同的处置策略:
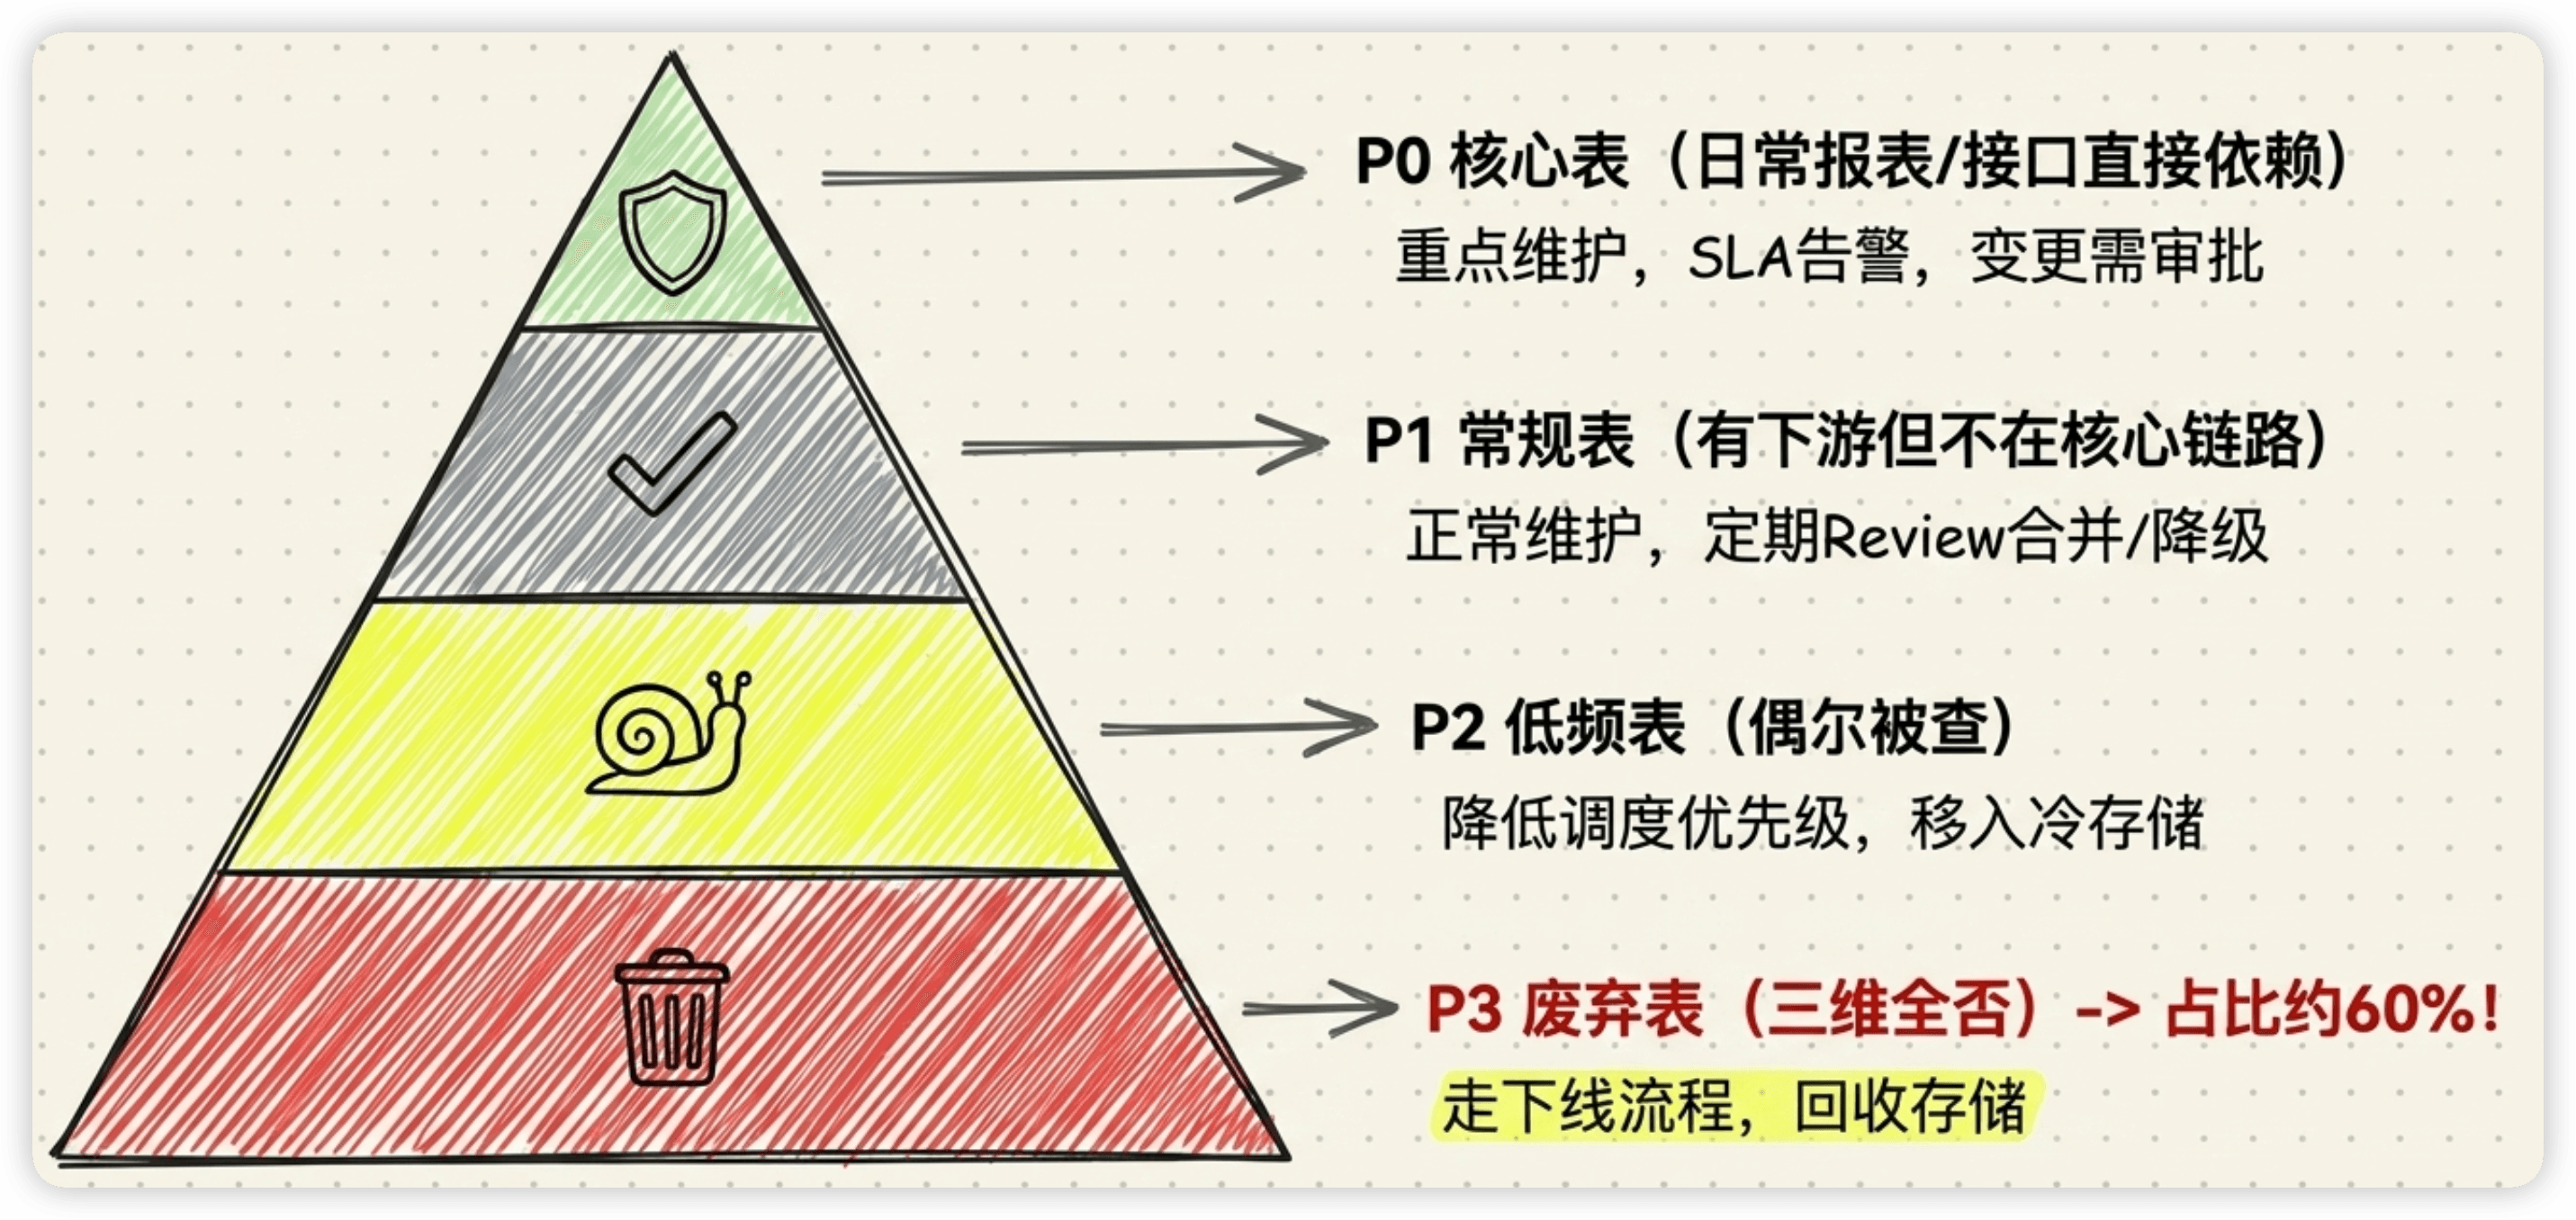
| 等级 | 定义 | 判定标准 | 处置方案 |
|---|---|---|---|
| P0 核心表 | 日常报表/接口直接依赖的表 | 每天被查询、有SLA要求 | 重点维护,有质量监控和告警,变更需审批 |
| P1 常规表 | 有下游使用但不在核心链路 | 有查询/依赖但频率不高 | 正常维护,定期Review是否可合并或降级 |
| P2 低频表 | 偶尔被查,有一定保留价值 | 季度内有少量查询 | 降低调度优先级,考虑移到冷存储 |
| P3 废弃表 | 90天无查询、无下游、无产出 | 三个维度全否 | 走下线流程,回收存储 |
在我那次盘点中,600多张表的分级结果:
P0 核心表:50张(占8%)→ 这些表要像宝贝一样呵护
P1 常规表:150张(占25%)→ 正常维护就好
P2 低频表:50张(占8%)→ 考虑降级或合并
P3 废弃表:350张(占59%)→ 走下线流程是的,近60%的表是废弃的。这个比例在我经历的几家公司中都差不多。
废弃表下线流程:四步走
直接DROP太危险了。万一有个季度才跑一次的任务正好依赖这张表呢?万一有个业务方偶尔手动查这张表做ad-hoc分析呢?
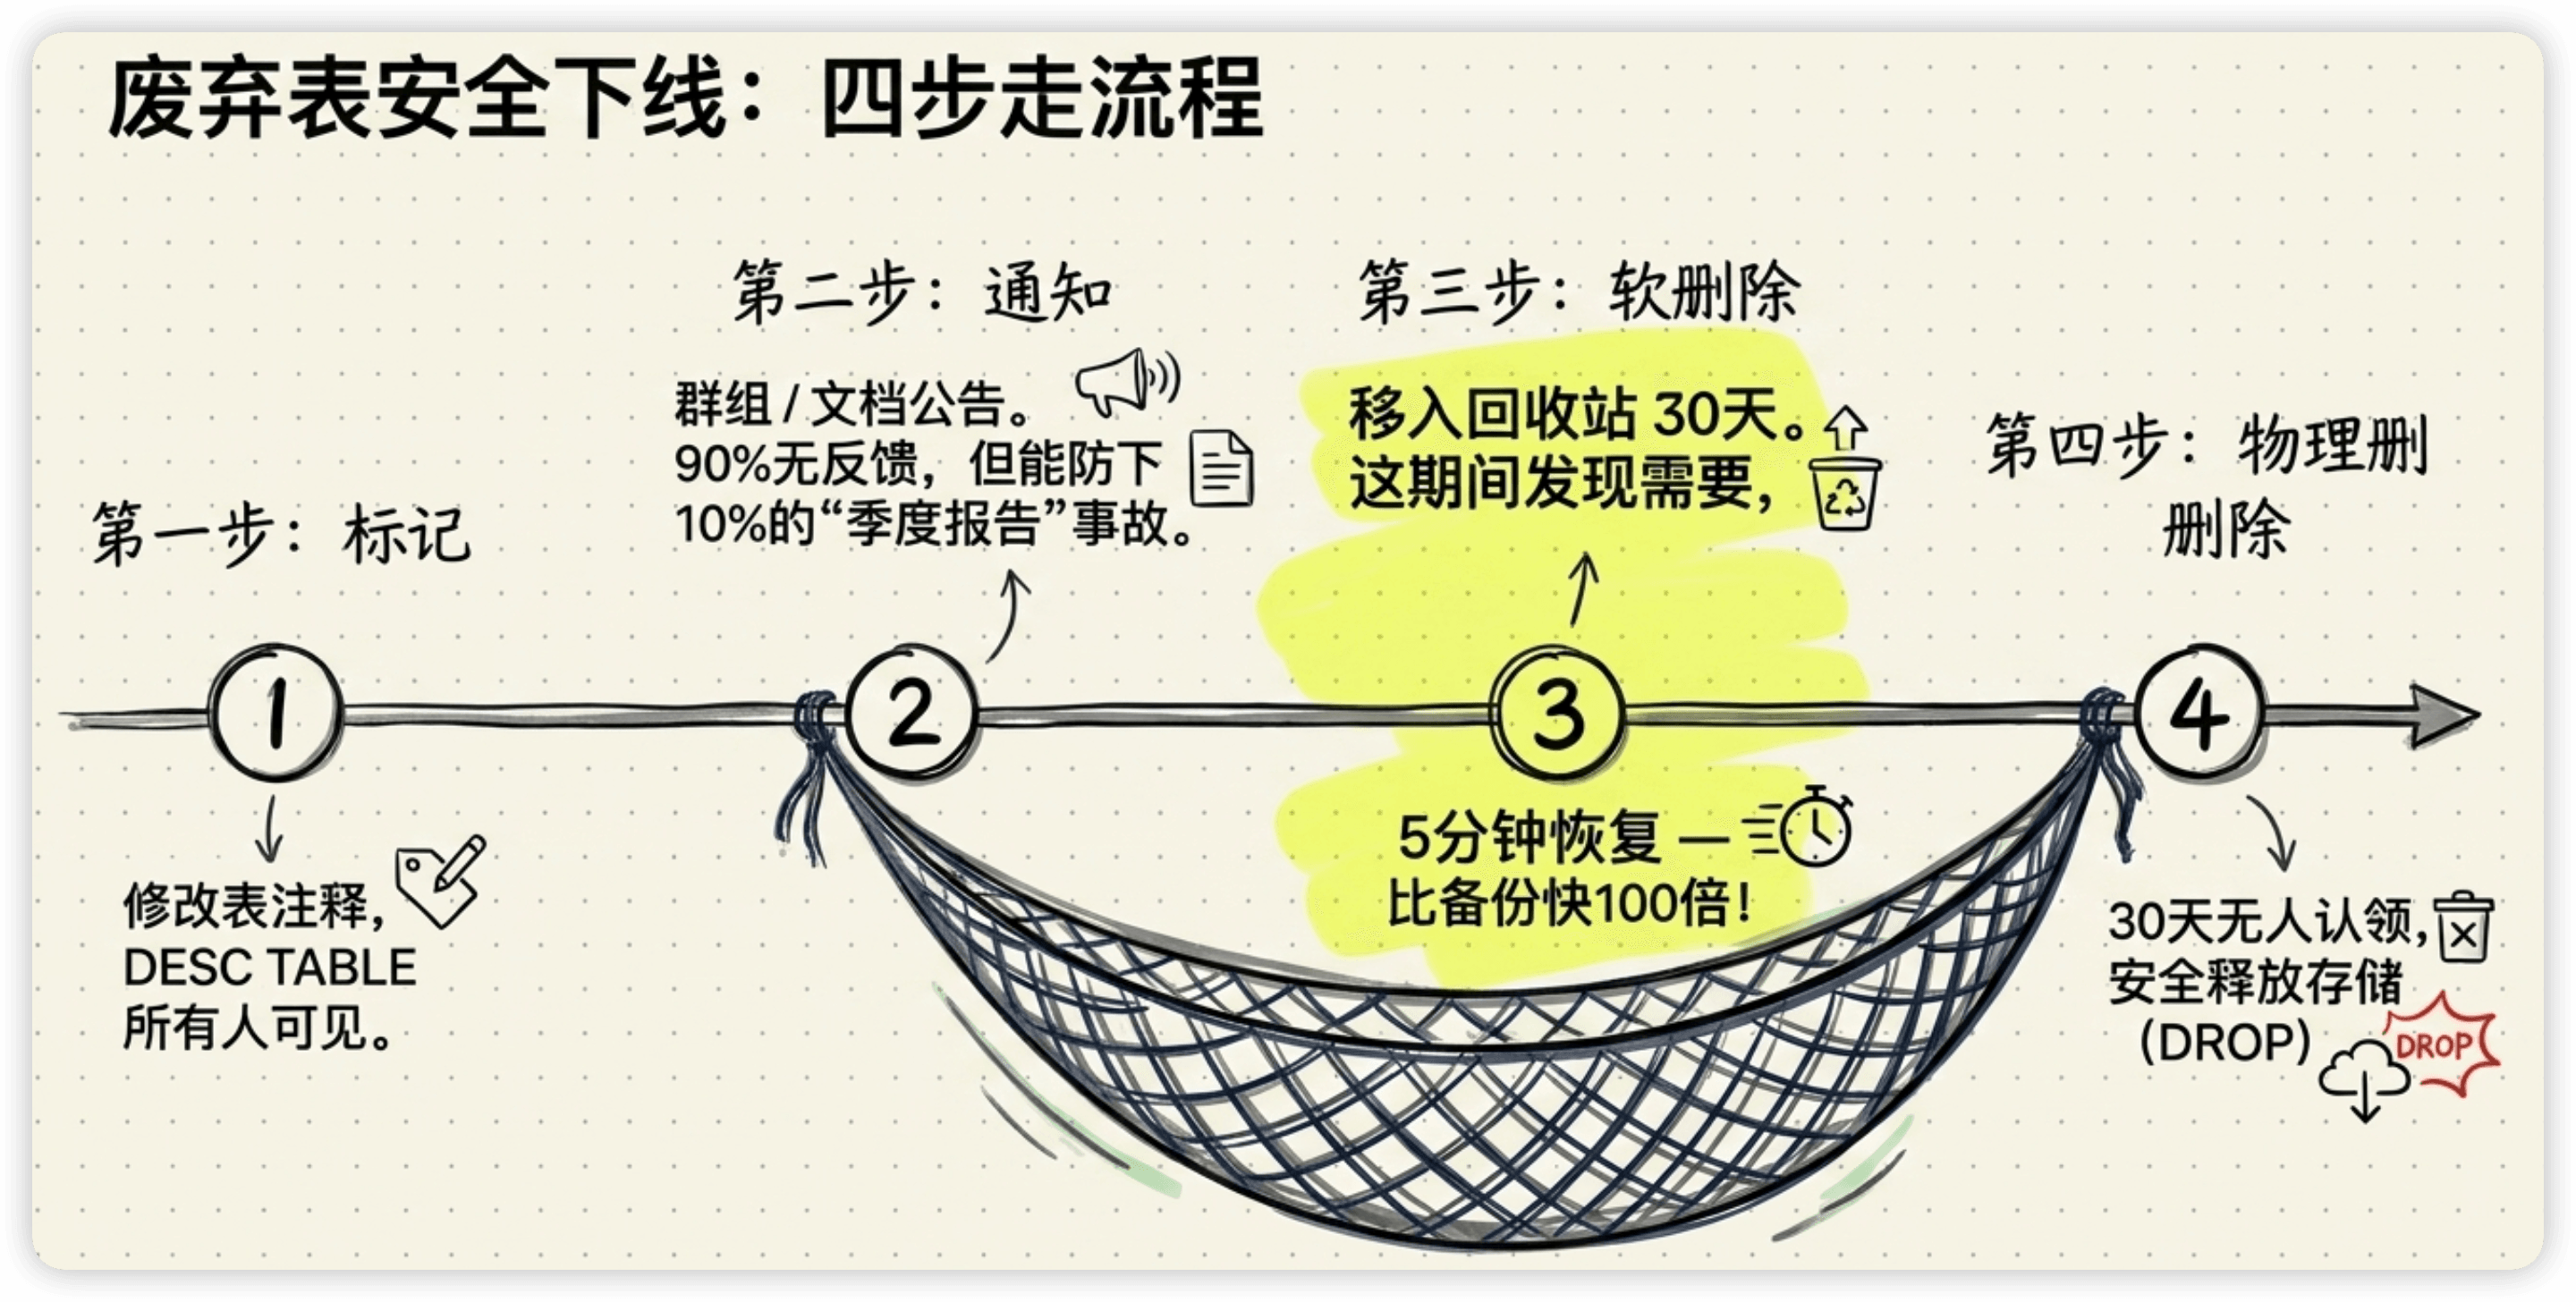
稳妥的下线流程是四步:
第一步:标记(Deprecated)
给疑似废弃的表打标记,修改表注释让所有人都能看到:
-- 在表注释中标记废弃信息
ALTER TABLE tmp_user_analysis_old
SET TBLPROPERTIES('deprecated' = 'true', 'deprecated_date' = '2025-01-15');

COMMENT ON TABLE tmp_user_analysis_old IS
'⚠️ [DEPRECATED 2025-01-15] 原用户分析临时表,已被dws_user_behavior_wide替代。
计划2025-02-15下线,如有使用请联系Wood。';标记之后,任何人DESC TABLE都能看到这张表即将下线的信息。
第二步:通知(至少两周缓冲)
在团队群/飞书文档里公告:
📢 表下线通知

以下XX张表标记为废弃,计划于2025-02-15下线:
- tmp_user_analysis_old(已被dws_user_behavior_wide替代)
- tmp_order_debug_20240801(调试临时表)
- dws_user_portrait_v1_bak(旧版用户画像备份)
...

如有使用需求,请在2025-02-01前反馈。
实际操作中,90%的情况下不会有人反馈。但这两周缓冲期非常重要——它是你的"安全网"。我遇到过一次:通知发出去后第二天就有人反馈"这张表我季度报告要用的",避免了一次事故。
第三步:软删除(移到回收站)
不直接DROP,先改名移到回收站schema:
-- 移到回收站(改名而非删除)
ALTER TABLE tmp_user_analysis_old
RENAME TO _trash.tmp_user_analysis_old_20250215;
在回收站保留30天。这期间如果有人发现需要,5分钟就能恢复——比从备份恢复快100倍。
第四步:物理删除
30天后无人认领,执行DROP TABLE释放存储。
#!/bin/bash
# 自动清理回收站中超过30天的表
EXPIRE_DATE=$(date -d "30 days ago" +%Y%m%d)

for table in $(hive -e "SHOW TABLES IN _trash" | grep "_${EXPIRE_DATE}"); do
    hive -e "DROP TABLE _trash.${table}"
    echo "Dropped: _trash.${table}"
done
预防中间表泛滥:治本之策
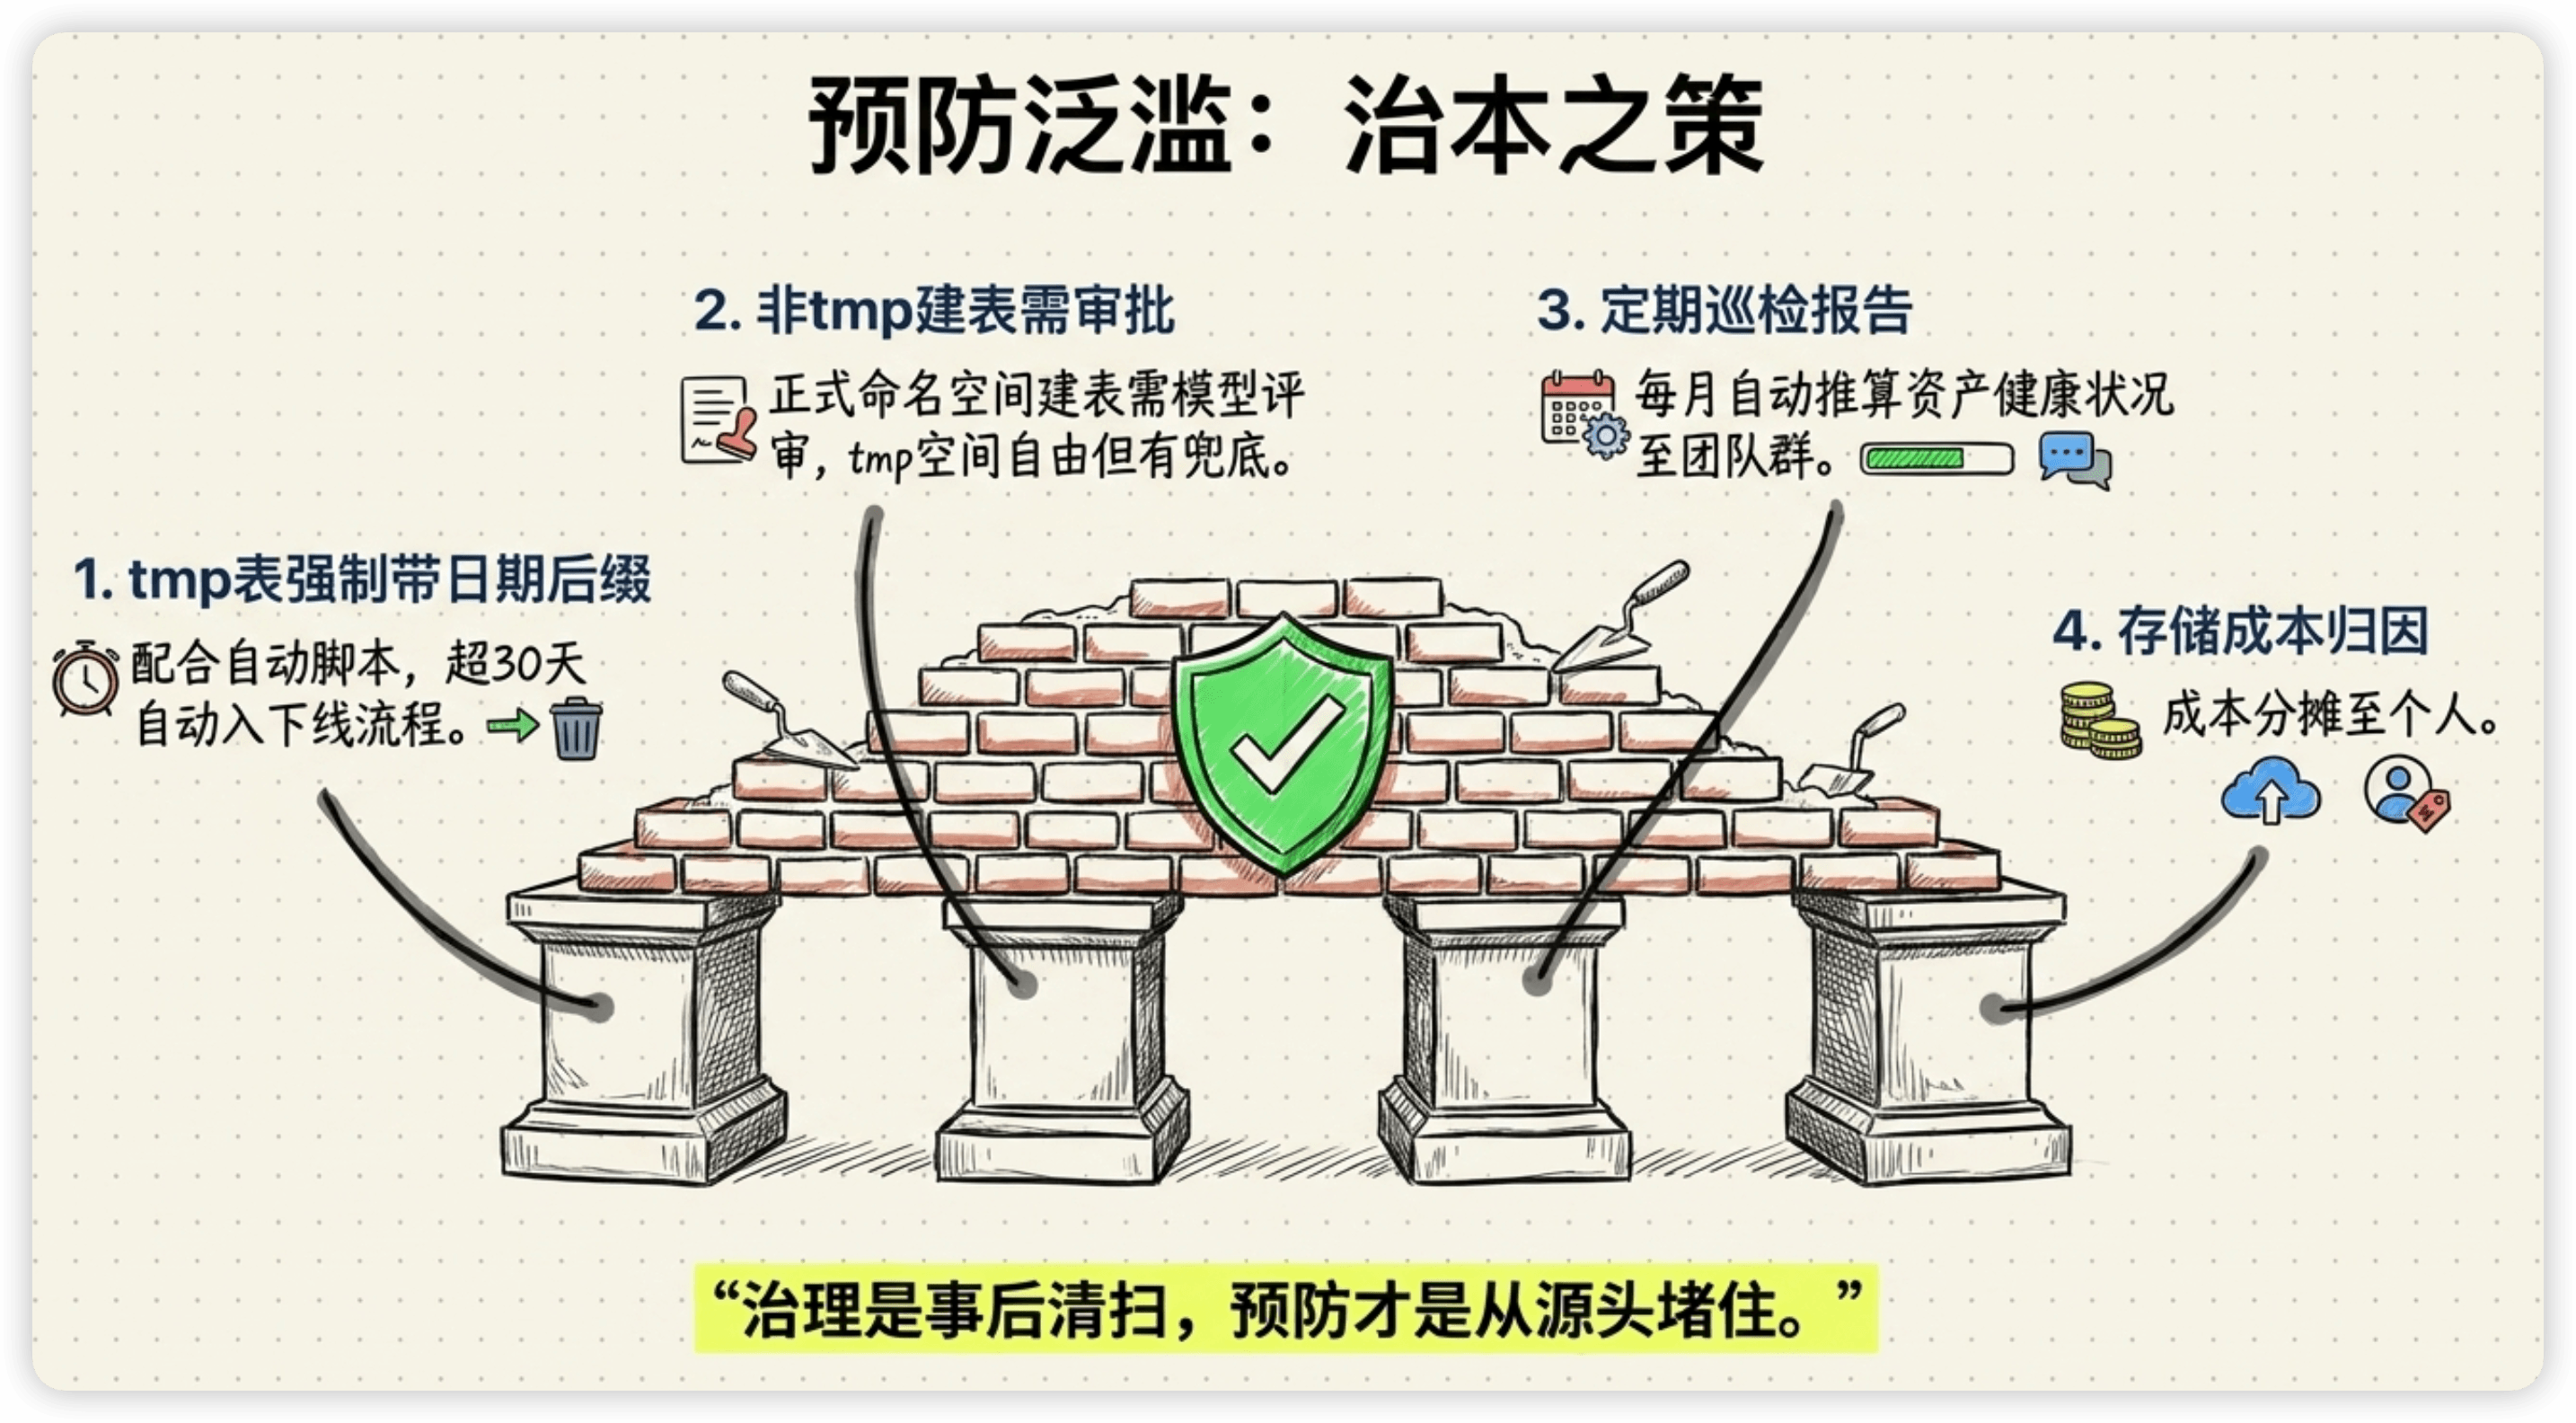
治理是"事后清扫",预防才是"从源头堵住"。
措施一:tmp表强制带日期后缀
✅ tmp_user_analysis_20250115  → 一眼知道什么时候建的
❌ tmp_user_analysis → 三个月后谁都不知道该不该删配合自动策略:tmp_开头且超过30天的表自动进入下线流程。脚本每天扫一遍,超期的自动标记Deprecated并通知创建者。
措施二:非tmp建表需审批
在正式的ods/dwd/dws/ads命名空间建表,需要走DAY 10的模型评审流程——至少有一个人Review过设计。
tmp命名空间可以自由建表(降低临时分析的门槛),但有自动清理机制兜底。
措施三:定期巡检报告
每月自动跑一次表资产盘点脚本,输出报告推送到团队群:
📊 月度数据资产报告(2025年1月)

总表数:650张(上月640张,+10张)
新增表:15张(其中tmp表8张)
废弃表候选:12张(90天零查询)
存储Top10表(占总存储60%):
  1. dwd_log_event_detail_di     520GB
  2. ods_ad_click_di             380GB
  ...
90天零查询表:23张,占存储45GB
建议下线清理可节省约45GB存储。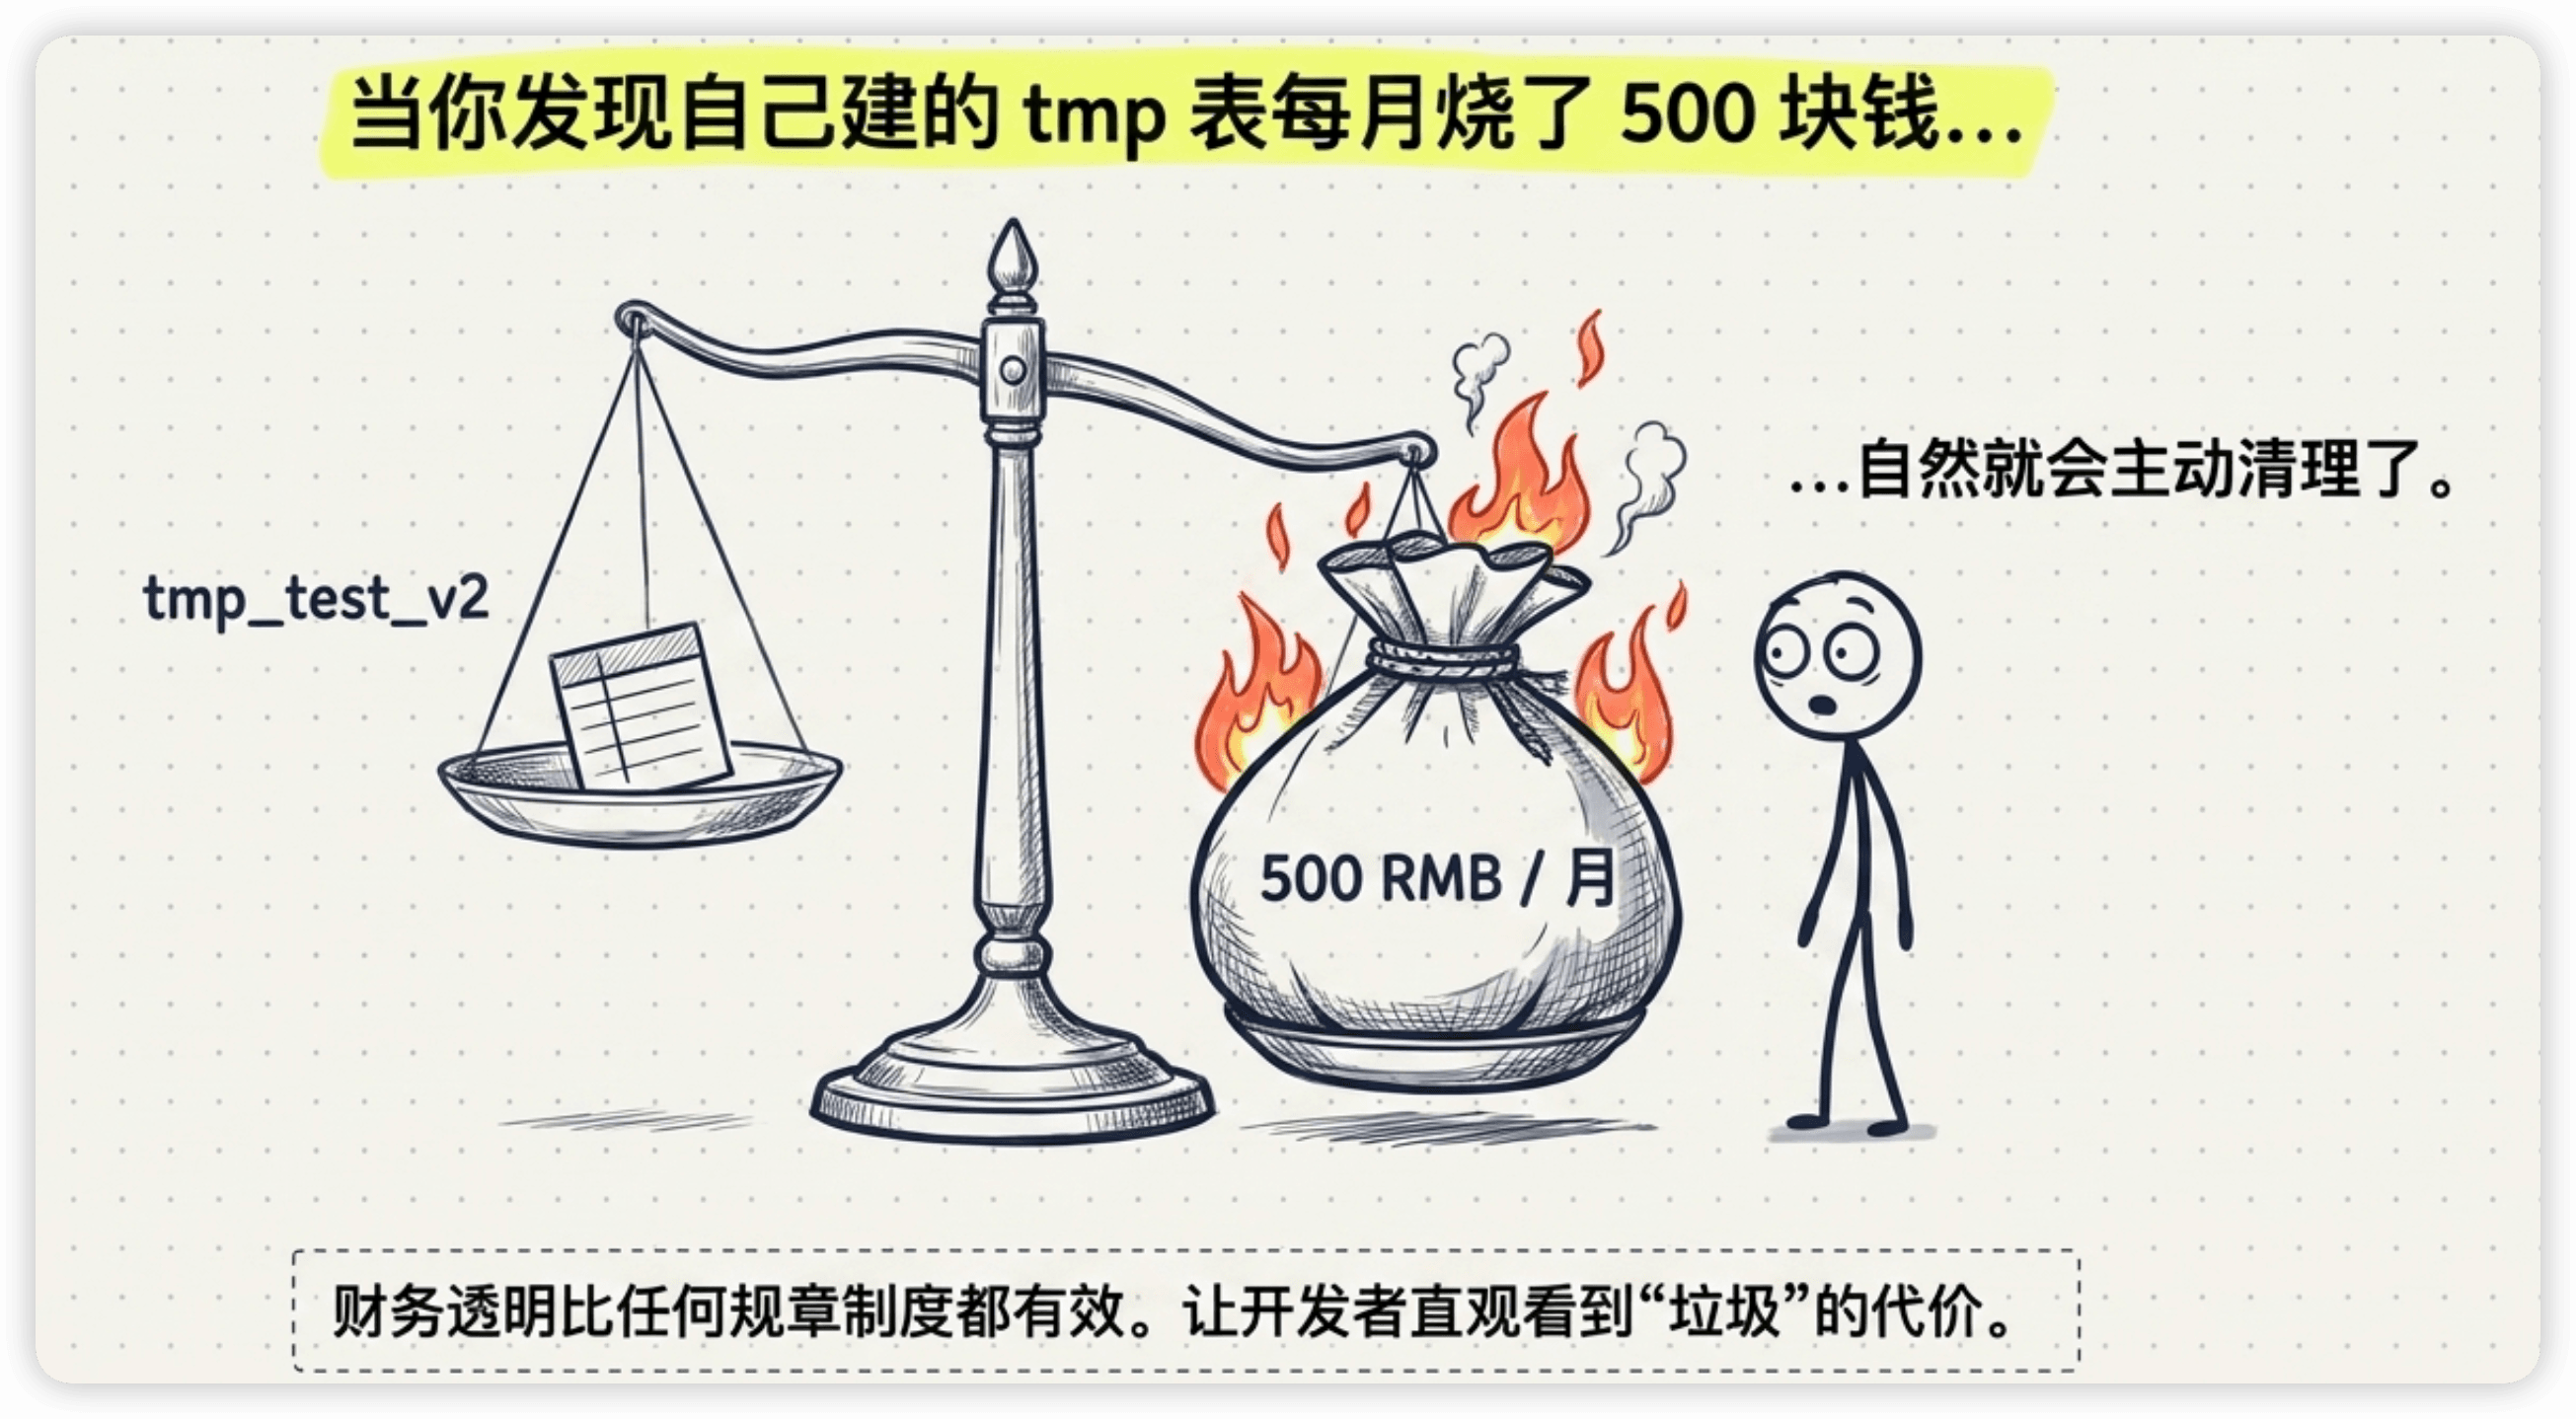
这种报告每月推一次,团队对数据资产的"健康状况"一目了然。
措施四:存储成本归因
把存储成本按表的创建者分摊。当你发现自己建的tmp表每月烧了500块,自然就会主动清理了。
-- 按创建者统计存储占用
SELECT
    table_owner,
    COUNT(*) AS table_cnt,
    SUM(storage_gb) AS total_gb,
    SUM(storage_gb) * 0.16 AS monthly_cost_usd  -- S3标准存储单价
FROM meta_table_info
GROUP BY table_owner
ORDER BY total_gb DESC;
我推行成本归因之后,团队成员开始主动清理自己的tmp表了——比任何规章制度都有效。
面试怎么答?
高分回答
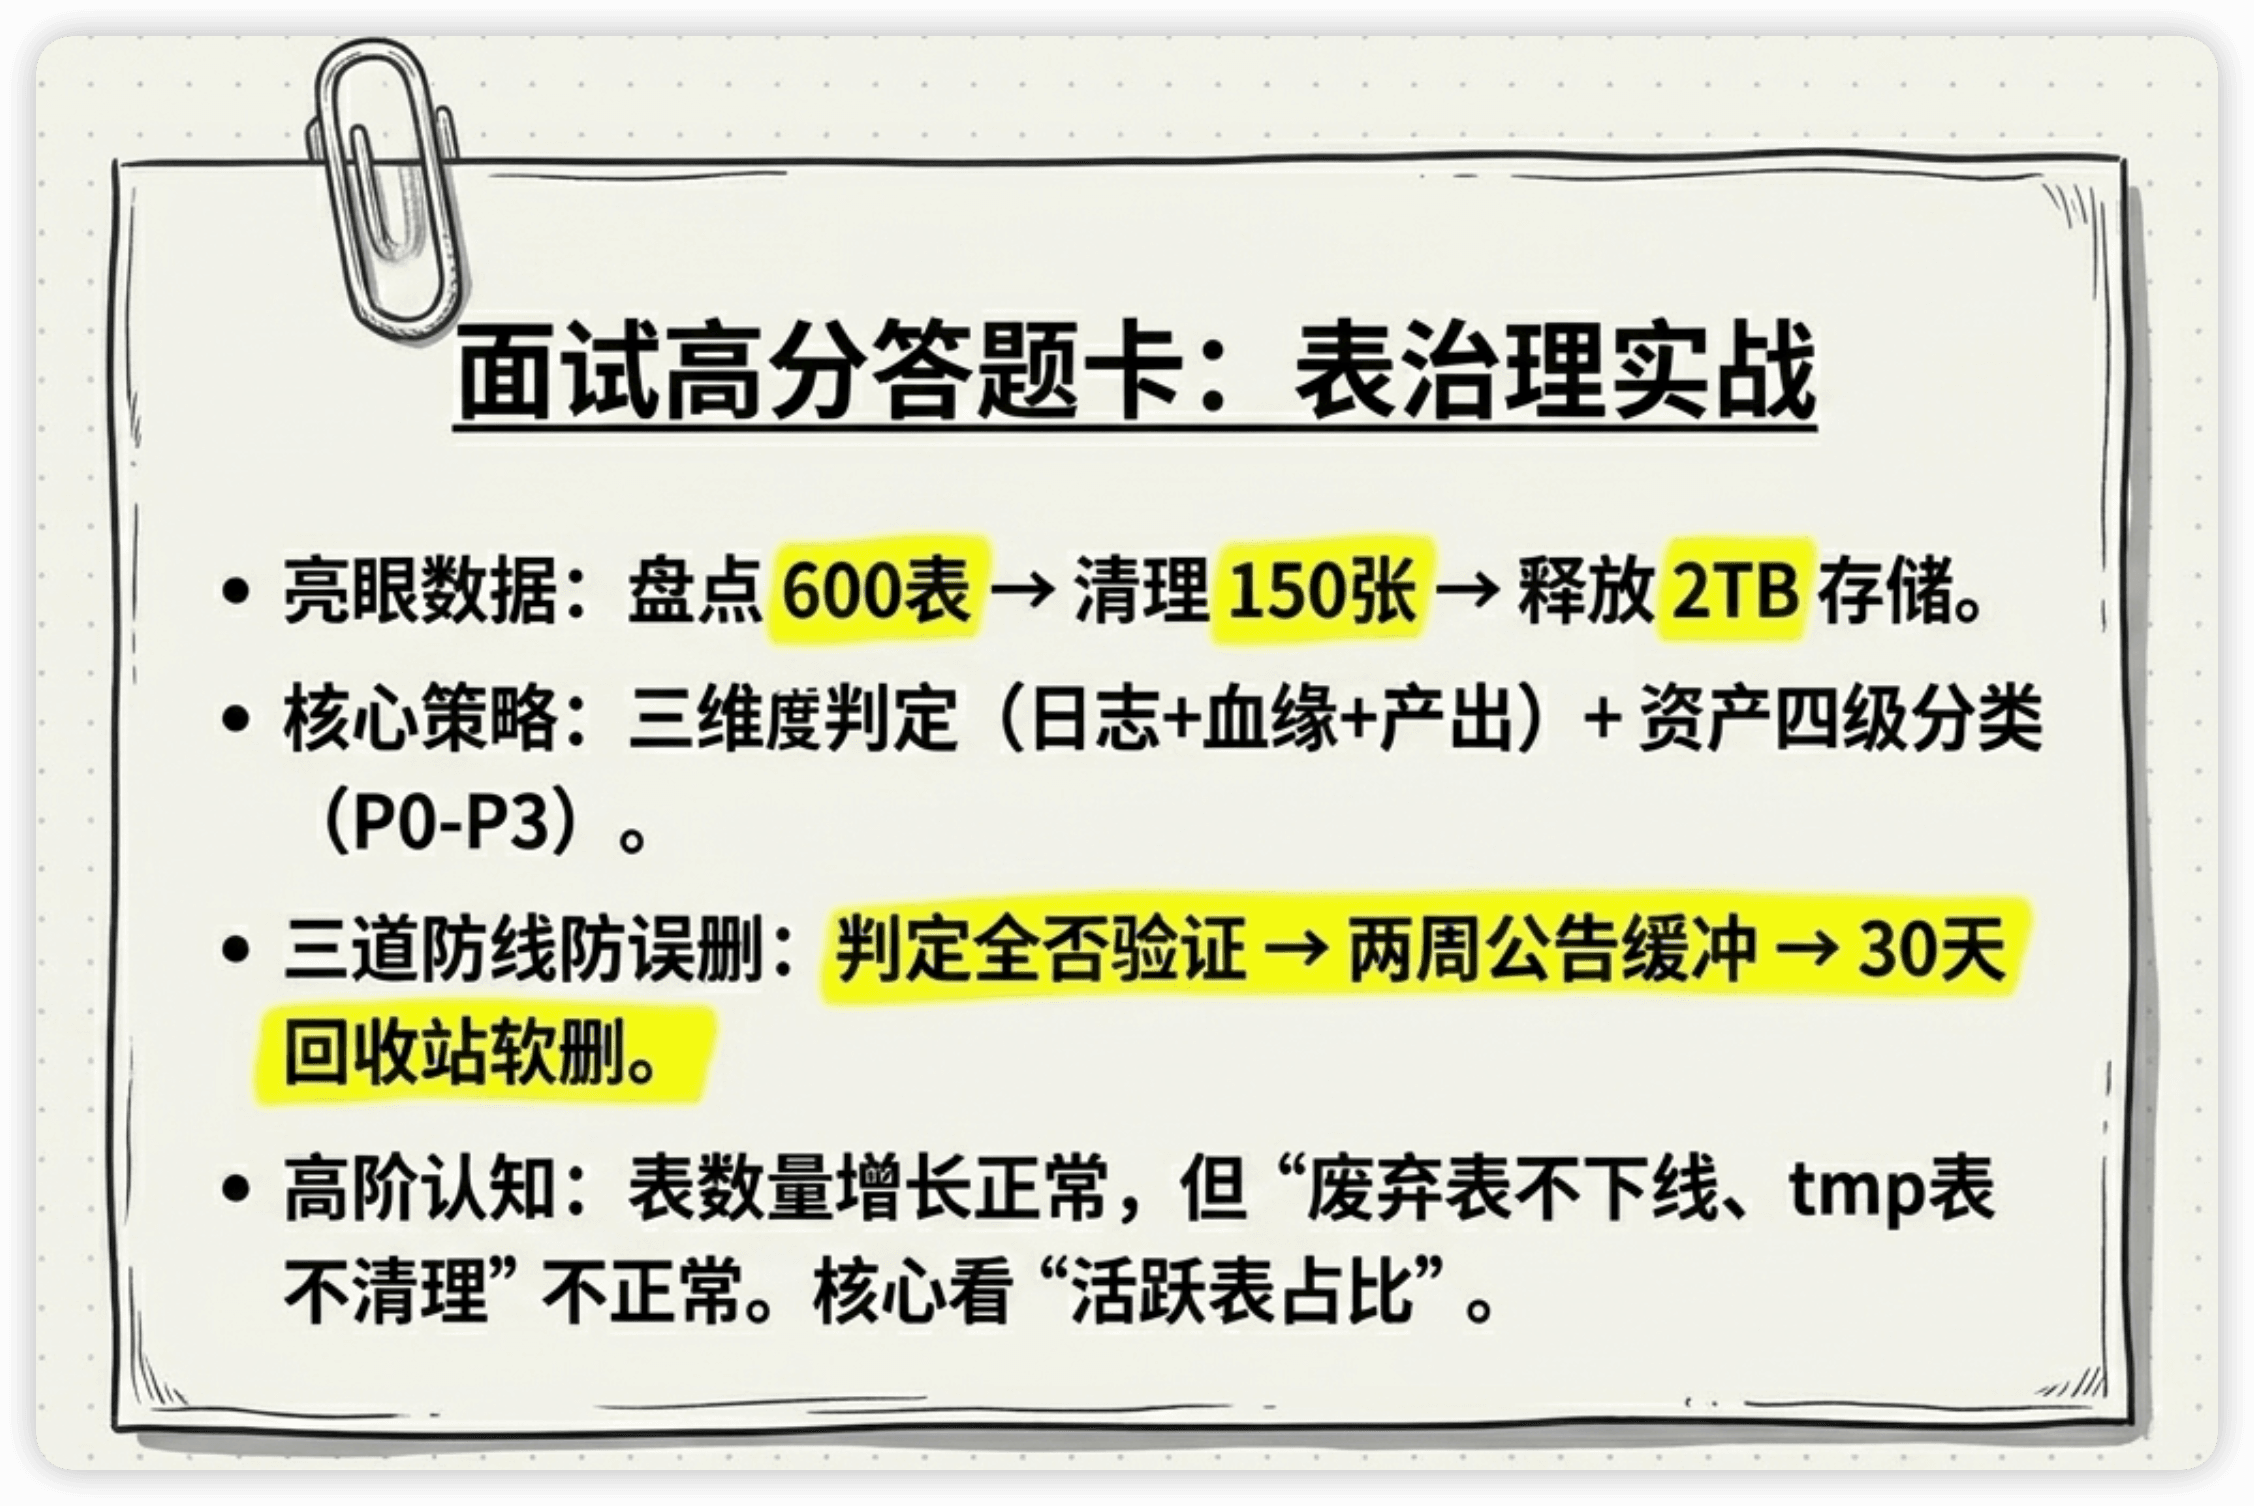
「我在接手数据组时做过一次全量表盘点。600多张表里有效的只有三分之一,其余400张是tmp表、废弃旧表和重复建设。我做了三件事:」
「第一,建立表分级机制,把所有表分为核心、常规、低频、废弃四级,对应不同的维护策略。第二,对废弃表走四步下线流程——标记→通知两周→软删除到回收站30天→物理删除,两个月下线了150张表,释放了约2TB存储。第三,制定预防措施,tmp表强制带日期后缀且30天自动清理,非tmp建表需审批,每月自动出表资产报告。」
追问防线
追问1:怎么确保不误删?
三道保险。第一道是三维度判定——查询日志、血缘依赖、产出状态全部确认无人使用才标记废弃。第二道是两周通知期——给可能的使用者反馈机会。第三道是30天回收站——即使误删也能快速恢复。三道保险全过了才物理删除,误删风险极低。
追问2:表越来越多是不是正常的?
表数量增长本身是正常的——业务在发展,需求在增加。不正常的是废弃表不下线、tmp表不清理。核心指标不是"总共有多少张表",而是"活跃表占比"和"废弃表占比"。活跃表占比低于50%就需要做治理了。
追问3:大公司怎么做表治理?
大公司通常有专门的数据资产管理平台(比如阿里的DataWorks数据地图、字节的数据目录),自动采集表的查询频率、血缘关系、存储占用等信息,提供可视化的资产全景视图。小团队没有这些平台,但核心逻辑是一样的——用数据(查询日志+血缘)判断,不靠猜。
总结
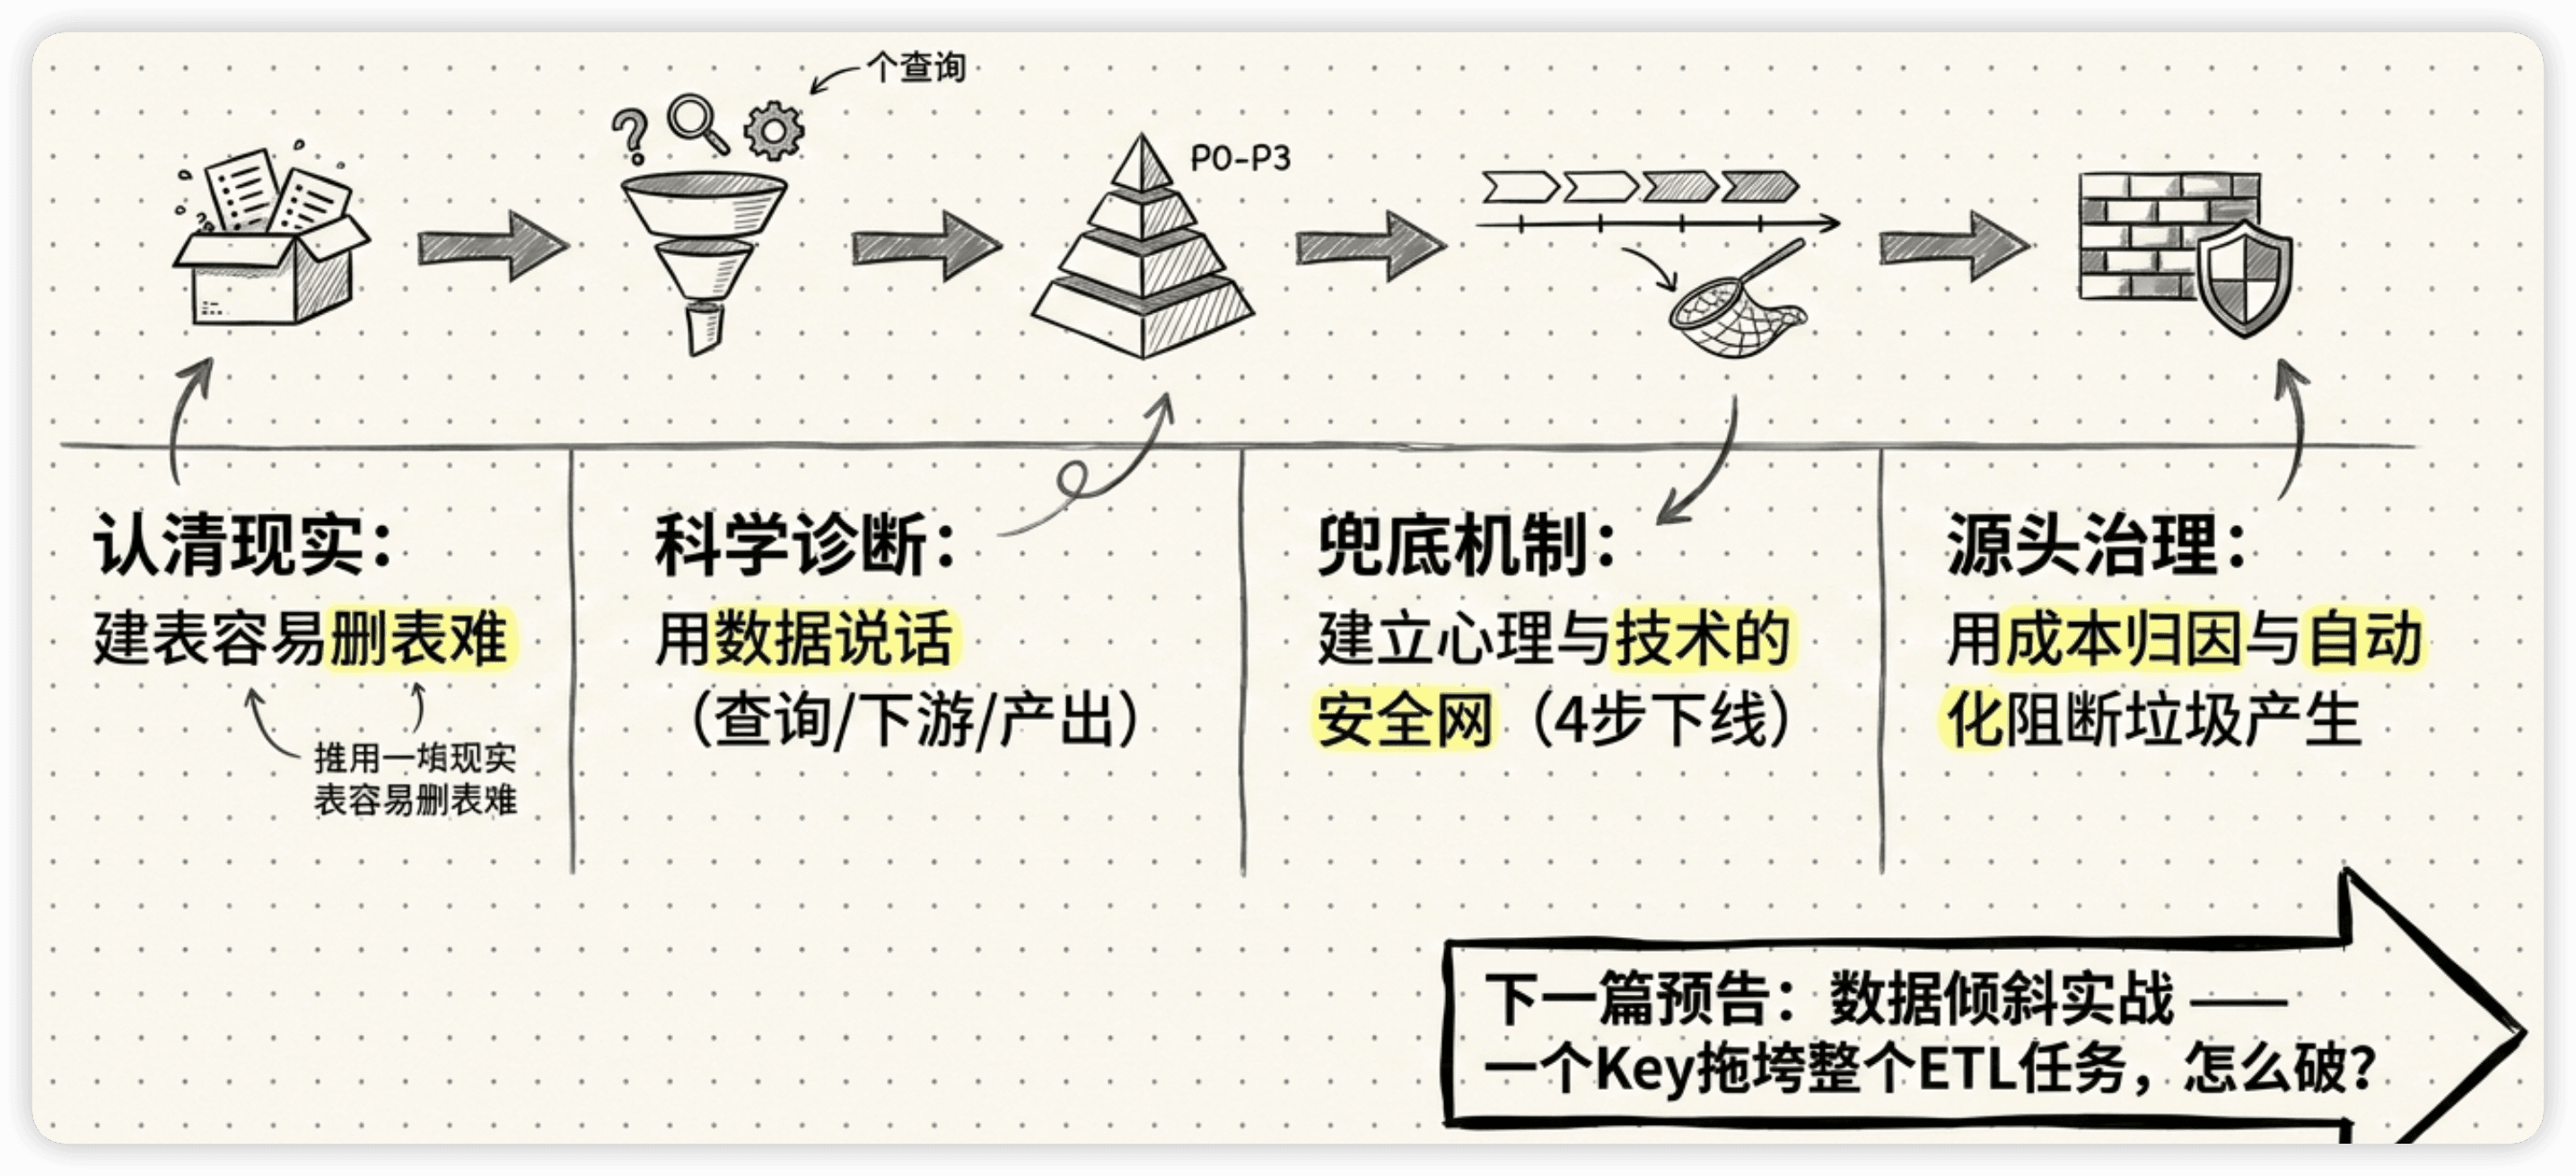
- 中间表泛滥是每个数仓的通病,根因是建表容易删表难
- 判定一张表有没有用:查询频次 + 下游依赖 + 产出状态,三个维度用数据说话
- 表资产分四级:核心 → 常规 → 低频 → 废弃,对应不同处置策略
- 下线四步走:标记 → 通知(2周) → 软删除(30天回收站) → 物理删除
- 预防四措施:tmp带日期+自动清理、建表审批、月度巡检报告、成本归因
- 面试关键:有数字(600张/150张/2TB)、有流程、有预防机制