分区策略
我接手过一个项目,有张核心事实表建的时候没做分区。每天全量扫描1000亿行数据,一条简单的SUM查询跑了4个小时。加了dt分区之后,同样的查询只要8分钟——性能差了30倍。
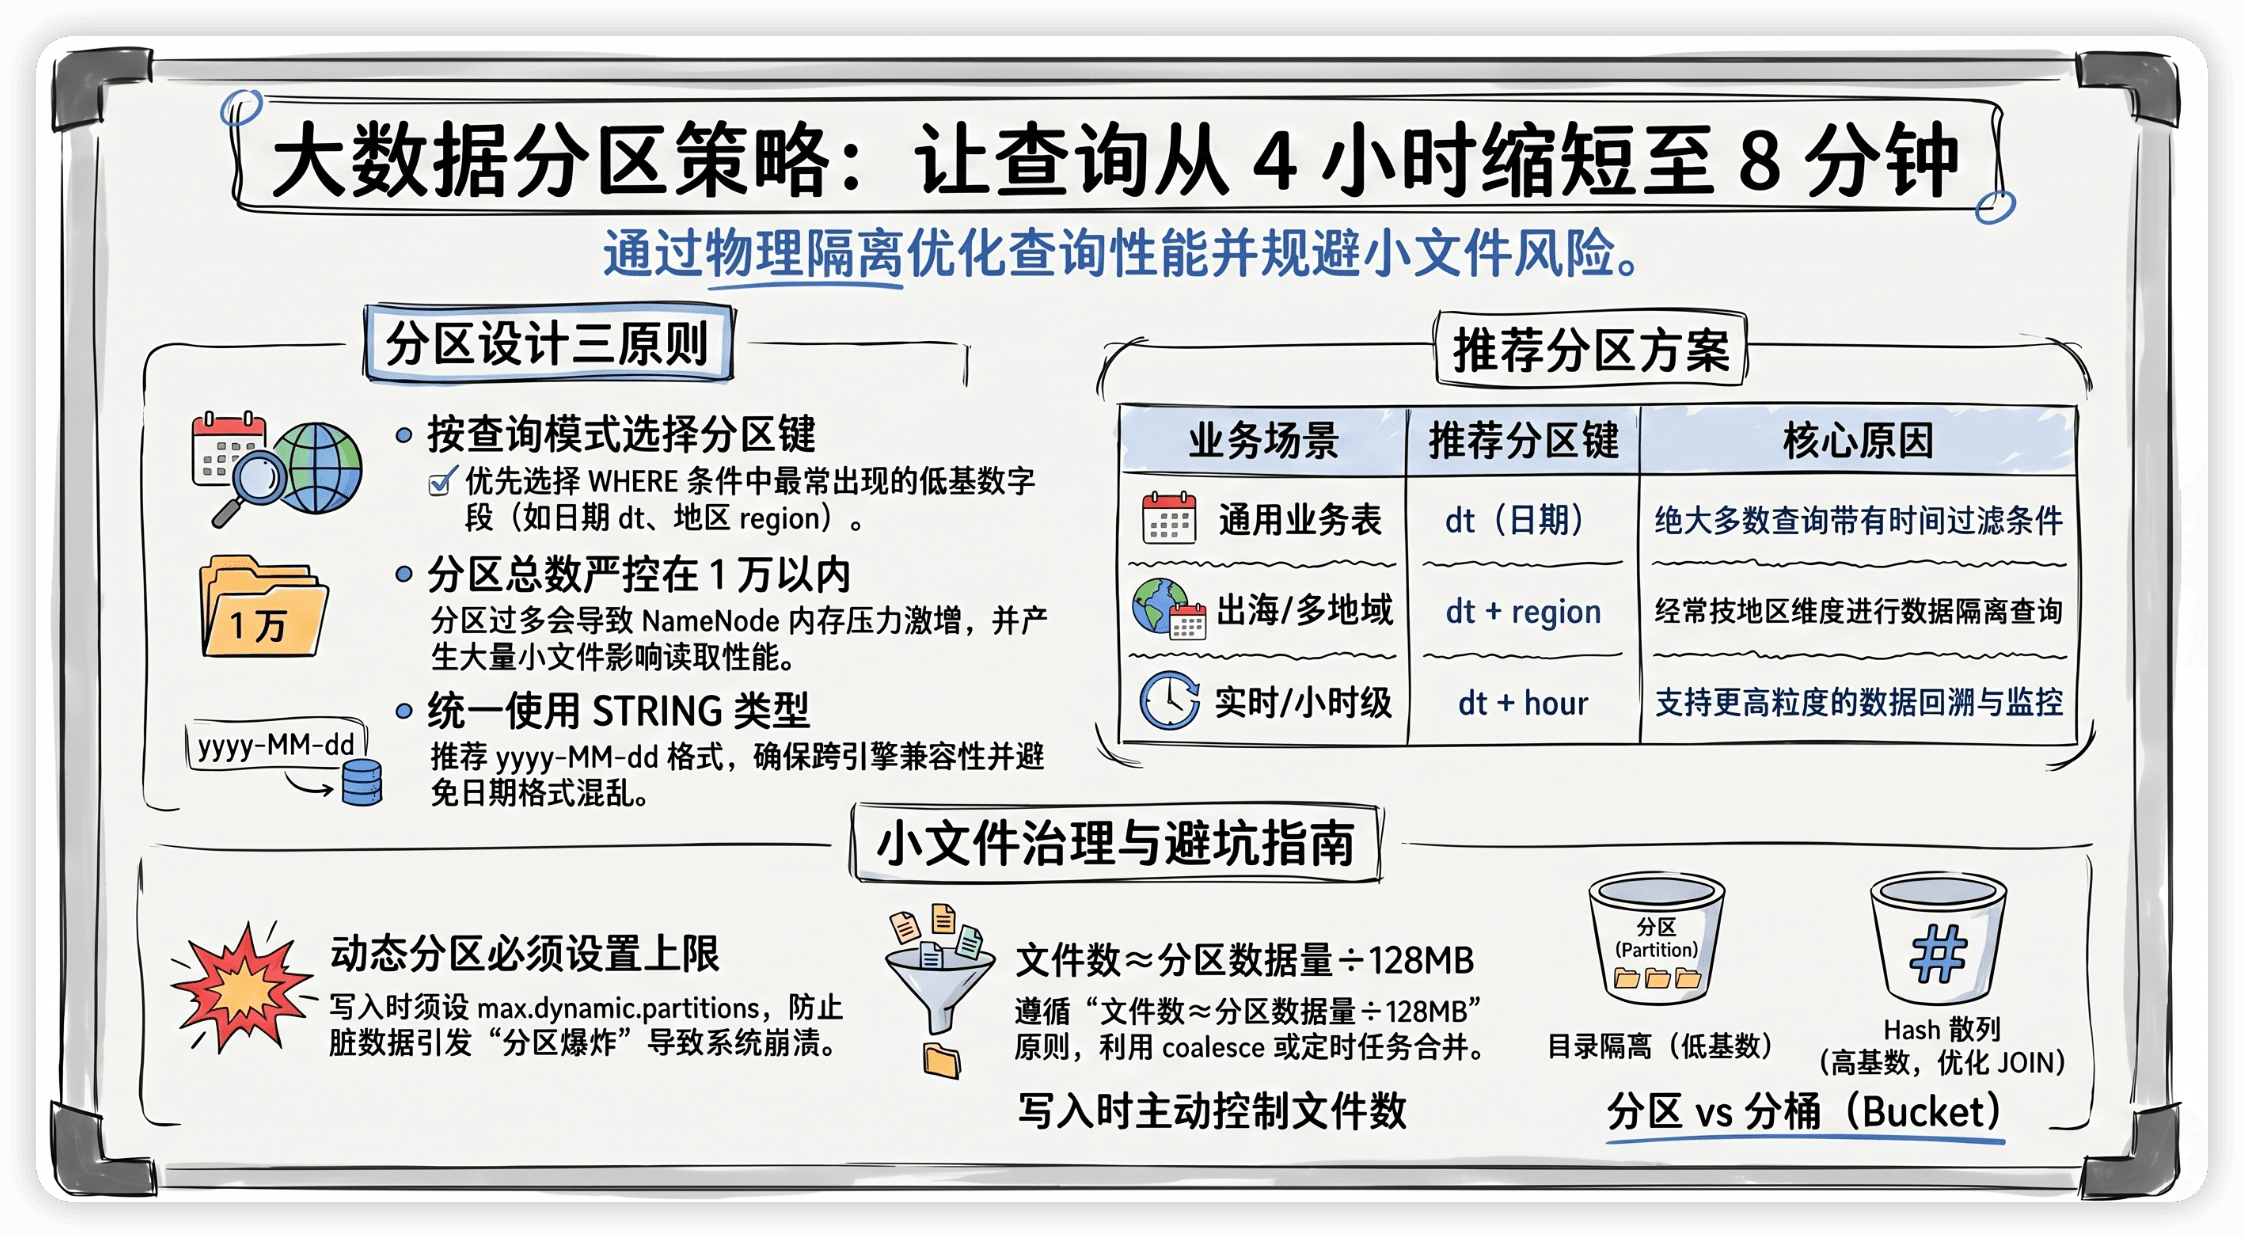 分区设计可能是数仓优化中投入产出比最高的一项操作。不需要改代码逻辑,不需要调参数,只是把数据按目录分开放,性能就能提升几十倍。
但分区设计也有坑——分区太少起不到效果,分区太多引发小文件问题反而更慢。这篇文章我把分区策略从原理到实践到踩坑一次讲清楚。
分区的本质:物理隔离数据
分区不是逻辑概念,它是物理层面的数据隔离。
在Hive/Spark中,每个分区对应HDFS上的一个目录。比如一张按天分区的表:
/warehouse/fact_order/
├── dt=2025-01-13/         ← 1月13日的数据文件
│   ├── part-00000.parquet
│   └── part-00001.parquet
├── dt=2025-01-14/         ← 1月14日的数据文件
│   └── part-00000.parquet
└── dt=2025-01-15/         ← 1月15日的数据文件
    ├── part-00000.parquet
    └── part-00001.parquet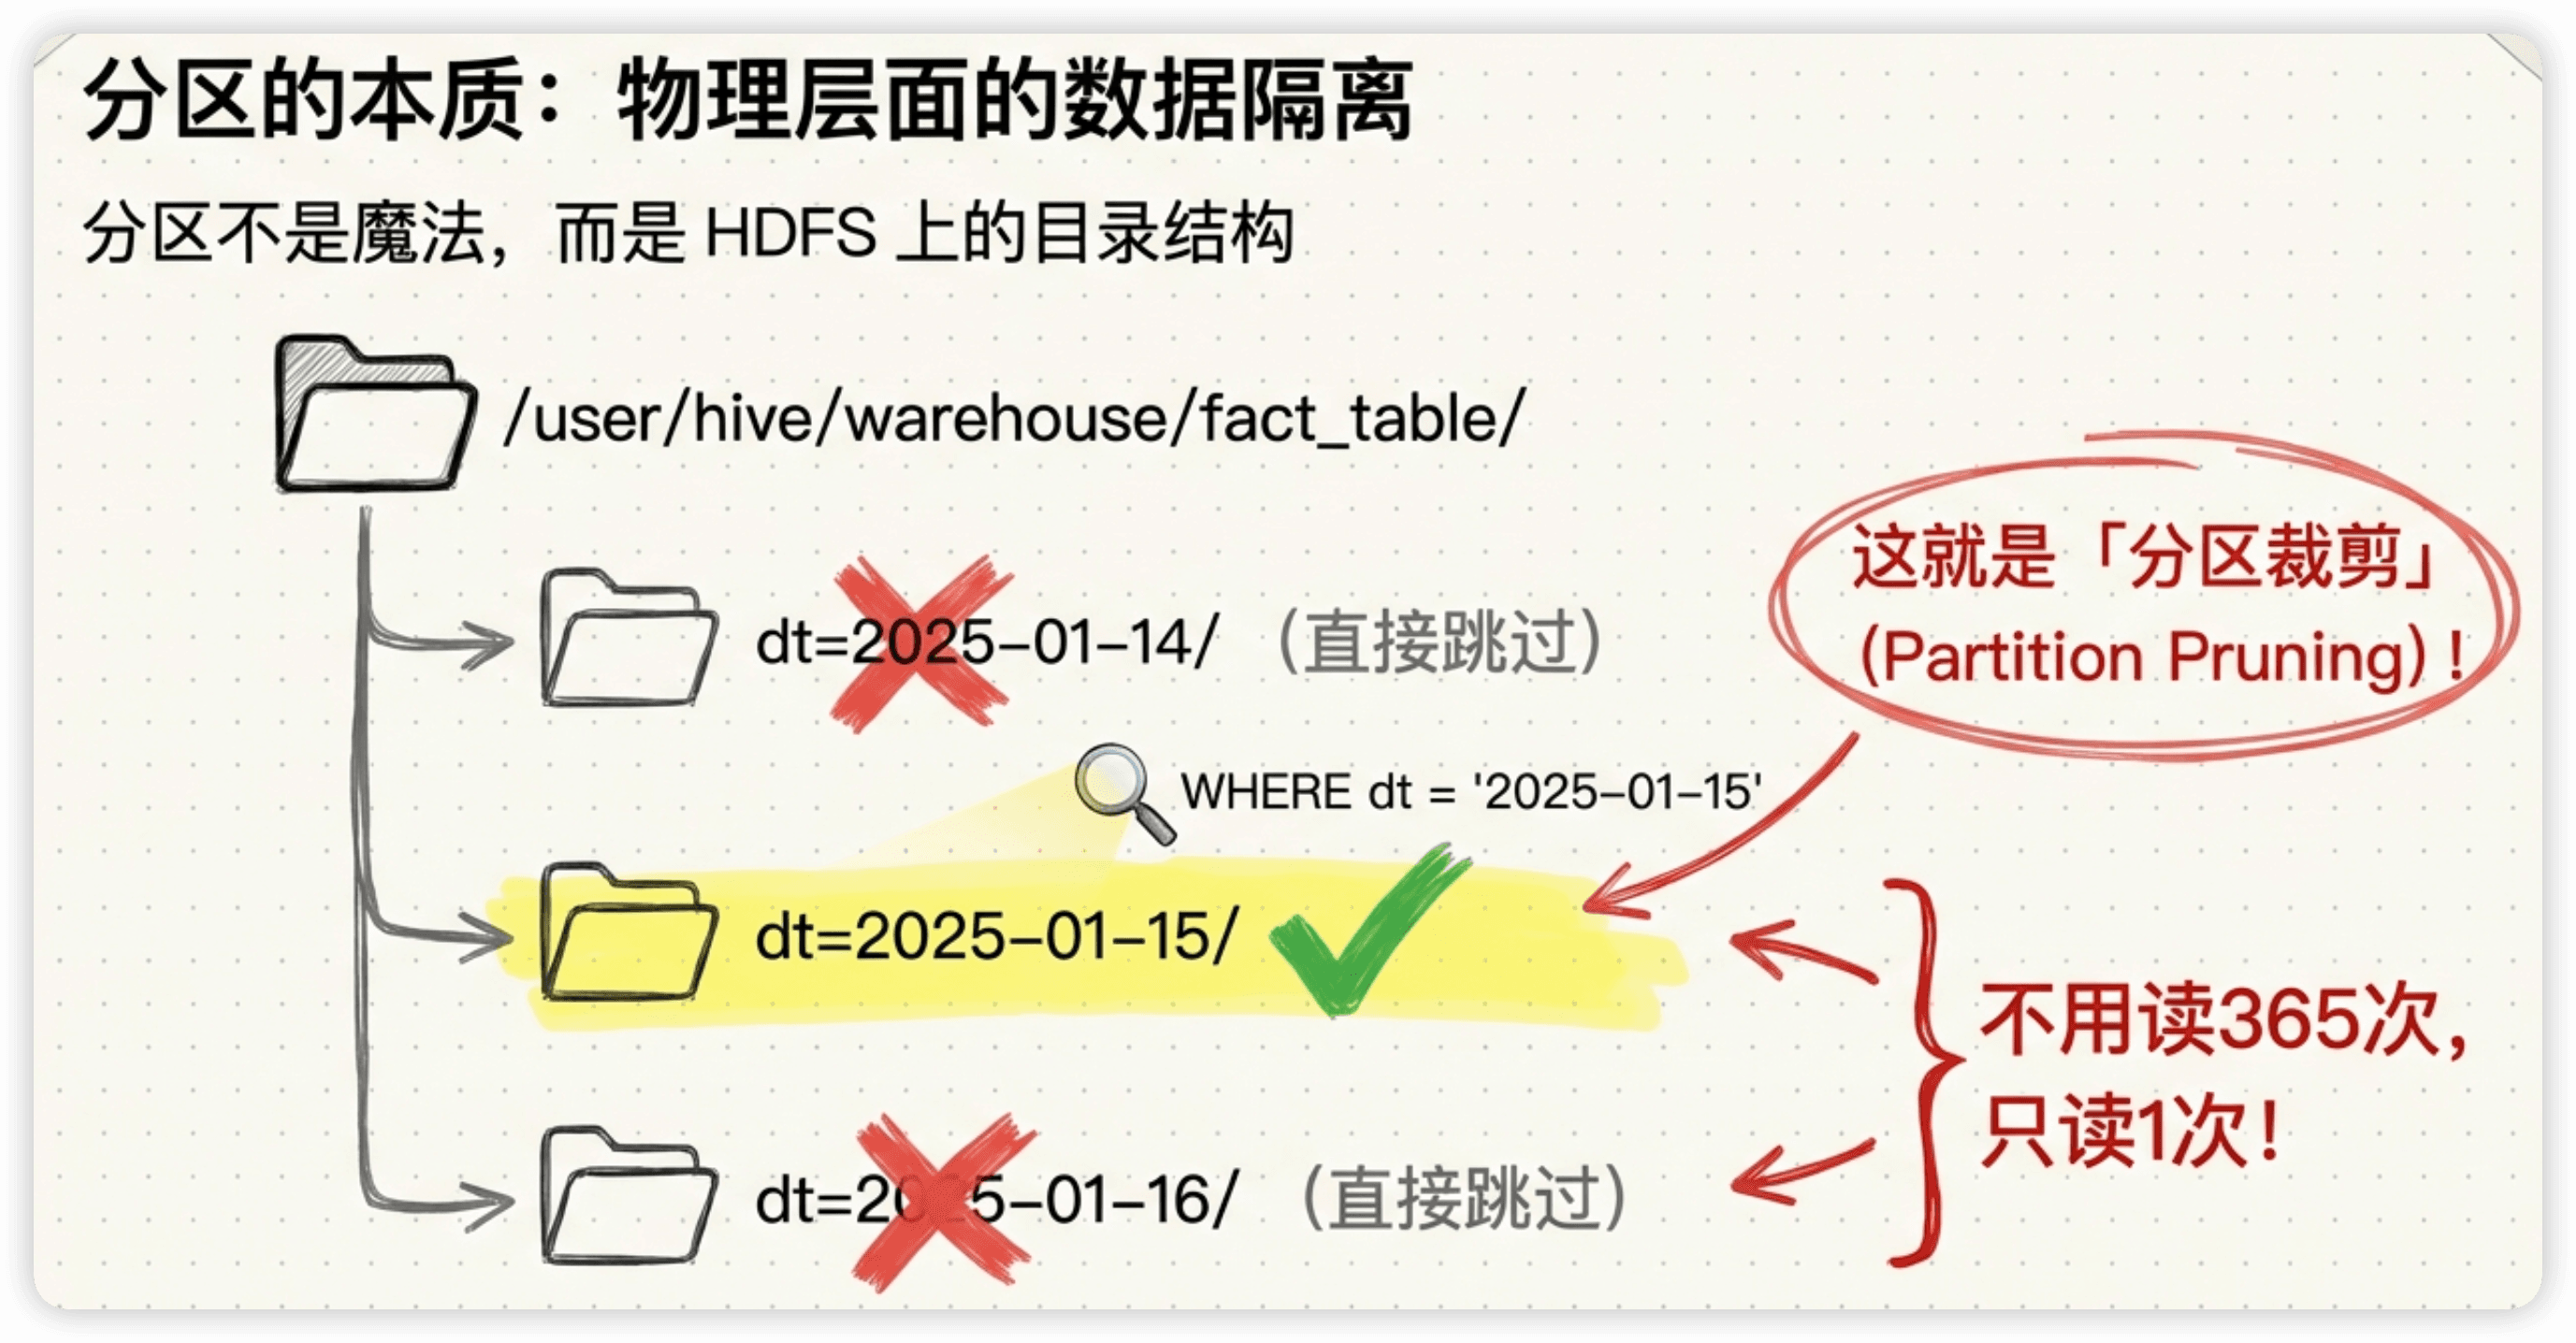
当你的SQL里写了WHERE dt = '2025-01-15',引擎只会读dt=2025-01-15/这个目录下的文件,完全跳过其他364天的数据。这就是分区裁剪(Partition Pruning)。
没有分区的话,引擎只能把所有文件都读一遍再过滤——数据量是365倍。
分区设计三原则
原则一:按查询模式选分区键
分区键要选WHERE条件里最常出现的字段。如果90%的查询都有WHERE dt = ...,那dt就是最合适的分区键。
| 业务场景 | 推荐分区键 | 原因 |
|---|---|---|
| 大部分业务表 | dt(日期) | 几乎所有查询都有时间范围条件 |
| 出海/多地域业务 | dt + region | 经常按地区过滤 |
| 多业务线共用表 | dt + biz_type | 不同业务线的数据量差异大,隔离后查询更快 |
| 实时/小时级任务 | dt + hour | 需要小时级粒度查询 |
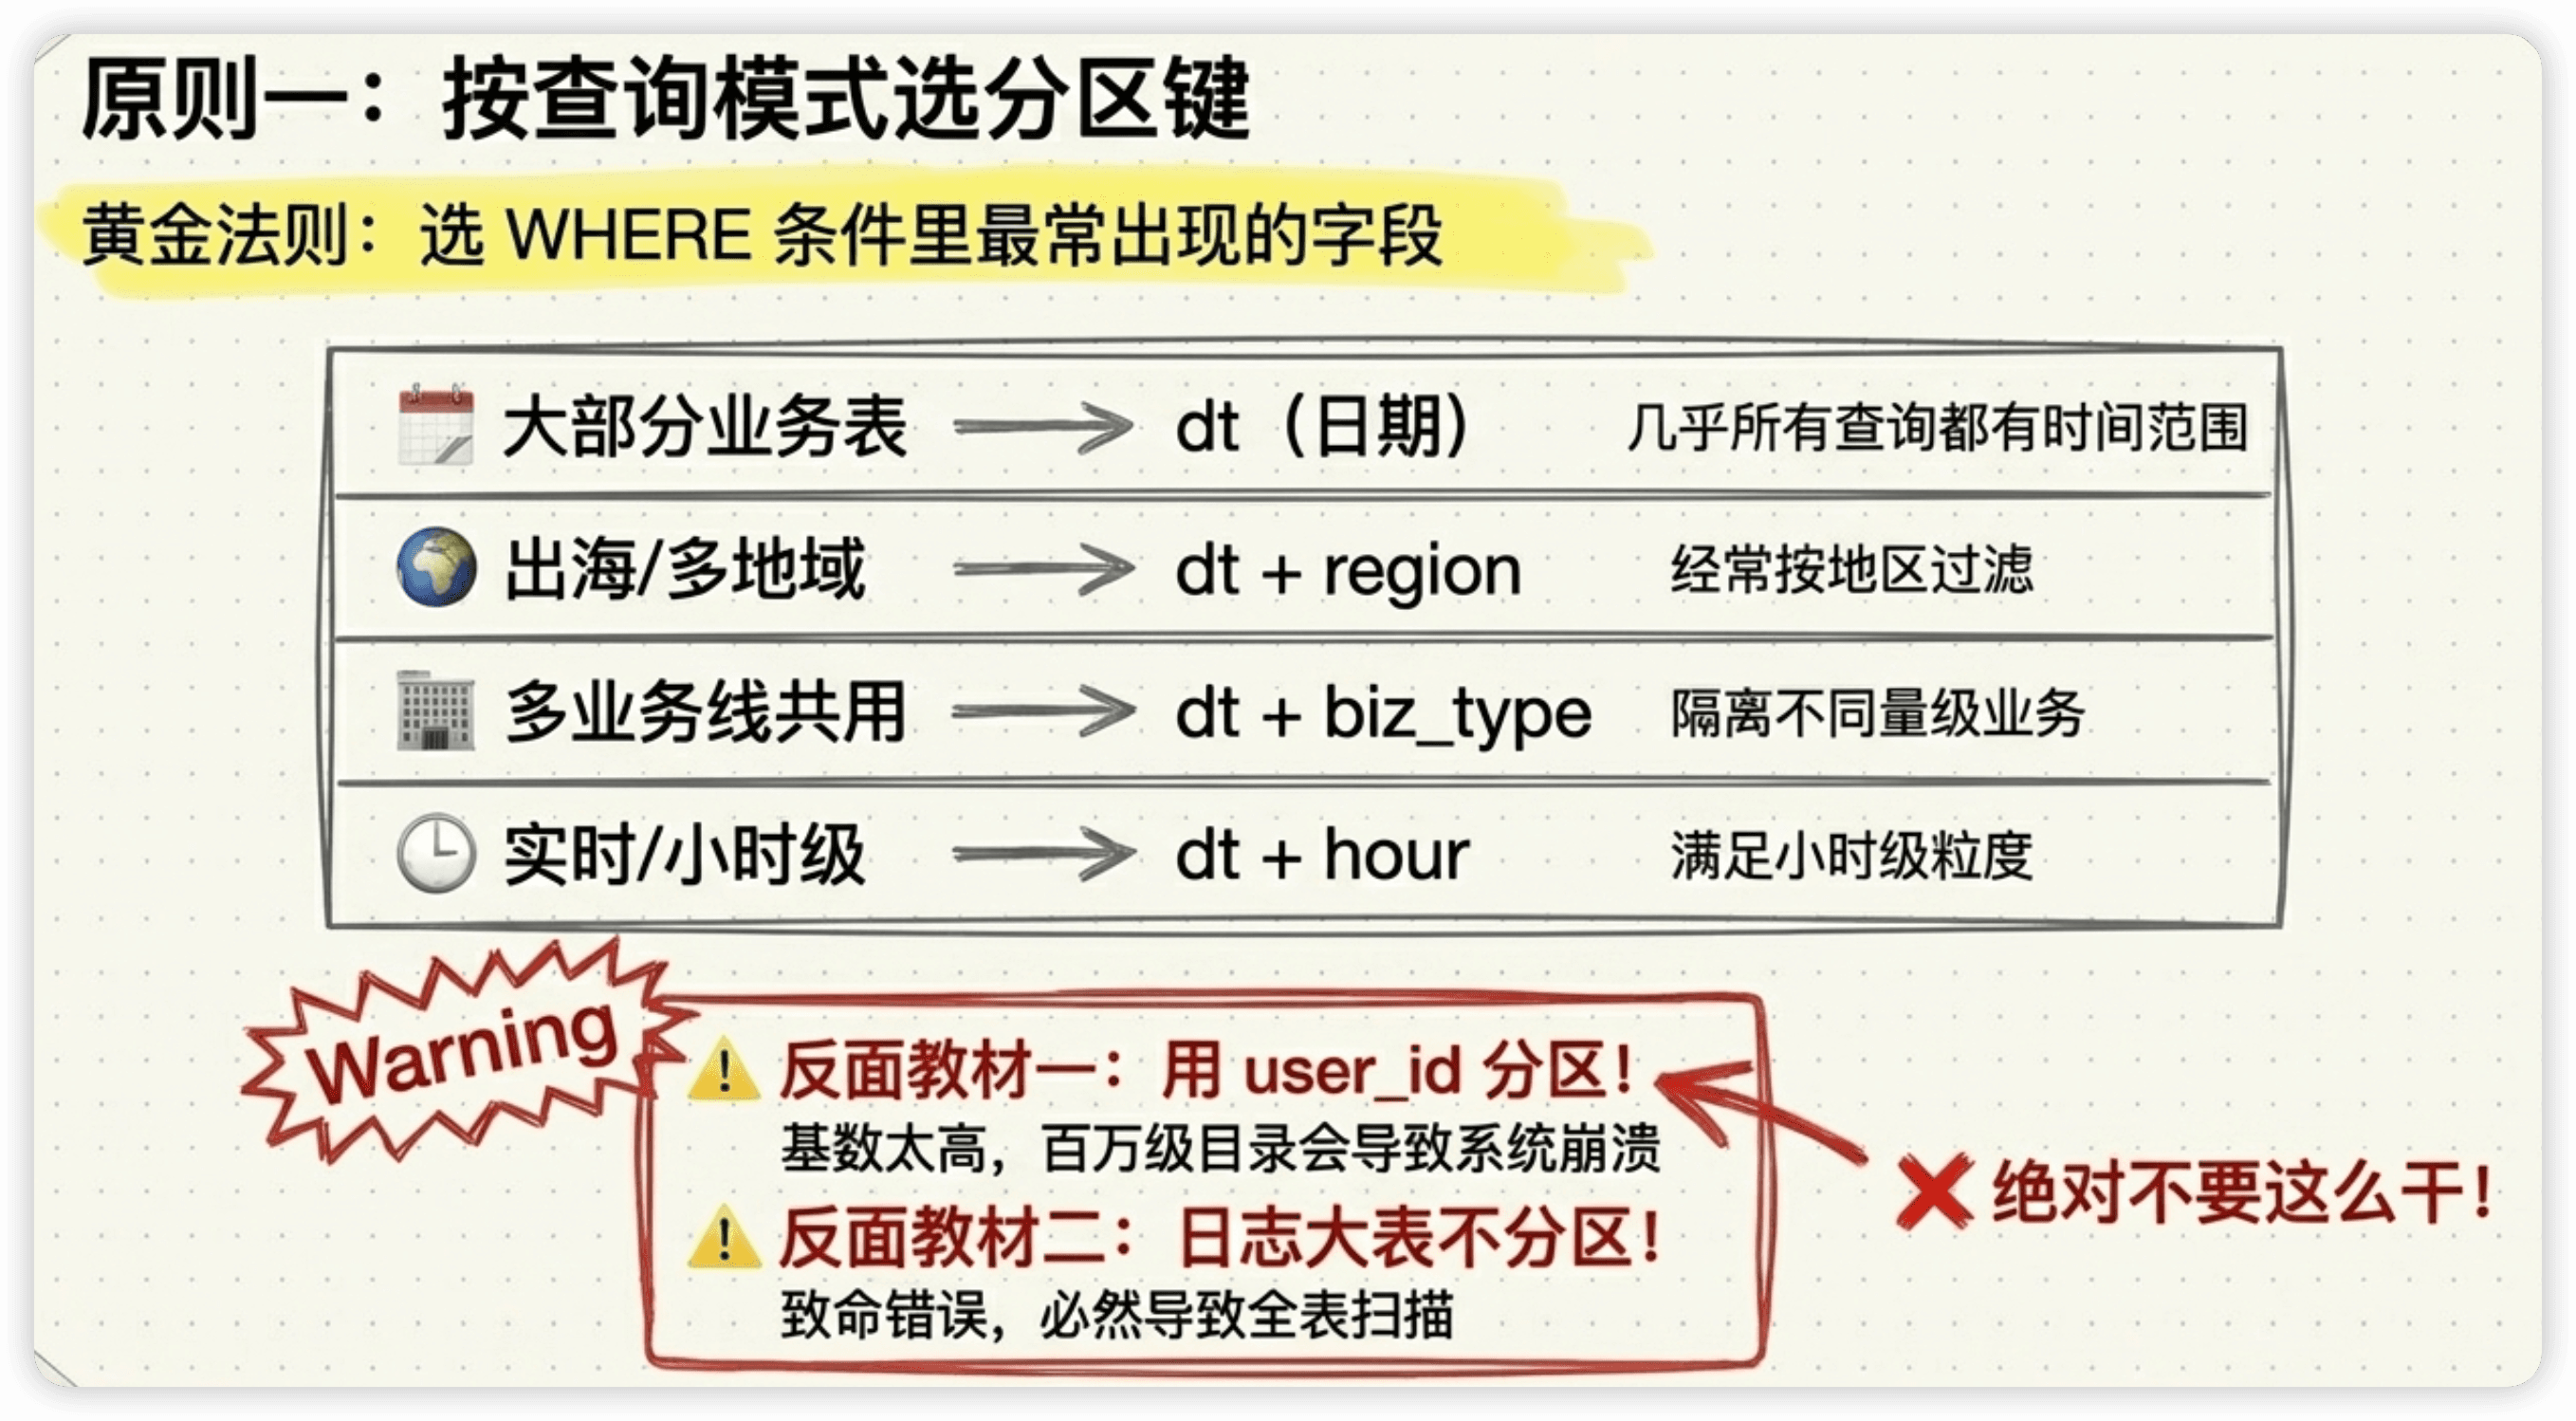
反面教材一:用user_id做分区。
❌ PARTITIONED BY (user_id BIGINT)
-- 用户量500万,就有500万个分区
-- HDFS NameNode元数据直接炸了
分区键的基数(distinct值的数量)不能太高。日期一年365个值,地区10-50个值——这些是合理的。user_id几百万甚至几千万个值,完全不适合做分区。
反面教材二:不用分区。
❌ CREATE TABLE fact_event_log (...);  -- 每天5000万行,没分区
-- 查最近一天的数据要扫描全部历史
日志类、事件类的大表,不加分区是致命的。
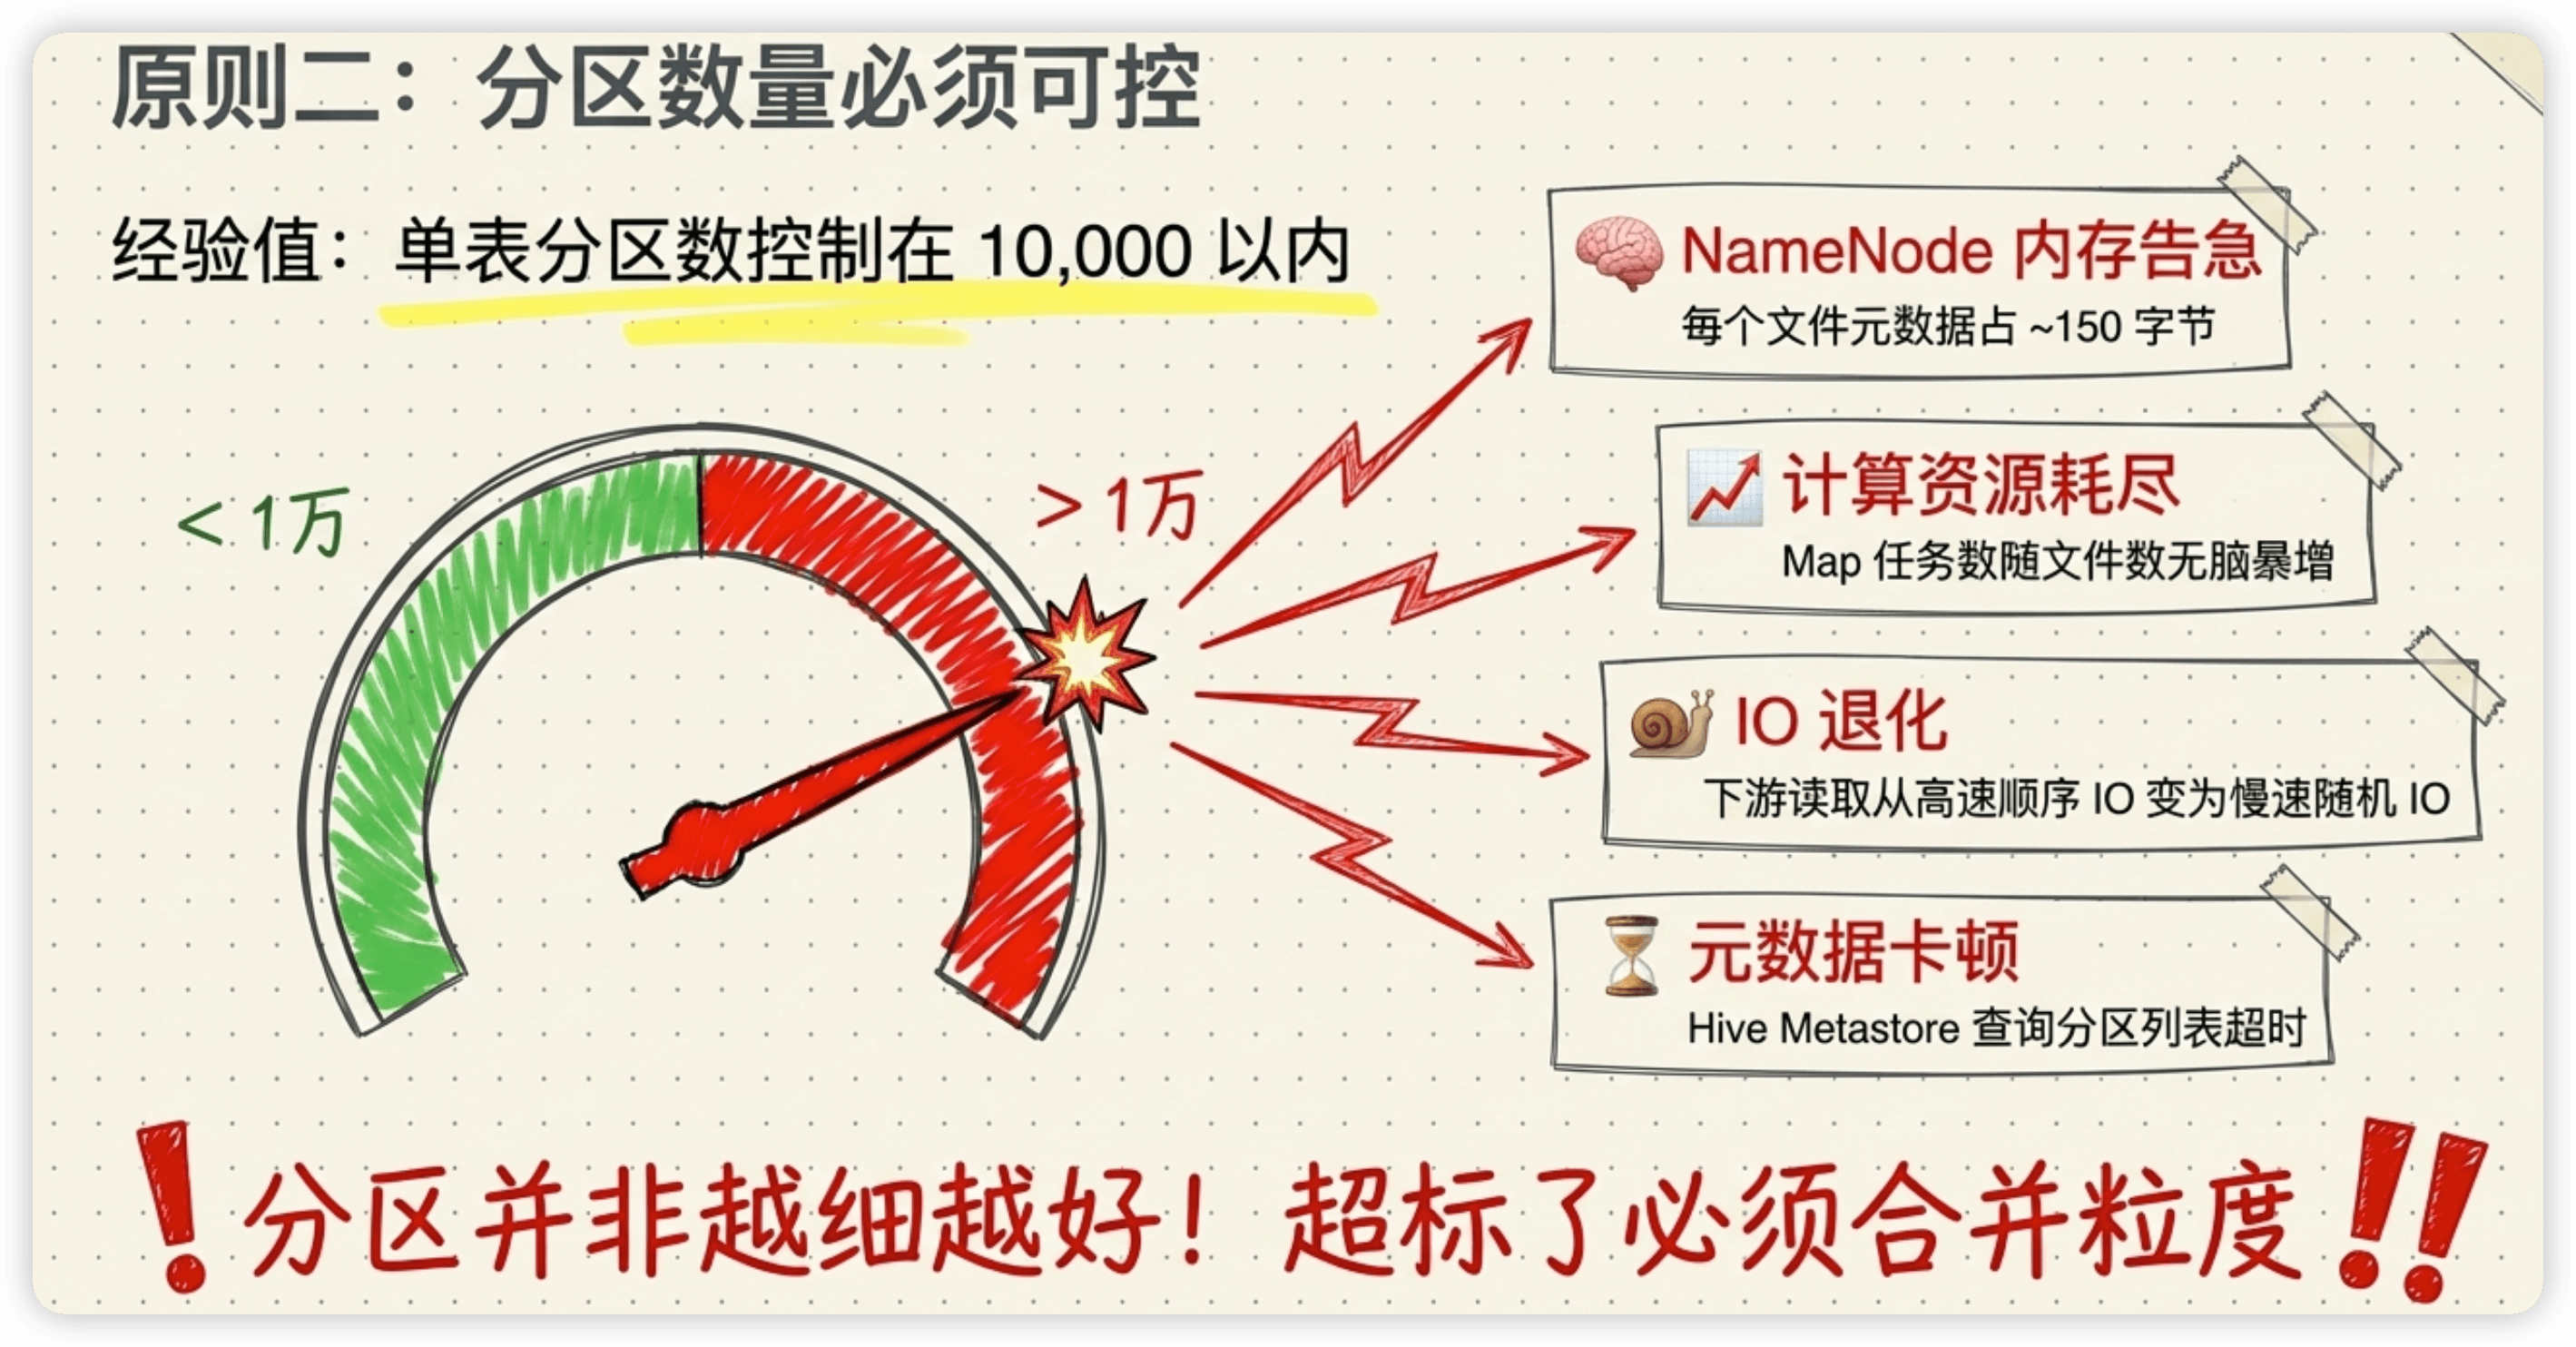
原则二:分区数量要可控
分区并非越细越好。每个分区在HDFS上至少对应一个文件,分区太多意味着文件太多:
✅ 合理:dt分区,一天一个,一年365个
✅ 合理:dt + region分区,10个地区 × 365天 = 3,650个
⚠️ 注意:dt + hour分区,365 × 24 = 8,760个(如果数据量不大,每个分区文件很小)
❌ 危险:dt + hour + city,365 × 24 × 500城市 = 4,380,000个分区
经验值: 单表分区数控制在1万以内。超过就要考虑合并粒度或换方案。
分区太多的后果:
- HDFS NameNode内存压力大(每个文件约150字节元数据)
- 大量小文件导致Map任务数暴增
- 下游读取性能反而变差(随机IO增多)
- Hive Metastore查询分区列表变慢
原则三:分区键数据类型用STRING
-- ✅ 推荐:STRING类型
dt STRING COMMENT '数据日期,格式yyyy-MM-dd'

-- ❌ 不推荐:DATE/INT类型
dt DATE    -- 不同引擎对DATE分区的行为不一致
dt INT -- 20250115这种数字格式不直观,容易混淆STRING类型最通用、最灵活,跨引擎兼容性最好。日期格式统一用yyyy-MM-dd,不要有的表用20250115有的用2025-01-15——统一才能避免混乱。
动态分区 vs 静态分区
静态分区:手动指定,日常调度用
-- 明确指定写入哪个分区
INSERT OVERWRITE TABLE fact_order PARTITION(dt='2025-01-15')
SELECT order_id, user_id, amount
FROM ods_order
WHERE dt = '2025-01-15';
每天的调度任务用静态分区最安全——你明确知道数据写到了哪个分区,不会写错。
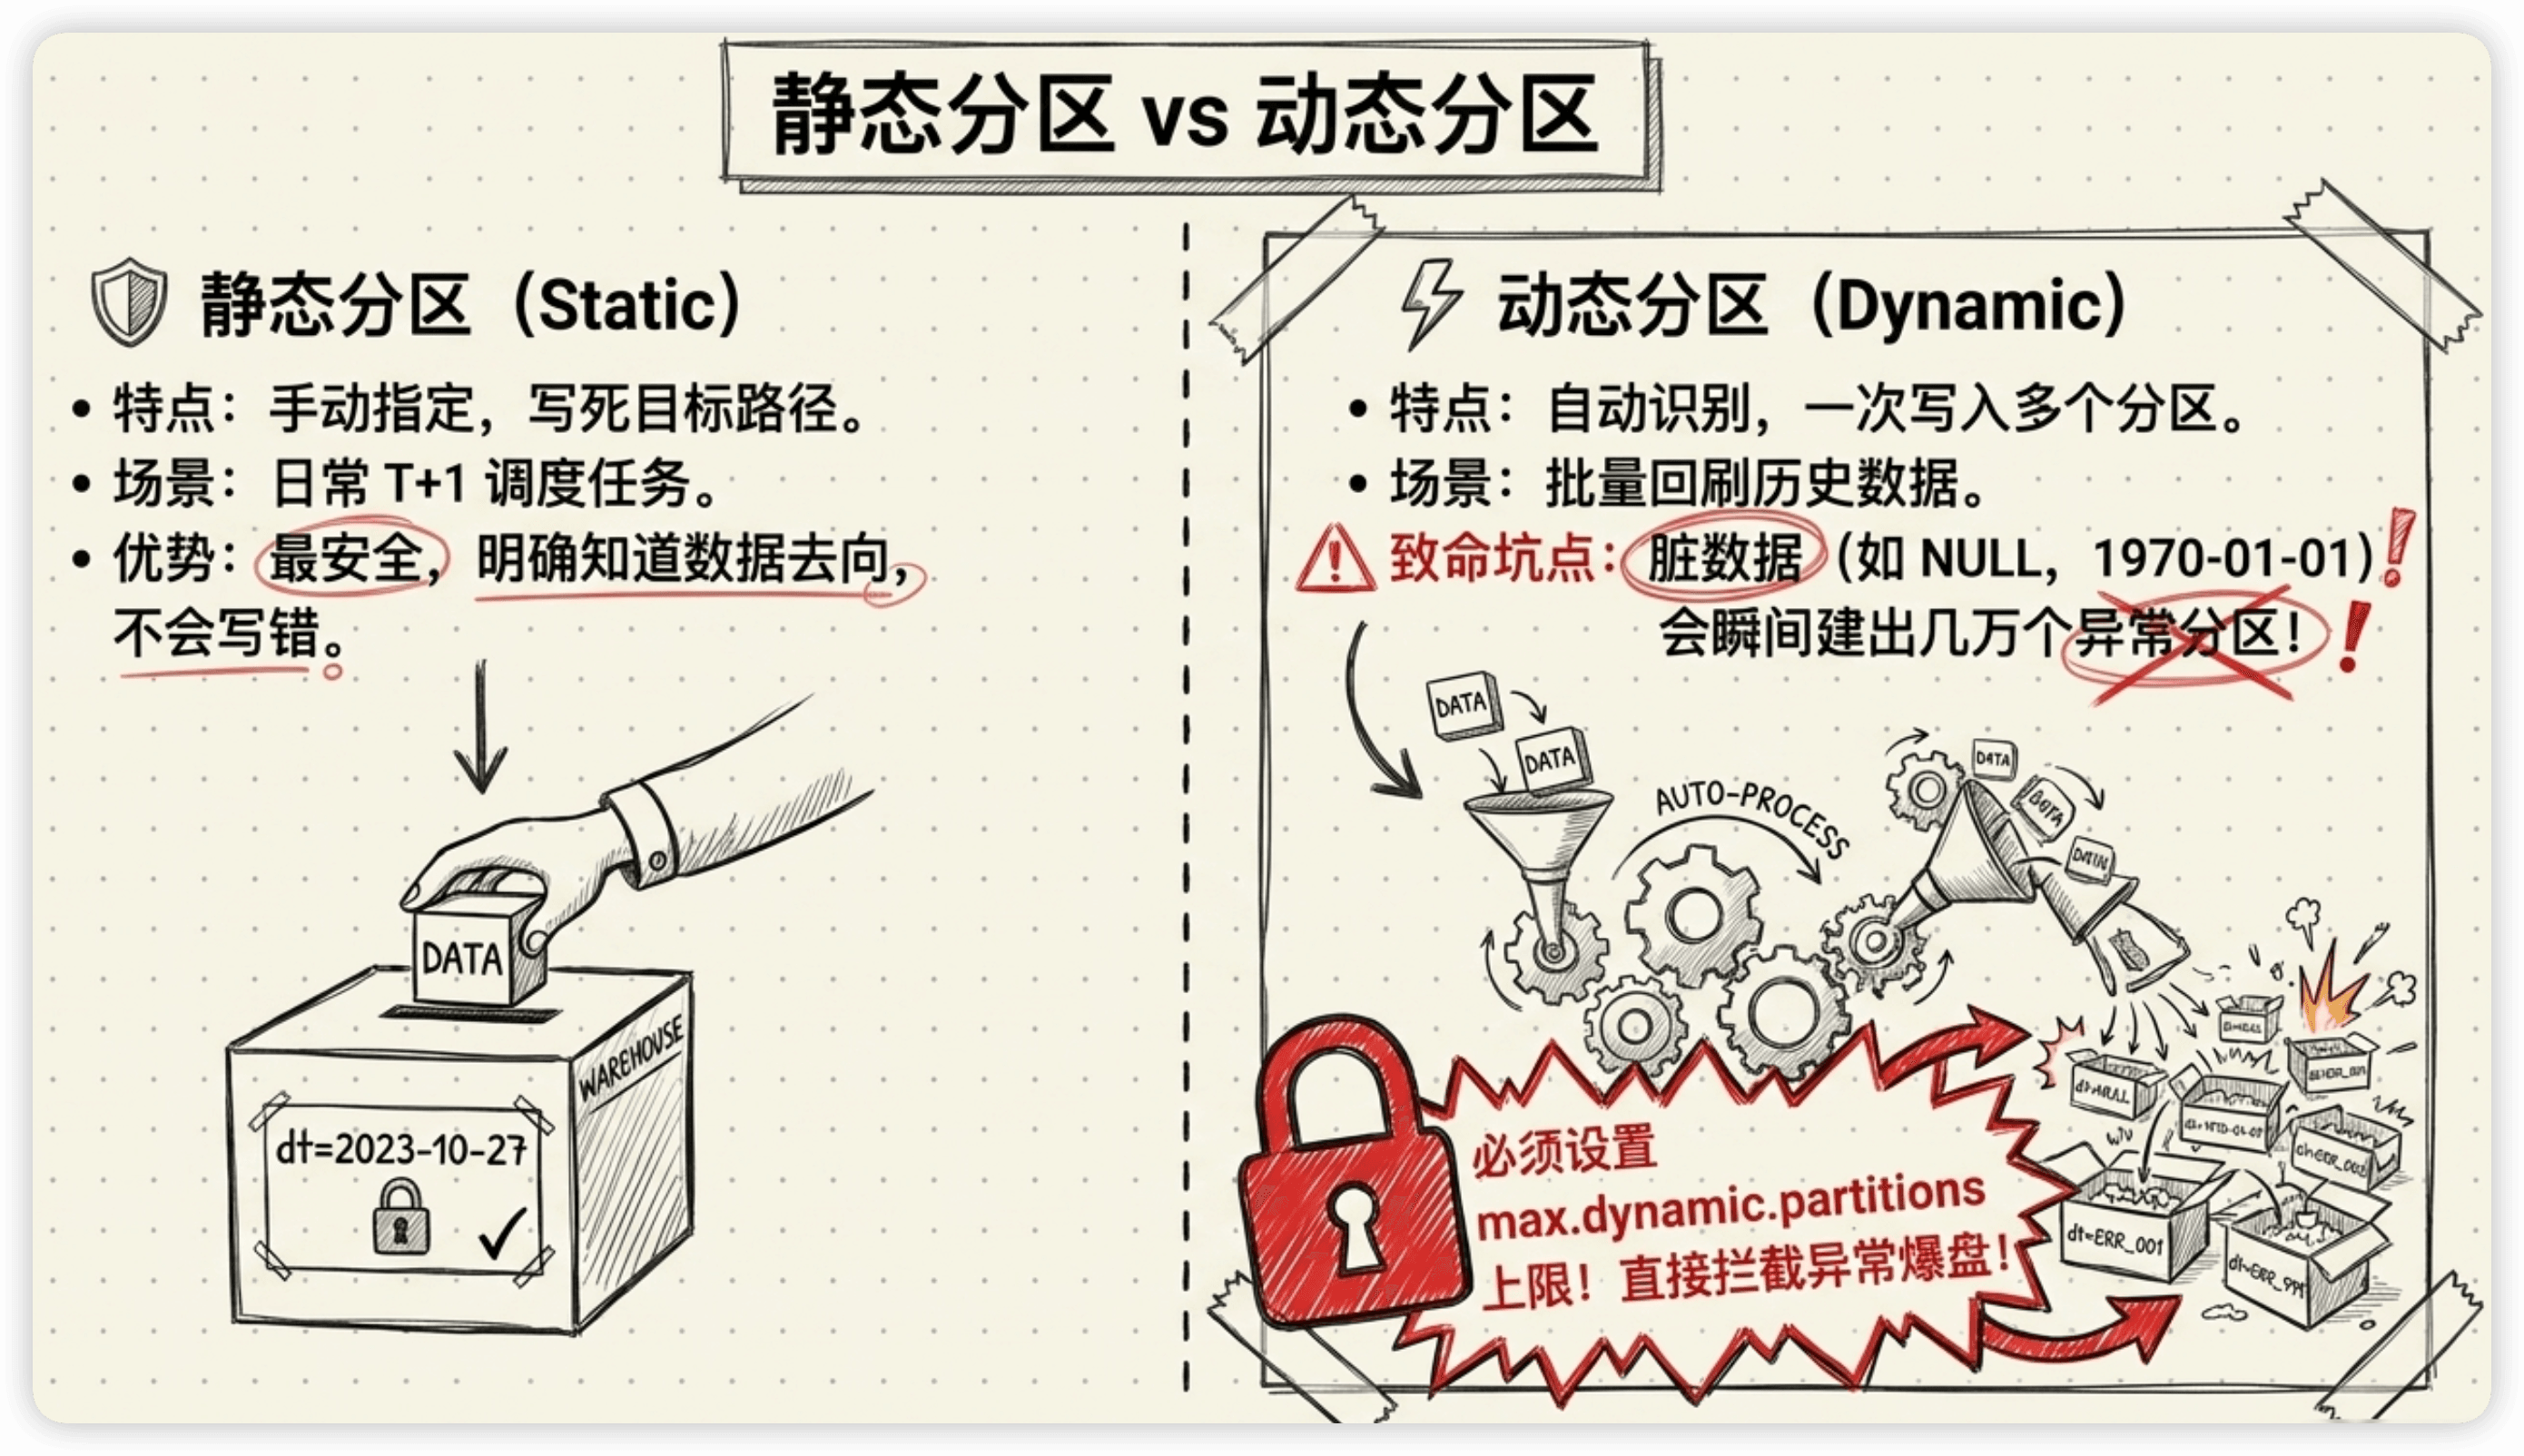
动态分区:自动识别,批量写入用
-- Hive开启动态分区
SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;
SET hive.exec.max.dynamic.partitions=2000;  -- 安全上限!

-- 数据根据字段值自动写入对应分区
INSERT OVERWRITE TABLE fact_order PARTITION(dt, region)
SELECT order_id, user_id, amount, dt, region
FROM ods_order
WHERE dt BETWEEN '2025-01-01' AND '2025-01-15';动态分区适合回刷历史数据的场景——一次写入多个分区,不用逐天跑。
但一定要设
max.dynamic.partitions上限!我有一次用动态分区回刷历史数据,没设上限,源表里有一些脏数据导致dt字段出现了几千个异常值(如NULL、1970-01-01),一口气创建了5万个分区,NameNode直接告警。加了上限之后再跑,超限的任务会自动失败而不是继续创建,安全多了。
分区与小文件问题
分区设计不当最容易引发的副作用就是小文件问题。
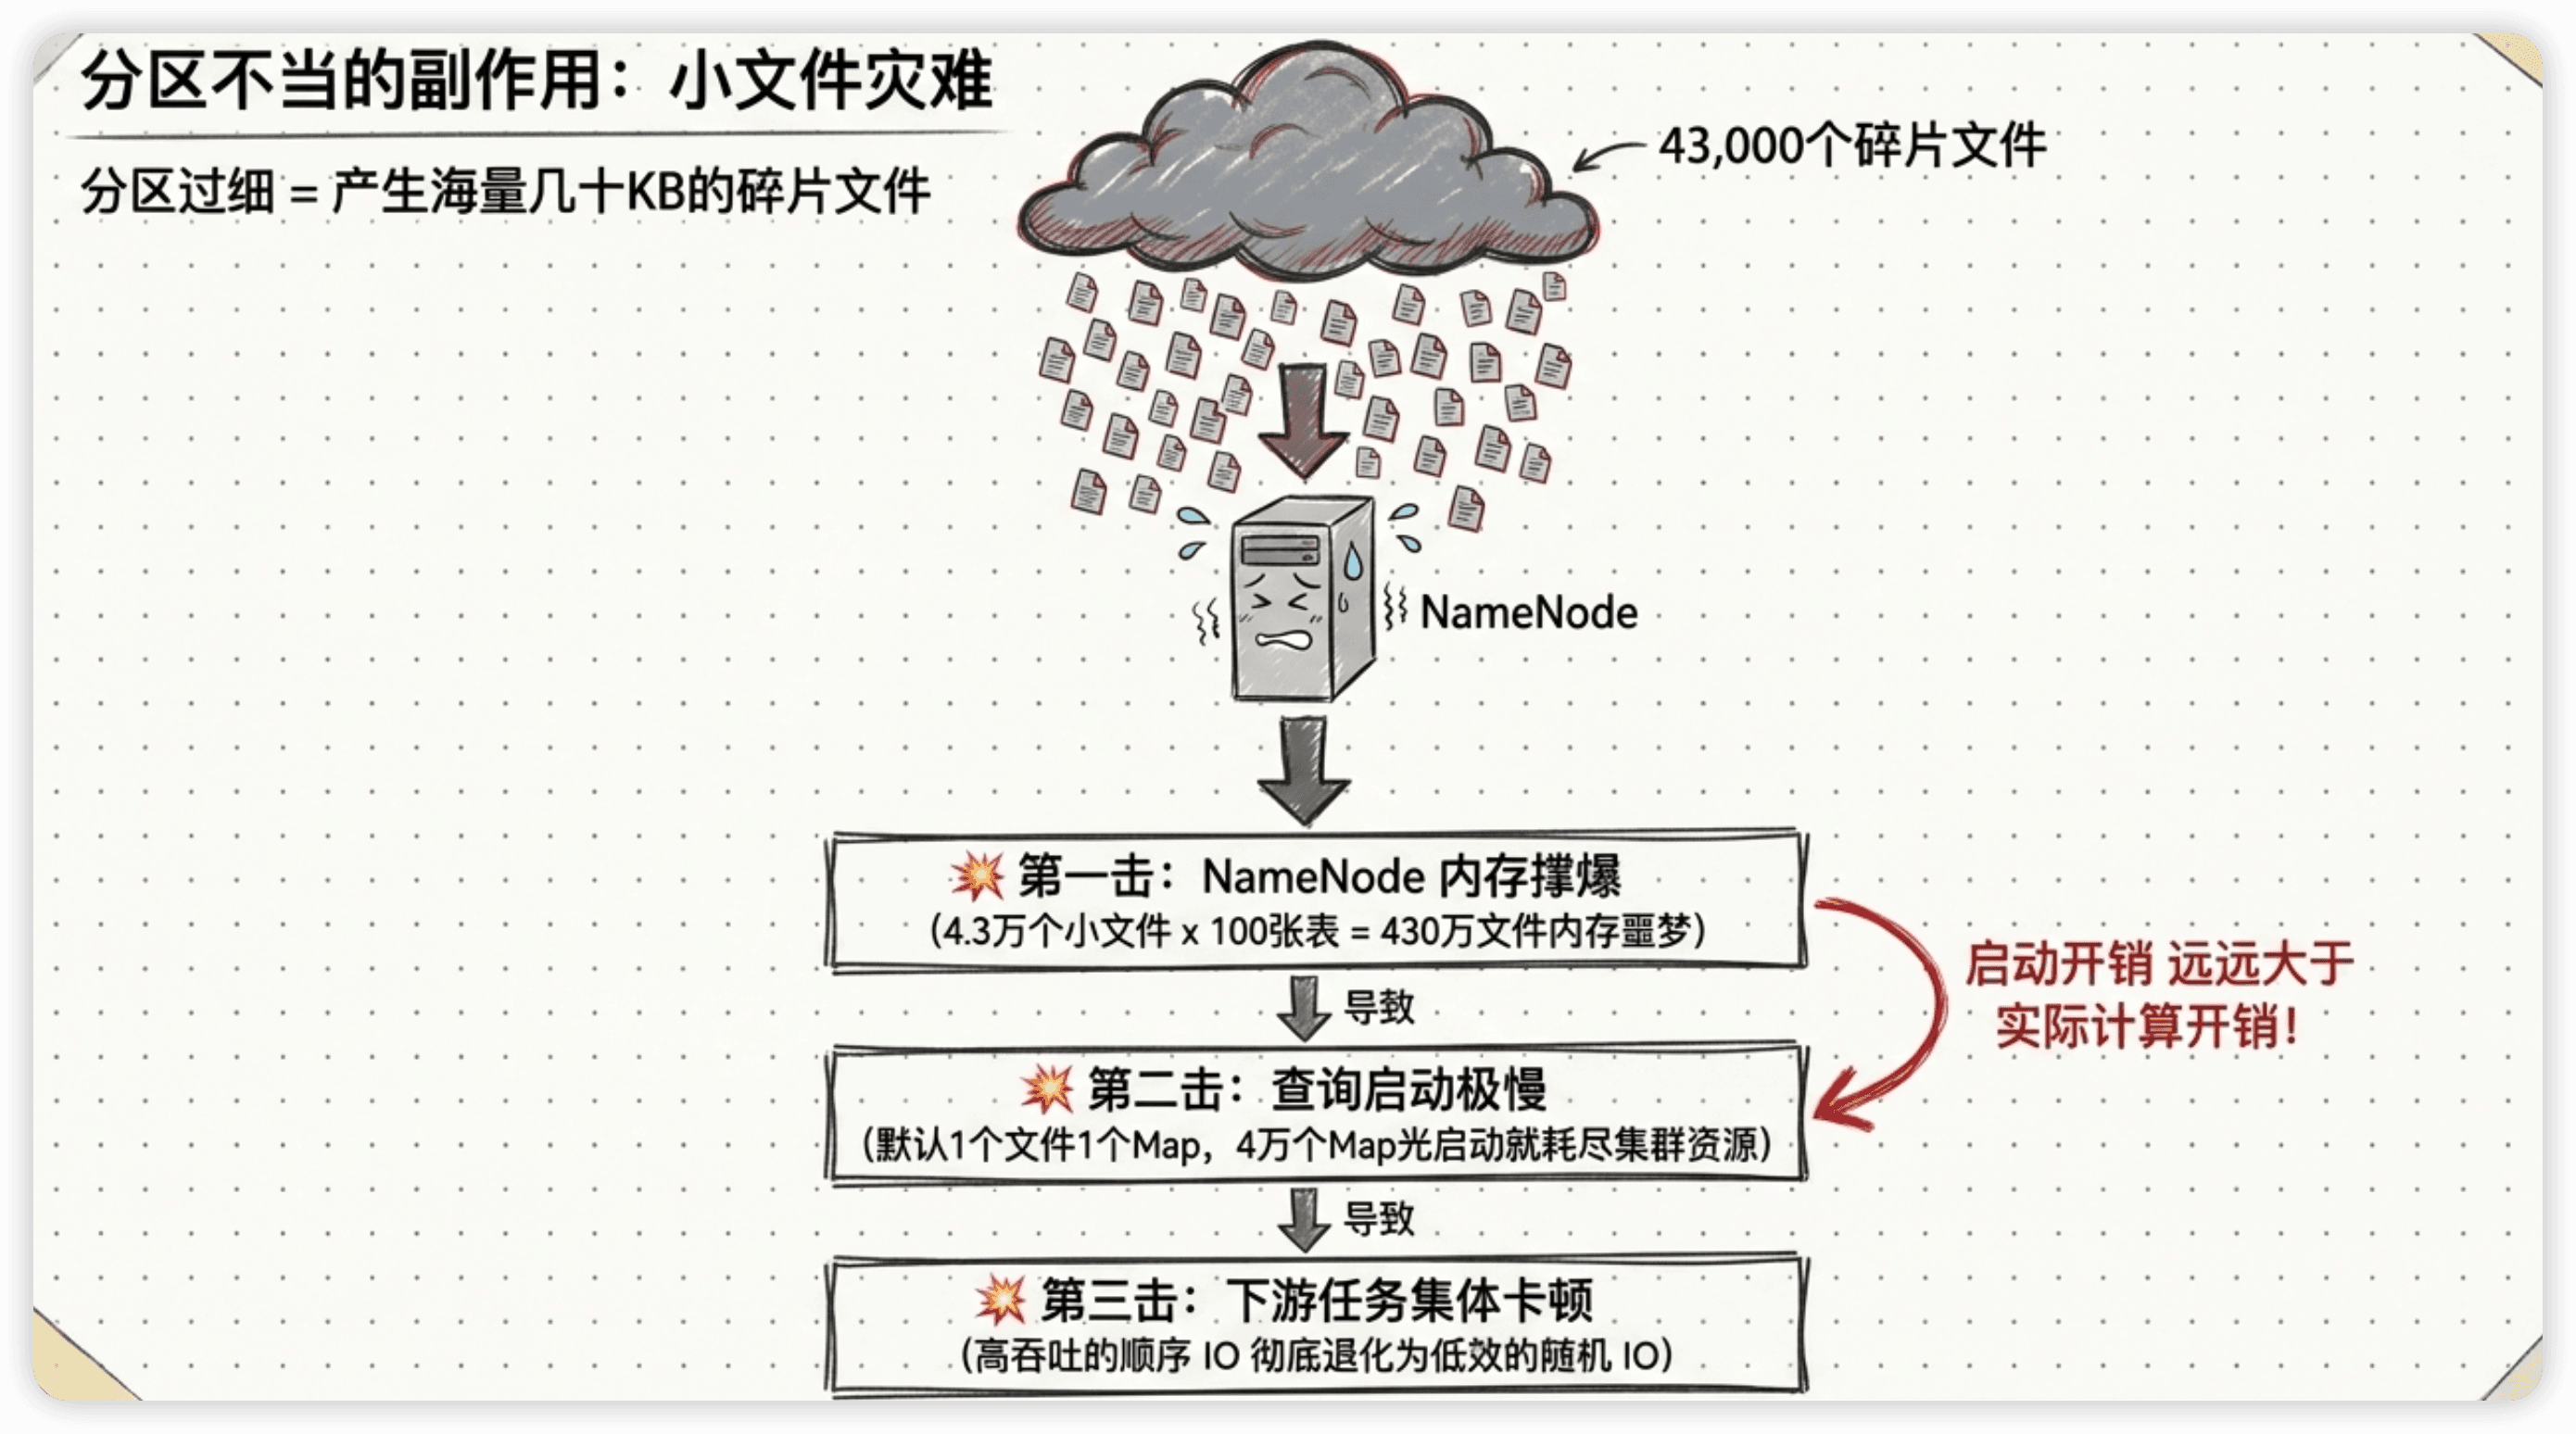
小文件怎么来的?
场景:实时任务每小时写入一次数据,按dt+hour分区
→ 每小时一个分区
→ 每个分区只有30-50MB数据
→ Spark/Flink的并行度是10,每个分区产生10个文件
→ 一天 = 24小时 × 10文件 = 240个文件
→ 一个月 = 7,200个文件
→ 半年 = 43,200个文件
→ 每个文件只有3-5MB,大量小文件
小文件的危害
第一,NameNode内存压力。HDFS的每个文件和Block在NameNode内存中占约150字节。43,000个小文件看起来不多,但如果有100张这样的表就是430万个文件,NameNode压力很大。
第二,查询性能差。默认一个文件启动一个Map任务,43,000个文件就要启动43,000个Map——启动开销远大于实际计算开销。
第三,下游任务变慢。读取大量小文件的随机IO远比读取少数大文件的顺序IO慢。
解决方案
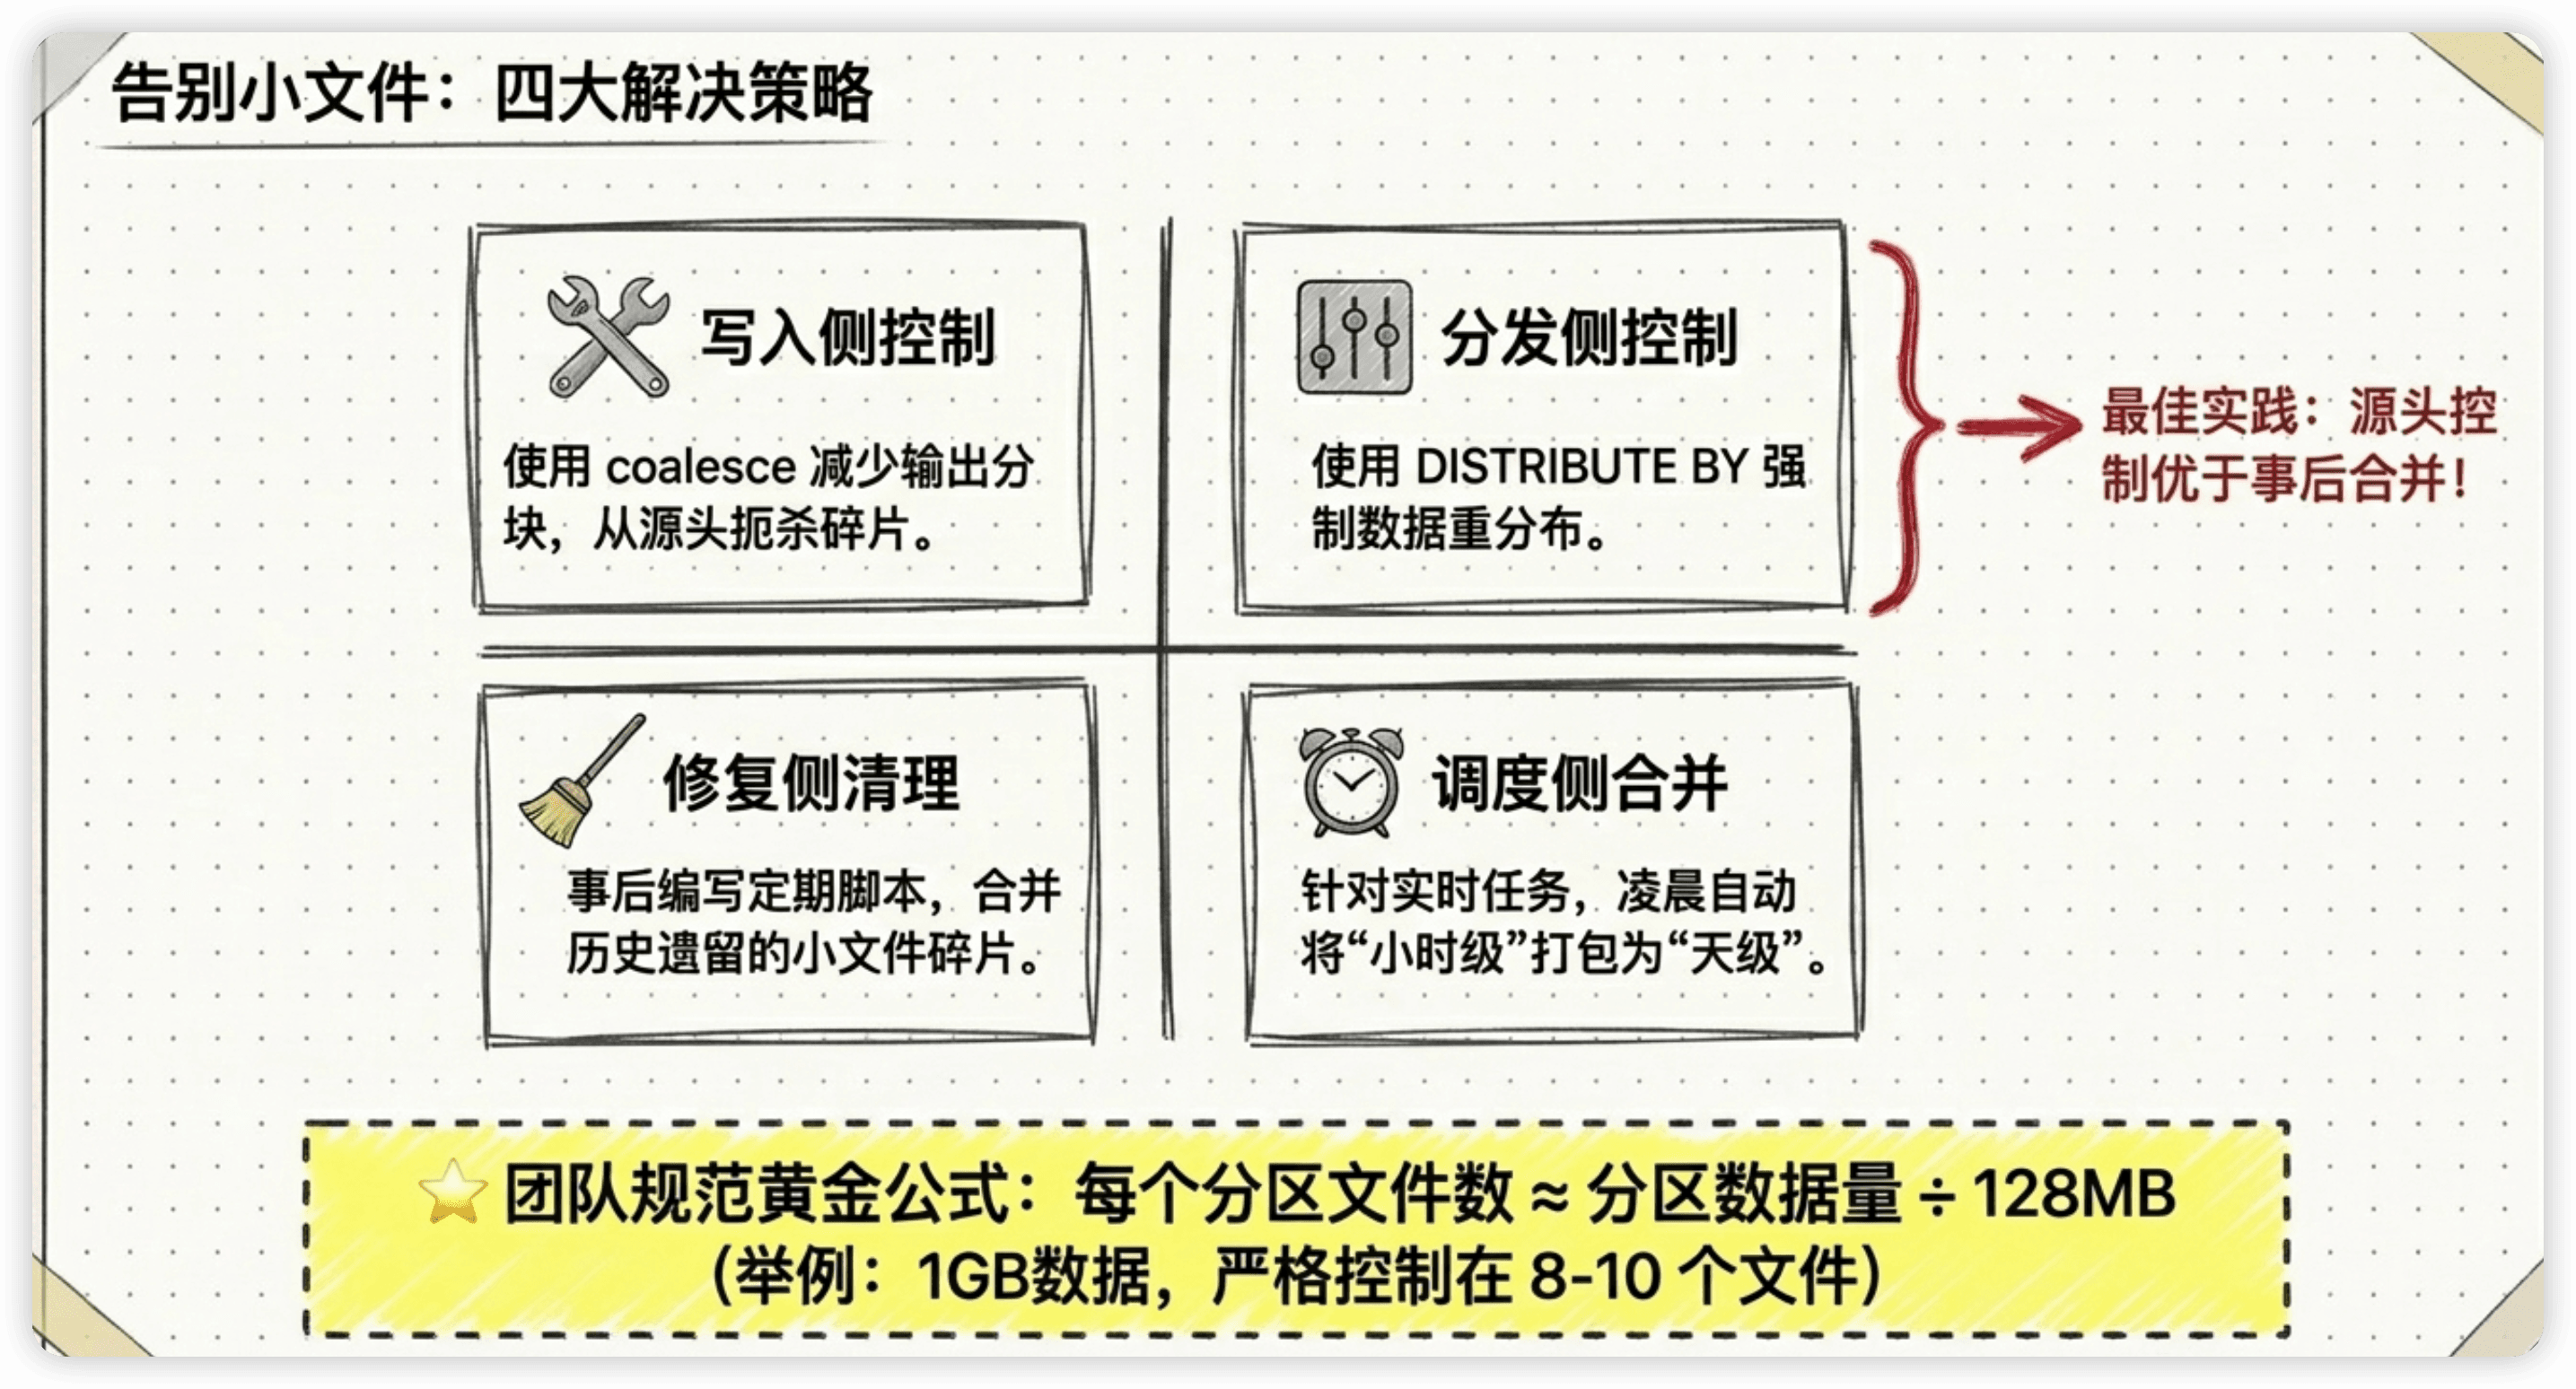
方案一:写入时合并
-- Hive写入后自动合并小文件
SET hive.merge.mapfiles=true;
SET hive.merge.mapredfiles=true;
SET hive.merge.size.per.task=256000000;       -- 目标文件大小256MB
SET hive.merge.smallfiles.avgsize=128000000;  -- 平均文件<128MB时触发合并
方案二:用DISTRIBUTE BY控制输出文件数
-- 控制输出文件数量为10个
INSERT OVERWRITE TABLE fact_order PARTITION(dt='2025-01-15')
SELECT order_id, user_id, amount
FROM source_table
DISTRIBUTE BY FLOOR(RAND() * 10);
-- 10个Reducer,产生10个文件
方案三:定期合并(事后修复)
-- Hive原生合并命令
ALTER TABLE fact_order PARTITION(dt='2025-01-15') CONCATENATE;

-- 或者用Spark重写分区
spark.read.table("fact_order").where("dt='2025-01-15'")
  .coalesce(10)  // 合并为10个文件
  .write.mode("overwrite").insertInto("fact_order")
方案四:每日合并调度任务
如果有实时任务每小时写入小文件,可以设置一个每日凌晨跑的合并任务,把小时级文件合并成天级大文件。
我们团队的规范是:每个分区的文件数 ≈ 分区数据量 ÷ 128MB。比如分区有1GB数据就控制在8-10个文件左右。写入时用coalesce或DISTRIBUTE BY主动控制,不依赖事后合并。
面试怎么答?
高分回答
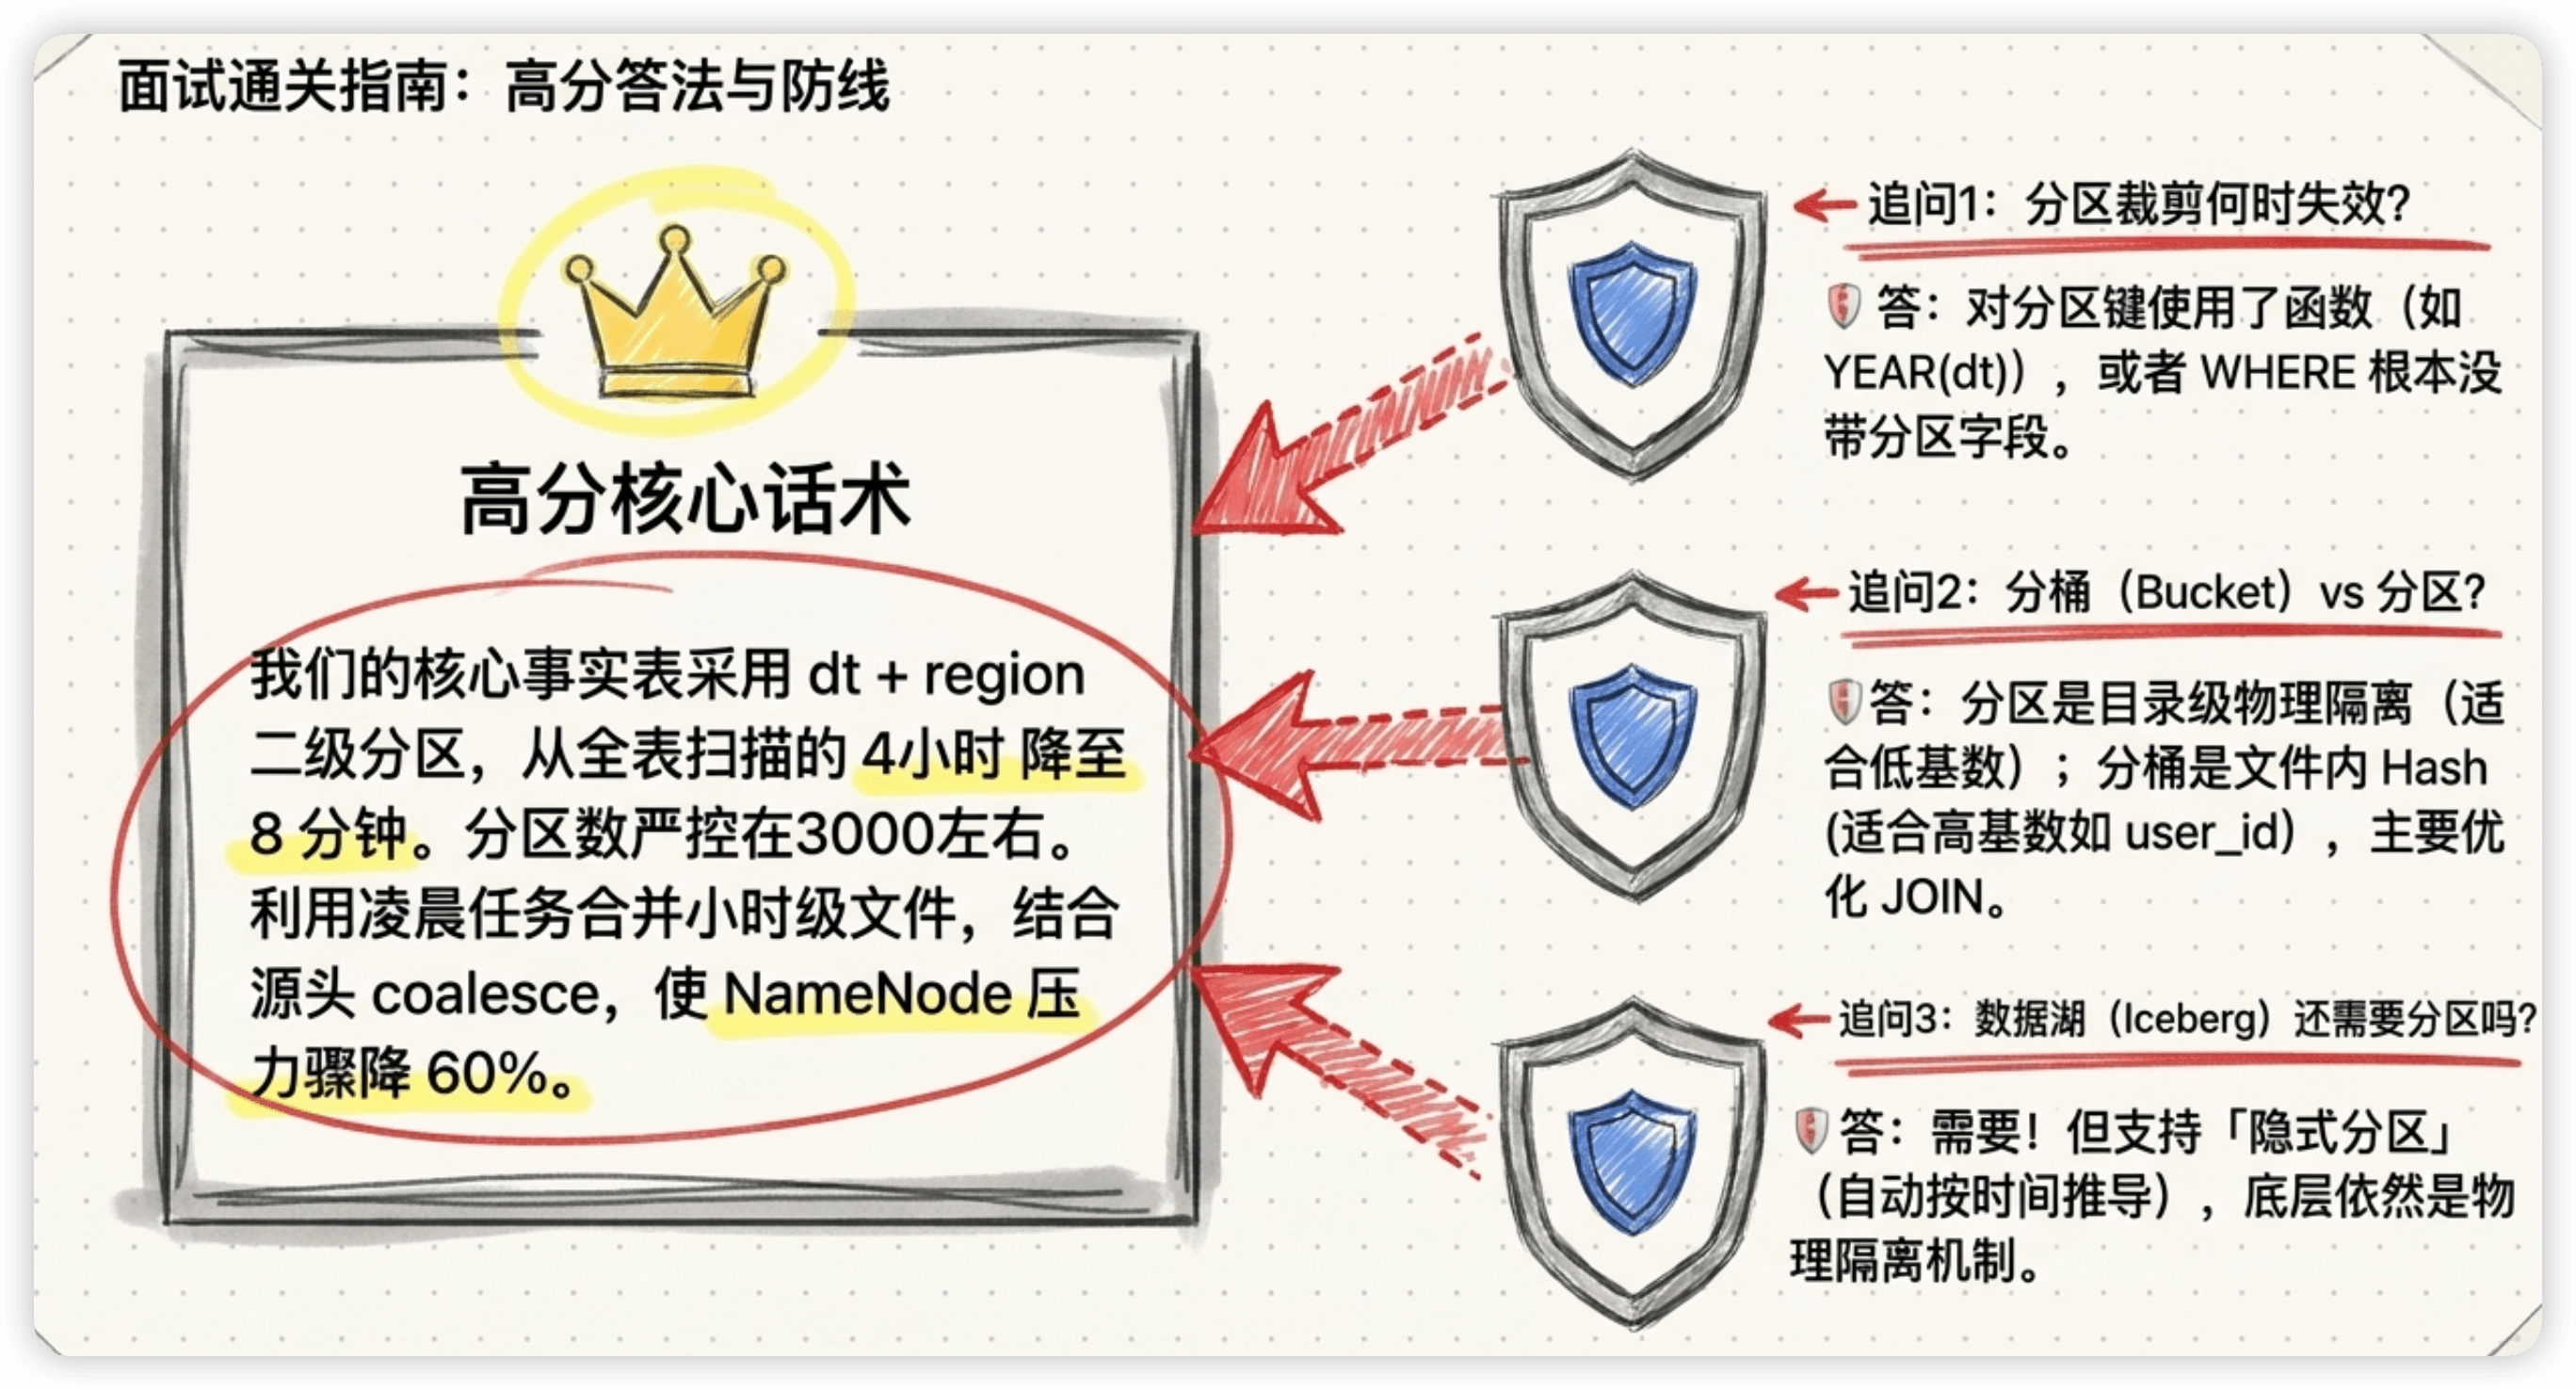
「我们核心事实表用dt做一级分区,出海业务加了region做二级分区。查询时99%的SQL都有dt和region条件,分区裁剪效果很好——从全表扫描4小时降到8分钟。分区数控制在合理范围,dt一年365个,region大概10个,总共3000多个分区。」
「遇到过一次小文件问题:实时任务每小时写入一次,每个分区只有几十MB,半年积累了几万个小文件,NameNode压力很大。后来我加了一个每日凌晨的合并任务,把小时级文件合并成天级大文件,NameNode压力下降了60%。同时在写入侧用coalesce控制输出文件数,从源头减少小文件产生。」
追问防线
追问1:分区裁剪什么时候失效?
两种常见情况。第一,SQL里对分区键做了函数转换——比如WHERE YEAR(dt) = 2025,引擎可能无法识别这是对dt分区的过滤,导致全表扫描。正确写法是WHERE dt >= '2025-01-01' AND dt < '2026-01-01'。第二,分区键不在WHERE条件里,引擎只能扫描全部分区。
追问2:分桶(Bucket)和分区有什么区别?
分区是把数据按字段值分成不同目录,适合基数低的字段(日期、地区)。分桶是在分区内部,按字段的Hash值把数据分成固定数量的文件,适合高基数字段(user_id)。分桶的主要用途是优化JOIN(两张表按相同字段分桶后可以做Bucket Map Join)和抽样查询。
追问3:Iceberg/Delta Lake这类湖格式还需要传统分区吗?
需要,但方式不同。湖格式支持隐式分区(Hidden Partitioning)——你不用在建表时显式声明分区字段,引擎会根据查询自动做分区裁剪。比如Iceberg可以根据时间字段自动按天/月分区,不需要手动维护dt字段。但底层原理还是一样的——把数据物理隔离到不同文件组,查询时跳过不需要的部分。
总结
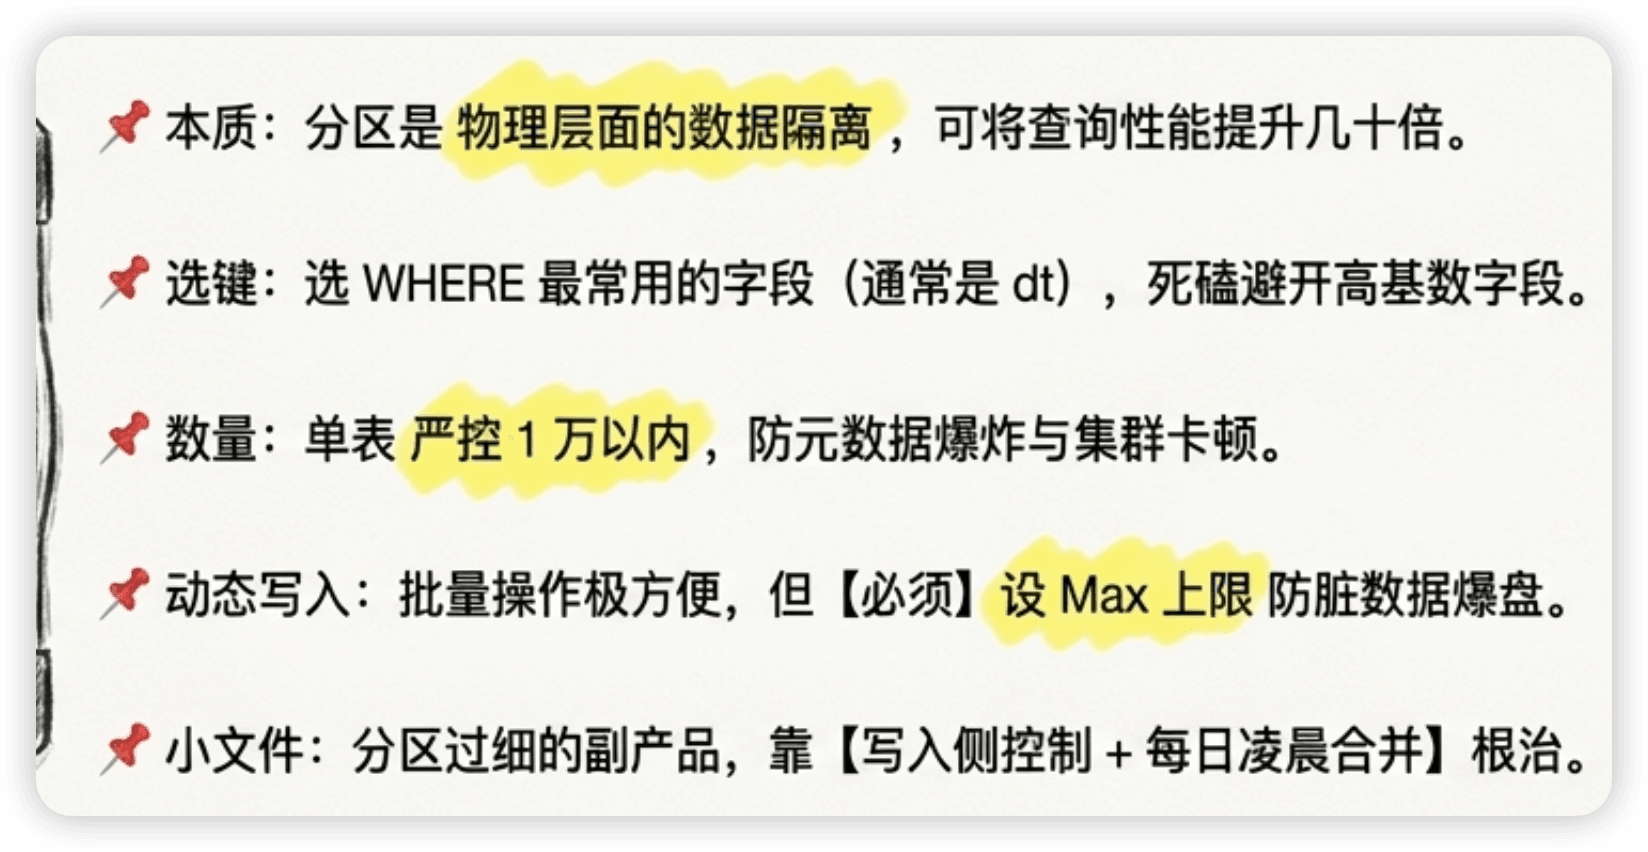
- 分区的本质是物理隔离数据,查询时跳过无关分区,性能提升可达几十倍
- 分区键选择:WHERE条件里最常出现的字段,通常是dt(日期)
- 分区数量:单表控制在1万以内,基数太高的字段不适合做分区
- 动态分区批量写入方便,但必须设max上限防止分区爆炸
- 小文件问题是分区过细的副产品,通过写入时控制文件数 + 定期合并解决
- 经验规则:每个分区的文件数 ≈ 分区数据量 ÷ 128MB