维度建模,星型模型 vs 雪花模型怎么选
面试被问"星型模型和雪花模型有什么区别",大多数人都能答上来。但面试官紧接着追一句"你们公司用的哪种?为什么?",就开始卡壳了。
这道题表面考的是概念,实际考的是你的技术选型能力——你能不能结合业务场景、技术栈、团队规模做出合理的判断,并说清楚理由。
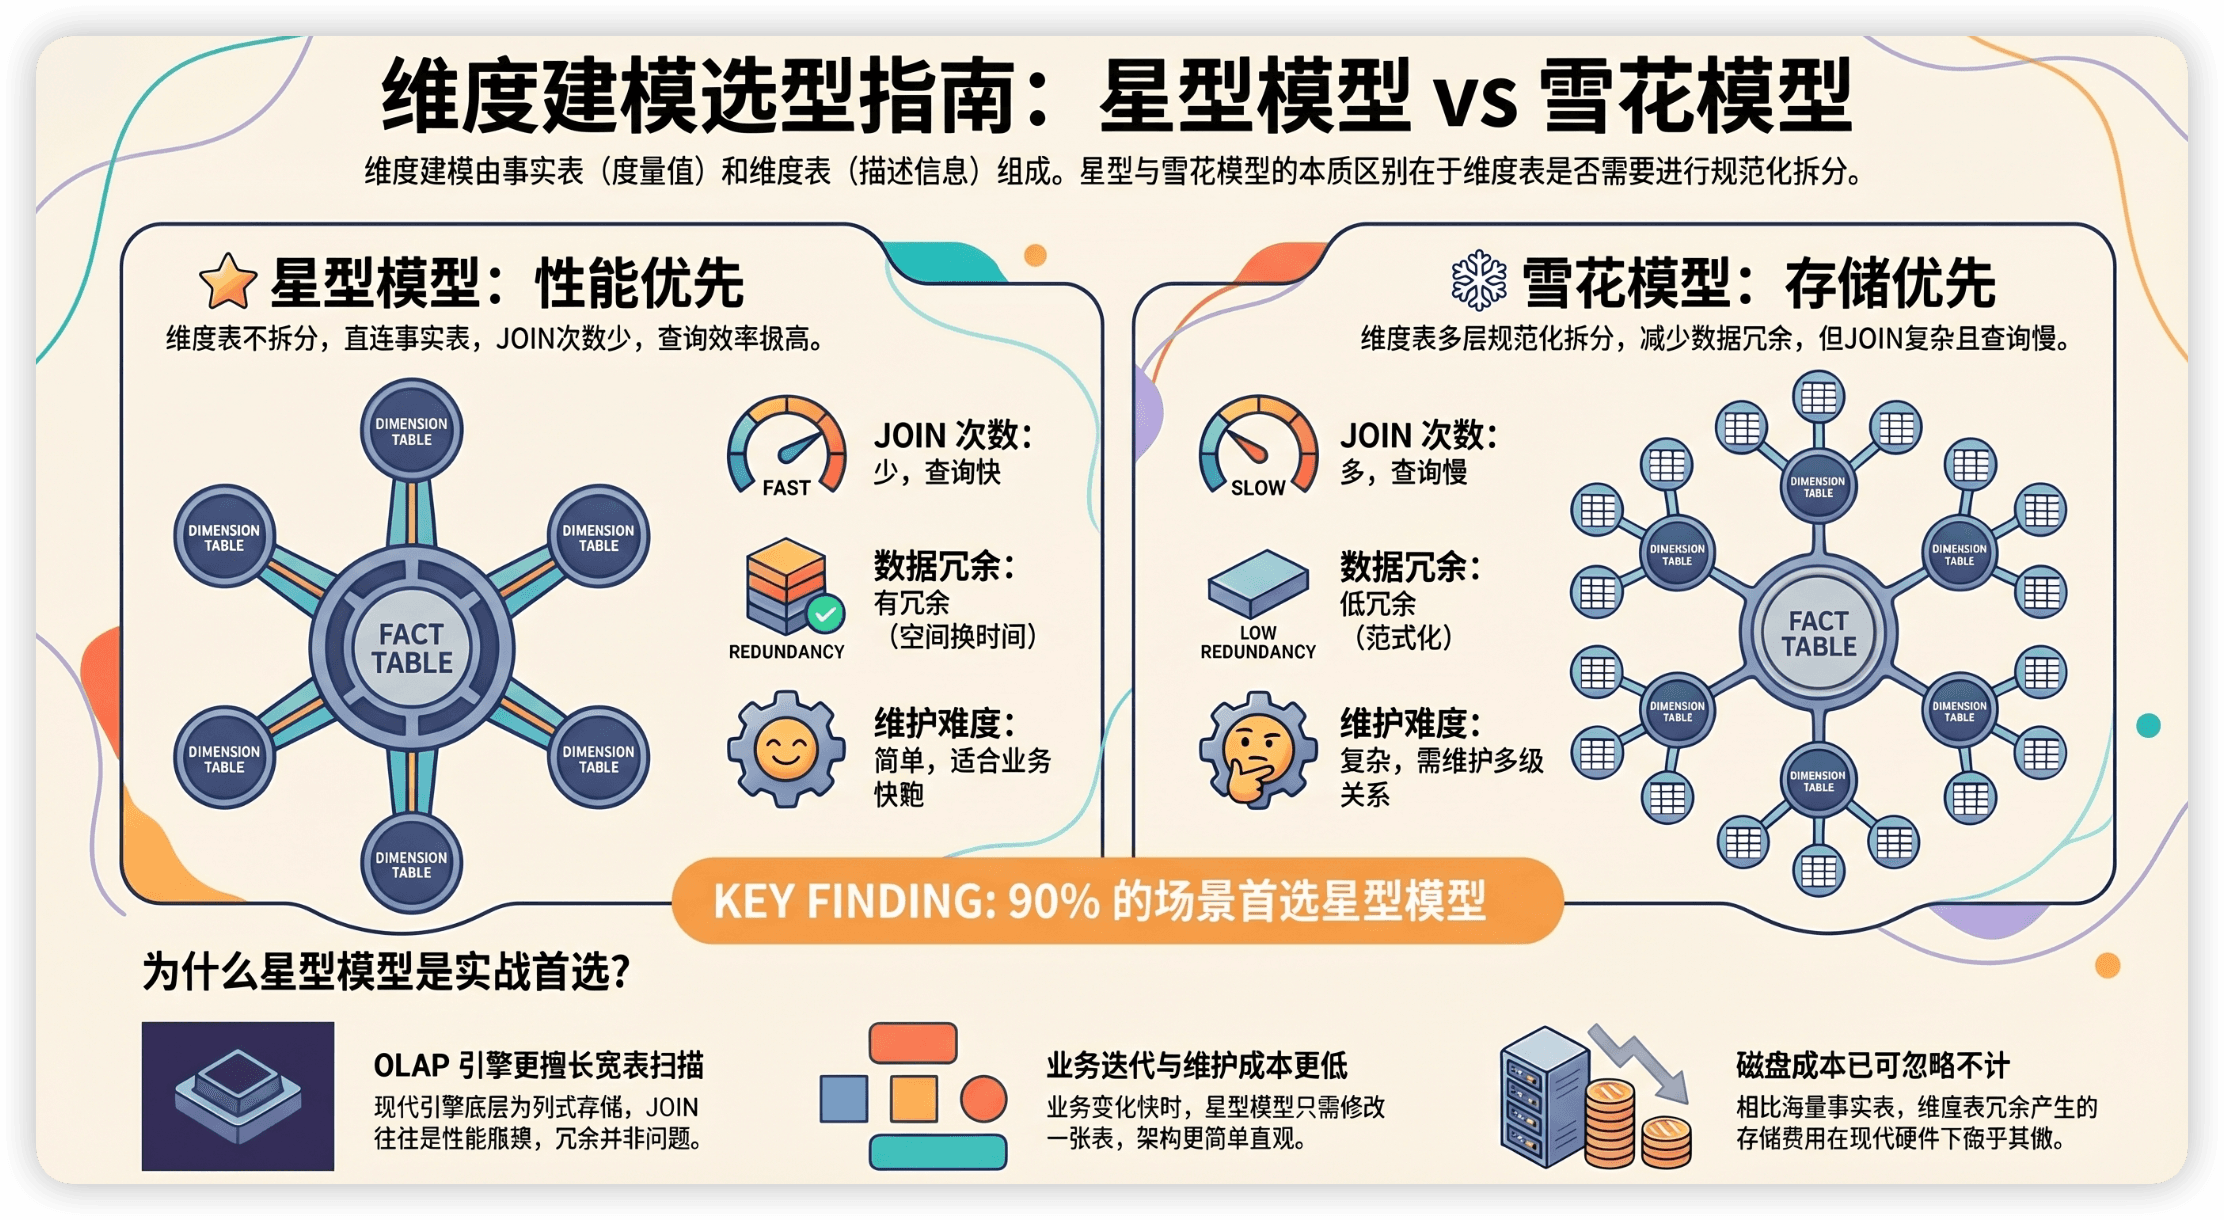
这篇文章我从维度建模的基本概念讲起,到星型和雪花的本质区别,再到实际工作中怎么选,最后给你一个面试高分回答模板。
先搞懂维度建模的两块砖
在聊星型和雪花之前,必须先理解Kimball维度建模的两个核心概念:事实表和维度表。这两张表是维度建模的全部基础,搞不清楚这个,后面都是空中楼阁。
事实表(Fact Table):存"发生了什么"
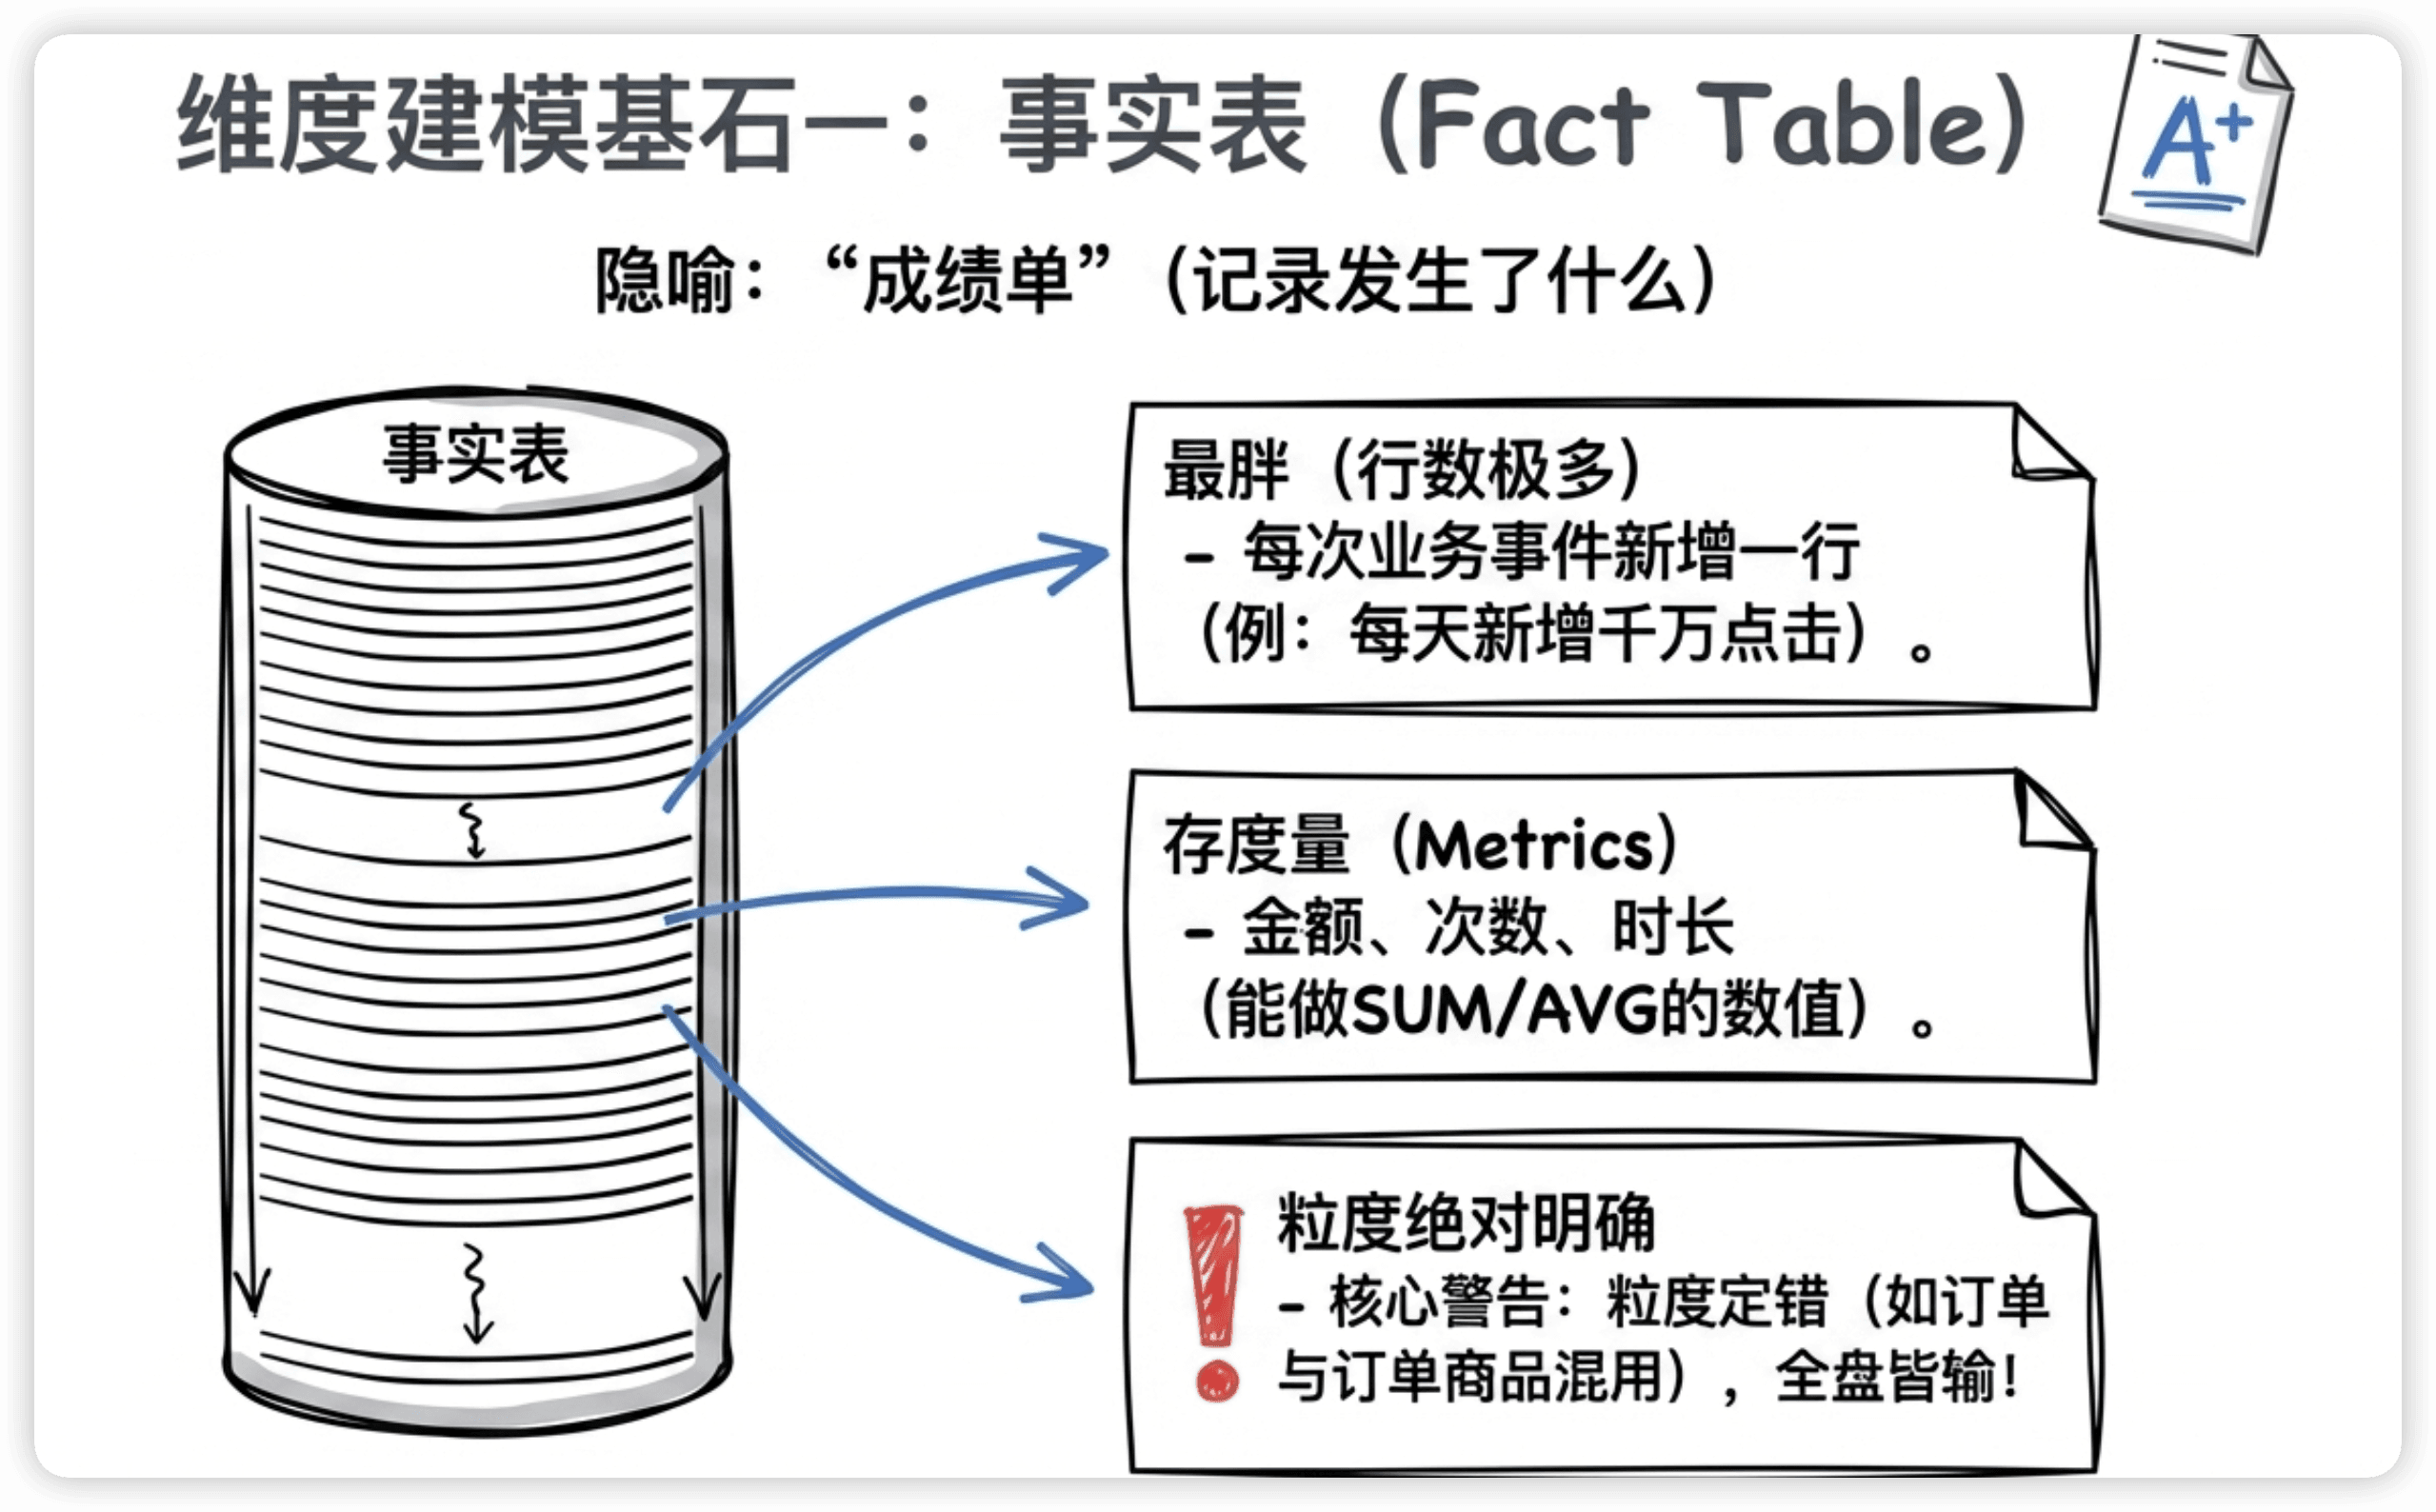
事实表记录的是业务过程中的度量值——一笔订单的金额、一次点击的时间、一段视频的播放时长。
事实表有几个特点:
第一,数据量大。它是数仓里最"胖"的表,因为每发生一次业务事件就会新增一行。我们短剧出海公司的广告点击事实表,每天新增几千万行。
第二,粒度必须明确。设计事实表的第一步是定义"一行代表什么"——一笔订单?一次点击?一个订单里的一件商品?粒度定错,后面所有指标都会算错。我见过有人把订单粒度和订单商品粒度混在一起,一笔订单买了3件商品就变成3行,金额直接被重复统计了。
第三,存的是可度量的数值。金额、次数、时长、数量——这些能做SUM、AVG运算的数字才放事实表。
-- 事实表示例:订单事实表
-- 粒度:一笔订单
CREATE TABLE fact_order (
    order_id       BIGINT,        -- 业务主键
    user_id        BIGINT,        -- 关联用户维度
    product_id     BIGINT,        -- 关联商品维度
    channel_id     INT,           -- 关联渠道维度
    order_amount   DECIMAL(10,2), -- 度量:订单金额
    pay_amount     DECIMAL(10,2), -- 度量:实付金额
    discount       DECIMAL(10,2), -- 度量:优惠金额
    order_time     TIMESTAMP,     -- 事件发生时间
    dt             STRING         -- 分区字段
);
维度表(Dimension Table):存"是什么"
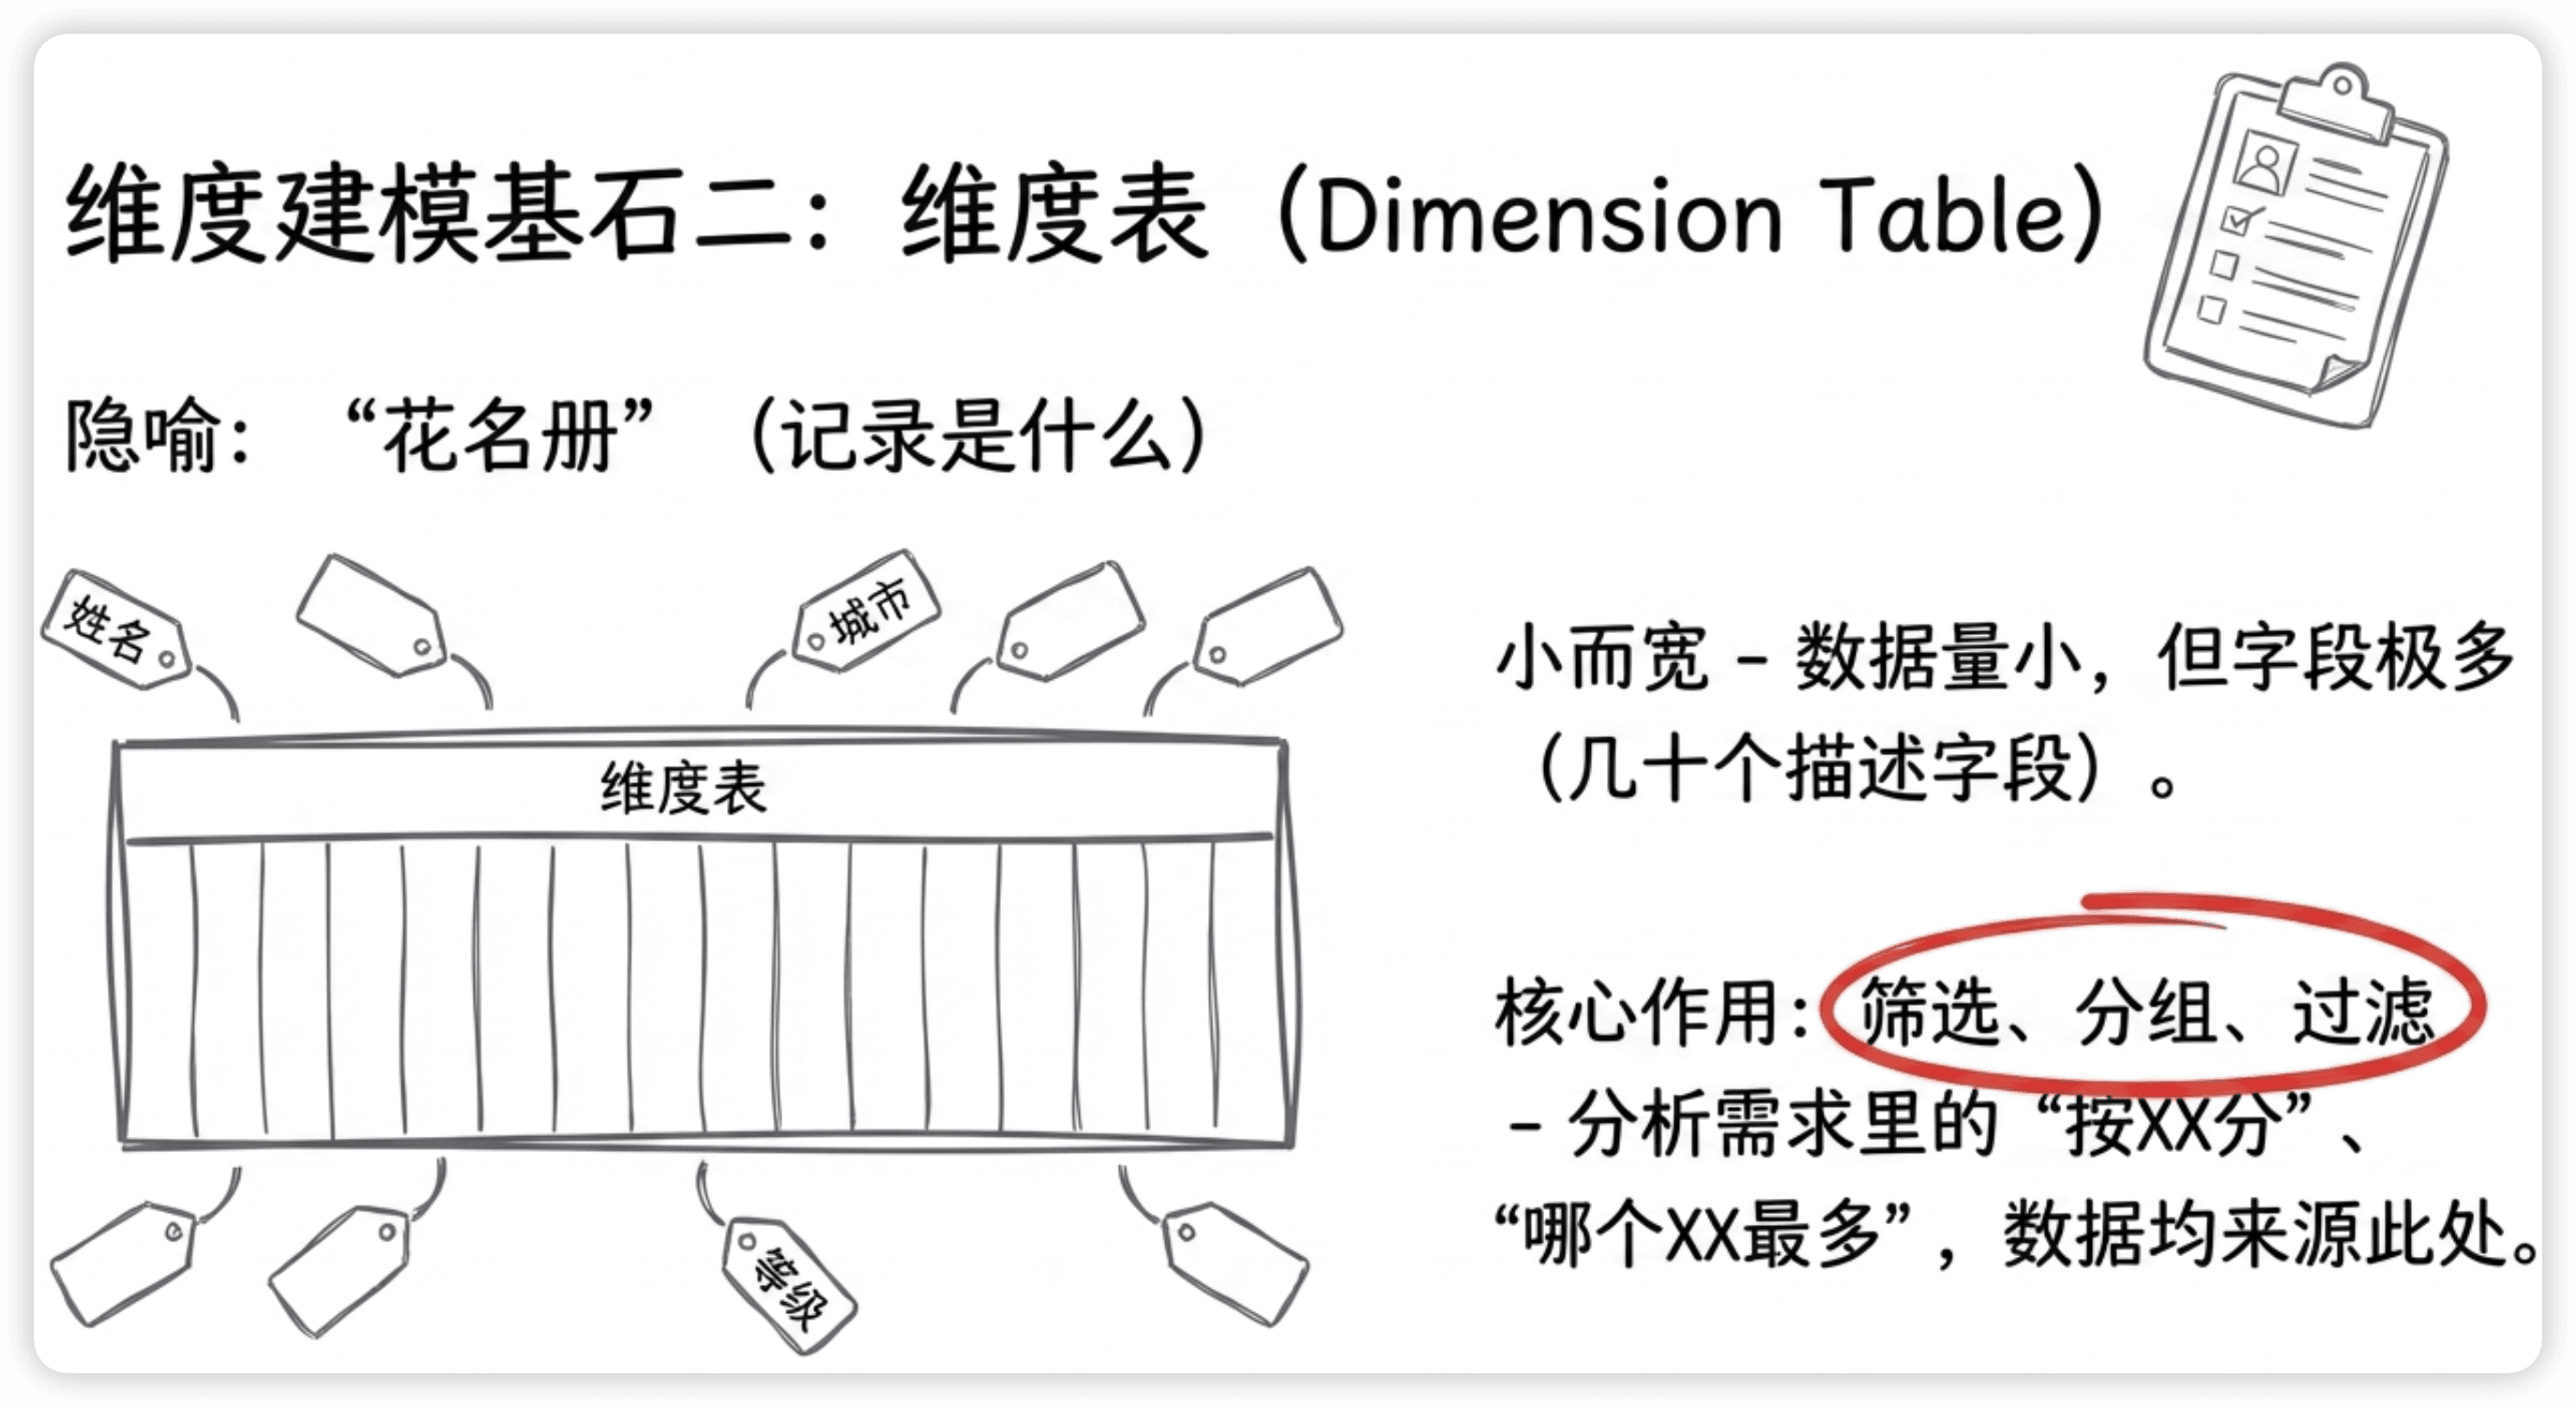
维度表记录的是描述信息——用户叫什么名字、住在哪个城市、属于什么会员等级;商品属于哪个分类、什么品牌、多少钱。
维度表的特点恰好和事实表相反:数据量相对小,但字段多。一张用户维度表可能有几十个字段:姓名、性别、年龄、城市、注册渠道、会员等级、首次购买日期……
维度表的核心作用是筛选、分组、过滤。所有分析需求里的"按XX分"、"XX等于"、"哪个XX最多",这些"XX"基本都来自维度表。
-- 维度表示例:用户维度表
CREATE TABLE dim_user (
    user_id          BIGINT,
    user_name        STRING,
    gender           STRING,
    age_group        STRING,      -- 年龄段
    city             STRING,
    province         STRING,
    country          STRING,
    register_channel STRING,      -- 注册渠道
    user_level       STRING,      -- 会员等级
    first_order_date STRING,      -- 首次下单日期
    is_vip           INT          -- 是否VIP
);
打个比方:事实表是"考试成绩单"(谁考了多少分),维度表是"学生花名册"(叫什么、哪个班、男生女生)。把两张表JOIN起来,就能回答"三年级男生的平均成绩是多少"这样的分析问题。
星型 vs 雪花,本质区别就一个
理解了事实表和维度表之后,星型和雪花的区别其实非常简单:
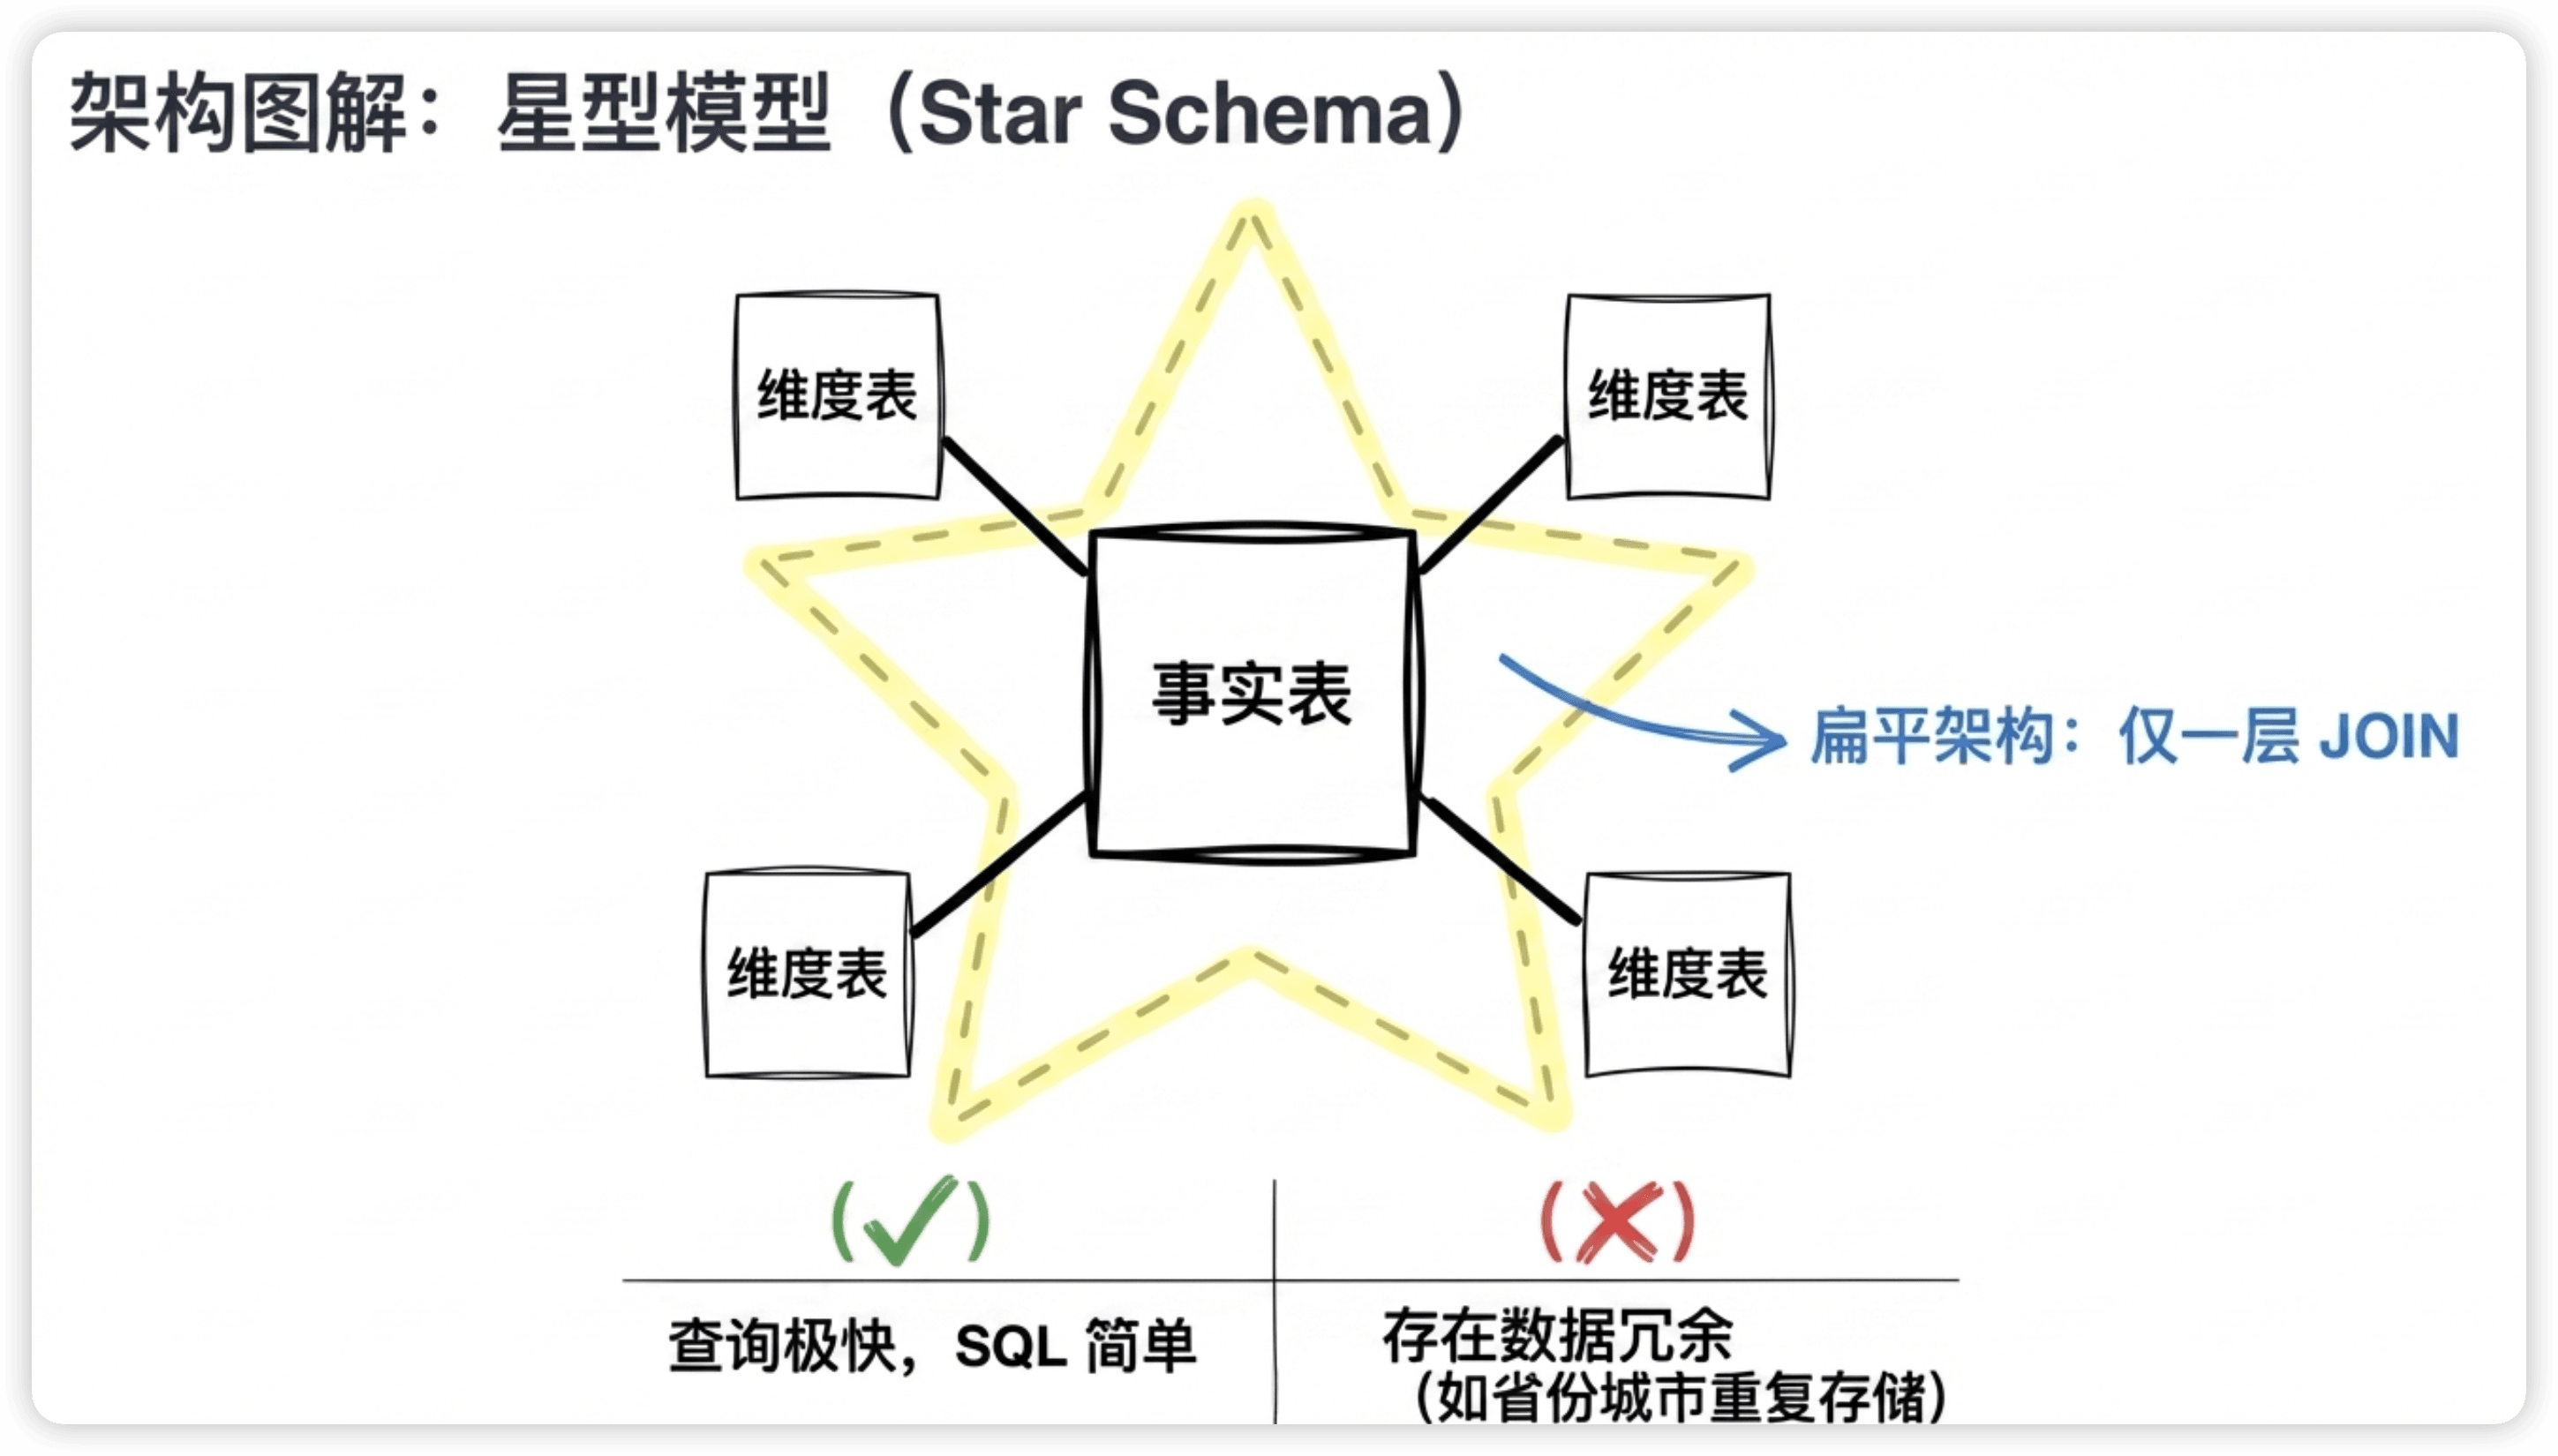
星型模型:事实表周围围一圈维度表,每张维度表直连事实表,结构像星星。
雪花模型:维度表进一步拆分成多层(规范化),结构像雪花。
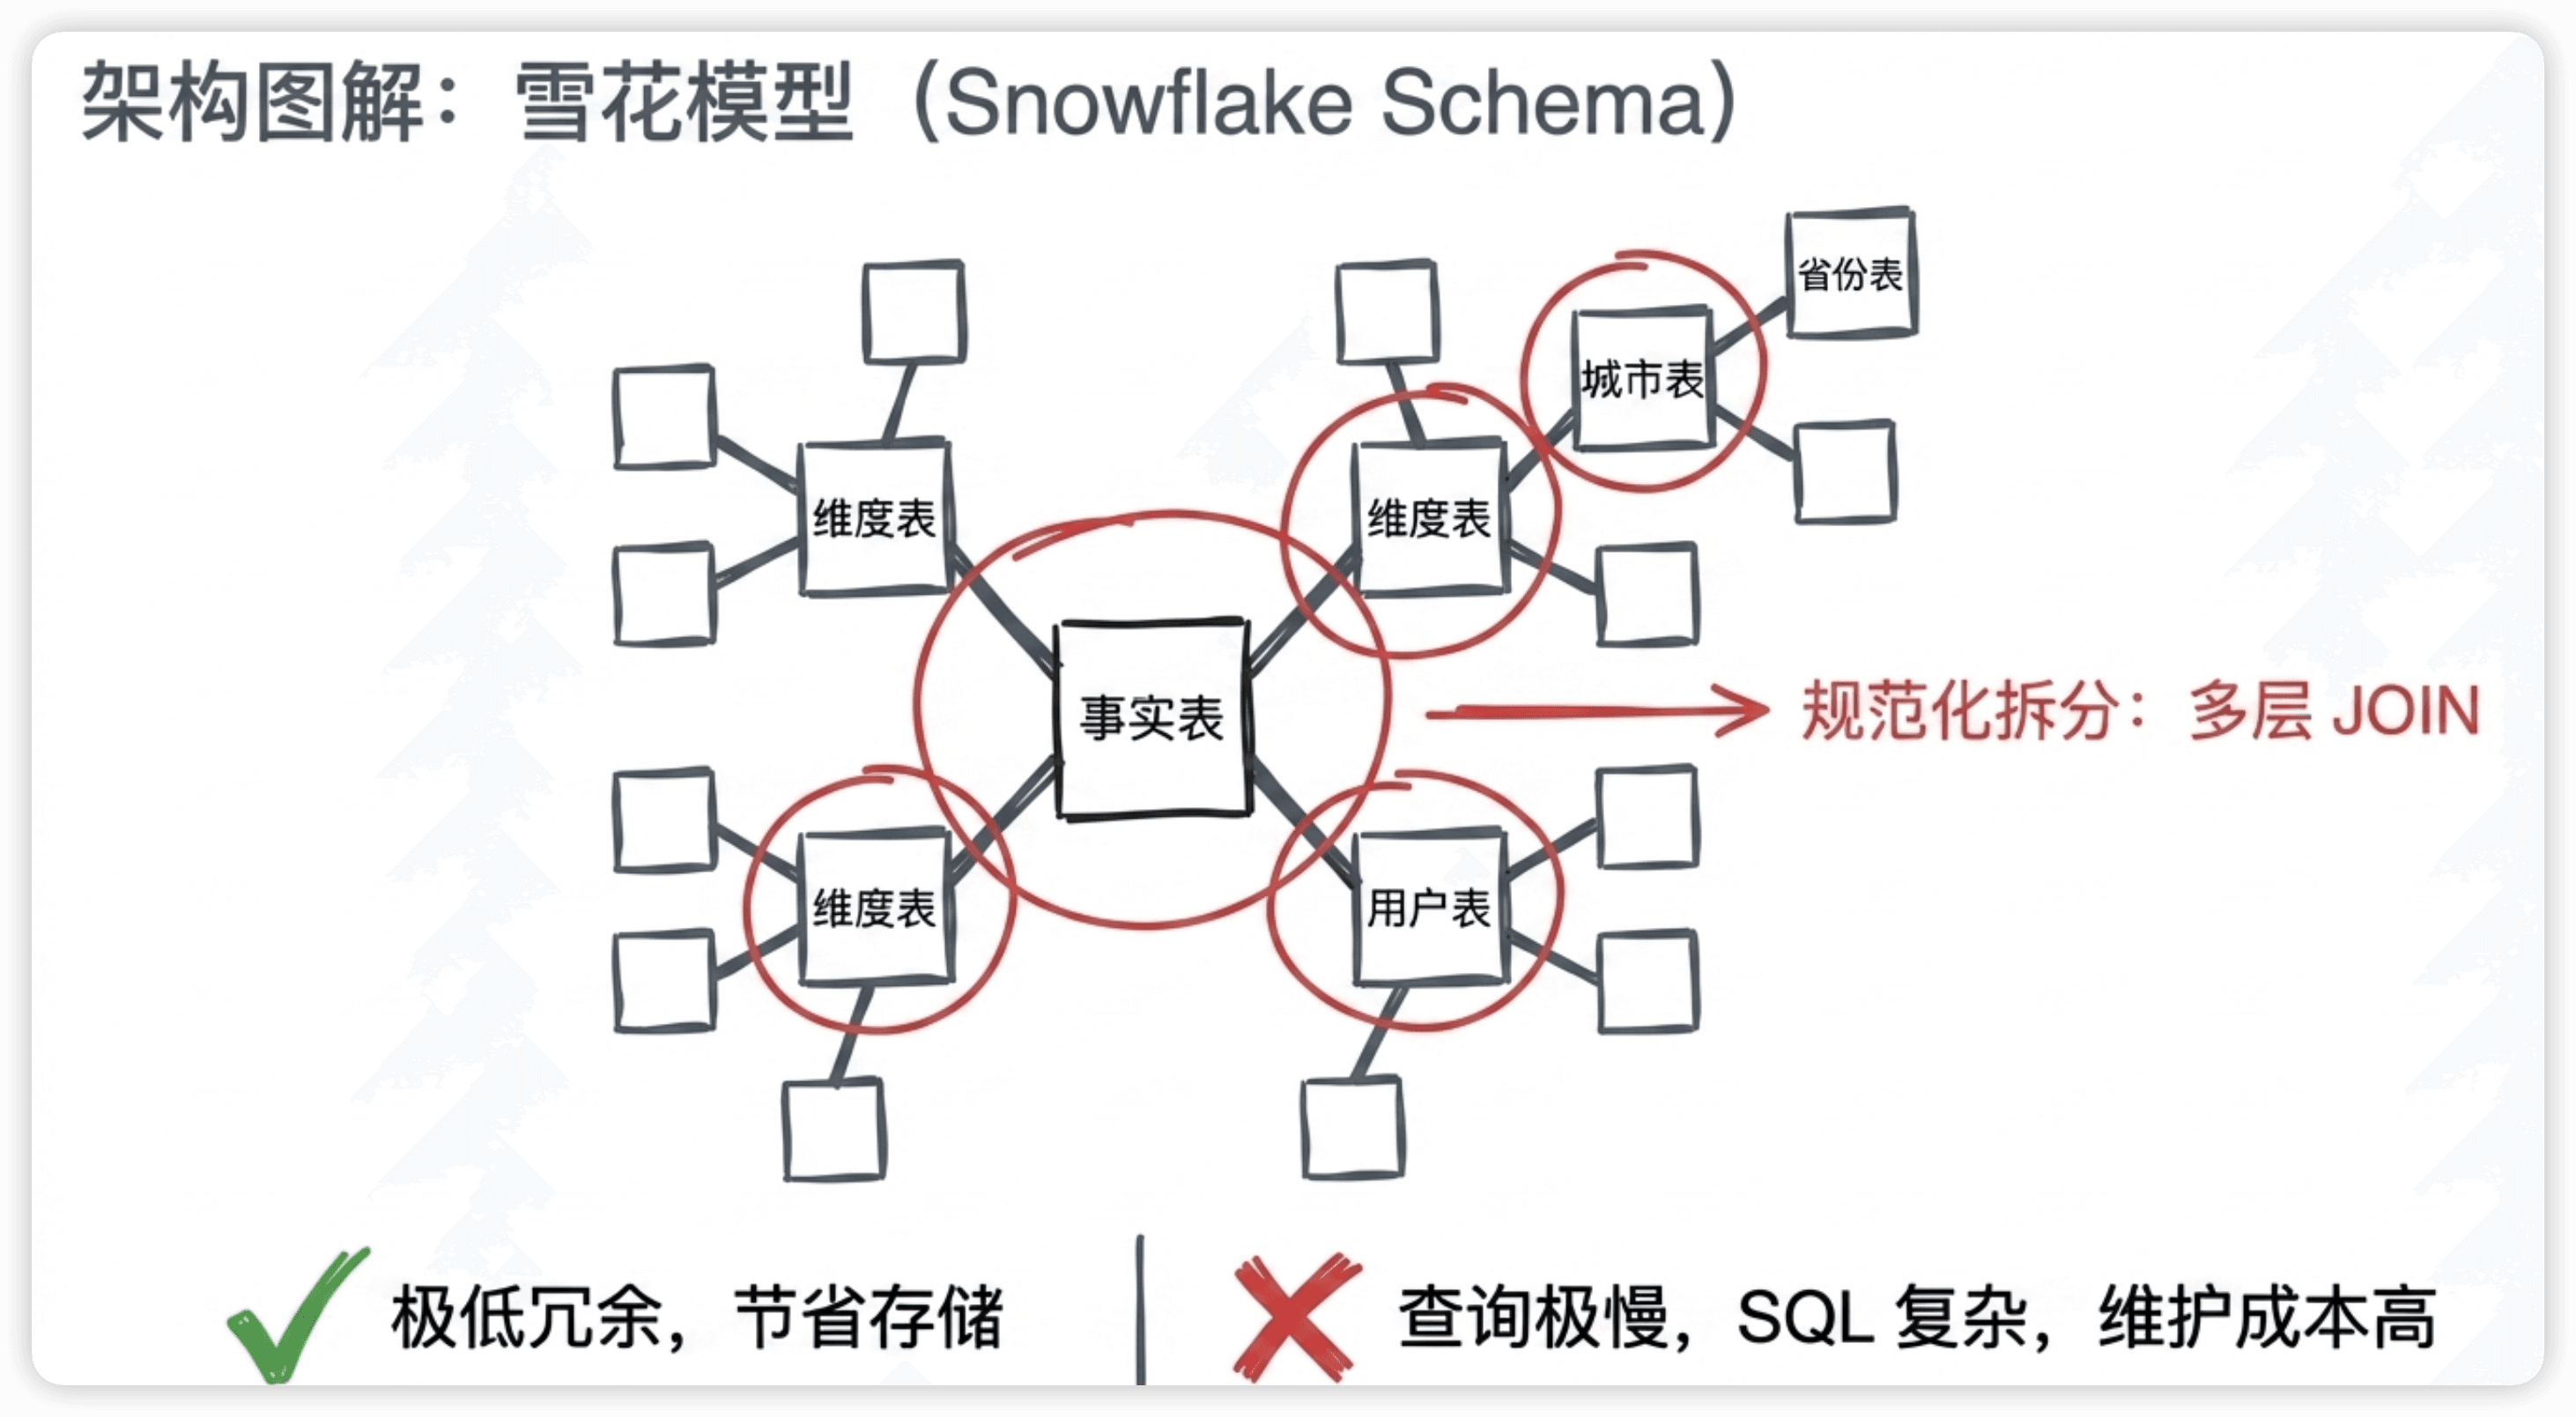
区别就在维度表要不要拆。
举个具体的例子
假设你在做一个订单分析的数仓,需要关联用户的地理位置信息。
星型模型的做法:
                    dim_user
                    ├── user_id
                    ├── user_name
                    ├── city          ← 城市直接放在用户表里
                    ├── province      ← 省份也放在用户表里
                    └── country       ← 国家也放在用户表里
                         │
    dim_product ──── fact_order ──── dim_user
                         │
                    dim_channel
城市、省份、国家全部"堆"在dim_user一张表里。有冗余吗?有——100个北京用户,"北京"这个城市出现了100次,"北京市"对应的"北京"这个省份也重复了100次。但查询只需要一次JOIN,SQL简单,性能好。
-- 星型模型查询:统计每个省份的订单金额
SELECT u.province, SUM(o.order_amount) AS total_amount
FROM fact_order o
JOIN dim_user u ON o.user_id = u.user_id
WHERE o.dt = '2025-01-15'
GROUP BY u.province;
-- 只需要JOIN 1张表
雪花模型的做法:
    dim_user
    ├── user_id
    ├── user_name
    └── city_id  ──→  dim_city
                      ├── city_id
                      ├── city_name
                      └── province_id ──→ dim_province
                                          ├── province_id
                                          ├── province_name
                                          └── country_id ──→ dim_country
                                                             ├── country_id
                                                             └── country_name
地理信息被拆成了city → province → country三层。没有冗余了,每个省份只存一次,但查询的时候要JOIN四张表。
-- 雪花模型查询:统计每个省份的订单金额
SELECT p.province_name, SUM(o.order_amount) AS total_amount
FROM fact_order o
JOIN dim_user u ON o.user_id = u.user_id
JOIN dim_city c ON u.city_id = c.city_id
JOIN dim_province p ON c.province_id = p.province_id
WHERE o.dt = '2025-01-15'
GROUP BY p.province_name;
-- 需要JOIN 3张表
完整对比
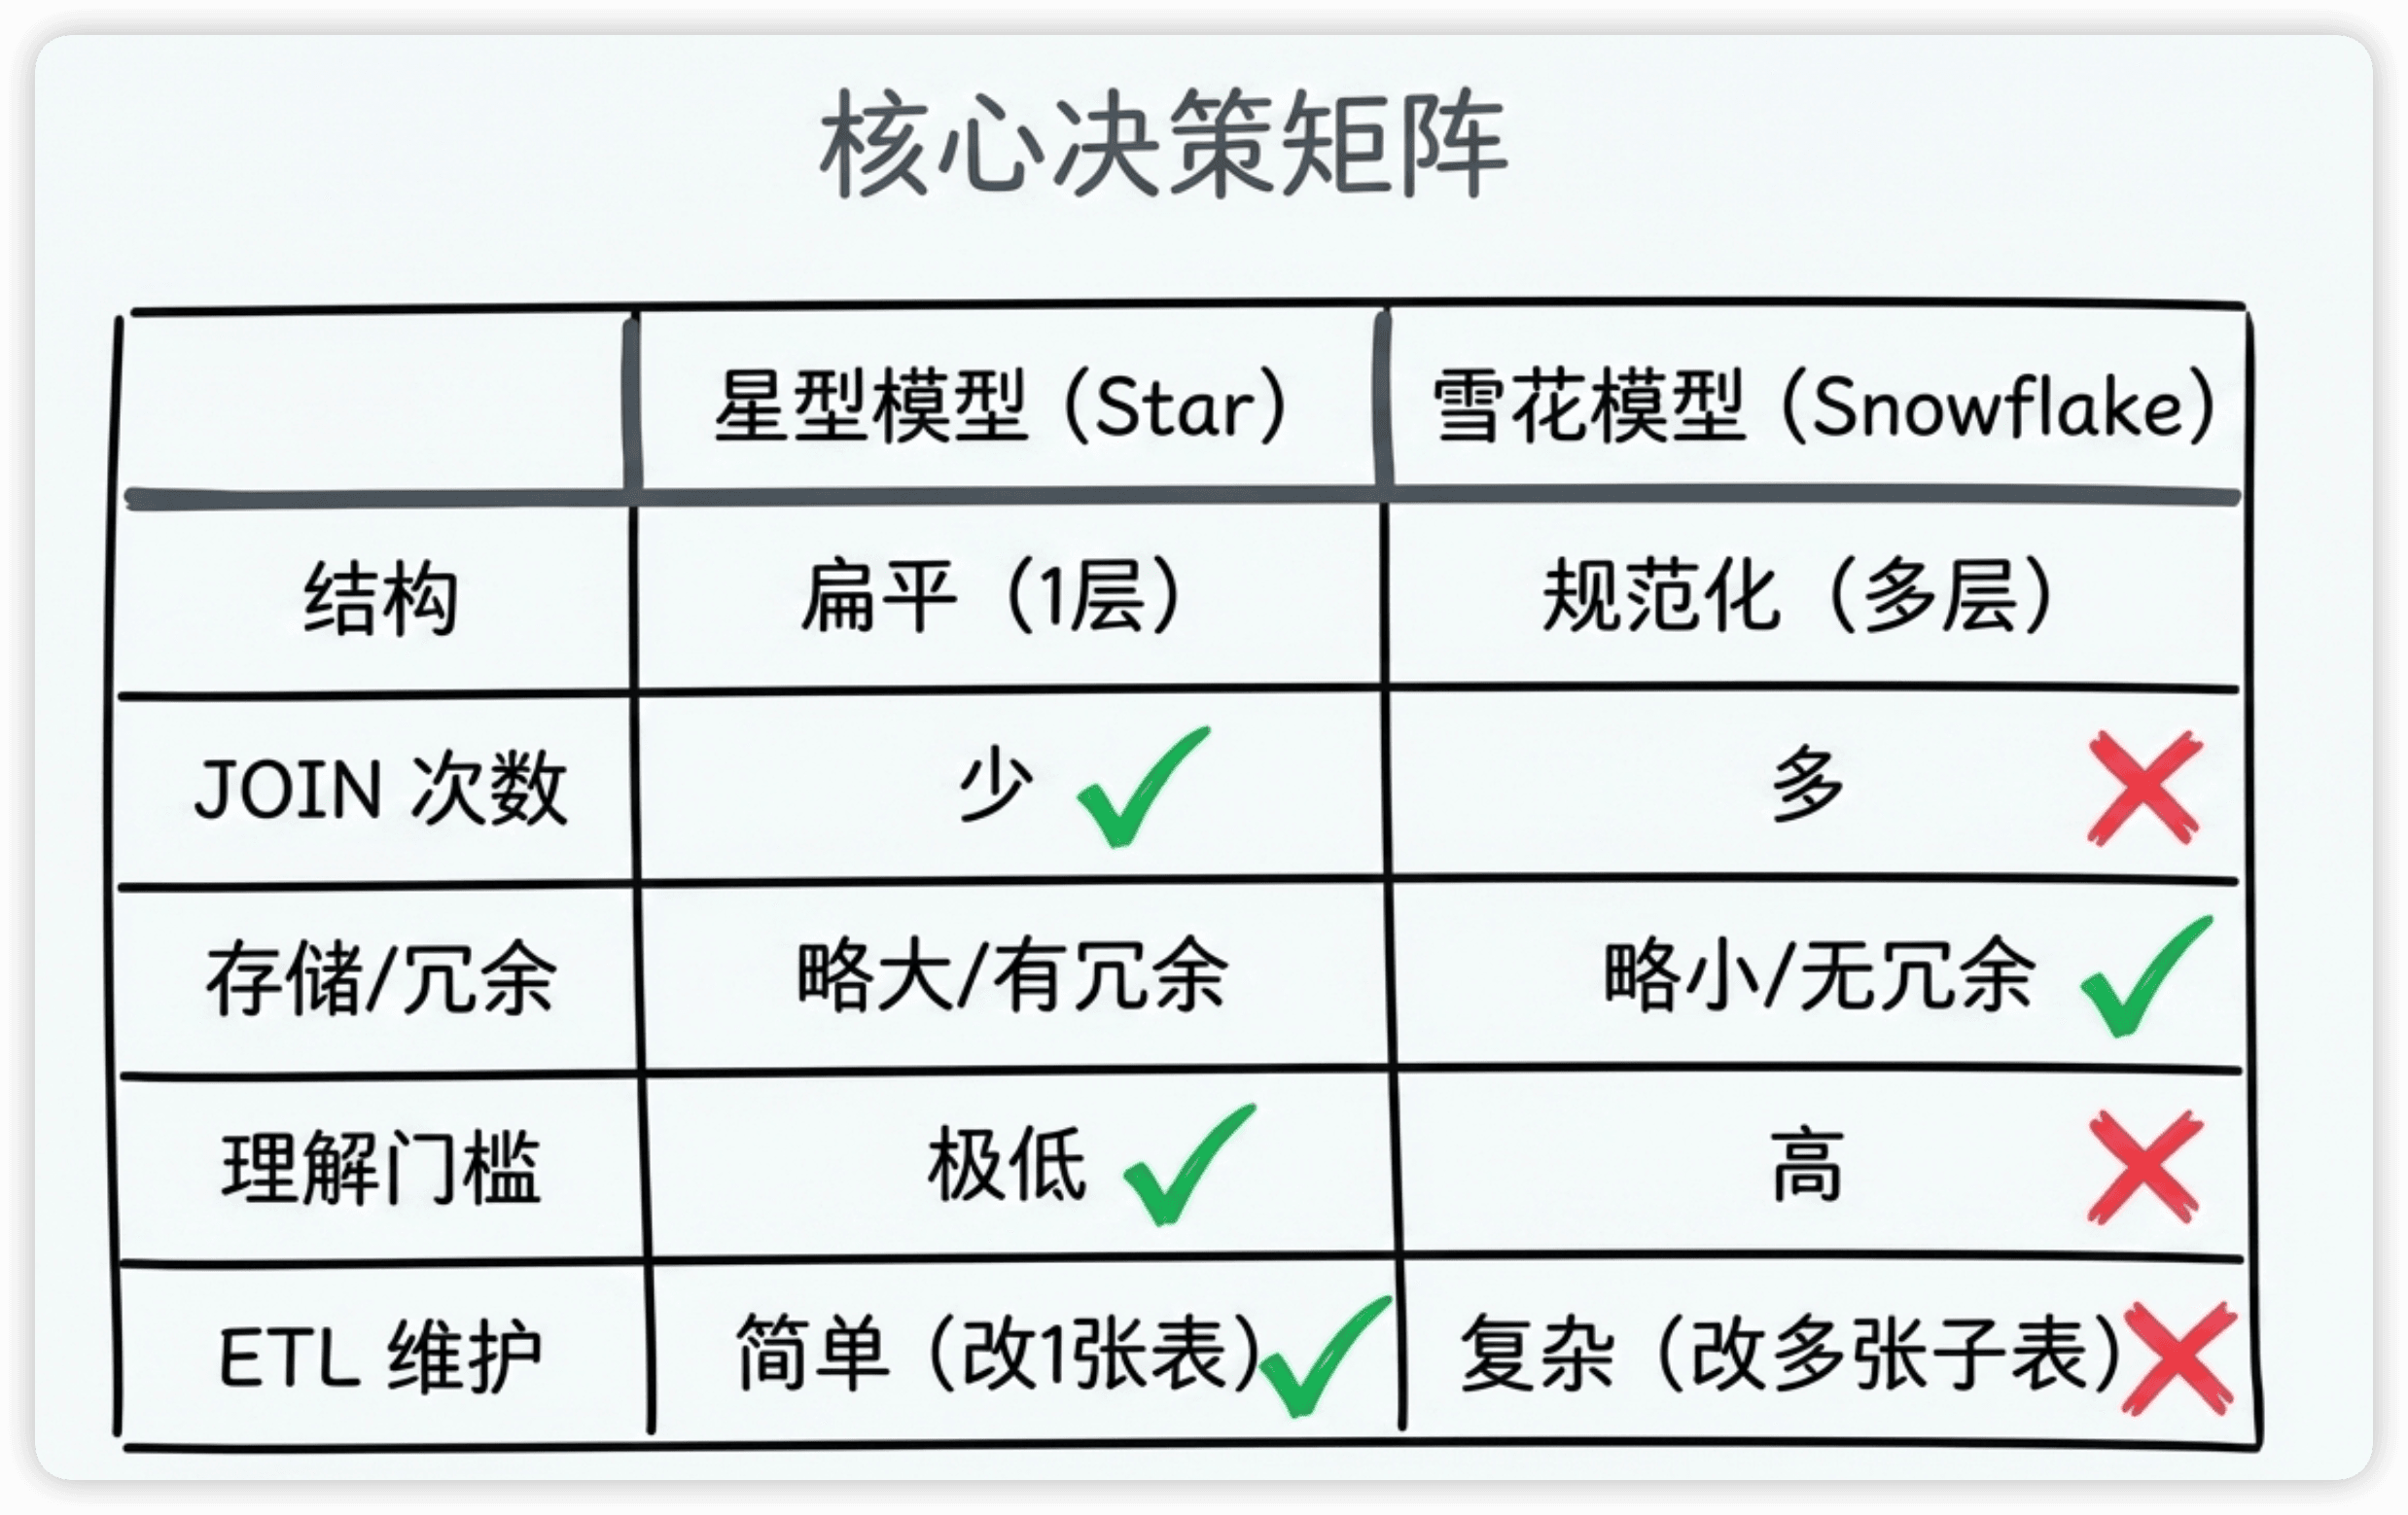
| 对比项 | ⭐ 星型模型 | ❄️ 雪花模型 |
|---|---|---|
| 维度表结构 | 扁平,一层 | 规范化,多层 |
| JOIN次数 | 少,查询快 | 多,查询慢 |
| 数据冗余 | 有冗余(维度值重复存) | 低冗余 |
| 理解难度 | 直观,业务方能看懂 | 复杂,要理解层级关系 |
| ETL复杂度 | 简单 | 复杂(要维护多张维度子表) |
| 存储空间 | 略大 | 略小 |
| 维度更新 | 改一张表 | 可能改多张表 |
| 适用场景 | 大多数OLAP分析 | 维度层级很深且需要严格规范化 |
实际工作中怎么选?
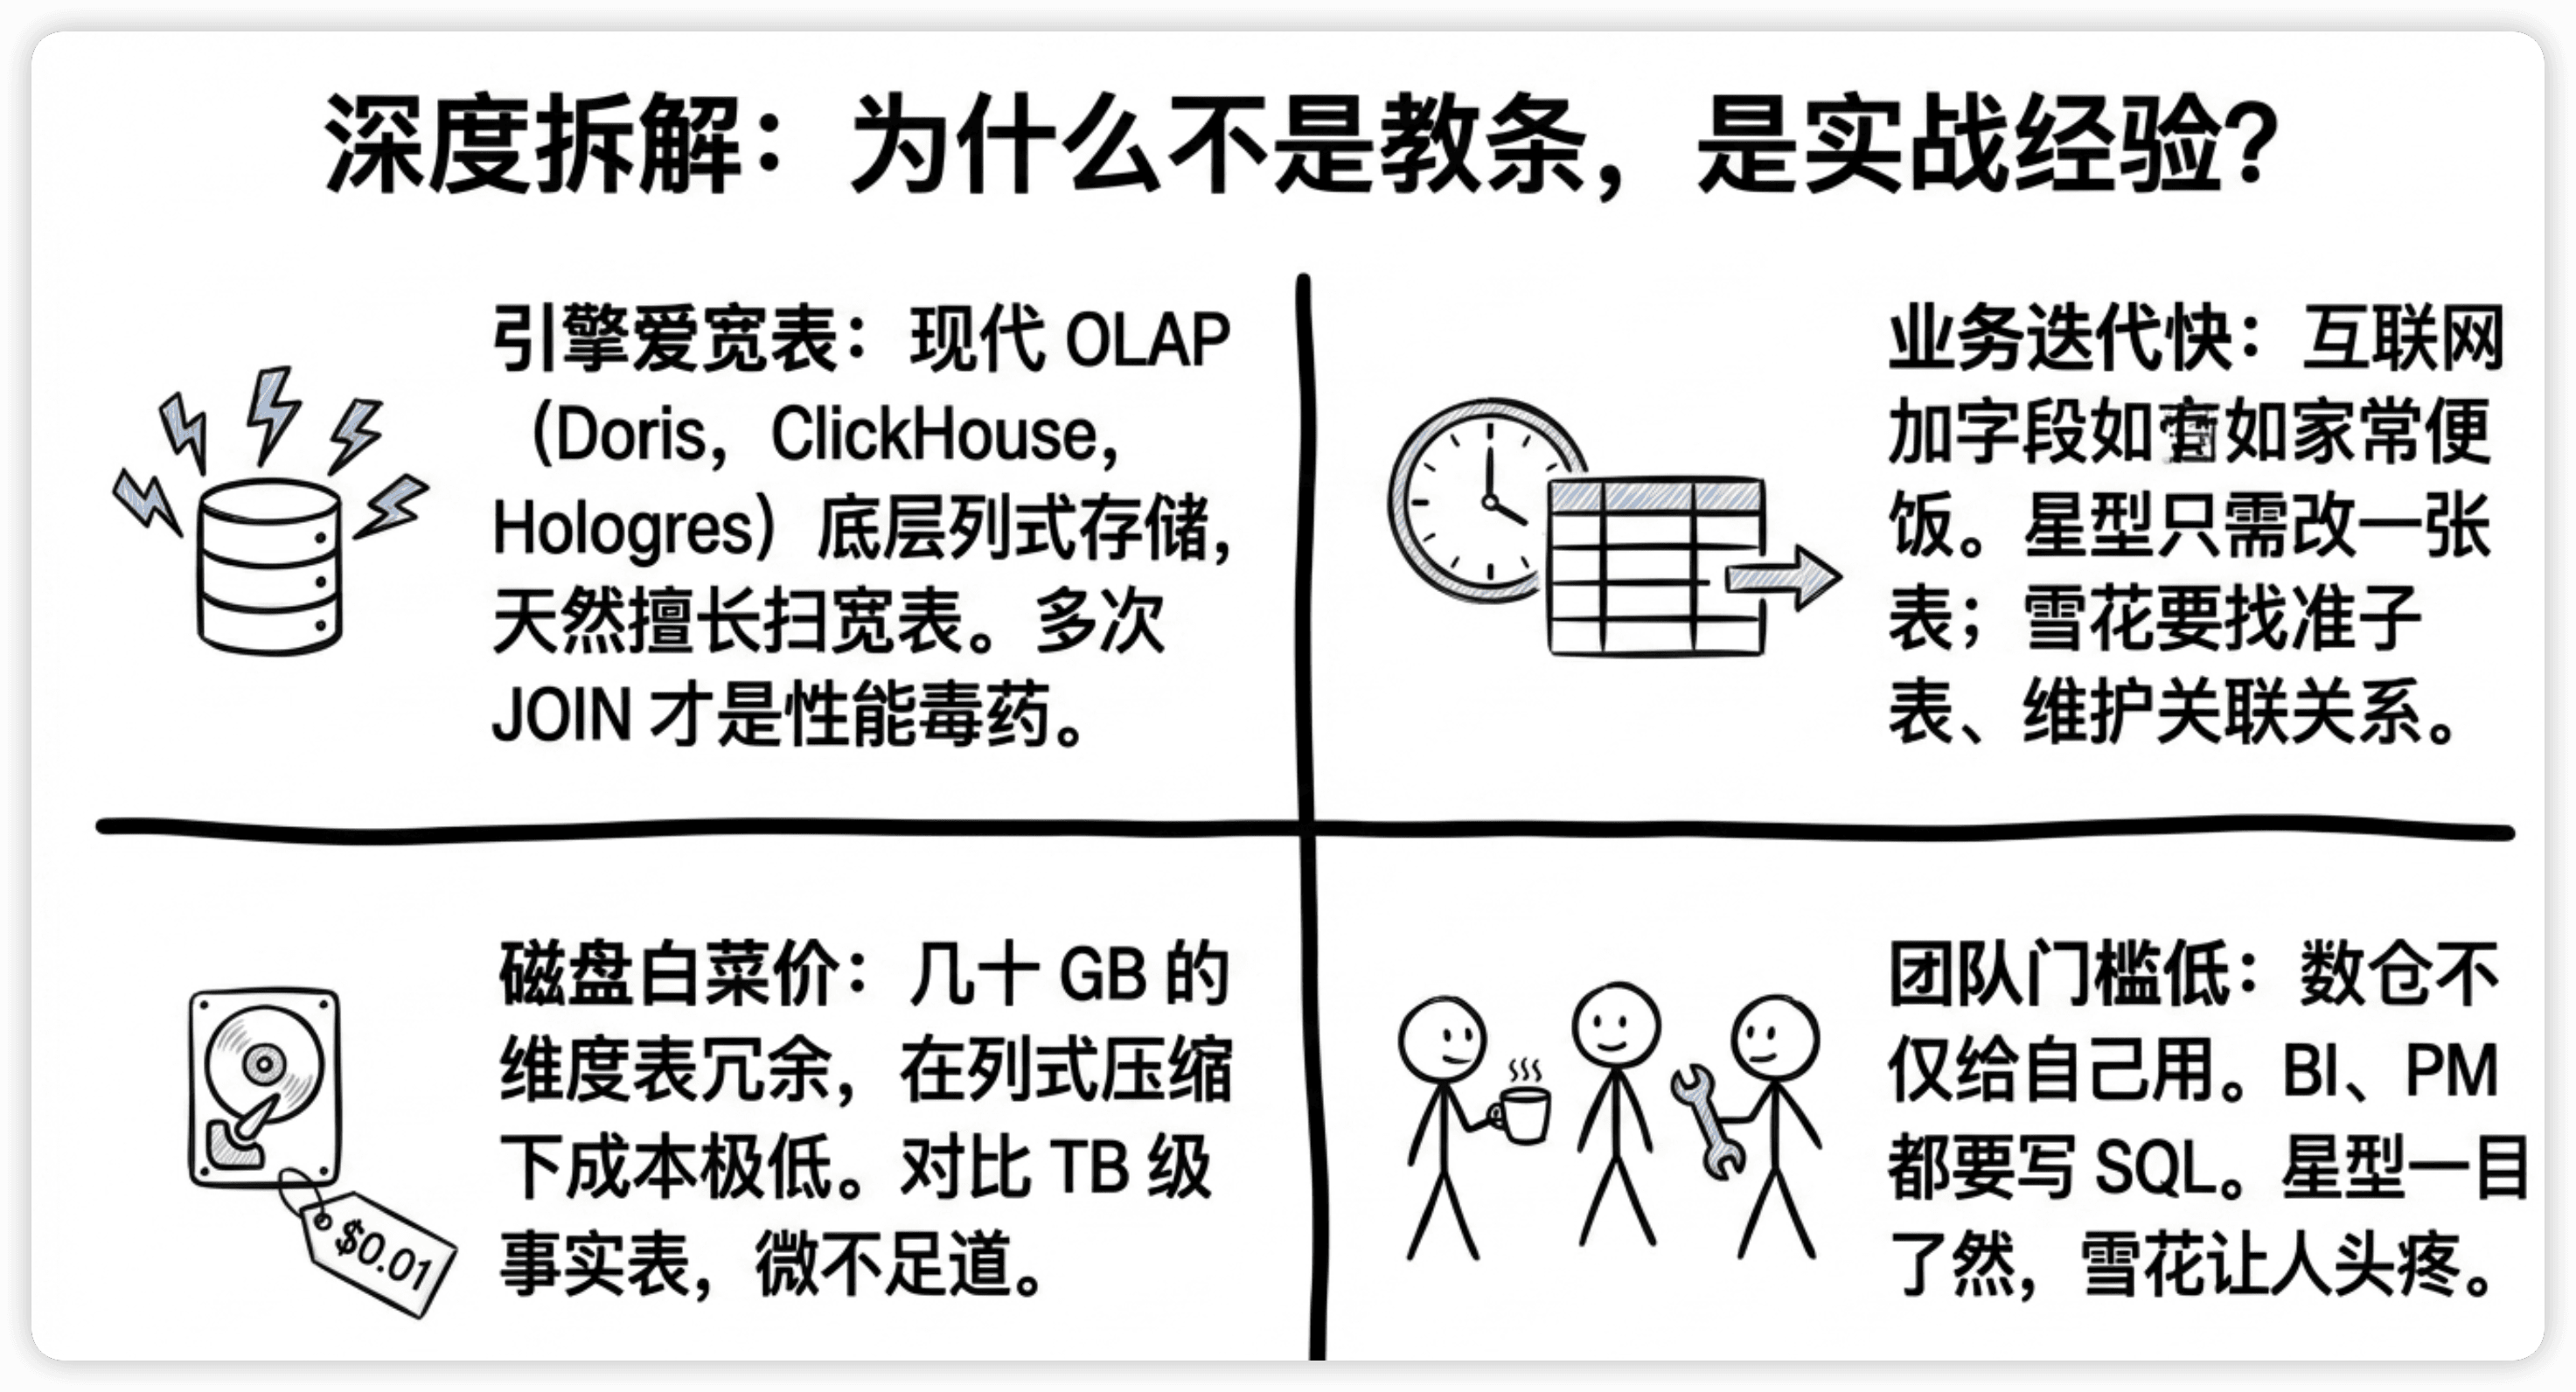
结论先行:90%的场景选星型模型,这不是教条,是实战经验。
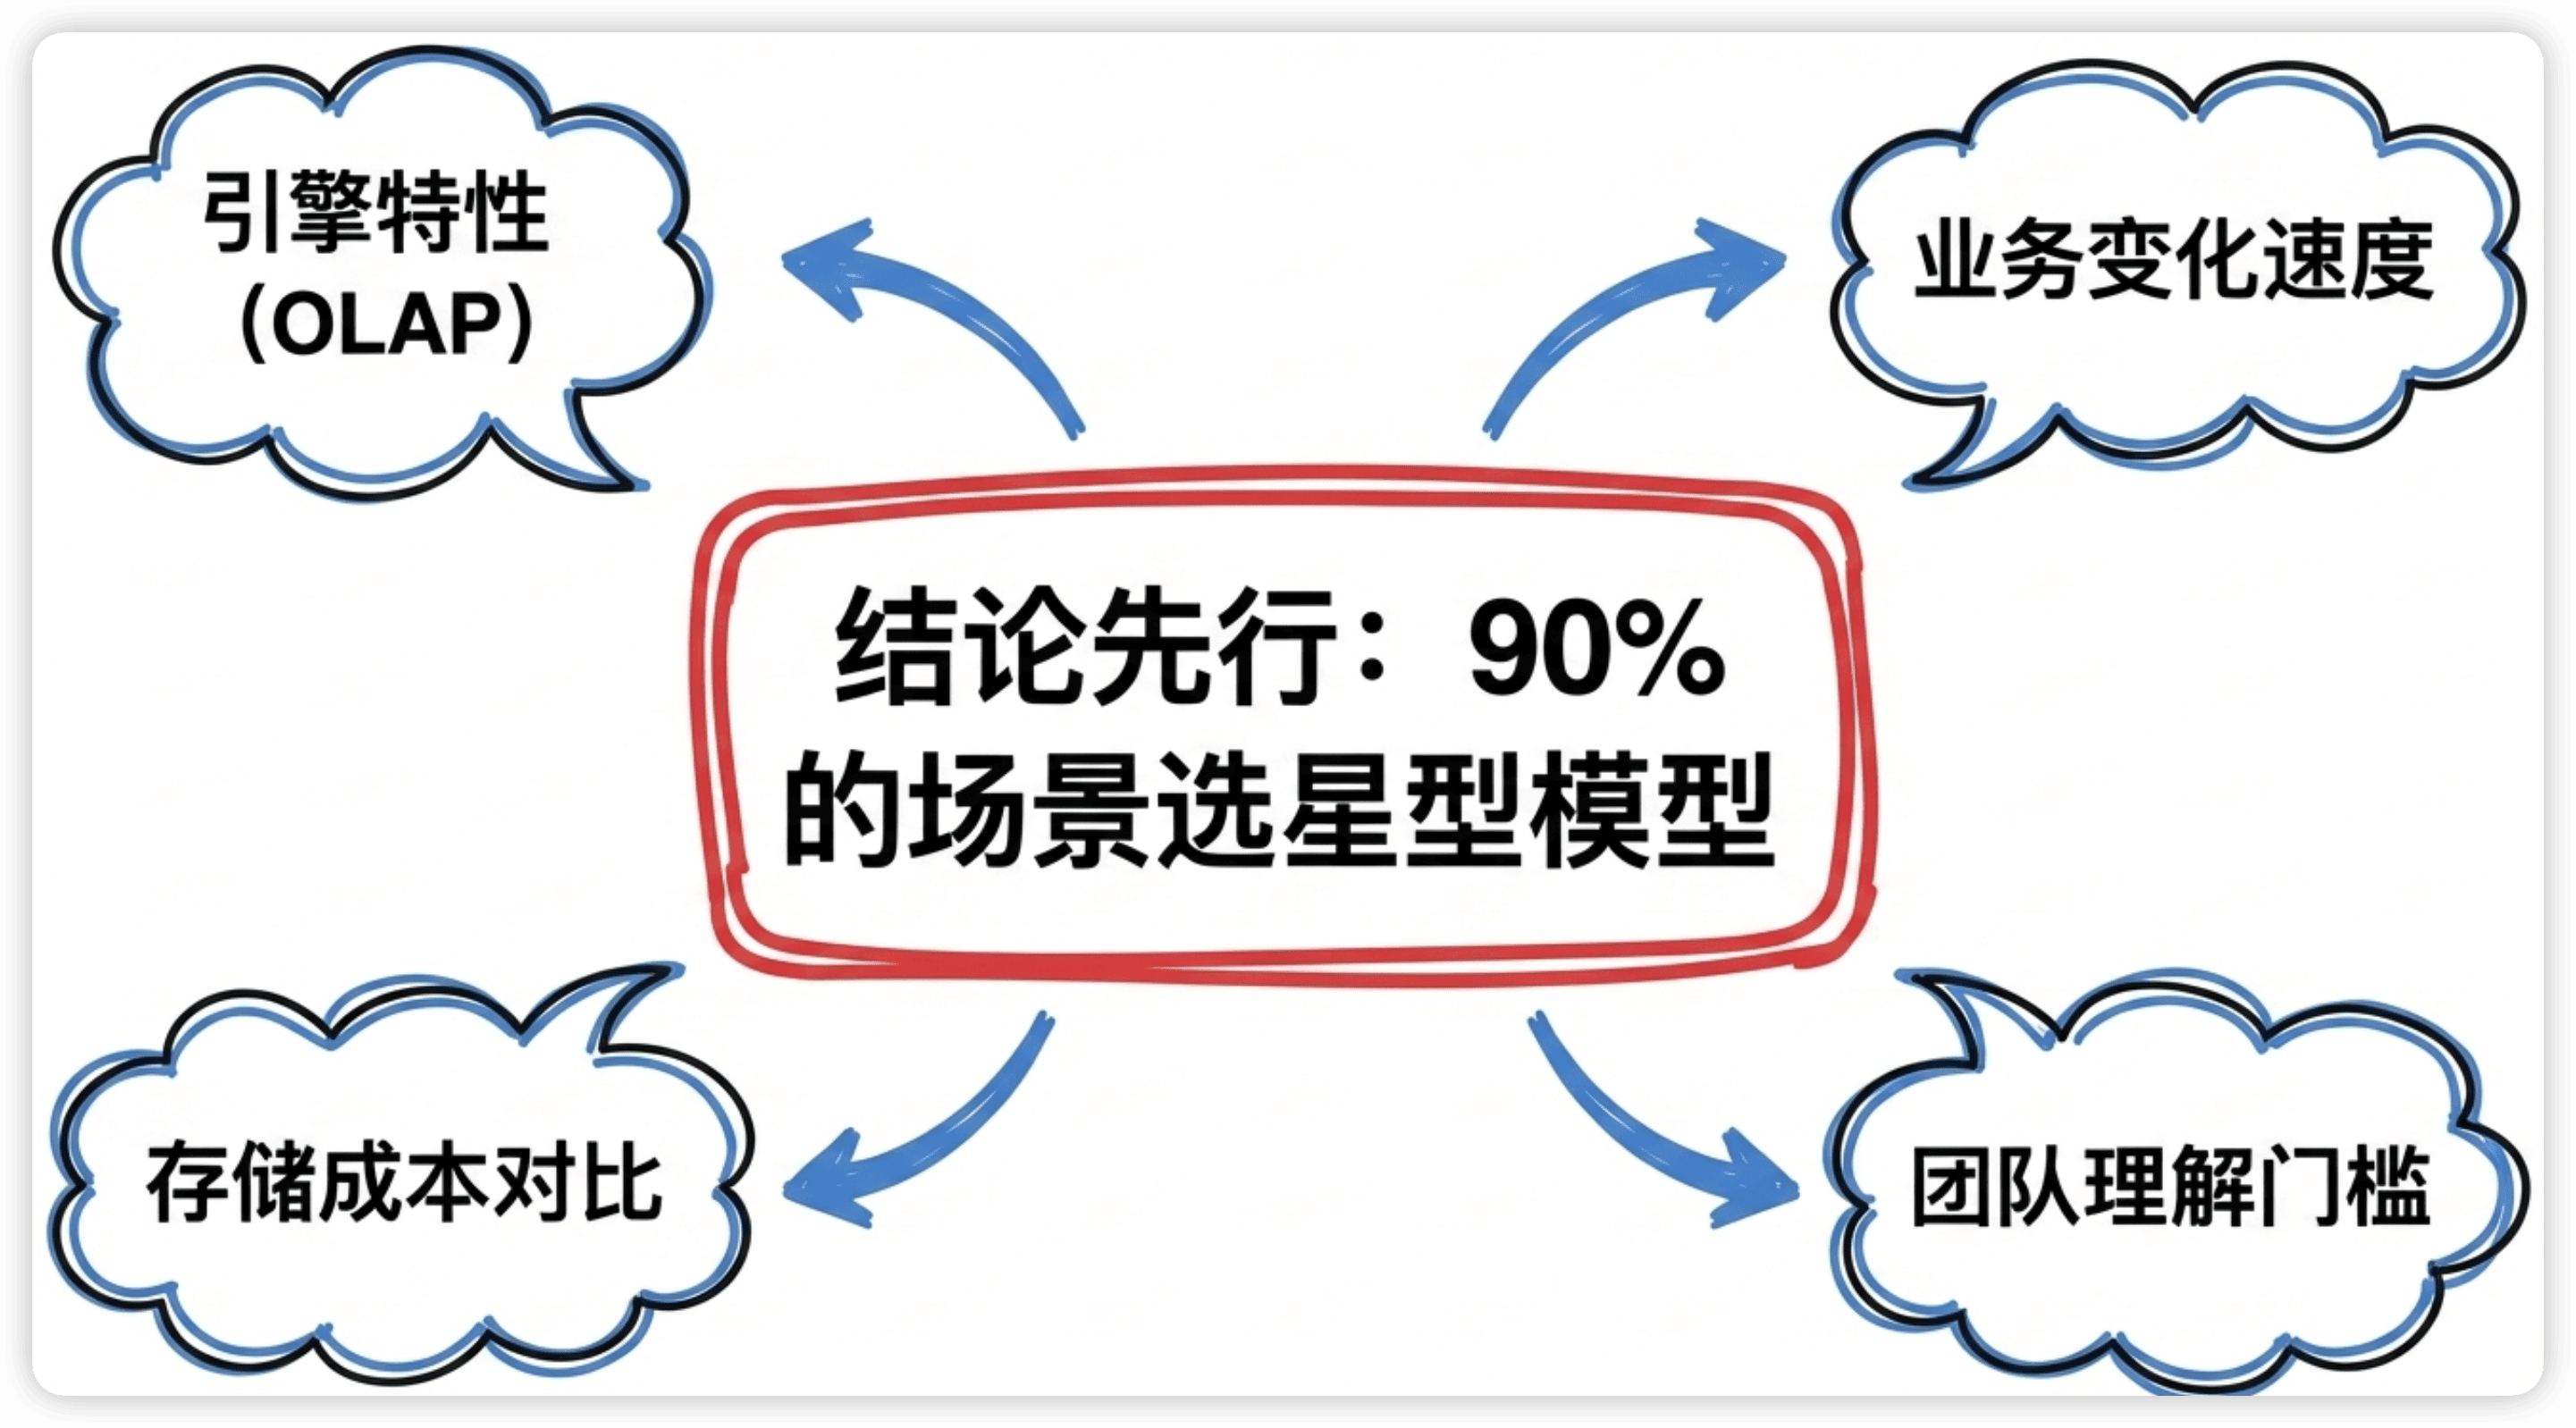
我做了9年数据开发,经历过4家公司——短视频平台、元宇宙社交应用、出海硬件品牌、短剧出海公司——全部用的星型模型为主。不是因为懒,而是因为以下几个原因:
原因一:OLAP引擎更擅长扫描宽表
现在主流的OLAP引擎——Doris、ClickHouse、StarRocks、Hologres——底层都是列式存储,天然擅长扫描大宽表。你把维度信息全塞进一张表里,引擎扫描起来反而更快。反过来,多次JOIN在这些引擎上反而是性能瓶颈。
这和传统关系型数据库(MySQL、PostgreSQL)的思路正好相反。在OLTP数据库里追求第三范式、减少冗余是对的;但在OLAP场景下,冗余不是问题,JOIN才是。
原因二:业务变化快,拆太细维护成本高
互联网公司的业务变化非常快。今天产品说要加一个"用户来源渠道"字段,下周又要加一个"首次付费日期"。如果你用雪花模型把维度拆成了5张子表,每次改动都要想清楚这个字段应该加在哪张子表里,还要处理子表之间的关联关系。
用星型模型就简单多了——直接在dim_user里加个字段就行。
原因三:磁盘便宜,冗余成本可以忽略
雪花模型的主要优势是节省存储。但说实话,在大数据场景下这个优势可以忽略。一张维度表通常几百万行撑死了(用户表顶天了也就千万级),就算字段有冗余,加上列式存储的压缩,多出来的存储成本可能也就几十GB。和每天TB级的事实表数据相比,这点存储根本不值一提。
原因四:团队理解成本低
这一点经常被忽略但非常重要。数仓不是你一个人在用——下游有BI分析师、有产品经理、有运营,他们经常要自己写SQL查数。星型模型一目了然:一张事实表JOIN几张维度表,新人半天就能理解。雪花模型呢?光是搞清楚dim_city和dim_province的关系就要花时间,更别提写查询了。
什么时候考虑雪花?
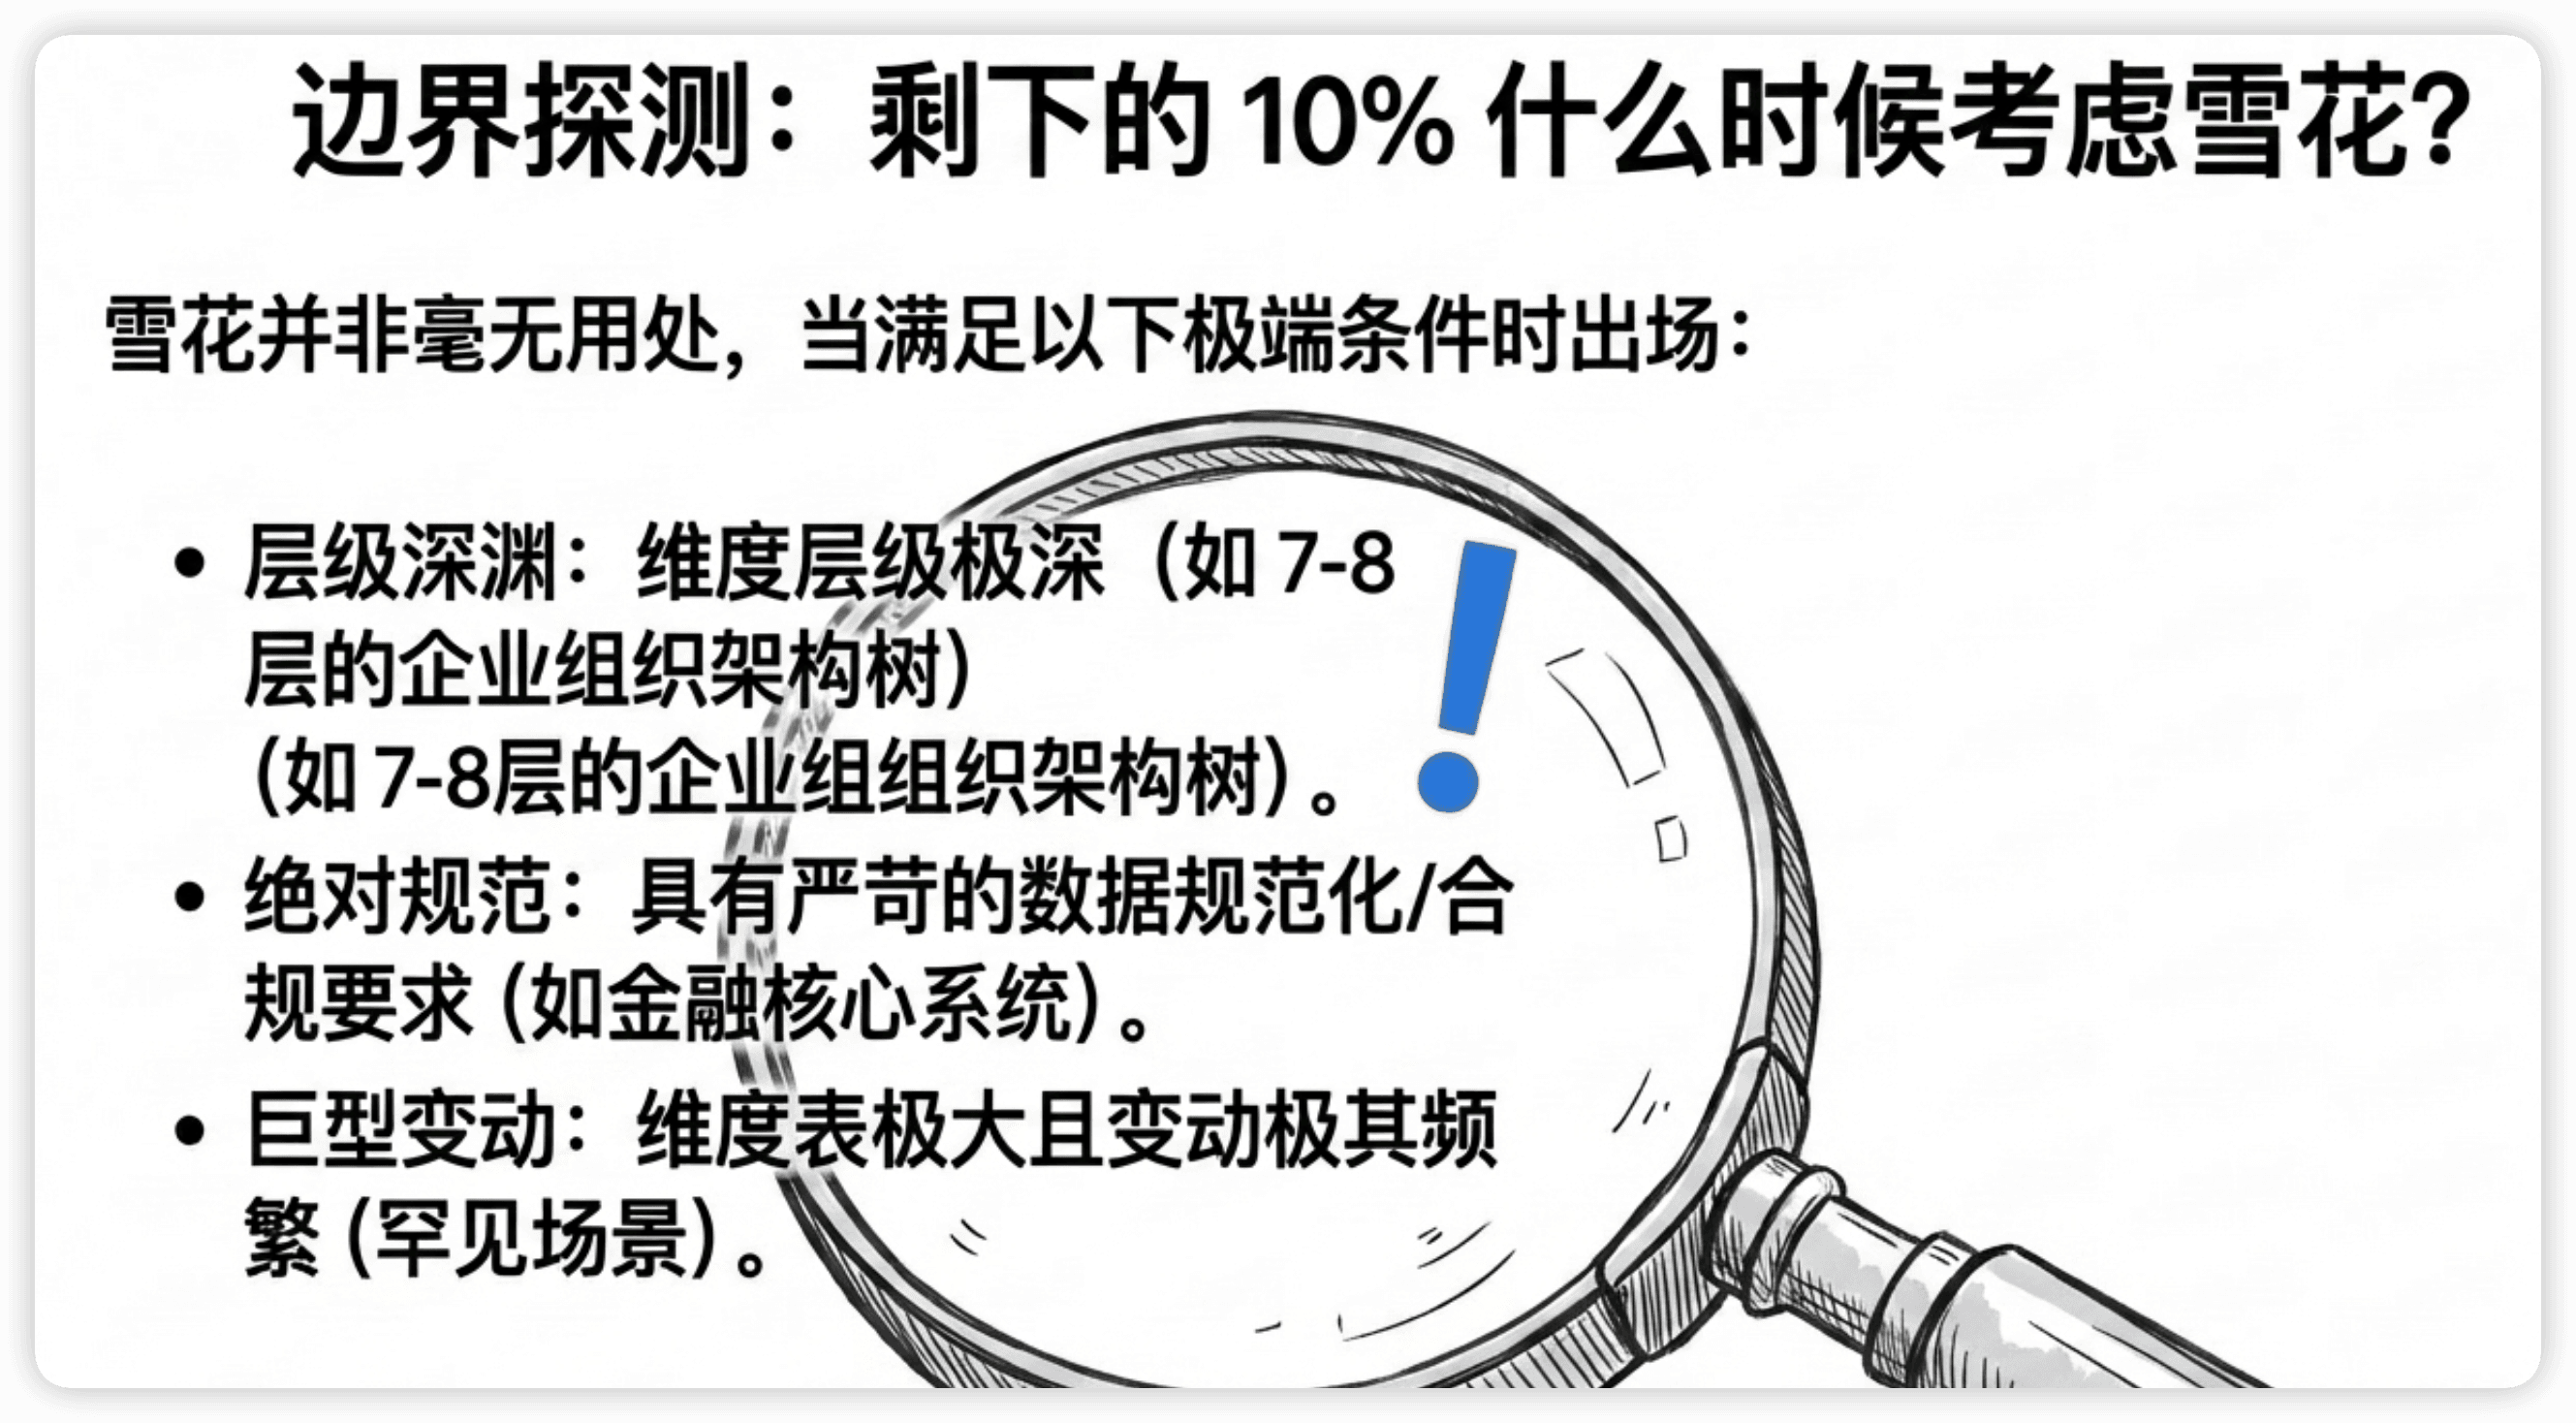
公平地说,雪花模型也不是完全没用。以下场景可以考虑:
- 维度层级特别深(比如组织架构树有7-8层),用星型模型一张表要存太多重复数据
- 有严格的数据规范化要求(比如金融行业的合规要求)
- 维度表非常大且变化频繁(罕见场景)
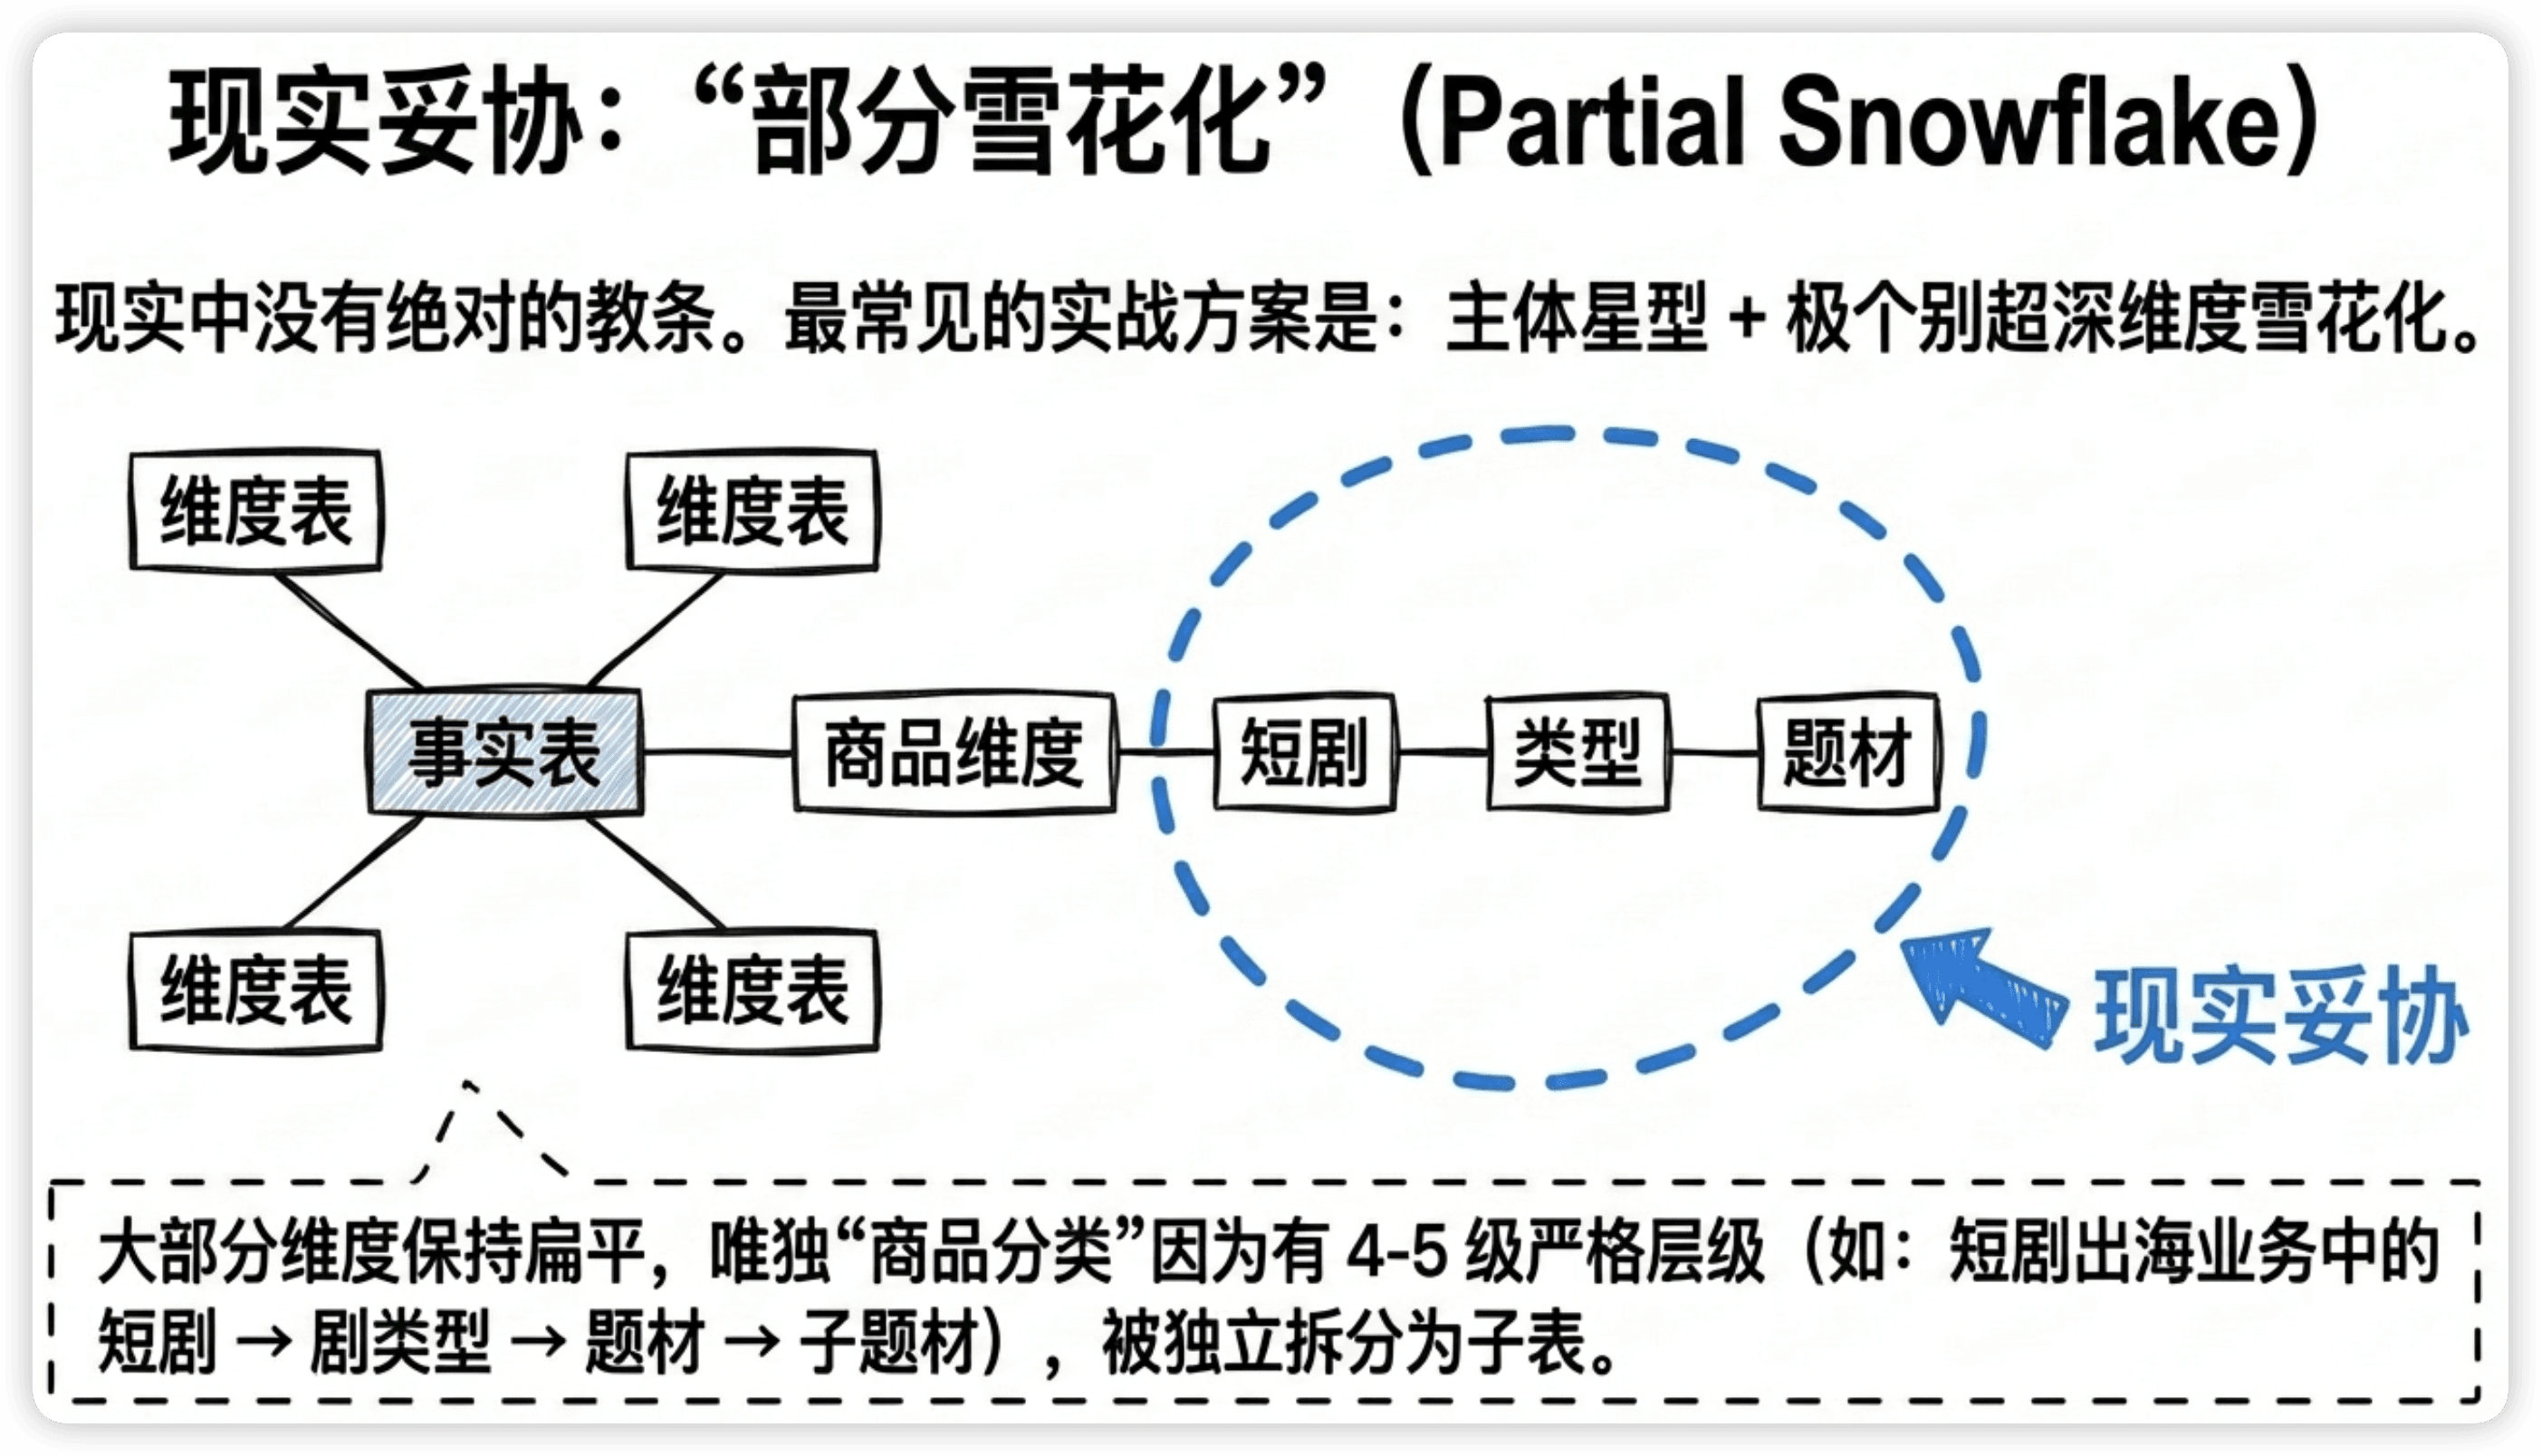
但说实话,我至今没在生产环境中用过纯雪花模型。现实中更常见的是"部分雪花"——主体用星型,个别层级特别深的维度(比如商品分类有4-5级)拆出来一张子表,其他维度还是保持扁平。
面试怎么答?
低分回答
「星型模型JOIN少查询快,雪花模型规范化存储省。我们用星型模型。」
面试官内心OS:谁都知道这些,你告诉我为什么。
高分回答
「我们主要用星型模型,偶尔个别维度做部分雪花化。选型考虑了三点:第一,我们的查询引擎是Hologres,底层列式存储擅长扫描宽表,多次JOIN反而是瓶颈,所以维度表尽量做成扁平的大宽表;第二,我们是出海业务,业务需求变化很快,维度表经常加字段,星型模型改一张表就行,维护成本低;第三,我们数据团队只有3个人,简单的架构更容易维护,新人上手也快。唯一做了雪花化处理的是商品分类维度——分类层级有4级,短剧→剧类型→题材→子题材,这个拆成了独立的分类维度表。」
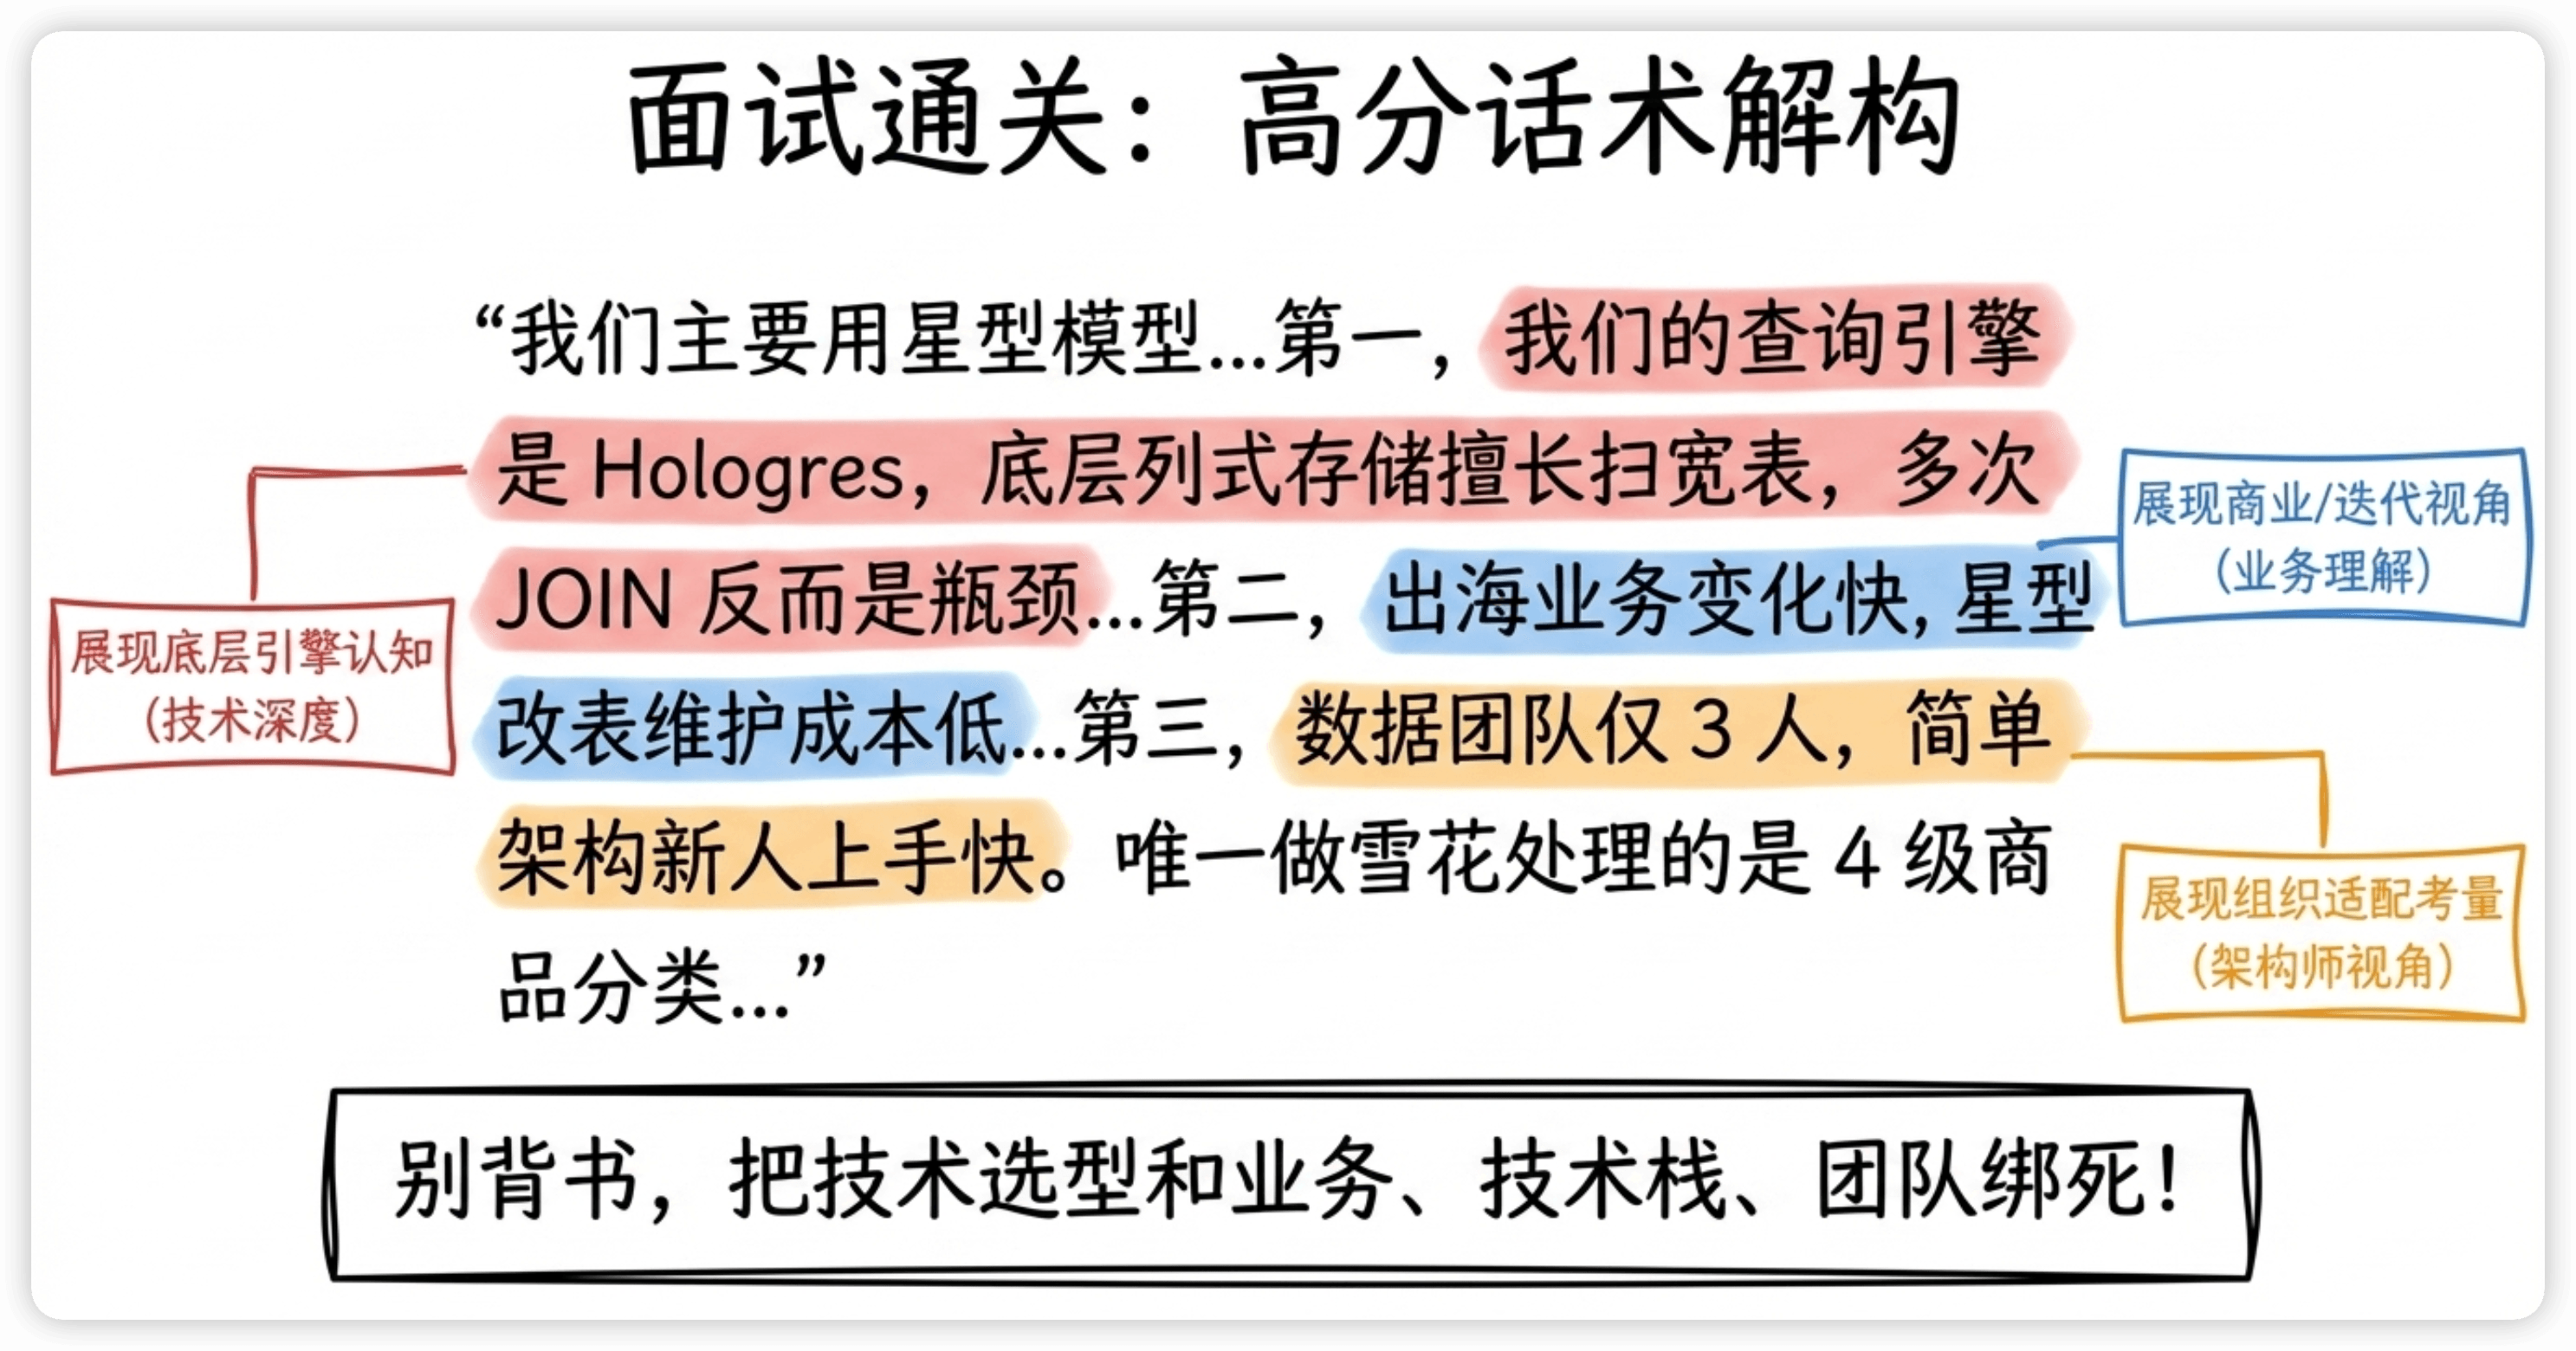
这个回答好在哪里?它不是在背教科书,而是把技术选型和业务场景、技术栈、团队规模绑在一起。面试官一听就知道你是真做过的。
追问防线
追问1:你说90%用星型,那Kimball和Inmon体系有什么区别?
Kimball是维度建模(星型/雪花),自底向上,先建数据集市再整合,适合快速响应业务需求。Inmon是第三范式建模,自顶向下,先建企业级数据仓库再拆分集市,适合大型企业、数据治理要求高的场景。
现在互联网公司几乎都是Kimball体系。Inmon体系建设周期太长,互联网的业务等不了。但两者不是非此即彼——很多公司的DWD层偏Inmon(保持一定范式化),DWS/ADS层偏Kimball(维度建模、宽表),算是取长补短。
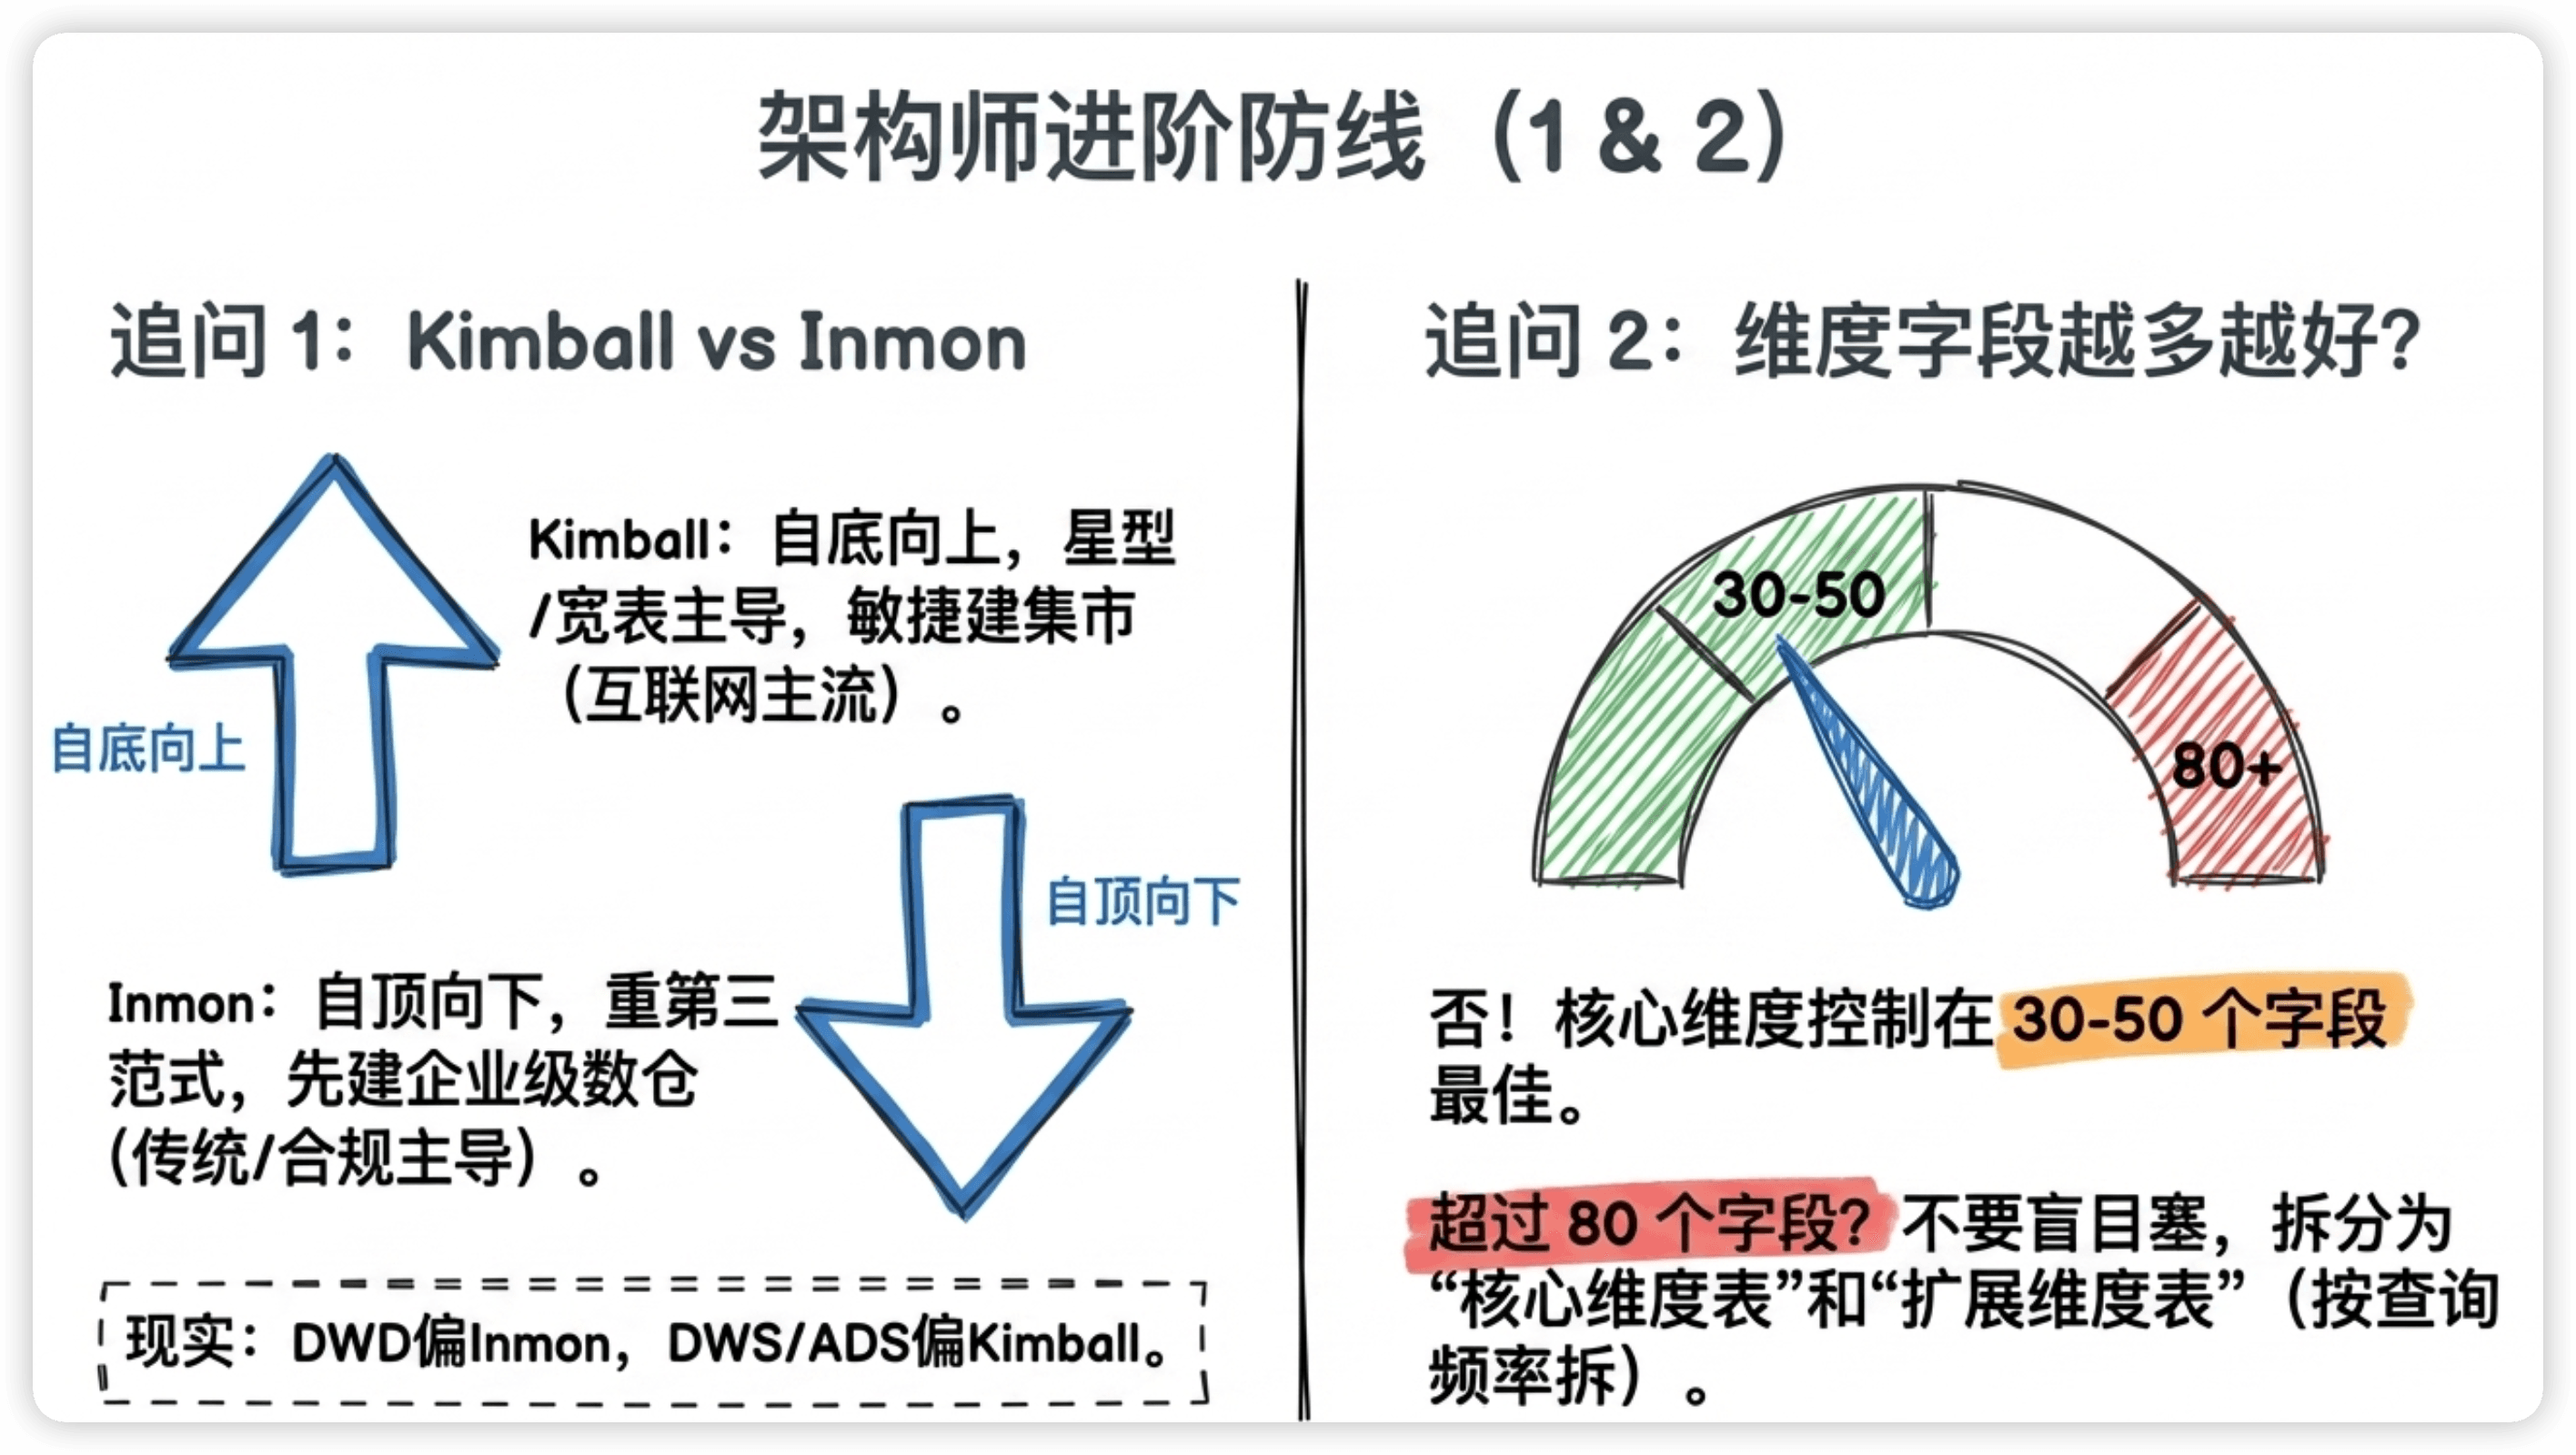
追问2:维度表的字段越多越好吗?
不是。维度表的字段要有选择性。常用的、高频查询的维度字段放进来;极少使用的字段不要硬塞,用的时候再JOIN。
我们团队有个经验值:核心维度表控制在30-50个字段比较合理。超过80个字段就要考虑拆分了——不是拆成雪花,而是拆成"核心维度表"和"扩展维度表",按使用频率分组。
追问3:星型模型和宽表有什么区别?
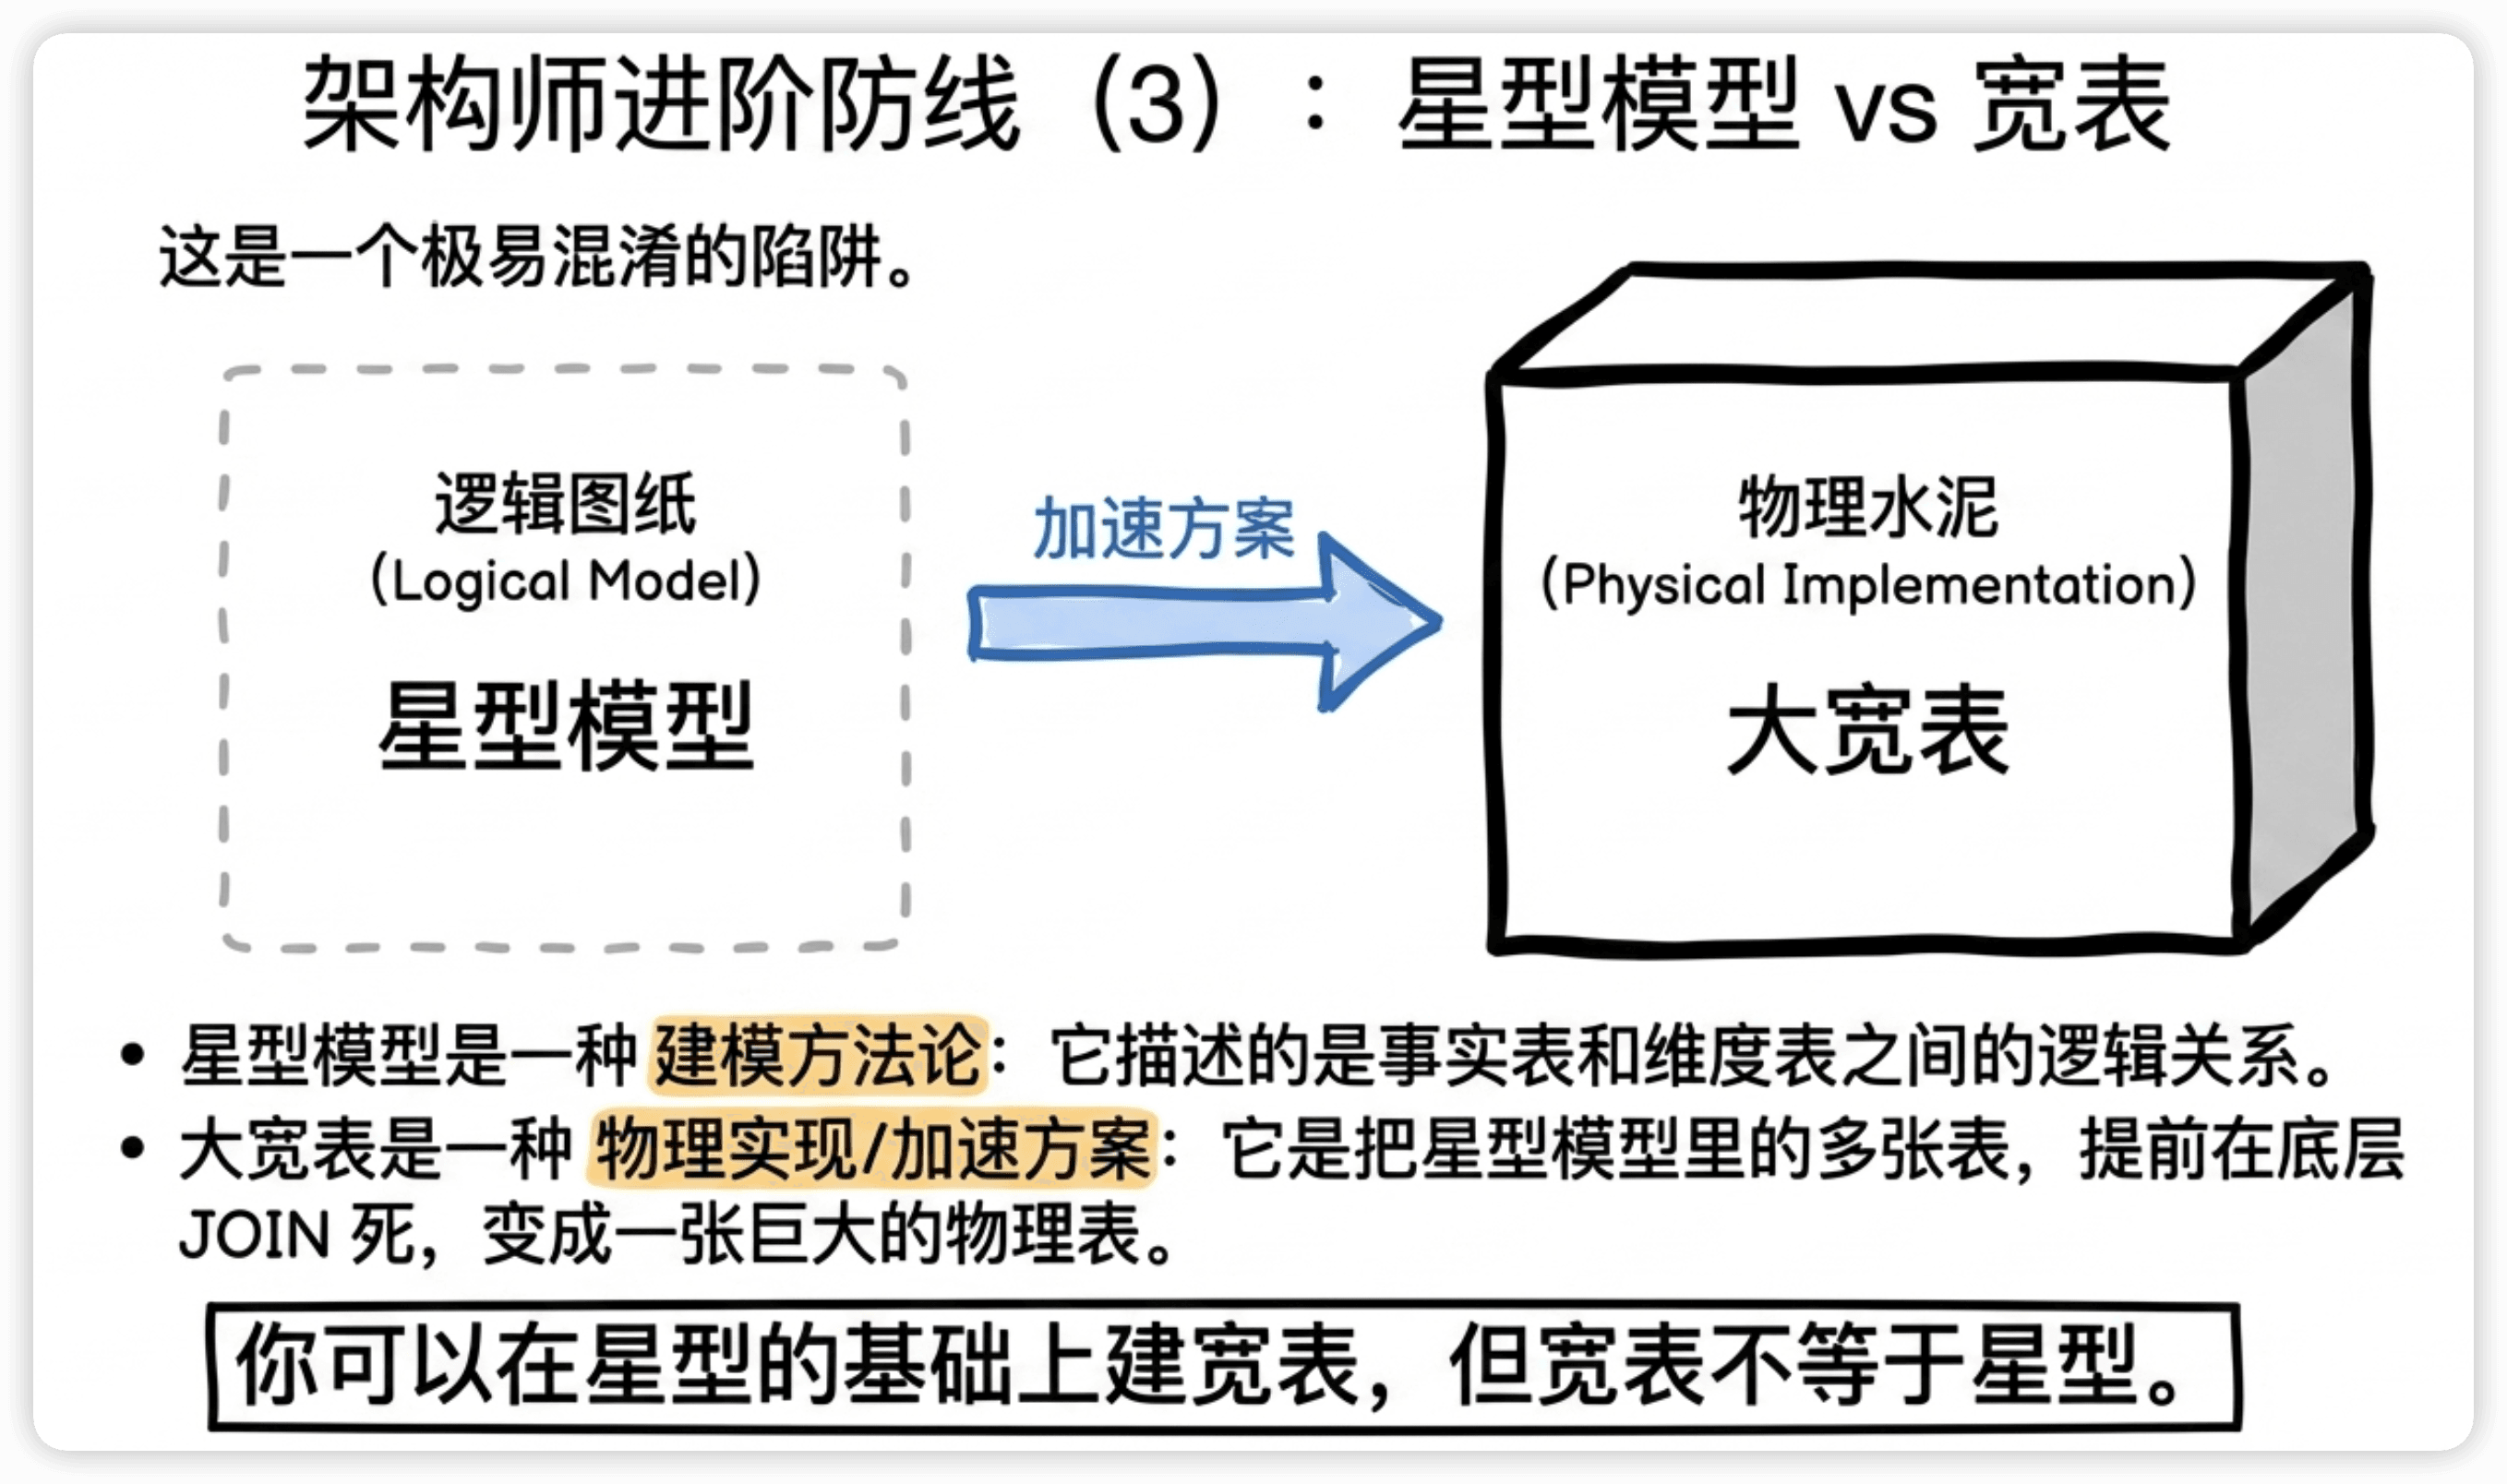
这是个好问题,很多人搞混。星型模型是一种建模方法论,描述的是事实表和维度表之间的关系;宽表是一种物理实现方式,是把多张表的字段提前JOIN到一起。
你可以在星型模型的基础上建宽表——把事实表和几张维度表JOIN好存成一张宽表。但宽表不等于星型模型,它只是星型模型的一种"加速方案"。后面DAY 5会专门讲宽表设计。
总结
- 事实表存度量(金额、次数),维度表存描述(属性),这是维度建模的两块砖
- 星型模型维度表扁平、JOIN少、查询快,是绝大多数场景的首选
- 雪花模型维度表规范化、JOIN多、存储省,仅在维度层级极深时考虑
- 选型要结合查询引擎特性(列式存储更适合宽表)、业务变化速度(快就不要拆太细)、团队规模(人少就选简单的)
- 面试时把技术选型和业务场景绑定起来说,才是高分回答