你有遇到过 Spark 的数据倾斜吗?
面试怎么回答
我遇到过。我的处理思路不是直接加盐,而是先确认是不是倾斜。我会在 Spark UI 里看同一个 Stage 的 Task 耗时、Shuffle Read 和记录数分布。如果只有少数 Task 数据量和耗时明显偏高,再定位对应的 Join 或聚合 key。聚合热点通常用两阶段聚合或加盐;小表 Join 优先考虑 Broadcast;NULL 和默认值热点会先过滤或拆开处理。Spark SQL 也可以利用 AQE 拆分部分倾斜的 Join 分区。核心是先找到数据为什么集中,再选择方案,而不是只调大资源。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
你是怎么发现,又是怎么解决的?
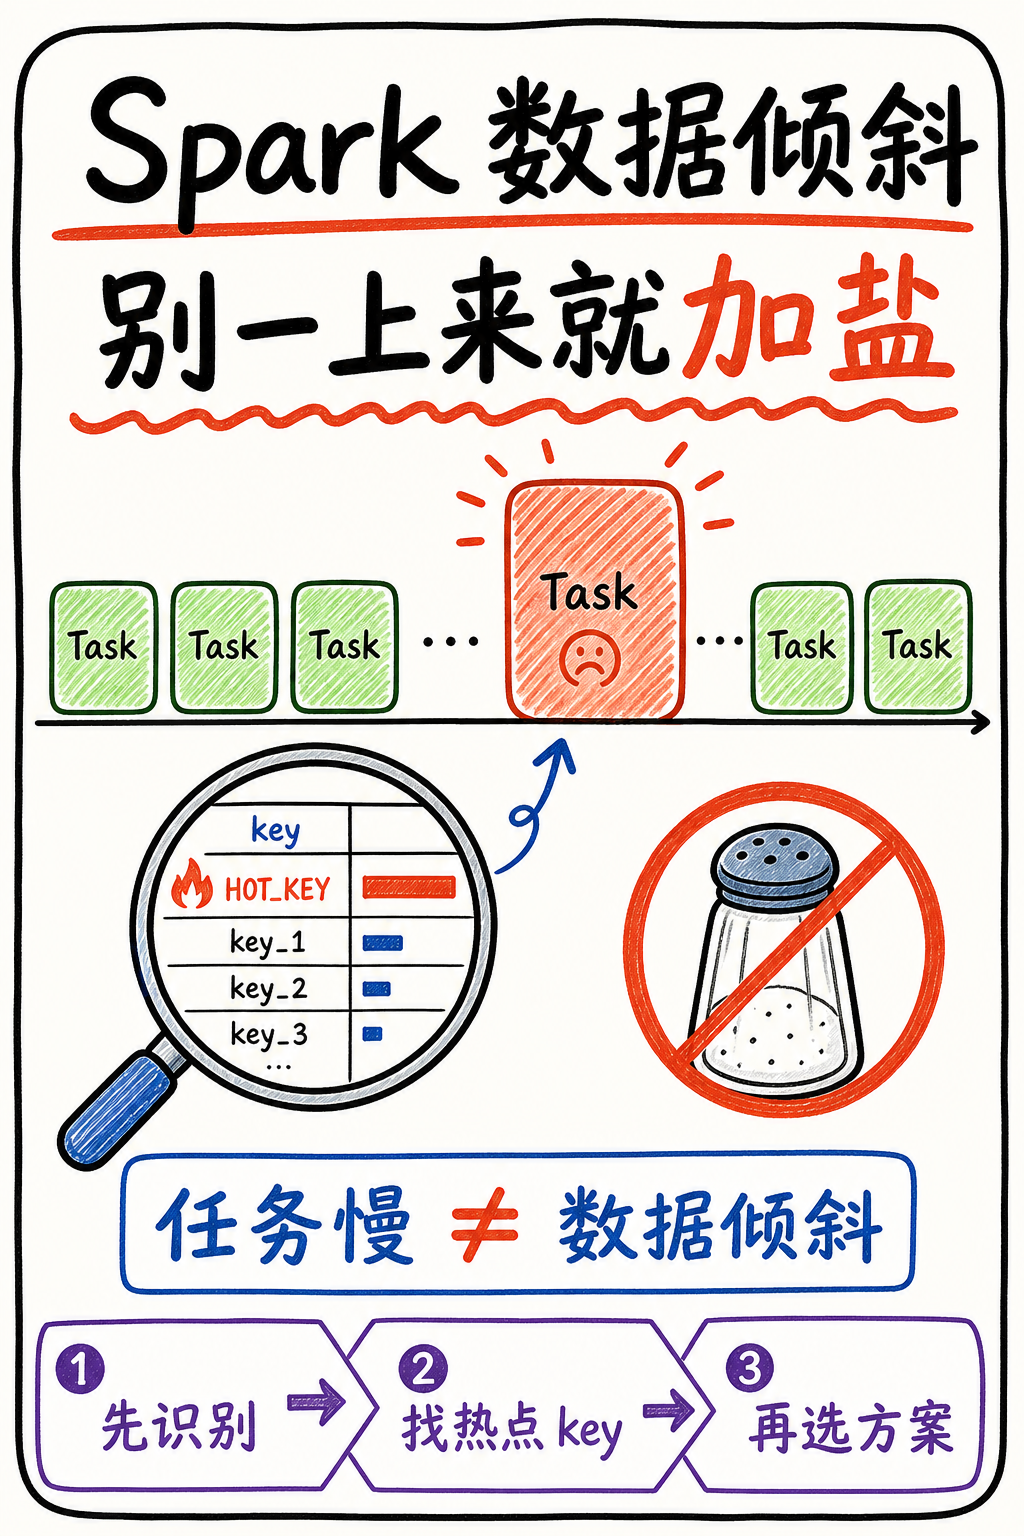
很多人一上来就回答:
- 给 key 加盐
- 调大 Shuffle 分区数
- 增加 Executor
这些方法都可能有用。
但如果只回答这些,面试官很可能会继续追问:
你怎么确定它真的是数据倾斜?又怎么知道该用哪一种方案?
因为 Spark 任务跑得慢,不一定就是数据倾斜。
真正有价值的回答,不是背优化手段,而是讲清楚一条完整链路:
先识别倾斜,再定位倾斜 key,最后根据产生原因选择方案。
第一步:先确认是不是数据倾斜
数据倾斜最典型的现象,不是整个任务都慢。
而是同一个 Stage 里:
- 大部分 Task 很快结束
- 少数 Task 长时间跑不完
- 个别 Task 的 Shuffle Read 或输入记录数远高于其他 Task
- 严重时还会出现大量 Spill、GC,甚至 OOM
这时候应该先看 Spark UI,而不是马上改参数。
重点看三个地方:
一看 Task 耗时分布
如果所有 Task 都慢,更可能是资源不足、计算逻辑复杂或者外部存储慢。
如果只有少数 Task 特别慢,才需要重点怀疑数据倾斜。
二看数据量分布
比较不同 Task 的 Input Size、Shuffle Read、Records 数量。
数据倾斜的本质,是少数分区承担了远高于其他分区的数据量。
三看执行算子
继续确认问题发生在 Join、Group By、窗口计算,还是 explode 之后。
因为发生位置不同,后面的解决方式也不一样。
先证明是倾斜,再谈怎么优化。

第二步:找到底是哪一类倾斜
确认倾斜之后,不应该直接加盐,而是继续查数据分布和执行计划。
实际工作中常见的原因主要有下面几类。
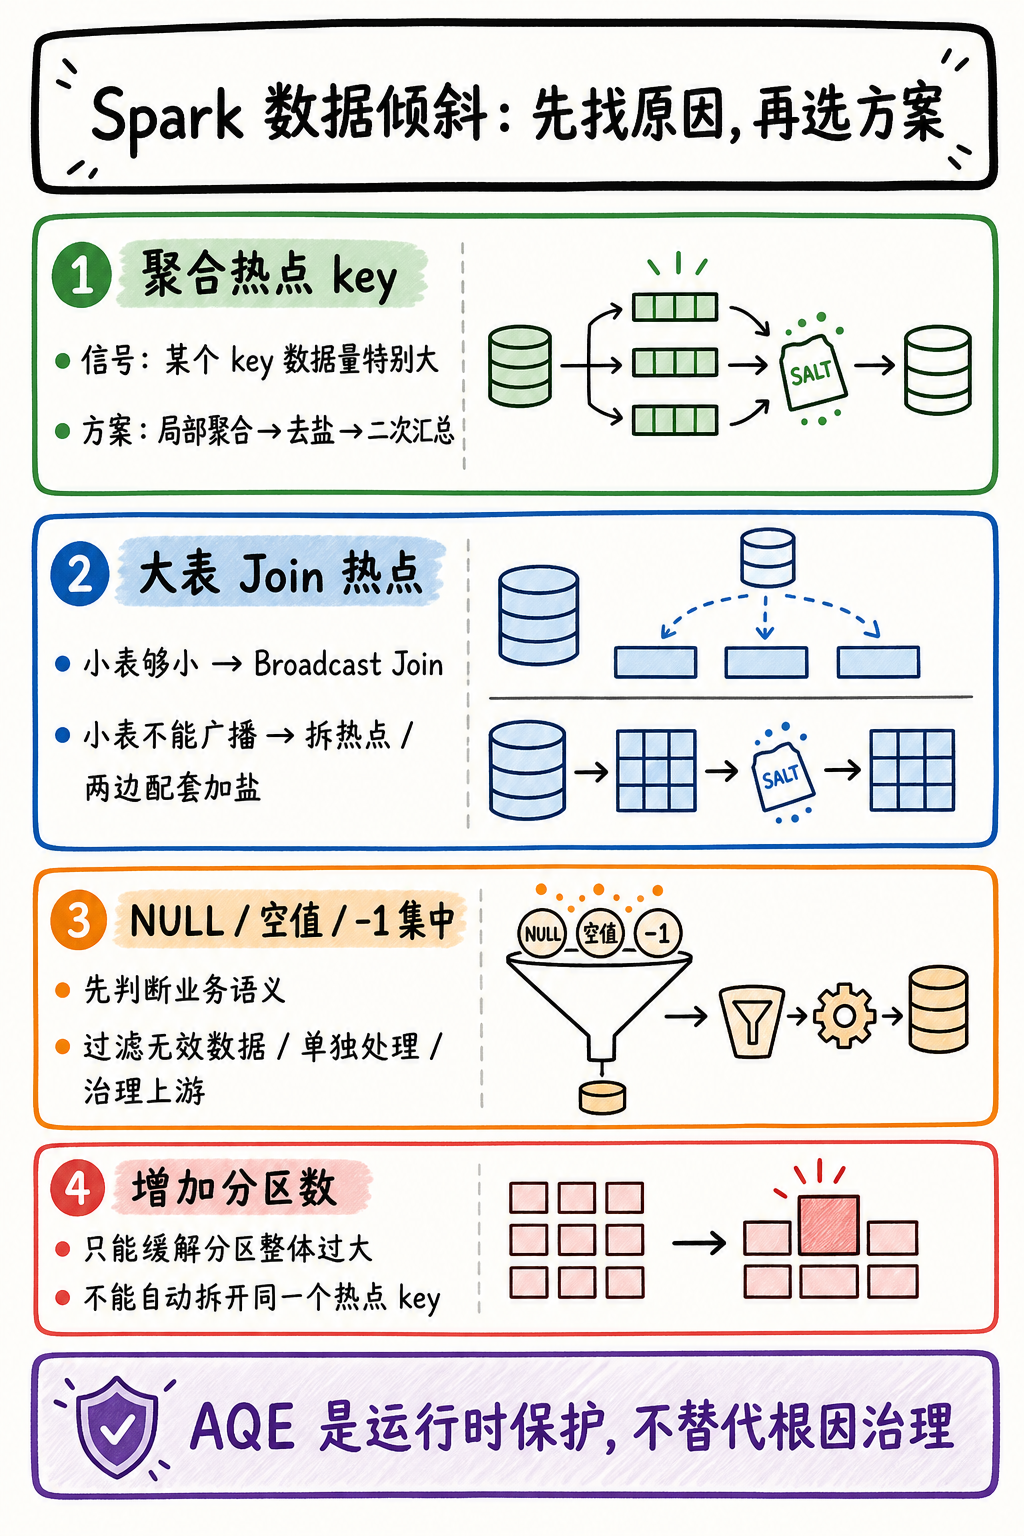
第一类:聚合 key 本身就是热点
例如按店铺统计订单,某个头部店铺的数据量远高于其他店铺。
所有相同 key 最终都要进入同一个分区,单纯增加分区数并不能拆开这个热点 key。
这种情况可以考虑:
- 先给热点 key 加随机前缀,做第一次局部聚合
- 去掉随机前缀,再做第二次汇总
- 能在上游预聚合的,尽量减少进入 Shuffle 的数据量
第二类:大表 Join 出现热点 key
例如大量事实数据都关联到同一个用户、商品或者默认值。
这时要先判断小表能不能广播。
如果维表足够小,使用 Broadcast Join 可以直接避免大表一侧按 Join key Shuffle。
如果不能广播,可以把热点 key 单独拆出来处理,或者给大表热点数据加盐,并对小表对应记录进行扩容后再 Join。
Spark SQL 的 AQE 也能在运行时识别并拆分部分倾斜的 Sort Merge Join 分区,但它更像一道运行时保护,不能替代对热点数据和业务语义的治理。
第三类:NULL 或默认值被集中到一起
这是非常容易被忽略的一种。
比如大量无效记录的 user_id 都被处理成 NULL、空字符串或者 -1。
业务上它们可能没有关联意义,但计算时却会被当成同一个 key,全部打到同一个分区。
这种情况应该先判断:
- 无效 key 是否可以直接过滤
- 是否需要单独走一条处理链路
- 默认值是否掩盖了上游数据质量问题
很多时候,清理无效 key 比加盐更直接。
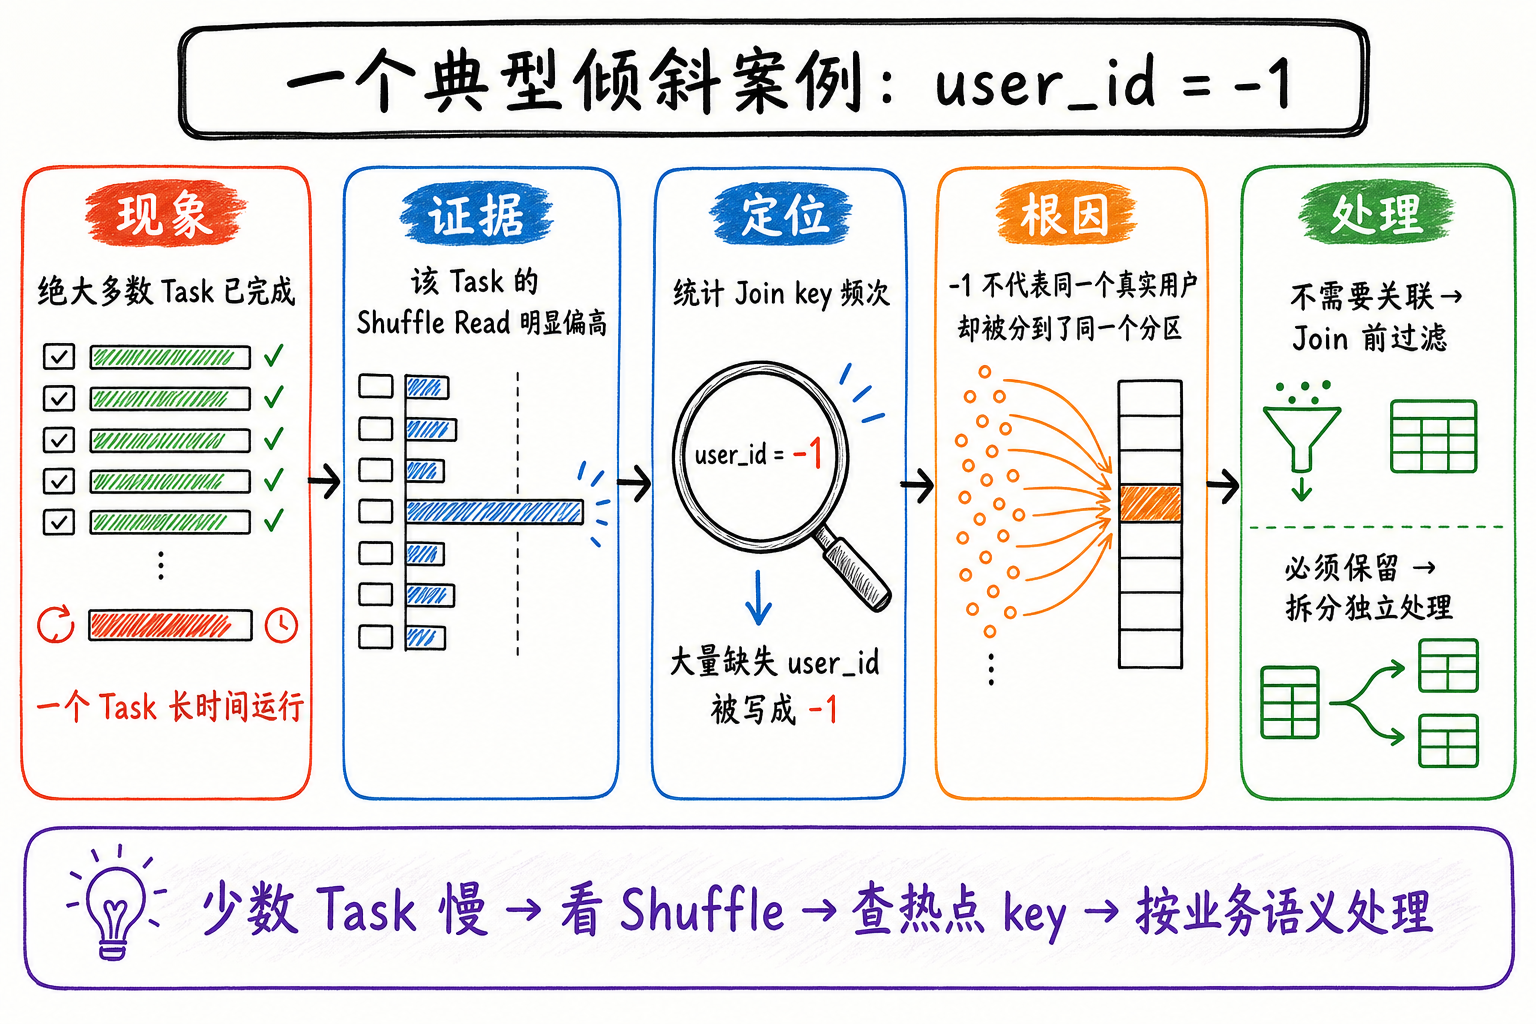
一个典型生产场景
比如一张行为明细表要关联用户维表。
任务运行后,绝大多数 Task 已经完成,只有一个 Task 长时间没有结束。
继续查看 Spark UI,会发现这个 Task 的 Shuffle Read 明显高于其他 Task。
再对 Join key 做频次统计,发现历史数据中大量缺失的 user_id 被统一写成了 -1。
问题就清楚了:
-1 并不代表同一个真实用户,却让大量数据集中到了同一个分区。
如果这些数据不需要参与用户关联,可以在 Join 前过滤或单独处理;如果必须保留,也应该把这部分数据拆开走独立逻辑,而不是盲目增加 Executor。
这条排查链路是:
少数 Task 异常慢 → 查看 Shuffle 分布 → 统计 Join key → 找到默认值热点 → 按业务语义拆分处理。
为什么“增加分区数”经常没效果?
因为增加分区数解决的是“分区整体太大”,不一定能解决“某一个 key 太大”。
假设同一个热点 key 有大量数据。
无论设置 200 个还是 2000 个分区,只要分区规则仍然基于这个 key,它最终还是会进入同一个分区。
同样,增加 Executor 只能增加可用资源。
如果最后只剩一个倾斜 Task 在跑,其他 Executor 仍然可能处于空闲状态。
所以优化数据倾斜最关键的一步不是调参数,而是回答:
为什么这些数据会集中到同一个分区?
我理解的 Spark 数据倾斜处理
Spark 数据倾斜不是一个固定参数问题,而是一个数据分布问题。
加盐、Broadcast Join、两阶段聚合、拆分热点数据、开启 AQE,都只是工具。
真正高级的处理方式,是先用 Spark UI 和数据统计找到热点,再根据聚合、Join、默认值或上游数据问题选择最小成本的方案。
不要一看到任务慢就加盐,也不要把所有优化都归结为增加资源。