Spark 堆内存没满,Executor 为什么还会被杀?memoryOverhead 怎么看?
本文目录
面试怎么回答
我先从容器和节点诊断确认是否确实因内存超限退出,不凭Executor丢失就下结论。在YARN或Kubernetes上,容器预算不只包含JVM堆,还涉及overhead、显式堆外内存以及配置的PySpark内存。要查看Python和原生分配、批量与并发峰值,再减少放大或合理调整预算。加堆不一定给真正吃内存的部分增加足够空间,还可能降低可调度性。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
监控里JVM堆使用率不到一半,Executor却消失了。再加一倍executor.memory,任务仍然失败。排查内存问题时,最容易漏掉的前提是:你看的图和平台限制的范围,可能根本不是同一个东西。
容器限制的是更大的进程内存范围,不只是JVM堆;先确认退出原因和内存组成,再同时控制并发峰值与资源预算。
先证明是内存问题,而不是从结果猜原因
Executor丢失可能来自容器超限、节点异常、主动回收或其他故障。日志中的退出码、平台事件与节点诊断,比一条ExecutorLost更接近原因。
即使看到某个常见退出码,也要结合平台上下文判断,不能把所有退出都归为堆内存不足。进程被外部终止时,JVM未必有机会生成堆OOM堆栈。
先记录具体Executor、发生时间、当时Task和容器诊断,再对齐同一时间段的指标。拿一分钟平均值解释瞬时峰值,也可能漏掉真正超限的短时分配。
memoryOverhead不是另一块Spark缓存
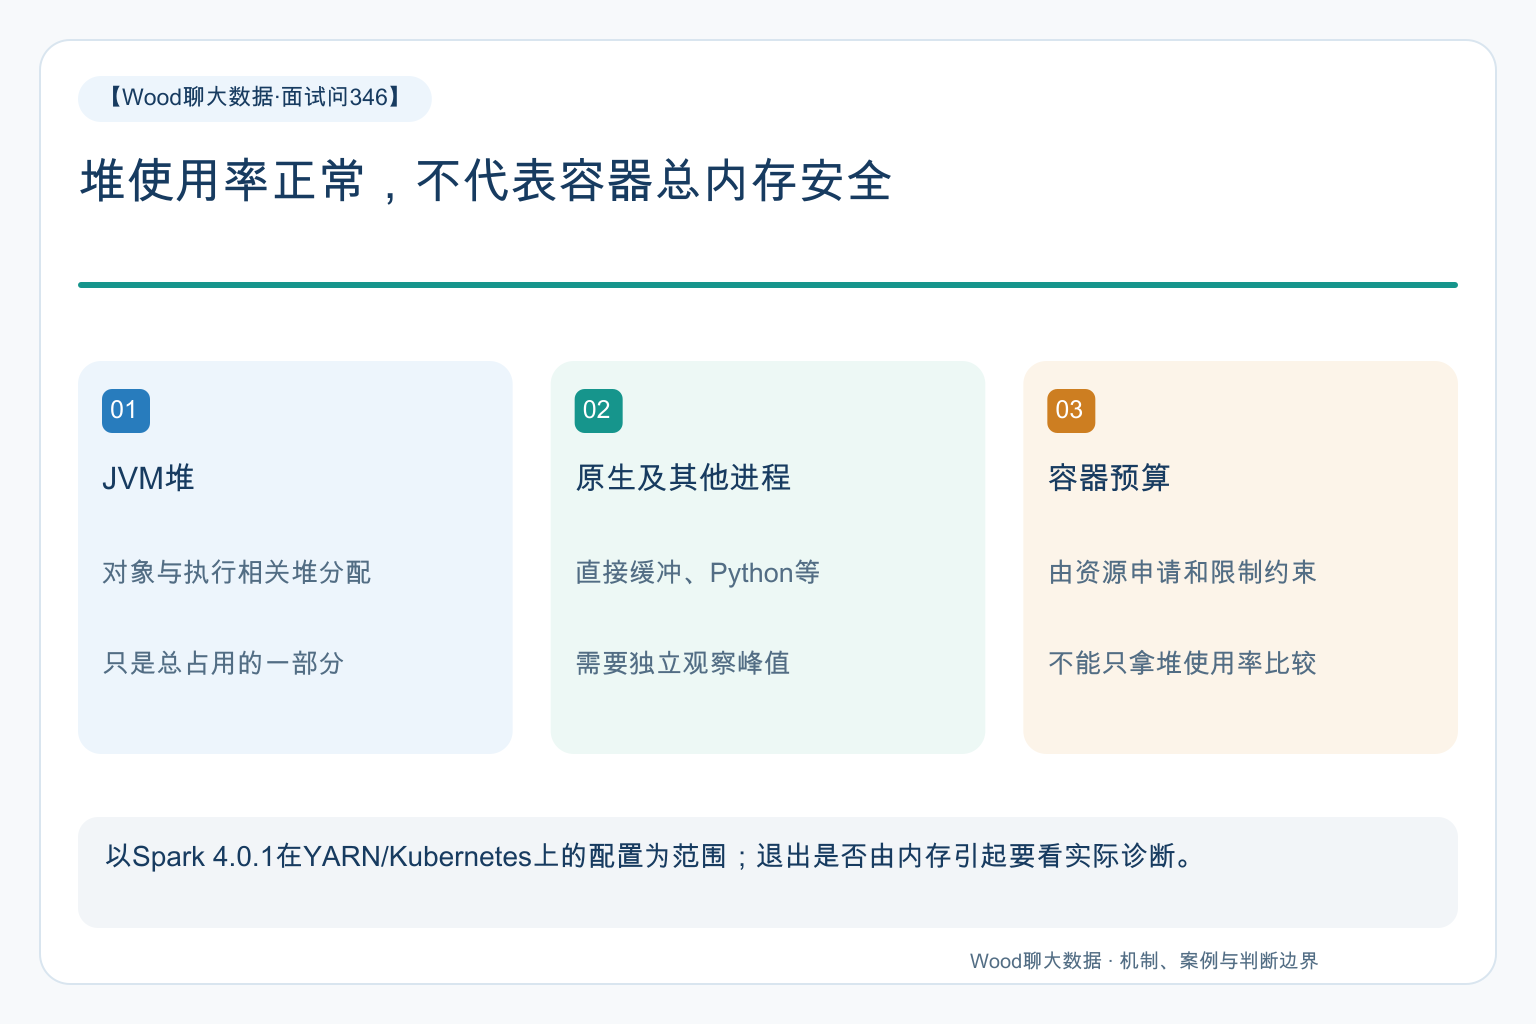
本文以Spark 4.0.1在YARN、Kubernetes上的配置说明为准。executor.memory主要对应JVM堆预算,memoryOverhead用于额外内存需求的资源预算,不是任意数据都能直接使用的缓存池。
官方列出的容器内存预算还涉及显式堆外大小与配置的PySpark内存。未单独配置PySpark内存时,Python等进程的占用会挤压共享的额外空间。
参数名字相近,并不意味着监控会自动替你把所有组成分开。需要结合部署方式、实际生效配置及平台统计口径,确认观测到的是进程、容器还是某一类JVM内存。
为什么加堆有时没有帮助
如果峰值来自Python进程或原生缓冲,单独调整堆大小未必减少这些分配。若memoryOverhead已显式固定,扩大堆也不会自动把这项预算同步扩大。
即使额外预算按比例计算,加大堆也可能造成资源申请变大、可并行运行的Executor变少,影响排队与吞吐。不能只看一次失败是否消失,而忽略整体成本。
反过来,直接无限增加overhead也不能修复无界缓存或每分区一次性加载全部数据。资源预算应覆盖合理峰值,不应替代有边界的数据处理设计。
检查批量与并发如何放大峰值
一个Python任务把整批数据转成对象,可能同时保留序列化、解码和计算中间表示。单条记录的存储大小,不能直接等同于内存中的对象大小。
每个Executor同时运行更多Task,会叠加多个批次的峰值。调整每批规模、分区大小、单Executor并发和中间对象生命周期,往往需要一起观察。
如果使用Arrow或其他原生库,应验证相关批次限制和实际数据类型,不要把调小某个行数参数当成对内存字节数的绝对上限。少量超宽记录仍可能很大。
一个典型场景:Python处理阶段容器退出
假设JVM堆一直平稳,但每到Python处理阶段某些Executor被终止。第一反应是Spark内存监控不准,于是只扩大堆,问题重复出现。
排查把Task时间线与Python进程占用对齐,发现多个并发任务各自构建大列表,容器总占用越过限制。旧告警仅监控堆,没有覆盖容器及子进程范围。
修正先让处理逻辑分批释放对象,缩小单批和并发峰值,再按新的实际峰值调整完整预算。使用相同输入和相同并发条件复测,避免把数据量下降误认为参数优化有效。
此处是通用诊断示例,不代表所有Python阶段失败都由同一个原因造成。
验收要同时看稳定性、吞吐与资源效率
观察失败次数、峰值占用、GC、Task耗时和排队时间,也检查输出一致性。若批量变小后吞吐下降,应在可接受延迟和内存余量之间寻找合适配置。
保留关键生效参数和平台限制作为发布记录,避免配置写在提交脚本里却被其他层覆盖。面试里把观测范围、预算范围和实际分配连起来,比背一个固定overhead比例更重要。