Spark Whole-Stage CodeGen 是怎么工作的?
本文目录
面试怎么回答
Whole-Stage CodeGen 会把一段连续、支持代码生成的物理算子融合成一个代码生成 Stage,Spark 生成并编译 Java 代码,让过滤、投影、聚合等在一个循环里完成,减少 next 调用、中间对象和数据物化。Exchange、Sort、UDF 或不支持 CodeGen 的算子会形成边界,所以我会结合 EXPLAIN 和生成代码判断融合范围。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
执行计划里一串算子前面带着同一个 *,并不是 UI 装饰。
它表示 Spark 正尝试把这些算子放进同一个代码生成阶段,让一行数据在 CPU 寄存器和局部变量中一路处理。
Whole-Stage CodeGen 把可生成代码的多个物理算子融合为一个 Stage,生成紧凑 Java 代码,减少解释执行、中间行物化和算子间调用。
传统火山模型的调用开销
经典执行器常由父算子反复调用子算子的 next(),一行数据会穿过多层虚函数、分支和对象包装。单次成本很小,但数十亿行累计后非常可观,而且每个算子生成中间对象会增加内存和 GC 压力。
CodeGen 把表达式变成代码
Catalyst 先得到物理计划,支持代码生成的表达式和算子会提供生成逻辑。Spark 拼接出 Java 源码,编译为字节码后执行。过滤条件、投影计算、哈希聚合等操作可以变成局部变量和直接分支。
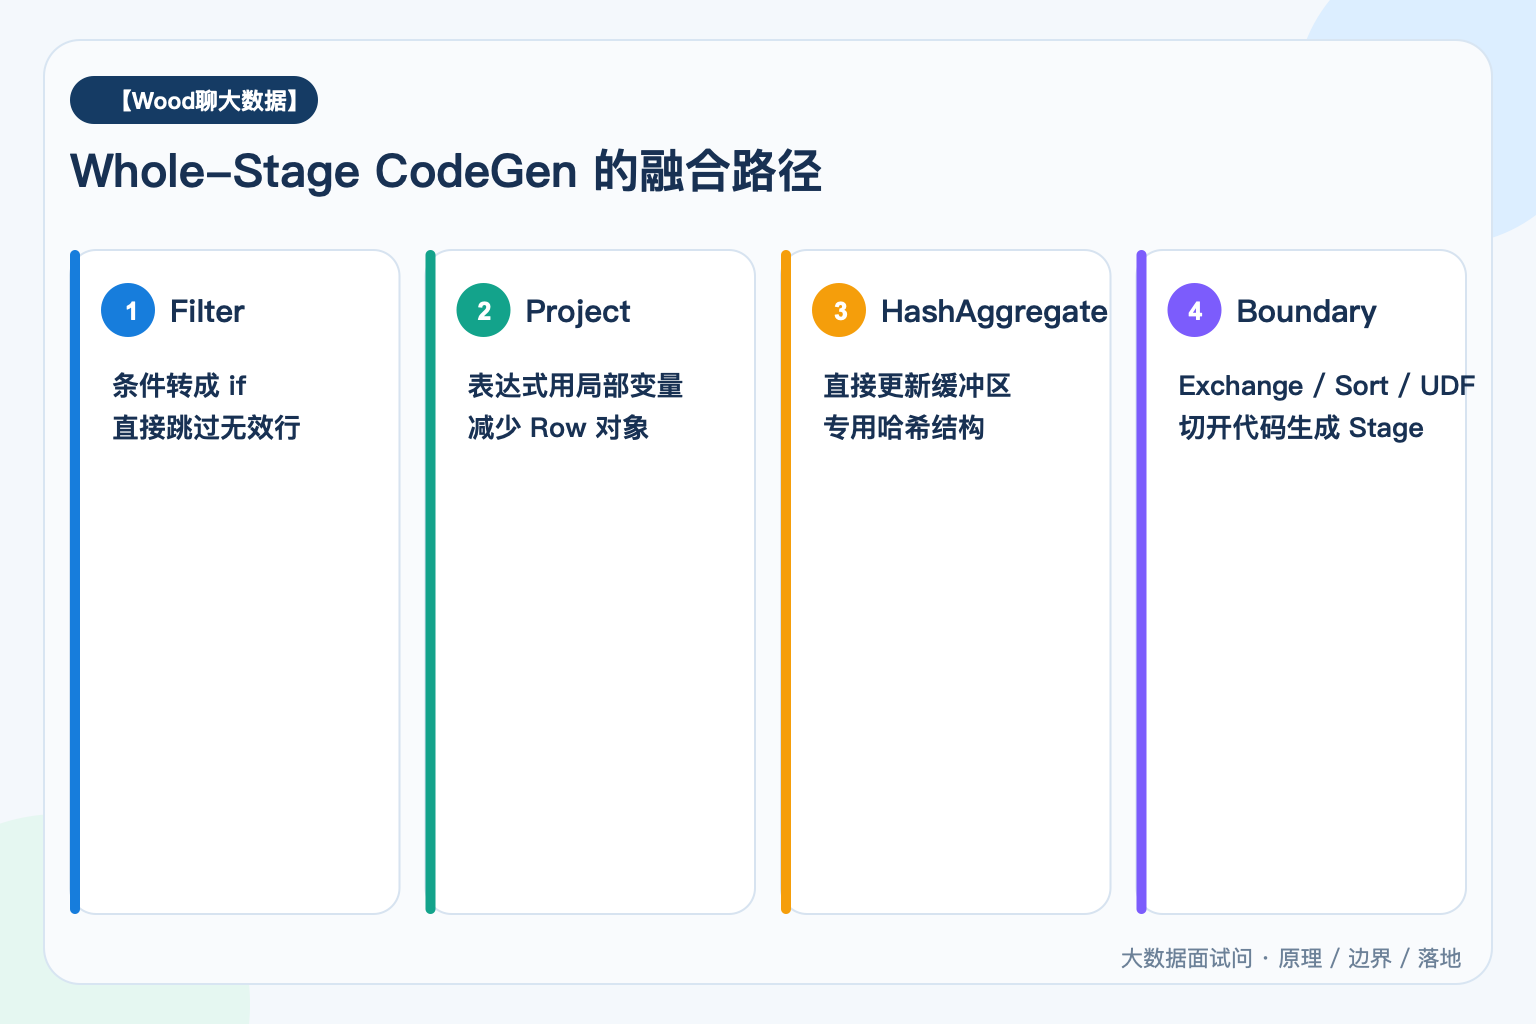
Whole-Stage 再把算子融合
仅给每个表达式生成代码还不够,算子之间仍有边界。Whole-Stage CodeGen 把一段连续的可生成算子融合起来,采用 produce/consume 模式生成一个处理循环,数据不必在每一层完整物化。
哪些地方会形成边界
Exchange、Sort 等需要重新分区或全局物化的算子天然切断流水线;不支持 CodeGen 的算子、对象式转换、部分 UDF 也会形成边界。生成方法过大还可能触发代码拆分或回退,复杂 SQL 不是融合得越长越好。
如何从执行计划验证
EXPLAIN FORMATTED 中观察带星号的算子和 codegen stage id,Spark UI 的 SQL 页面可以查看 WholeStageCodegen 节点。调试时还可查看生成代码,重点判断边界是否来自 Exchange、UDF 还是复杂表达式,而不是只看是否出现节点名称。
和 Tungsten、Catalyst 的关系
Catalyst 决定逻辑和物理计划,Tungsten 提供二进制内存与高效执行基础,Whole-Stage CodeGen 把选定物理算子的处理路径编译出来。三者分别解决“怎么规划、数据怎么放、算子怎么跑”,不能混为同一个概念。
参考资料
- Spark SQL Performance Tuning:https://spark.apache.org/docs/latest/sql-performance-tuning.html