Spark Driver 和 Executor 分别负责什么?
面试怎么回答
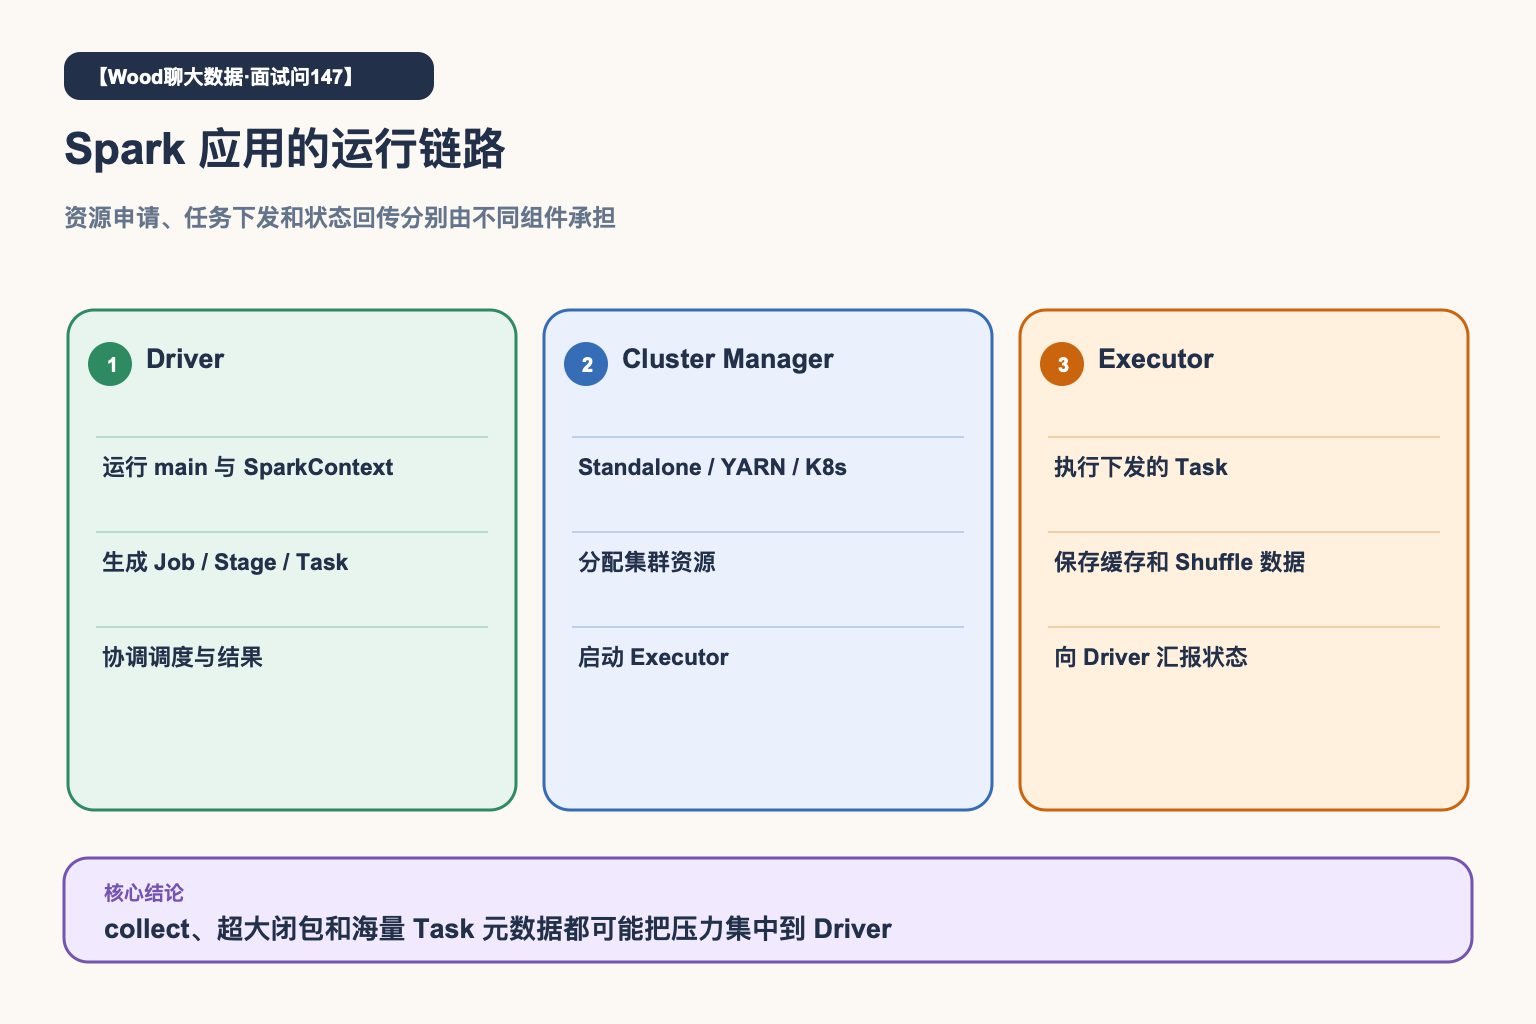
Driver 运行主程序和 SparkContext,负责构建执行计划、划分 Job 与 Stage、生成 Task、调度并跟踪状态。Cluster Manager 负责为应用申请资源并启动 Executor。Executor 在工作节点上执行 Task,保存缓存和 Shuffle 数据并向 Driver 汇报。排障时我会先区分 Driver 与 Executor 日志,避免 collect、超大广播和海量小 Task 把压力集中到 Driver。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Executor 数量加倍,任务却没有明显变快。有时问题根本不在计算资源,而是 Driver 正在处理过多 Task 元数据或接收过大的结果。
理解 Driver 和 Executor 的边界,是排查 Spark 问题的基础。
Driver 负责应用级协调、计划和调度,Executor 负责执行 Task、缓存数据并回报状态,Cluster Manager 负责申请和分配资源。
Driver 是应用的控制中心
Driver 运行 main 函数并创建 SparkContext 或 SparkSession。Action 触发计算后,它构建 Job、切分 Stage、生成 Task 并调度到 Executor。
Driver 还要跟踪 Task 状态、处理调度结果和维护应用元数据。它不是“大数据计算节点”,但控制面压力过大同样会拖慢甚至终止整个应用。
Executor 承担真正的并行任务
Executor 是为某个 Spark Application 启动的工作进程,接收 Driver 下发的 Task,在自己的内存和 CPU 中执行计算,并保存缓存或 Shuffle 数据。
不同 Application 通常有各自的 Executor。某个 Executor 故障后,相关 Task 可以在其他 Executor 重算,但外部系统副作用仍要靠业务逻辑保证幂等。
Cluster Manager 只负责资源层协调
Standalone、YARN 或 Kubernetes 等 Cluster Manager 为应用分配资源和启动进程,但不会替 Driver 决定 SQL 的 Join 计划,也不会替 Executor 执行 Task。
client mode 和 cluster mode 的重要区别,是 Driver 进程运行在哪里。前者依赖提交端网络和生命周期,后者由集群环境托管。
常见错误是把数据拉回 Driver
collect、toPandas、大规模本地 Map 或过大的广播变量,都可能让 Driver 内存和网络成为单点。海量小分区还会产生大量 Task,让调度和状态回报本身变成开销。
排障时要先判断异常来自 Driver 日志还是 Executor 日志:Driver OOM、心跳超时、Executor Lost、Task OOM 对应的责任边界完全不同。
一个典型场景
一条聚合任务在集群侧计算很快,却总在最后阶段 Driver OOM。继续检查发现代码为了导出结果调用 collect,把数百万行全部拉回单进程。
继续增加 Executor 只会让结果更快地涌向 Driver,并不能解决问题。把结果分布式写入存储,再由独立导出流程处理后,应用才稳定。
Driver 是控制中心,不应该被当成最终数据仓库。