Spark Executor 参数怎么配置?
面试怎么回答
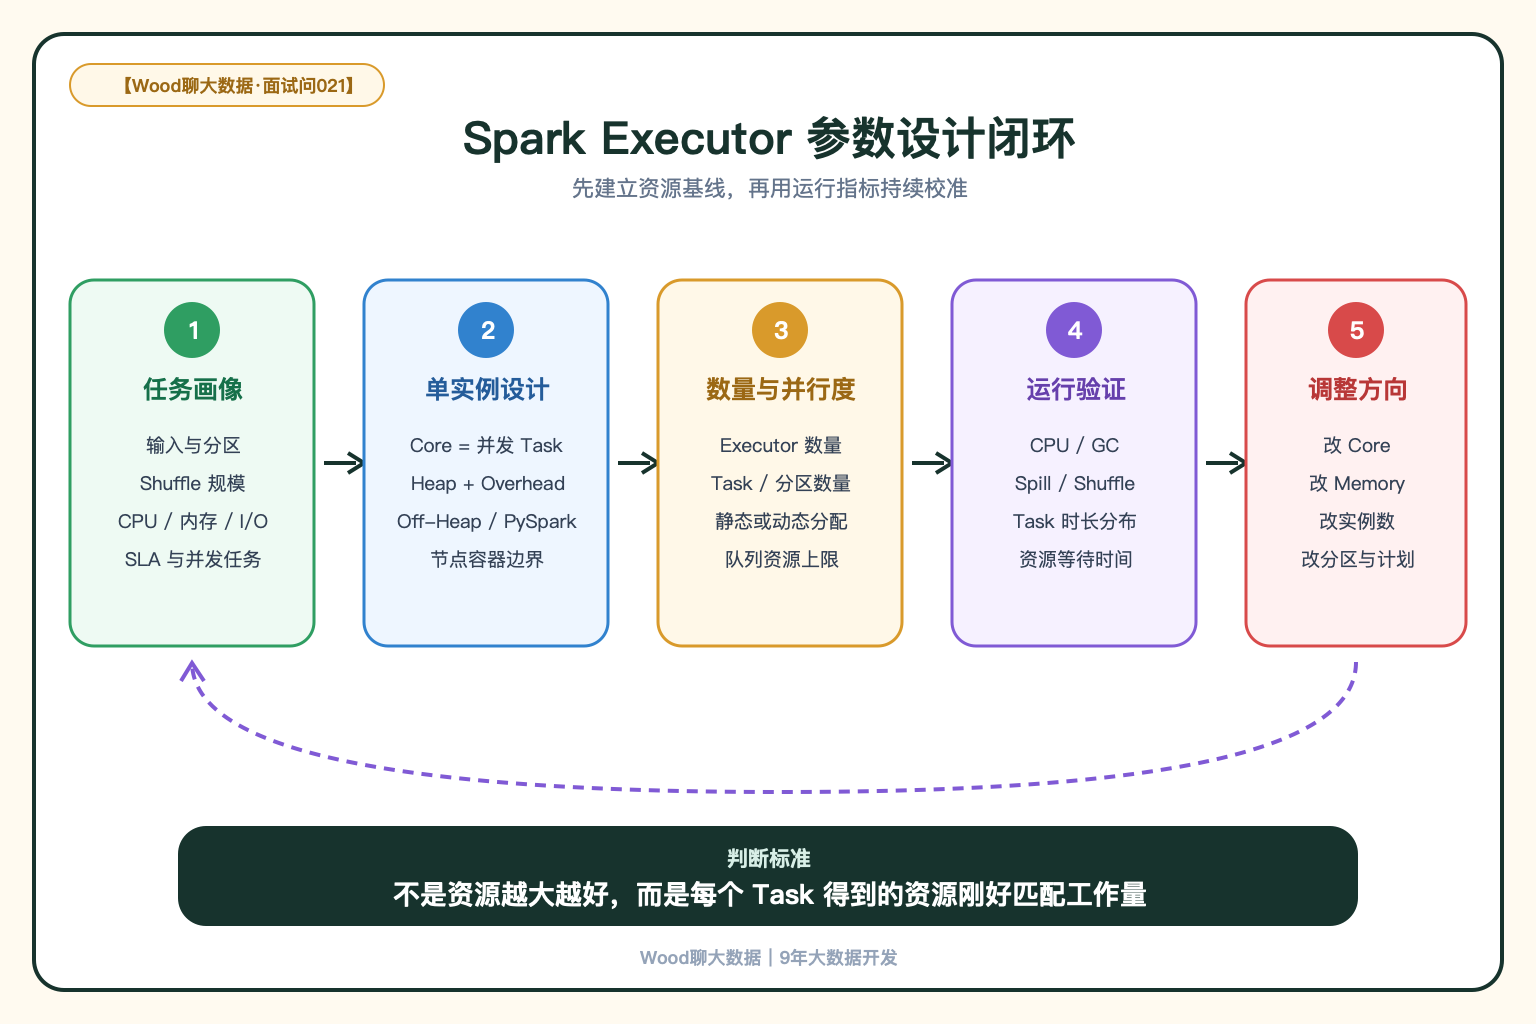
我不会直接背固定参数,而是先看数据量、Task 数、Shuffle、任务类型和队列资源。单个 Executor 要平衡 Core 并发与单 Task 内存,并把 Overhead、Off-Heap 和 PySpark 算进容器总内存。再按集群资源和并行度决定实例数,峰谷明显时评估 Dynamic Allocation。上线后用 CPU、GC、Spill、Task 分布和资源等待反推调整,形成配置与指标闭环。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会直接背一组经验值:
“每个 Executor 5 个 Core、10G 内存,再根据数据量决定 Executor 个数。”
这组数字可能在某个集群、某类任务上有效,但不能当成通用答案。
Executor 参数真正要解决的是:
在集群资源边界内,让每个 Task 获得足够的 CPU 和内存,同时保持合理并行度。
第一步:先看任务是什么类型
配置之前,我会先确认四件事:
- 输入数据量、文件数和分区数
- Shuffle 数据量与宽依赖算子
- 单个 Task 是 CPU 密集、内存密集还是 I/O 密集
- SLA、并发任务数量和队列资源上限
如果 Task 数本来就很少,增加 Executor 数量不会带来更多有效并发。
如果单个分区特别大,增加 Executor 数量也不会自动拆开这个分区。
所以资源配置必须和数据分区、执行计划一起看。
第二步:设计单个 Executor 的大小
Executor Core 决定并发 Task 数
一个 Executor 有多少 Core,通常就能同时运行多少个 Task。
Core 太少,单个 Executor 利用率可能不高;Core 太多,多个 Task 会共同争抢执行内存,GC、Shuffle Fetch 和 I/O 也更容易互相影响。
因此不能只追求“大 Executor”,还要看单 Task 的内存需求和计算特征。
Executor Memory 不是容器全部内存
在 YARN 或 Kubernetes 上,一个 Executor 容器通常还包括:
- JVM Heap,也就是
spark.executor.memory - Memory Overhead
- 配置后的 Off-Heap Memory
- 单独配置的 PySpark Memory
如果只把 Heap 配得很大,却没有给堆外、Python Worker 或网络缓冲留空间,容器仍可能因为总内存超限被杀。
不要忽略集群单容器边界
单个 Executor 不能无限做大。还要结合节点总内存、可用 Core、队列上限和容器规格,避免一个 Executor 占满节点,影响资源碎片和故障恢复。
第三步:决定 Executor 数量和并行度
静态分配时,可以先用集群可用资源除以单个 Executor 的资源需求,得到实例上限,再结合 Task 数和 SLA 收缩到合理范围。
但 Executor 数量不等于 Shuffle 分区数。
任务真正能否并行,还取决于:
- 输入分区和 Shuffle 分区数量
- 当前 Stage 的 Task 数
- 是否存在热点分区
- 集群是否还有其他任务竞争资源
如果业务峰谷明显,也可以使用 Dynamic Allocation,但要设置合理的最小、初始和最大 Executor 数,并观察扩容速度、空闲回收和 Shuffle 数据保留机制。
第四步:用运行指标反推,而不是一次猜中
第一版配置只是基线,最终要通过 Spark UI 和集群指标验证。
我会重点看:
- CPU 利用率是否长期偏低或持续打满
- GC Time 占比和 Executor Lost
- Memory Spill、Disk Spill 和 Peak Execution Memory
- Task 时长分布是否均匀
- Scheduler Delay 和资源等待时间
- Shuffle Read、Fetch Wait 与网络吞吐
如果 CPU 很低但 GC 很高,问题可能不是 Core 不够,而是 Executor 太大、对象太多或并发 Task 争抢内存。
如果 CPU 很高、GC 很低且 Task 分布均匀,才更像是需要增加计算资源或优化 CPU 逻辑。
一个典型场景
比如一个大聚合任务,把每个 Executor 配成很多 Core 和很大的 Heap,表面看单容器资源很充足,但运行时多个聚合 Task 同时竞争执行内存,频繁 Spill 和 Full GC。
第一次调整只是继续增加 Heap,任务虽然偶尔能跑过,但资源利用率和稳定性没有改善。
更合理的做法是拆成更多中等大小的 Executor,降低单 Executor 并发 Core,并结合单 Task 数据量调整 Shuffle 分区。
这样做不是因为“小 Executor 永远更好”,而是让单 Task 的资源需求、并发数量和容器边界重新匹配。
参数优化不是寻找一组万能值,而是建立“配置—指标—调整”的闭环。