Spark 为什么报 Task not serializable?闭包里不能放什么?
本文目录
面试怎么回答
Task not serializable 通常要检查闭包捕获的对象。Spark 会把函数和它需要的变量发送到 Executor,访问实例字段或方法可能顺带捕获整个 this,而里面有连接池等不可序列化资源。处理上先把简单配置复制到局部变量,纯函数与资源分开;需要连接时在执行端按分区等生命周期创建并可靠释放。不能只给类加 Serializable,还要考虑重试副作用与执行端依赖。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一段 map 里只拼接了一个字符串,却报 Task not serializable。代码只有一行,不代表依赖只有一个字段:这个字段背后,可能连着整个服务对象、连接池和客户端。
Spark 分发的是函数及其捕获的对象图;应缩小闭包依赖,在执行端按生命周期创建不能跨进程传递的资源。
Spark 需要把什么送到 Executor?
Driver 上定义的函数最终可能在另一个进程、另一台机器执行。Spark 需要分发函数以及执行它所依赖的变量,这些捕获内容构成闭包。报错时应检查被捕获对象的引用关系,不是只盯输入数据是不是字符串。
本文主要讨论 Scala、Java 的 Task not serializable;PySpark 也有闭包序列化问题,但使用的机制和异常信息不完全相同,不能把 Java 的修饰符建议照搬过去。
一个对象可序列化,也不代表序列化后仍能正常工作。进程内的连接、线程池和文件句柄有自己的运行环境,复制对象字段并不能把它们的真实资源连接搬到远端。
访问实例字段,可能把 this 一起带走
假设服务类里同时有 prefix 和数据库连接池,map 中引用 prefix。源码看起来只读取前缀,但访问外部实例字段可能表现为 this.prefix,闭包由此引用整个外部对象。
类似地,把实例方法传入 map,也可能要求分发方法所属的实例。若它持有不可序列化成员,就会在闭包分发阶段失败。不能仅凭“没有在 lambda 中直接写数据库连接”排除连接池的影响。
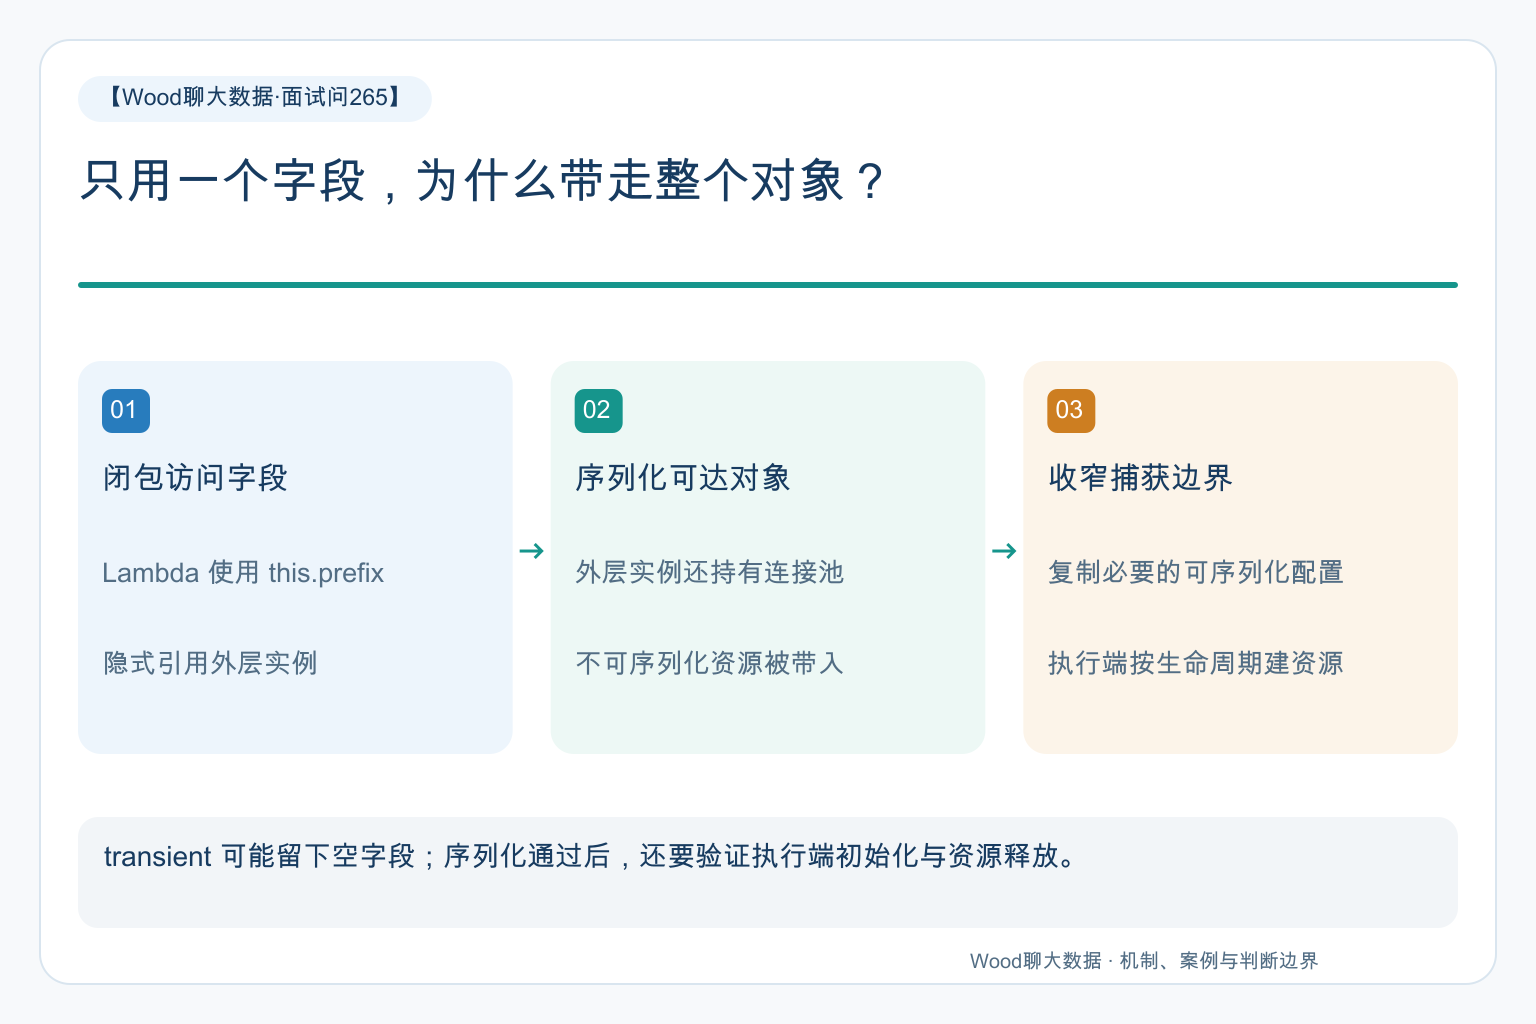
排查时要沿异常里的序列化引用链定位:哪个字段属于哪个对象,哪一个外部引用把它带进来。去掉无关成员后再测,是验证捕获路径的办法,不是让异常堆栈静音的技巧。
优先缩小依赖,而不是让整个类都可传
若执行只需要一个字符串或少量配置,可以在构建闭包前复制到局部不可变变量,让函数只捕获真正必要的值。纯计算逻辑可放到不持有外部资源的函数或对象中,减少隐式依赖。
给外层类加 Serializable 只是一项类型声明;它引用的字段是否可序列化、序列化代价多大、到远端能否使用,都仍需要检查。把大型配置服务整体塞进去,可能从报错变成过大的任务负载。
只读大数据集合可以评估广播变量,但广播也需要可分发的数据,不是把打开的连接池跨进程共享的通道。两类问题不能靠同一个开关解决。
外部资源应在使用它的进程里创建
需要查询外部系统时,可以考虑在执行端按分区等合适生命周期创建客户端,而不是在 Driver 创建后捕获。这样既明确资源归属,也避免每条记录都建立连接。
但“按分区创建”并不意味着每个 Executor 永远只有一个连接。多个并发任务、任务重试和推测执行,都可能产生多个实例,需要按并发量预算连接数,并设置超时和可靠释放机制。
还要特别注意惰性迭代器:不能返回一个尚未消费的 Iterator 后,立即在外层 finally 关闭客户端,导致后续真正读取时资源已经失效。释放点应与实际消费结束、任务完成和异常路径相匹配。
一个典型场景:把连接池标成 transient 后又空指针
比如闭包捕获了带连接池的服务实例,任务先报不可序列化。最初以为只要不传连接池就行,给字段加 transient 后序列化通过,执行端却因为字段未初始化而报空指针。
根因是资源生命周期没有重新设计。原测试只验证对象能被序列化,没有真正执行远端访问,所以误把“能发送”当成“能使用”。修复要分离可传配置和执行端资源,并在真实执行路径测试创建、使用、失败和关闭。
另外,别为方便调试把完整配置对象或连接字符串输出到日志。定位引用链需要对象结构和字段名,不需要暴露密码或访问凭据。
序列化修好以后,还有两件事
第一是依赖可用性。Driver 装了某个库,不代表每个 Executor 都有相同版本;本地路径存在,也不代表远端能读取。要验证打包、配置分发和网络可达性。
第二是重复执行。Spark 任务可能重试,外部写入应有业务幂等或适配的提交机制。闭包不再报错,只解决了“代码能送过去”,没有自动解决副作用正确性。
面试回答如果能从对象引用一路讲到运行资源和失败重试,就比一句“实现 Serializable 接口”更接近真实工程问题。