Spark 动态资源分配是怎么工作的?
面试怎么回答
Spark 动态分配会在任务持续积压时申请更多 Executor,在 Executor 空闲超过阈值后释放资源,并受最小、初始和最大数量约束。关键前提是 Executor 移除后 Shuffle 数据仍可访问,例如使用 External Shuffle Service 或 Shuffle Tracking。我会结合容器启动时间、阶段波峰、缓存和 SLA 调整超时,短任务不一定适合从很小规模慢慢扩容。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
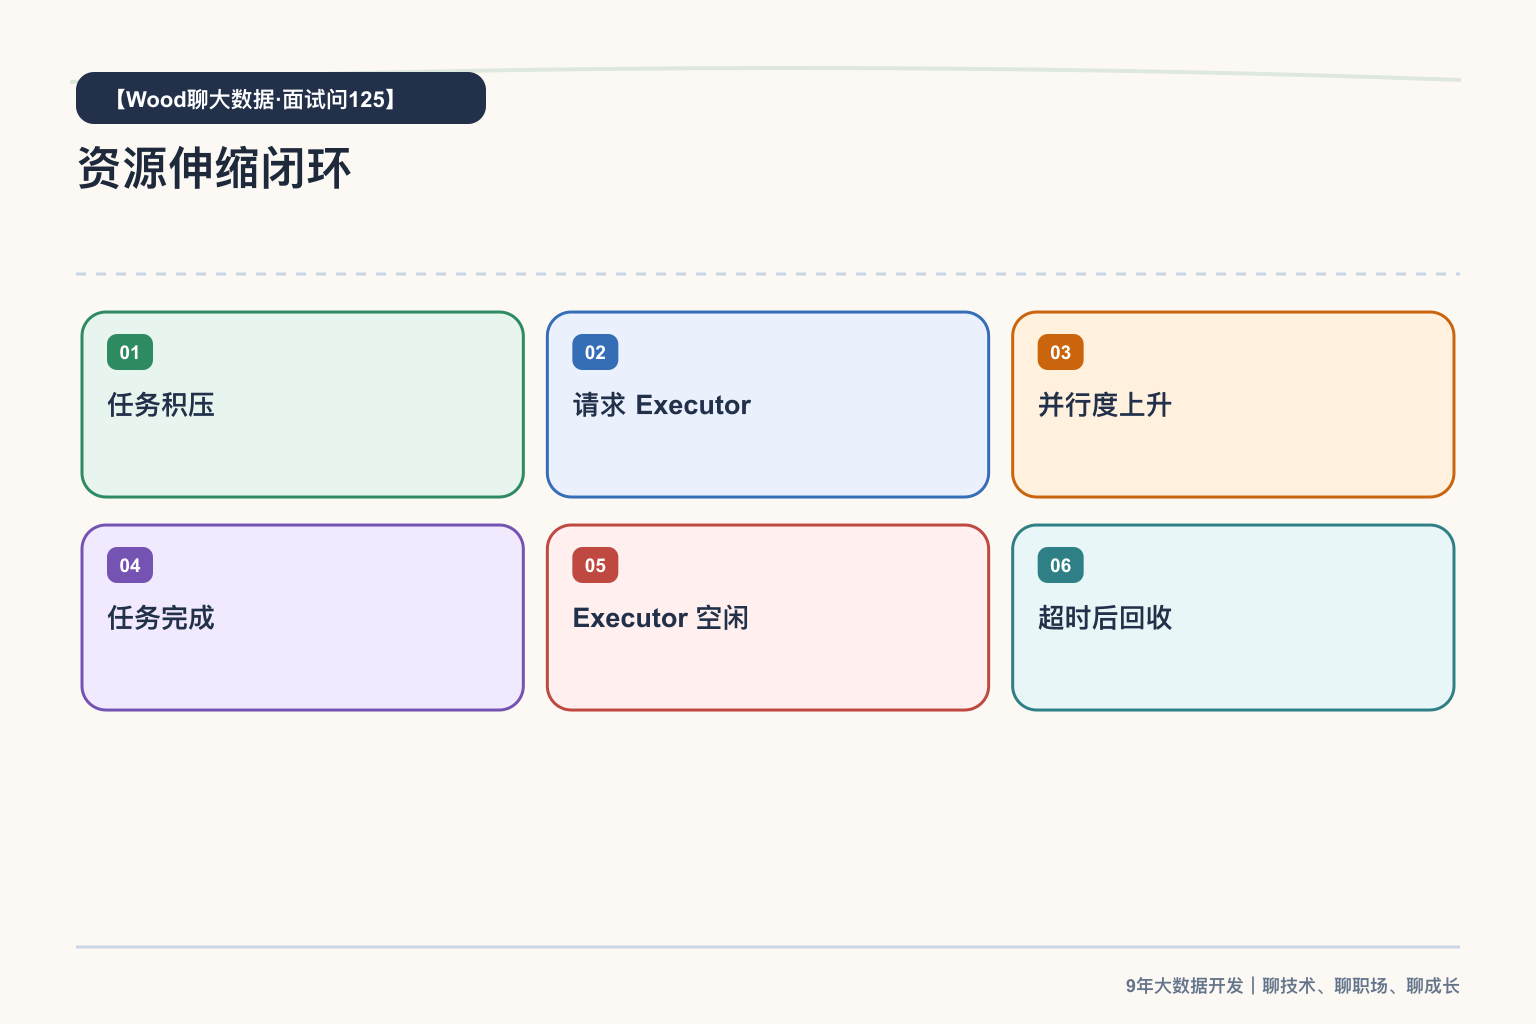
任务刚启动时只有少量 Executor,Shuffle 阶段迅速扩容,后半段空闲资源又逐步释放。
动态资源分配不是“自动把参数调到最优”,而是根据待调度任务和空闲时间调整 Executor 数量。
动态分配通过积压请求资源、通过空闲超时释放资源,前提是 Shuffle 数据在 Executor 移除后仍可被可靠访问。
什么时候扩容
当调度器持续存在待执行任务,Spark 会请求更多 Executor,通常按逐步加速的方式扩张,直到满足并行需求或达到最大上限。扩容存在申请与启动延迟。
什么时候缩容
Executor 长时间没有任务会被回收,缓存数据较多的 Executor 可能使用不同空闲策略。缩容过快会导致下一阶段重新申请资源和缓存丢失。
Shuffle 数据如何保留
传统方式依赖 External Shuffle Service;也可以使用 Shuffle Tracking 等机制。核心要求是 Executor 被移除后,后续 Stage 仍能找到已经生成的 Shuffle 数据。
参数要跟工作负载匹配
最小、初始、最大 Executor,积压超时和空闲超时要结合任务波峰、集群队列和启动速度设置。长时间稳定负载未必比固定资源更合适。
为什么不能只回答概念?
“误区:打开开关就能同时获得高性能和低成本”之所以常见,是因为它在理想数据和单次执行里往往说得通。但生产环境会加入数据规模、异常值、并发、版本、失败重试和下游口径,这些条件一变化,只记住术语就很容易给出错误结论。
所以我会把 什么时候扩容、什么时候缩容、Shuffle 数据如何保留、参数要跟工作负载匹配 串成一条完整链路。最终判断标准不是某个函数或配置是否出现,而是能否稳定得到可解释、可验证、可恢复的业务结果。
落地时我会检查什么?
- 输入边界:确认数据范围、时间口径、主键和异常值是否符合假设。
- 执行过程:观察分区、并行度、状态、Shuffle 或资源变化,验证方案是否真正生效。
- 输出结果:用行数、唯一性、关键指标和样本明细证明结果正确,而不是只看任务成功。
- 失败恢复:说明重跑、回滚、版本兼容和责任人,避免一次成功后无人维护。
这些检查不一定全部写进一条 SQL 或一个任务,但面试时能主动补充,说明你回答的不是背诵题,而是在描述一套可上线的工程方案。
一个典型场景
一个短批任务把最小 Executor 设得很低,容器启动又慢。每个小时任务的大部分时间都在等待扩容,刚达到峰值就进入收尾并触发缩容。动态分配节省了静态占用,却拉长 SLA。最后提高初始资源,并针对短任务使用更保守的缩容策略。
动态分配优化资源弹性,不保证任务启动最快。