Spark 广播变量和累加器有什么区别?
面试怎么回答
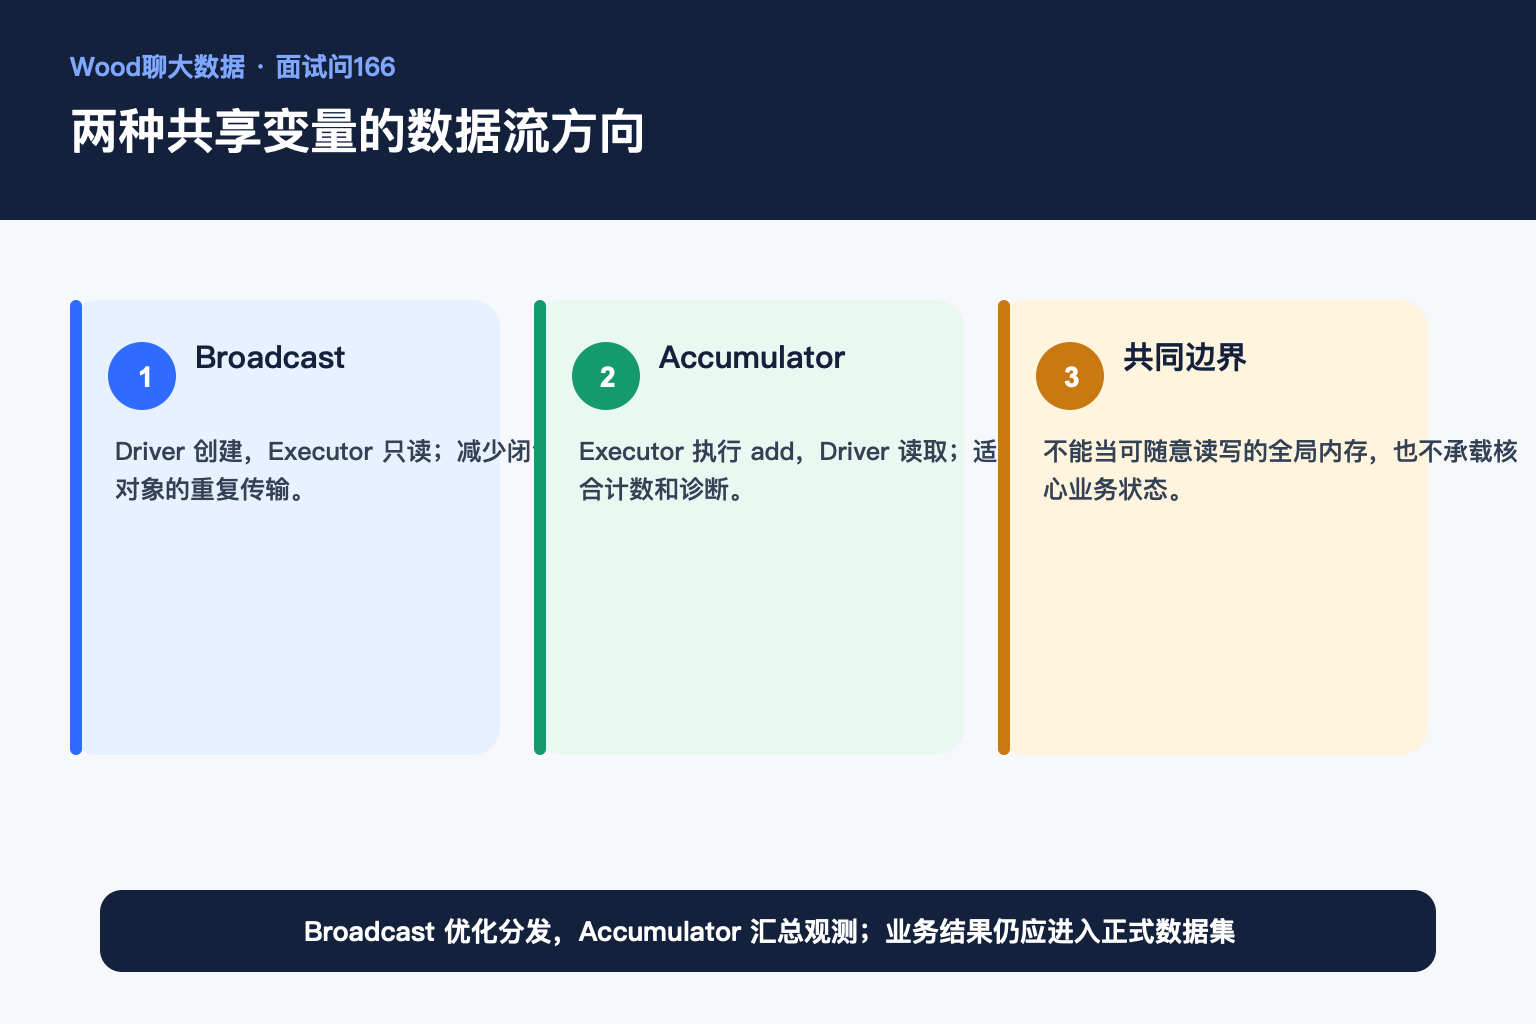
广播变量是 Driver 到 Executor 的只读分发,减少大对象随任务重复传输;累加器是任务侧 add、Driver 侧读取的聚合变量,常用于计数和监控。两者都不是通用共享内存。广播要关注对象大小和生命周期,累加器要关注惰性执行、重算与重试,因此不能拿它承载要求精确一次的业务状态。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
广播变量和累加器都叫共享变量,于是很多回答只剩一句:一个读,一个写。
真正需要讲清楚的是数据流方向、可见性和任务重试边界。
广播变量把只读数据从 Driver 高效分发到 Executor,累加器把任务侧统计聚合回 Driver。
广播变量解决重复发送大对象
如果闭包引用一份较大的维表或配置,Spark 可能随任务重复序列化和传输。广播变量由 Driver 创建,把只读对象高效分发并缓存在各节点,任务通过 value 读取。它适合体量可控、更新不频繁的查询侧数据。
广播不是把任意大表放进内存
广播对象要占用 Driver 和 Executor 的内存,也要经过网络分发。过大的对象会带来序列化、超时和内存压力。广播后对象应视为只读;如果业务配置变化,通常要创建新广播并清理旧广播,而不是在 Executor 中修改。
累加器是任务到 Driver 的聚合通道
任务可以对累加器执行 add,Driver 读取最终值。它适合统计坏数据条数、命中特定分支次数和调试指标。Executor 不能依赖累加器当前值决定业务分支,因为任务之间看不到一个可靠、同步的全局状态。
重试和惰性执行是关键边界
Transformation 没有被 Action 触发时,里面的累加不会执行。同一个计算被重复触发、阶段重算或任务重试时,累加器的更新也可能超出直觉。因此不要用它生成订单号、扣减库存或作为精确业务结果;关键结果应由 RDD、DataFrame 或事务存储产出。
一个典型场景
清洗日志时,需要把一份几 MB 的规则字典分发给所有 Executor,同时统计格式错误和规则未命中的行数。规则字典使用广播变量,两个计数使用累加器;清洗后的有效记录仍写入正式数据集。这样性能优化、可观测性和业务结果各自有明确载体。
参考资料
- Apache Spark RDD Programming Guide:https://spark.apache.org/docs/latest/rdd-programming-guide.html