Spark FetchFailedException 怎么排查?
本文目录
面试怎么回答
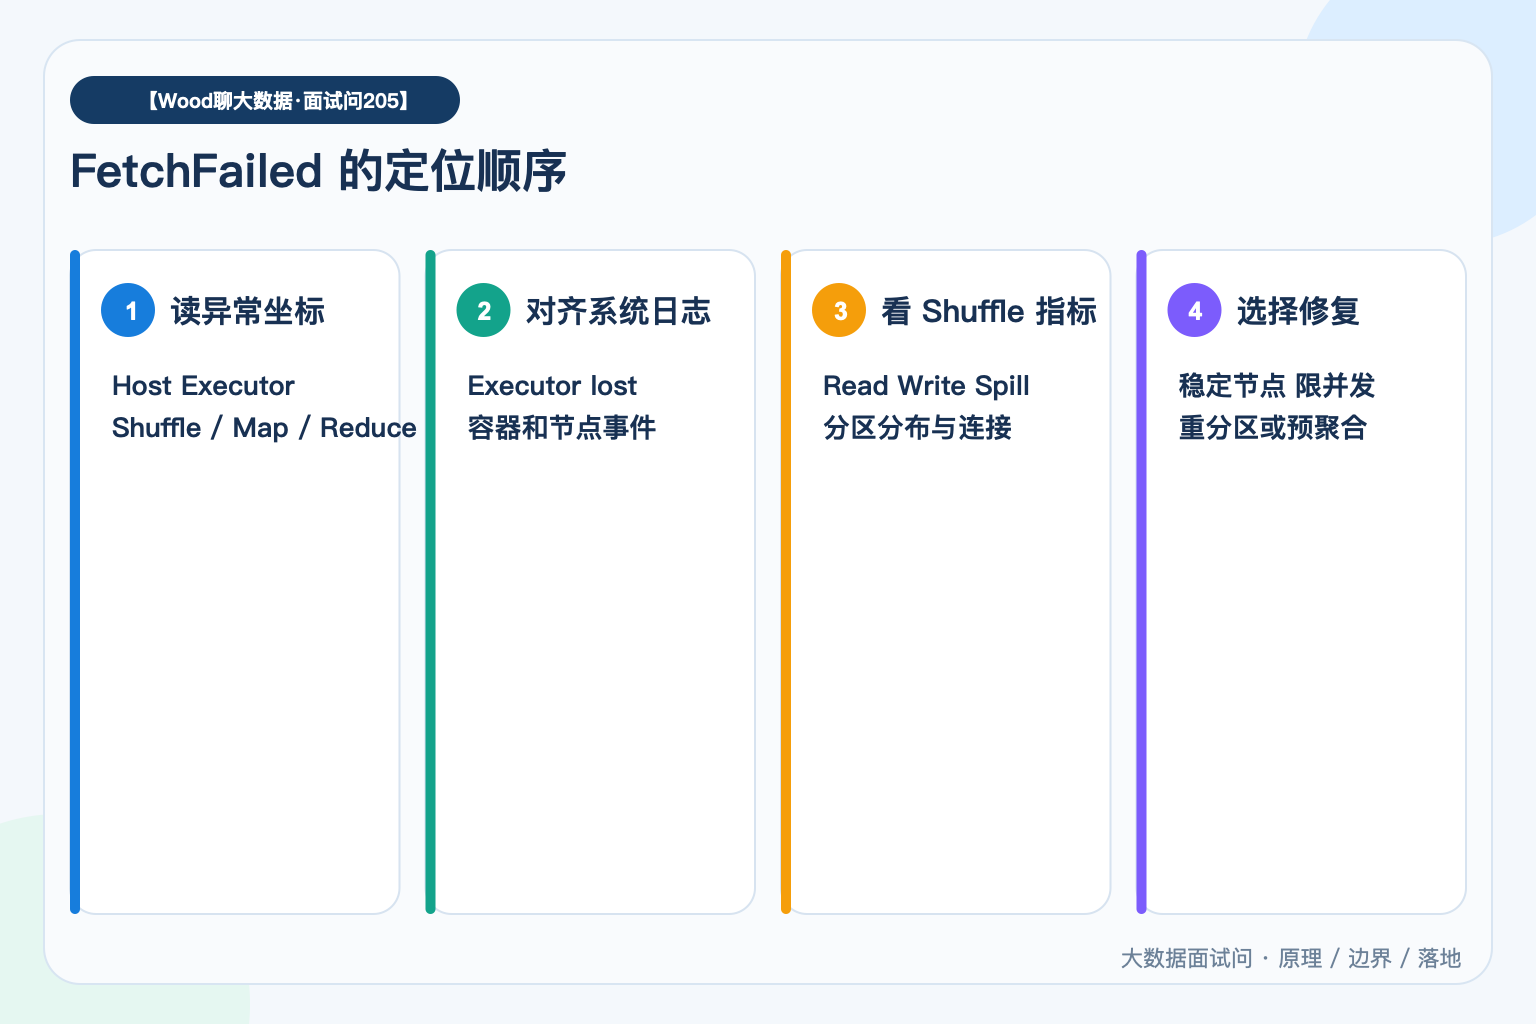
FetchFailed 表示 Reduce Task 拉不到上游 Map 输出,Spark 通常会回退并重算产生该输出的 Stage。排查我会先从异常中的 Executor、Host、ShuffleId 和 ReduceId 定位,再关联 Executor lost、网络超时、Shuffle Service、磁盘和分区大小。根因不同处理也不同:节点不稳先修 OOM 或 GC,连接风暴限并发,倾斜则重分区,重试参数只处理瞬时 I/O 故障。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
日志里真正有用的往往不是最后一句“Stage failed”,而是前面那条 FetchFailed:哪个 Reduce Task,从哪个 Executor,拉哪个 Shuffle Block 失败。
它说明下游取不到上游 Map 输出,但原因可能是 Executor 丢失、网络超时、磁盘损坏、服务过载或超大 Shuffle。
FetchFailed 是 Shuffle 数据不可获取的结果,不是单一根因;按丢失节点、网络、磁盘、服务负载和数据规模逐层定位,再决定重算还是调参。
先理解 Spark 为什么回退 Stage
Reduce Task 需要从多个 Map Task 所在节点拉取 Shuffle Block。某个 Block 不可用时,仅重试当前 Reduce 往往没有意义,Spark 会使当前 Stage 失败,并回到生成该 Map 输出的上游 Stage 重算丢失数据。重复失败最终才让作业退出。
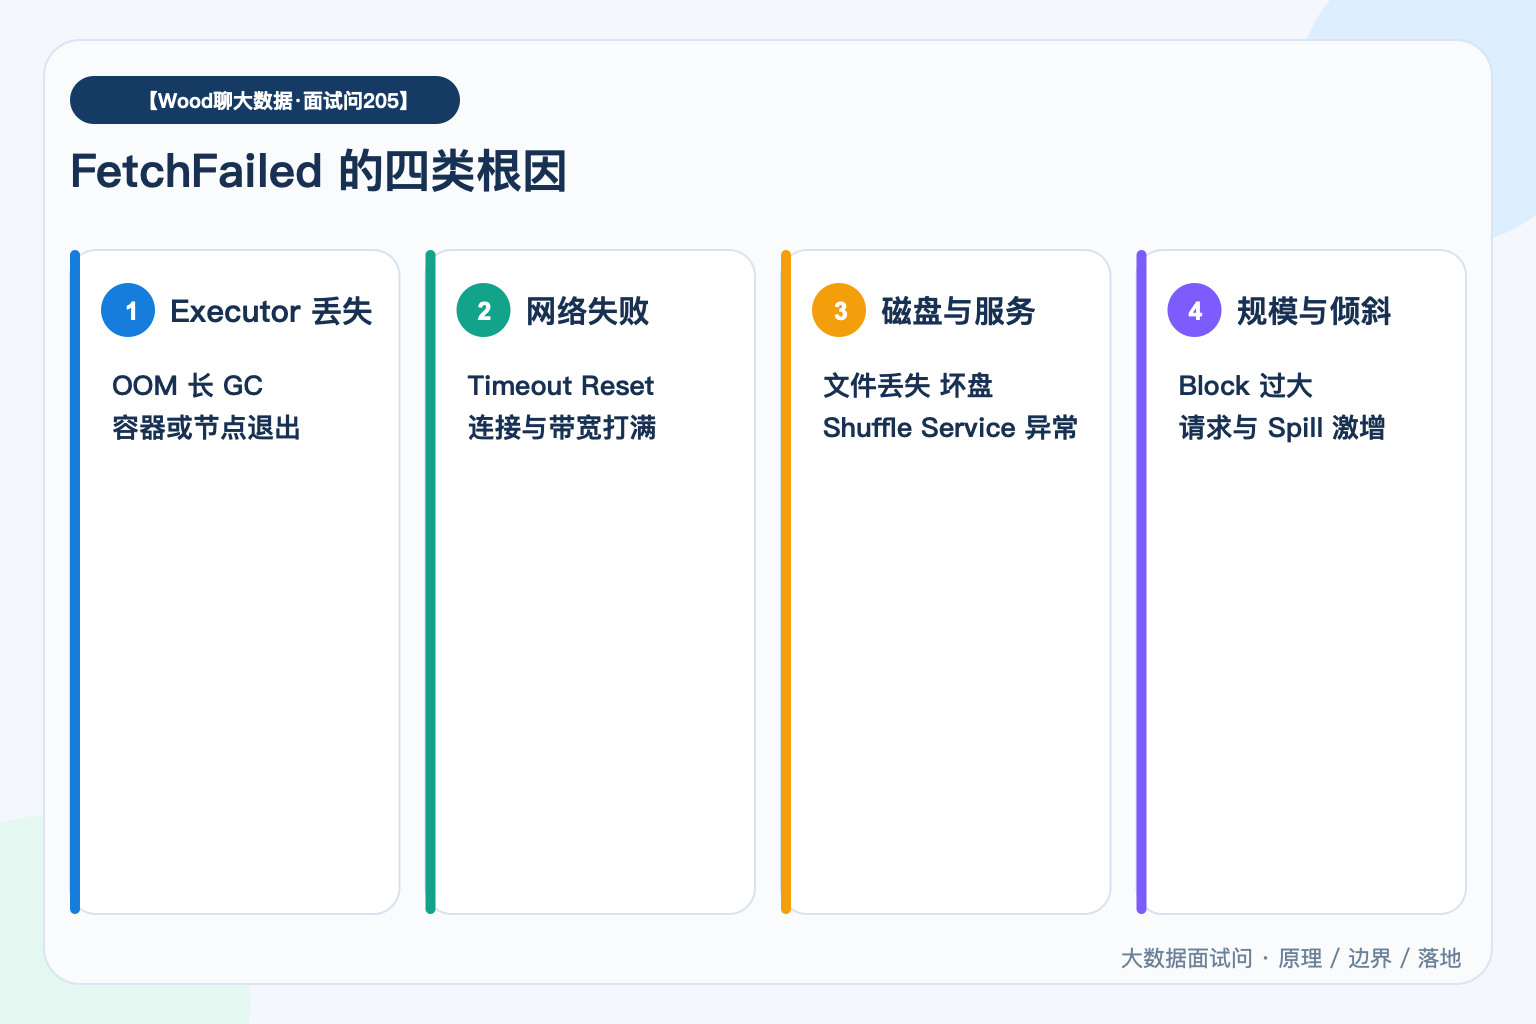
第一类:保存数据的 Executor 丢了
Executor OOM、长 GC、容器被抢占、节点重启或动态资源回收不当,都可能让本地 Shuffle 文件随进程消失。先把 FetchFailed 中的 BlockManager 地址与 Executor lost、YARN/K8s 事件和 GC 日志对齐。
第二类:Block 还在但拉不过来
网络抖动、连接被拒、超时、Netty backlog、并发请求过多,会让大量 Reduce 同时打爆某个节点。观察失败是否集中在少数 Host、是否伴随 Connection reset、Timeout,以及网络带宽、连接数和 Shuffle Service 指标。
第三类:磁盘与文件异常
本地磁盘满、坏盘、文件被提前清理、External Shuffle Service 路径不一致,都会表现为找不到或无法读取 Block。检查 NodeManager 或 Shuffle Service 日志、磁盘错误、目录权限和 Executor 退出后的文件保留机制。
第四类:Shuffle 规模与倾斜放大故障
单个分区过大、Map 输出数量过多或 Reduce 端同时拉取太多 Block,会让内存、连接和磁盘压力到达临界点。需要结合 Shuffle Read/Write、分区分布、spill 和失败 Reduce ID 判断是否由倾斜触发。
调参只能针对已确认的瓶颈
短暂网络抖动可适当调整 spark.shuffle.io.maxRetries 和 retryWait;连接风暴可限制并发请求;节点频繁丢失应先修 OOM、GC 或集群稳定性;超大分区则要重分区、预聚合或处理倾斜。盲目增加重试只会把一次确定性故障拖得更久。
参考资料
- Spark FetchFailed API:https://spark.apache.org/docs/latest/api/scala/org/apache/spark/FetchFailed.html
- Spark Shuffle Configuration:https://spark.apache.org/docs/latest/configuration.html#shuffle-behavior