Spark 广播变量能实时更新吗?规则变更怎么保证任务用同一版本?
本文目录
面试怎么回答
我会把广播变量看作只读版本快照,广播后不修改原对象。规则更新时创建新广播,并让一个作业或批次显式绑定规则版本,而不是期待Driver修改同步到Executor。切换需要考虑已提交任务仍引用旧版本,旧广播也要等在途使用结束再清理。输出保留规则版本,恢复和回放使用同一版本,才能验证结果一致性。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Driver里把规则Map的折扣从九折改成八折,Executor却还在按旧规则算。有人建议加锁,担心线程没同步。可广播变量不是跨进程共享的那一块Map,给Driver加锁也不会自动把新内容推到所有任务。
广播变量是分发的只读快照,不是共享可变内存;规则变更需要新版本和明确切换边界。
广播解决重复分发,不是建立共享内存
Spark广播变量用于将只读数据分发给工作节点,避免把相同内容随大量任务重复传输。读取的是分布式环境中的副本,不是Driver对象的远程实时视图。
因此广播完成后,不应继续修改原始对象并期待所有节点保持同步。不同副本可能在不同时间序列化或获取,原地修改会破坏“同一规则快照”的假设。
这与线程共享变量不同。Driver进程里的锁只能约束该进程内的访问,不能让已经运行在其他进程的任务自动获得新Map。
新规则用新快照,切换边界要显式
可以为规则生成不可变版本,例如规则内容、版本号和生效范围,创建新的广播对象,再让后续作业或批次捕获这个明确引用。
但仅把Driver变量名指向新广播,不会重新改写已经提交的任务闭包。旧任务仍可能按照提交时捕获的版本执行,这是需要设计的行为,不是异常。
因此先决定规则按作业、微批次,还是业务事件时间生效。不同边界对应不同实现,不能让某个Executor什么时候收到更新来决定业务规则。
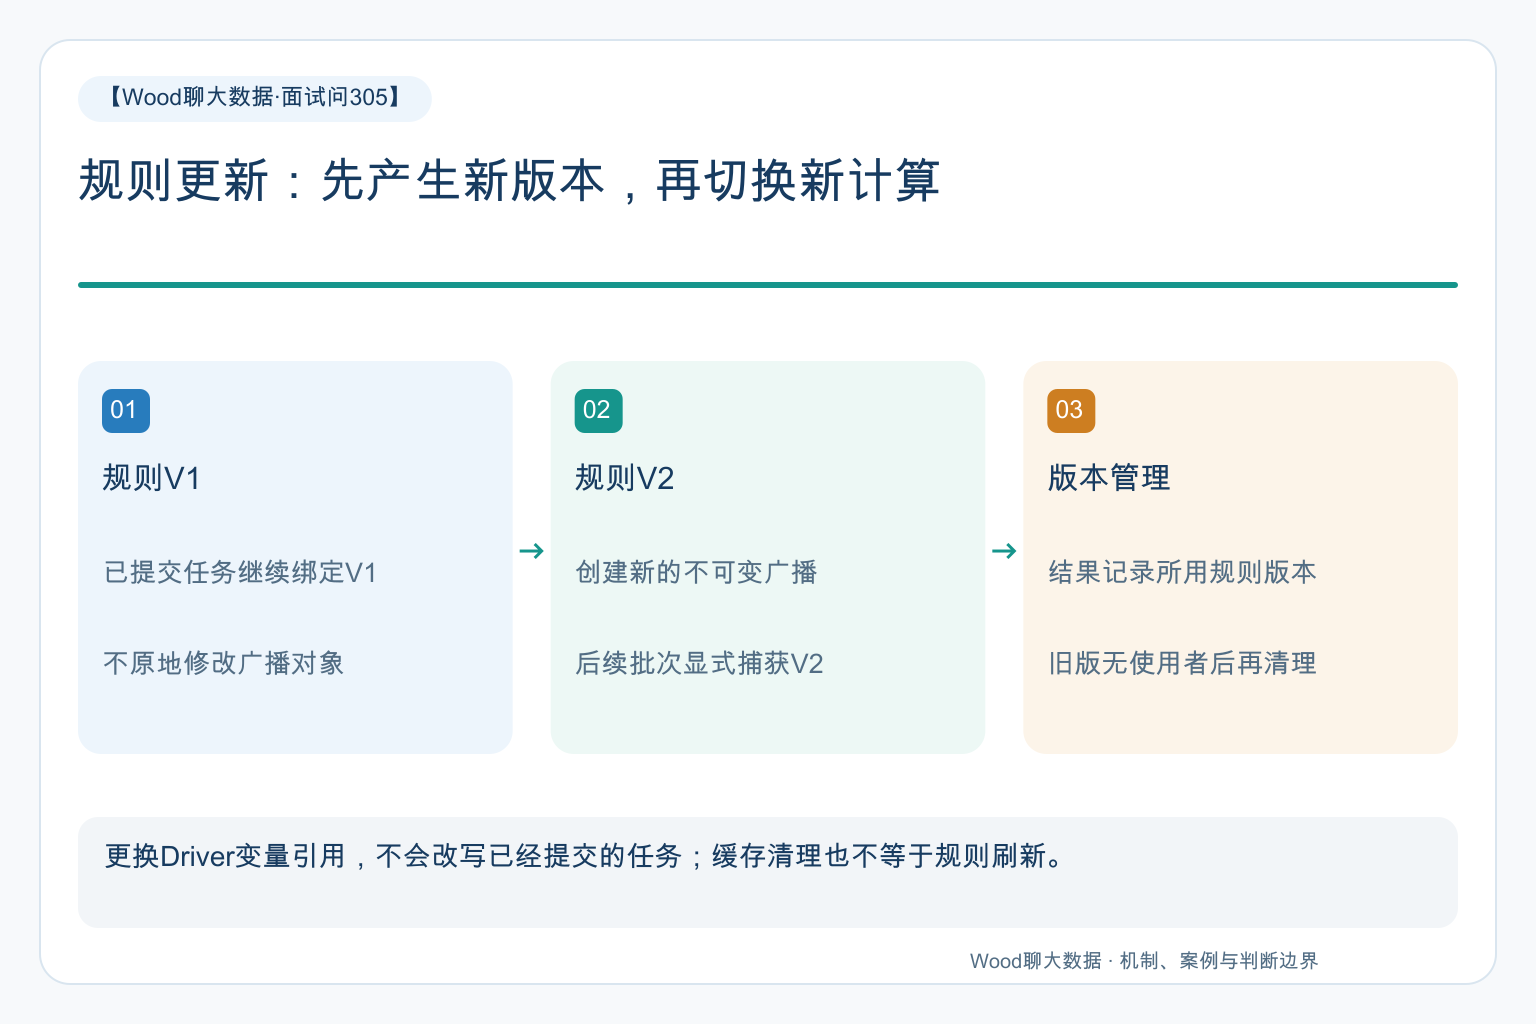
规则版本应成为结果的一部分
计算输出保留规则版本或批次版本,便于解释相同输入在不同发布中为什么结果变化,也便于对账。
如果规则表会覆盖更新,应保存足够的历史版本供回放使用。仅保留一个“当前规则”地址,任务失败后重跑可能读到新内容,导致同一批输入两次结果不同。
规则本身还应完整校验,例如适用范围、互斥性和引用维度是否齐全。广播只是分发手段,不会替你验证规则是否业务正确。
一个典型场景:同一批结果混用了两版折扣
比如多个作业分段处理同一天订单,中途修改Driver端规则并重新提交部分任务,输出却没有记录规则版本。
报表出现相同条件订单折扣不同,最初怀疑订单金额精度。回查任务提交时间才发现,部分结果来自旧广播,部分来自新广播。
旧验收只验证每个分段独立成功,没有检查同一发布批次的规则一致性。修复应固定批次规则版本,必要时重新计算受影响范围,并在发布清单里记录版本。
如果业务确实要求某个时刻切换,应按明确的业务时间条件选择对应版本,而不是把“分段任务恰好先后运行”当成生效规则。
清理旧广播,也是一项生命周期管理
新广播建好后,旧任务可能仍然使用旧版本。立即销毁旧广播,会给在途任务或后续重试带来问题,需要先确认不再有使用者。
Spark区分unpersist与destroy:前者释放缓存副本后仍可能在需要时重新获取,后者用于永久清理该广播的相关数据和元数据。具体调用方式以对应版本文档为准。
不要把unpersist当作“刷新成新规则”。缓存清理与规则更新是两个动作,重新获取旧广播并不会自动变成新内容。
什么时候不该靠频繁重建广播解决?
如果规则体积很大、更新很频繁,持续创建广播可能增加Driver和网络压力。应评估版本化维表关联、外部查询或其他符合时效要求的设计。
选型时同时考虑一致性边界、更新时间、查询成本和失败恢复。没有一种分发机制可以在不说明生效时点的情况下,自动获得完全正确的业务语义。
面试里最有用的结论是:规则更新先设计版本,再选择分发方式。广播变量让只读快照更容易被复用,不会替你完成在线配置中心的全部职责。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。