Spark 动态分区裁剪 DPP 是怎么工作的?
面试怎么回答
DPP 解决的是 Join 过滤无法在规划期直接作用到大表分区的问题。Spark 先计算过滤侧的 Join Key,再生成动态过滤,在事实表扫描前跳过无关分区;Broadcast Join 时还可能复用广播结果。它要求被裁剪表按可追踪的 Join Key 分区、过滤有选择性且 Join 类型与数据源支持。排查时看 EXPLAIN、实际扫描分区和统计信息,而不是只看开关。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
事实表 SQL 没有直接写日期条件,执行计划却只扫描了少量分区。
过滤条件明明在维表一侧,Spark 是怎么在运行时把它传给事实表扫描的?这就是 Dynamic Partition Pruning。
DPP 利用 Join 另一侧的过滤结果生成分区值集合,在扫描大表前动态跳过无关分区。
静态裁剪为什么不够?
如果 SQL 直接写 fact.dt = '2026-08-29',优化器在规划阶段就能裁剪分区。但星型模型常写成:事实表通过 date_id Join 日期维表,过滤条件是维表的月份、季度或节假日属性。
规划事实表时,具体 date_id 集合还没有直接出现在事实表条件中,静态裁剪无法利用。
DPP 的基本过程
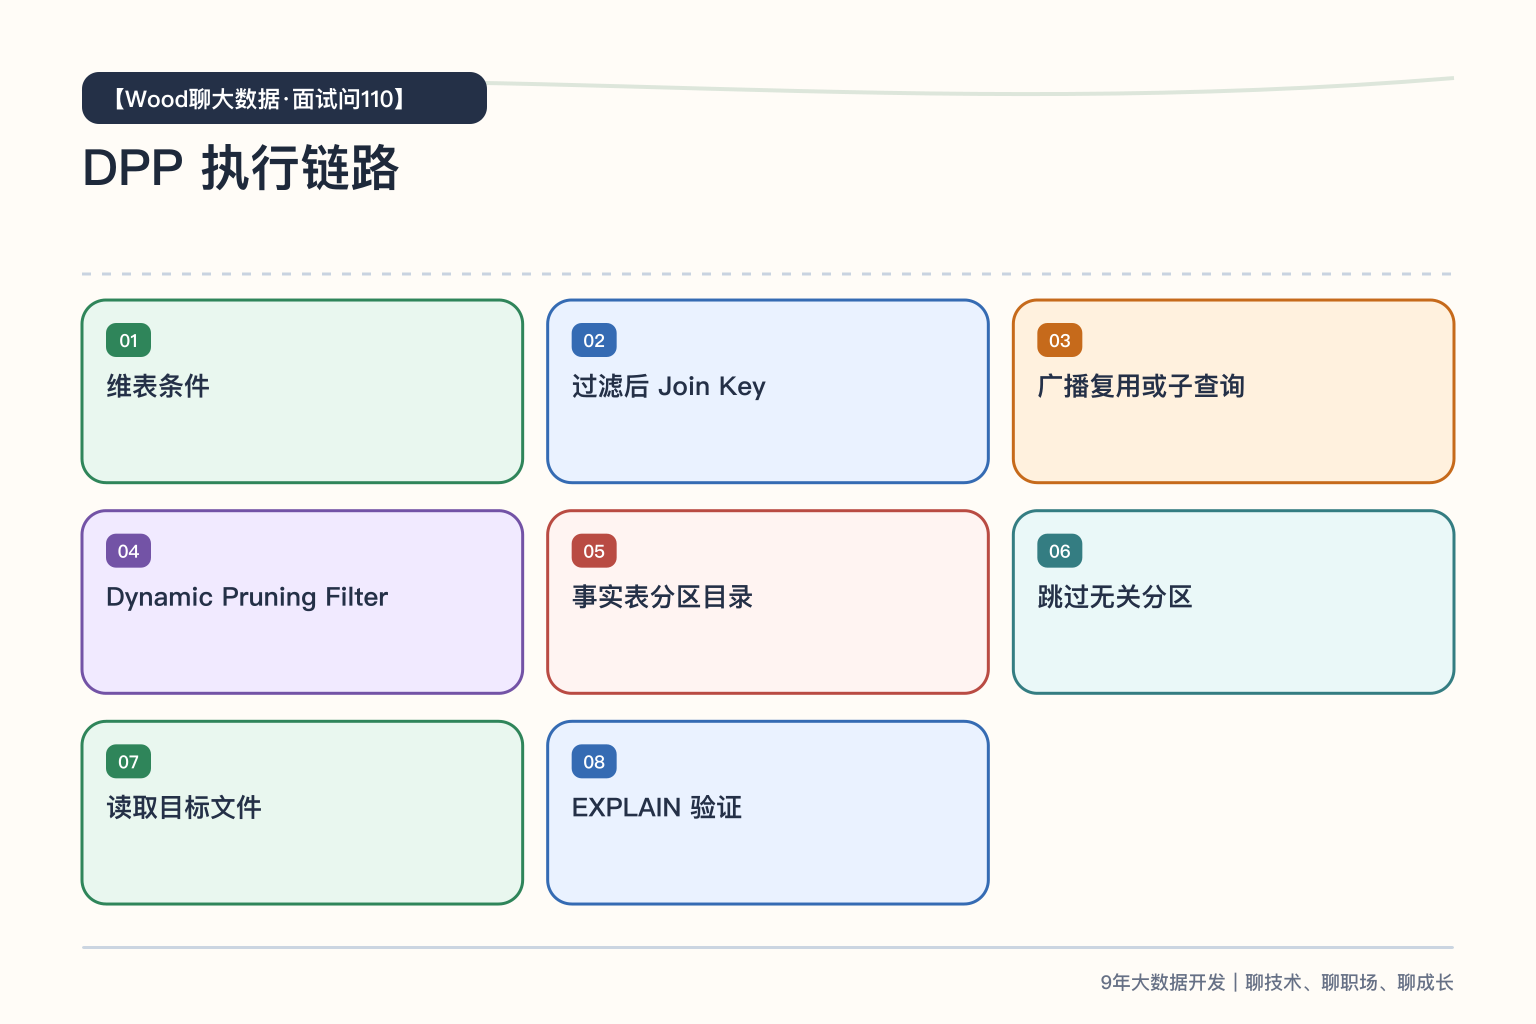
第一步,维表先应用高选择性过滤,得到满足条件的 Join Key;第二步,Spark 把这些 Key 构造成动态过滤子查询;第三步,在事实表分区扫描前,用 Key 集合过滤分区目录或支持 Runtime Filtering 的数据源。
如果维表参与 Broadcast Hash Join,Spark 可能复用广播结果,避免重复计算;如果不能复用,则要比较额外子查询成本和能节省的扫描量。
什么时候容易生效?
被裁剪的大表必须按 Join Key 或可追踪表达式分区,另一侧要有选择性过滤,并且 Join 类型满足优化条件。字段类型、表达式和血缘如果无法匹配,动态过滤可能无法下推。
统计信息也会影响成本判断。如果维表过滤后仍返回大量 Key,生成和传递过滤集合可能得不偿失。
为什么开了配置仍没效果?
常见原因包括:事实表不是按 Join Key 分区;Join Key 被复杂 UDF 包装;字段类型不一致;过滤条件选择性太低;Join 类型不支持;统计信息缺失;数据源不支持对应运行时过滤。
检查 EXPLAIN 中是否出现 Dynamic Pruning 相关表达式,再对比扫描分区数和文件数。不能只看配置值判断是否生效。
一个典型反例
事实表按字符串 dt 分区,维表 Join Key 却是整数 date_id。虽然两者语义上都表示日期,但 Join Key 不是事实表分区列,DPP 无法直接裁剪。
解决方案可能是调整模型,让分区键参与 Join,或者在查询中增加可推导的分区条件。DPP 不是自动理解业务语义。