Spark SQL Catalyst 优化器是怎么工作的?
面试怎么回答
Catalyst 会先把 SQL 解析成未解析逻辑计划,再由 Analyzer 结合 Catalog 绑定表、字段和类型;优化器通过规则改写逻辑计划,例如谓词下推、列裁剪和常量折叠;随后生成并选择物理计划。排查时我会用 EXPLAIN EXTENDED 对比各阶段计划,并结合统计信息、Exchange、Join 策略和 AQE 判断优化是否生效。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
如果只回答“它会自动优化 SQL”,信息量几乎为零。面试官真正想听的是:一条 SQL 如何从文本变成可执行计划,Catalyst 在哪几个阶段做了什么。
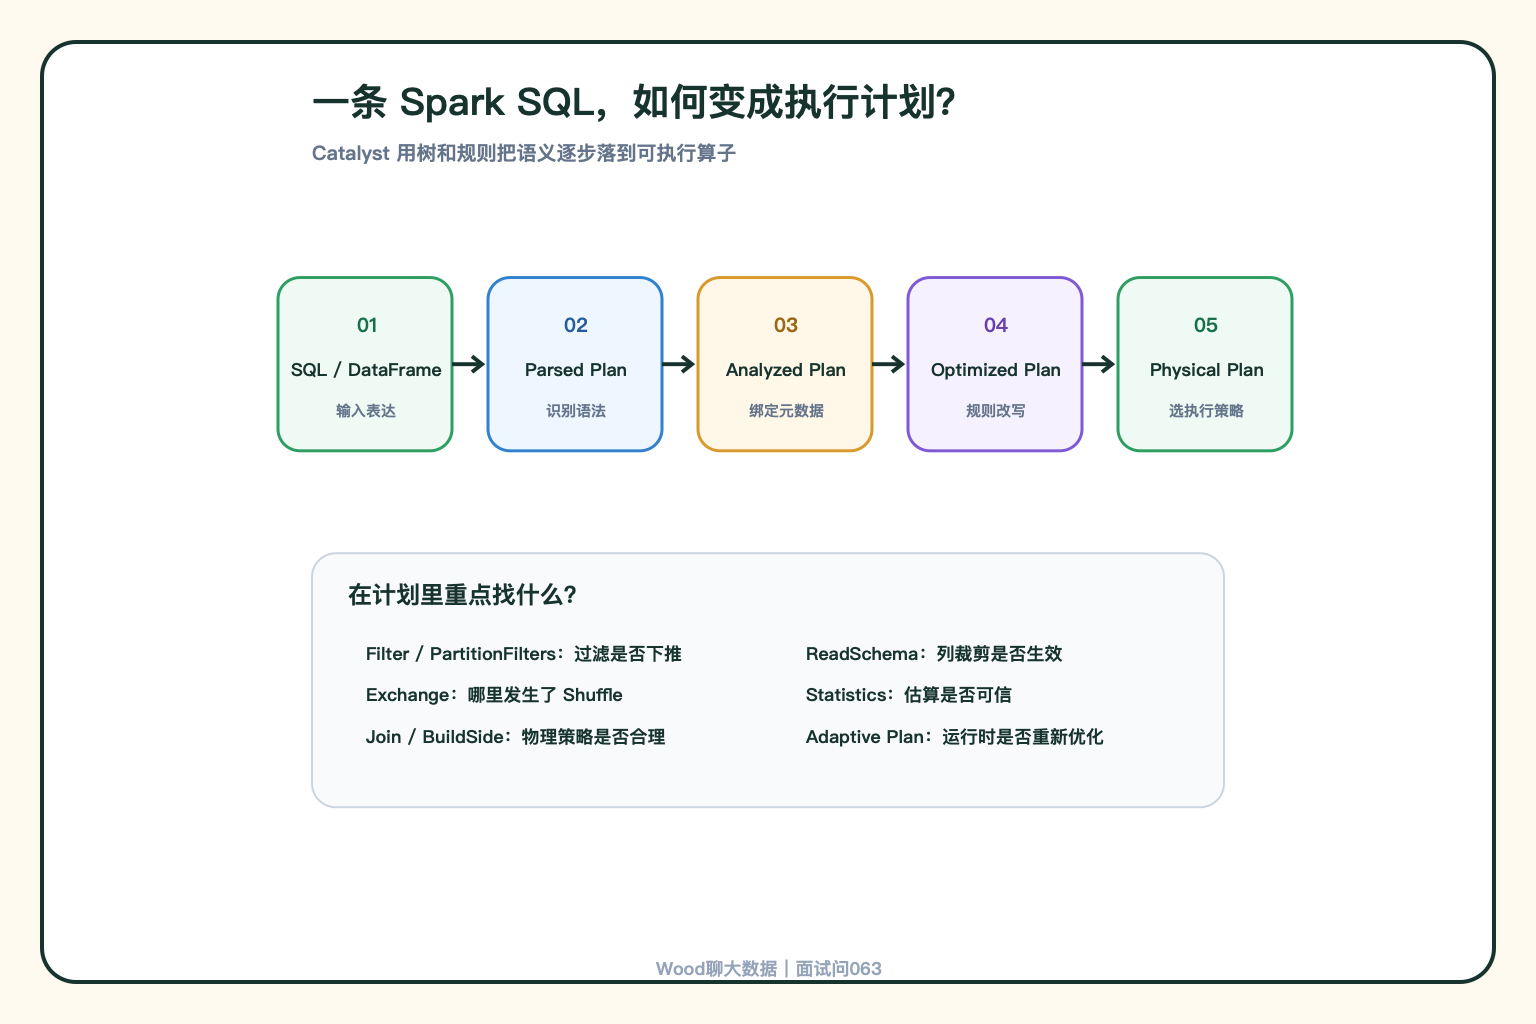
可以先记住一条主线:解析 SQL、绑定元数据、优化逻辑、选择物理计划,最后再交给执行引擎。
第一步:解析成逻辑计划
Spark 先把 SQL 文本解析成树形结构。这个阶段能识别 SELECT、JOIN、WHERE 等语法,但表、字段和数据类型还不一定已经确定,因此得到的是未解析的逻辑计划。
如果 SQL 本身语法不合法,问题会在这里暴露。
第二步:Analyzer 绑定真实元数据
Analyzer 会借助 Catalog,把计划中的表名、字段名、函数和数据类型解析成明确对象,并完成必要的类型校验与转换。
例如同名字段没有限定表别名、字段不存在,或者函数参数类型不匹配,通常会在分析阶段失败。
第三步:优化逻辑计划
Catalyst 的核心不是某一条神奇算法,而是一套基于树和规则的优化框架。优化器会对逻辑计划反复应用可用规则,例如:
- 把过滤条件尽量推到数据源附近
- 只保留后续真正需要的列
- 折叠可以提前计算的常量表达式
- 简化冗余条件与不必要的算子
- 在具备统计信息时辅助调整 Join 选择
这些优化的目标,是在不改变结果语义的前提下减少扫描、传输和计算。
第四步:生成并选择物理计划
同一个逻辑操作可能有多种物理实现。比如 Join 可以使用广播哈希、排序合并等策略。
Spark 会生成候选物理计划,再结合规则、统计信息、配置和代价选择执行方案。真正执行时看到的 BroadcastHashJoin、SortMergeJoin、Exchange、HashAggregate,已经属于物理计划。
怎么验证优化器到底做了什么?
不要靠猜,直接看计划:
EXPLAIN EXTENDED
SELECT user_id, SUM(pay_amount)
FROM dwd_order
WHERE dt = '2026-08-27'
GROUP BY user_id;
EXPLAIN EXTENDED 会展示 Parsed、Analyzed、Optimized Logical Plan 和 Physical Plan。排查时重点对比:
- 分区过滤和普通过滤是否下推
- 无用字段是否被裁剪
- Join 选择和 Build Side 是否合理
- 哪里出现了
Exchange,意味着发生了数据重分布 - 估算行数、表大小等统计信息是否可信
如果统计信息缺失或过期,优化器可能低估大表、误判广播条件。Spark 运行过程中还可以通过 AQE 使用运行时统计重新调整部分计划,但它也不是所有问题的兜底。
Catalyst 解决不了什么?
Catalyst 能优化的是它可以理解和改写的计划,不代表任何 SQL 都会自动变快。
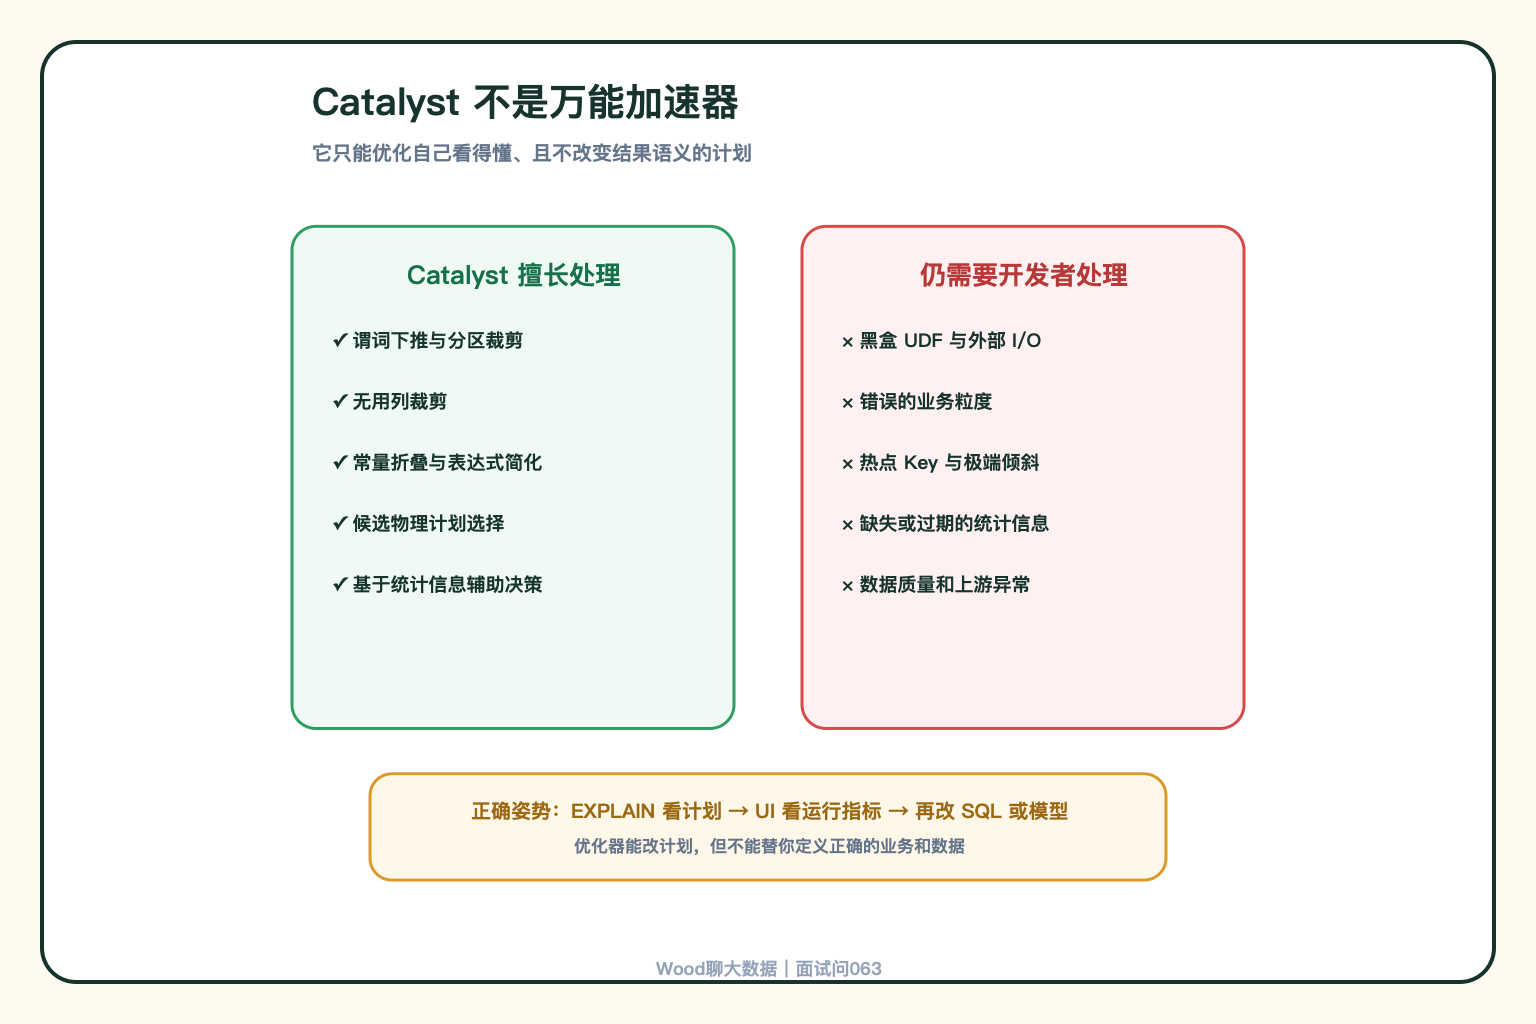
下面几类问题仍然需要开发者处理:
- 黑盒 UDF 阻断下推或增加序列化开销
- 业务模型错误,导致 Join 粒度失控
- 数据倾斜、极端热点或外部系统变慢
- 统计信息长期不更新
- 代码写法改变了类型或分区列,导致过滤无法下推
所以优化 SQL 的正确方式不是“相信 Catalyst”,而是先读计划,再根据扫描、Shuffle、Join 和运行时指标定位问题。