Spark AQE 能解决什么问题?有什么局限?
面试怎么回答
AQE 会利用运行时统计重新优化后续物理计划,常见能力包括合并过小的 Shuffle 分区、动态调整 Join 策略,以及拆分倾斜分区。它解决的是执行前统计不准带来的部分计划偏差,但不能替代 SQL、模型、热点 Key 和外部 IO 的治理。生产中我会同时检查 AdaptiveSparkPlan 的最终计划、Task 分布和总耗时,而不是只确认开关是否开启。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
AQE 的价值,不是提前把一切都猜对,而是让 Spark 在执行过程中拿到更准确的统计信息后,再调整后续计划。
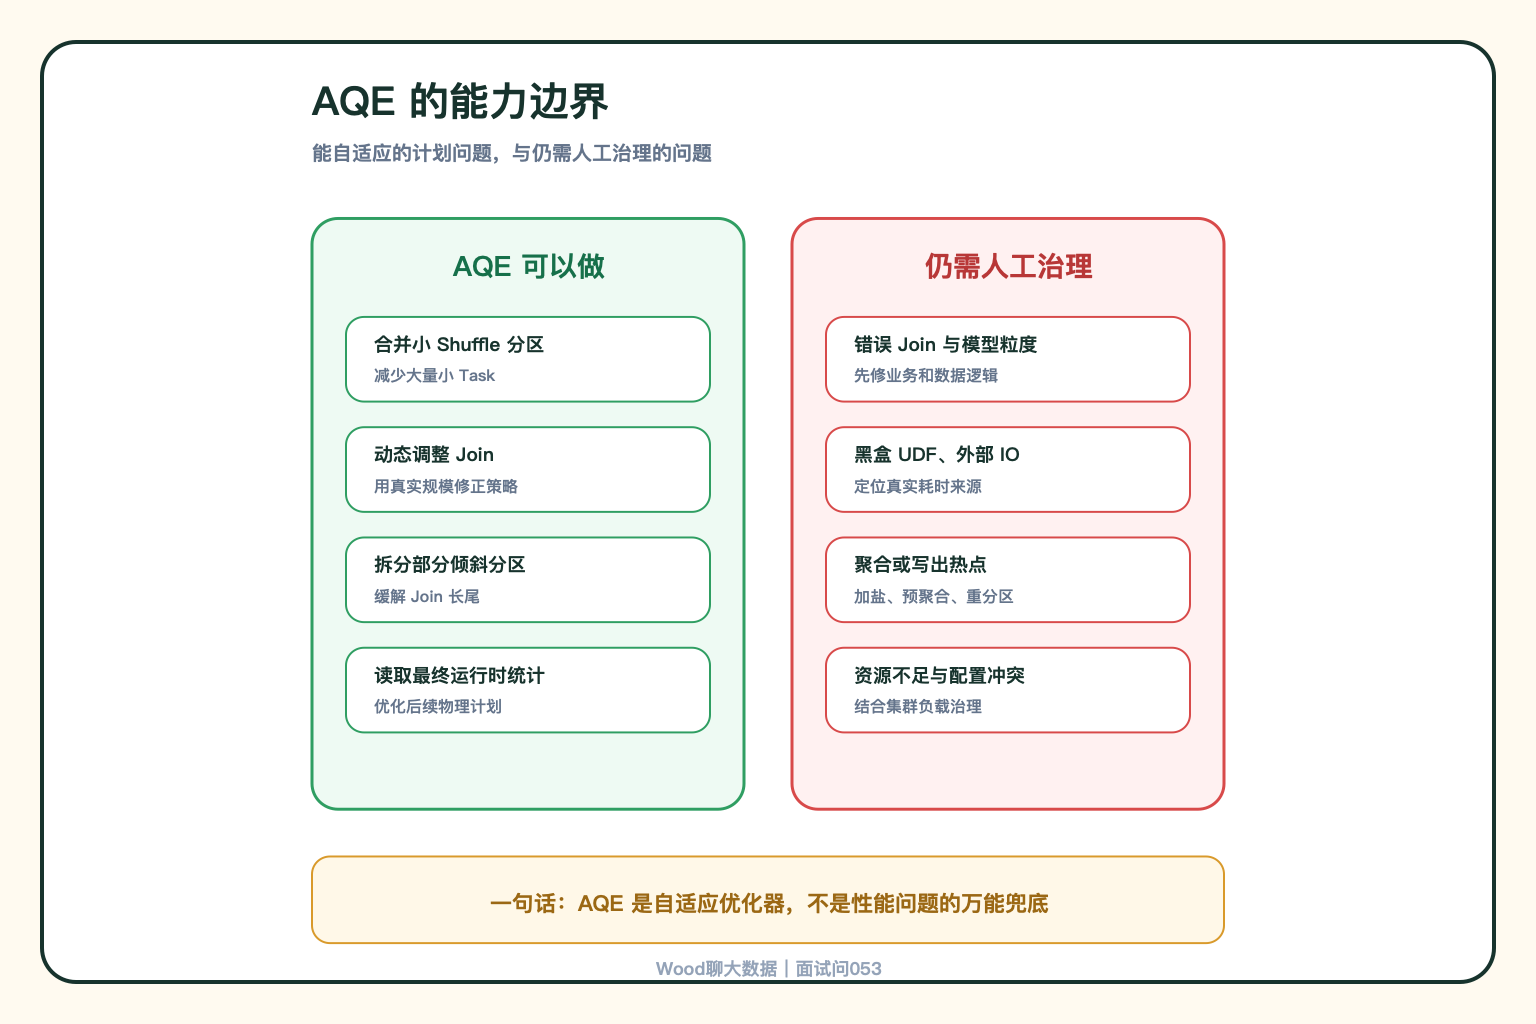
一句话概括:AQE 是运行时自适应优化器,它能修正部分“执行前估不准”的问题,但不能替代数据建模、SQL 优化和资源治理。
AQE 为什么有价值?
传统执行计划主要依赖执行前统计信息。但真实任务中,过滤后的数据量、Shuffle 分区大小和 Join 两侧规模,常常只有跑起来才知道。
AQE 会在 Shuffle 等阶段边界收集运行时统计,再重新优化后续物理计划。
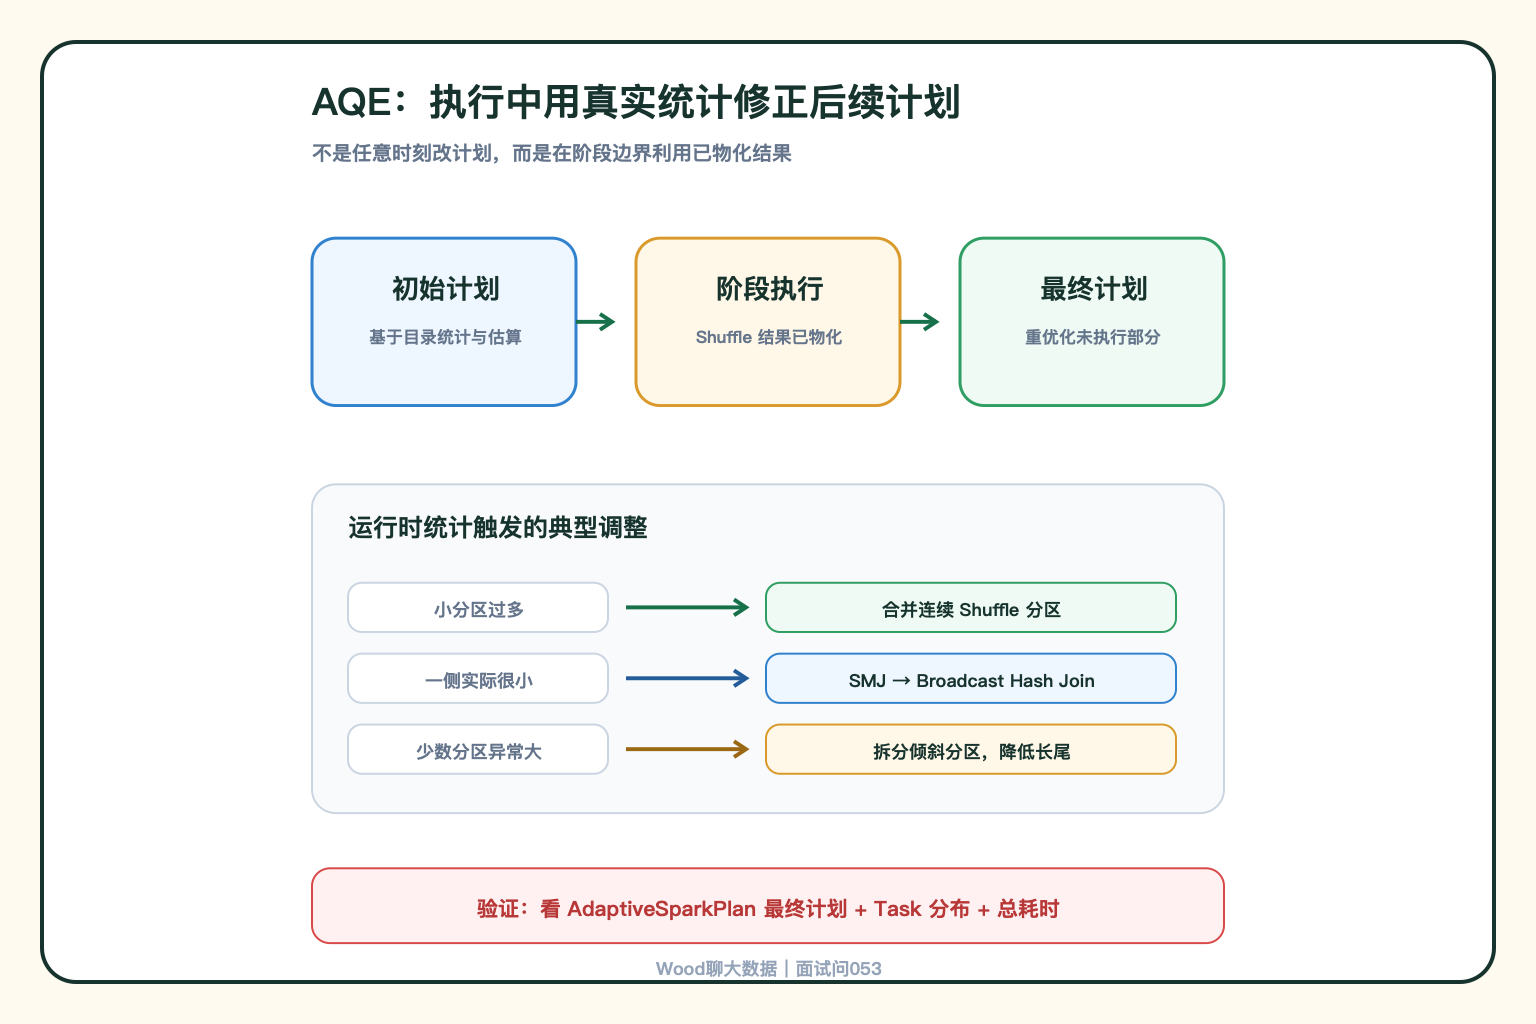
它不是一边处理单条数据一边随意改计划,而是利用已经物化的阶段结果,调整还没执行的部分。
AQE 主要解决三类问题
1. 合并过多的小 Shuffle 分区
spark.sql.shuffle.partitions 配得太大时,过滤后的数据可能只剩很少,却仍产生大量小 Task。
AQE 可以根据运行时分区大小合并连续的小分区,减少调度开销和小任务数量。
2. 动态调整 Join 策略
执行前无法确认某一侧足够小时,Spark 可能先选择 Sort Merge Join。运行时发现一侧实际很小后,AQE 有机会改成 Broadcast Hash Join,避免不必要的排序和部分 Shuffle 开销。
3. 优化倾斜的 Shuffle 分区
当少数分区明显大于其他分区时,AQE 可以识别倾斜分区并拆分,在 Join 场景中按需复制另一侧数据,降低单个长尾 Task 的影响。
AQE 有哪些局限?
它只能优化支持的执行计划
AQE 主要作用于 Spark SQL、DataFrame 的物理计划与阶段,不会自动修复任意 RDD 代码、黑盒 UDF 或外部接口慢的问题。
它不是所有数据倾斜的万能解法
热点 Key、聚合倾斜、写出倾斜和业务分布异常,仍可能需要预聚合、加盐、拆分热点或重新设计分区策略。
它不能弥补错误的业务设计
全表扫描、无效字段过多、错误 Join 条件、数据重复、模型粒度不清,这些问题不会因为开启 AQE 就消失。
优化有前提,也有代价
运行时统计要到阶段完成后才能获得;广播受阈值和 Executor 内存约束;拆分倾斜分区也可能带来额外读取与复制。
生产里怎么判断 AQE 是否生效?
不要只看配置是否为 true,还要看:
- SQL UI 中是否出现 AdaptiveSparkPlan
- 初始计划和最终计划是否发生变化
- Shuffle 分区数、Task 大小和长尾是否改善
- Join 策略是否被动态调整
- 总耗时下降的同时,是否引入广播内存风险
配置打开,只代表具备自适应能力;最终计划和任务指标,才代表它真正解决了问题。