Spark 分区数怎么设置?
面试怎么回答
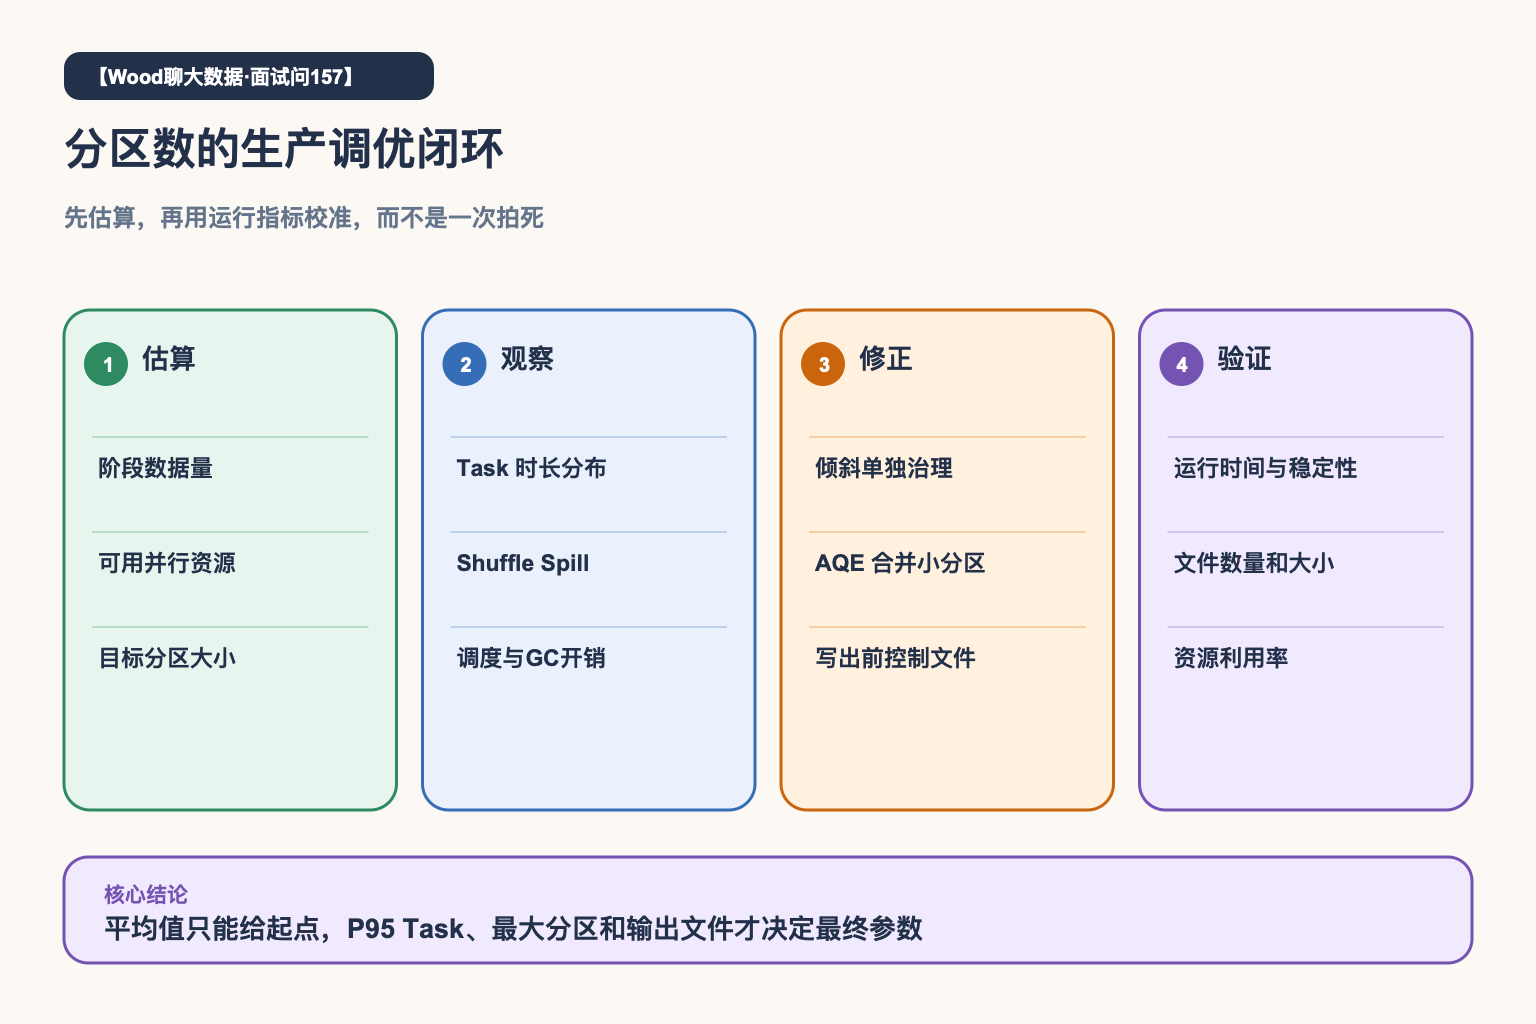
我会把输入分区、Shuffle 分区和输出分区分开设计。输入看文件切片,Shuffle 看阶段数据量、单分区大小、Core 和倾斜,输出看目标文件大小与下游消费。先用数据量做估算,再通过 Spark UI 的 Task 长尾、Spill、GC、调度开销和文件数量校准。AQE 可以动态合并小分区,但热点倾斜和输出文件仍要单独治理。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一份数据,分区太少时少数 Task 跑很久;分区太多时,调度和小文件又会拖慢任务。
所以“分区数设成 CPU Core 的两三倍”只能作为起点,不能当成固定答案。
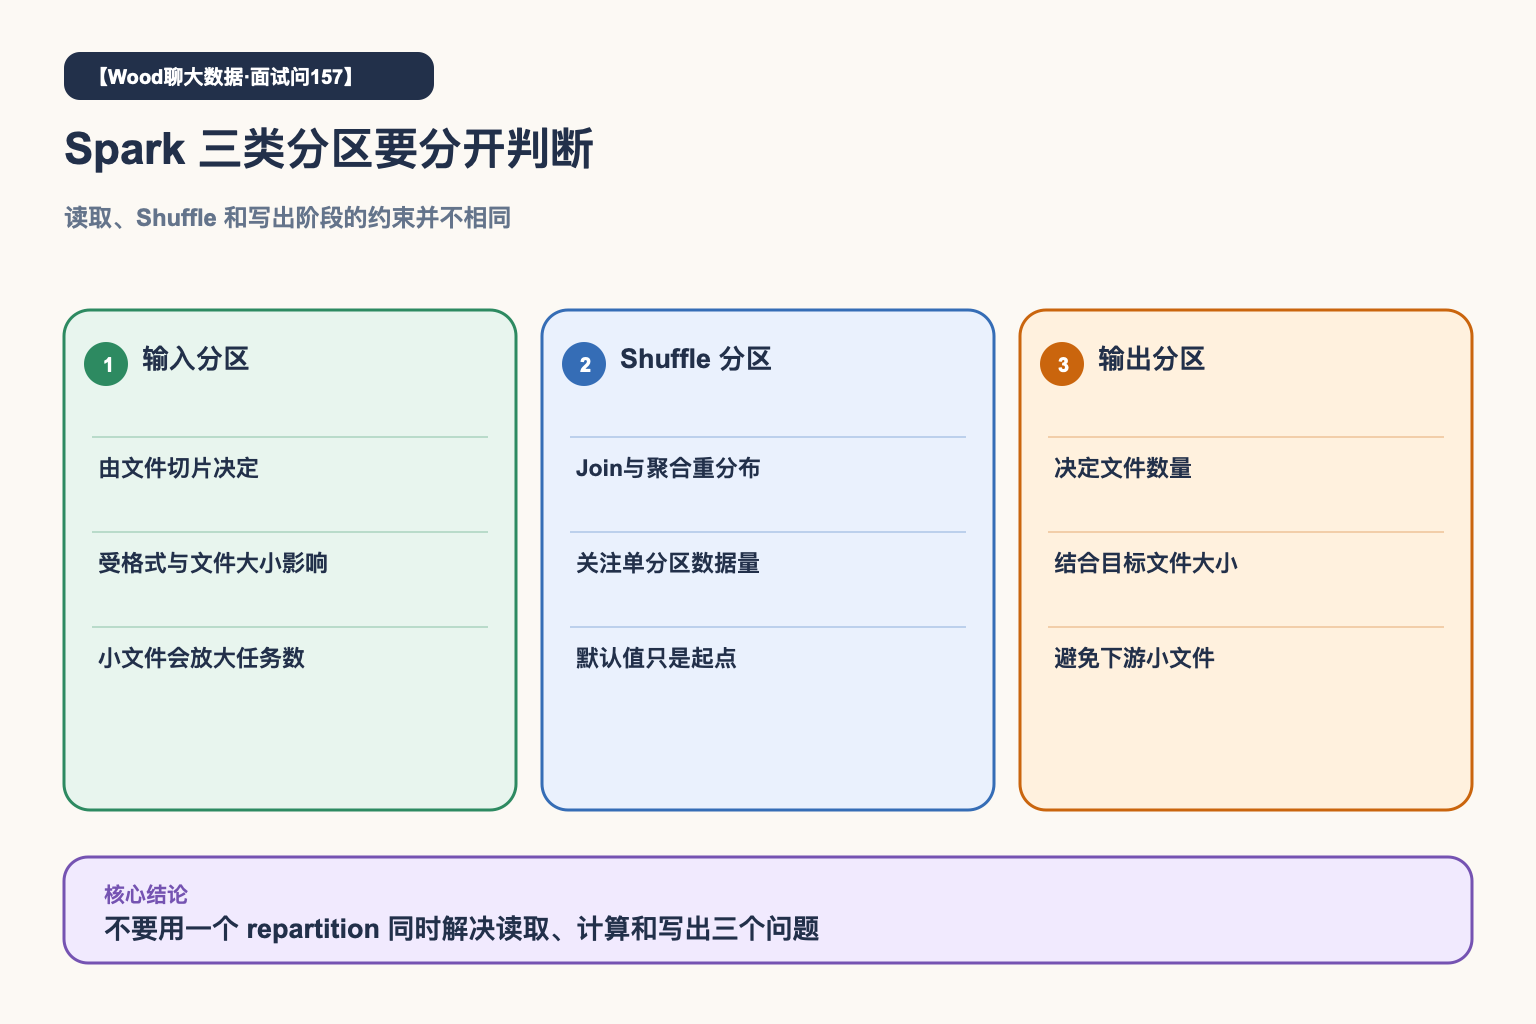
Spark 分区数要分别看输入、Shuffle 和输出,并围绕阶段数据量、倾斜、资源和目标文件大小实测调整。
输入分区:先看文件如何被切分
读取文件时,分区数受文件数量、文件格式、可切分性和扫描配置影响。
大量小文件可能产生大量输入 Task;单个不可切分的大文件又可能限制并行度。此时只调整 spark.sql.shuffle.partitions,并不能改变输入阶段。
Shuffle 分区:决定 Join 和聚合的并行度
Join、GROUP BY、distinct 等宽依赖通常会触发 Shuffle。Shuffle 分区太少,单个 Task 数据量大,容易出现 Spill、GC 和长尾;分区太多,则增加调度、网络连接和小任务开销。
当前 Spark 文档中,spark.sql.shuffle.partitions 仍是 SQL Shuffle 的默认分区配置,但默认值只能当基线。AQE 可以在运行时合并过小分区、处理部分倾斜场景,仍然不能替代对数据分布的理解。
输出分区:决定最终文件数量
计算阶段合适的分区数,不一定适合写文件。
如果直接把上游几千个分区写到分区表,可能产生大量小文件;如果为了少文件提前 coalesce 到很少分区,又可能让最后写出阶段变成瓶颈。
更合理的方式是根据目标文件大小、下游读取方式和写入吞吐,在输出前单独控制分区。
怎么给出一个初始值
可以先估算当前阶段的数据量和希望的单分区处理量,再结合可用 Core 得到初始范围。
但估算后必须看 Spark UI:Task 时长分布、输入与 Shuffle 数据量、Spill、GC、最大分区、调度延迟和输出文件大小。
一个典型场景
某聚合任务平均每个分区并不大,但一个热点 Key 把单个分区推到远高于平均值。继续整体增加分区数,只是增加了大量空闲 Task,热点分区仍然最慢。
这时要单独处理倾斜,例如拆分热点 Key、预聚合或使用适合的 AQE 策略,而不是继续盲目加分区。