Spark Stage 卡在99%都是数据倾斜吗?慢尾任务怎么定位?
面试怎么回答
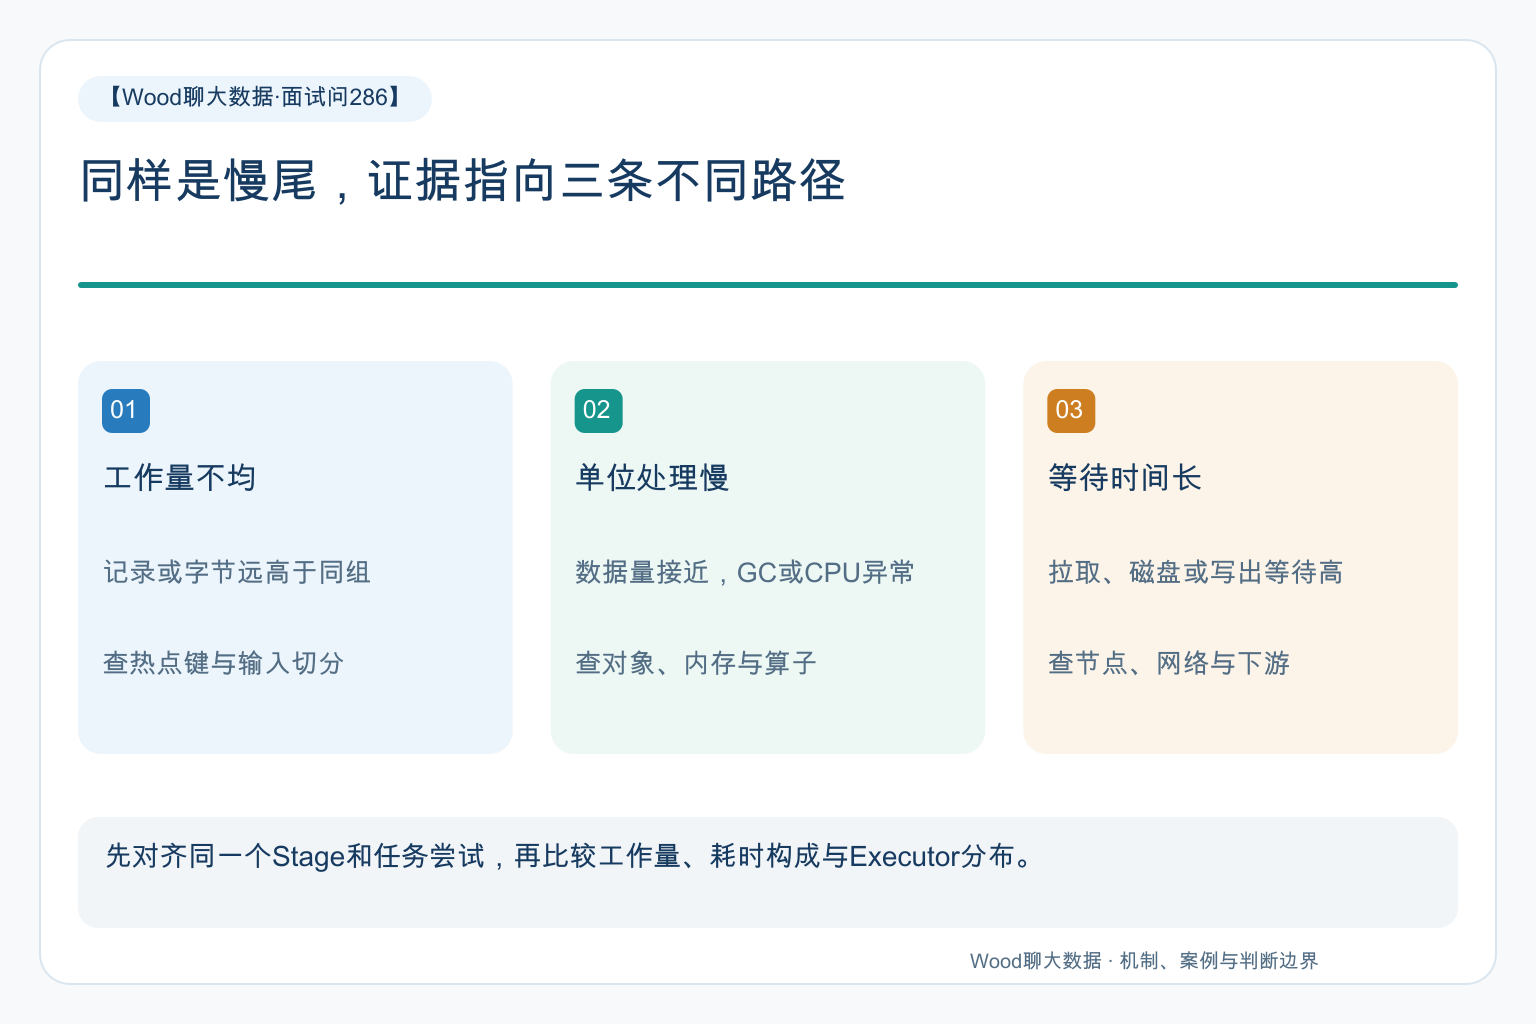
我会先确认剩余任务是在运行还是等待提交,再比较慢任务和中位任务的输入量、Shuffle量、耗时及节点分布。工作量明显不均才优先考虑数据倾斜;数据量接近但GC、拉取等待或写出时间异常,则沿内存、网络、磁盘或下游排查。最后按证据做单项调整并复测,不把所有慢尾都用加盐或增加并行度处理。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
“Stage 一直停在99%,我准备把 Join Key 加盐。”这个操作可能有效,也可能只是让 SQL 更复杂。最后一个任务慢,既可能是分区特别大,也可能是它落在一台磁盘很慢的机器上。先证明是哪一种,再动手。
慢尾是现象,倾斜只是原因之一;比较任务输入、计算、等待与节点分布后,再决定是否改数据分布。
99% 不是剩余时间只差1%
进度条通常反映任务完成数量,不按每个任务预计耗时加权。前面许多任务很快结束,剩下少数大任务仍可能占据大部分墙钟时间。
也要确认当前卡点。Task 还在执行、等待资源、Driver 拉取结果,以及文件写完后的提交阶段,属于不同路径。看见页面没变化就判断 Shuffle 倾斜,容易选错入口。
先保留 Job、Stage、任务尝试和 Executor 的对应信息。重试后的新尝试不能与原尝试混在一起比较,否则可能把恢复开销误认为单次处理时间。
第一组比较:它是否真的干了更多活?
对比慢任务和同一 Stage 中其他任务的输入记录、输入字节、Shuffle 读取记录及字节。记录数多,可能有热点键;记录数接近而字节差距大,也可能是宽字段或大对象集中。
不要只盯着平均数。中位数、高分位和最大值之间的差距,通常更能暴露尾部。平均量看起来正常,并不能证明分区均衡。
但字节多也不自动等于 Join Key 倾斜:输入文件切分、不可拆分数据、过滤后的分布变化,都可能导致任务负载不均。还要回到实际算子,确认热点出现在读取、关联还是聚合。
第二组比较:时间究竟花在哪里?
Spark 4.0.1 的任务页面提供执行时长、GC、Shuffle 拉取等待、写入及 Spill 等线索。指标之间不是可以随意相加的独立账目,应结合线程、日志和节点监控解释。
工作量相近,但拉取等待异常,优先核对远端 Shuffle、网络和数据所在节点;GC 占比突出,要检查对象规模、内存压力与同 Executor 上的并发任务。
写出阶段慢还可能来自存储请求、限流、文件提交或下游响应。增加计算实例不一定能提升一个已经饱和的外部写入端。
一个典型场景:给热点加盐,却没治好坏磁盘
比如少量任务持续拖尾,最初按倾斜处理,增加分区并给疑似热点键加盐,整体改善却不稳定。
进一步按 Executor 汇总后发现,慢任务并不总处理同一批业务键,而是集中在同一节点;它们的输入量与其他任务接近,磁盘读写等待却明显偏高。
旧验收只比较最大任务耗时,没有记录任务与机器的关联,因而把硬件异常当成了数据分布问题。修复应先排除异常节点并确认恢复,再决定是否保留增加的数据处理复杂度。
这是一个典型反例,不意味着遇到坏节点就可以忽略倾斜。两种问题可能同时存在,需要分别观察工作量差异和单位工作量耗时。
优化要对应原因,也要能撤回
证实是少量热点键时,再考虑预聚合、热点拆分或合适的 Join 策略;证实是节点或存储异常时,优先修复基础设施路径。
推测执行可能缓解某些偶发慢任务,但对于所有副本都要处理的巨大分区,不能从根本上消除工作量;涉及外部副作用时还要确认重复执行安全。
单次复测最好固定输入和主要资源条件,只改变有证据支持的一项。比较端到端完成时间、尾部任务分布、资源成本和结果一致性,而不是只截图一个更快的 Task。
当最后一个 Task 结束后仍有长时间等待,记得把调查继续推进到 Driver 和提交协议。慢尾排查的终点是业务产物按时可用,不是进度条从99变成100。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。