Spark 广播 Join 什么时候用?有哪些坑?
面试怎么回答
广播 Join 适合一侧过滤、投影后足够小,能被 Driver 分发并在每个 Executor 内存中构建,且另一侧 Shuffle 成本较高的场景。我不会只看磁盘大小,而会检查统计、行数和字段宽度,用 EXPLAIN 确认 Build Side。主要风险是统计过期、强制广播过大、并发叠加、超时和内存压力。上线后看广播耗时、GC 和 Executor Lost,必要时回退 Shuffle Join。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“大表 Join 小表时,把小表广播出去,避免 Shuffle。”
方向是对的,但真正危险的地方就在“小表”两个字。
广播 Join 的核心取舍是:
用每个 Executor 的内存和一次网络分发,换掉大表按 Join Key Shuffle 的成本。
第一步:什么场景适合广播 Join
当 Join 一侧在过滤、投影之后足够小,可以被 Driver 收集并发送到各 Executor,同时能在每个 Executor 内存中构建查询结构时,广播通常很有价值。
典型场景包括:
- 大事实表关联小维表
- 小表经过强过滤后只剩少量数据
- 大表 Shuffle 成本明显高于广播成本
- 同一个广播侧会被多个并行 Task 使用
Spark 可以根据统计信息和 spark.sql.autoBroadcastJoinThreshold 自动选择,也可以使用 BROADCAST Hint 提示优化器。
但 Hint 是强烈建议,不是安全校验。强制广播之前,仍要确认真实数据大小和 Join 类型。
第二步:“小”要看实际构建大小
不能只看表的磁盘文件大小。
Parquet 或 ORC 在磁盘上有压缩,读取成 JVM 对象或内部行格式后,内存占用可能明显放大。
也不能只看整张表大小。
真正参与 Join 的是过滤、投影和上游算子完成后的结果。如果统计信息过期,优化器可能错误估算;如果某个表达式导致行数膨胀,原本的小表也可能变成大表。
我通常会看:
EXPLAIN中实际选择的 Join 策略和 Build Side- Catalog、文件和运行时统计是否可信
- 过滤后行数、字段宽度和序列化大小
- SQL UI 中广播阶段的数据量和耗时
- Executor 内存、并发广播和 Broadcast Timeout
第三步:广播 Join 常见的几个坑
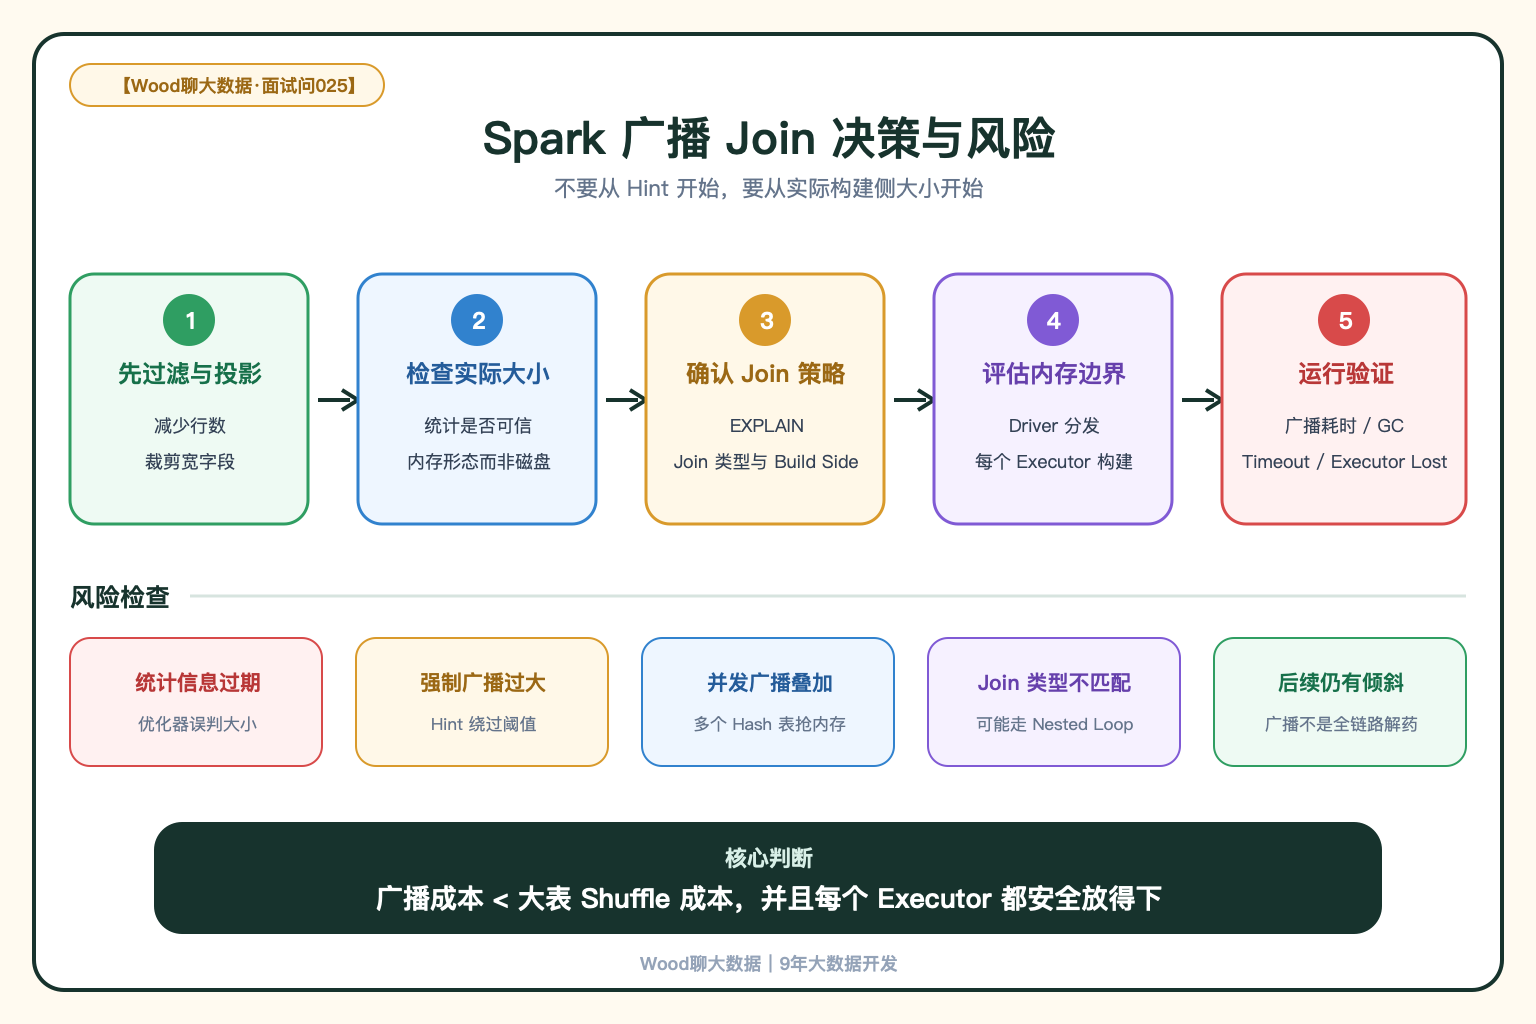
统计信息过期
优化器以为是小表,实际运行时远大于估算,可能出现广播超时或内存压力。
强制广播过大的结果集
使用 Hint 可以让 Spark 优先广播超过自动阈值的关系。如果只为了消除 Shuffle 就强制 Hint,Driver 收集和每个 Executor 构建 Hash 表都可能成为新瓶颈。
只看单个广播,不看并发
一个 Executor 可能同时运行多个 Query 或持有多个广播变量。单个都不大,叠加后仍会挤占执行内存。
把广播当成数据倾斜万能药
广播可以避免大表按 Join Key 重分布,对某些 Join 倾斜有效;但如果大表本身输入分区不均、后续聚合仍按热点 Key Shuffle,倾斜还会在其他 Stage 出现。
忽略 Join 类型和执行计划
不是所有 Join 类型都能使用 Broadcast Hash Join。没有等值条件时,Spark 可能选择 Broadcast Nested Loop Join,计算成本完全不同。
第四步:一个稳妥的使用流程
我会按下面的顺序:
- 先尽量过滤广播侧并裁剪无用字段
- 更新或检查表统计信息
- 用
EXPLAIN确认 Build Side 和 Join 策略 - 估算 Driver 与单 Executor 的内存开销
- 小流量验证广播时间、内存和任务稳定性
- 上线后监控广播大小、超时、GC 和 Executor Lost
如果数据大小经常跨越广播安全边界,优先让 AQE 和可靠统计参与决策,而不是长期写死 Hint。
一个典型场景
比如一张压缩后的维表文件看起来不大,开发者直接加了 BROADCAST Hint。
实际运行时,维表读取后包含多个宽字符串字段,内存中构建 Hash 表的体积远大于磁盘大小。Driver 可以完成广播,但多个 Executor 在并发 Task 下频繁 GC,最后出现 Executor Lost。
修复时先裁剪无关字段、过滤无效维度,再重新评估构建侧大小;如果仍超出安全范围,就恢复 Sort Merge Join,而不是继续加广播超时。
广播是否划算,取决于实际内存形态,不是文件列表里显示的大小。