Spark 为什么重视序列化?Java 和 Kryo 怎么选?
面试怎么回答
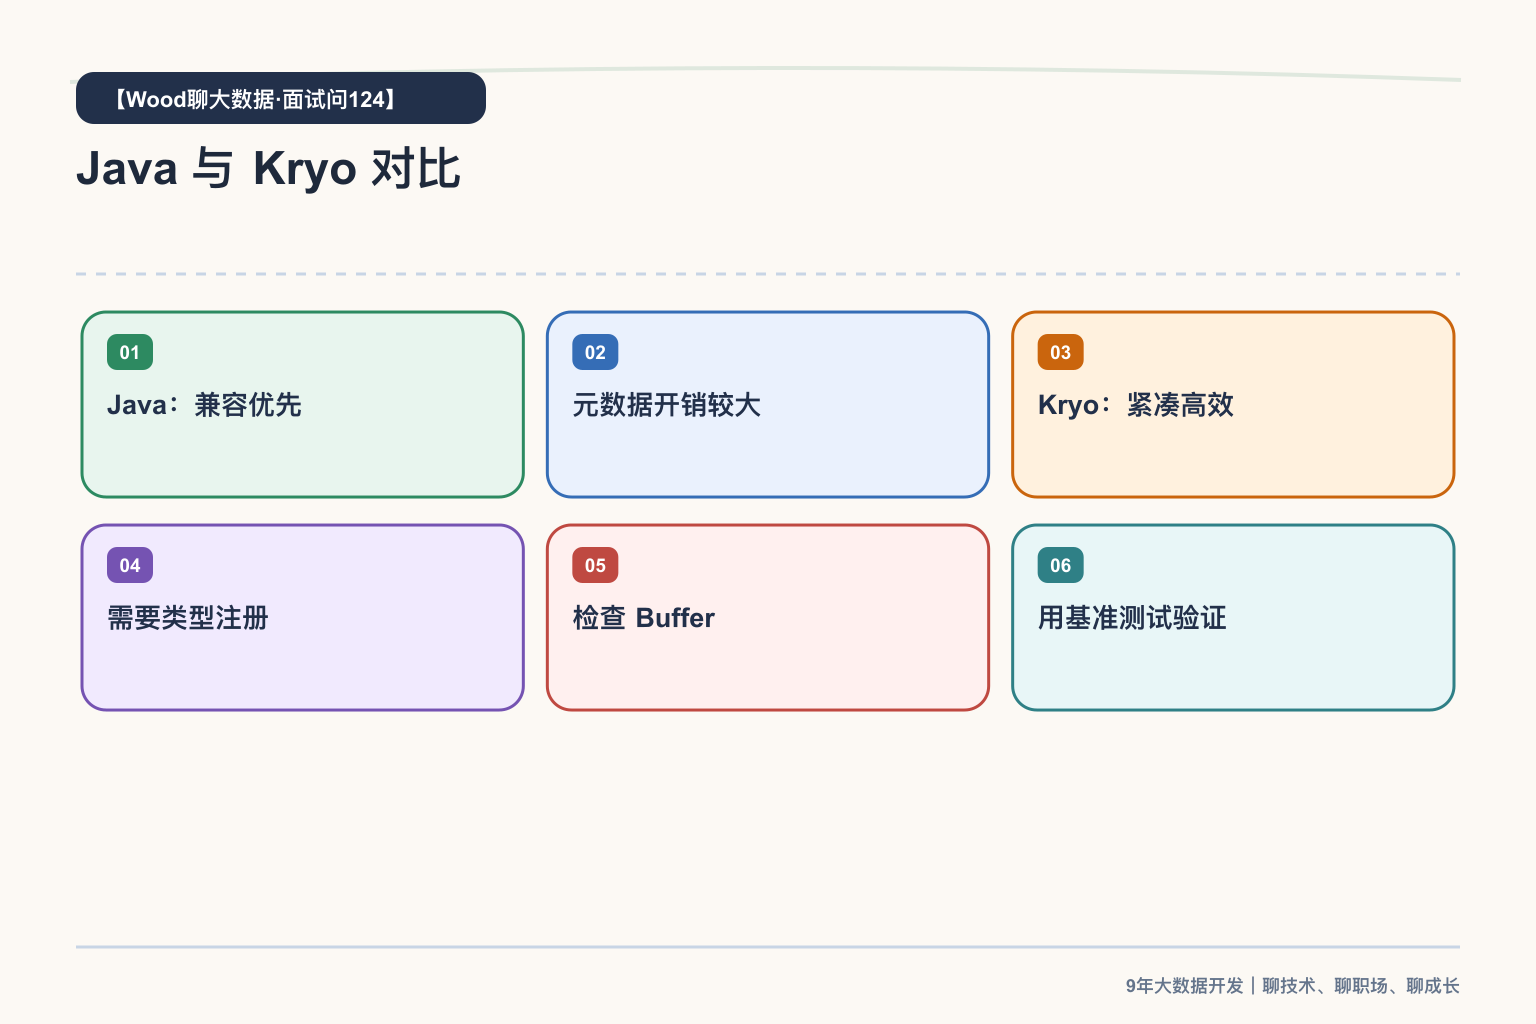
Spark 的 Shuffle、缓存、广播和闭包传输都会发生序列化。Java 序列化兼容性好但通常更慢更大;Kryo 通常更紧凑高效,但需要注册类型、验证类兼容并配置合理 buffer。我不会只改一个参数,而会先减少复杂对象、优先使用 DataFrame 和原生类型,再通过对象体积、GC、网络和端到端耗时验证收益。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
任务没有明显数据倾斜,CPU 和 GC 却很高,Shuffle 文件也比预期大。最后发现,时间都花在对象序列化、网络传输和反序列化上。
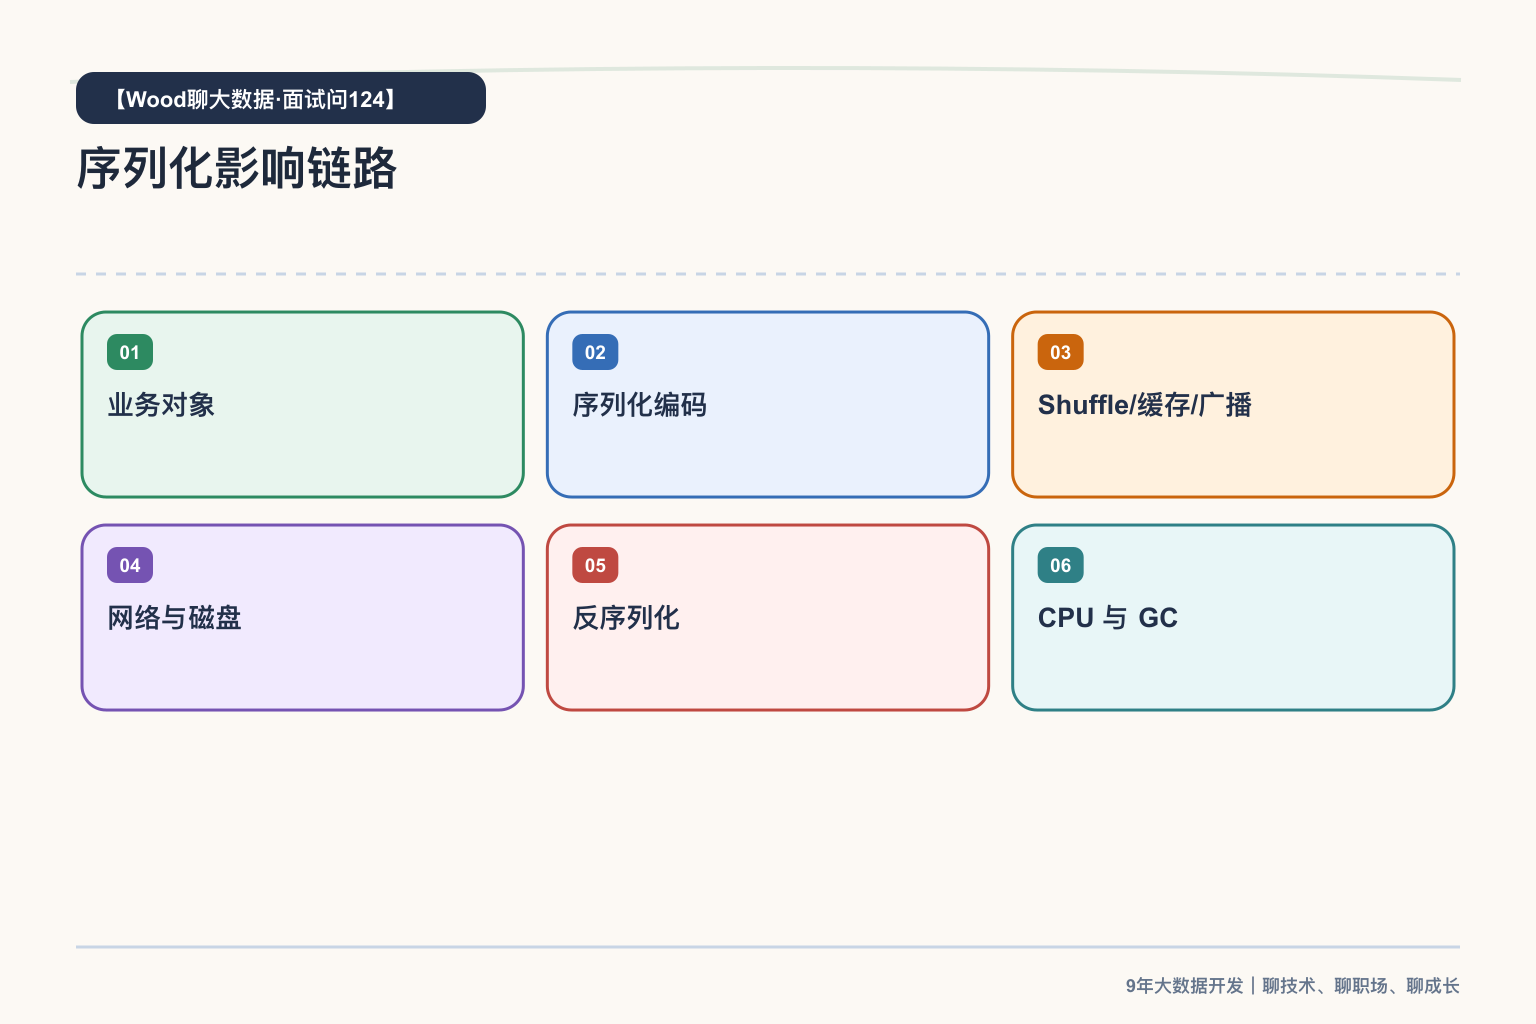
序列化不是一个孤立参数,它贯穿 Shuffle、缓存和网络通信。
Java 序列化换来兼容和易用,Kryo 通常换来更紧凑更快,但需要类型注册、兼容测试和容量配置。
序列化成本出现在哪里
Spark 需要在 Executor 间传输 Shuffle 数据、保存缓存块、发送闭包和广播变量。对象体积越大、编码越慢,网络、磁盘和 GC 压力越高。
Java 序列化的特点
Java 序列化通用、对普通 Serializable 对象友好,迁移成本低,但元数据和对象开销通常较大。它适合兼容优先或对象规模有限的场景。
Kryo 的收益和条件
Kryo 往往更快更紧凑,但自定义类型最好显式注册;还要关注 buffer 上限、类变更兼容和第三方对象是否可正确序列化。只改 serializer 配置不代表所有数据路径都受益。
优先优化数据表达
能使用 Spark SQL 内部格式、原生类型和紧凑 Schema 时,通常比把复杂 Java 对象塞进 RDD 更有效。序列化选择应结合对象大小、GC、Shuffle 和端到端基准测试。
为什么不能只回答概念?
“误区:配置 Kryo 后所有对象都会自动最优”之所以常见,是因为它在理想数据和单次执行里往往说得通。但生产环境会加入数据规模、异常值、并发、版本、失败重试和下游口径,这些条件一变化,只记住术语就很容易给出错误结论。
所以我会把 序列化成本出现在哪里、Java 序列化的特点、Kryo 的收益和条件、优先优化数据表达 串成一条完整链路。最终判断标准不是某个函数或配置是否出现,而是能否稳定得到可解释、可验证、可恢复的业务结果。
落地时我会检查什么?
- 输入边界:确认数据范围、时间口径、主键和异常值是否符合假设。
- 执行过程:观察分区、并行度、状态、Shuffle 或资源变化,验证方案是否真正生效。
- 输出结果:用行数、唯一性、关键指标和样本明细证明结果正确,而不是只看任务成功。
- 失败恢复:说明重跑、回滚、版本兼容和责任人,避免一次成功后无人维护。
这些检查不一定全部写进一条 SQL 或一个任务,但面试时能主动补充,说明你回答的不是背诵题,而是在描述一套可上线的工程方案。
一个典型场景
一个任务把深层嵌套业务对象缓存为 RDD,切换 Kryo 后速度有所提升,却因为未注册类和 buffer 不足间歇失败。后来将数据改成明确 Schema 的 DataFrame,只在必要边界保留自定义对象,序列化体积和故障率都更可控。
先减少复杂对象,再选择序列化器。