Spark 统一内存管理是怎么工作的?
面试怎么回答
Spark 把 Execution 和 Storage 放在统一区域 M 中弹性共享。Execution 用于 Join、Sort、Shuffle 和聚合,Storage 用于 Cache 与广播。Execution 内存不足时可以驱逐部分 Storage,但会保留受保护区域 R;Storage 不能驱逐正在使用的 Execution。统一管理能提高利用率,但仍可能出现 Spill、缓存重算、GC 或 memoryOverhead 超限,所以我会先用指标区分具体内存压力,再决定是否调参数。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
缓存已经占了很多 Executor 内存,新的 Shuffle 是不是一定会直接 OOM?
不一定。Spark 的 Execution 和 Storage 内存并不是完全固定切开的,它们可以在统一区域里弹性共享。
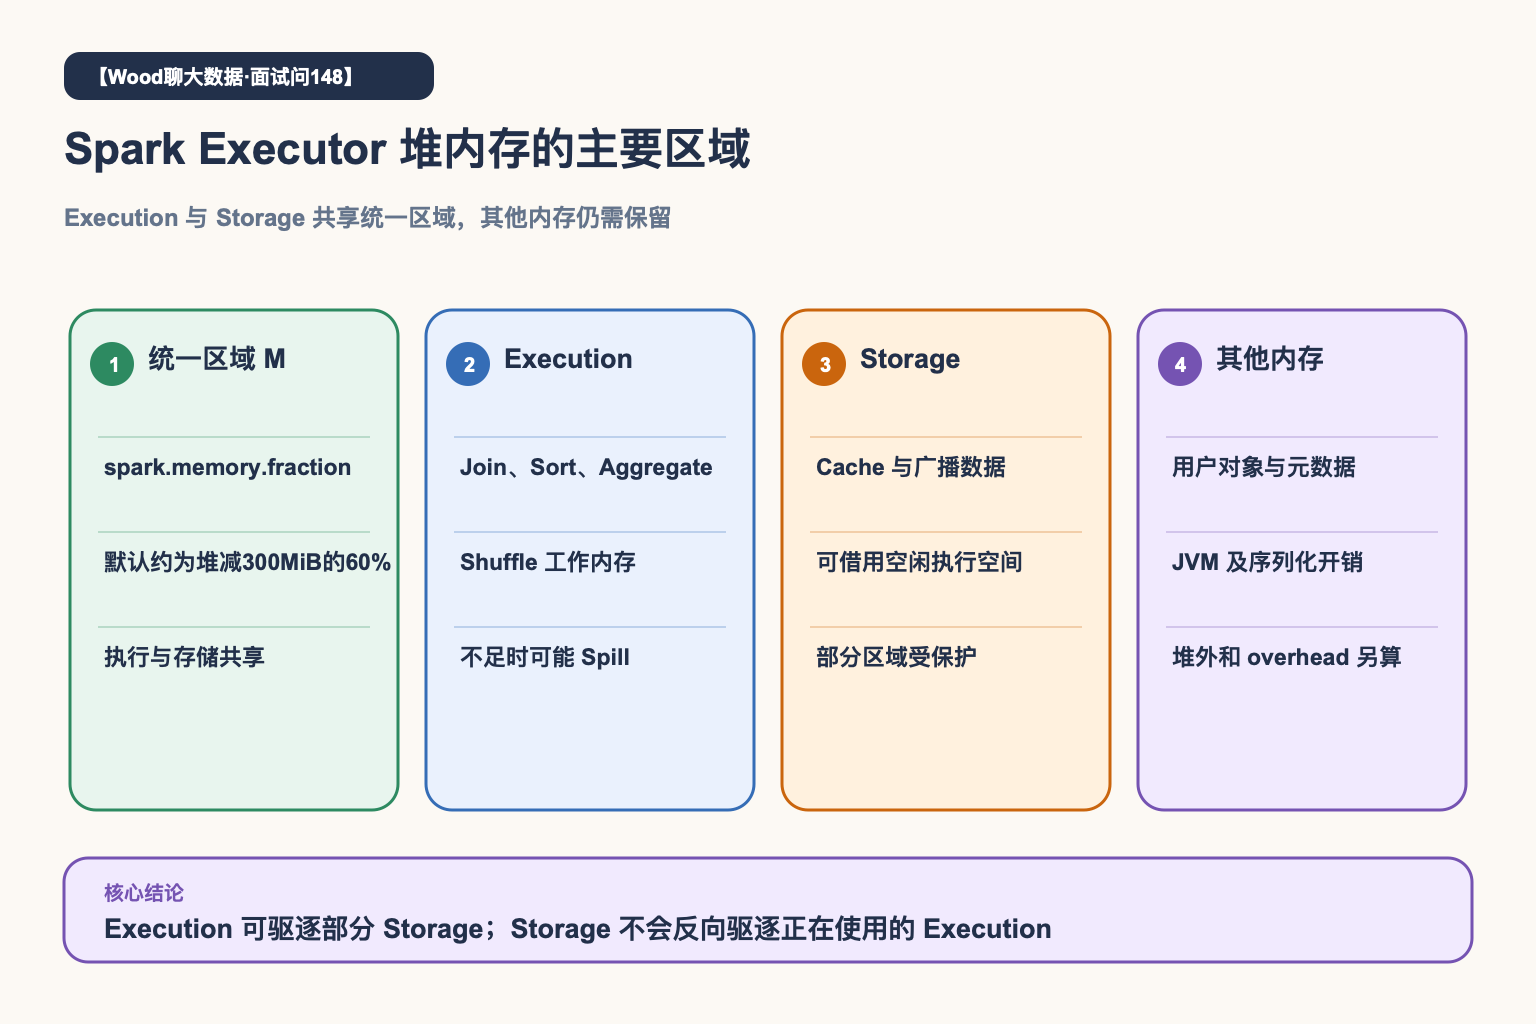
统一内存管理让执行和缓存共享内存区域,但执行可以驱逐部分缓存,缓存不能反向驱逐正在使用的执行内存。
先认识统一区域 M
当前 Spark 文档中,spark.memory.fraction 默认是 0.6,表示 Executor JVM heap 扣除约300MiB后,有一部分作为 Execution 与 Storage 的统一区域 M。
剩余堆空间用于用户数据结构、Spark 内部元数据和估算误差保护。不能把 Executor heap 全部都理解成可用于 Shuffle 或 Cache。
Execution 和 Storage 负责不同工作
Execution 用于 Shuffle、Join、Sort 和 Aggregate 等计算过程。Storage 用于缓存分区以及广播数据等存储需求。
当一侧空闲时,另一侧可以使用更多统一区域,因此没有大量缓存的任务可以把更多内存用于执行,减少不必要的 Spill。
共享不代表驱逐完全对称
Execution 需要内存时,可以驱逐 Storage 中可被驱逐的缓存块,但会保留一个受保护的 Storage 子区域 R。Storage 不会驱逐正在使用的 Execution 内存,因为执行过程的内存回收更复杂。
因此缓存可能突然被淘汰并重算,而 Shuffle 仍可能因为内存不足 Spill 到磁盘。
还有很多内存不在这张图里
Executor memoryOverhead、Python Worker、直接内存、序列化缓冲区、JVM 元空间和 RocksDB 等堆外组件,都不等于统一堆内存。
看到容器被系统杀掉时,不能只盯 spark.memory.fraction;看到 Full GC 时,也要检查对象结构、缓存方式和分区数据量。
一个典型场景
某任务把中间表全部 cache,后续大 Join 开始后缓存命中率迅速下降,部分分区被反复重算。第一反应是缓存失效,实际是 Execution 内存抢占了可驱逐的 Storage 区域。
删除无用缓存、减少单分区数据量后,重算和 Spill 同时下降。直接把 storageFraction 调大,反而可能压缩执行空间。
调内存参数之前,先判断压力来自执行、缓存、用户对象还是堆外。