Spark RDD、DataFrame 和 Dataset 有什么区别?
面试怎么回答
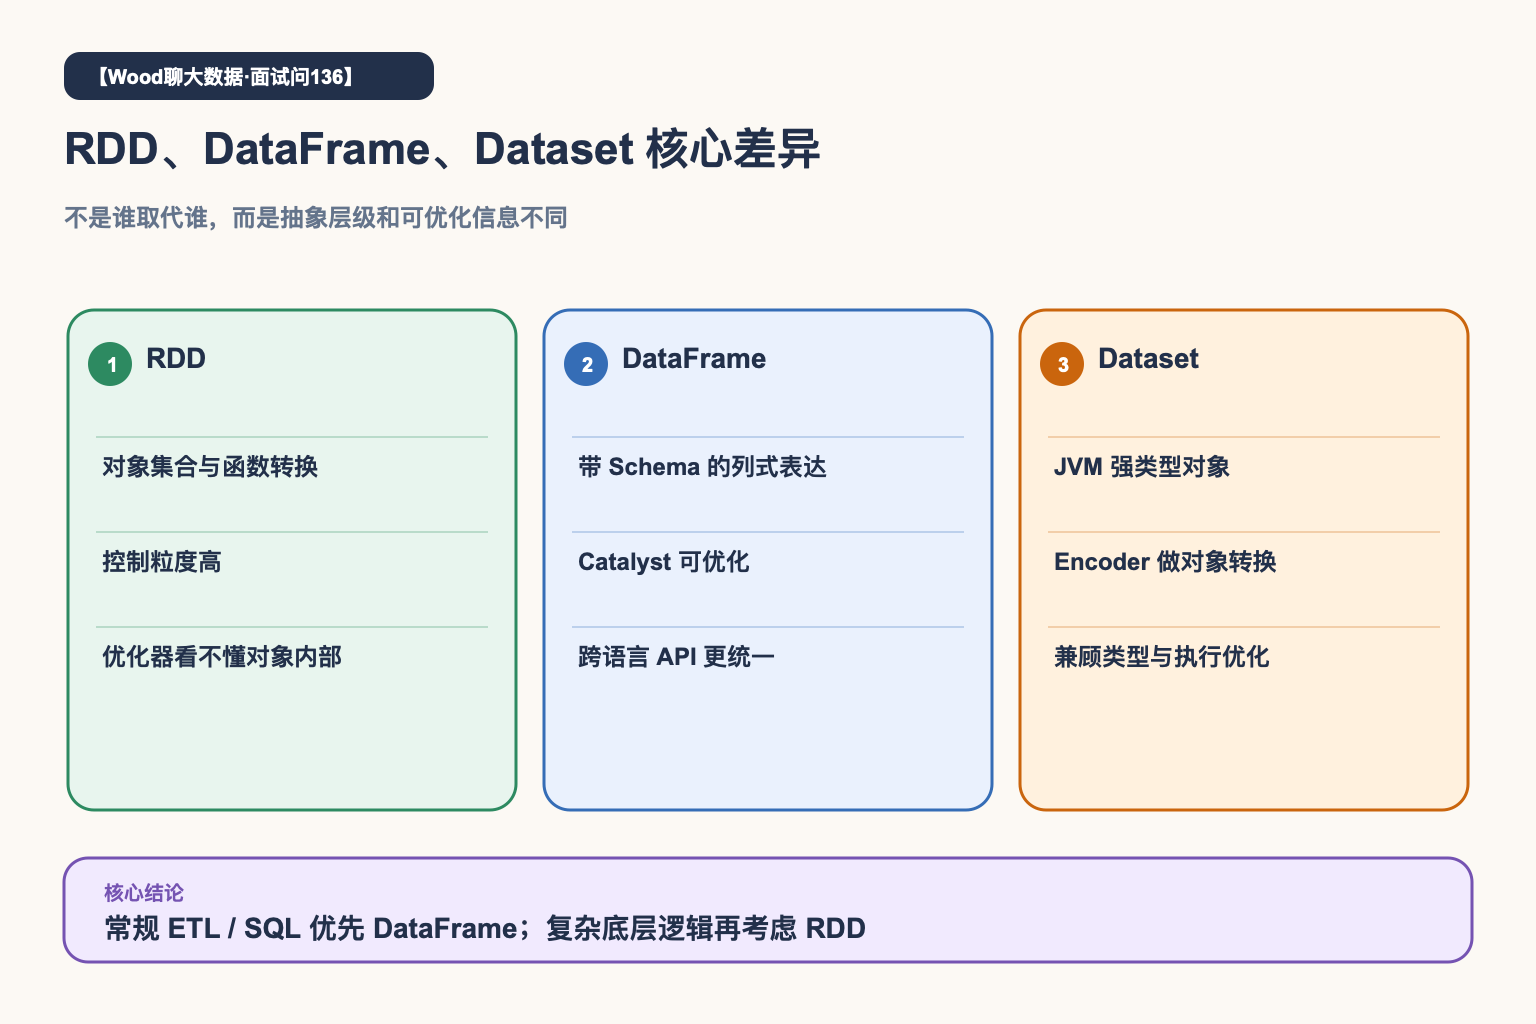
RDD 是底层容错分布式对象集合,控制灵活,但 Spark 对对象内部语义了解有限。DataFrame 带 Schema 和命名列,能够进入 Catalyst 优化,适合大多数 ETL 和 SQL 场景。Dataset 主要在 Scala、Java 中使用,通过 Encoder 同时提供类型化对象操作和结构化执行;DataFrame 可以理解为 Dataset
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
RDD、DataFrame 和 Dataset 都能完成 map、filter、聚合和 Join。既然结果相同,它们只是三套不同语法吗?
不是。真正的差别是数据有没有结构、Spark 能看到多少计算语义,以及编译期能提供多少类型约束。
RDD 更接近底层分布式对象集合,DataFrame 更强调结构化列和优化器,Dataset 则在 JVM 语言中把强类型对象与结构化执行结合起来。
RDD:控制灵活,但优化信息有限
RDD 是分区在集群上的容错数据集合,提供 map、flatMap、reduceByKey 等函数式转换,也允许开发者控制分区和自定义对象逻辑。
问题在于,普通对象内部对 Spark 来说比较“黑盒”。优化器很难像处理 SQL 表达式一样做列裁剪、谓词下推和表达式重写,序列化开销也需要开发者自己关注。
DataFrame:把计算表达成结构化计划
DataFrame 有明确 Schema 和命名列。select、filter、join 等操作会形成逻辑计划,由 Catalyst 优化后再生成物理计划。
因为 Spark 知道字段、类型和表达式,才有机会做列裁剪、谓词下推、Join 策略选择和代码生成。对于常规 ETL、报表计算和 SQL 分析,DataFrame 通常是默认选择。
Dataset:类型约束与结构化执行结合
Dataset 使用 Encoder 在 JVM 对象与 Spark 内部表示之间转换,可以使用类型化的 map、flatMap,也能进入 Catalyst 优化的结构化执行体系。
在 Scala 和 Java 中,DataFrame 本质上可以看成 Dataset
选型要看表达方式,而不是只看性能标签
如果逻辑可以用内置列函数和 SQL 表达,优先 DataFrame 或 Dataset。它们不仅可能更快,也更容易查看执行计划和做跨团队维护。
只有在需要非常底层的分区控制、处理难以结构化的对象或依赖特定 RDD API 时,再下沉到 RDD。即使使用 DataFrame,如果大量逻辑塞进黑盒 UDF,优化器同样很难看透。
一个典型场景
一段清洗逻辑从 RDD 改写成 DataFrame 后仍然没有明显提升。排查发现,所有字段处理都被封装在一个返回复杂对象的 UDF 中,Spark 无法把过滤条件下推,也无法裁掉无用列。
把常用逻辑拆回内置表达式后,执行计划才真正发生变化。
API 名称不是优化保证,关键是有没有把语义暴露给执行引擎。