Spark 推测执行什么时候开?有哪些坑?
面试怎么回答
Spark 推测执行会为异常慢的 Task 启动副本,先完成的结果生效,适合节点抖动、偶发 GC 等少量拖尾。我会先比较输入量、运行时间和处理速率,排除数据倾斜与整体资源不足。开启后还要控制触发比例和慢速阈值,并确认输出与外部副作用幂等,否则重复 Task 可能造成重复写入或加剧资源竞争。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一个 Spark Stage 已经完成了绝大多数 Task,却被最后一个慢 Task 拖了很久。
有人建议立刻打开推测执行,也有人担心它会让集群更忙。
这时真正要回答的问题是:Spark 推测执行什么时候开?它能解决什么,又会带来哪些坑?
推测执行会为疑似异常慢的 Task 启动一个重复副本,两个实例谁先成功就采用谁的结果。
但它只适合解决少数机器或 Task 偶发变慢,不能替代数据倾斜、资源不足和代码问题的根因治理。
先判断是不是“异常慢”
一个 Task 慢,可能有两类原因。
偶发拖尾
- 某台机器磁盘或网络抖动
- Executor 短时 GC
- 宿主机资源争抢
- 个别 Task 运行速度明显偏离同批任务
这类问题换一个 Executor 重跑,有机会更快完成,适合推测执行。
确定性慢
- 某个分区数据量特别大
- SQL 逻辑本身复杂
- 所有 Task 都因资源不足变慢
- 外部存储整体限流
这类问题启动重复 Task,只会让同一份大数据再算一次,进一步争抢资源。
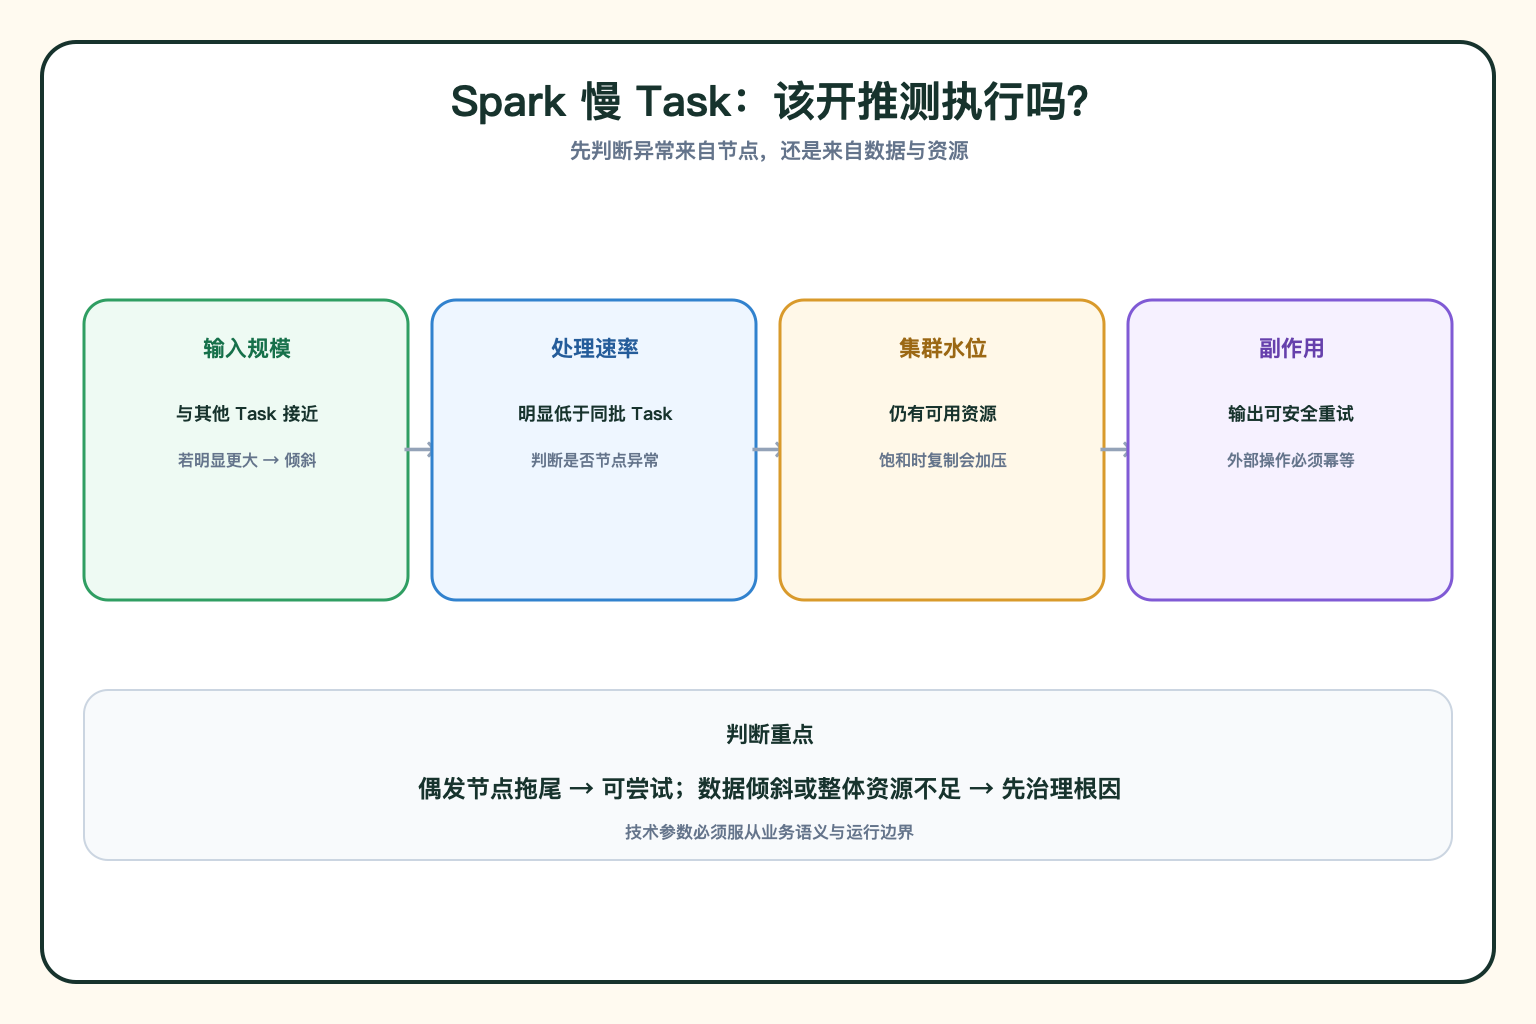
它是怎么判断慢 Task 的?
Spark 不会在 Task 一变慢时就复制,而是综合判断:
- 已完成 Task 是否达到一定比例
- 当前 Task 是否运行了足够长时间
- 它比同 Stage 其他 Task 慢多少
- 当前处理速率是否明显偏低
相关参数包括 spark.speculation、spark.speculation.quantile、spark.speculation.multiplier 和最小运行时间等。
参数过敏,会产生大量重复任务;参数太保守,又可能等到接近结束才触发。
生产里常见的三个坑
坑一:把数据倾斜当机器故障
如果慢 Task 对应的输入远大于其他分区,副本仍要处理同样的数据。应优先处理 Key 倾斜和分区设计。
坑二:重复执行外部副作用
如果 Task 内直接调用外部接口、写非幂等数据库或发送消息,两个副本可能产生重复副作用。使用推测执行前,要确认写出协议和外部操作可以安全重试。
坑三:资源紧张时继续加压
集群本来已经 CPU、内存或 IO 饱和,再启动副本可能让正常 Task 也变慢。
一个典型场景
比如一个 Stage 有 500 个 Task,其中 499 个在相近时间完成,最后一个输入规模并不大,却因所在节点磁盘异常持续拖尾。
这种情况下,把它重新调度到其他节点可能明显缩短尾部时间。
但如果最后一个 Task 的输入是其他分区的几十倍,那么推测副本不会改变输入规模。正确动作是定位倾斜 Key、拆分热点或调整分区。
先判断慢来自“节点”,还是来自“数据”。