Spark 流任务改了代码,旧 Checkpoint 还能接着用吗?
面试怎么回答
我会把变更拆成输入、状态算子和输出三类,按当前Spark版本检查同一Checkpoint允许的变化。分组键和状态结构变化不能默认复用;即使某个过滤变更允许恢复,也不代表旧状态已经按新规则重算。不兼容时设计新查询和状态重建,明确回放范围、输出隔离、幂等及切换点,并验证可回退,不能通过删除Checkpoint绕过问题。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一次需求只是多加了一个分组字段。发布后任务无法从旧目录恢复,有人建议“把Checkpoint删掉再启动”。任务也许能启动,但之前积累的状态和消费进度又该怎么算?
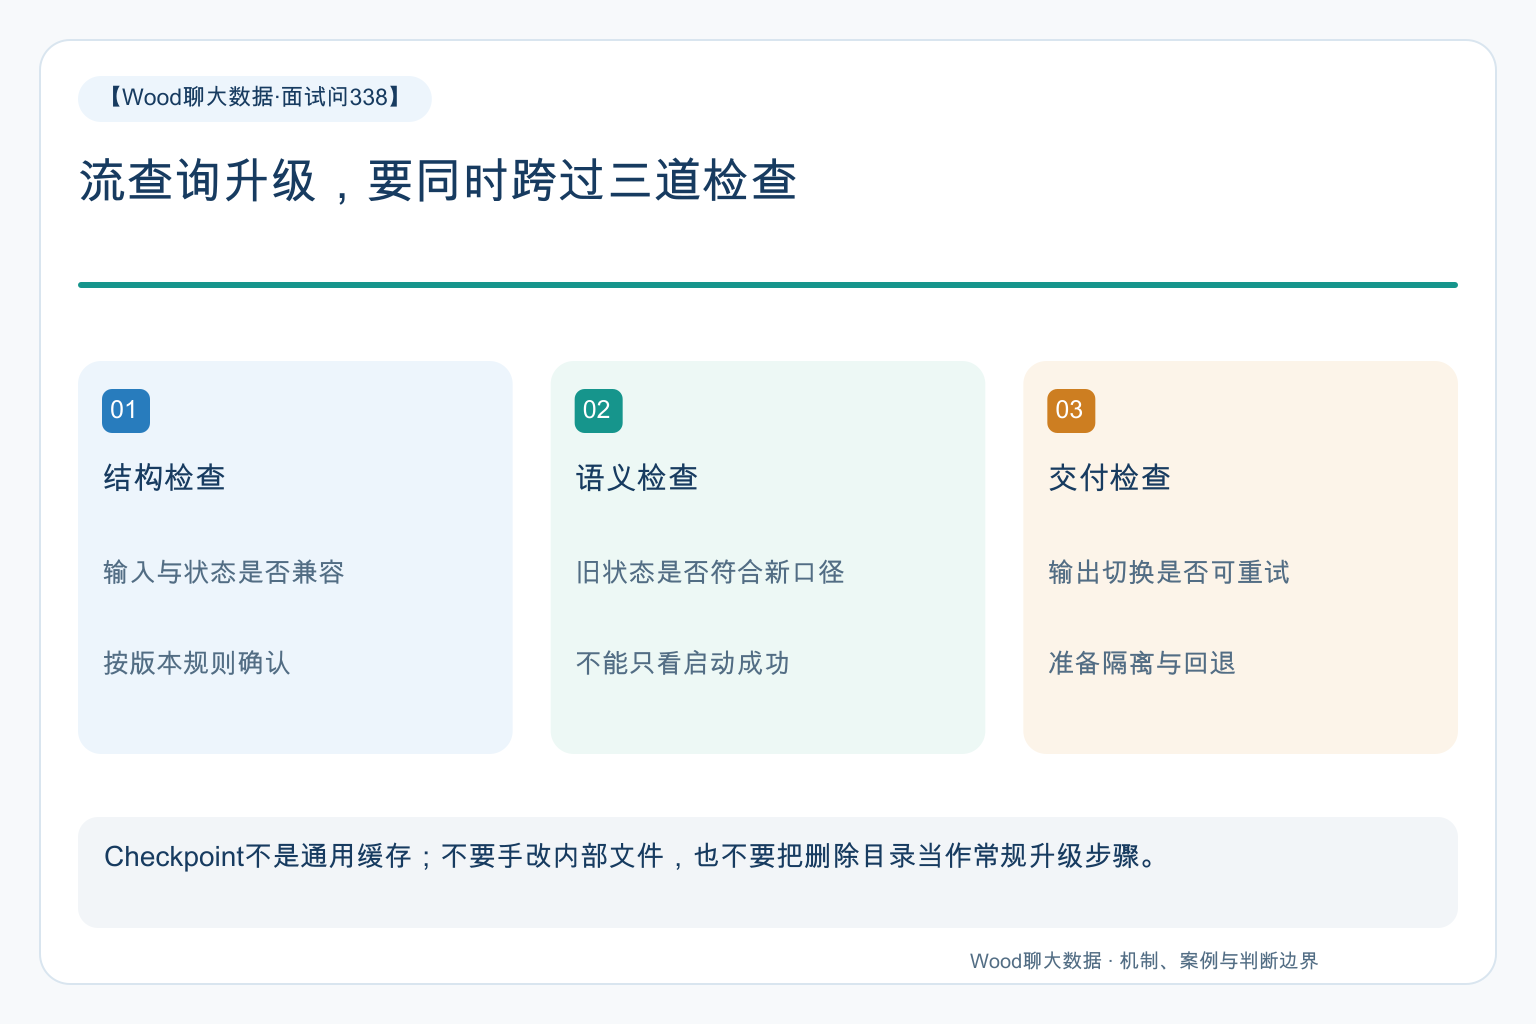
Checkpoint属于具体流查询的进度和状态契约;升级既要检查结构兼容,也要检查新逻辑能否延续旧结果的业务含义。
它保存的不只是“上次读到哪里”
Structured Streaming的Checkpoint还关联查询的进度、状态等恢复信息。对有状态聚合来说,旧结果是此前输入经过旧逻辑积累出的状态,而不是一份可随意套到新程序的原始明细。
所以“同一条业务链路”不一定等于“可以沿用同一个Checkpoint”。输入源数量、类型、状态算子结构和输出方式的变化,都需要逐项判断。
本文以Spark 4.0.1官方规则为讨论范围。不同版本及新旧状态接口可能有额外迁移能力,不能把某个版本的限制或允许项泛化到所有环境。
先区分结构兼容与业务语义兼容
官方文档列出了可以、不可或需按情况判断的变更。例如输入源数量或类型变化不能按普通续跑处理;部分限流参数和过滤修改允许,但仍需评估语义。
对流式聚合,分组键和聚合状态变化必须重点检查。原先按用户计数,改成按用户与渠道计数,旧状态里没有渠道拆分信息,不能凭空从一个总数恢复出各渠道的历史数量。
还有一种更隐蔽的情况:过滤条件调整后程序可以恢复,旧状态却仍含被新规则排除的历史记录。新规则从接下来的输入生效,不代表过去的累计结果已经自动重算。
不兼容时,先设计迁移,再决定目录
新建Checkpoint意味着要明确新查询从何处开始、如何重建必要状态,而不是认为它天然继承旧查询的一切。
若从较晚位点开始,窗口或累计状态可能缺少历史;若从更早位置回放,又可能重复输出。数据源的日志保留、可回放范围和目标端幂等能力,必须放在同一个迁移计划里。
可以选择新查询写入隔离目标,完成回放与对账后切换消费入口。并行观察也有资源和外部调用成本,不应让新旧查询无保护地向同一目标追加相同结果。
不要手动改Checkpoint里的内部文件来“对齐版本”。这种方式难以证明一致性,也会让原本可用的恢复证据失去可信度。
一个典型场景:过滤规则升级后历史人数没降下来
假设业务要求从累计用户数中排除测试账号。任务加了过滤后正常恢复,新事件也被正确过滤,但历史累计仍偏高。
最初以为新包没有生效,排查发现日志和后续数据都符合新逻辑。根因是旧状态里已经存在测试账号的历史贡献,过滤后续输入无法自动撤销它们。
原发布验收只看任务运行和当前样本,没有验证历史状态。修正需要选择可证明的状态重建或业务修正方案,并在隔离输出中对比目标口径,不能反复重启期待旧状态消失。
这个场景说明:技术上允许恢复与业务上允许续用,是两份不同的检查单。
验收要包括失败之后会发生什么
测试应在受控环境使用允许的状态副本与隔离输出,覆盖正常重启、回放中失败、输出成功但批次确认前失败等边界。不能把实验直接落在唯一生产恢复目录上。
记录代码版本、状态来源、数据边界和输出版本,比较代表性键的累计值、窗口结果和重复写入情况。对账要用相同输入范围,不要拿不同处理进度的两个任务直接比较。
回退也不只是换回旧代码。如果新程序已经改变了外部输出,旧程序回滚可能继续写入混合口径的数据。应明确入口切换、目标隔离与数据回退责任。
面试时最有价值的判断是:先说明缺了什么历史信息,再选择重建或迁移方法,而不是把启动成功当作整次发布成功。