Spark 任务 OOM,你怎么排查?
面试怎么回答
我会先从日志确认 OOM 在 Driver、Executor 还是 Memory Overhead,并定位 Stage 和 Task。再看 Spark UI 数据量分布、Shuffle、GC、Spill 和广播大小,判断是整体资源不足,还是倾斜、单分区过大或 Cache 导致。处理时先减少数据、修正 Join 与分区、清理缓存,再按指标调整 Memory、Overhead、Core 和并行度,最后对比峰值内存与 Task 分布验证效果。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人的第一反应是:
“把 Executor Memory 调大一点。”
有时确实能暂时跑过去,但 OOM 不是一个统一问题。Driver、Executor、堆内、堆外和单个 Task 爆内存,原因完全不同。
真正有效的排查顺序是:
先定位谁爆了,再判断什么占满了内存,最后决定改数据、改执行计划,还是补资源。
第一步:先判断 OOM 发生在哪里
不要只看任务最终状态,要先看 Driver 和 Executor 日志里的第一条真实错误。
Driver OOM
常见原因包括:
collect、toPandas把大量数据拉回 Driver- 广播表实际比预估大
- 文件和分区过多,Driver 维护的任务元数据过大
- 查询结果或日志在 Driver 侧持续累积
Executor OOM
常见原因包括:
- 单个分区数据量过大
- 聚合、排序、Join 的执行内存不足
- Cache 占用过多存储内存
- UDF 创建大量对象,序列化开销过高
- 单个 Executor 同时运行太多 Task
内存开销或容器被杀
如果日志是 Memory Overhead Exceeded、容器被 YARN 或 Kubernetes 杀掉,还要继续区分堆外内存、Python Worker、直接内存和容器总内存,而不是只调整 JVM Heap。
第二步:判断是整体不够,还是局部撑爆
这是最关键的一步。
如果所有 Executor 都在高 GC、频繁 Spill,可能是整体内存和并行度不合理。
如果总是少数 Executor、少数 Task 失败,尤其是 Reduce Stage 某个 Task 远大于其他 Task,更像是数据倾斜或单分区过大。
我一般会在 Spark UI 重点看:
- 失败发生在哪个 Stage、哪个算子
- Task 的 Input、Shuffle Read、Peak Memory 和运行时长分布
- 是否只有个别 Task 明显异常
- GC Time 是否持续偏高
- Spill 到内存和磁盘的数据量
- 是否有大表被错误广播
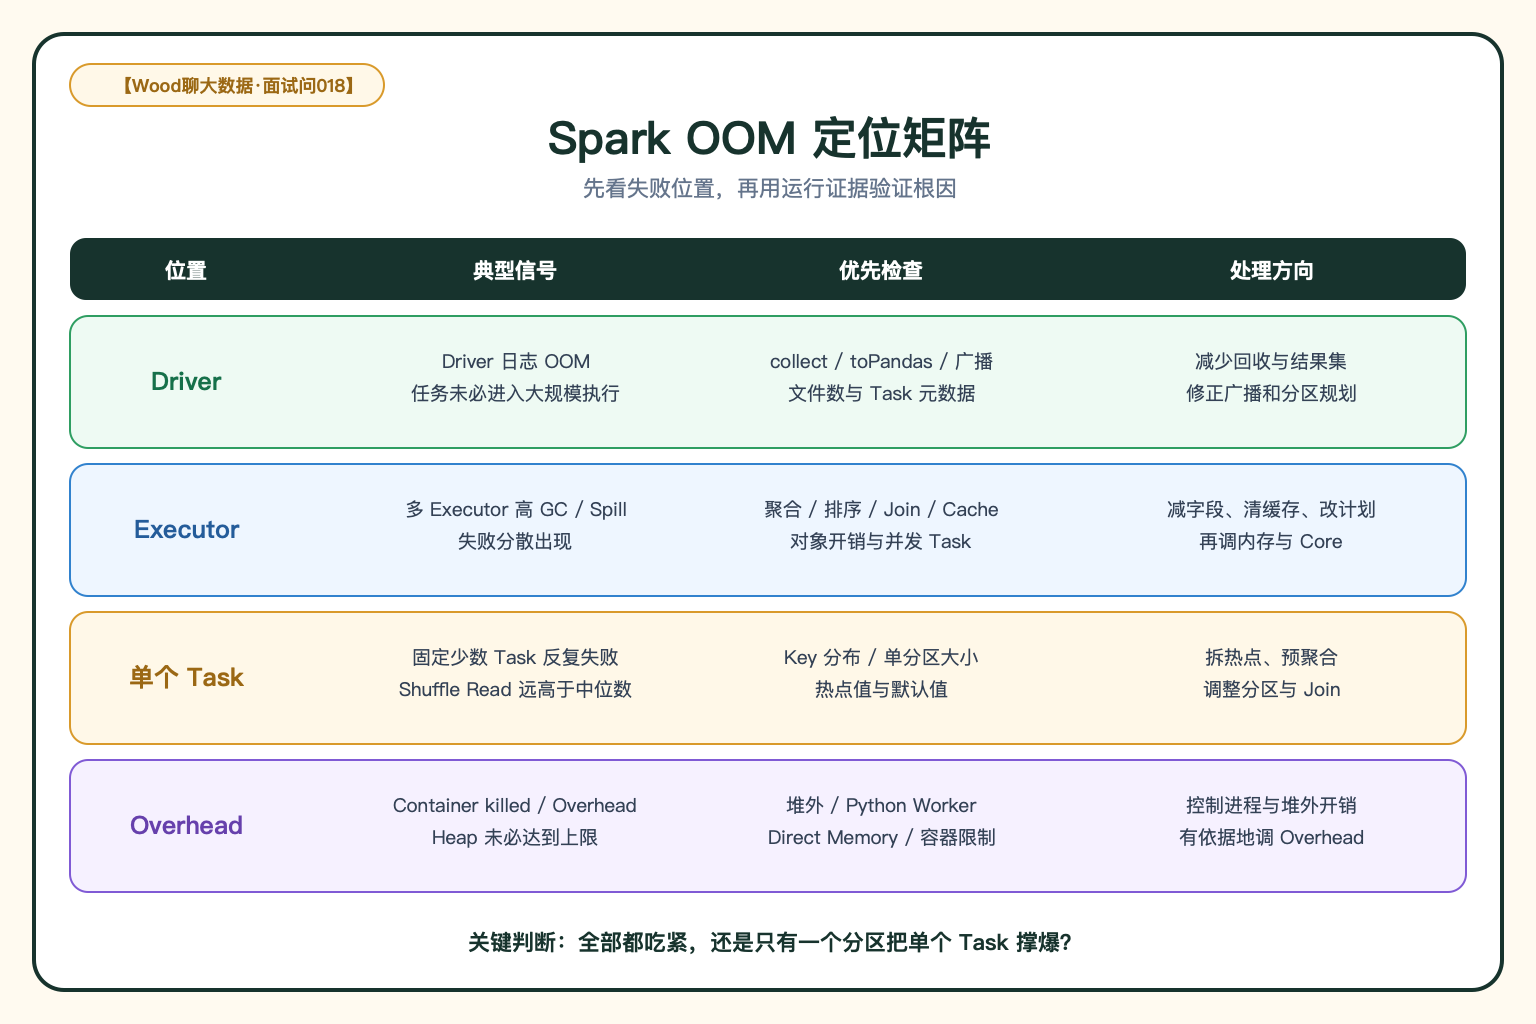
第三步:按原因处理,不要先堆资源
Driver 拉取过多数据
避免对大结果集使用 collect;能在 Executor 侧聚合、过滤和落盘,就不要把明细拉回 Driver。广播前也要验证真实大小,而不是只看表的历史统计信息。
单分区过大或数据倾斜
先看分区数据量和 Key 分布,再考虑增加 Shuffle 分区、拆分热点 Key、预聚合或调整 Join 策略。
仅增加 Executor 数量,不会自动拆开已经落到同一个 Task 的热点数据。
Cache 占满内存
检查缓存是否真的被复用,选择合适的持久化级别,不再使用的数据及时 unpersist。不要因为“后面可能用到”就缓存整个宽表。
对象和并发开销过高
减少不必要的宽字段和对象创建,优先使用 Spark SQL 内置表达式;同时检查 Executor Core 数。一个 Executor 并发 Task 越多,执行内存也会被更多 Task 共同竞争。
资源确实不足
在数据分布和执行计划合理后,再调整 Executor Memory、Memory Overhead、Core 数和实例数。资源调整应该有指标依据,而不是反复试一个更大的数字。
一个典型场景
比如一个订单明细和用户标签的 Join,在 Reduce Stage 总是同一个 Executor OOM。
表面看像 Executor 内存不足,但 Spark UI 里只有一个 Task 的 Shuffle Read 是其他 Task 的几十倍。继续加 Executor Memory,只是让它晚一点失败。
进一步检查发现,空用户 ID 被统一填成了同一个默认值,所有异常订单都进入同一个分区。
最终做法是先单独处理空 Key,再对热点数据拆分,并合理增加 Shuffle 分区。
OOM 的直接表现是内存不够,真正的根因却可能是数据分布出了问题。