Spark 的 map 和 mapPartitions 有什么区别?
面试怎么回答
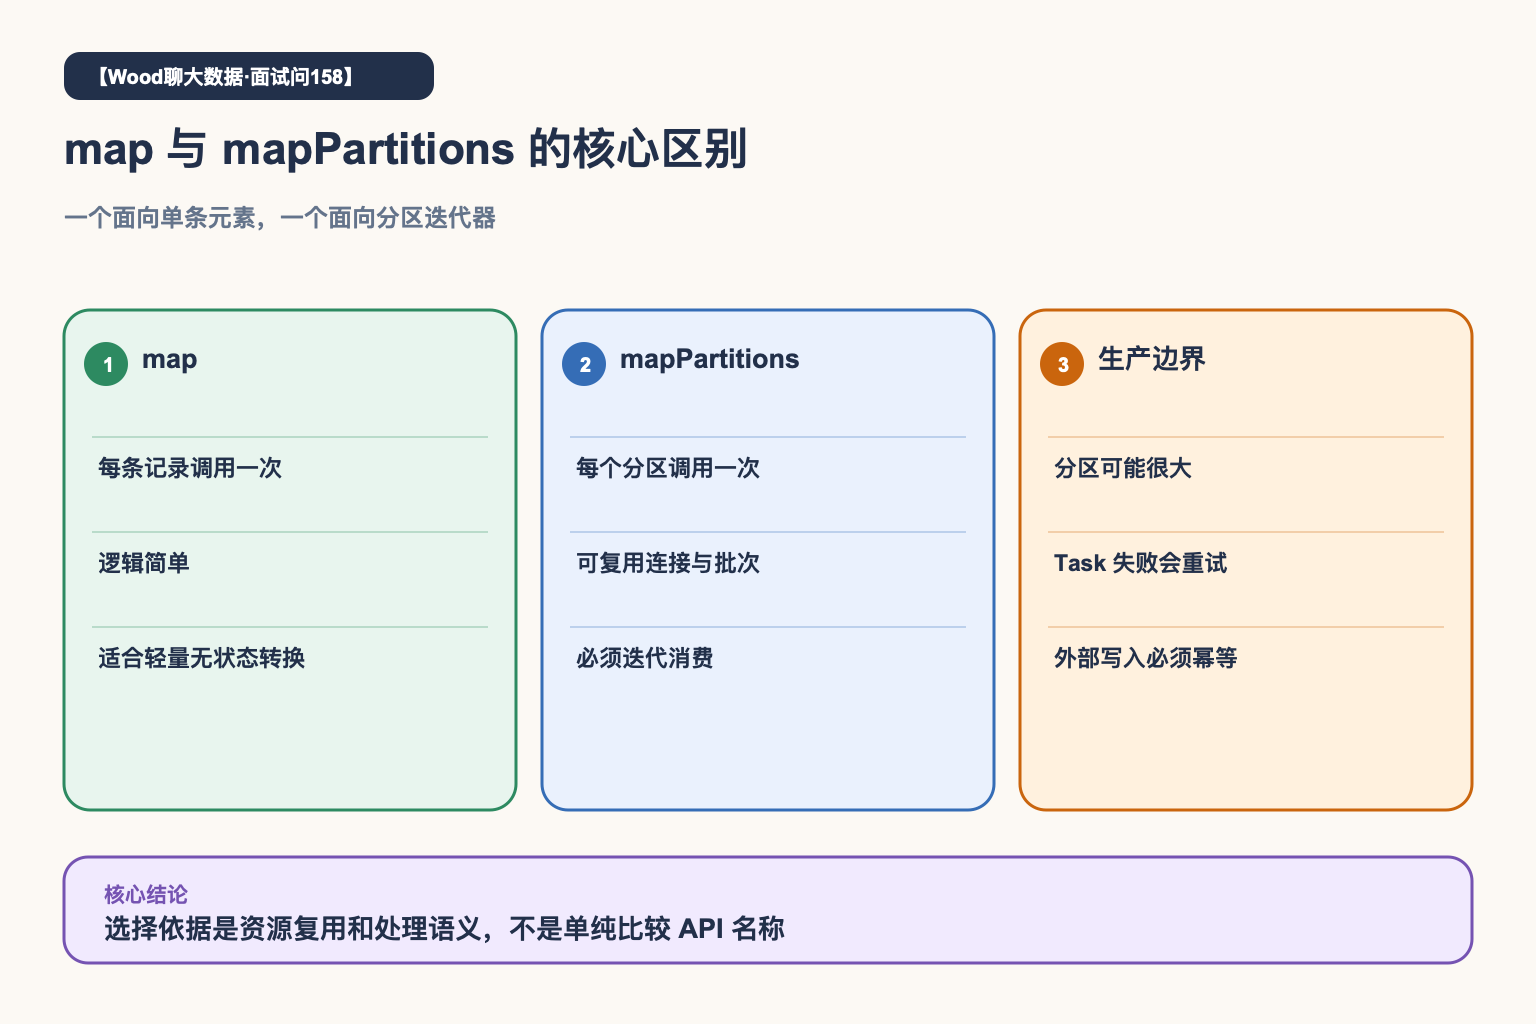
map 是逐条调用函数,适合轻量无状态转换;mapPartitions 是每个分区调用一次,输入是迭代器,适合复用数据库连接、客户端或模型,并进行批处理。但不能把整个分区直接收集到内存,还要正确关闭资源、限制并发,并考虑 Task 重试带来的重复写入。选择它的核心是资源复用和批处理语义,而不是认为它一定更快。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
“mapPartitions 一定比 map 快”听起来很合理。
但如果把一个分区全部放进内存,任务可能更快地 OOM。
map 按元素调用函数,mapPartitions 按分区处理迭代器。后者的核心价值是复用昂贵资源,不是一次性加载整个分区。
map:一条记录调用一次
map 的函数输入是一条记录,输出一条转换结果。它的语义直接,适合字段转换、简单计算和不需要共享外部资源的逻辑。
如果每条记录都在函数里创建数据库连接、HTTP 客户端或模型对象,初始化成本就会被重复放大。
mapPartitions:一个分区调用一次
mapPartitions 的输入是当前分区的迭代器,函数可以在分区开始时初始化资源,然后处理多条记录,最后统一关闭。
常见场景包括:批量访问外部服务、复用序列化器、加载一次模型、按批次写入数据库。
不要把迭代器直接转成集合
mapPartitions 不代表分区数据已经安全放进内存。输入通常是惰性迭代器,应该边读边处理或按受控批次处理。
如果直接调用 toList、toArray 收集整个分区,分区稍大就会占满 Executor 内存。尤其在数据倾斜时,平均分区大小不能代表最大分区。
外部资源必须正确关闭
连接和客户端最好在分区级创建,并通过 try/finally 或框架提供的资源管理方式关闭。
还要控制每个 Executor 的总并发。一个 Executor 同时运行多个 Task,意味着可能同时创建多个连接;如果下游连接池容量有限,分区级复用也可能把下游压垮。
Task 重试会放大副作用
Spark Task 失败后可能重试,同一个分区的写入逻辑可能再次执行。
因此,用 mapPartitions 写外部系统时必须考虑幂等键、事务边界、批量失败重试和部分成功。不能因为函数只调用一次,就假设业务只执行一次。
一个典型场景
某任务使用 map 每条记录创建一次 JDBC 连接,吞吐很低。改成 mapPartitions 后连接次数下降,但批次设置过大,单次事务时间过长,失败重试成本反而上升。
最终通过分区级连接复用、受控小批次提交和幂等写入,才同时解决性能与稳定性。