Spark Cache 和 Persist 有什么区别?
面试怎么回答
以 RDD 为例,cache() 是使用默认存储级别的 persist() 简写,persist() 可以显式选择内存、磁盘、序列化或副本策略。我不会见到复用就直接缓存,而会看重复次数、上游重算成本、数据规模和集群内存。缓存后还要观察命中率、GC 和淘汰情况,最后及时 unpersist()。它解决的是重复计算性能,不等同于 Checkpoint。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人只会回答:
“cache() 放内存,persist() 可以选择内存或磁盘。”
以 RDD 为例,cache() 本质上是使用默认存储级别的 persist() 简写;真正重要的不是 API 名字,而是缓存是否值得、存储级别是否合适、生命周期有没有控制。
缓存不是越多越快,而是用存储空间换掉值得避免的重复计算。
第一点:两者的核心能力相同
RDD 的 cache() 相当于使用默认 StorageLevel 调用 persist()。
persist() 的区别是可以显式选择存储级别,例如:
MEMORY_ONLY:只保存在内存,放不下的分区需要重新计算MEMORY_AND_DISK:内存放不下时落盘- 序列化存储:降低内存占用,但增加序列化和反序列化成本
- 带副本的存储级别:提高可用性,但占用更多资源
需要注意,RDD、DataFrame 和不同语言 API 的默认级别可能不同。面试里最好先说明讨论对象,不要把所有 cache() 都概括成完全相同的行为。
第二点:先判断是否值得缓存
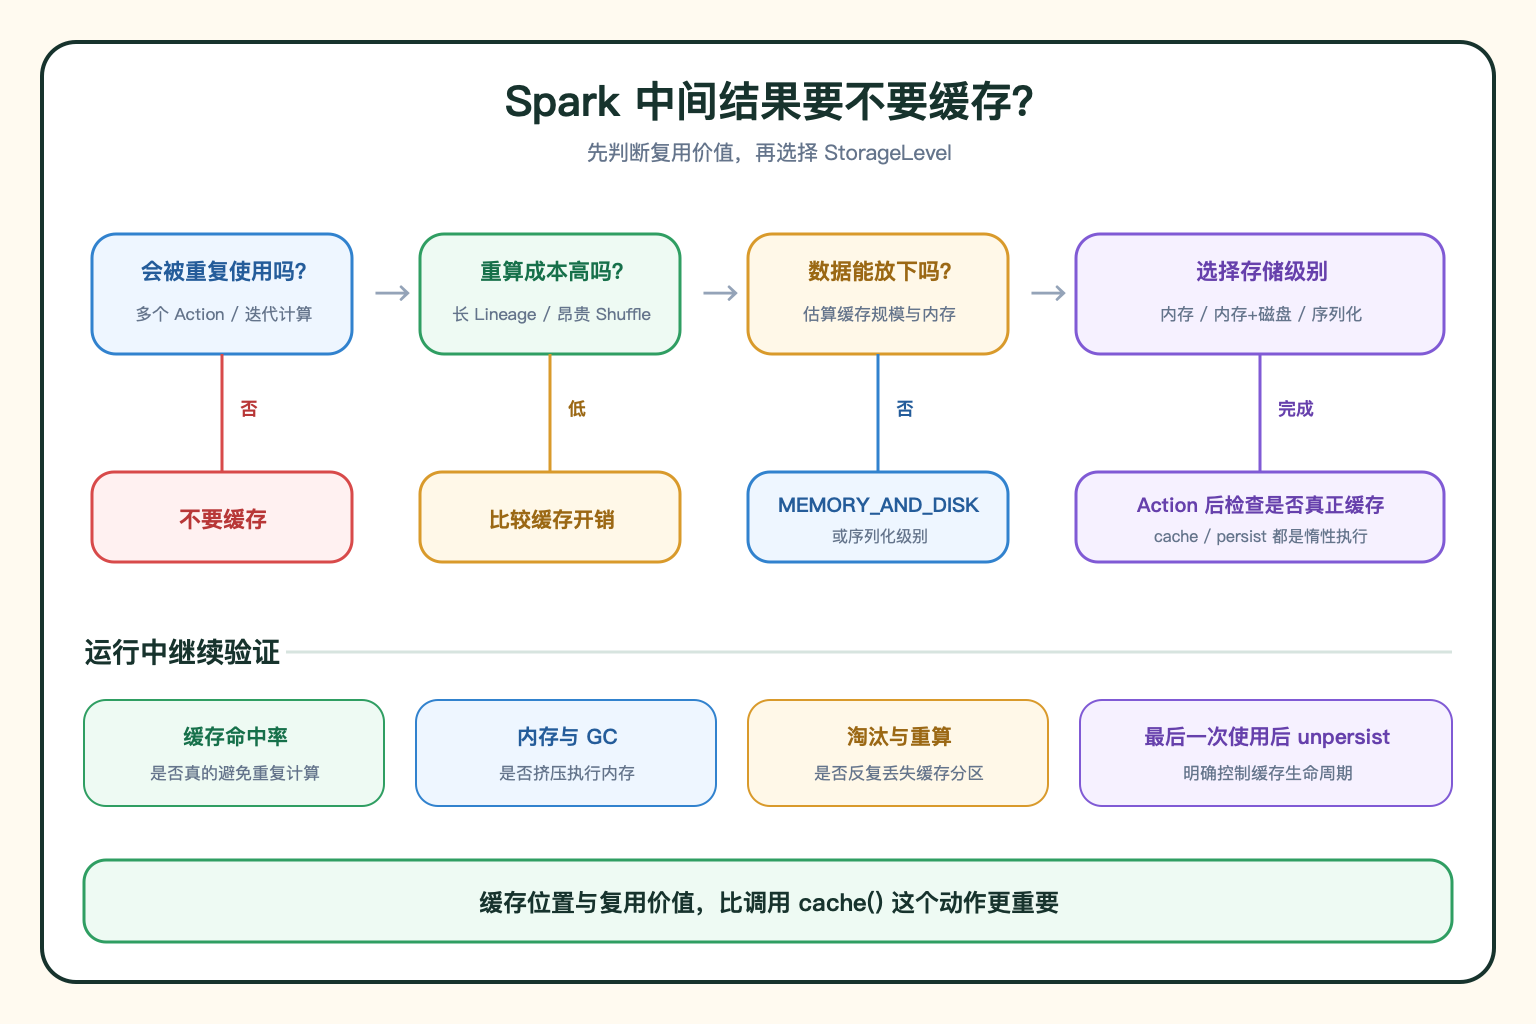
通常满足这些条件才值得考虑:
- 同一个中间结果会被重复使用
- 上游计算链路很长或成本很高
- 迭代算法会多次扫描同一份数据
- 缓存后的数据规模与集群资源匹配
如果一个 RDD 只用一次,缓存只会增加写入、内存管理和淘汰成本。
另外,cache() 和 persist() 都是惰性的,只有 Action 真正执行后,计算结果才会逐步写入缓存。
第三点:按数据规模选择存储级别
内存充足、重算便宜时,可以使用 MEMORY_ONLY。
数据可能放不下、但重算代价高时,MEMORY_AND_DISK 往往更稳妥。序列化级别能减少空间,却会增加 CPU 成本。
选择时要一起看:
- 缓存命中率
- Executor 内存压力与 GC
- 被淘汰分区的重算成本
- 磁盘读写是否成为新瓶颈
只看到 Storage 页面里“缓存成功”,不代表整体任务一定更快。
第四点:及时释放,不把缓存当 Checkpoint
中间结果不再使用时,应调用 unpersist() 释放资源,尤其是长时间运行或多个作业共享集群时。
缓存的数据丢失后,Spark 通常可以根据 Lineage 重新计算。它主要解决重复计算性能问题,不等同于切断血缘和可靠持久化的 Checkpoint。
一个典型反例
比如一个任务读取大表后做多次聚合。为了“加速”,一开始就把未过滤的原始 RDD 全量缓存。
结果原始数据占满 Executor 内存,真正被反复复用的聚合中间结果反而频繁被淘汰,GC 和重算都增加。
更合理的做法是先过滤和裁剪字段,再缓存会被多个 Action 重复使用的中间结果;根据规模选择内存或内存加磁盘,并在最后一次使用后释放。
缓存位置比调用 cache() 这个动作更重要。