Spark Shuffle 为什么慢?怎么优化?
本文目录
面试怎么回答
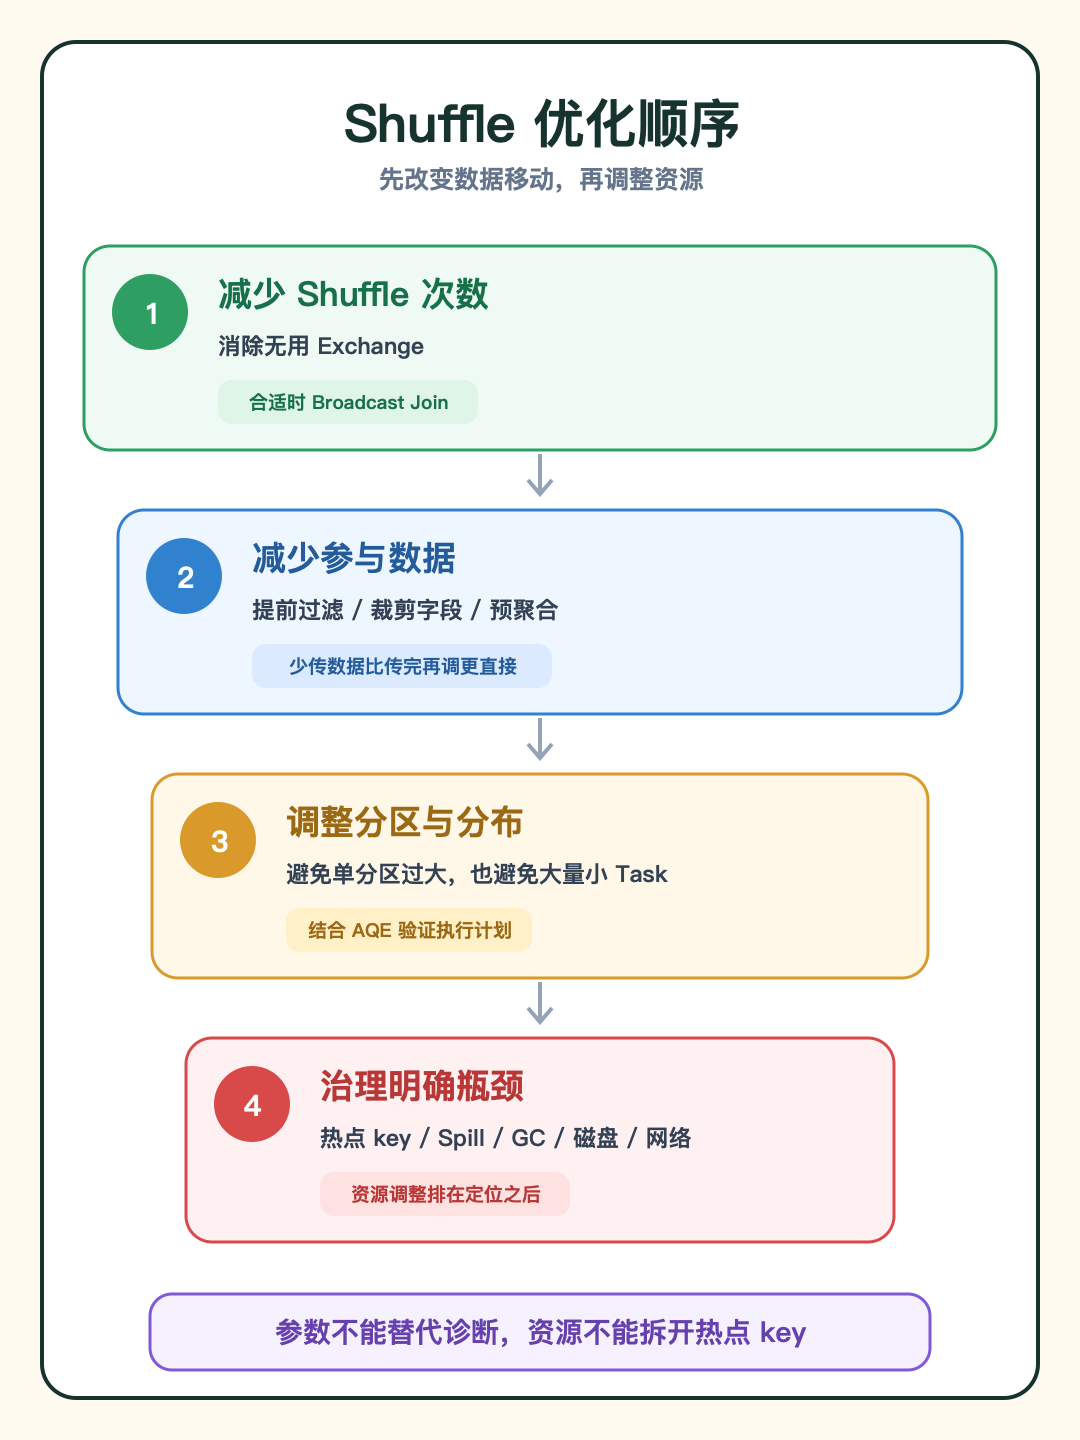
Shuffle 会让数据按新分区跨节点重分布,过程中包含序列化、排序聚合、内存 Spill、磁盘 IO、网络拉取,而且 Stage 要等待最慢的 Task,所以成本很高。我会先在 Spark UI 和执行计划里定位 Shuffle Stage,看 Read、Write、Task 分布、Spill、GC 和 Fetch Wait。优化顺序是先减少不必要的 Exchange,比如合适时使用 Broadcast Join;再在 Shuffle 前过滤、裁剪字段和预聚合;然后根据总量和 Task 分布调整分区,并单独治理热点 key。AQE 可以帮助合并小分区和处理部分倾斜,但仍要用运行指标验证。最后才是针对明确的内存、磁盘或网络瓶颈调资源。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人一上来就回答:
- 调大内存
- 增加 Executor
- 调整 Shuffle 分区数
- 开启 AQE
这些方法有时确实有效。
但如果只回答参数,面试官很可能会继续追问:
这次 Shuffle 到底慢在数据量、分区分布、内存 Spill,还是网络拉取?
因为 Shuffle 不是一个单独动作。
它会让数据跨分区重新分布,并引入序列化、落盘、网络传输、排序聚合和慢 Task 等待。
真正有效的优化顺序应该是:
先减少不必要的 Shuffle 和参与 Shuffle 的数据,再处理分区、倾斜与资源问题。
第一步:先理解 Shuffle 为什么贵
当 Join、Group By、Distinct、Repartition 等操作要求相同 key 的数据进入同一个分区时,Spark 通常需要重新分发数据。
上游 Map Task 会按目标分区组织输出,下游 Reduce Task 再拉取属于自己的数据。
这条链路可能包含:
- 数据序列化和反序列化
- 内存缓冲、排序和聚合
- 内存不足后的磁盘 Spill
- 跨 Executor 的网络传输
- 大量 Shuffle 文件和随机 IO
- Reduce Task 等待所有上游输出可用
所以 Shuffle 慢,往往不是因为“网络慢”这一个原因。
它把 CPU、内存、磁盘、网络和数据分布问题放到了一起,最终 Stage 还要等待最慢的 Task 完成。

第二步:先定位慢在哪个 Stage、哪类指标
排查时先看 Spark UI 的 Jobs、Stages 和 SQL 页面,找到耗时明显的 Stage 以及对应执行计划。
重点看四组信号。
第一看:Shuffle Read 和 Shuffle Write
确认这个 Stage 实际交换了多少数据,是否远超输入规模,是否存在不必要的宽依赖或中间结果膨胀。
第二看:Task 分布
比较 Task Duration、Shuffle Read Size 和 Records。
如果所有 Task 都慢,更像是总数据量过大、分区整体太大或资源能力不足;如果只有少数 Task 特别慢,更像是数据倾斜。
第三看:Spill、GC 和 Peak Memory
大量 Memory Spill、Disk Spill 或长时间 GC,说明单个 Task 的工作集超出可用执行内存,或者分区过大、聚合结构过重。
第四看:Fetch Wait 和失败日志
如果 Shuffle Fetch 等待明显,或者出现 FetchFailed,要继续排查 Executor 丢失、网络稳定性、磁盘压力和 Shuffle 文件可用性。
先判断瓶颈类型,再决定改 SQL、分区还是资源。
第三步:优化时按收益顺序处理
第一层:减少 Shuffle 次数
先看执行计划里有没有可以消除的 Exchange。
例如小表满足条件时使用 Broadcast Join,可以避免大表两侧都按 Join key 重分区;已经满足分布要求的数据,也不要反复 Repartition。
对于 RDD 聚合,能先在 Map 端合并的场景,优先使用 reduceByKey、aggregateByKey 等方式,而不是把同一个 key 的所有原始值都通过 groupByKey 拉到下游。
第二层:减少进入 Shuffle 的数据量
尽量在 Shuffle 之前完成:
- 过滤无效数据
- 只保留需要的字段
- 提前做局部聚合
- 避免 Join 后无意义的数据膨胀
少传一份数据,通常比传完以后再调参数更直接。
第三层:让分区大小更合理
分区太少,单个 Task 数据过大,容易 Spill、GC 甚至 OOM;分区太多,又会产生大量小 Task、调度开销和小文件。
因此不能机械地把 spark.sql.shuffle.partitions 调大或调小,而要结合 Shuffle 总量、Task 耗时、分区大小和集群并行度一起判断。
Spark SQL 的 AQE 可以依据运行时统计合并过小的 Shuffle 分区,并对部分倾斜 Join 做动态优化,但仍要验证最终执行计划和实际分布。
第四层:单独治理倾斜和资源瓶颈
热点 key 需要按业务语义处理,例如过滤无效 key、拆分热点、两阶段聚合、加盐或选择合适的 Join 策略。
如果分布已经合理,但所有 Task 仍然出现高 Spill、长 GC 或慢磁盘,再考虑调整 Executor 内存、核心数、并行度、序列化和本地磁盘能力。
资源调整应该排在定位之后,而不是作为第一反应。
一个典型场景
比如两张大表按用户维度 Join,任务在一个 Shuffle Stage 长时间跑不完。
第一反应是增加 Executor,但扩容后总耗时变化不大。
继续查看 Spark UI,会发现大部分 Task 很快完成,少数 Task 的 Shuffle Read 和 Spill 远高于中位数。
再检查 Join key 分布,发现空值和默认用户被集中到少数分区;同时 SQL 在 Join 前还保留了大量最终不使用的字段。
真正的处理顺序应该是:
先过滤或拆分无业务意义的默认 key → Join 前裁剪字段和数据 → 对剩余热点选择拆分或 AQE 倾斜优化 → 最后再根据分区大小调整并行度。
这时增加 Executor 只能提供更多空闲资源,无法拆开已经落到单个分区里的热点数据。
为什么只调 Shuffle 分区数经常不够?
调整分区数只能改变多数普通数据的切分粒度。
它不能自动解决:
- 一个热点 key 必须进入同一分区
- Join 方式本身产生了不必要的双边 Shuffle
- 上游没有过滤,传输了大量无用数据
- 数据膨胀来自错误的 Join 关系
- Executor、网络或磁盘不稳定
所以一个分区参数无法替代完整诊断。
更重要的问题是:
哪些数据为什么需要移动,移动了多少,又为什么集中到了这些 Task?
我理解的 Spark Shuffle 优化
Shuffle 优化不是记一组参数,而是降低数据重分布的总成本。
先从执行计划确认是否必须 Shuffle,再减少数据量,然后让分区大小和分布合理,最后处理 Spill、GC、网络和磁盘。
能不移动的数据不要移动,必须移动的数据尽量少、尽量均匀。