SQL Join 后数据量翻倍,你怎么排查?
面试怎么回答
我会先确认左右表和目标结果的粒度,再分别检查 Join Key 的唯一性,判断实际是 1:1、1:N 还是 N:M。接着检查关联条件是否漏了租户、日期、版本或有效期,并定位扩张倍数最高的 Key。修复时按目标粒度处理:需要当前记录就按确定规则取最新,需要汇总就先聚合,需要历史匹配就加有效期。最后验证 Join 后主键唯一性和金额等指标没有被复制,而不是直接加 DISTINCT。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人第一反应是:
“右表有重复,先加 DISTINCT 或 ROW_NUMBER 去重。”
这样有时能把行数压回去,但也可能随机丢掉本来有业务意义的多条记录。
Join 后数据膨胀的根因通常不是 SQL 语法,而是:
两边粒度、关联键和基数关系没有被说清楚,实际 Join 从预期的一对一变成了一对多或多对多。
第一步:先确认 Join 前两张表的粒度
不要一上来就看执行计划,先回答:
左表一行代表什么?
右表一行代表什么?
结果表希望一行代表什么?
例如:
- 左表:一行一个订单
- 右表:一行一个订单状态变更
- 目标:一行一个订单当前状态
右表天然是一单多行。如果只按 order_id 关联,左表每个订单会复制成多条,这不是右表“脏数据”,而是两张表的业务粒度不同。
第二步:检查关联键是否完整
有时两边在完整业务键上都是唯一的,但 Join 条件少写了一列。
常见缺失包括:
- 只按
user_id,漏了tenant_id - 只按
product_id,漏了shop_id - 只按业务 ID,漏了日期分区
- 关联历史维度时,漏了有效期条件
例如维度表按 product_id + effective_from 保存多个历史版本,事实表只用 product_id Join,就会同时匹配过去和当前多个版本。
所以要检查的是业务唯一键,不是只看字段名相同就拿来关联。
第三步:量化到底是哪种基数关系
Join 前可以先分别统计:
SELECT join_key, COUNT(*)
FROM left_table
GROUP BY join_key
HAVING COUNT(*) > 1;
右表也做同样检查,再判断当前关系:
- 1:1:两边 Join Key 都唯一
- 1:N:一边唯一,另一边多行
- N:M:两边都多行,行数可能乘法膨胀
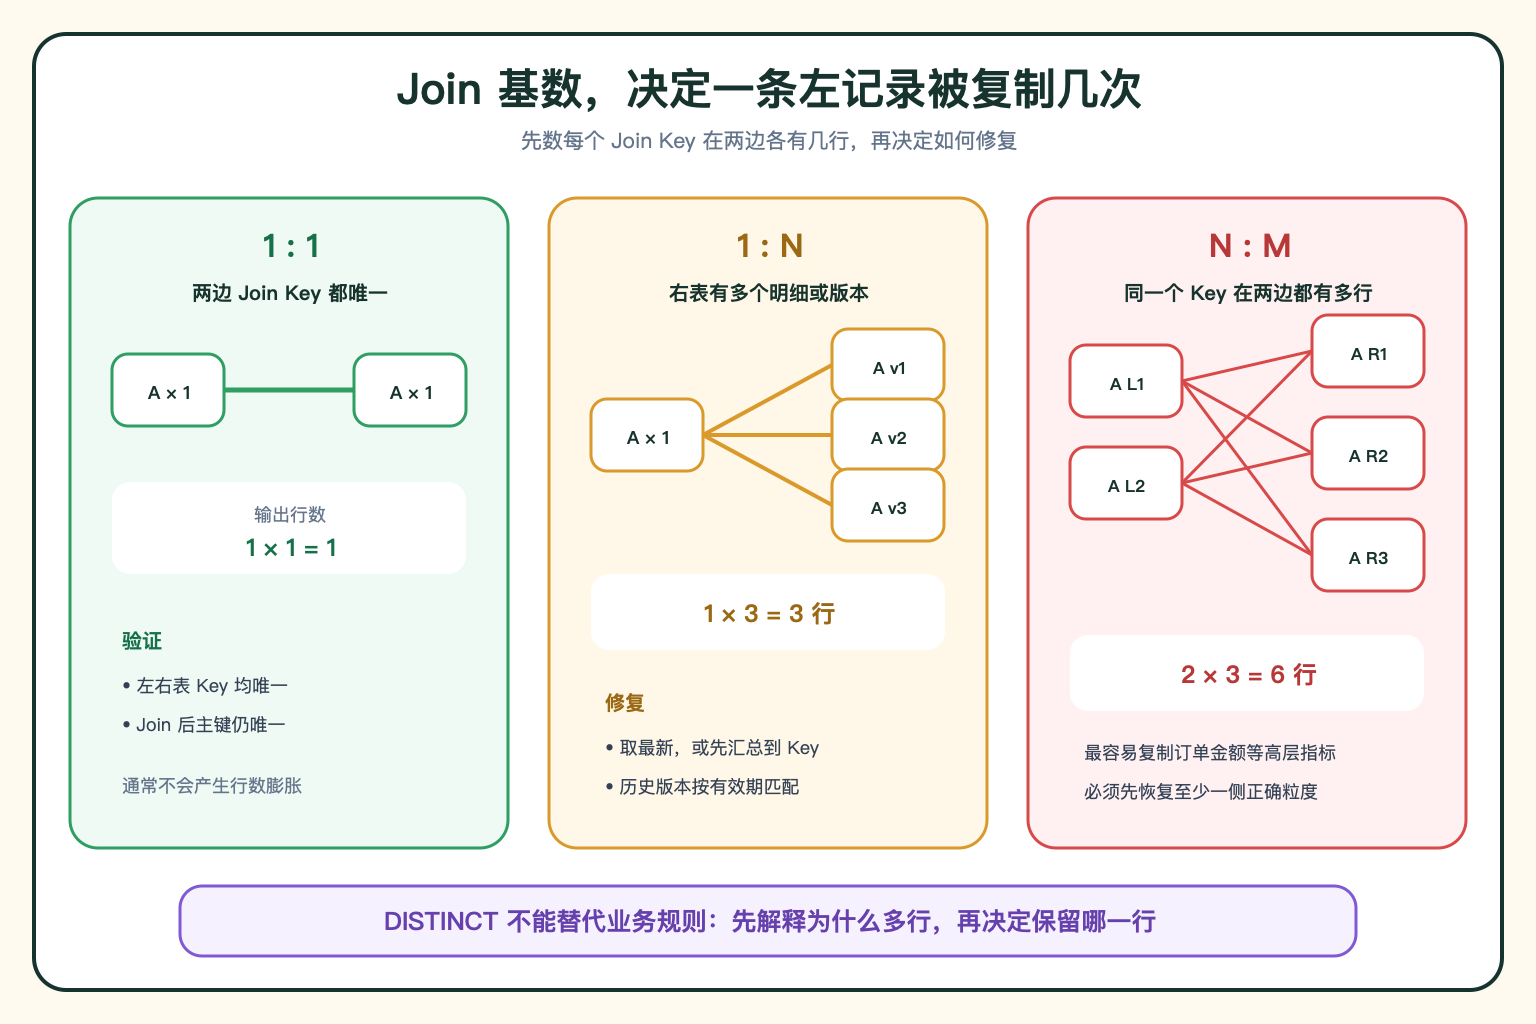
排查时除了看总行数,还要看:
COUNT(*)与COUNT(DISTINCT 主键)- 哪些 Join Key 的匹配数最大
- Join 前后核心主键重复度
- 指标金额是否被重复复制
总行数翻倍只是结果,真正要定位的是哪些 Key 发生了几倍扩张。
第四步:按目标粒度修复,不要盲目 DISTINCT
修复方式取决于目标表到底要什么。
只要最新一条
按明确排序规则使用 ROW_NUMBER,例如状态时间降序,再用稳定 ID 作为第二排序条件。
需要先汇总
右表先聚合到 Join Key 粒度,再与左表关联。
需要匹配历史版本
增加有效期条件:
event_time >= effective_from
AND event_time < effective_to
同时保证同一业务键的有效期不重叠。
本来就是一对多
如果目标粒度允许多行,就不应该强行去重,而要防止下游把订单级金额在明细层重复汇总。
DISTINCT 只能删除完全相同的结果行,无法替你决定哪条业务记录应该保留。
一个典型场景
比如订单表一行一个订单,状态历史表记录 CREATED、PAID、SHIPPED 等多次变化。
为了获取当前状态,SQL 直接按 order_id 做 Left Join。订单表 100 万行,Join 后变成 350 万行,GMV 也同步放大。
最初用 SELECT DISTINCT,但不同状态和时间字段本来就不同,行数并不会回到 100 万。
正确做法是先在状态表中按 order_id、状态时间和事件 ID 排序,明确选出当前版本,再与订单表做一对一关联,并验证 Join 后订单主键仍然唯一。
先恢复正确粒度,再谈去重;否则只是把错误藏起来。