SQL 窗口函数 ROWS 和 RANGE 有什么区别?
面试怎么回答
ROWS 按物理行位置定义窗口,RANGE 按 ORDER BY 值的范围定义窗口。排序值重复时,ROWS 逐行推进,但必须补充唯一排序字段保证稳定;RANGE 会把相同排序值的 Peer Rows 一起纳入边界。逐笔累计通常选 ROWS,按时间点或值区间累计才考虑 RANGE,同时显式写出 Frame,并确认目标引擎对 RANGE 的具体支持。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样是计算累计金额,两条记录的排序时间完全相同。
一条 SQL 会逐行增长,另一条却会把同一时间的多条记录一次性都算进去。
这不是数据库随机行为,而是窗口边界不同:ROWS 和 RANGE 到底有什么区别?
ROWS 按物理行数定义窗口;RANGE 按 ORDER BY 值的范围定义窗口。遇到相同排序值时,两者可能产生不同结果。
ROWS:按行的位置移动
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW表示从分区第一行累计到当前物理行。
如果同一时间有两条记录,它们仍是两行。要得到稳定顺序,ORDER BY 最好加入唯一字段:
ORDER BY event_time, event_id否则同值记录之间的先后顺序可能不稳定。
RANGE:按排序值的范围移动
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW关注的是当前 ORDER BY 值。同一个排序值的 Peer Rows 通常会被视为同一边界,一起包含在当前窗口中。
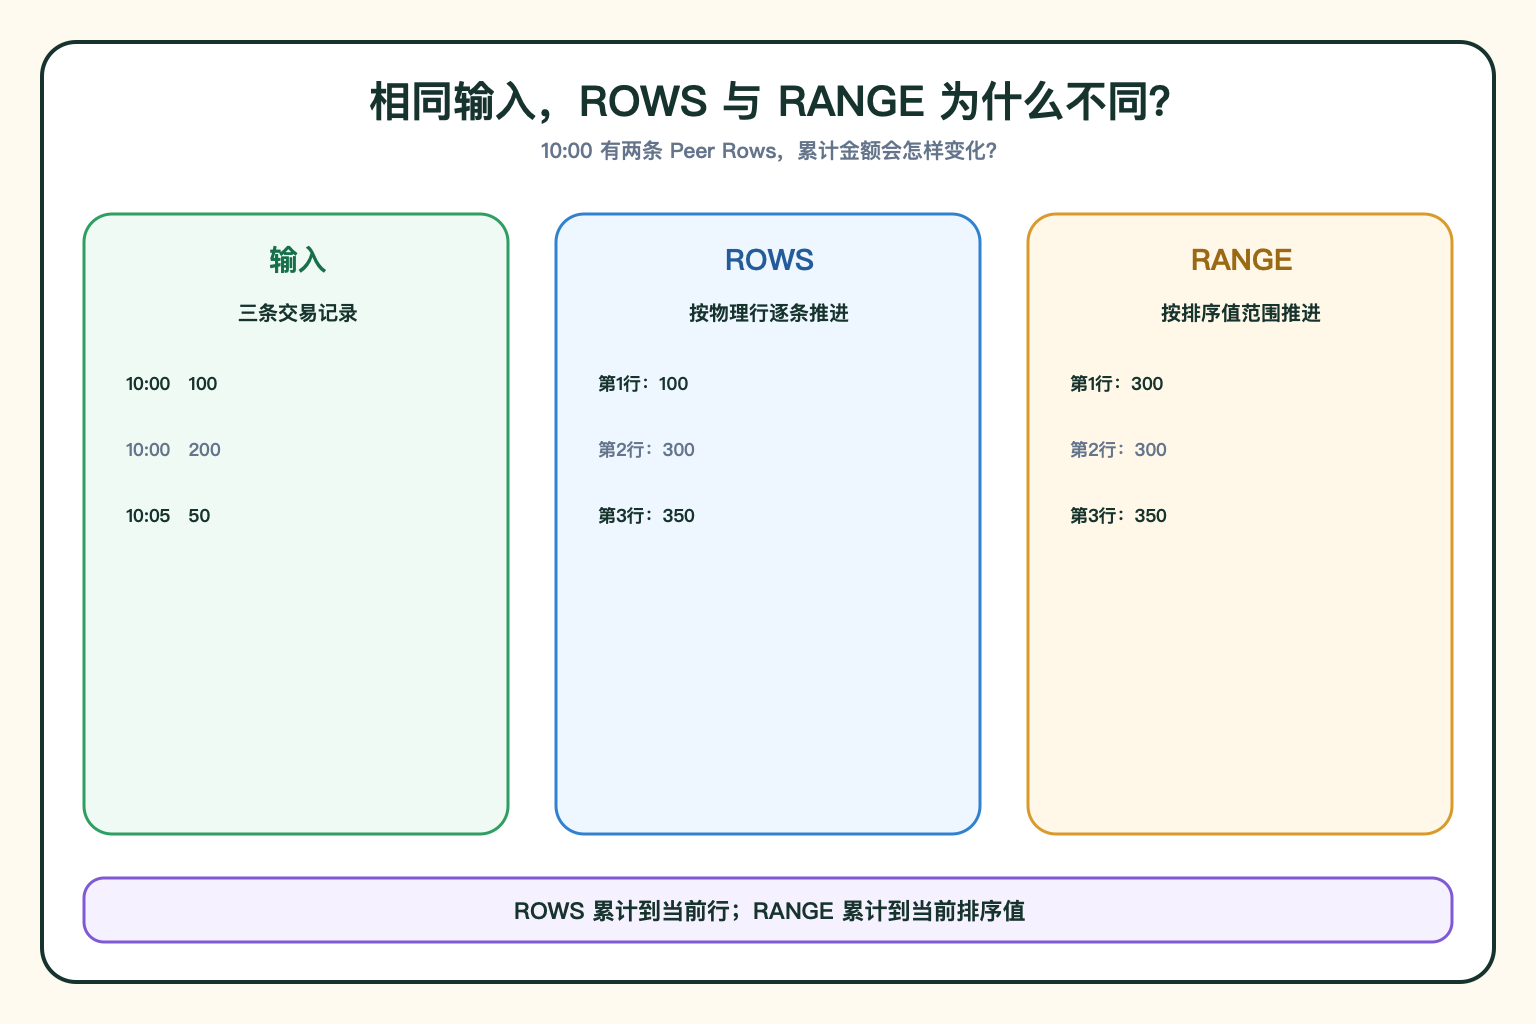
一个简单例子
输入数据:
10:00  amount=100
10:00  amount=200
10:05  amount=50
使用 ROWS 并保证第一条在前时,累计值可能是:
100 → 300 → 350使用 RANGE 按时间累计时,两条 10:00 记录属于同一个排序值范围,结果可能是:
300 → 300 → 350所以 RANGE 更像“累计到当前时间点”,ROWS 更像“累计到当前这条记录”。
选择时看三个问题
业务边界是行还是值?
逐笔交易流水通常使用 ROWS;按日期、价格区间或时间点整体计算,才考虑 RANGE。
排序字段是否重复?
如果重复值很多,Peer Rows 会让 RANGE 结果成组变化。必须确认这符合业务预期。
数据库是否支持对应语法?
不同引擎对 RANGE 的数据类型、偏移写法和多排序列支持可能不同。不要依赖隐式默认窗口,最好显式写出 Frame。
一个典型反例
比如希望按交易流水逐笔计算账户余额,却只按秒级 event_time 排序并使用 RANGE。
同一秒的多笔交易会一起进入窗口,余额出现“批量跳变”,无法还原每一笔后的状态。
正确做法是使用 ROWS,并在时间后增加稳定唯一的流水号排序。反过来,如果业务要的是“截至这个时间点的总额”,RANGE 的 Peer 语义可能更符合需求。
先定义业务边界,再选择窗口 Frame。