SQL WHERE 和 HAVING 有什么区别?
面试怎么回答
WHERE 在分组和聚合前过滤明细行,不能直接依赖聚合结果;HAVING 在分组后过滤组,适合 SUM、COUNT 等聚合条件。能在明细阶段判断的条件通常放 WHERE,既表达准确,也便于减少后续处理量。实战中我会先确认结果粒度,再按明细条件和聚合条件拆分,并结合执行计划验证是否真正下推。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
业务要找“近 30 天成交金额超过 1 万元的上海客户”。有人把城市和金额条件全写进 HAVING,结果虽然能跑,却把两种完全不同的过滤混在了一起。
先给结论:WHERE 过滤分组前的明细行,HAVING 过滤分组后的结果。判断条件放哪里,关键看它依赖的是原始字段,还是聚合结果。
先看一段正确写法
SELECT customer_id,
       SUM(pay_amount) AS total_amount
FROM dwd_order
WHERE city = '上海'
  AND pay_time >= CURRENT_DATE - INTERVAL '30' DAY
GROUP BY customer_id
HAVING SUM(pay_amount) > 10000;city、pay_time 是明细行属性,所以在 WHERE 阶段先过滤;SUM(pay_amount) 只有分组后才存在,因此放在 HAVING。
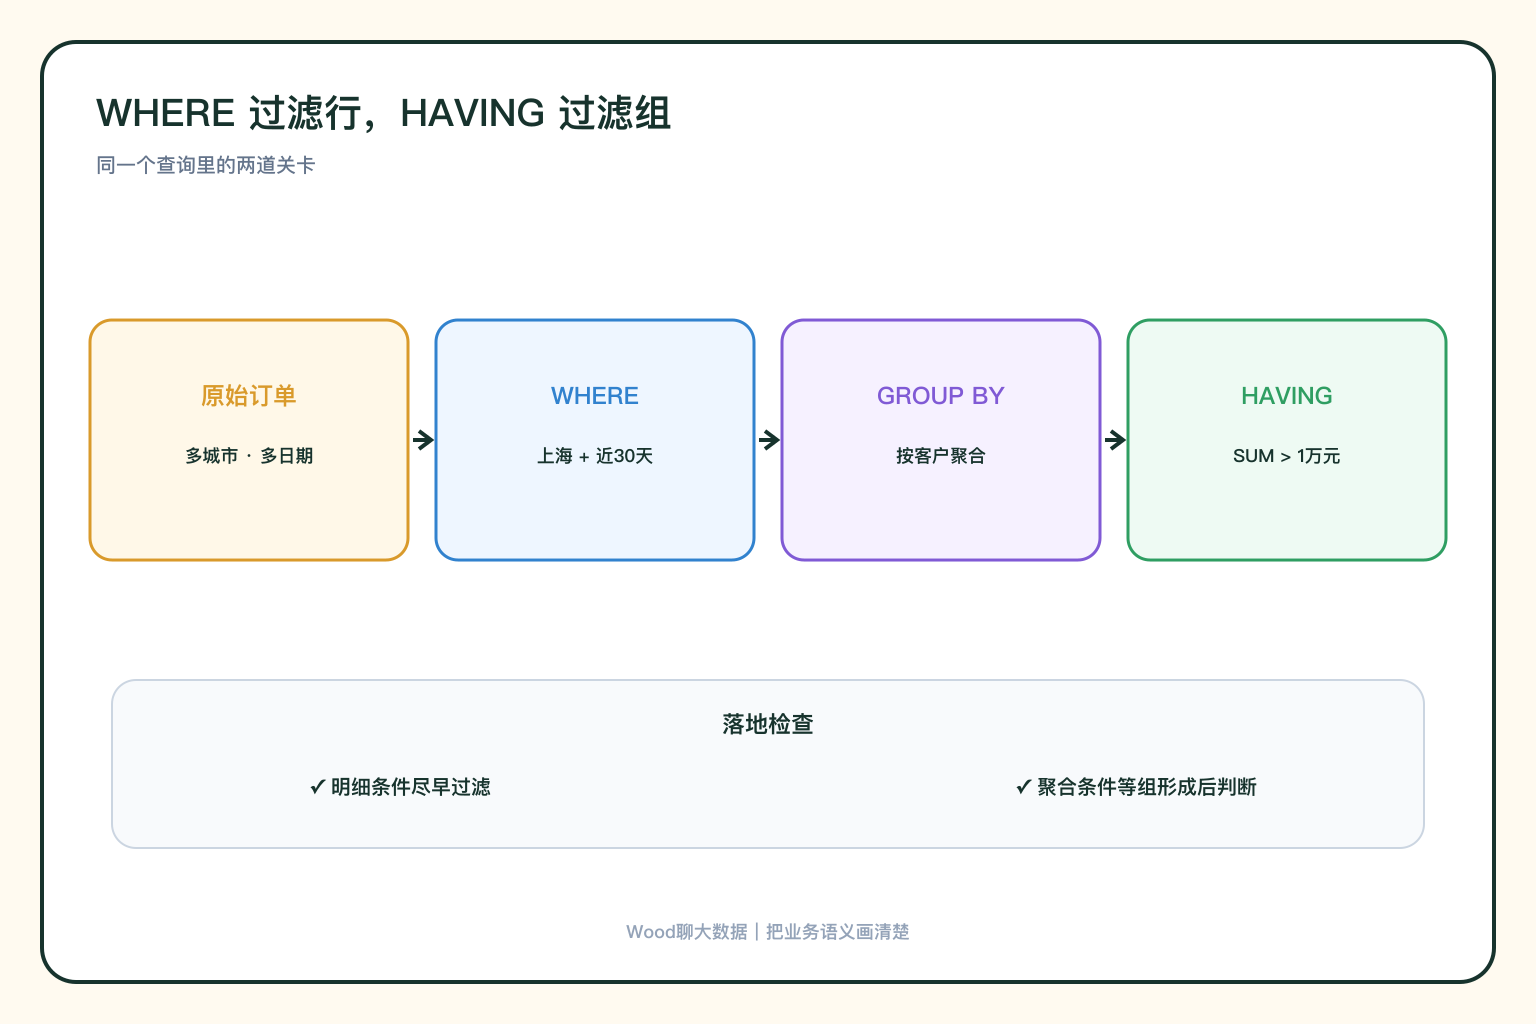
可以把查询过程理解成:先从表中取行,再用 WHERE 缩小明细集,之后 GROUP BY 形成分组并计算聚合,最后由 HAVING 决定保留哪些组。
为什么不要把普通条件都塞进 HAVING?
下面这种写法在部分引擎中可能可以执行:
SELECT city, SUM(pay_amount)
FROM dwd_order
GROUP BY city
HAVING city = '上海';
但 city = '上海' 明明在聚合前就能判断。写进 WHERE 更能表达意图,也更有机会尽早减少参与聚合的数据量。优化器有时会自动下推条件,但面试里不要把“优化器可能改写”当成混写条件的理由。
还有一个常见错误:在 WHERE 中直接写聚合函数。
-- 错误思路
WHERE SUM(pay_amount) > 10000
WHERE 执行逻辑发生在聚合结果形成之前,此时还没有 SUM(pay_amount) 可供判断。
三个容易答漏的边界
第一,HAVING 不只是“和 GROUP BY 一起用”的语法标签,它真正过滤的是聚合后的组。不同引擎对无 GROUP BY 的 HAVING 支持存在差异,跨引擎 SQL 不要依赖冷门写法。
第二,WHERE 过滤掉的行不会进入聚合。例如求订单平均金额时,WHERE status = 'PAID' 表示只用已支付订单计算平均值;而在聚合后再判断状态,语义已经不同。
第三,一个需求可能同时需要两层过滤:先排除测试订单,再筛选订单数超过 10 的客户。前者是 WHERE,后者是 HAVING,不能二选一。
生产中怎么检查写对没有?
我会先写清结果粒度,再逐个标注条件:明细条件、分组条件还是聚合条件。随后分别统计 WHERE 前后行数、GROUP BY 后组数和 HAVING 后组数。这样不仅能检查语义,也能快速发现条件写错层级导致的数据放大或误删。
性能上还要看执行计划是否真的完成分区裁剪、谓词下推和聚合前过滤。逻辑位置写对是第一步,物理执行是否高效仍要以具体引擎计划为准。