SQL MERGE INTO 如何实现增量更新?
面试怎么回答
我会先确认业务唯一键和输入是增量日志还是全量快照,再决定 MERGE 的三个分支。源表必须在业务键上去重,MATCHED 只更新允许变化且版本更新的字段,NOT MATCHED 插入;删除要依赖明确的删除事件或快照语义,不能因为本批没出现就删除。最后用插入、更新、删除计数和唯一性校验保证幂等。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
增量任务重跑后,目标表多了重复数据;补数时又把正常记录覆盖了。
这类问题通常不是 MERGE INTO 不够强,而是匹配键、源端去重和删除语义没有先设计清楚。
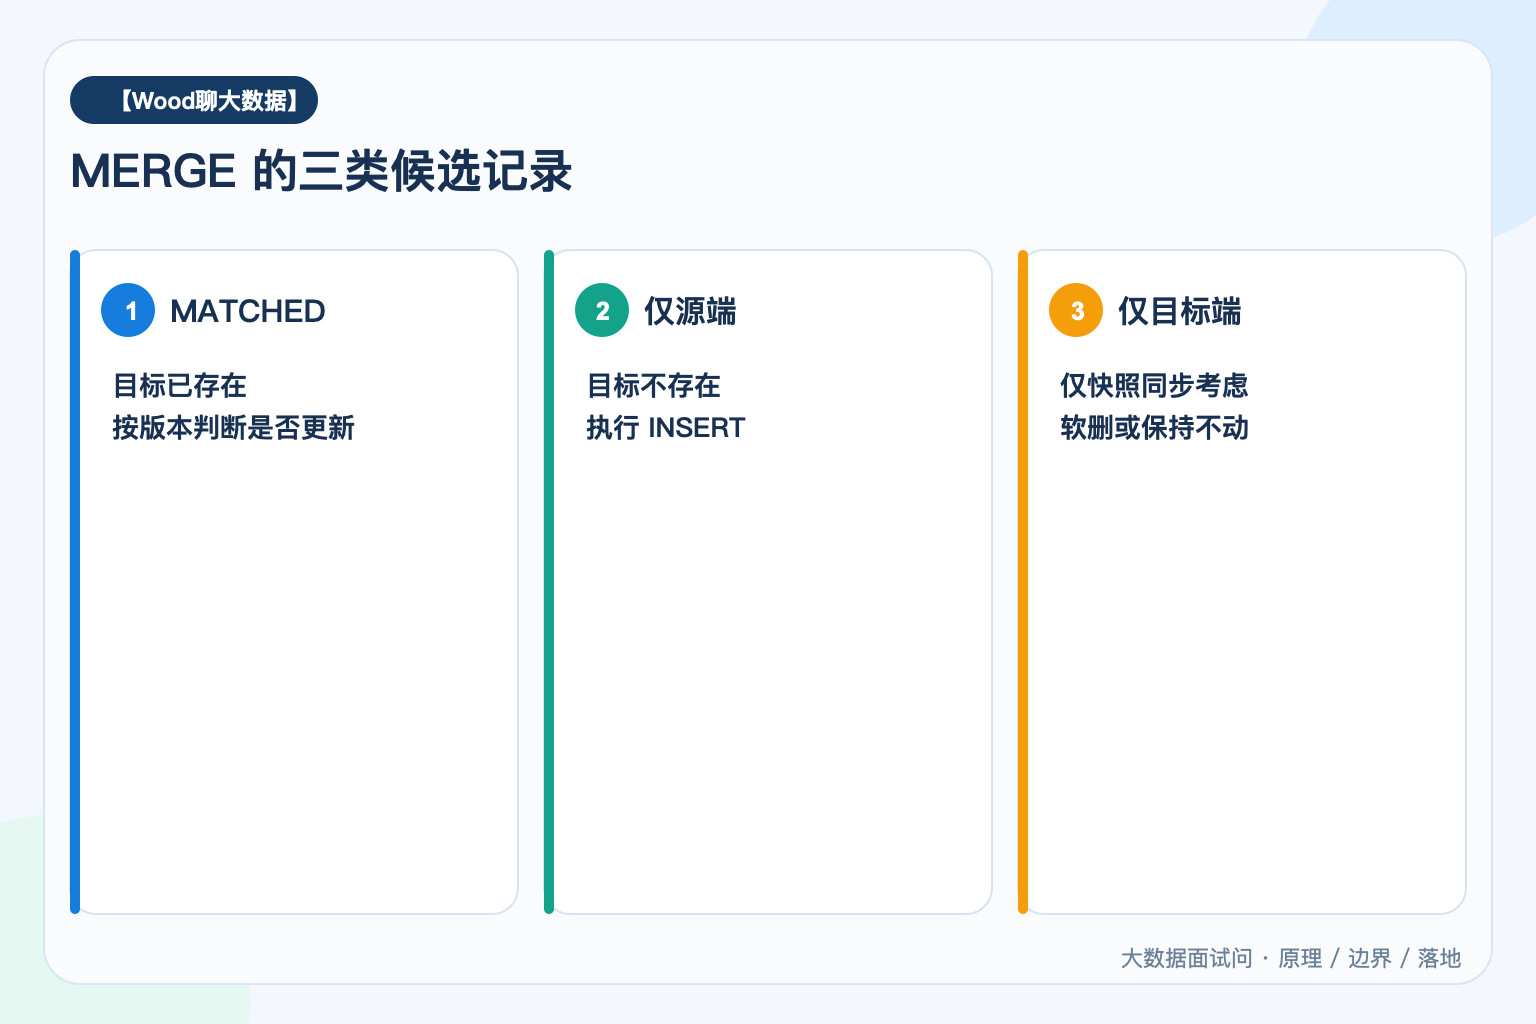
MERGE 的本质是先用业务键把源表与目标表分成“匹配、仅源端、仅目标端”三类,再为每一类定义可重复执行的动作。
先明确三类候选记录
执行 MERGE 时,系统先按 ON 条件连接源表和目标表。匹配到的记录进入 MATCHED,只在源端出现的记录进入 NOT MATCHED BY TARGET,部分引擎还支持只在目标端出现的 NOT MATCHED BY SOURCE。WHEN 分支按顺序判断,一条候选记录只执行一个动作。
ON 条件必须代表真正的业务唯一键
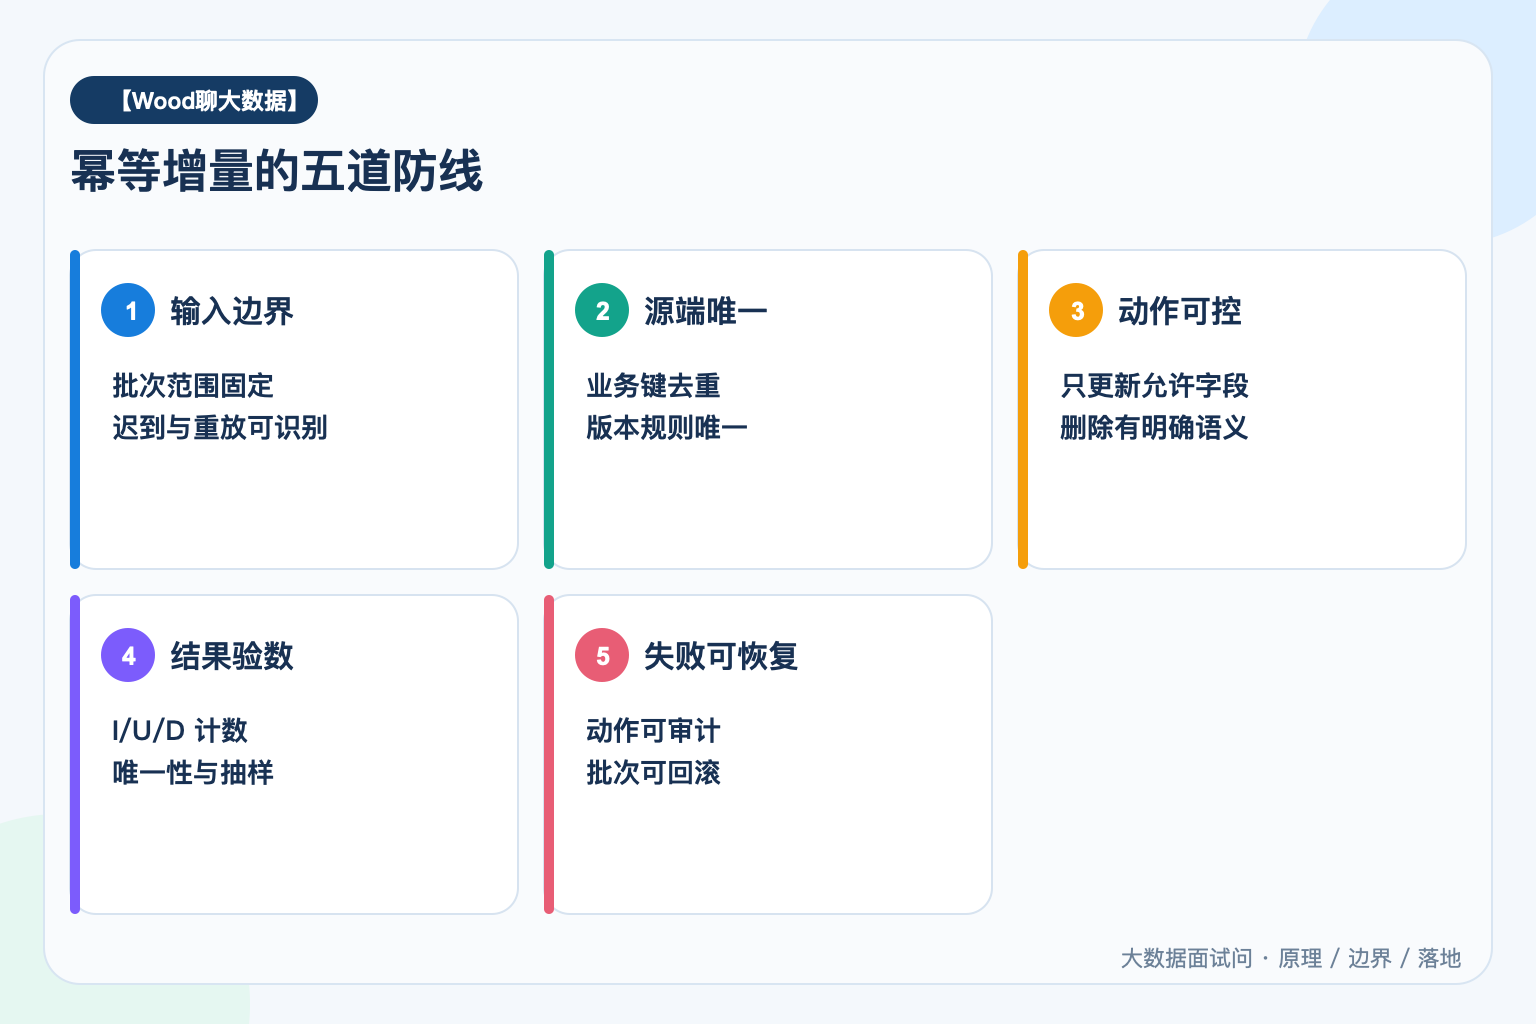
不能为了让语句跑通,随手用日期、状态等非唯一字段做匹配。若一条目标记录匹配到多条源记录,可能报基数冲突,也可能在不同引擎中产生不确定结果。生产里通常先用 ROW_NUMBER 按业务键去重,并明确保留最新版本还是优先级最高版本。
更新不是把所有字段重新覆盖
更稳妥的做法是只更新发生变化且允许被源端改写的字段。审计时间、人工修正值、首次创建时间不应被无条件覆盖;空字符串和 NULL 也要先约定语义。否则一次迟到数据回放,就可能把目标表中的高质量值改回旧值。
删除语义需要单独设计
源端不再出现,并不天然等于目标记录应该删除。全量快照同步可以考虑 NOT MATCHED BY SOURCE 后软删;增量日志则不能这么做,因为“本批没来”只是没有变化。若源端有删除标记,优先按标记更新有效状态,并保留可追溯信息。
幂等要靠输入边界和校验闭环
同一批数据重复执行,结果应保持一致。除了 MERGE 语句,还要固定批次范围、去重规则和版本比较条件。执行后至少核对源端唯一键数、插入数、更新数、删除数以及目标表唯一性,异常批次要能定位和回滚。
一个更稳妥的模板
先在 USING 子查询中完成过滤与去重,再以业务主键匹配;MATCHED 分支增加版本号或更新时间条件,避免旧数据覆盖新数据;NOT MATCHED 再插入。若引擎支持 RETURNING 或变更统计,把动作类型落到审计表,补数时更容易解释。
参考资料
- PostgreSQL MERGE:https://www.postgresql.org/docs/current/sql-merge.html