SQL 中 NOT IN 遇到 NULL,为什么结果可能为空?
面试怎么回答
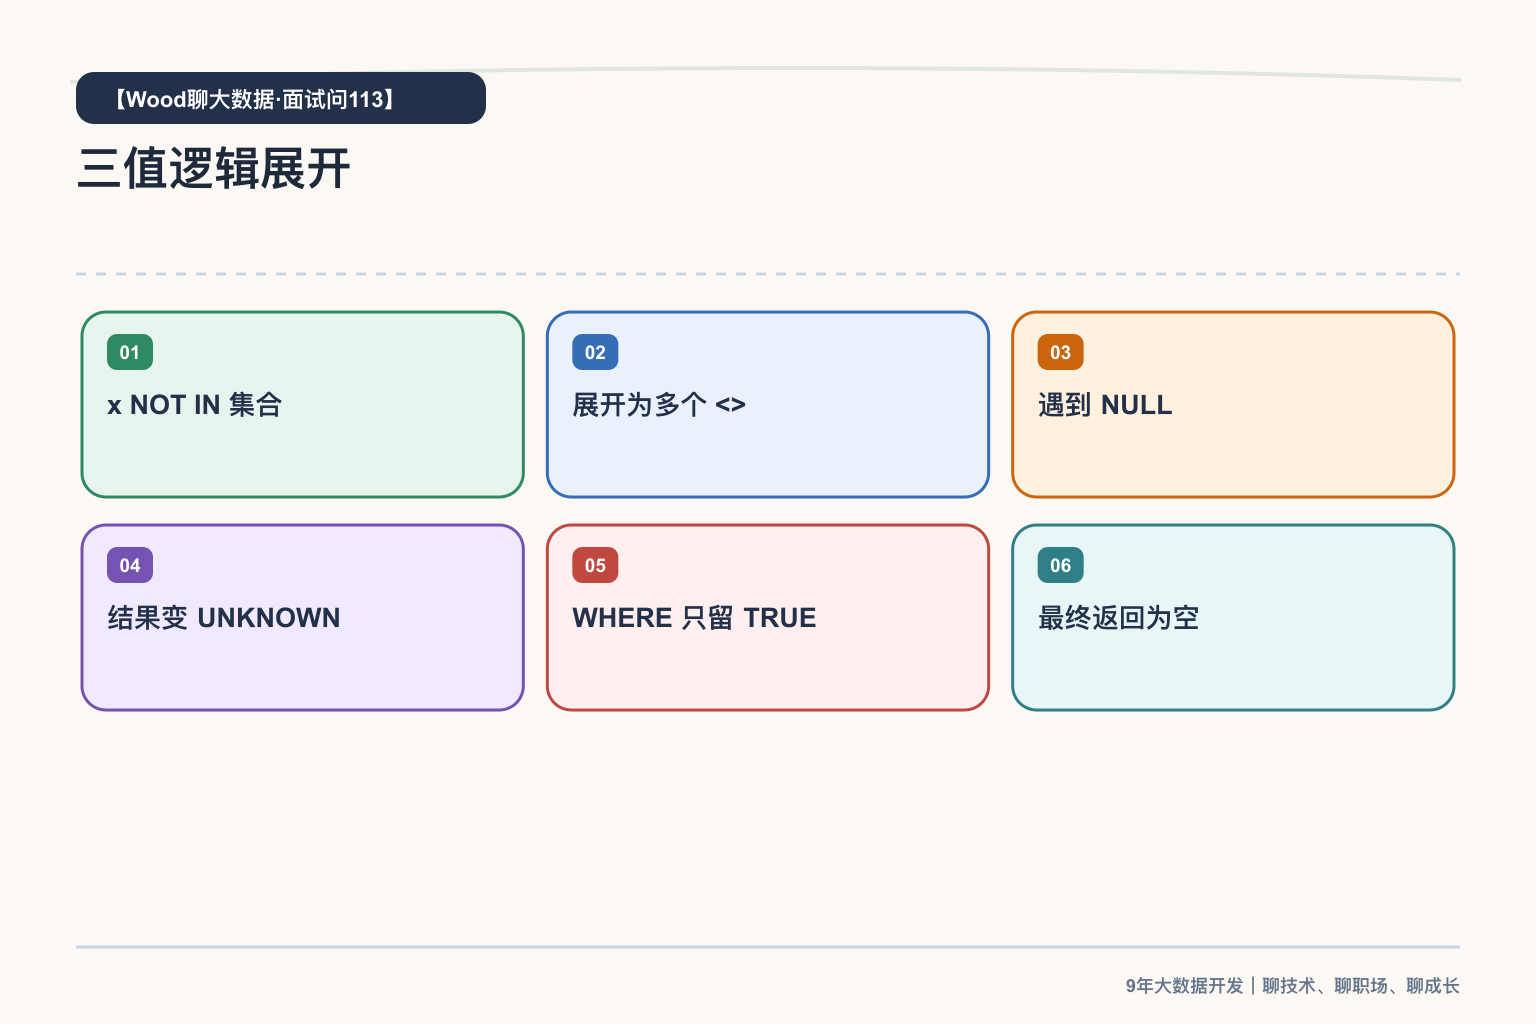
我会先说明 SQL 是三值逻辑。NOT IN 会展开成多个不等比较,只要集合中有 NULL,某一项就会得到 UNKNOWN,WHERE 又只保留 TRUE,因此可能整批无结果。生产中我更倾向使用带关联条件的 NOT EXISTS;如果使用 NOT IN,会先过滤子查询 NULL,并为关联键加非空校验,避免数据变化后静默出错。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一张黑名单表里只有几条数据,主表明明有上万条记录。执行 WHERE id NOT IN (SELECT id FROM blacklist) 后,结果却一条都没有。
这不是数据库“算错了”,而是 SQL 的三值逻辑在起作用。
NOT IN 的真正风险不是慢,而是子查询只要混入 NULL,比较结果就可能从 TRUE 变成 UNKNOWN。
先理解三值逻辑
SQL 条件不只有 TRUE 和 FALSE,还有 UNKNOWN。任何值与 NULL 做 =、<> 比较,结果通常都不是 TRUE,而是 UNKNOWN。WHERE 只保留 TRUE,FALSE 和 UNKNOWN 都会被过滤。
NOT IN 如何展开
x NOT IN (1,2,NULL) 可以理解成 x<>1 AND x<>2 AND x<>NULL。前两项即使成立,最后一项仍是 UNKNOWN,整个 AND 无法得到 TRUE,所以记录不会返回。
生产里怎么写
如果业务语义是“主表不存在对应黑名单记录”,优先使用 NOT EXISTS,并写清主外键关联条件。若必须使用 NOT IN,至少在子查询中显式过滤 WHERE id IS NOT NULL。
还要检查数据语义
NULL 可能表示未知、尚未采集或不适用,不能随手转成 0 或空字符串。修 SQL 前先确认字段是否应该允许 NULL,以及 NULL 是否应该参与排除逻辑。
为什么不能只回答概念?
“误区:NOT IN 就等于排除集合”之所以常见,是因为它在理想数据和单次执行里往往说得通。但生产环境会加入数据规模、异常值、并发、版本、失败重试和下游口径,这些条件一变化,只记住术语就很容易给出错误结论。
所以我会把 先理解三值逻辑、NOT IN 如何展开、生产里怎么写、还要检查数据语义 串成一条完整链路。最终判断标准不是某个函数或配置是否出现,而是能否稳定得到可解释、可验证、可恢复的业务结果。
落地时我会检查什么?
- 输入边界:确认数据范围、时间口径、主键和异常值是否符合假设。
- 执行过程:观察分区、并行度、状态、Shuffle 或资源变化,验证方案是否真正生效。
- 输出结果:用行数、唯一性、关键指标和样本明细证明结果正确,而不是只看任务成功。
- 失败恢复:说明重跑、回滚、版本兼容和责任人,避免一次成功后无人维护。
这些检查不一定全部写进一条 SQL 或一个任务,但面试时能主动补充,说明你回答的不是背诵题,而是在描述一套可上线的工程方案。
一个典型场景
实际工作中常见的反例是:开发环境黑名单字段非空,SQL 测试正常;上线后上游新增一条缺失主键的数据,整个反查结果突然归零。常规行数监控只看到输出下降,却看不出是一个 NULL 改变了谓词语义。修复时既要改成 NOT EXISTS,也要为关键关联键增加非空质量规则。
先确认 NULL 语义,再选择反连接。