SQL EXISTS、IN 和 JOIN 怎么选?
面试怎么回答
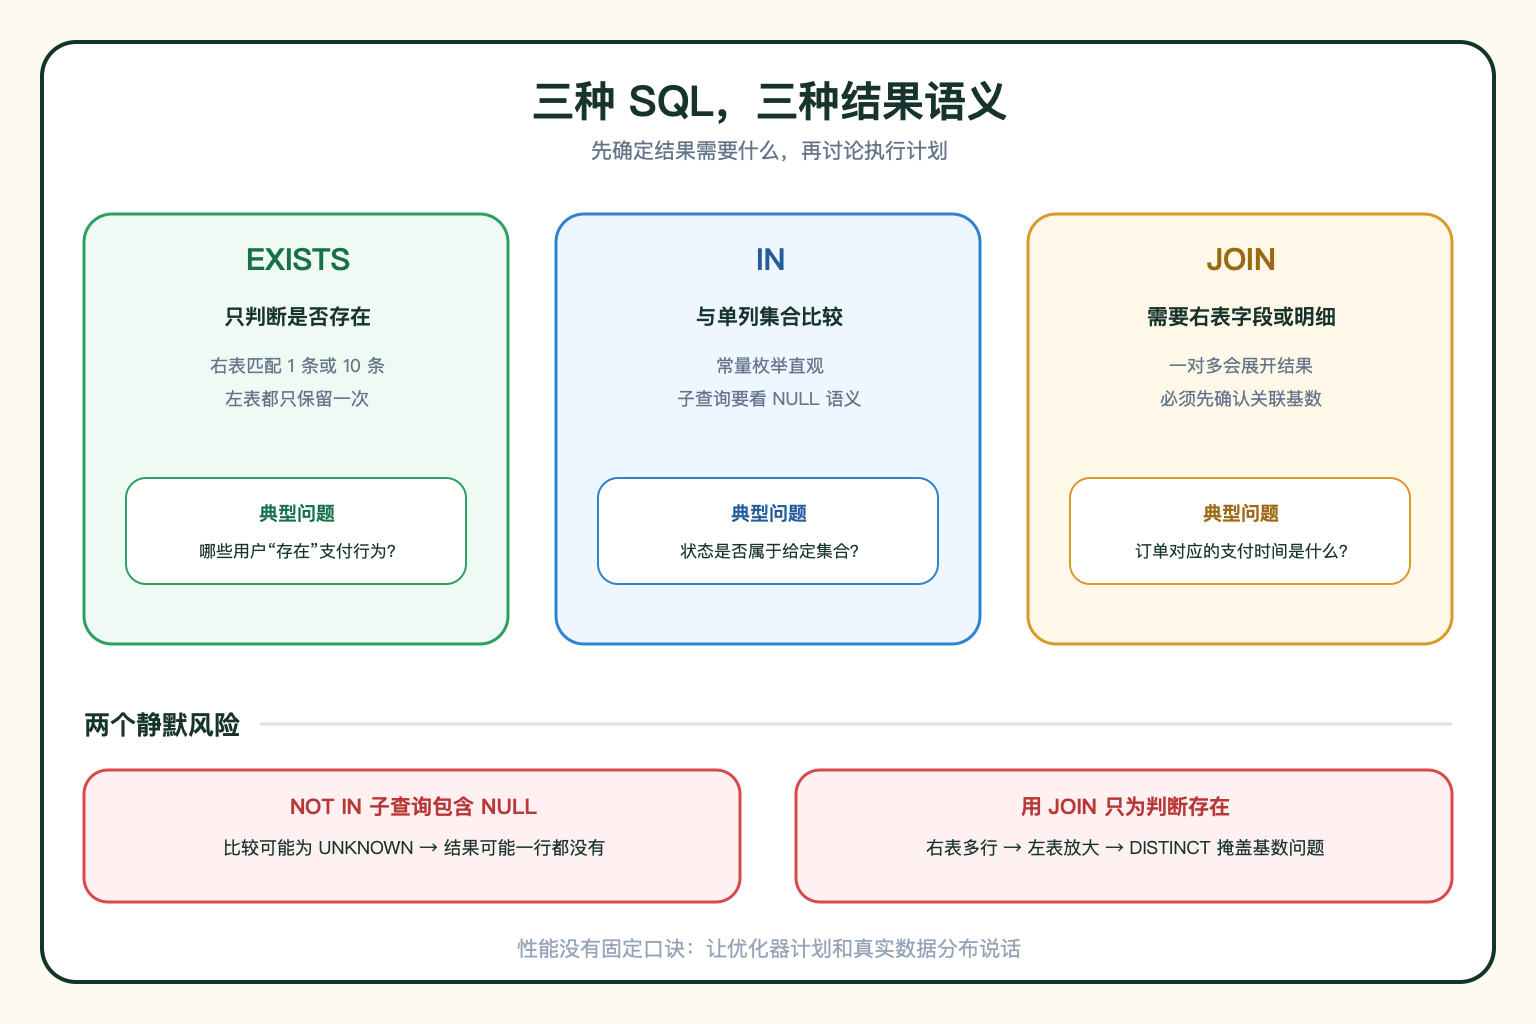
我会先按结果语义选择:只判断右表是否存在匹配,用 EXISTS;与明确的单列集合比较,用 IN;需要右表字段或保留一对多关系,用 JOIN。反向筛选时重点防止 NOT IN 子查询含 NULL,通常优先 NOT EXISTS。性能上不背固定口诀,因为优化器可能改写,我会再看执行计划、数据量和基数,同时验证 JOIN 没有把左表意外放大。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人一上来就背:
“小表用 IN,大表用 EXISTS,JOIN 性能最好。”
这类结论太绝对。现代优化器可能把不同写法转换成相似执行计划,真正应该先看的是结果语义:只判断是否存在、与一个值集合比较,还是需要展开右表字段。
先用业务语义选择 SQL,再用执行计划验证性能。
EXISTS:只关心有没有匹配
EXISTS 判断相关子查询是否至少返回一行:
SELECT a.*
FROM orders a
WHERE EXISTS (
  SELECT 1
  FROM paid_orders b
  WHERE b.order_id = a.order_id
);
它表达的是半连接语义:右表匹配一条还是多条,左表都只保留一次。
适合“筛选有过支付的订单”“筛选存在行为的用户”。
IN:与一个值集合比较
IN 适合明确的小集合或单列子查询:
WHERE status IN ('PAID', 'SHIPPED')它的表达清晰,尤其适合常量集合。使用子查询时,要确认列类型和空值语义。
最危险的是 NOT IN:如果子查询结果包含 NULL,比较可能得到 UNKNOWN,最终没有任何行满足条件。
JOIN:需要右表字段或展开关系
如果结果需要右表的属性,使用 JOIN 更自然:
SELECT a.order_id, b.pay_time
FROM orders a
JOIN payments b
  ON a.order_id = b.order_id;
但右表同一个 order_id 有多行时,左表也会被复制。只想判断存在却使用 JOIN,再加 DISTINCT 压回去,既掩盖基数问题,也增加计算成本。
选择时看三件事
结果要不要右表字段?
不要,只判断存在:优先表达成 EXISTS。
要:使用 JOIN,并先确认是一对一、一对多还是多对多。
条件是不是一个明确集合?
状态枚举、固定 ID 列表等,使用 IN 最直观。
是不是反向筛选?
要找“不存在匹配”的记录,NOT EXISTS 通常比带空值风险的 NOT IN 更安全,但仍要保证关联条件完整。
一个典型反例
比如要找没有支付记录的订单:
WHERE order_id NOT IN (SELECT order_id FROM payments)支付表中只要出现一条 order_id IS NULL,结果就可能一行都不返回。任务没有报错,但业务结果完全错误。
改用关联条件清楚的 NOT EXISTS,或者在子查询中显式排除 NULL,才能得到预期结果。
另一个常见问题是用 JOIN 判断存在,右表多条支付尝试把订单复制多行,再用 DISTINCT 掩盖。
SQL 没报错,不代表关联语义正确。