SQL 执行计划怎么看?如何定位慢查询?
面试怎么回答
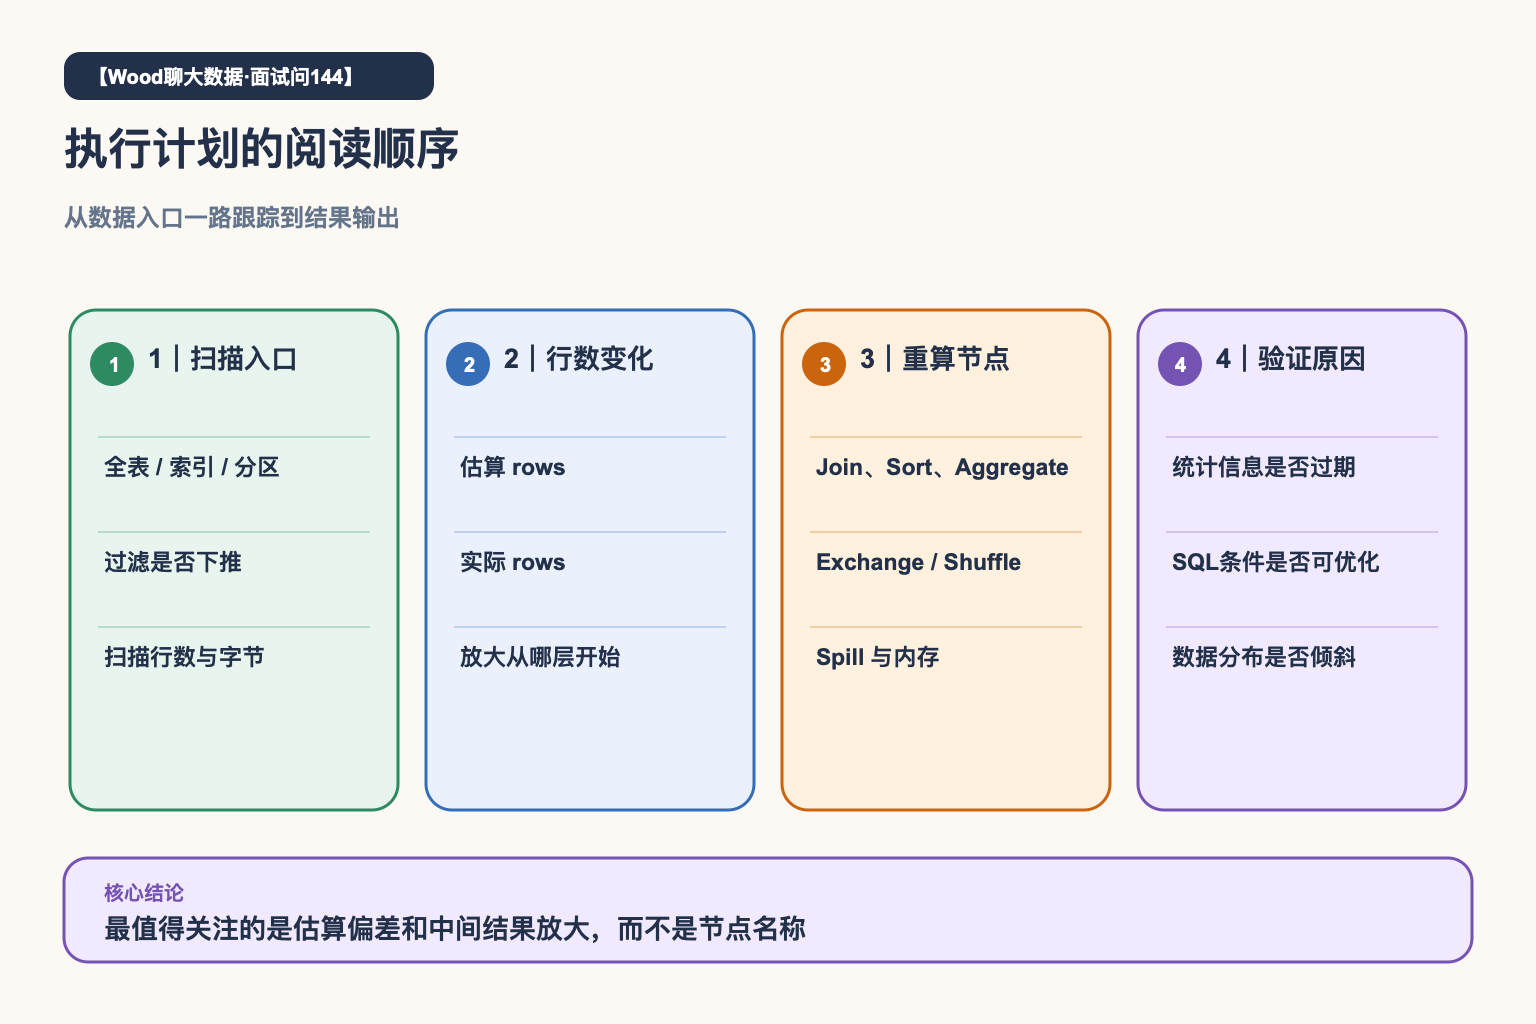
我通常先确认是估算计划还是真实执行计划,再从扫描节点向上看分区裁剪、过滤下推和每层行数变化。重点比较 estimated rows 与 actual rows,找到中间结果放大和估算失真的位置,然后检查 Join、Sort、Aggregate、Exchange 与 Spill。最后回到统计信息、关联基数、SQL 条件和数据倾斜验证根因,而不是看到全表扫描就直接判定错误。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
看到执行计划里出现全表扫描,就认定“索引没生效”,这是很常见的误判。
如果查询本来就要读取大部分数据,全表扫描可能比大量随机索引访问更合理。
执行计划的价值,是解释数据从哪里进入、在哪一层被放大,以及优化器的估算为什么和真实执行不同。
先分清 EXPLAIN 和真实执行
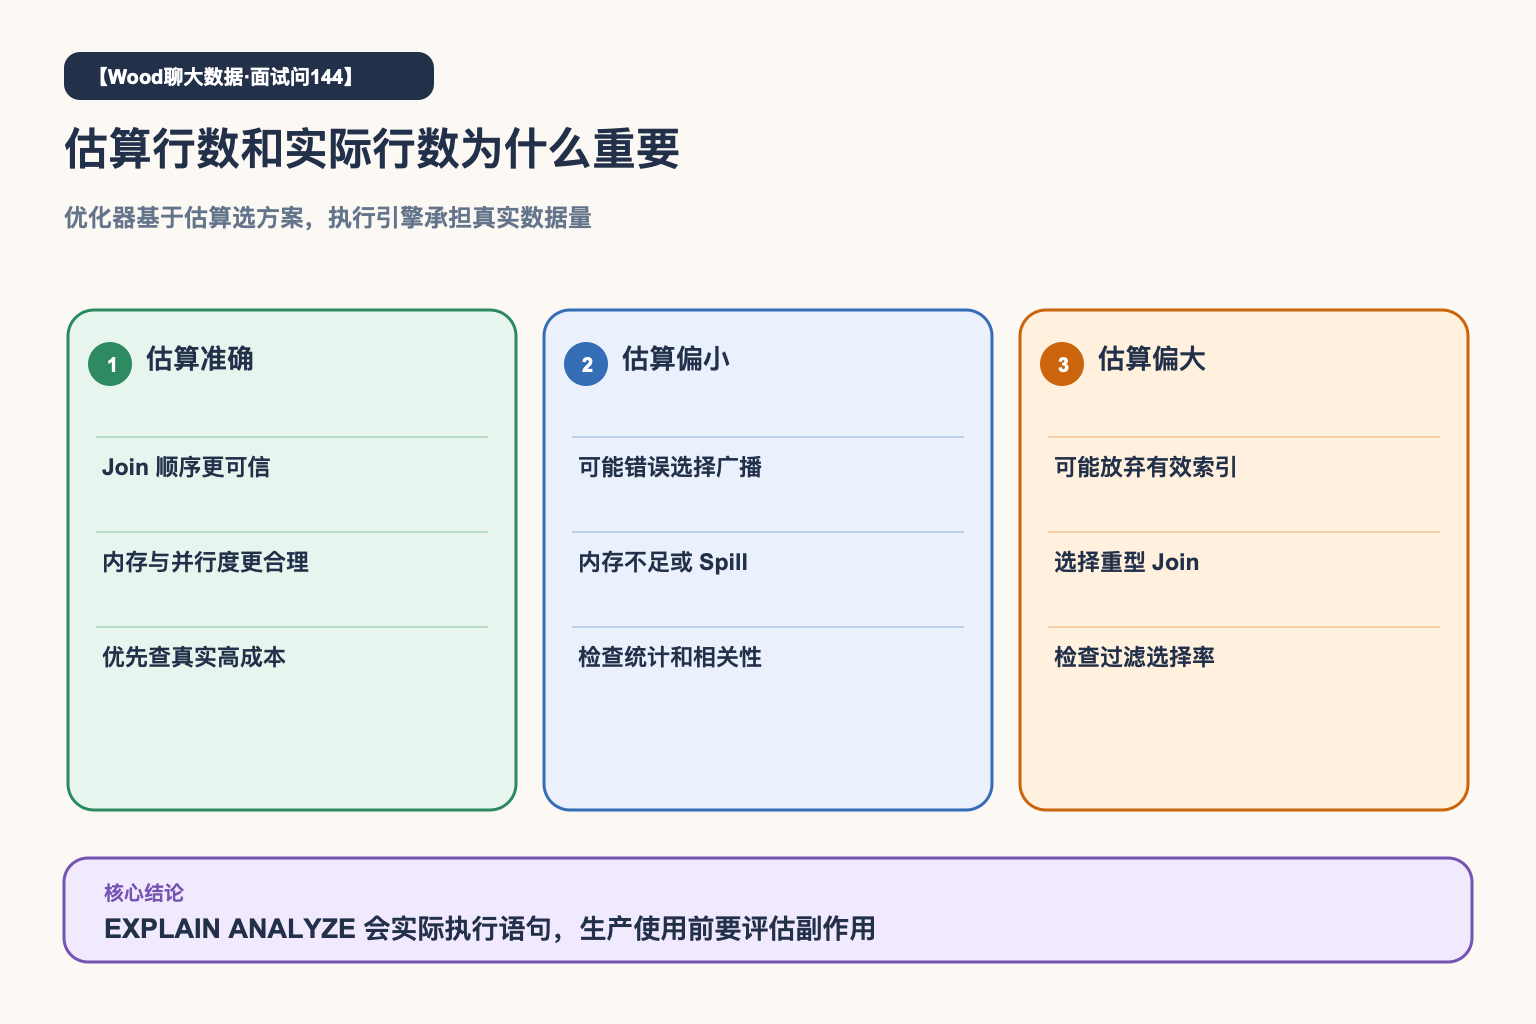
普通 EXPLAIN 展示优化器计划和成本估算;EXPLAIN ANALYZE 一类能力会实际执行并返回真实行数、耗时等信息。
后者更有价值,但对 INSERT、UPDATE、DELETE 或昂贵查询可能产生真实副作用和资源消耗。生产环境不能为了看计划就直接运行。
从扫描入口跟踪行数变化
先看表扫描方式、分区裁剪、列裁剪和过滤下推,再沿执行树观察每个节点输入与输出行数。
某个 Join 前只有十万行,Join 后突然变成上亿行,问题通常不是最后的排序,而是关联键不唯一、条件缺失或估算严重偏差。
重点看估算行数和实际行数
优化器根据统计信息估算过滤选择率、Join 基数和成本,再选择扫描方式、Join 顺序与算法。
估算偏小,可能误选广播 Join 或分配过少内存;估算偏大,可能放弃有效索引或选择更重的执行路径。统计信息过期、字段相关性和数据倾斜都可能造成偏差。
分布式引擎还要看 Exchange 和 Spill
在 Spark、Hive 等分布式引擎里,Exchange 或 Shuffle 表示数据重新分布。排序、聚合和 Join 还可能因为内存不足写磁盘。
因此我会同时看扫描字节、分区数、网络交换量、峰值内存、Spill、长尾 Task 和 key 分布。SQL 文本看起来短,并不代表物理执行简单。
一个典型场景
一条查询的 Hash Join 非常慢,最初怀疑 Join 算法不合适。查看实际行数后发现,优化器估算右表过滤后只有几千行,真实却有数千万行。
根因是分区统计长期未更新,导致错误的 Join 选择。刷新统计并修正过滤条件后,计划才恢复合理。单纯强制另一个 Join 算法,只是在绕开失真的输入信息。
执行计划分析最终要回到数据规模、分布和统计可信度。