SQL 深分页为什么慢?游标分页怎么设计?
面试怎么回答
我会先区分扫描成本、排序边界和跨页一致性。OFFSET 要处理被跳过的记录,深分页成本会增长;游标用稳定排序键加唯一主键,保存上一页完整边界,再结合索引或裁剪能力定位。它适合连续翻页,但随机跳页和一致性导出要另外设计快照或批次,最后用扫描行数和全集对账验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一张订单表,第一页瞬间返回,翻到几万页以后却越来越慢。接口每次只取几十条,数据库到底忙在哪里?这个现象很适合拿来解释 OFFSET 与游标分页的区别。
先建立唯一、稳定的排序,再用上一页边界定位下一段数据;游标分页的效率依赖访问路径,跨页一致性还需要单独设计。
OFFSET 的成本藏在跳过的记录里
LIMIT 限制返回量,OFFSET 要先跳过前面的记录。即使有合适索引,数据库通常仍要沿访问路径处理被跳过的部分;没有索引时,还可能先扫描、排序大量候选行。
所以排查不能只看接口返回行数,要看执行计划实际扫描行数、排序规模、回表次数和耗时。分页越深越慢,往往说明访问量随着页码增长,而连接池和接口线程只是在等待这个过程。
排序必须能够唯一确定一行的位置
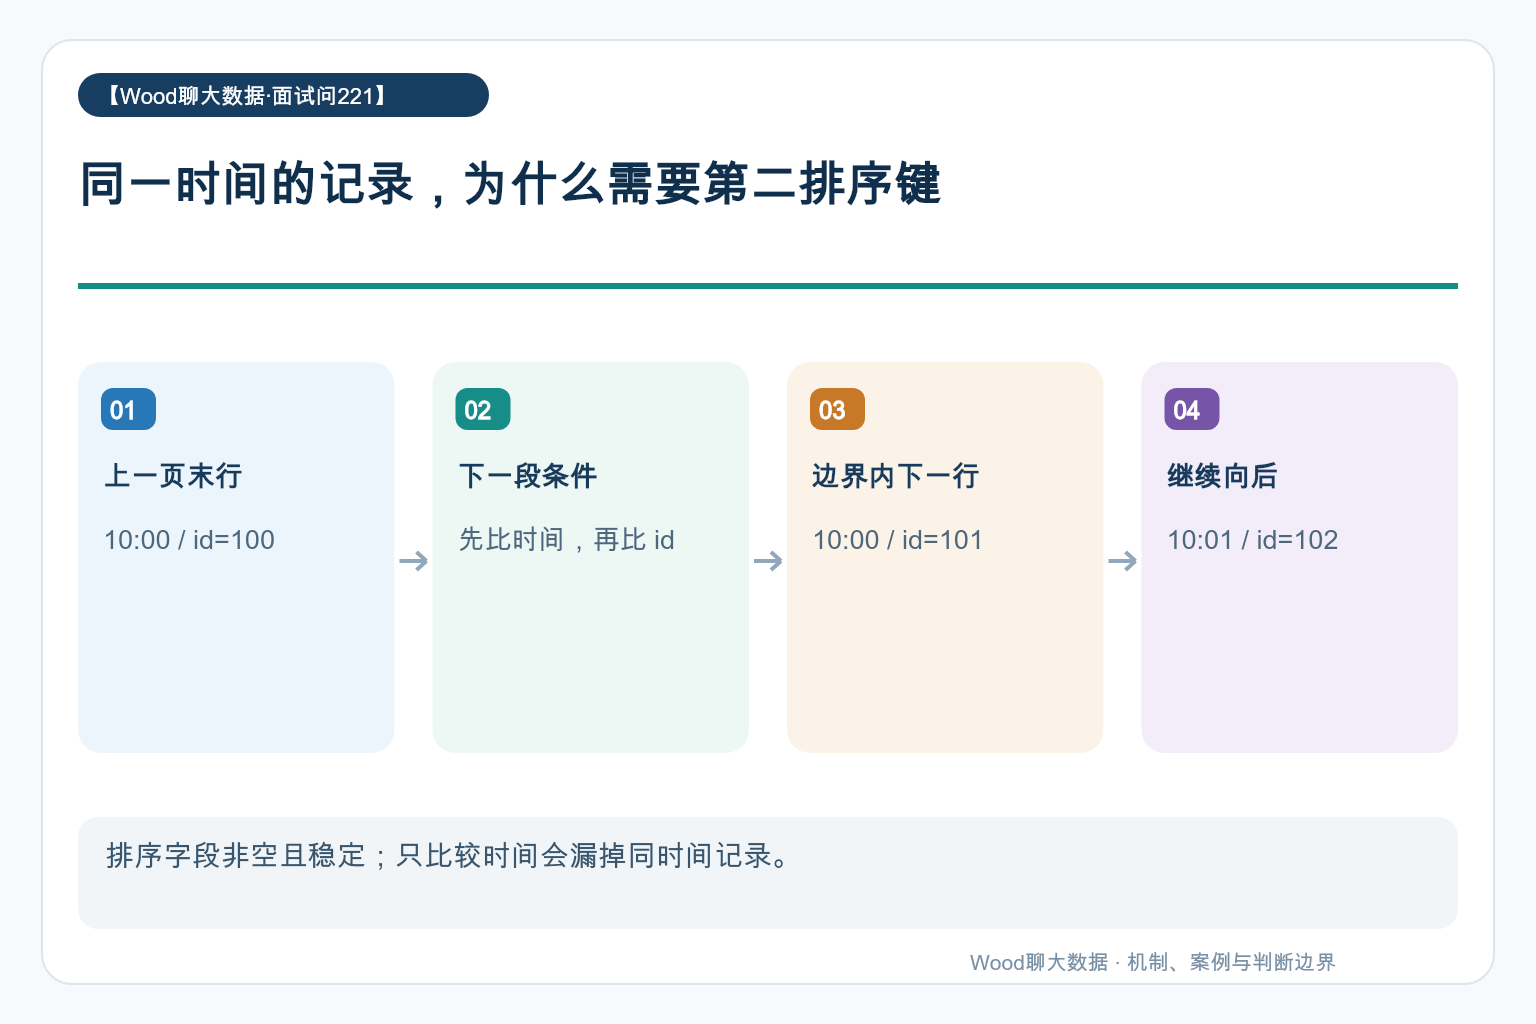
只写 ORDER BY created_at 不够,同一时间可能有很多订单。下一页如果仅使用 created_at > 上页时间,与边界同时间的其他记录就被跳过。
可以把非空、不可变的主键作为第二排序字段,形成 created_at、id 的全序。游标保存两个值,也保存筛选条件和排序方向;否则上一页筛选的是已支付订单,下一页换条件后,边界已失去原来的含义。
游标分页用条件推进边界
以下示例按时间和主键升序,假设两个字段都不为空。它表达的是读取上一页最后一行之后的数据,降序时比较符号也要相应调整。
-- PostgreSQL,参数由调用方绑定
SELECT id, created_at, amount
FROM orders
WHERE tenant_id = :tenant_id
  AND (created_at, id) > (:last_time, :last_id)
ORDER BY created_at, id
LIMIT 50;
针对这种固定访问模式,可以评估 tenant_id、created_at、id 的联合索引。是否真的少扫数据,要用计划验证;在没有索引定位能力的分析引擎里,改成游标也可能仍然扫描很多文件。
一个典型场景:翻页没有变慢,却少了订单
比如运营导出订单时,开发改成游标后发现速度稳定,但总条数仍不对。最初怀疑消费端丢包,后来比对边界记录,才发现排序使用会被修改的 update_time,记录更新后越过了已经读取的位置。
单页接口检查只验证了这一页有无重复,没有检查整个导出集合。修正方案是选用稳定排序键,并明确导出快照或固定批次。记录可能修改、删除时,单靠游标不能承诺导出过程看到同一个时间点的数据。
跳页和稳定快照是两项额外要求
游标适合向后连续翻页,天然不擅长直接跳到任意页。确有跳页需求,可以评估浅分页、预建页边界或异步导出;不要一边要求随机跳页,一边忽略维护索引边界的成本。
如果要完整导出某个时点的结果,考虑数据库快照、物化导出结果或冻结批次。只设置最大主键上限能限制后来插入的数据,却无法阻止范围内旧记录被更新。验收时要覆盖同时间值、末页、删除和并发更新。