SQL 多列去重能直接拼接吗?COUNT DISTINCT 为什么会少算?
面试怎么回答
我会先明确去重粒度和NULL口径,再用多列DISTINCT形成组合,外层COUNT统计组合数。直接拼接会丢失字段边界,加分隔符也要解决转义和缺失值。只有编码规范可逆且稳定时才考虑拼接键;精确计数还不能把哈希当成绝对无碰撞。验收会覆盖分隔符、空串、NULL、重复行和类型变化。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
两组字段分别是(ab,c)和(a,bc)。明明是两个组合,拼接后却都变成了 abc。一个看上去省事的 COUNT DISTINCT,就这样悄悄少算了。
联合去重首先比较字段组合;字符串拼接必须证明编码无歧义,NULL和空串也要有明确口径。
先问:究竟在数什么?
用户加商品的组合数,不等于用户数,也不等于购买次数。先把目标写成“在指定时间范围内,不同用户与商品的配对数量”,才能判断一条重复事件是否应该增加结果。
接着确认字段语义。商品编码中的前导零是否保留?大小写是否有业务区别?去重发生在原始值上,还是经过标准化之后?这些选择会改变集合,不只是改变查询速度。
如果两列来自一对多关联,还要先确认关联没有制造无意义组合。多列去重只能合并相同组合,不能证明组合本身合法。
把两列作为两列处理
下面按 PostgreSQL 17 的语法展示,不依赖某个引擎特有的多参数计数写法:
SELECT COUNT(*) AS pair_cnt
FROM (
    SELECT DISTINCT user_id, product_id
    FROM purchase_events
    WHERE event_date >= DATE '2026-09-01'
      AND event_date <  DATE '2026-10-01'
) AS pairs;
内层保留不同字段组合,外层统计这些行。这里重复出现的同一组合只占一行;包含NULL的组合也可能进入结果,不会因为外层COUNT(*)而自动排除。
如果业务要求两个字段都有效,应在内层显式增加非空和合法性条件。不要拿单列COUNT(column)忽略NULL的规则,直接推导所有引擎的多列COUNT DISTINCT行为;具体语法及缺失值处理应查对应版本。
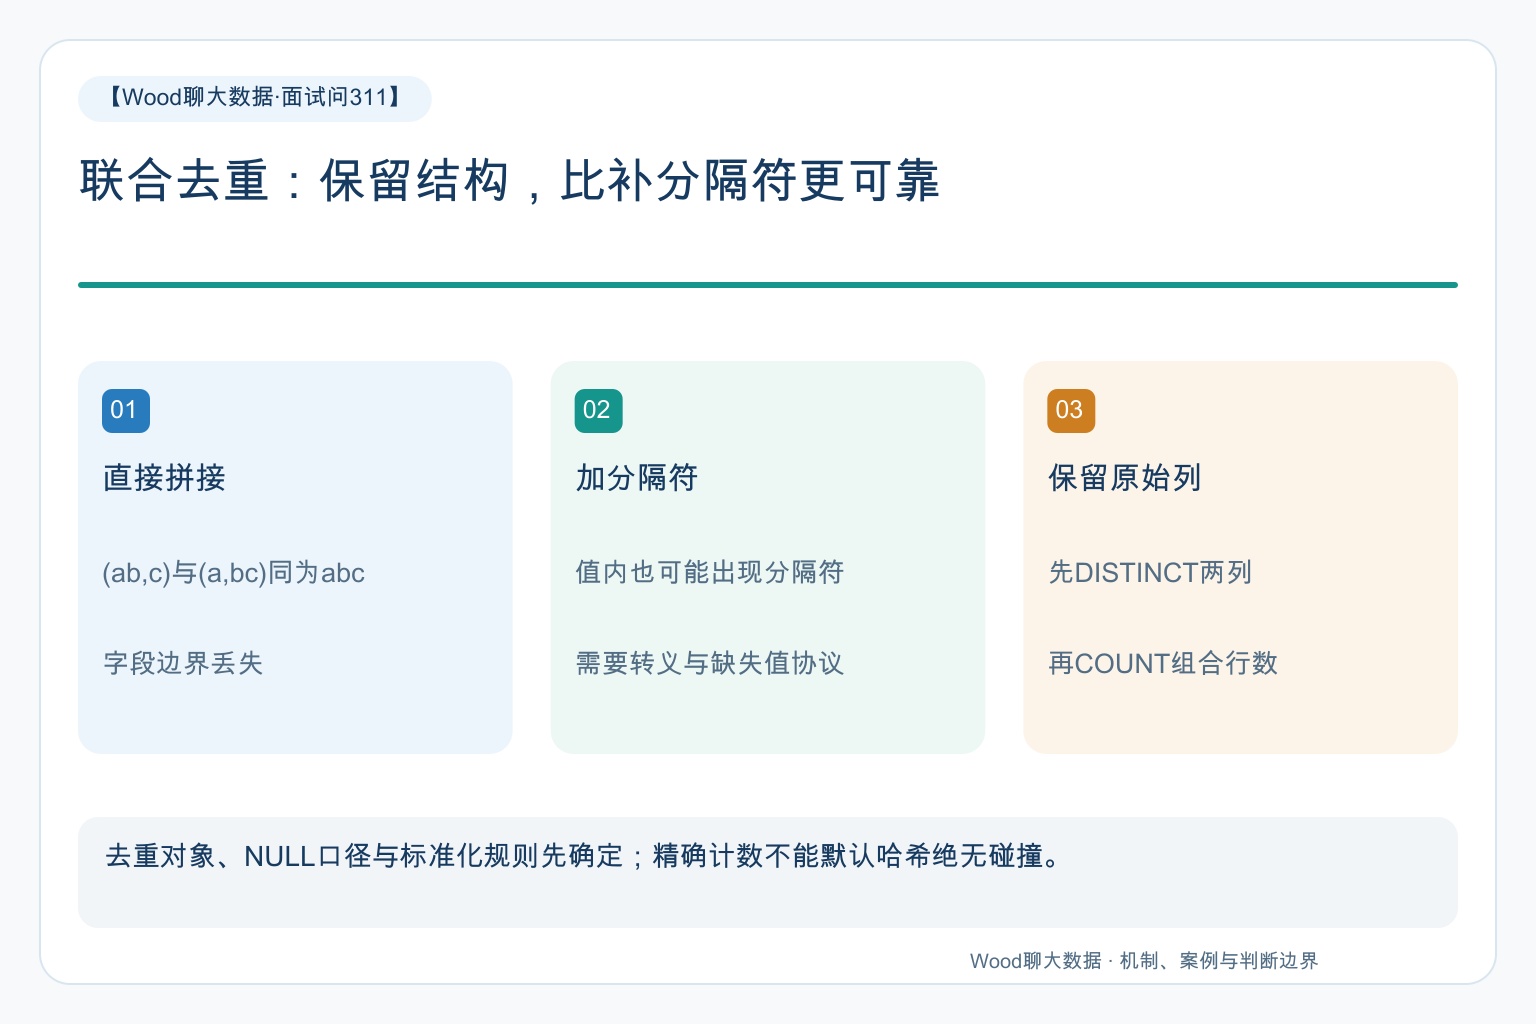
加一道分隔符,问题就解决了吗?
直接拼接没有字段边界。加竖线后,(a|b,c)与(a,b|c)仍然可能得到同一个字符串。所谓“这个字符应该不会出现”,不是长期可依赖的数据契约。
真要序列化,应使用带类型、长度或可靠转义规则的编码,并说明NULL与空字符串的区别。不同语言实现、字符编码、日期格式与小数格式,也需要一致。
更不能默认把NULL替换成空串:缺失用户配商品A,与用户编码确实为空串配商品A,可能因此合并。若业务认为二者等价,也应把这种归一化写进口径,而不是藏在函数里。
哈希可以让键更紧凑,但有限长度哈希存在碰撞可能。精确计数要求多高、是否需要保留原始字段复核,必须按场景决定;不能因为摘要很长就声称数学上绝无碰撞。
一个典型场景:结果稳定,却一直偏小
假设渠道编码和活动编码允许包含下划线,任务用下划线拼接后统计活动组合。上线后渠道侧说少了一批活动,开发第一反应是迟到数据尚未到齐。
实际抽取原始二元组后,发现两种不同拆分得到相同拼接结果。旧验收只检查任务成功、总行数和同一SQL的重跑一致性,当然无法发现:错误编码每次都会稳定地算错。
调整时先保留原始两列做精确基线,再定位发生碰撞的组合,最后修正正式聚合。历史结果是否回补,则按受影响日期和消费方约定处理,不只修改今天的代码。
这组测试也不应只有漂亮的字母数字样本。带分隔符、空串、NULL、中文和重复记录,才是最值得放进回归测试的数据。
优化必须守住同一个集合
多列DISTINCT可能产生较大Shuffle,可以先过滤无关日期、减少无用字段、在业务允许时预聚合。但减少数据移动与改变去重对象,是两件完全不同的事。
例如先在每天去重再把每天数量相加,不能得到整月不同组合数,因为同一组合可以跨天出现。想复用中间结果,需要保留可合并的集合表达或重新去重;近似结构则要明确误差,不能悄悄替代精确口径。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。