SQL COUNT(*)、COUNT(1) 和 COUNT(列) 有什么区别?
面试怎么回答
COUNT() 统计结果集行数;COUNT(1) 统计常量表达式非 NULL 的行数,因此通常与 COUNT() 结果一致;COUNT(列) 会忽略该列为 NULL 的行。现代优化器下 COUNT() 和 COUNT(1) 往往执行计划相同或等价,不能脱离引擎断言谁一定更快。统计总行数我优先用 COUNT(),统计有效字段或 LEFT JOIN 右表匹配数时才用 COUNT(列)。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一张表执行三条 SQL:
SELECT COUNT(*) FROM t;
SELECT COUNT(1) FROM t;
SELECT COUNT(user_id) FROM t;前两个结果相同,第三个却更小。原因通常不是性能,而是:COUNT(列) 不统计 NULL。
先记住结论:COUNT(*) 统计行数,COUNT(常量) 统计常量表达式非 NULL 的行数,COUNT(列) 只统计该列非 NULL 的行数。
三种写法分别统计什么?
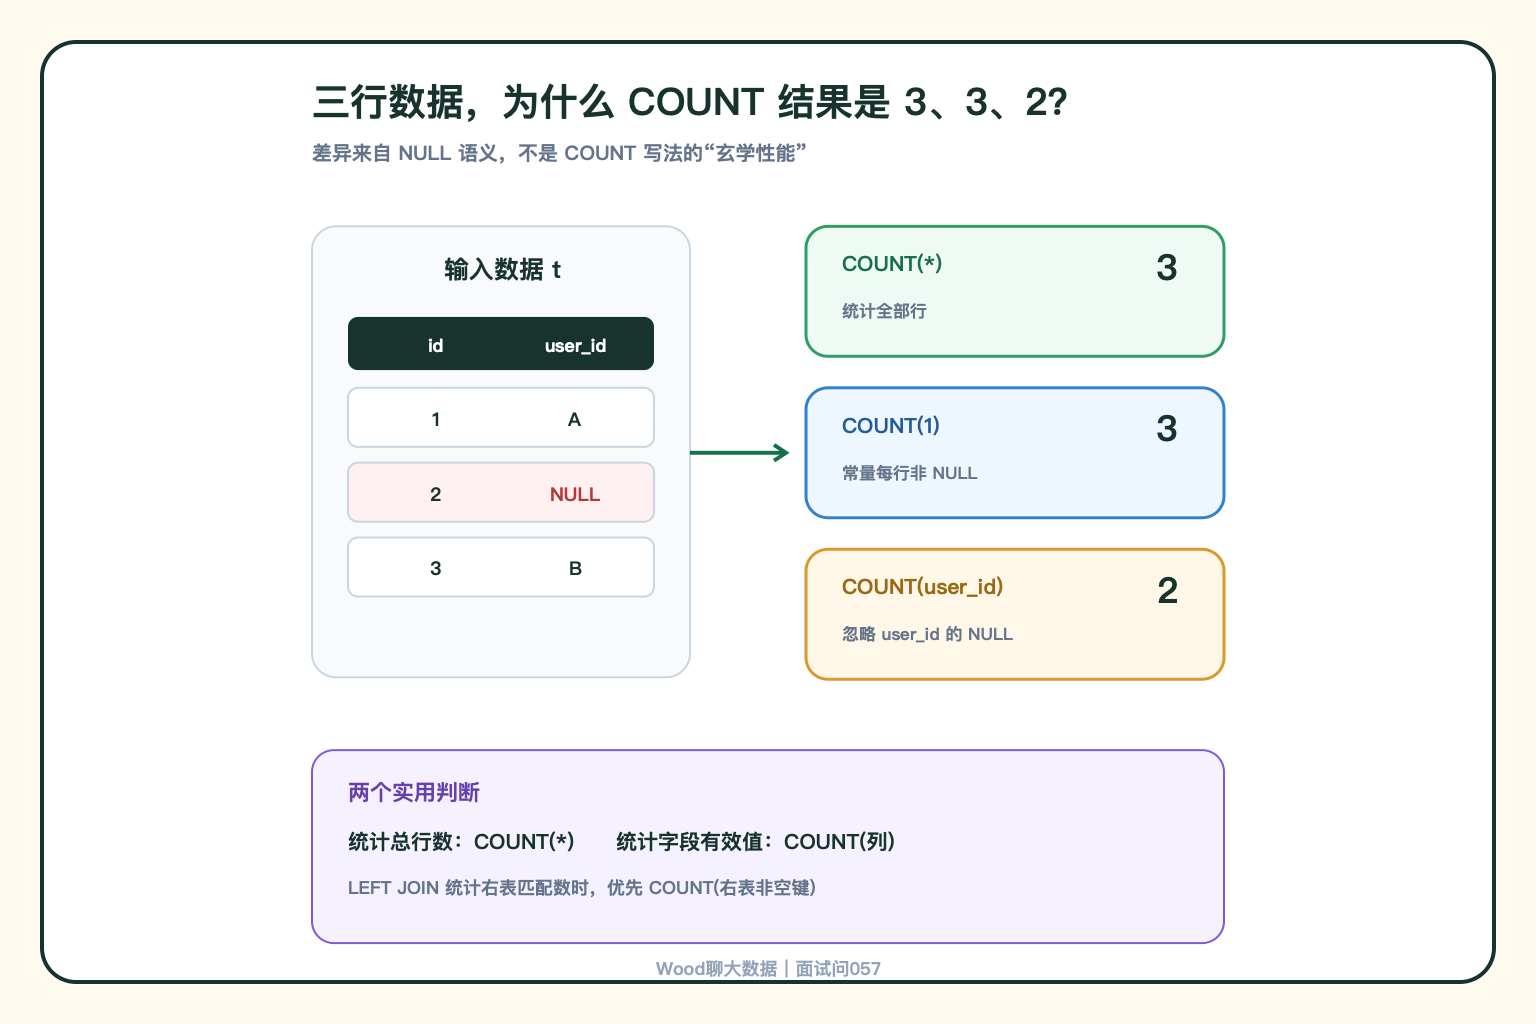
假设数据是:
id | user_id
1  | A
2  | NULL
3  | B
结果为:
COUNT(*)       = 3
COUNT(1)       = 3
COUNT(user_id) = 2
COUNT(*) 不关心某一列是否为空,只统计结果集有多少行。
COUNT(1) 中的 1 是每行都非 NULL 的常量,因此通常也统计所有行。写成 COUNT(0)、COUNT('x'),语义上也类似。
COUNT(user_id) 会忽略 user_id IS NULL 的行。
COUNT(*) 和 COUNT(1) 谁更快?
不要脱离数据库引擎、版本和执行计划给出绝对答案。
现代优化器通常能识别两者都是统计行数,并生成相同或等价的执行计划。实际耗时更多受这些因素影响:
- 是否需要扫描整表或可以利用元数据、索引
- 存储格式和列裁剪能力
- 过滤条件选择性
- 并行度、分区裁剪与缓存
- 分布式引擎是否需要全局聚合
如果业务意图是统计行数,优先写 COUNT(*),语义最清楚。不要为了传闻中的微小性能差异牺牲可读性。
COUNT(列) 什么时候有用?
它适合统计某字段的有效值数量,例如:
SELECT
  COUNT(*) AS total_rows,
  COUNT(phone) AS phone_filled_rows,
  COUNT(*) - COUNT(phone) AS phone_null_rows
FROM user_profile;
还要注意 COUNT(DISTINCT col) 同样会忽略 NULL,并对非 NULL 值去重。多个字段的 DISTINCT 语义与支持方式,则要以具体引擎为准。
两个常见坑
LEFT JOIN 后用错 COUNT
SELECT a.id, COUNT(*)
FROM a LEFT JOIN b ON a.id = b.a_id
GROUP BY a.id;
即使右表没有匹配,LEFT JOIN 仍会保留一行,所以 COUNT(*) 可能是 1。若要统计匹配到的右表记录,应统计右表非空键,例如 COUNT(b.id)。
把 NULL 当成零或空字符串
NULL、0 和 '' 是不同状态。COUNT(col) 只忽略 NULL,不会忽略 0 或空字符串。