数据开发怎么写测试?SQL 单测、集成测试和端到端验收怎么分工?
本文目录
面试怎么回答
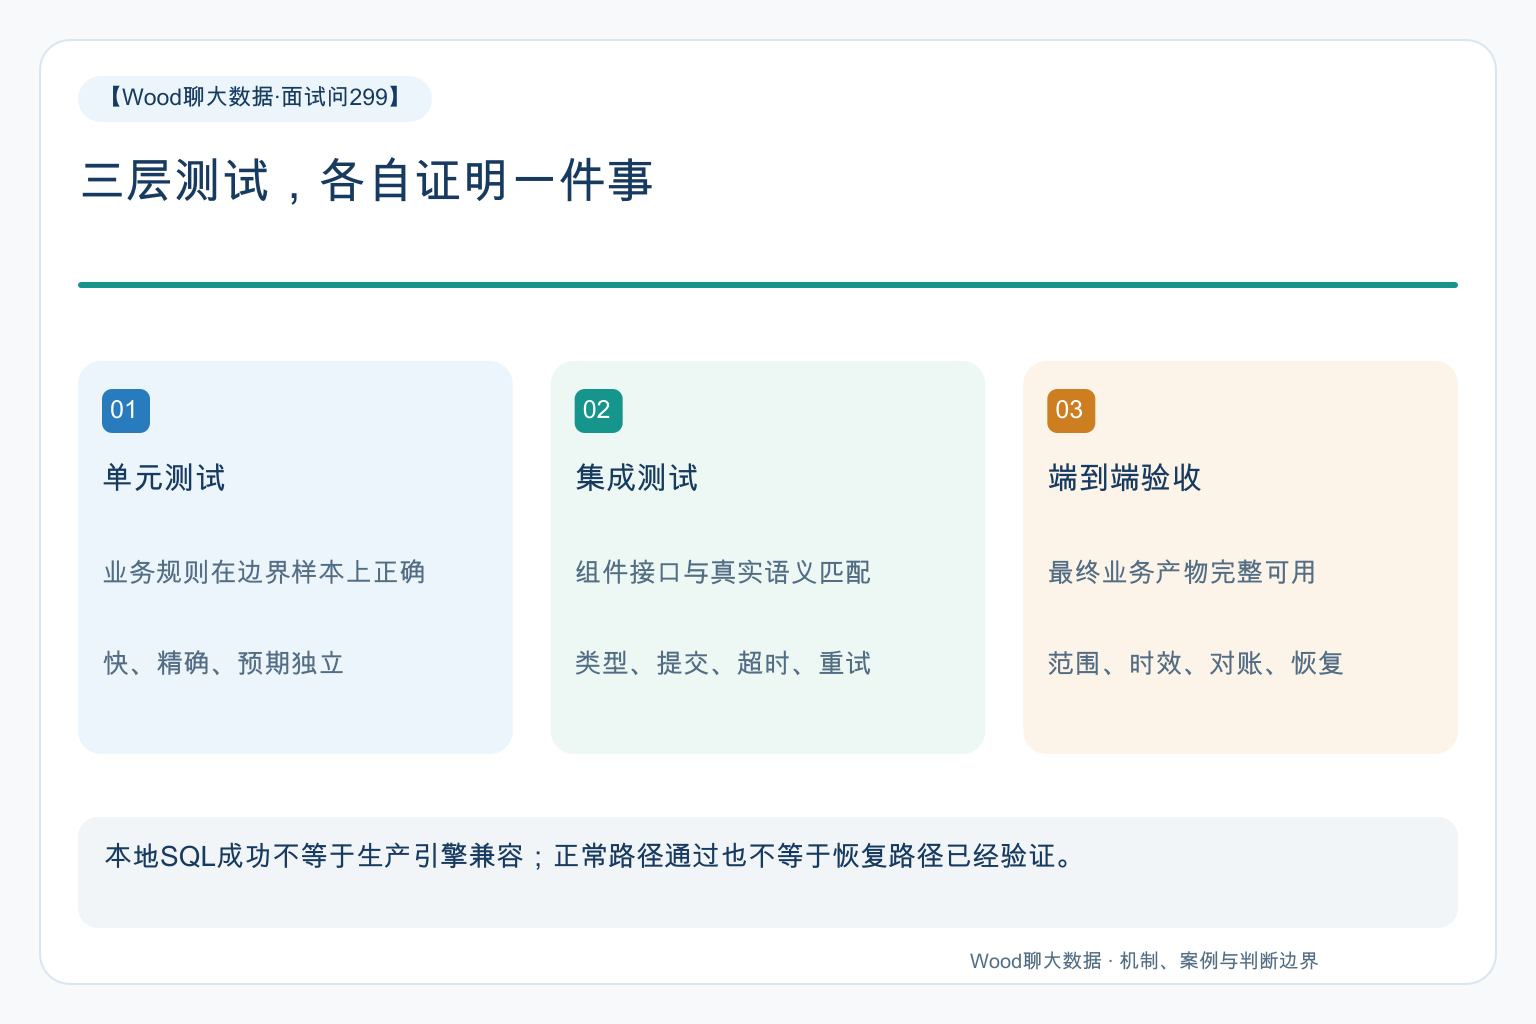
我会按单测、集成和端到端分层。单测用小而精确的样本验证NULL、重复、时间边界和业务规则;集成测试验证真实引擎类型、连接器、提交和重试;端到端验收固定输入范围,核对下游业务键、金额、时效与恢复。预期结果要独立推导,不能复制同一套SQL算答案。每次线上问题补成回归反例,并明确哪些能力仍未覆盖。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一条SQL在测试表里返回了正确结果,上线后却把业务日期写错了。计算逻辑没错,调度参数错了。这样的故障说明:SQL单测非常有用,但它不负责证明整条数据链路已经正确连起来。
单测证明局部规则,集成测试证明接口协作,端到端验收证明业务产物;三层证据不能互相替代。
单测的优势,是用少量数据把规则说死
一条关联规则,可以用几笔订单覆盖一对一、一对多、零命中和重复维度;一个日期计算,可以用跨月、闰日和时区边界验证。
样本不必大,但预期结果必须具体到业务键和字段。只断言“结果不为空”或“运行不报错”,对计算正确性帮助很有限。
最好把转换规则从环境依赖中拆出来,让大多数错误能在快速反馈里发现。输入为空、字段为NULL、金额下降、相同时间不同版本,都比随机生成大量正常数据更有价值。
集成测试负责跨组件的真实行为
在本地SQL引擎跑通,不代表目标数仓的类型转换、时间函数、精度、空值排序和写入语义完全一致。
连接器还会引入分页、批量提交、重试和错误映射。模拟接口永远返回成功,就无法证明超时后实际提交状态不确定时能否安全恢复。
因此集成环境应尽量覆盖关键版本和协议,但不必机械复制整个生产规模。重点是验证组件交界处的假设,而不是把所有资源都搬一遍。
端到端验收,要从输入一直走到业务产物
选定一段可控输入,记录业务日期、规则版本和执行批次,再核对最终结果的键覆盖、金额、维度归属、数据时效和发布位置。
调度日期是否正确传入、上游依赖是否齐全、目标分区是否覆盖到正确范围,这些通常不在纯SQL单测的能力范围内。
如果任务声明支持恢复,还应中断后重跑,检查重复、缺口与外部副作用。正常跑完一次,只能证明正常路径,不等于恢复路径已经验收。
一个典型场景:答案和实现用了同一段逻辑
比如开发写了一个复杂分摊SQL,再把同一套表达式复制到测试里生成预期值。测试长期全绿,后来业务发现尾差分配一直有问题。
最初怀疑测试数据量不够,增加随机样本也没发现异常。根因是“标准答案”复制了实现错误,两边始终以同样方式算错。
旧测试只证明两份相同逻辑一致,没有独立验证业务规则。修复应使用人工可推导的小样本、独立计算方式以及金额守恒等性质检查。
例如原金额100元拆成三个部分,除了逐行预期,还应核对分摊之和仍为100元。性质检查能补充具体样例,但不能替代归属是否正确的验证。
把不可控因素从测试结果里分离
当前时间、随机数、外部维表和持续变化的数据,会让测试今天通过、明天失败。可以注入固定观察时点,固定随机种子,并使用版本化输入。
不过固定随机种子不能修复变化的外部表,快照也不能自动证明生产权限相同。测试报告要说明固定了哪些条件、没有覆盖哪些能力。
对存在合法数值容差的计算,明确容差来自浮点误差还是业务舍入;不要因为测试偶尔红,就不断扩大容差直到全部通过。
测试分层,不是把责任推给下一层
局部规则错了,应尽量在单测发现;连接器行为错了,要在集成层暴露;业务范围和最终发布错了,则需要端到端检查兜底。
每次故障都可以补一个最小反例,并标记它属于哪一层。这样回归库逐渐沉淀真实风险,而不是积累许多只验证“能执行”的脚本。
上线报告可以同时给出通过项、未覆盖项和需要生产观察的指标。承认规模性能尚未验证,比把一次小样本成功包装成全链路可靠更专业。
面试官想听到的,不只是你会不会写assert,而是你如何组织证据,让不同类型的错误在合适的阶段被发现。