SQL PIVOT 和 UNPIVOT 有什么区别?
面试怎么回答
PIVOT 把行中的分类值展开为列,并对同一输出单元格执行聚合;UNPIVOT 把多个列转成“属性名 + 属性值”的多行。二者不是严格可逆,因为 PIVOT 聚合后会丢失明细。实战中我会把稳定长表作为公共存储,只在展示层做有限列的 PIVOT;还要检查动态列导致的 Schema 变化,以及不同引擎对 NULL 和语法的差异。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一份月度销售数据,报表希望“月份变成列”,下游算法却要求“每个月一行”。表里的值没变,数据形状的要求完全相反。
这就是 PIVOT 和 UNPIVOT 要解决的问题:PIVOT 把某列的取值展开为多列,并配合聚合;UNPIVOT 把多列收拢为属性和值两列,转成多行。
PIVOT:从长表变宽表
原始表是“一行一个商品、月份、销售额”:
product_id | month | amount
A          | 01    | 100
A          | 02    | 120
PIVOT 后可以变成:
product_id | m01 | m02
A          | 100 | 120
以 Spark SQL 为例:
SELECT *
FROM sales
PIVOT (
  SUM(amount)
  FOR month IN ('01' AS m01, '02' AS m02)
);
这里不只是把值搬到列上,还发生了聚合。如果同一商品同一月份原本有多行,会先由 SUM(amount) 汇总。
UNPIVOT:从宽表变长表
SELECT *
FROM monthly_sales
UNPIVOT (
  amount FOR month IN (m01 AS '01', m02 AS '02')
);
结果重新变为“月份一行”。这种形态更适合统一计算、时间序列分析和追加新记录。
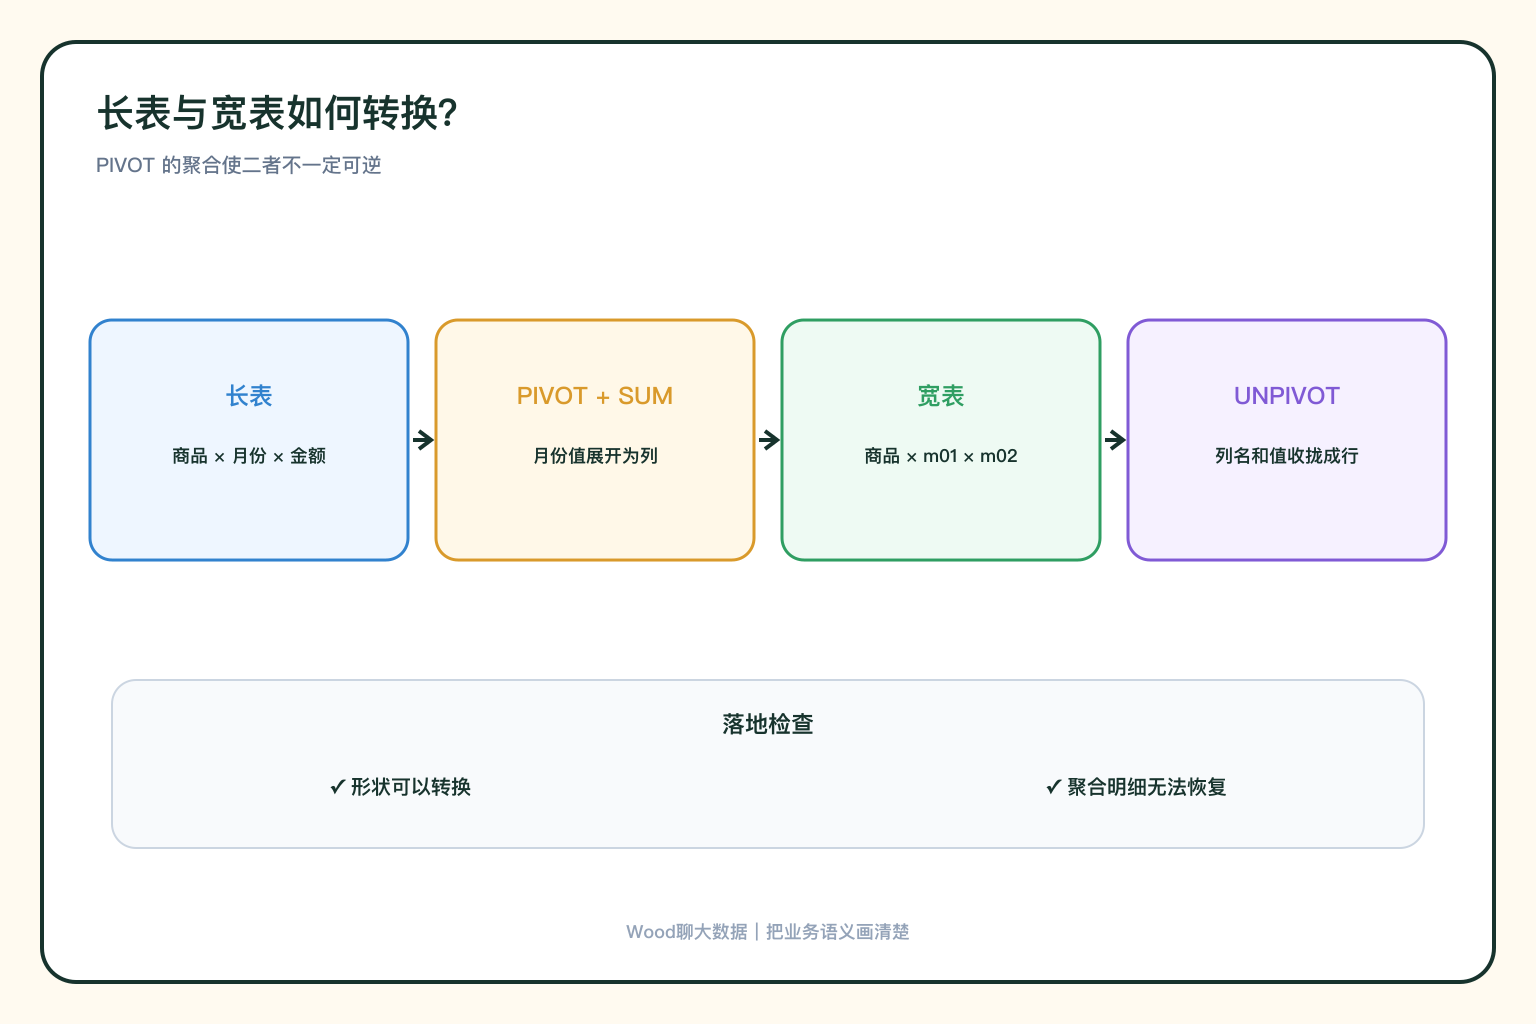
UNPIVOT 不一定能还原 PIVOT 前的数据
这是最容易答漏的一点。PIVOT 可能把多行聚合成一个值,明细已经丢失;再 UNPIVOT 只能恢复为长表形状,无法把聚合前的多条明细重新拆出来。
另外,NULL 的处理也要看数据库语义。以 Spark SQL 为例,UNPIVOT 默认排除值为 NULL 的行,可以显式使用 INCLUDE NULLS 保留。跨引擎迁移时要检查支持的语法和默认行为。
动态列是生产中的真正难点
如果月份固定,提前列出 12 个值很简单;如果要按不断新增的渠道、商品类别做动态 PIVOT,输出 Schema 会持续变化。下游表结构、BI 字段和数据接口都可能跟着失稳。
因此明细层和公共汇总层通常更适合保存稳定的长表结构。PIVOT 更常放在面向展示的查询层,并限制为明确、有限的列集合。
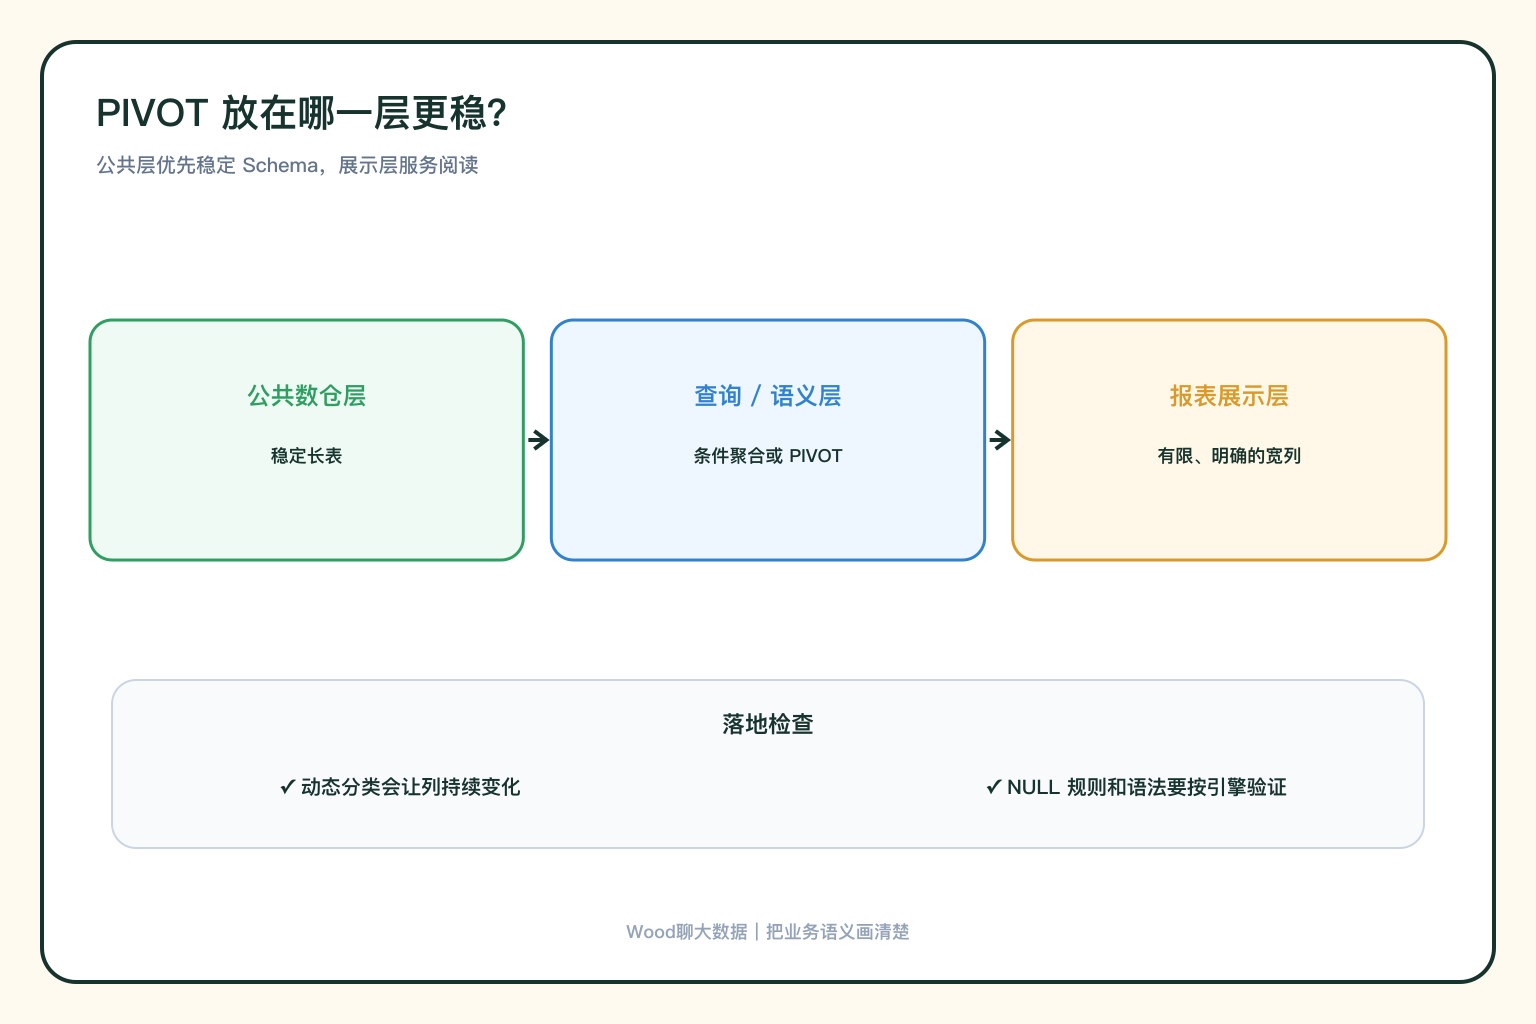
当数据库不支持 PIVOT,或者希望兼容更多引擎,也可以用条件聚合:
SUM(CASE WHEN month = '01' THEN amount END) AS m01它更通用,但列很多时 SQL 会变长。无论使用哪种方式,都要先确认输入粒度、聚合函数和列值范围。