SQL 去重怎么做?DISTINCT 和 ROW_NUMBER 怎么选?
面试怎么回答
我会先定义目标粒度和业务唯一键。整行完全相同用 DISTINCT;同一业务主键要按规则保留一条,用 ROW_NUMBER,并用版本、时间和唯一 ID 构造稳定排序;多条明细都要参与指标时用 GROUP BY 聚合。处理后再验证主键唯一、指标无误和重跑一致,并继续排查上游重复写入或 Join 基数问题。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人看到重复数据,就先写一个 DISTINCT。
但“重复”至少有三种不同含义:整行完全相同、业务主键相同但属性不同、同一主键需要汇总多条明细。
去重之前必须先定义目标粒度,以及同一个业务主键出现多条时到底保留谁。
第一步:先确认什么才算重复
不要先选函数,先回答三个问题:
目标表一行代表什么?
用哪些字段判断同一条业务记录?
多条记录冲突时保留哪一条?
例如订单表希望一行一个 order_id。同一个订单的状态、更新时间不同,这些行不是整行重复,而是同一业务实体的多个版本。
如果没有明确目标粒度,任何去重都可能把合法明细删掉。
第二步:根据重复类型选择方法
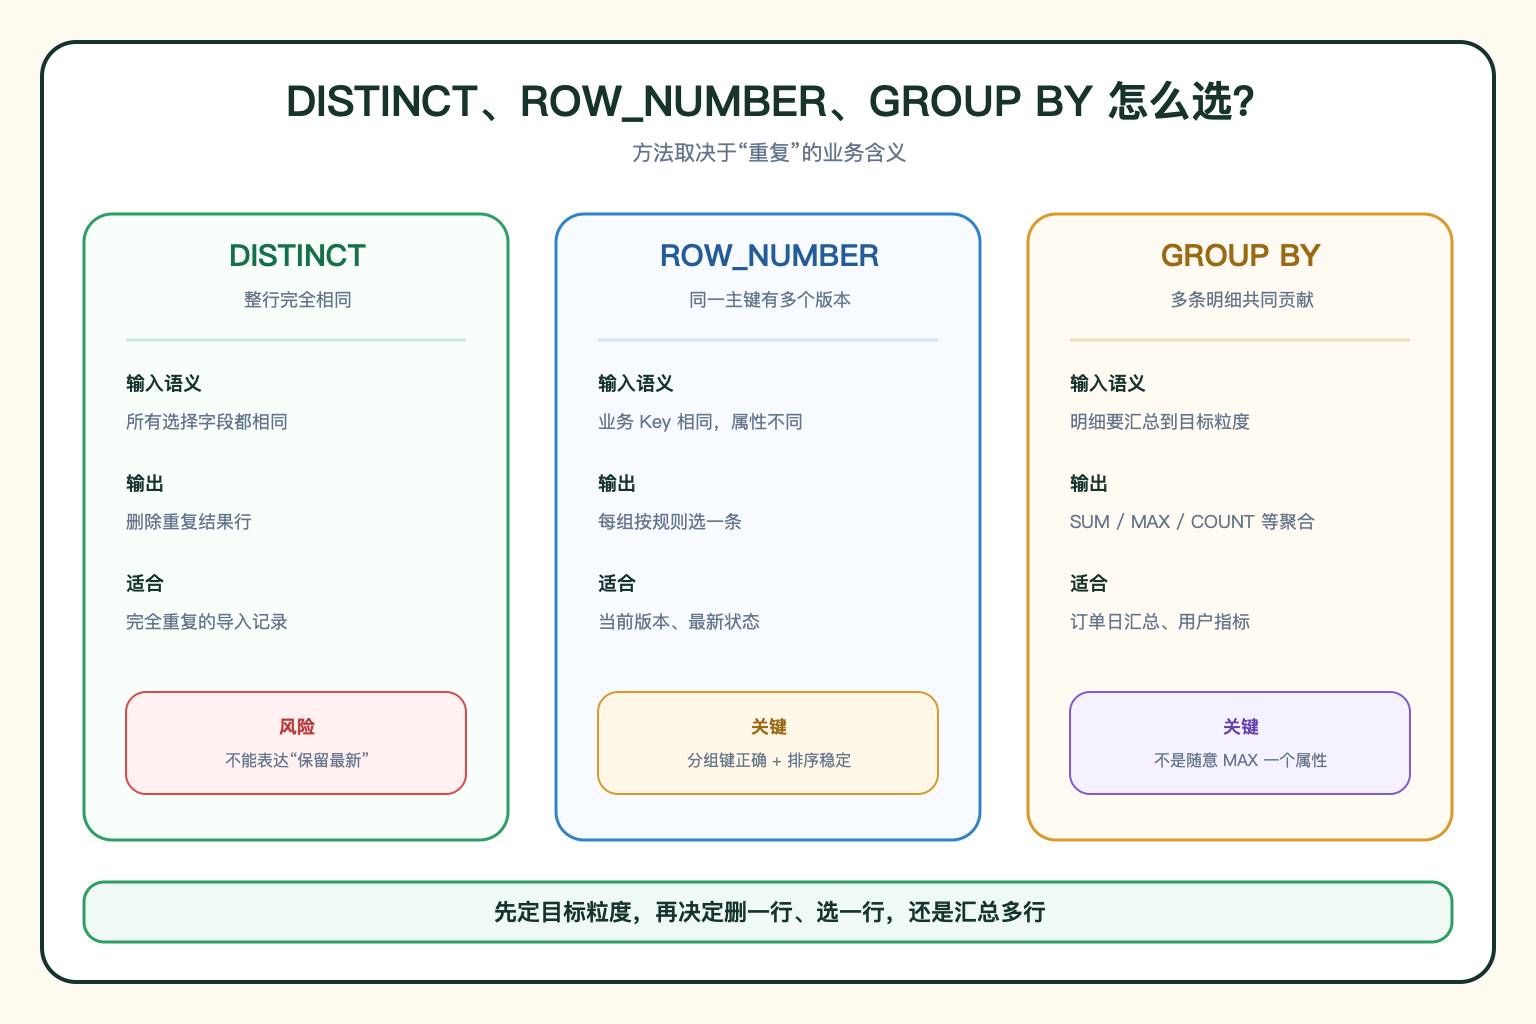
DISTINCT:删除完全相同的结果行
适合所有选择字段都相同的重复记录。
只要某个字段不同,两行就都会保留。它不能表达“同一个订单保留最新状态”。
ROW_NUMBER:每组按规则选择一条
适合按业务主键去重:
SELECT *
FROM (
  SELECT t.*,
         ROW_NUMBER() OVER (
           PARTITION BY order_id
           ORDER BY update_time DESC, event_id DESC
         ) AS rn
  FROM source_table t
) s
WHERE rn = 1;
它的关键不是 rn = 1,而是 PARTITION BY 是否符合业务唯一键,以及 ORDER BY 是否能稳定决定保留记录。
GROUP BY:把多条明细汇总成目标粒度
如果多条记录都应该贡献指标,就不该“选一条”,而应按目标粒度执行 SUM、MAX、COUNT 等聚合。
第三步:ROW_NUMBER 必须有稳定排序
只写:
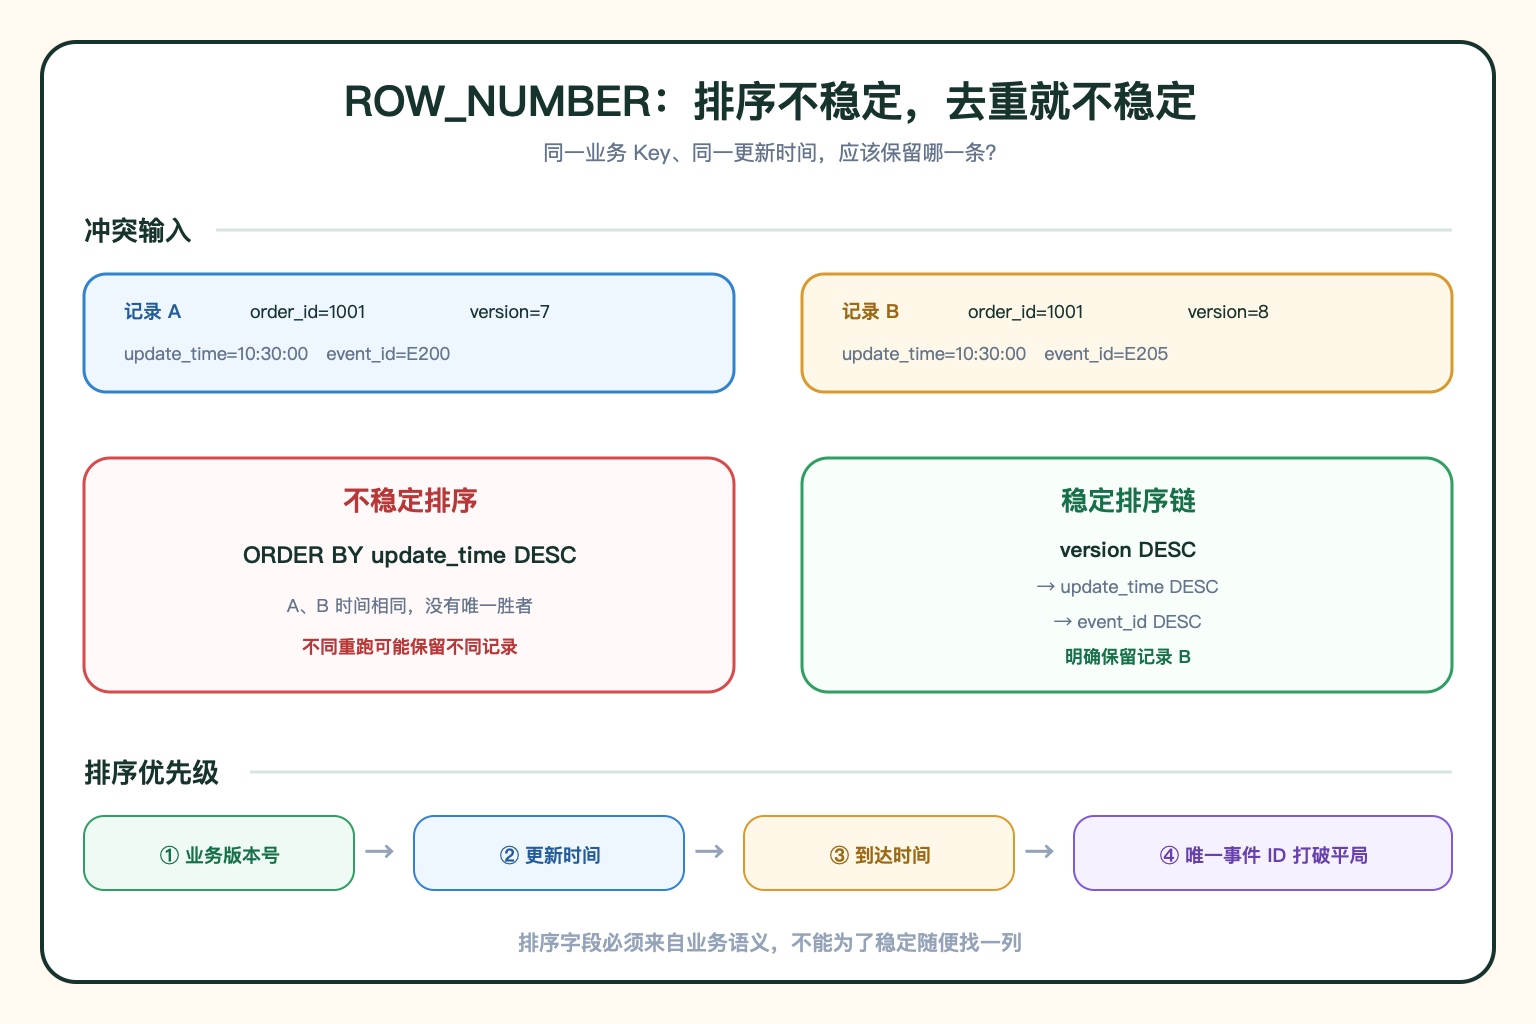
ORDER BY update_time DESC如果两条记录的 update_time 一样,数据库可能任意选择其中一条,不同批次重跑甚至可能得到不同结果。
所以排序规则要形成稳定的优先级,例如:
- 业务版本号更大优先;
- 更新时间更晚优先;
- 到达时间更晚优先;
- 最后使用唯一事件 ID 打破平局。
具体顺序要由业务语义决定,不能为了“稳定”随便找一个字段。
第四步:去重后仍要验证
至少检查:
- 目标业务主键是否唯一
- 去重前后行数和主键数变化
- 被删除记录是否符合保留规则
- 金额、数量等指标是否被误删
- 相同输入重跑结果是否一致
如果重复来自上游重复写入或 Join 基数错误,还要从源头修复幂等和关联条件。下游加一次去重,只是兜底,不是治理闭环。
一个典型场景
比如订单状态表中,同一个 order_id 有 CREATED、PAID、SHIPPED 多条记录。
直接使用 DISTINCT 后,各行状态和时间不同,仍然会保留多条;如果只按 order_id 做 GROUP BY 并随意取 MAX(status),又可能选出字典序最大而不是业务上最新的状态。
正确做法是根据业务版本、更新时间和事件 ID 建立稳定排序,用 ROW_NUMBER 选出当前版本,再验证一单一行。
去重不是删除看起来多余的行,而是恢复目标表的业务粒度。