SQL 如何把用户行为切成会话?30 分钟规则有哪些边界?
面试怎么回答
我会先明确身份范围、超时比较符号和跨天规则。SQL 上先去重并稳定排序,用 LAG 算相邻间隔,标记新会话,再累计求和生成组号。生产里最容易错的是只读当天分区和迟到事件合并会话,所以要传递边界状态或重算受影响范围,并验证下游会话标识的一致性。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一个用户在 10:00、10:20、10:40 连续访问,算一次会话还是两次?如果直接把时间除以 30 分钟再分组,答案很可能从第一步就错了。会话切分看的不是固定时间格子,而是相邻行为之间的间隔。
先按用户稳定排序,用相邻事件间隔标记新会话,再累计编号;跨天与迟到事件必须遵循同一套会话边界。
先问清楚“超过”还是“达到”30 分钟
假设业务约定:同一用户相邻两次有效行为的间隔超过 30 分钟,才开始新会话。那么 10:00、10:20、10:40 的三个事件属于同一会话,虽然首尾相隔 40 分钟。会话总时长可以大于超时阈值。
如果间隔恰好 30 分钟,是继续还是切开?这取决于口径中的大于或大于等于。还要明确身份范围:按账号、设备,还是租户加账号;后台心跳算不算有效行为;没有登录的事件如何归属。SQL 不应该代替业务默默做这些选择。
用三层计算,把边界写出来
先按事件唯一标识去重,并隔离空用户和空时间;再按用户、事件时间、唯一事件号稳定排序。同一时间的两条有效行为可以保留,唯一事件号用于让处理顺序可复现,并不意味着应当把它们合并。
下面用 PostgreSQL 表达核心逻辑。假设输入 clean_events 已完成上述清洗,时间戳使用统一时间基准,本例不在零点强制切会话。
WITH prev AS (
  SELECT *, LAG(event_time) OVER (
    PARTITION BY user_id ORDER BY event_time, event_id
  ) AS prev_time
  FROM clean_events
), marked AS (
  SELECT *, CASE
    WHEN prev_time IS NULL
      OR event_time > prev_time + INTERVAL '30 minutes'
    THEN 1 ELSE 0 END AS is_new
  FROM prev
)
SELECT user_id, event_id, event_time,
       SUM(is_new) OVER (
         PARTITION BY user_id ORDER BY event_time, event_id
         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       ) AS session_no
FROM marked;
LAG 找上一条,CASE 标记起点,累计 SUM 生成组号。组号只在当前用户和当前计算范围内有意义,不能把数字 1 当成全局会话主键。汇总时使用用户与会话标识的完整组合,再计算起止时间、事件数等指标。
一个典型场景:每日任务都成功,会话数却偏高
比如用户在 23:50 和次日 00:10 各访问一次。开发只读取当天分区,第二天的第一条记录找不到上一条,于是被标记成新会话。最初以为用户活跃增加,逐日核验行数也没有异常,因为两条原始事件都在。
根因是读取边界被当成了业务边界。若业务允许跨天会话,日任务需要携带上一批次的最后事件时间和未结束会话标识,或者读取足够的前序上下文后只发布目标范围。只补读前 30 分钟可以帮助判断连接,却未必恢复一条已持续很久的会话身份。
如果产品明确要求每日零点重新计数,则应该把这条规则写进口径,而不是把意外截断包装成设计。跨时区业务还要说明这里的零点属于哪个业务时区。
迟到事件可能合并原来的两个会话
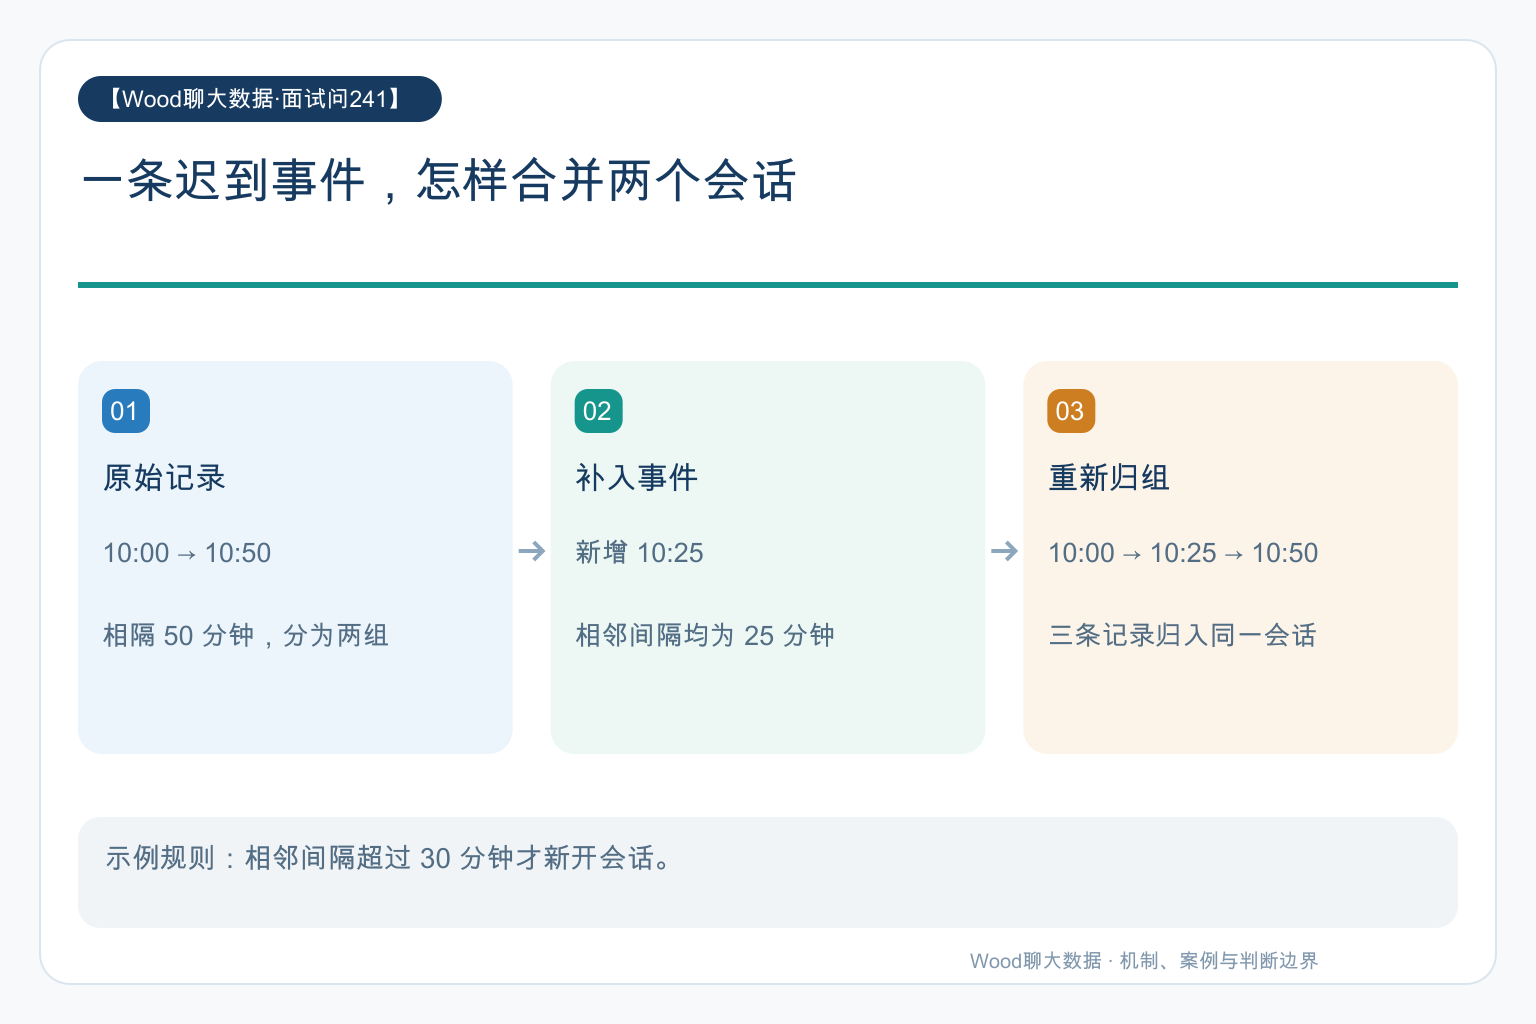
假设原来只有 10:00 和 10:50,两者相隔 50 分钟;后来补进 10:25,两个相邻间隔都变成 25 分钟,原先的两个会话需要合并。因此补数据不是单纯再追加一个会话编号。
离线任务可以按受影响用户和时间范围重算;实时链路则要约定允许迟到多久、结果何时定稿,以及下游是否能接受撤回或覆盖。历史组号可能变化,引用会话标识的下游也要一起处理,不能只改汇总数字。
性能优化不能打散语义
先裁剪必要日期、过滤无效事件、减少参与排序的列,再观察热点用户与排序开销。窗口计算依赖同一用户的完整相关序列,随机加盐把一个用户拆成多组,会破坏相邻关系,不能直接当成通用优化。
验收样本至少覆盖同时间事件、恰好阈值、跨天延续、迟到桥接和重复上报。先人工列出每条事件的预期会话,再对照 SQL,通常比只看总会话数更容易发现问题。