SQL 怎么稳定抽取百分之一用户?随机抽样和哈希抽样有什么区别?
面试怎么回答
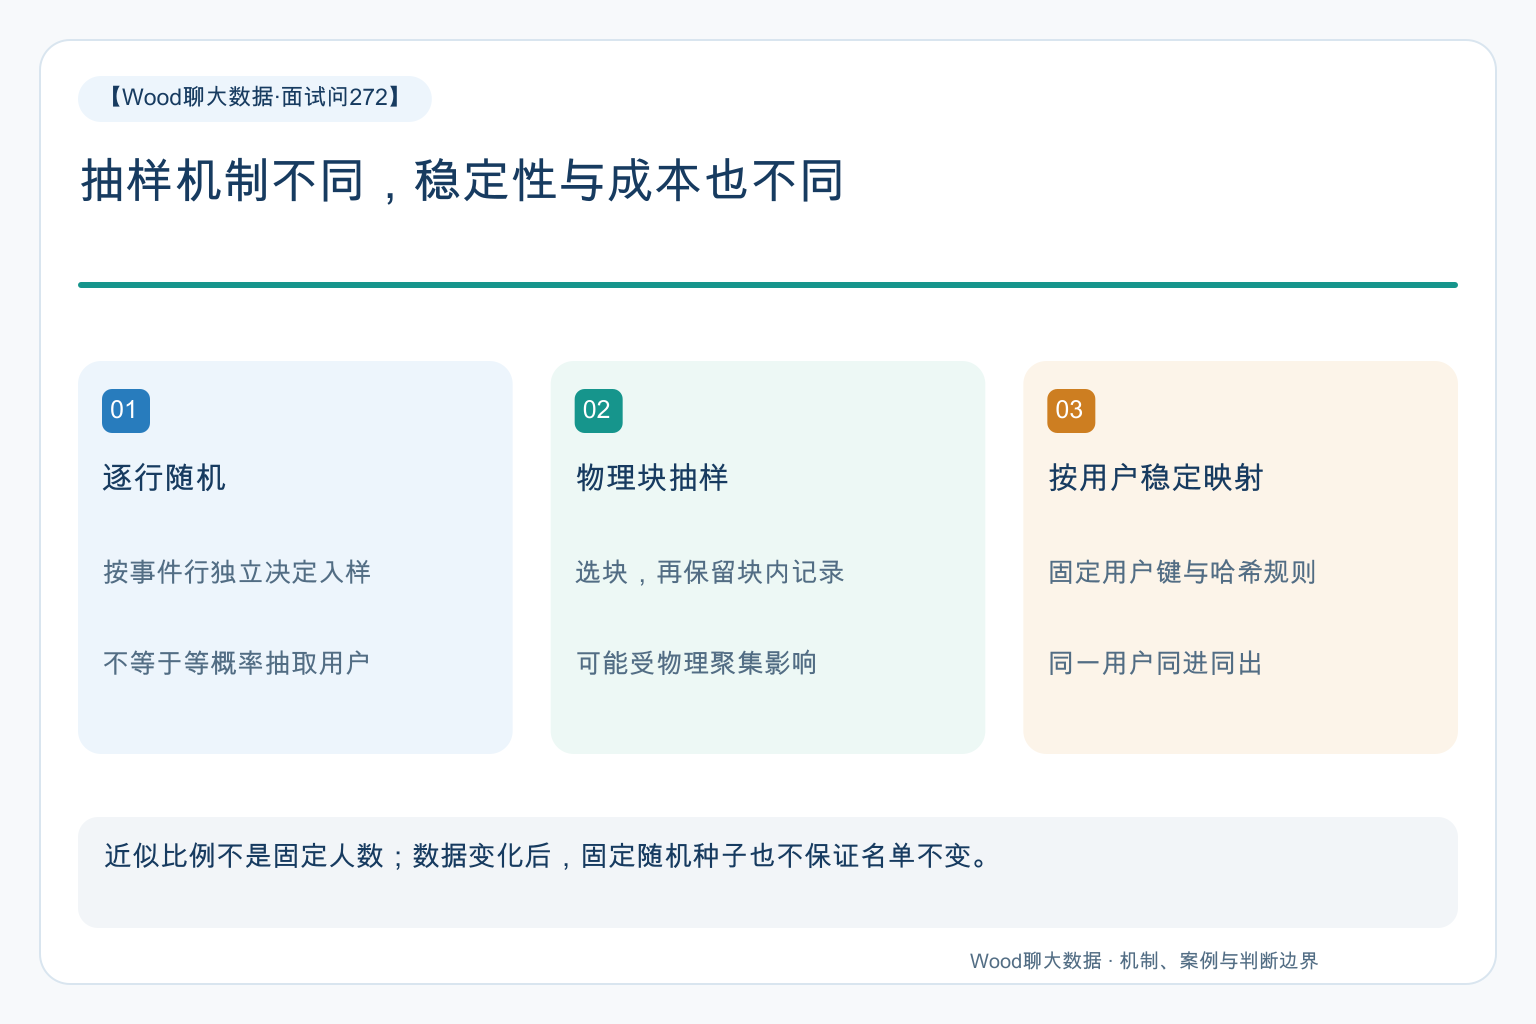
我会先问抽的是用户还是行为行。要跨天保留同一批用户,可以对规范化用户键使用固定、分布合理的哈希映射,再按阈值选桶;相同规则下同一用户始终同进同出。比例通常是近似值,不保证恰好百分之一。随机种子只在特定不变条件下复现,块抽样还可能受物理聚集影响。最后检查样本结构,并把抽样规则版本保存下来。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
测试同学希望每天都拿到同一批百分之一用户,方便比较改动前后的结果。直接随机取百分之一行为日志,今天和明天的名单可能完全不同;给随机函数加个种子,也未必解决跨天稳定的问题。
先定义抽样单位;稳定样本依赖规范化键与固定映射,随机种子不保证数据变化后名单不变。
先问抽用户,还是抽行为?
一个用户每天有一千条事件,另一个用户只有一条。如果按行为行独立抽样,活跃用户更容易至少命中一条。这适合某些事件级问题,却不是等概率抽取用户。
想保留同一批用户的完整行为,应先根据稳定的用户身份确定入样资格,再用这个资格筛选事件。用户有多少行为,不应改变他是否入样。
身份本身也要有边界。匿名设备和登录账号能否当作同一人,跨租户的相同 ID 是否相同,都需要先定义;抽样算法不能修复混乱的身份模型。
随机行、随机块与稳定映射
以 PostgreSQL 17 为例,TABLESAMPLE BERNOULLI 按行选择,SYSTEM 按物理块抽样。前者需要扫描全表,后者在小比例下可能读得更少,但块内聚集会影响样本结构。
下面用于演示近似百分之一的行抽样,不是稳定用户名单方案:
SELECT user_id, event_time
FROM event_log
TABLESAMPLE BERNOULLI (1)
REPEATABLE (20260912);
REPEATABLE 在表未变化、参数相同等条件下可以复现样本。表每天新增、重写或变化后,不应把固定种子理解成永远保持同一批用户。
此外,这类 TABLESAMPLE 在 WHERE 之前发生。先从全表抽样再过滤某个小渠道,剩余样本可能极少;它并不等价于专门在该渠道内抽够所需样本。
稳定样本可以由身份决定
一种工程设计是:规范化用户键,拼入规则版本或固定的实验盐值,通过指定哈希算法映射到均匀整数空间,再按阈值选择。相同键、相同规则下,是否入样不随事件行数改变。
例如把空间均分为一万个桶,选择编号 0 到 99,目标比例约为百分之一。这里是方法描述,不是某个引擎都能直接运行的 HASH 函数语法。
实现时要固定字符串编码、租户前缀、空值处理与算法版本。不同系统的内置 HASH 可能不一致;不能让离线用一种算法、实时用另一种,却期待用户名单相同。
还要小心负数取模和整数最小值取绝对值的边界。更稳妥的是明确无符号解释或使用经过测试的非负映射,并用跨语言固定样例验证。
稳定不等于恰好,也不等于代表性
哈希阈值抽样通常得到近似比例,不承诺小群体中也恰好百分之一。一个只有几十人的渠道可能一个人都没入样,这并不自动证明算法错误。
如果必须每个渠道都有足够样本,可以设计分层抽样,但各层入样率不同时,汇总估计要考虑权重。不能把为了调试补入的异常用户,当作等概率随机样本直接计算总体指标。
如果要求固定数量,可按稳定哈希排序取前 N,但新用户可能挤出旧用户。长期固定名单则更适合保存已选身份及生成规则,而不是每天重新计算“前 N”。
一个典型场景:样本用户异常活跃
比如抽样表里的用户平均事件数明显高于全量,团队最初认为线上用户活跃度变好了。排查才发现,抽的是事件行,之后又去重成用户名单。
高频用户有更多命中机会,偏差来自抽样单位,不是指标 SQL。旧验收只看抽出行数约为百分之一,没有对比用户入样率与活跃度分布。
修复后改为按用户键判断入样,再保留入样用户的行为;同时比较渠道、日期、活跃分层等结构。样本比例对了,只是验收的一项,不是全部。
稳定抽样不自动节省扫描
即使筛掉百分之九十九的行,如果引擎必须读取所有数据才能计算哈希,底层扫描量仍可能很大。可以提前物化抽样桶或样本表,但要验证分区裁剪、文件统计等机制是否真正减少读取。
最后保存生成时间、原始范围、规则版本和适用用途。复现一次测试,需要知道当时读的是哪批数据,而不只是知道种子是多少。