数据库 Nested Loop、Hash Join 和 Merge Join 怎么选?
面试怎么回答
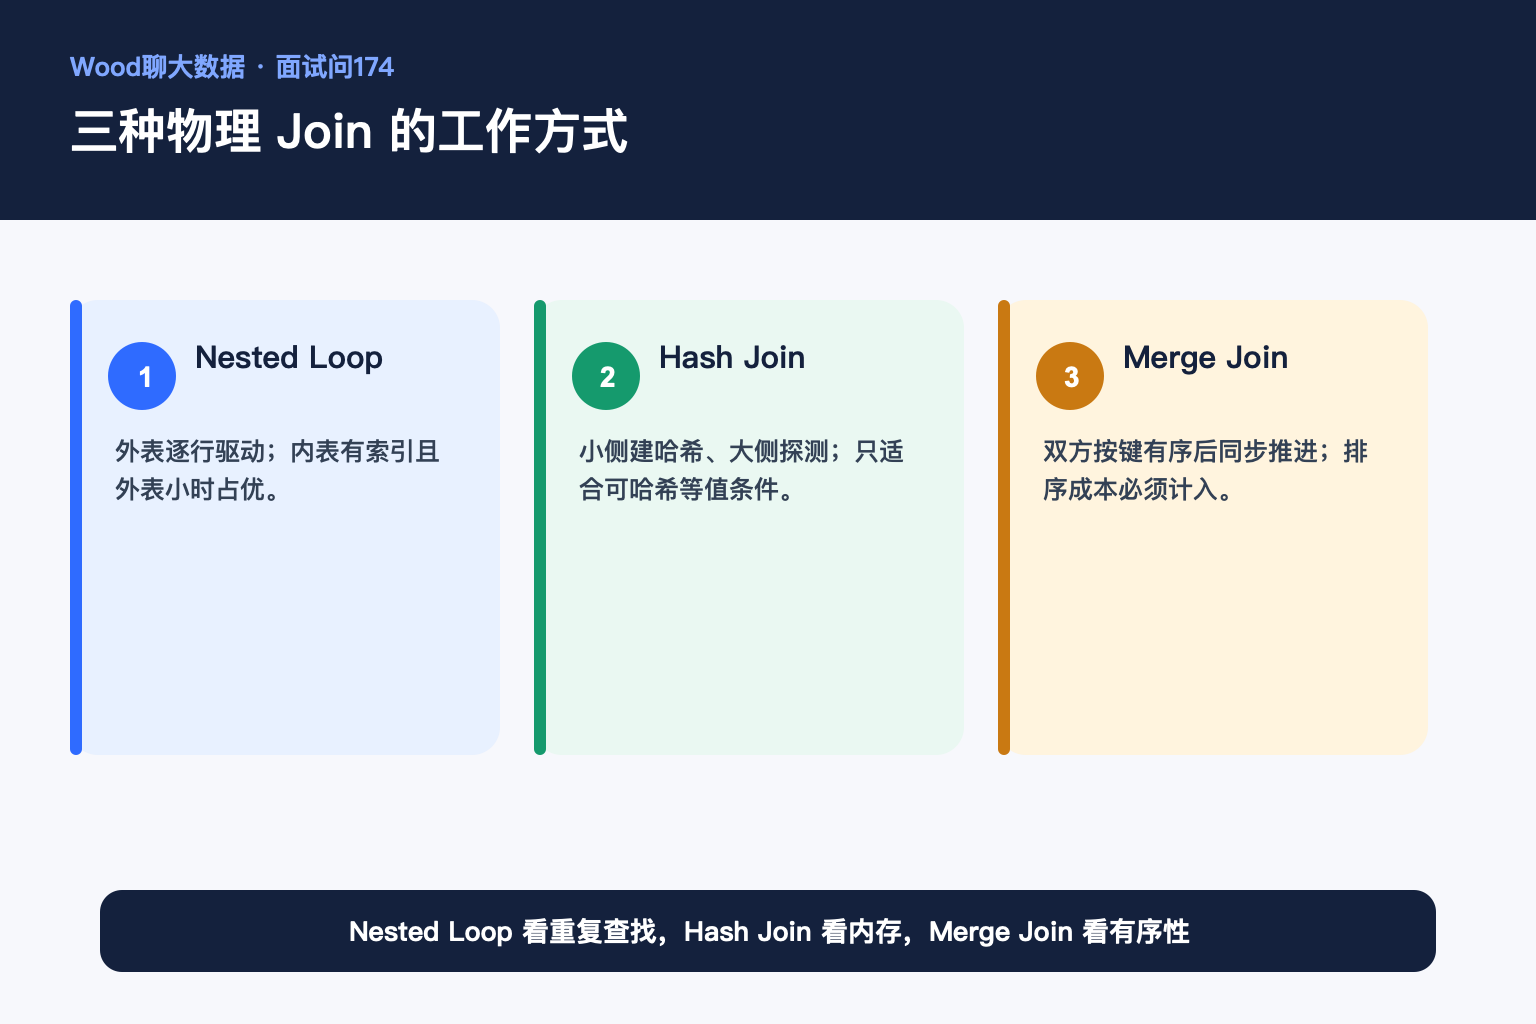
Nested Loop 适合小外表驱动且内表有高效索引;Hash Join 适合大批量等值连接,但要关注哈希表内存和落盘;Merge Join 适合两侧已有序或排序可复用的大数据连接。数据库会根据统计信息和成本选择算法,我会重点检查连接条件、实际行数与估算行数、索引、有序性以及内存,而不是手工固定某一种。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
面试官追问一句:两张表 Join,数据库底层到底怎么执行?
只回答小表放左边还不够,因为优化器真正选择的是物理连接算法和访问路径。
Join 算法的选择取决于输入规模、连接条件、索引、有序性和可用内存,而不是固定偏爱某一种。
Nested Loop 适合小外表加快速内表查找
Nested Loop 从外表取一行,再到内表查找匹配记录。外表很小、内表连接键有高效索引时,它可以很快,也能较早返回结果。若外表估算过小但实际很大,内表访问会被重复成千上万次,性能就会急剧下降。
Hash Join 擅长大批量等值连接
Hash Join 通常选择较小输入构建哈希表,另一侧逐行探测。它不要求输入预先有序,适合等值 Join。哈希表能放进工作内存时效率很好;内存不足发生分批或落盘后,磁盘 I/O 和分区成本会显著增加。
Merge Join 利用有序输入线性推进
Merge Join 要求双方按连接键有序,可以利用已有索引顺序,也可能先执行 Sort。两个游标按键值同步推进,适合大规模有序数据和可复用排序的场景。若为了 Join 单独排序成本很高,它未必比 Hash Join 划算。
优化器为什么可能选错
优化器依赖表统计信息、选择性估计、成本参数和可用路径。如果统计信息过期、列相关性未被识别或参数过滤值高度倾斜,估算行数会偏离实际,进而选错外表、Build Side 或 Join 算法。分析执行计划时要同时看估算行数与实际行数。
一个典型场景
查询先按状态筛出极少订单,再按主键关联用户表。Nested Loop 配合用户主键索引通常合适。但如果状态字段突然大面积命中,外表从几百行变成几百万行,重复索引访问会放大,此时 Hash Join 可能更稳。根因不是某种算法不好,而是基数估算与数据分布变了。
参考资料
- PostgreSQL Query Planning Overview:https://www.postgresql.org/docs/current/geqo-intro.html